

Decir «#1 en el ranking» es cierto para una prueba concreta, ejecutada de una forma concreta, un día concreto. Dice mucho menos sobre si ese modelo es el mejor para tu trabajo. Antes de cambiar de herramienta o pagar un plan más caro por un ranking, averigua de qué tabla sale, quién la ejecutó y qué mide.
Esto importa más en 2026 porque los rankings se han convertido en negocio. Arena, el sitio público de rankings antes conocido como LMArena, levantó 200 millones de dólares con una valoración de 3.100 millones este año, casi el doble de los 1.700 millones en que se valoraba a principios de 2026 (Phemex). Arena afirma que sus ingresos anualizados ya superan los 100 millones de dólares (Arena). Hoy todo lanzamiento de un modelo abre con una posición en el ranking, y esa posición vende.
Nada de esto significa que las tablas sean falsas. La mayoría las han construido profesionales serios y miden algo real. El problema es que cada una mide algo distinto, y un post de lanzamiento citará la que mejor deje al modelo. Esta guía explica cómo funcionan las tablas principales, dónde falla cada una y cómo leer una afirmación en unos dos minutos.
Cuatro tipos de ranking, cuatro preguntas distintas
La mayoría de los rankings que te encontrarás caen en uno de cuatro grupos. Los grupos importan más que cualquier tabla concreta, porque un número solo significa algo cuando sabes de qué grupo viene.
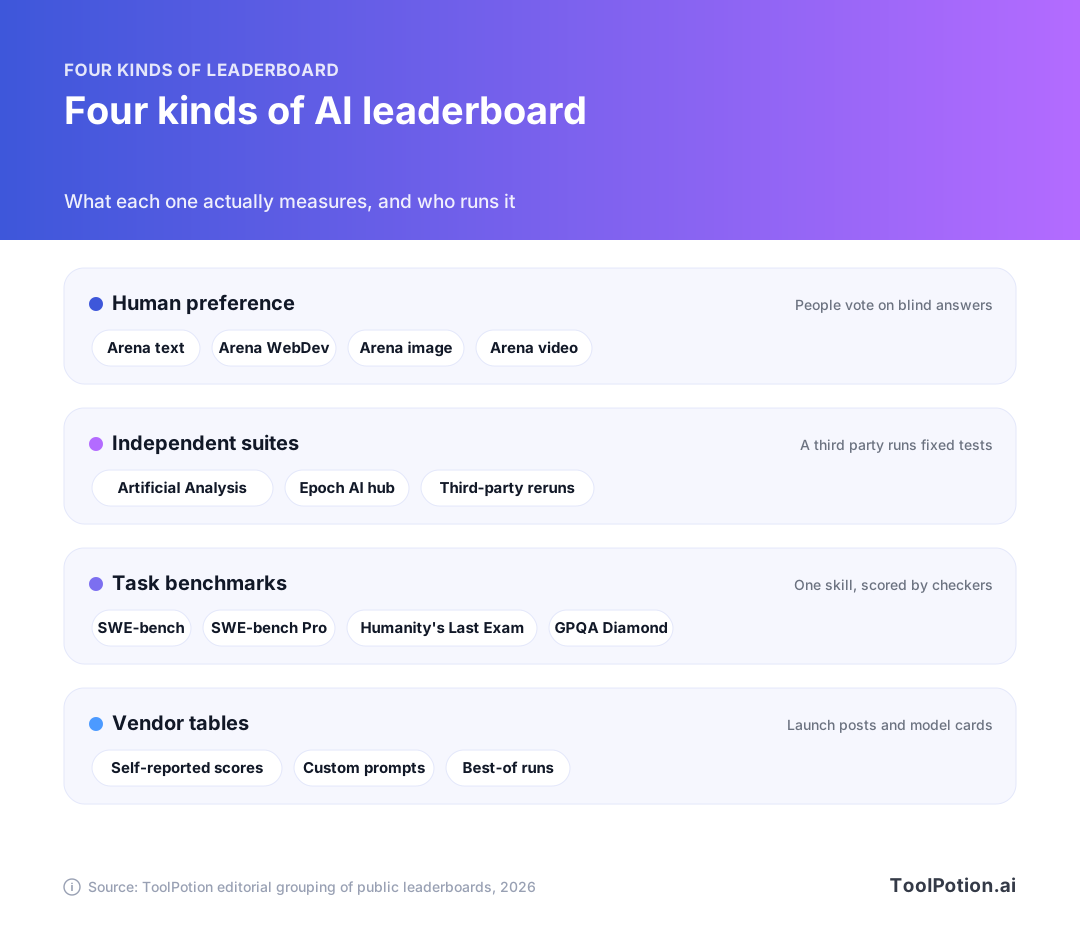
Las arenas de preferencia humana preguntan a la gente qué respuesta le gusta más. Las suites independientes ejecutan un conjunto fijo de pruebas en todos los modelos en las mismas condiciones. Los benchmarks de tareas comprueban una sola habilidad, como arreglar bugs reales de software, con un evaluador automático. Las tablas de fabricante son las puntuaciones que un laboratorio publica en su propio post de lanzamiento o ficha del modelo, normalmente con ajustes que eligió el propio laboratorio.
Los grupos no compiten entre sí, sino que responden preguntas distintas. La preferencia te dice con qué modelo disfruta la gente al conversar. Una suite te dice cómo se comparan los modelos cuando un tercero neutral lleva el cronómetro. Un benchmark de tareas te dice si un modelo sabe hacer un trabajo muy concreto. Una tabla de fabricante te dice en qué quiere el laboratorio que te fijes.
| Tipo de ranking | Ejemplo | Qué mide | Punto débil principal |
|---|---|---|---|
| Preferencia humana | Arena texto y WebDev | Qué respuesta vota la gente | Premia el estilo y la longitud, se puede manipular |
| Suite independiente | Artificial Analysis, hub de Epoch AI | Puntuaciones en un conjunto de pruebas fijo | Solo es tan buena como las pruebas que eligió |
| Benchmark de tareas | SWE-bench, Humanity's Last Exam | Una habilidad con evaluación automática | Contaminación, tareas defectuosas, saturación |
| Tabla de fabricante | Posts de lanzamiento, fichas de modelo | Lo que el laboratorio decidió reportar | Ajustes y prompts que no puedes verificar |
Cómo un voto en Arena se convierte en una puntuación
Arena nació como Chatbot Arena, un proyecto de investigación de UC Berkeley. La idea es simple: escribes un prompt, dos modelos anónimos responden y eliges la mejor respuesta. El artículo original de los investigadores describe una plataforma que reunió más de 240.000 votos en sus primeros meses y concluyó que los votos de la multitud coincidían bien con el criterio de expertos (arXiv).
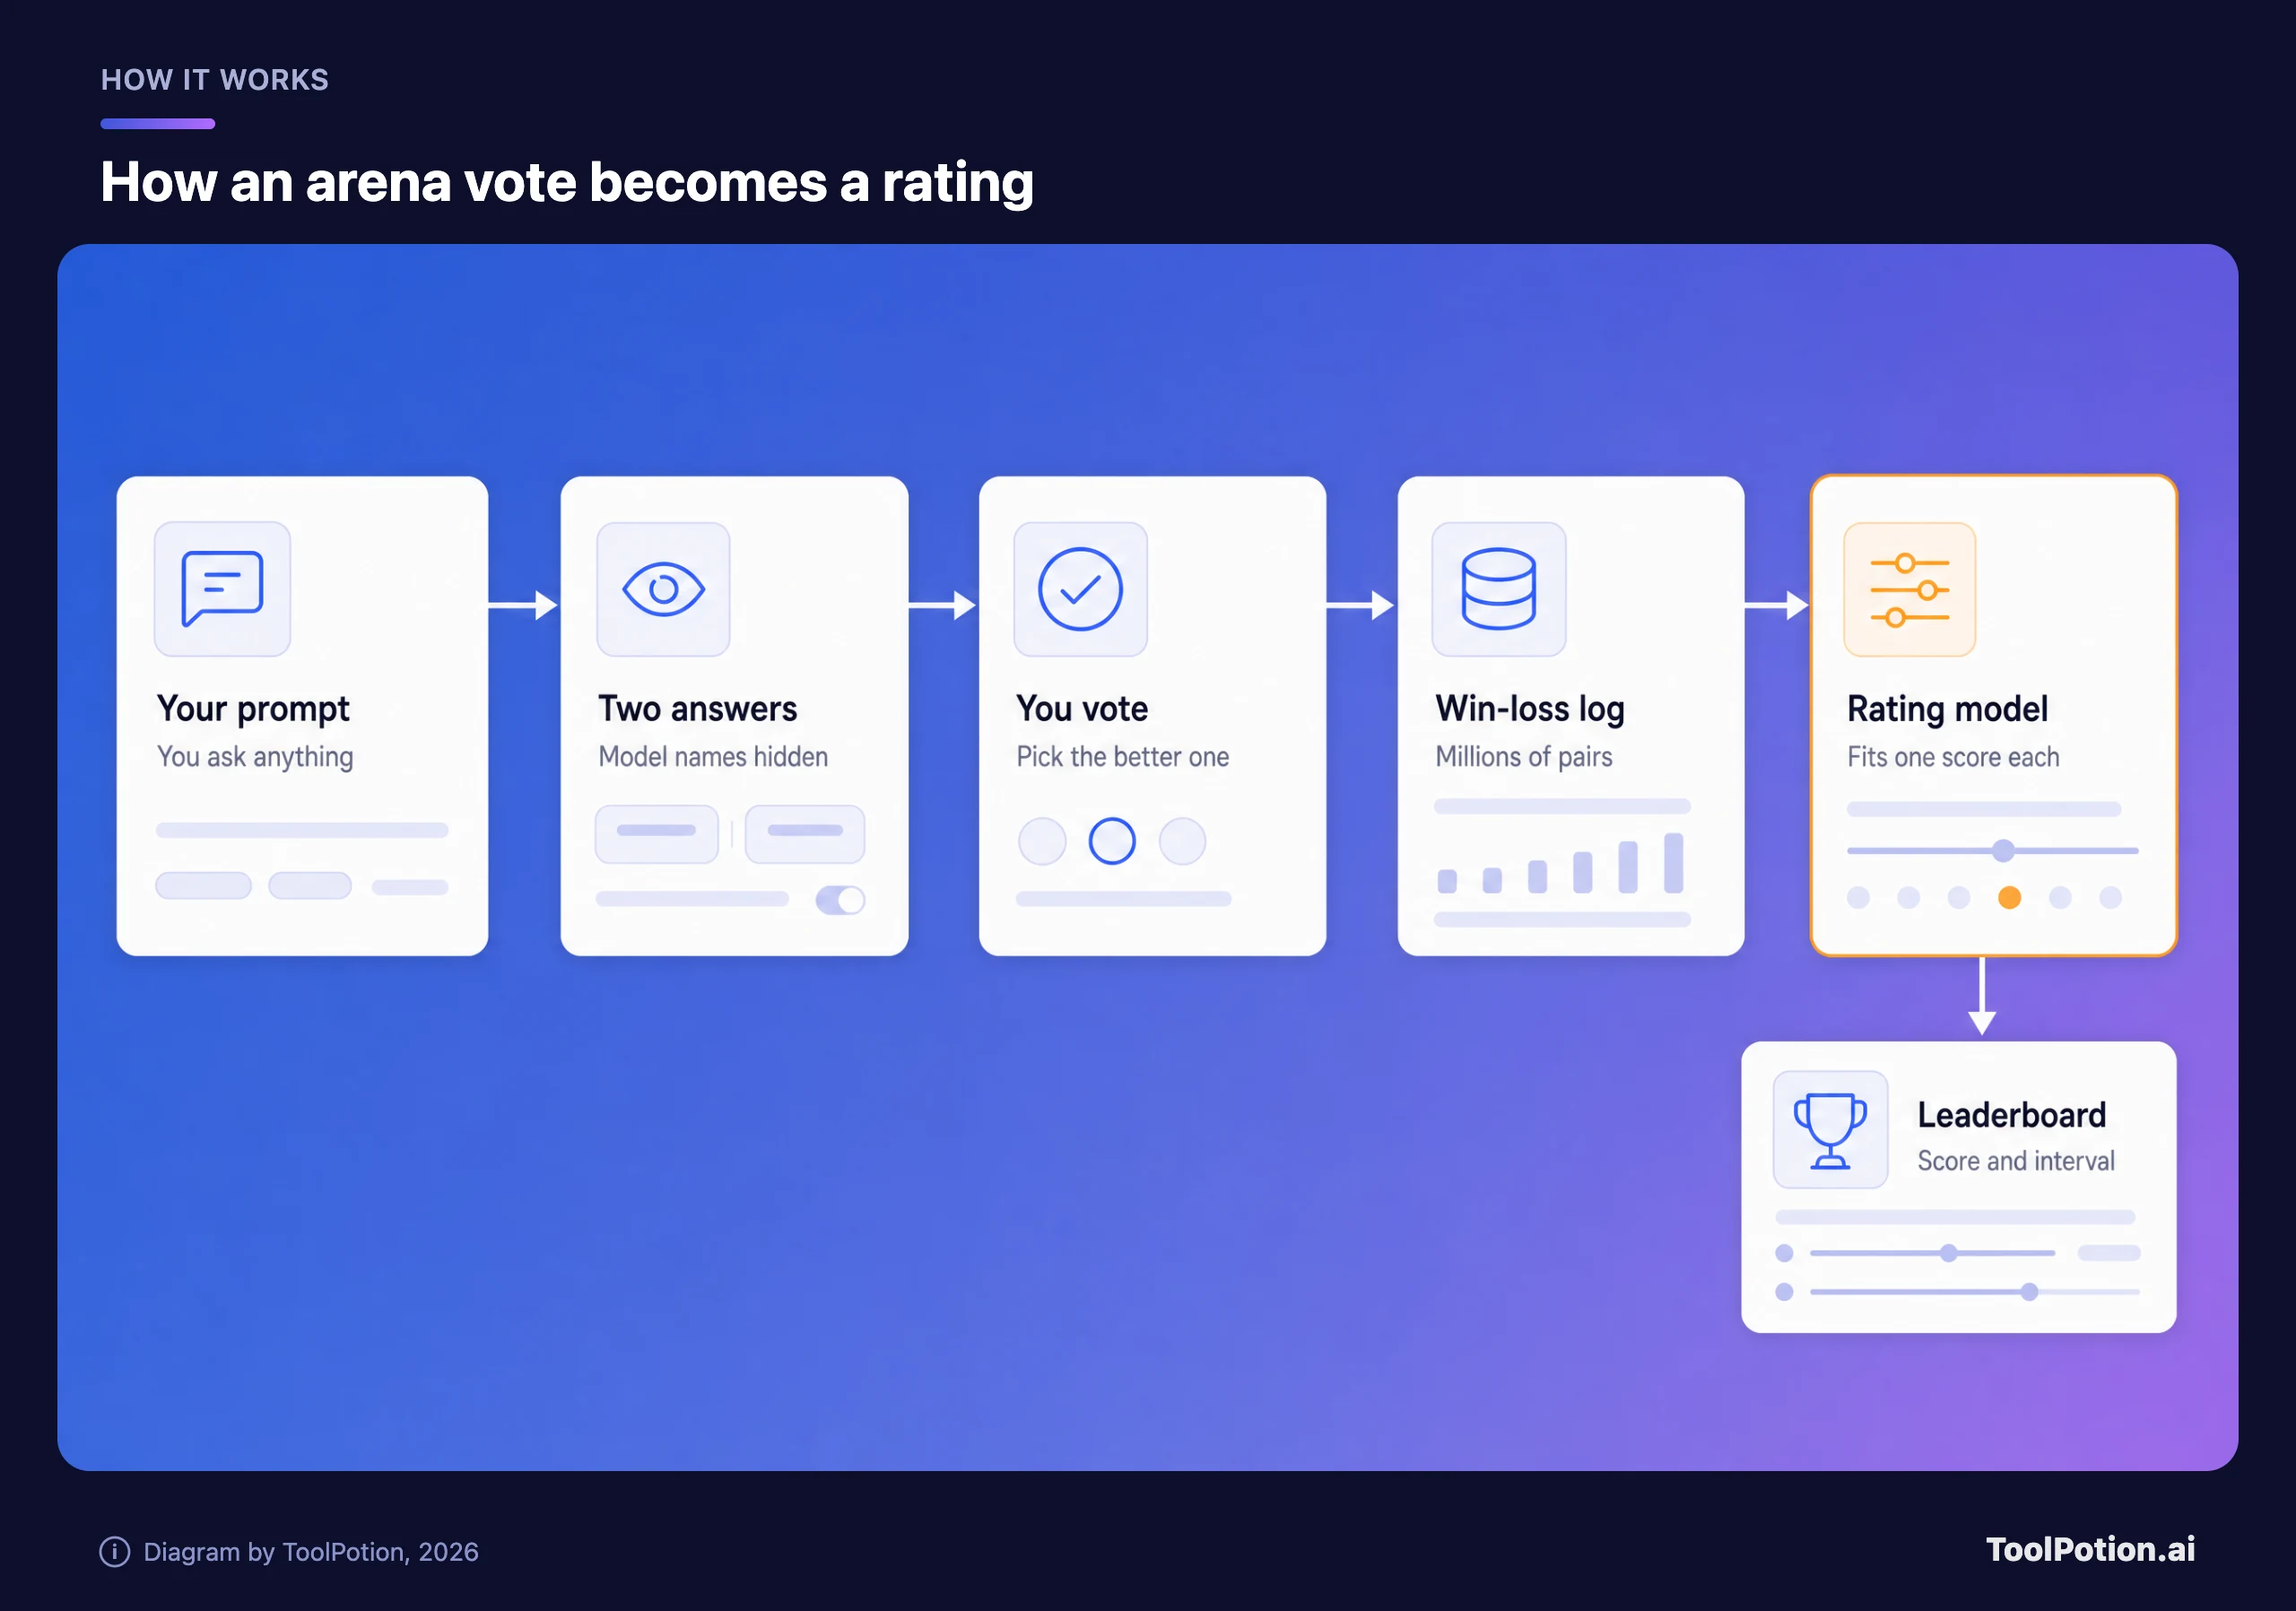
Cada voto es un registro minúsculo: el modelo A ganó al modelo B en este prompt. Millones de esos registros alimentan un modelo estadístico que asigna una única puntuación a cada modelo. Los propios textos de Arena describen el método como una regresión Bradley-Terry, un pariente cercano del sistema Elo del ajedrez (LMSYS). La puntuación de un modelo sube cuando vence a rivales fuertes y baja cuando pierde contra los débiles, y el ranking de texto muestra un intervalo junto a cada puntuación (una cifra con «±»), no solo la estimación puntual.
Ese intervalo es lo que los posts de lanzamiento se saltan. Si dos modelos están a pocos puntos y sus intervalos se solapan, la lectura honesta es un empate. Un «#1» basado en una diferencia de dos o tres puntos suele ser una moneda al aire estadística.
Arena también ha crecido mucho más allá del chat. Su ranking tiene ahora tablas separadas para texto, WebDev, visión, búsqueda, generación y edición de imágenes y vídeo, además de una tabla de agentes más reciente que muestra el coste por tarea junto al porcentaje de victorias (Arena). Vale la pena leer la columna de coste. Un modelo que queda un puesto por encima a un precio varias veces mayor es otra recomendación.
Lo que una arena no te puede decir
Votar por preferencia tiene tres problemas bien documentados. El primero es el estilo. A la gente le gustan las respuestas largas y bien formateadas, así que un modelo puede subir escribiendo más y añadiendo encabezados. El propio análisis del equipo de Arena concluyó que la longitud de la respuesta era el efecto de estilo dominante y que, al corregir por longitud y markdown, los modelos cambiaban de puesto. En ese análisis de 2024, GPT-4o-mini cayó del sexto al undécimo puesto mientras Claude 3.5 Sonnet subía del sexto al cuarto (LMSYS). Arena ofrece ahora vistas con control de estilo, y conviene usarlas.
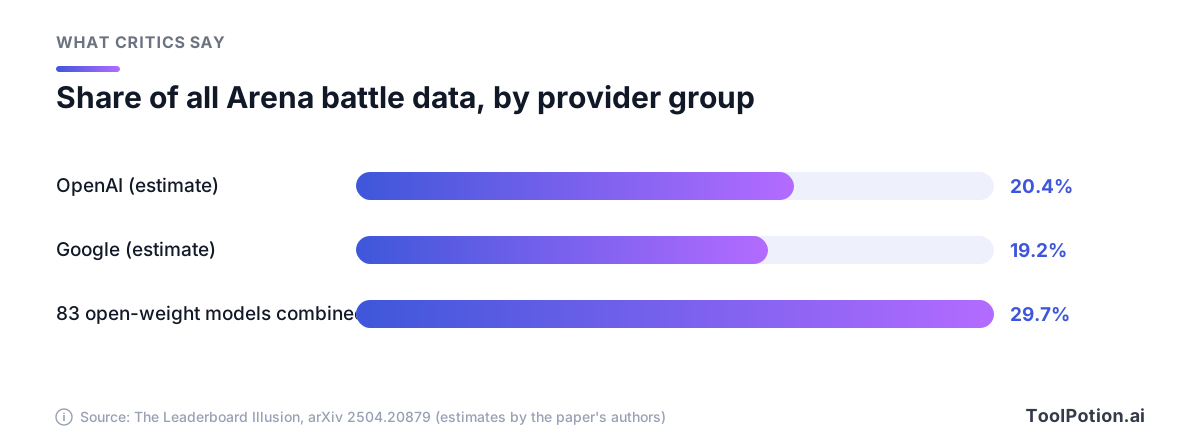
El segundo problema es el acceso. Un artículo de 2025 titulado «The Leaderboard Illusion», con autores como Sayash Kapoor y Noah Smith, sostenía que los grandes laboratorios obtenían ventajas estructurales en Arena. Según el artículo, Meta probó 27 variantes privadas de modelo antes del lanzamiento de Llama 4 y publicó solo la mejor puntuación, y estimaba que Google y OpenAI recibieron en torno al 19,2 % y el 20,4 % de todos los datos de Arena, mientras que 83 modelos de pesos abiertos juntos recibieron cerca del 29,7 % (arXiv).
El artículo también señalaba que entrenar con datos al estilo de Arena puede mejorar el rendimiento en la distribución de Arena hasta un 112 %, lo que incentiva ajustar el modelo para la tabla y no para la capacidad general. Son estimaciones y afirmaciones de los autores, y reflejan una instantánea del momento en que se escribió el artículo. Aun así, es la descripción externa más clara de cómo se puede manipular un ranking de preferencia sin que nadie rompa ninguna regla.
El tercer problema es que preferencia no es corrección. Una respuesta segura y amable puede ganar un voto y aun así contener un dato falso. Para el tono de la conversación y la escritura, la preferencia es una guía razonable. Para código que tiene que funcionar o una cifra que tiene que ser exacta, es una guía débil.
La página de políticas actual de Arena aborda parte de esto. Dice que los modelos previos al lanzamiento se prueban con nombres anónimos hasta que las puntuaciones se estabilizan (un mínimo de 1.000 votos), que esas puntuaciones se comparten en privado con el proveedor y que la puntuación de un modelo se marca como «preliminar» tras el lanzamiento público hasta que llegan votos nuevos. También dice que cada batalla incluye al menos un modelo disponible públicamente y que al menos el 20 % de las batallas enfrentan solo a modelos públicos (Arena). La regla práctica: una etiqueta «preliminar» significa que el número aún no está asentado.
Suites independientes: Artificial Analysis y Epoch AI
Si las tablas de preferencia preguntan qué le gusta a la gente, las suites independientes preguntan qué sabe hacer un modelo cuando todos reciben la misma prueba. Artificial Analysis es la más conocida. Su Intelligence Index, ahora en la versión 4.3.2, combina 10 evaluaciones en cuatro grupos: agentes (30 % del peso), conocimiento general y razonamiento (30 %), programación (20 %) y razonamiento científico (20 %). Cada modelo se ejecuta en las mismas condiciones con puntuación pass@1, es decir, un intento por pregunta, y el sitio afirma que mantiene sus propias copias de los conjuntos de datos. Para la evaluación subjetiva usa un panel de tres modelos de frontera de laboratorios distintos. El índice es sobre todo en inglés y texto, y el sitio mide por separado la capacidad multilingüe y multimodal (Artificial Analysis).
Los pesos son una decisión editorial. Otra ponderación, con menos peso en agentes y más en programación, reordenaría algunos modelos. No es un defecto, pero significa que el número «global» es una opinión sobre qué importa. Si lo que más te interesa es programar, lee los resultados de programación, no el titular.
Epoch AI mantiene un hub de benchmarks que combina pruebas que ejecuta él mismo, como GPQA Diamond, FrontierMath y SWE-bench Verified, con resultados de fuentes externas. Su hallazgo más útil para el lector tiene que ver con las cifras de los fabricantes. Claude 3.5 Sonnet se reportó con un 65 % en GPQA Diamond. Epoch midió un 55 %, con un margen de ±3, en 16 ejecuciones, y señaló que los laboratorios a menudo no publican el prompt ni la temperatura que usaron (Epoch AI). Una diferencia de 10 puntos solo por la configuración es una buena razón para preferir repeticiones hechas por un tercero. El hub está financiado por el UK AI Security Institute y sus datos se pueden reutilizar libremente.
Independiente no significa imparcial. Un tercero sigue eligiendo las pruebas, y cualquier índice que incluya jueces LLM hereda las manías de esos jueces. El propio estudio de Arena sobre jueces de IA encontró que los modelos favorecen sus propias respuestas. En 1.460 batallas de Text Arena juzgadas por 12 modelos, los jueces eligieron sus propias respuestas un 70 % más a menudo que los humanos (Arena).
Los benchmarks se desgastan
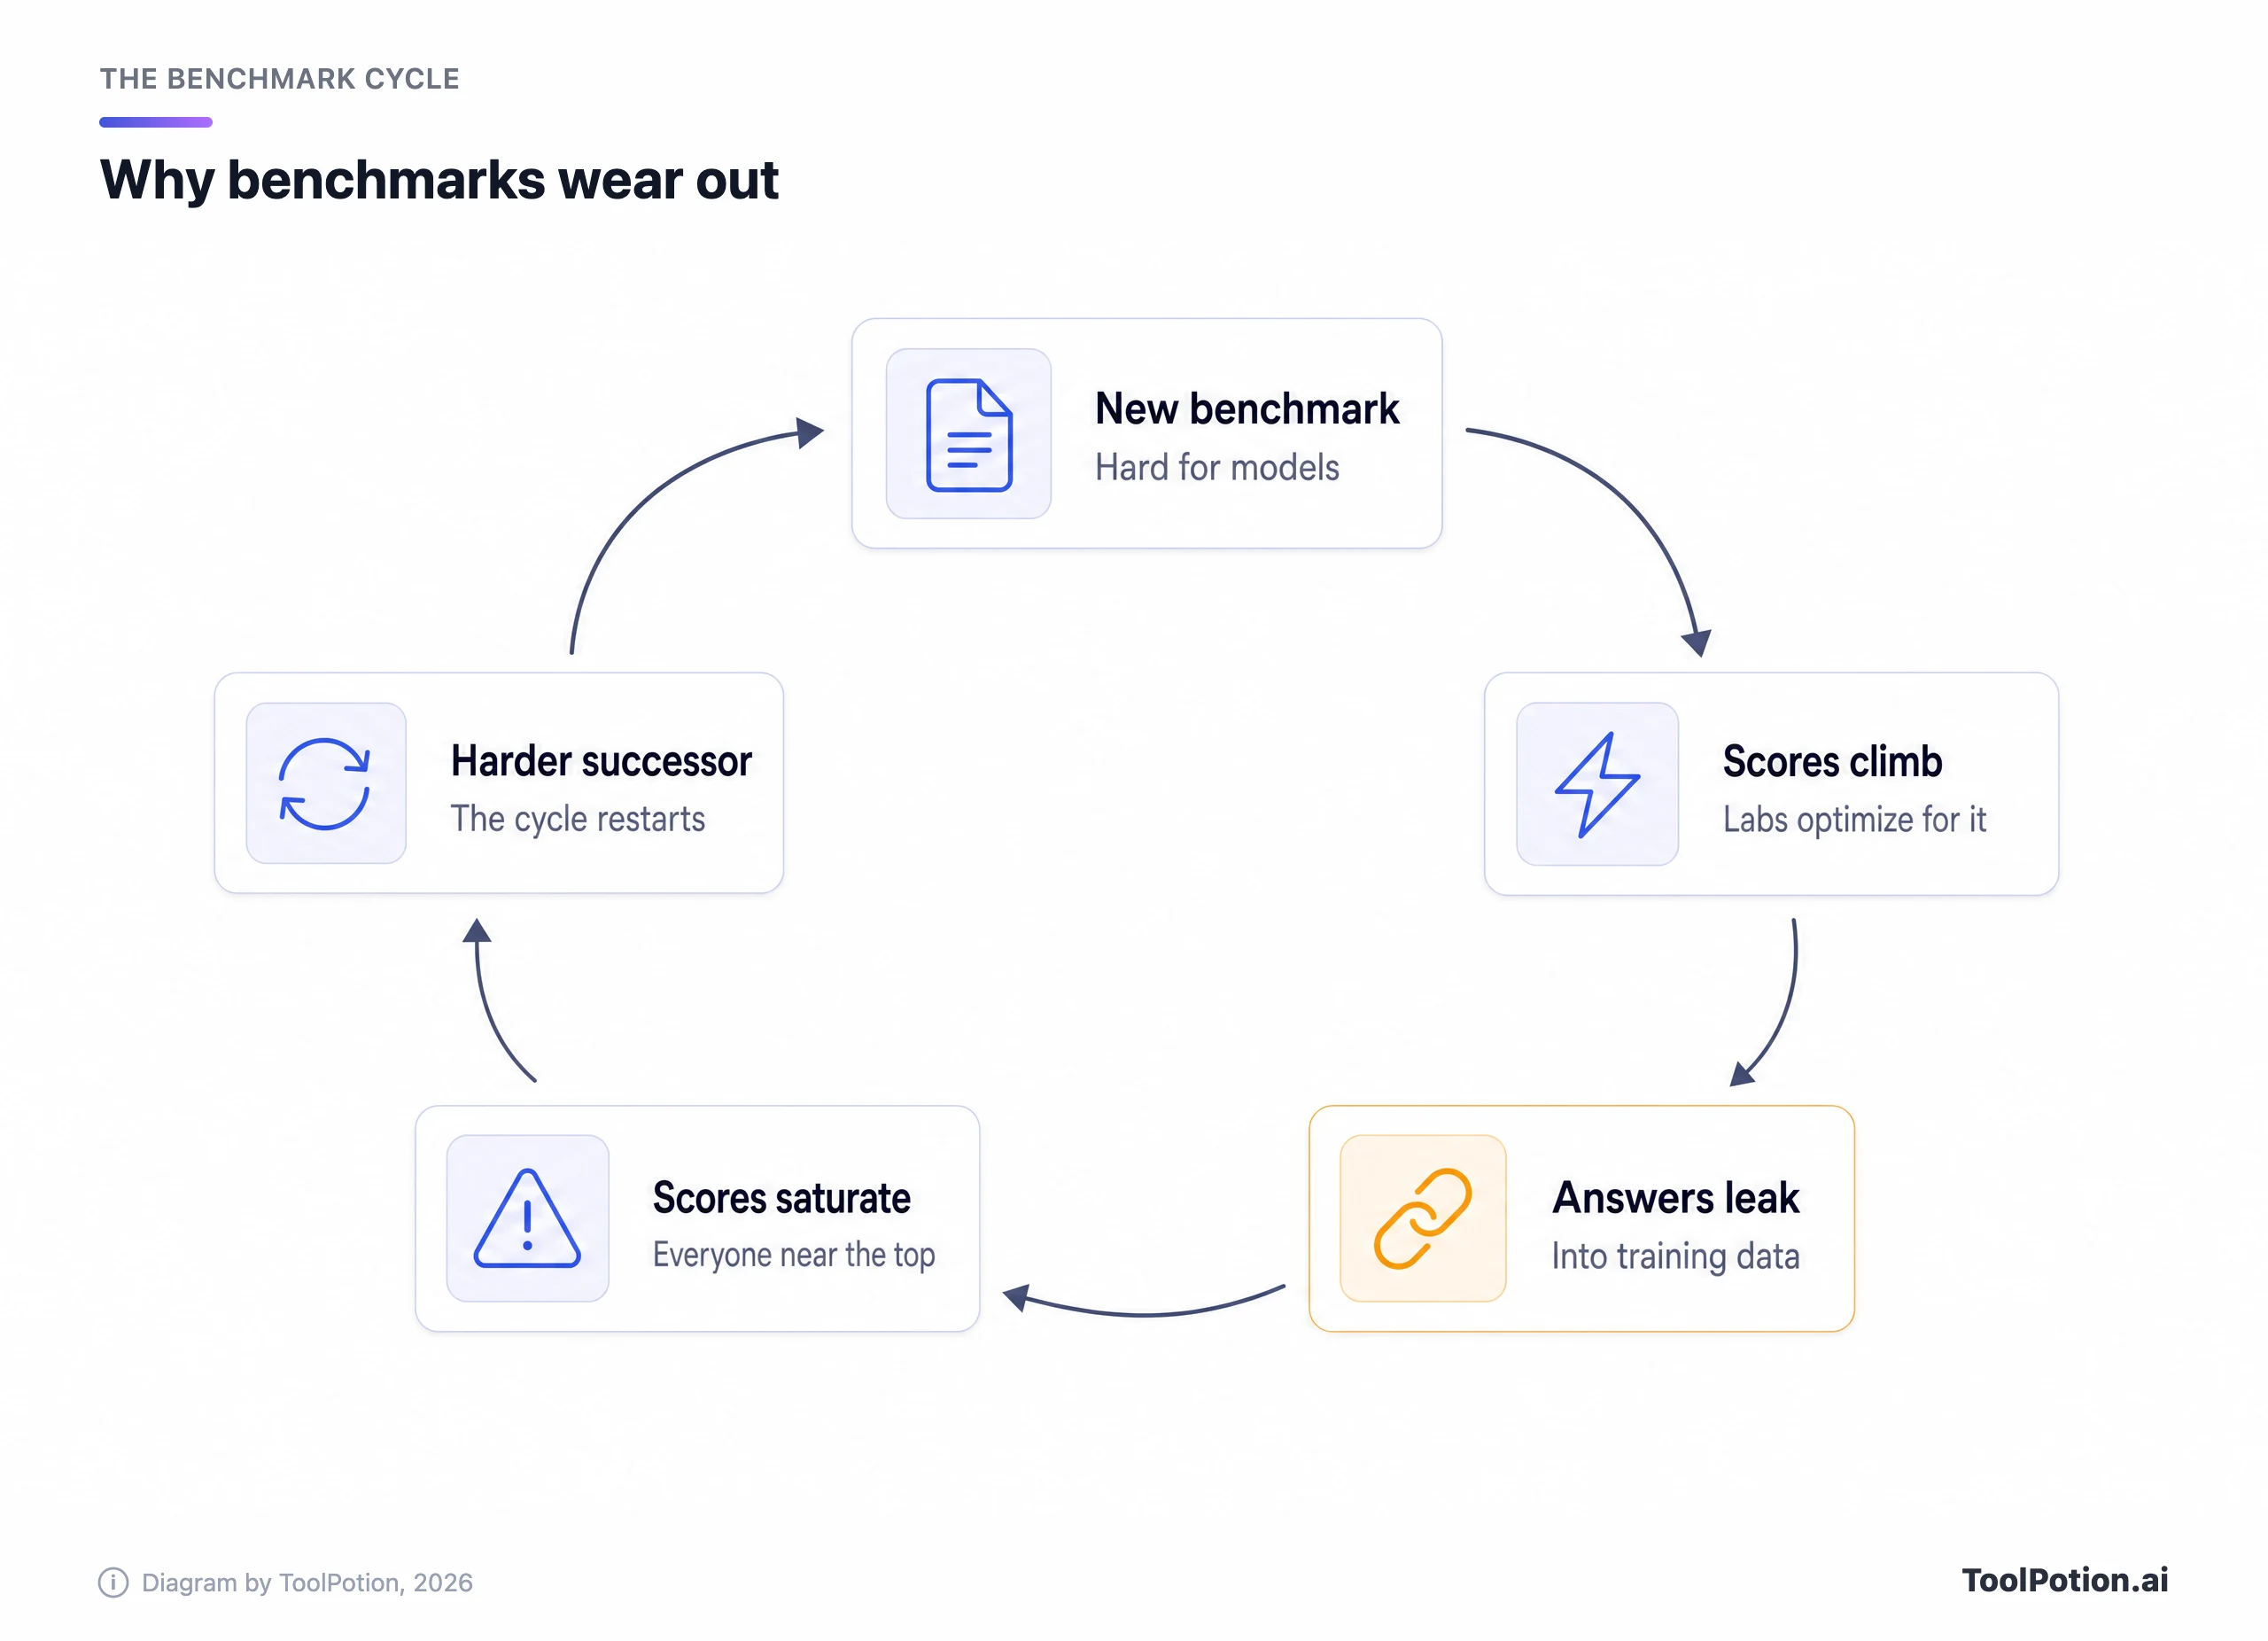
Los benchmarks de tareas tienen el problema contrario. Son objetivos, pero envejecen rápido. Un benchmark sale siendo difícil, los laboratorios optimizan para él, las puntuaciones suben, la prueba se filtra a los datos de entrenamiento y pronto todos los modelos top rondan el techo y el ranking deja de significar nada.
Humanity's Last Exam es un buen ejemplo de la respuesta a ese problema. Tiene 2.500 preguntas de más de cien materias, escritas por casi 1.000 expertos de más de 500 instituciones, y mantiene un conjunto de prueba privado para detectar el sobreajuste. Sus autores lo crearon porque pruebas más antiguas como MMLU habían sido llevadas por encima del 90 % por los modelos de frontera (arXiv). Se publicó en Nature en 2026, e incluso sus creadores esperaban que las puntuaciones subieran rápido.
SWE-bench muestra el ciclo completo. El benchmark original tenía 2.294 issues reales de GitHub de 12 proyectos de Python, y el mejor modelo de entonces, Claude 2, resolvió el 1,96 % (según el artículo original). Un subconjunto depurado de 500 tareas llamado Verified se convirtió en la cifra estándar en los lanzamientos de modelos de programación. Entonces llegó la auditoría.
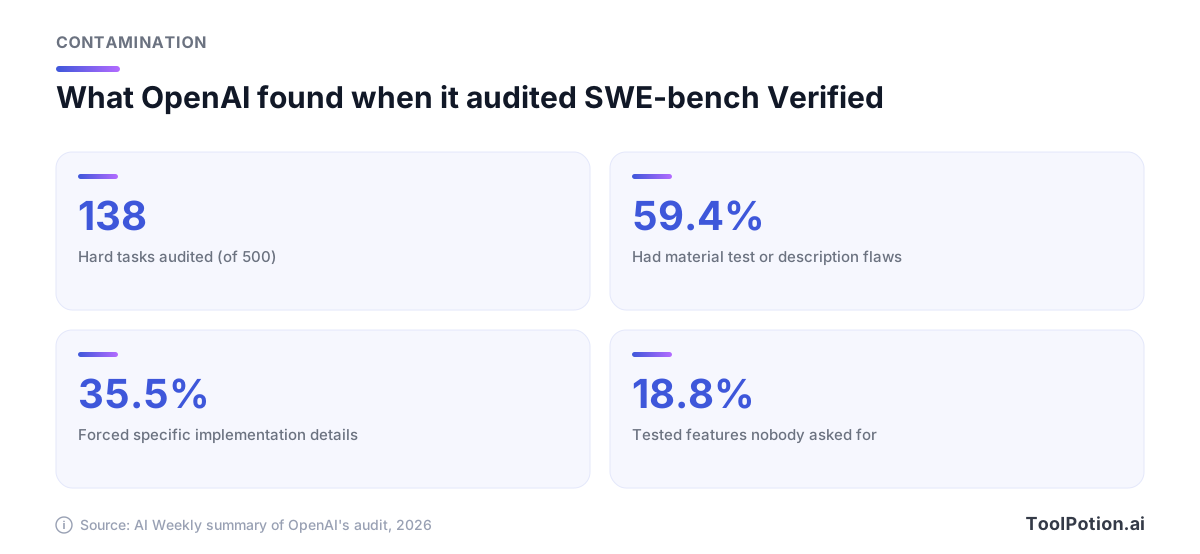
OpenAI auditó 138 problemas de Verified que su modelo o3 no resolvía de forma fiable, cada uno revisado por al menos seis ingenieros. Encontró que el 59,4 % tenía problemas importantes en sus pruebas o descripciones. En una prueba de contaminación aparte, GPT-5.2, Claude Opus 4.5 y Gemini 3 Flash Preview fueron capaces de reproducir detalles de las soluciones originales, señal de que las tareas se habían filtrado a los datos de entrenamiento. OpenAI dice que ha dejado de reportar puntuaciones de Verified y recomienda SWE-bench Pro (OpenAI). El resumen de AI Weekly añade que los mejores modelos rondaban el 80 % en Verified y unos 35 puntos menos en Pro, y que una auditoría externa posterior también puso en duda los evaluadores de Pro (AI Weekly).
La lección no es que los benchmarks de programación sean inútiles. Es que la puntuación de una prueba retirada o filtrada es un dato viejo. Cuando un post de lanzamiento cite SWE-bench, comprueba la variante y comprueba qué andamiaje de agente envolvía al modelo. El estudio «HarnessTax» de Arena, sobre 21 pares de modelo y andamiaje, encontró que la elección del andamiaje apenas afectaba al éxito de las tareas pero cambiaba el coste hasta 5 veces para resultados similares, con una muestra pequeña de 30 tareas por benchmark (Arena).
Una lista de control para cualquier «#1»
Esta es la versión de dos minutos. Repásala antes de creerte un ranking, y sobre todo antes de gastar dinero por culpa de uno.
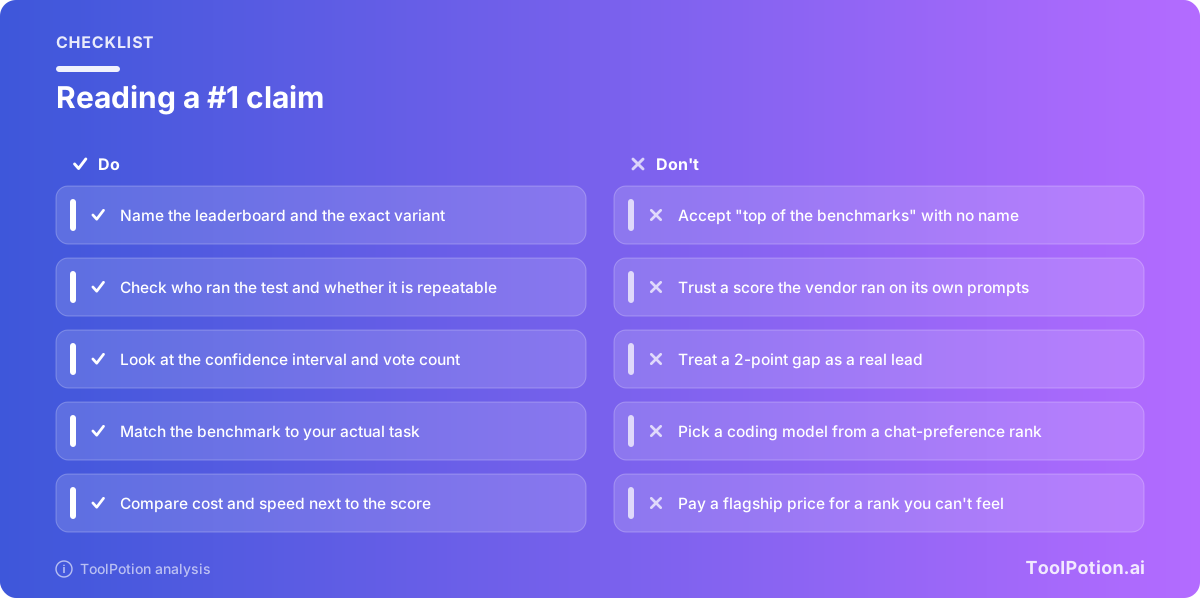
- Localiza la tabla y la versión exactas. «Lidera los benchmarks» no es una afirmación que puedas comprobar. «Primero en Arena texto con control de estilo» sí.
- Averigua quién la ejecutó. Una prueba del propio laboratorio con sus propios prompts es un número de marketing. Una repetición hecha por un tercero pesa más.
- Lee el intervalo y el número de votos. Si la ventaja es menor que el intervalo, es un empate.
- Comprueba si el modelo es público. Una puntuación de algo que hoy no puedes probar no te ayuda a elegir.
- Pregúntate si la prueba se parece a tu tarea. La preferencia en chat no predice cómo se las apañará un modelo con tus hojas de cálculo o tu código.
- Busca una segunda tabla, distinta, que coincida. Una tabla puede estar equivocada o manipulada. Que dos independientes coincidan es mucho más difícil de falsificar.
- Pon el precio y la velocidad junto a la puntuación. El modelo más barato que queda dos puestos por debajo suele ser la mejor compra.
Puedes puntuar tú mismo una afirmación con la lista de abajo. Está ponderada hacia lo más difícil de falsificar, como las pruebas de terceros y la coincidencia entre tablas.
Elige la tabla según tu pregunta
Como las tablas responden preguntas distintas, lo útil es partir de tu pregunta y elegir la tabla después. Si buscas un asistente para escribir y conversar, una arena de preferencia es un buen primer filtro. Si quieres una comparación repetible de capacidad bruta, usa una suite independiente. Si eliges una herramienta de programación, mira benchmarks de tareas basados en repositorios reales y luego prueba con tu propio código.
El árbol es un punto de partida, no un veredicto. Sea cual sea la tabla a la que llegues, una prueba corta con tu propio trabajo vale más que cualquier ranking público. Coge 10 tareas reales que haces cada semana, pásalas por dos o tres finalistas y compara los resultados lado a lado. Lleva una tarde y mide lo único que ningún ranking puede medir: tu trabajo.
Para comparar por categorías, el directorio de modelos de IA y LLM y el ranking de modelos de IA de ToolPotion listan los modelos lado a lado, y la guía para elegir el nivel de modelo de IA según la tarea explica cuándo merece la pena pagar por un modelo insignia. Para un repaso más amplio, mira Los 15 mejores modelos de IA y LLM en 2026, o alternativas a ChatGPT en 2026 si partes de un asistente concreto.
Dónde son menos fiables los números
Algunas situaciones piden una sospecha extra. Los modelos nuevos en sus primeros días tienen menos votos e intervalos más anchos, y Arena marca esas puntuaciones como preliminares por algo. Los modelos de pesos abiertos, los que puedes descargar de Hugging Face, son el otro punto ciego: los autores de Leaderboard Illusion estimaron que reciben una parte menor de los datos de Arena, así que sus puntuaciones pueden ser más ruidosas. Los modelos alojados también pueden cambiar de comportamiento bajo el mismo nombre, por lo que una puntuación de la semana de lanzamiento puede no describir el modelo que usas meses después.
El trabajo especializado es la mayor laguna. La redacción jurídica, la codificación médica, un idioma minoritario y el código interno de una empresa están mal cubiertos por las tablas públicas. Real-SWE Benchmark es una respuesta: evalúa modelos de frontera sobre bases de código empresariales privadas, que tienen menos probabilidades de haberse filtrado a los datos de entrenamiento que los repositorios públicos. Considera una tabla así una segunda opinión útil, no un sustituto de tu propia prueba.
Y si eres un usuario ocasional, quizá no necesites nada de esto. Para escribir y hacer preguntas del día a día, los mejores modelos de OpenAI, Anthropic y Google están lo bastante cerca como para que la elección dependa del precio, la interfaz y la costumbre. Dedicar una hora a los rankings para elegir entre casi empates es mal negocio.
Preguntas frecuentes
¿Arena es lo mismo que LMArena?
Sí. LMArena surgió del proyecto de investigación Chatbot Arena de UC Berkeley y ahora se llama Arena, en arena.ai. El nombre antiguo sigue apareciendo en artículos y en trabajos más antiguos.
¿Qué ranking es el más fiable?
Ninguno es fiable en todos los casos, y la respuesta depende de lo que quieras saber. Para la repetibilidad, lo más sólido es una suite de terceros que ejecuta ella misma todos los modelos. Para saber qué prefiere la gente, Arena tiene más datos. La evidencia más fiable es que dos tablas independientes coincidan, y después una prueba corta con tus propias tareas.
¿Qué es la contaminación de un benchmark?
Es cuando un modelo ha visto las preguntas o respuestas de una prueba durante el entrenamiento, de modo que una puntuación alta refleja memoria y no habilidad. La auditoría de OpenAI sobre SWE-bench Verified encontró que los modelos de frontera podían reproducir las soluciones originales de algunas tareas. Los conjuntos de prueba privados, como el que mantiene Humanity's Last Exam, son una defensa.
¿Los fabricantes hacen trampa en los rankings?
La evidencia respalda una afirmación más acotada. Los laboratorios eligen qué puntuaciones publicar, qué ajustes usar y, según el artículo de Leaderboard Illusion, qué variantes privadas revelar. Eso es reporte selectivo dentro de las reglas, no necesariamente romperlas. Es la razón por la que importan las repeticiones independientes.
¿Debo cambiar de modelo cada vez que uno nuevo llega al #1?
No. Una diferencia de puestos suele caer dentro del margen de error, y cambiar tiene costes reales en prompts, flujos de trabajo y pruebas. Cambia cuando un modelo supere al actual en tus propias tareas, o cuando iguale al actual con un precio claramente menor.