

"Si tu trabajo no se beneficia de las herramientas de IA actuales, eso es un hallazgo, no un fallo", dijo Amazon a sus ingenieros de software en un memo que publicó CNBC. Es una frase inusual en una empresa que vende IA a otras empresas, y es fácil resumirla en un titular: Amazon dice a sus ingenieros que usen menos IA.
El memo es más matizado que ese titular, y el debate que lo rodea importa más que el memo en sí. Los tokens ya son una partida en los presupuestos de ingeniería, y a los responsables de todas partes les piden que respondan lo que Amazon acaba de responder en público: ¿cómo sabes que ese gasto te está dando algo a cambio? A continuación te cuento qué dice el memo y qué omite, cuánto cuesta realmente un puesto en cuatro herramientas importantes y dónde un límite ayuda o perjudica.
El tokenmaxxing es un problema de ranking
CNBC define el tokenmaxxing como desarrolladores que usan la IA "al máximo y sin prestar atención al resultado". La palabra tiene una pequeña historia en Amazon. Según CNBC, la empresa cerró a principios de este año un ranking interno al descubrir que los empleados hacían tokenmaxxing para escalar posiciones. El artículo de I-Programmer, que se apoya en información del Financial Times, cuenta que el ranking se llamaba Kirorank, estuvo activo solo unas semanas y nunca fue oficial. La gente se inventaba tareas triviales para que los agentes de IA las ejecutaran, y Amazon pagaba los tokens.
Amazon no fue la única. El mismo artículo dice que Meta cerró a principios de este año un ranking creado por empleados donde el personal competía por títulos como Token Legend, según los tokens que quemaban en Claude Code. También recuerda un mensaje filtrado anteriormente de Dave Treadwell, vicepresidente sénior de Amazon, en el que pedía a la plantilla que dejara de "usar la IA solo por usarla".
Para que esto pasara no hizo falta que nadie fuera deshonesto. Pon un número en una pantalla, clasifica a la gente según ese número, y el número sube.
Qué dice el memo y qué no dice
Según CNBC, el memo circuló internamente antes de que Amazon lo publicara en su web. Revisa cómo describe Amazon el trabajo de los ingenieros de desarrollo de software y de sus responsables. Su conclusión central tiene que ver con la medición. El uso de tokens, el ritmo de adopción de herramientas de IA y el recuento de cambios de código o revisiones siguen siendo formas "profundamente defectuosas" de juzgar el uso de IA de un equipo, dice el memo, porque pueden disparar los costes y la complejidad.
No llega a prohibir los números. Hay que leerlos "con cuidado y criterio" junto con otros datos, y la vara de medir que prefiere el memo se dice sin rodeos: "Creemos que lo mejor es medir, y ser medidos, por los resultados a largo plazo".
Un portavoz de Amazon dijo a CNBC que la empresa no ha impuesto límites al uso de tokens. Eso importa, porque "usa menos IA" se pasa de lo que se ha publicado. Nada de la cobertura que leímos describe una cuota, un presupuesto por ingeniero o una cifra en dólares. Amazon no ha dicho cuánto gasta, y ninguna de las informaciones pudo decirlo.
Marc Brooker, vicepresidente e ingeniero distinguido de AWS, explicó la lógica a CNBC en dos partes. La empresa mira cosas como la velocidad de entrega de funcionalidades (cuántos lanzamientos, cuántos cambios exitosos en producción) y trata el gasto como una inversión. Lo que no quiere, dijo, es "esfuerzo desperdiciado" en problemas que no importan, y admitió que a veces es difícil saber cuáles son, así que se mantiene cierto margen para experimentar.
Leído así, el memo se parece más a una política de evaluación del desempeño que a una de recorte de costes. La frase que subrayaríamos es la que citamos al principio. Un ingeniero que sabe explicar dónde la IA todavía no ayuda está, en palabras del memo, "demostrando el criterio que pedimos". Es una empresa diciendo a sus responsables que no castiguen a quien apaga una herramienta.
Por qué se frenaría una empresa que vende IA
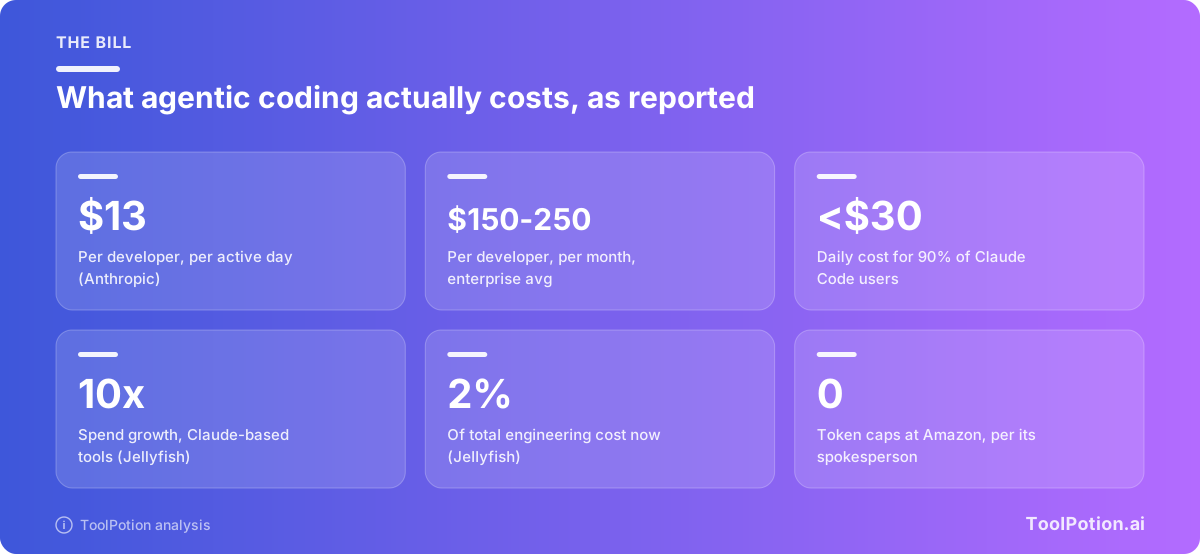
La respuesta sencilla es el coste, y las cifras crecen más rápido que los presupuestos. Jellyfish, que fabrica herramientas para equipos de ingeniería, publicó un informe sobre herramientas de programación con agentes que recogió TechCrunch. Entre los clientes de Jellyfish, el gasto en Claude Code y otras herramientas basadas en modelos de Anthropic se ha multiplicado por 10 desde principios de año, y ya equivale a cerca del 2 % del coste total de ingeniería. Un 2 % es poco, pero Nicholas Arcolano, científico jefe de Jellyfish, dijo a TechCrunch que "ese crecimiento de 10x es un crecimiento que la mayoría de los CFO no había previsto".
La documentación de Anthropic marca un suelo para la cifra individual. En los despliegues empresariales, el coste medio de Claude Code ronda los 13 $ por desarrollador y día activo, y entre 150 y 250 $ por desarrollador al mes, y el 90 % de los usuarios se queda por debajo de 30 $ al día (documentación de Claude Code). Es una media de los propios clientes del proveedor, así que considera tu propio piloto como el número real.
Otras dos razones son inferencia nuestra, y nada de lo publicado las menciona. Una métrica basada en cambios de código y revisiones puede enterrar a los revisores bajo un volumen de código que nadie pidió. Y un ingeniero que persigue una cifra de uso tiene pocos motivos para preguntarse si una tarea necesitaba un modelo. Ni la cobertura del memo ni lo publicado a su alrededor menciona la seguridad como motivo, así que no vamos a fingir que lo fue.
Las bajas voluntarias de Microsoft y un proveedor que vende el contador
El memo de Amazon llegó la misma semana que otras noticias sobre empresas que concilian la IA con las cuentas, y no son la misma historia. Microsoft ofreció bajas voluntarias a un grupo de unos 60.000 empleados elegibles, cerca del 27 % de su plantilla, mientras equilibra una costosa expansión de infraestructura de IA con la eficiencia del capital. CNBC lo vincula con la infraestructura y el flujo de caja, no con el uso de tokens de nadie. El mismo artículo sí dice que Microsoft intenta cobrar a los clientes según cuánta IA usan realmente, que es el contador dado la vuelta.
Luego está la empresa que más tiene que ganar si gastas más. Anthropic lanzó herramientas de informes que permiten a un responsable ver qué produjo un equipo en un rango de fechas, cuánto costó y dónde fallaron los flujos de trabajo, además de presupuestos de grupo compartidos para que los equipos gestionen el gasto en tokens. TechCrunch lo describe como un intento claro de demostrar el retorno de la inversión. Pienses lo que pienses del motivo, el producto muestra qué piden ahora los compradores: un coste por resultado en lugar de un coste por puesto.
Averigua cuánto cuesta de verdad un puesto
Empieza con un grupo piloto y una línea base, y hazlo antes de que nadie escriba un límite. Todos los proveedores se han movido hacia el uso medido, así que el precio de lista de un puesto dice cada año menos. Esto es lo que mide cada herramienta importante, según las páginas de los propios proveedores.
| Herramienta | Qué se mide | Dónde se limita |
|---|---|---|
| GitHub Copilot | Tokens, convertidos en créditos de IA a 0,01 $ cada uno. Business reúne 1.900 créditos por usuario al mes; Enterprise, 3.900 | Presupuestos en dólares por usuario, centro de costes y organización |
| Cursor (Teams) | Bolsa semanal por puesto de pago para los modelos propios de Cursor. Los modelos de terceros se facturan de un saldo prepagado compartido | Límite mensual del equipo, más límites predeterminados y por miembro |
| Claude Code | Tokens de API. Teams y Enterprise consumen de las asignaciones del puesto | Límites de gasto en los ajustes de administración, o límites del workspace en Console |
| Codex (ChatGPT) | Asignación compartida con ChatGPT Work, luego créditos | Créditos que compras y el panel de uso para vigilar el ritmo |
Algunos detalles que encontramos en la documentación y que una página de precios no te cuenta. La política de uso de pago de Copilot viene activada por defecto en Business y Enterprise, así que el gasto que supere los créditos compartidos continúa a menos que un administrador lo desactive explícitamente (documentación de GitHub). Los autocompletados en línea siguen siendo ilimitados incluso con un presupuesto de 0 $. La revisión de código de Copilot se cobra según el nivel de esfuerzo: GitHub estima entre 0,05 y 1 $ para Lite y entre 1,50 y 25 $ para Max, unos 10 $ de media, con los minutos de Actions aparte (modelos y precios de GitHub). Son estimaciones, y la documentación dice que el tamaño de la pull request las mueve.
Si estás comparando los propios editores, Cursor vs GitHub Copilot vs Windsurf lo cubre. El plan Teams de Cursor vende puestos Premium, Super y Ultra a 30, 100 y 200 $ al mes, cada uno con su propia bolsa semanal para los modelos propios de Cursor que no se transfiere entre compañeros. Los modelos de terceros, Claude incluido, no entran en la bolsa: se facturan de un saldo prepagado compartido al precio de lista de la API más una tarifa de Cursor de 0,25 $ por millón de tokens (documentación de Cursor). El plan Enterprise de Claude cuesta 20 $ por puesto al mes más el uso facturado a tarifas de API (precios de Claude). La página de precios de Codex te dice claramente que los precios de tokens de la API son independientes del uso de la suscripción y que no deben usarse para estimar las tareas incluidas.
Deriva el trabajo rutinario a un modelo más barato
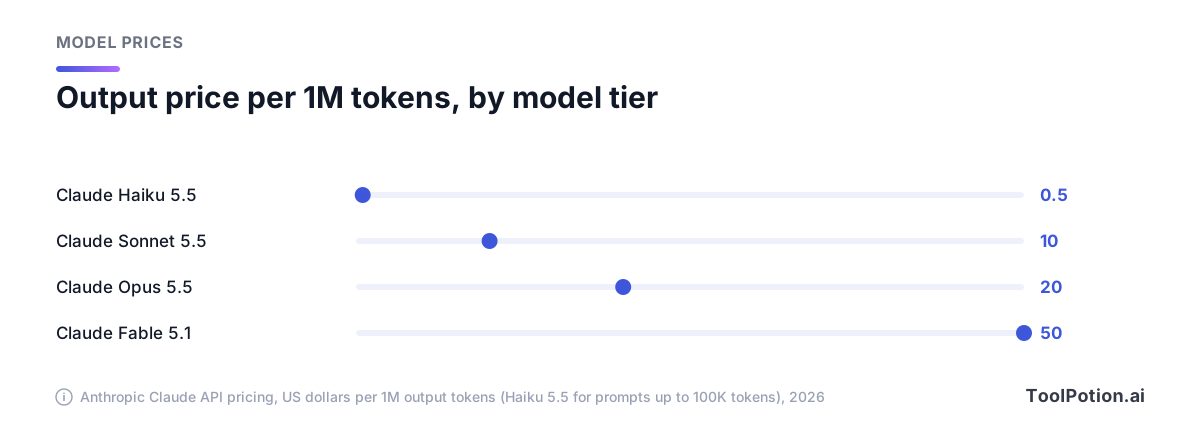
La mayor palanca en la documentación no es un límite. Es el modelo. En la lista de precios de la API de Anthropic, Claude Haiku 5.5 cobra 0,50 $ por millón de tokens de salida para prompts de hasta 100.000 tokens (sube a 2,50 $ por encima de eso), Sonnet 5.5 10 $, Opus 5.5 20 $ y Fable 5.1 50 $. Es una diferencia de 100x entre lo más barato y lo más caro de una misma gama, y las tablas de GitHub y Cursor muestran los mismos precios de salida.
La guía de costes de Anthropic coincide con la aritmética. Sonnet "gestiona bien la mayoría de las tareas de programación y cuesta menos que Opus", dice, reservando Opus para decisiones de arquitectura o razonamiento de varios pasos, y model: haiku para tareas sencillas de subagentes (documentación de Claude Code). Nuestra opinión más extensa sobre cómo asignar niveles a tareas está en qué nivel de modelo de IA para qué tarea, y los agentes de terminal se comparan en Claude Code vs Codex vs Gemini CLI.
Este es el ahorro a precios de lista, con la proporción de trabajo que puede asumir un modelo pequeño como estimación tuya. Los precios son los de lista de Anthropic para prompts cortos.
Los tokens de salida son solo una parte de la factura, y la proporción del modelo pequeño es una suposición que tendrás que ganarte con tus propias tareas. Renombrar variables y escribir andamiaje de tests probablemente cuenten. Un plan de migración para un servicio de pagos, probablemente no.
Límites, en el orden en que los fijaríamos
- Activa los informes de uso para un grupo piloto y analiza dos semanas antes de elegir ninguna cifra.
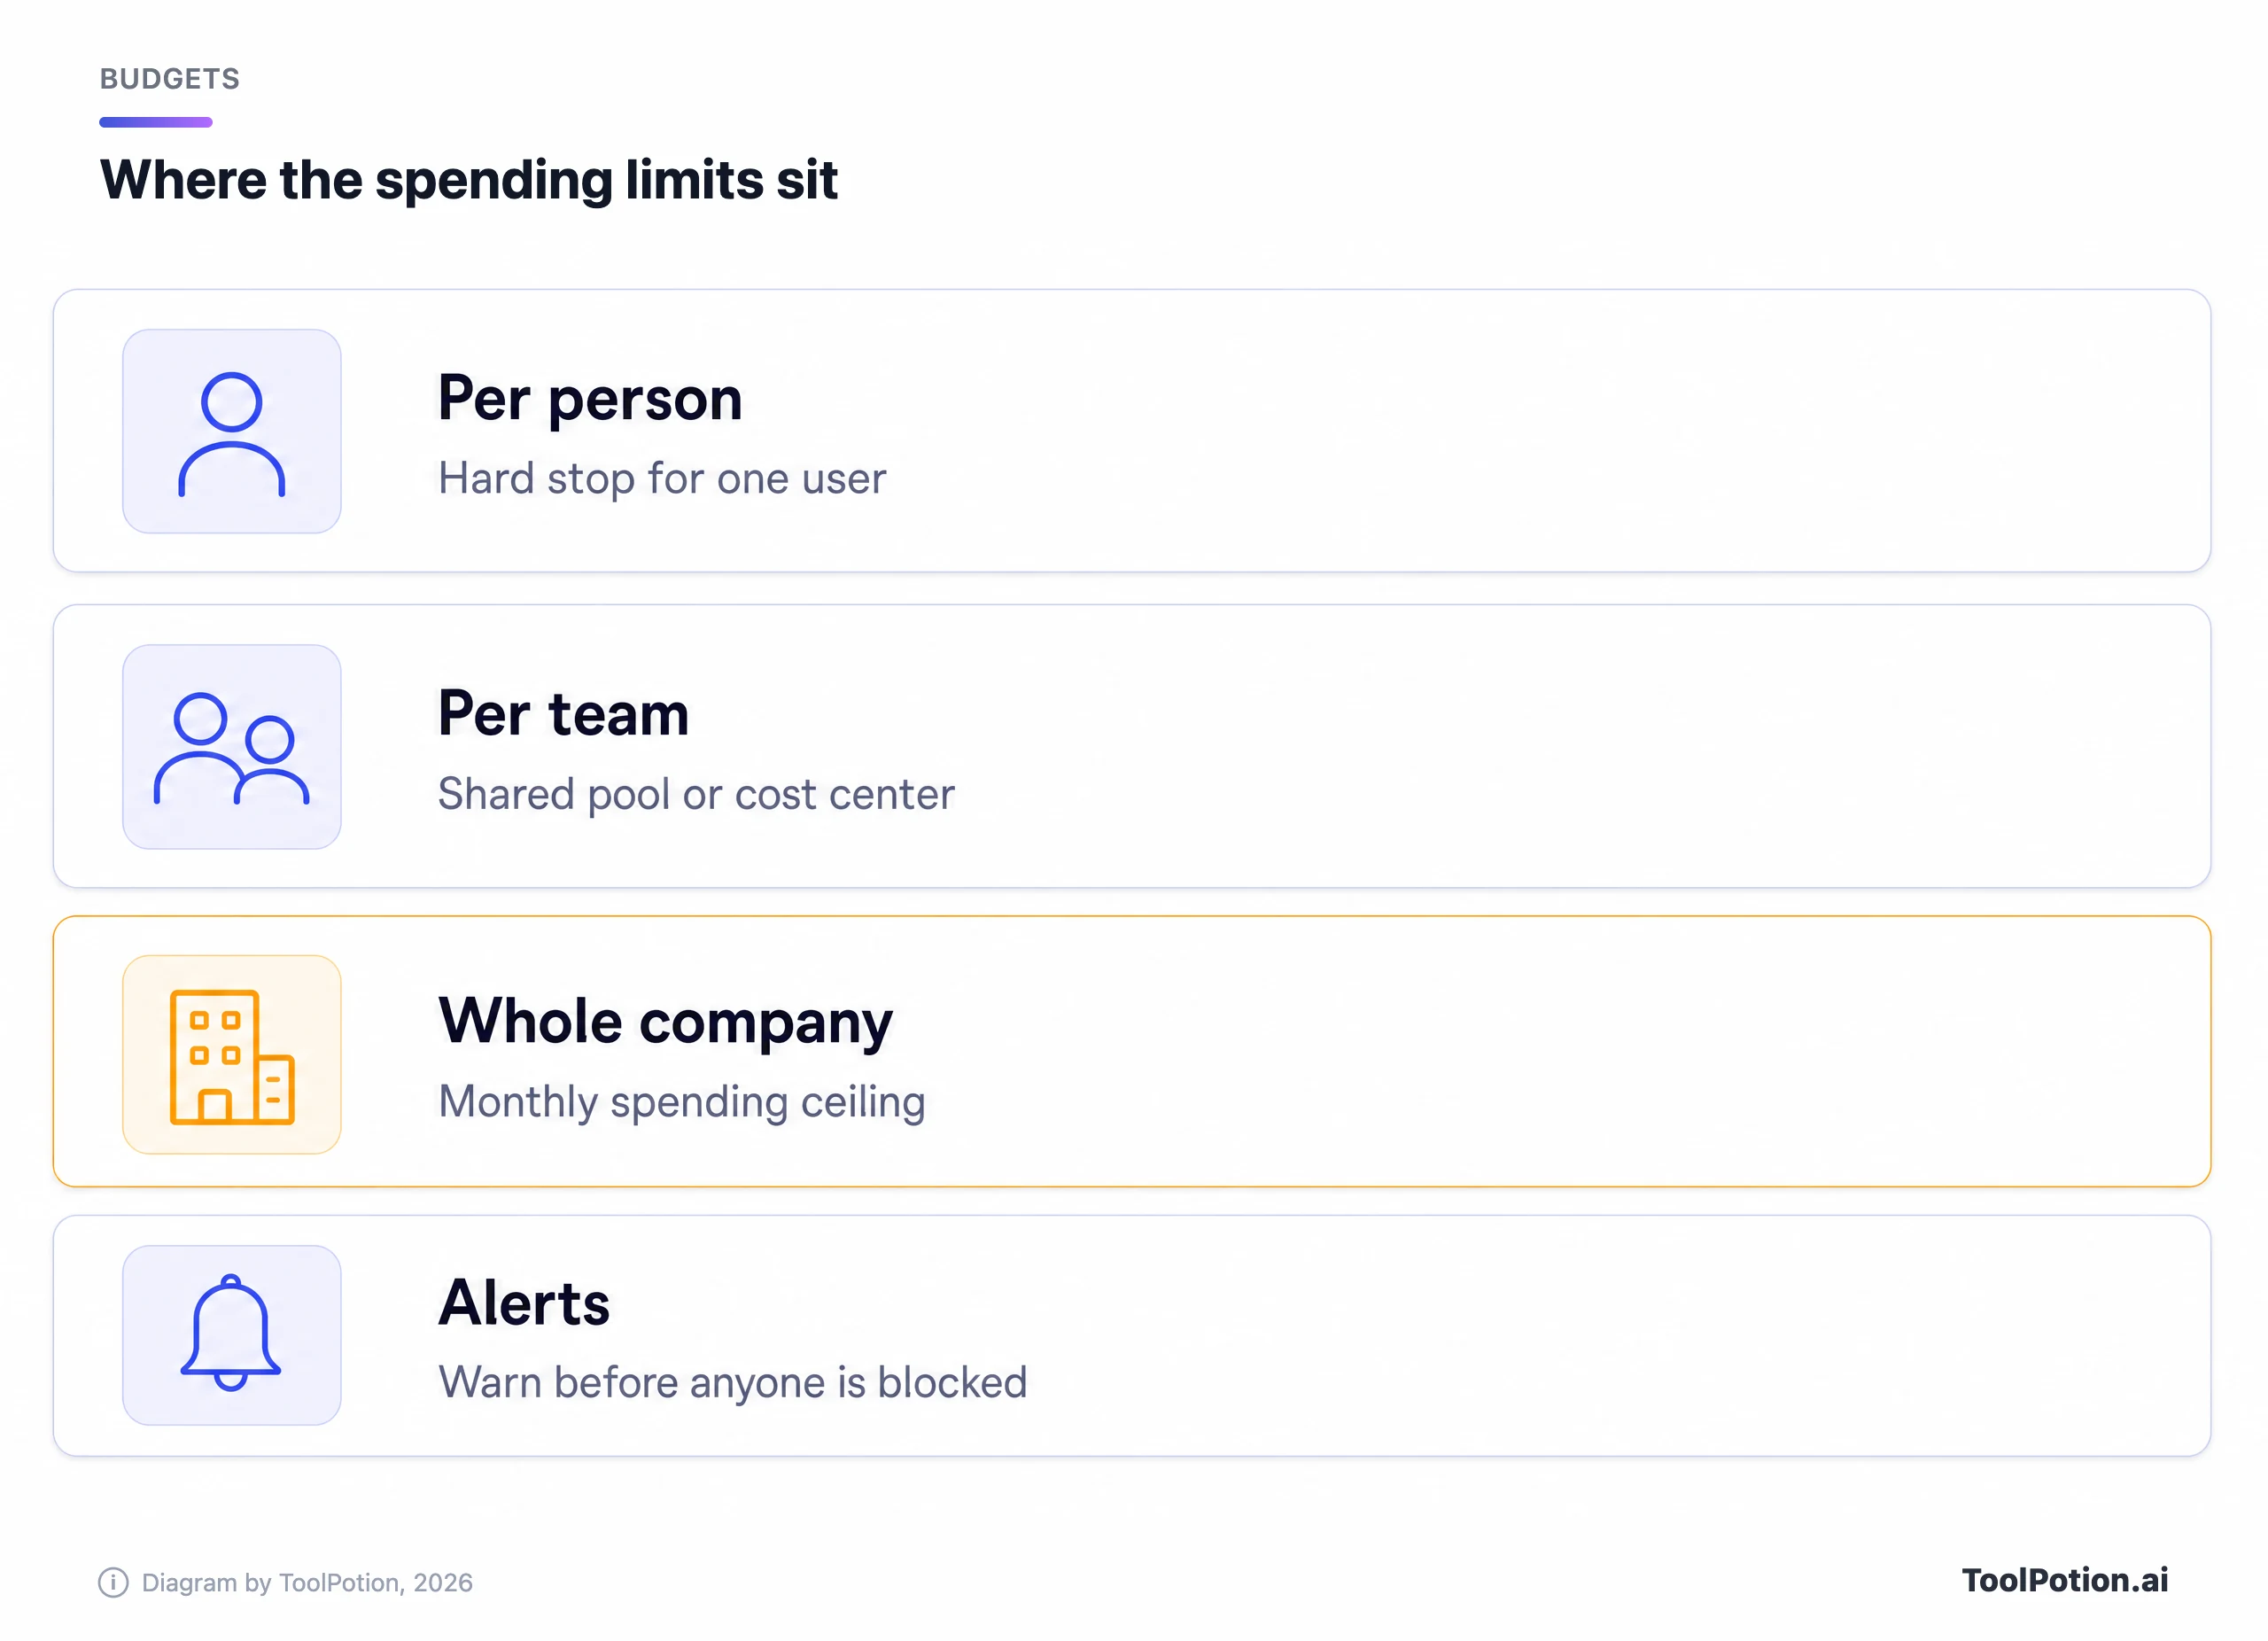
- Configura primero las alertas. GitHub puede enviar un correo y mostrar un aviso al 75 %, 90 % y 100 % de un presupuesto (documentación de GitHub).
- Añade un techo mensual para toda la empresa que podrías asumir si todos los puestos llegaran al máximo, de modo que un bucle descontrolado de un agente cueste una cantidad conocida.
- Solo entonces añade límites por equipo o persona, y hazlos flexibles donde la herramienta lo permita. El presupuesto a nivel de usuario de GitHub siempre corta en seco, y su documentación advierte de que presupuestos superpuestos pueden bloquear a la gente una herramienta de la que depende.
- Baja un nivel los modelos predeterminados para el trabajo rutinario y haz que el modelo premium sea una elección deliberada.
La documentación de Claude Code también da puntos de partida de límites de tasa por usuario según el tamaño del equipo, por ejemplo de 15.000 a 20.000 tokens por minuto por usuario para entre 100 y 500 usuarios. Son limitadores de ritmo, no presupuestos, y la documentación los presenta como recomendaciones que hay que ajustar.
Cuándo racionar es inteligente y cuándo es falsa economía
Racionaríamos el desperdicio y nunca los intentos. Un límite que hace pensárselo dos veces a un desarrollador antes de pegar un repositorio entero en el mejor modelo está haciendo su trabajo. Un límite que hace que ese mismo desarrollador se salte la ejecución de tests generados con IA, o evite el agente en el refactor difícil donde más rinde, cuesta más de lo que ahorra.
Haz las cuentas. Si las herramientas con agentes equivalen a un 2 % del coste de ingeniería, como dice Jellyfish, recortar la factura a la mitad ahorra un 1 % del coste de ingeniería. Un ingeniero ralentizado un 1 % lo devuelve. Racionar solo compensa cuando elimina gasto que no produjo nada, que es justo el argumento de Amazon sobre el esfuerzo desperdiciado.
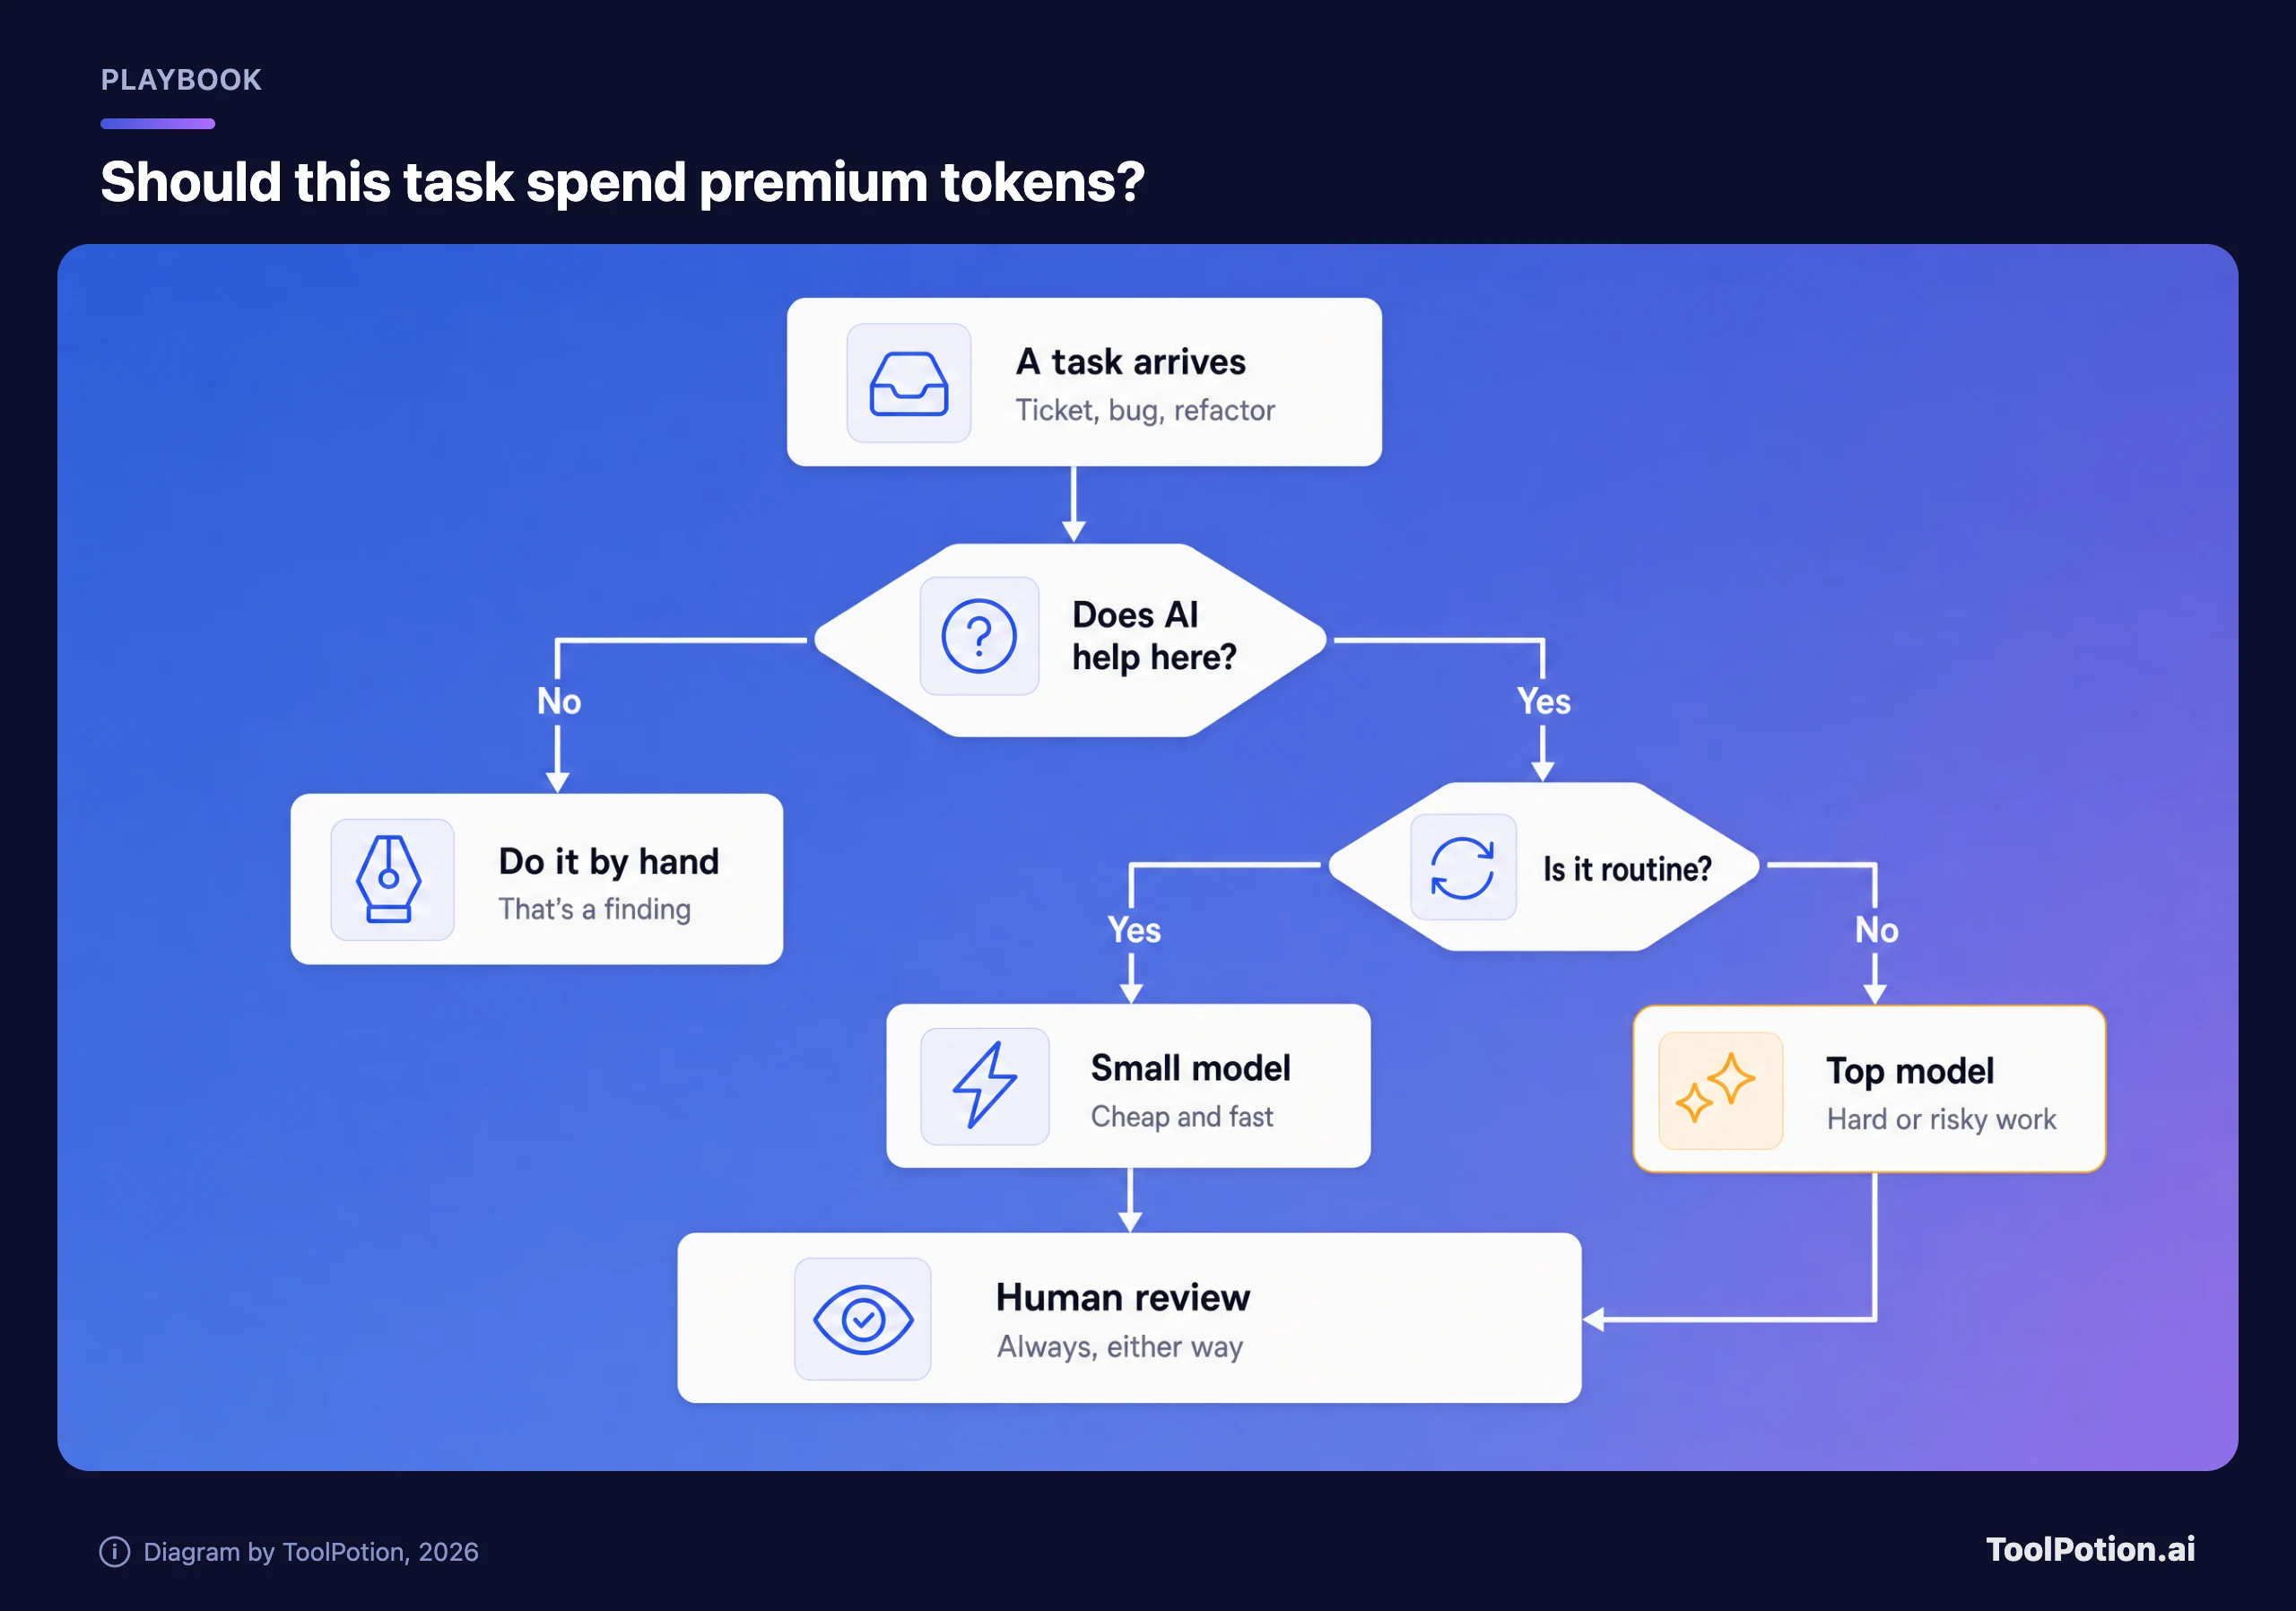
Racionar es inteligente para la automatización en segundo plano que nadie lee, para el mejor modelo en trabajos rutinarios y para los rankings por persona. Es falsa economía en la revisión de código, los tests y el onboarding. Si el paso de revisión con IA es lo que detecta el merge malo, limitarlo es apostar contra tu propia red de seguridad, y nuestra guía de herramientas de revisión de código con IA y el ranking ToolRank de revisión y testing muestran cuántas alternativas hay antes de recortar nada.
Lo que no recortaríamos
La revisión humana se queda, sea cual sea el modelo que escribió el código. El memo de Amazon advierte contra medir el número de revisiones, pero no sugiere saltárselas. La formación también se queda, porque quien sabe cuándo recurrir al modelo barato es quien ha aprendido para qué sirve cada uno. Y la experimentación se queda, porque el propio Brooker admite que nadie puede saber de antemano qué problemas importan.
Sí conviene medir los resultados como lo hace el memo: lanzamientos, cambios exitosos en producción, tiempo desde la petición hasta el merge. Los tokens en bruto van en la columna de costes, y lejos de cualquier evaluación de desempeño. Si aún no has dejado por escrito qué puede y qué no puede darles de comer tu equipo a estas herramientas, nuestra plantilla de política de uso de IA es un punto de partida, y la explicación de modelos de precios y la auditoría de stack cubren la parte de las suscripciones.
Tras leer las páginas de precios de GitHub Copilot, Cursor, Claude Code y Codex, nos quedamos con una regla: el precio del puesto es solo la entrada. Saca el uso por persona de un mes reciente en la herramienta que uses, ordénalo y mira las cinco primeras filas. Si son tus mejores ingenieros, déjalos en paz. Si es un único script en un bucle, ya has encontrado tu límite.