

8 دولارات و40 دولارًا. هذا هو سعر Claude Fable 5.2 لكل مليون token من المدخلات والمخرجات على الترتيب، بعد أن كان 10 و50 دولارًا لـ Fable 5.1، وهو أقل بنسبة 20% بالضبط من سعر القائمة لـ GPT-6 Astra (Fortune). تحققنا من ذلك في صفحات الشركتين نفسيهما، والرقم صحيح: تعلن Anthropic عن 8 و40 دولارًا (وثائق Anthropic)، وتعلن OpenAI عن سعر GPT-6 Astra بـ 10 و50 دولارًا (OpenAI).
هذا هو العنوان الرئيسي، وهو عنوان جيد. لكن ما نراه أحق بالانتباه يرد أدنى في مقالة بمركز المساعدة: يحتفظ Fable بمدخلاتك ومخرجاتك 30 يومًا على الأقل، أما خيار عدم الاحتفاظ بالبيانات (ZDR) فغير متاح أصلًا لمعظم العملاء. أطلقت Anthropic نموذجين في اليوم نفسه: Fable 5.2 لكل الخطط المدفوعة، وMythos 5.2 لفرق الأمن والأحياء التي خضعت للتدقيق. سنفكك هنا كليهما: ما الذي تغيّر، وأين يعمل كل منهما، وكم يكلّف مقارنةً بـ Astra وGemini 4 Carbon، وإلى أي حد يمكن الوثوق بجدول المقاييس، وأي نموذج نستخدمه لأي مهمة.
نموذج واحد باسمين
تقول Anthropic إن النموذجين هما النموذج الأساسي نفسه (Anthropic). يأتي Fable مع مصنِّفات تحجب الأعمال السيبرانية عالية الخطورة، مثل اختبار الاختراق وتوليد الثغرات، إضافةً إلى معظم أبحاث الأحياء. أما Mythos فهو النسخة بلا هذه القيود، ويُمنح للمؤسسات التي تتقدم عبر برنامج التحقق السيبراني (Cyber Verification Program) أو برنامج التحقق لعلوم الحياة (Life Sciences Verification Program) لدى Anthropic.
لا ينتهي طلب Fable المحجوب بخطأ. يجيب Claude عندئذٍ بنموذج Opus 4.8 في موضوعات الأمن السيبراني وOpus 5 في موضوعات الأحياء، بحسب إعلان Anthropic (Anthropic). هذا التحويل موثّق (بل إن مركز المساعدة يعرض مقالة بعنوان "Why Claude switched models in your conversation with Fable models" بحسب صفحة Covered Models)، لكن من الأفضل أن تعرفه قبل أن تبدو الإجابة مختلفة على نحو غريب فتبحث عن السبب.
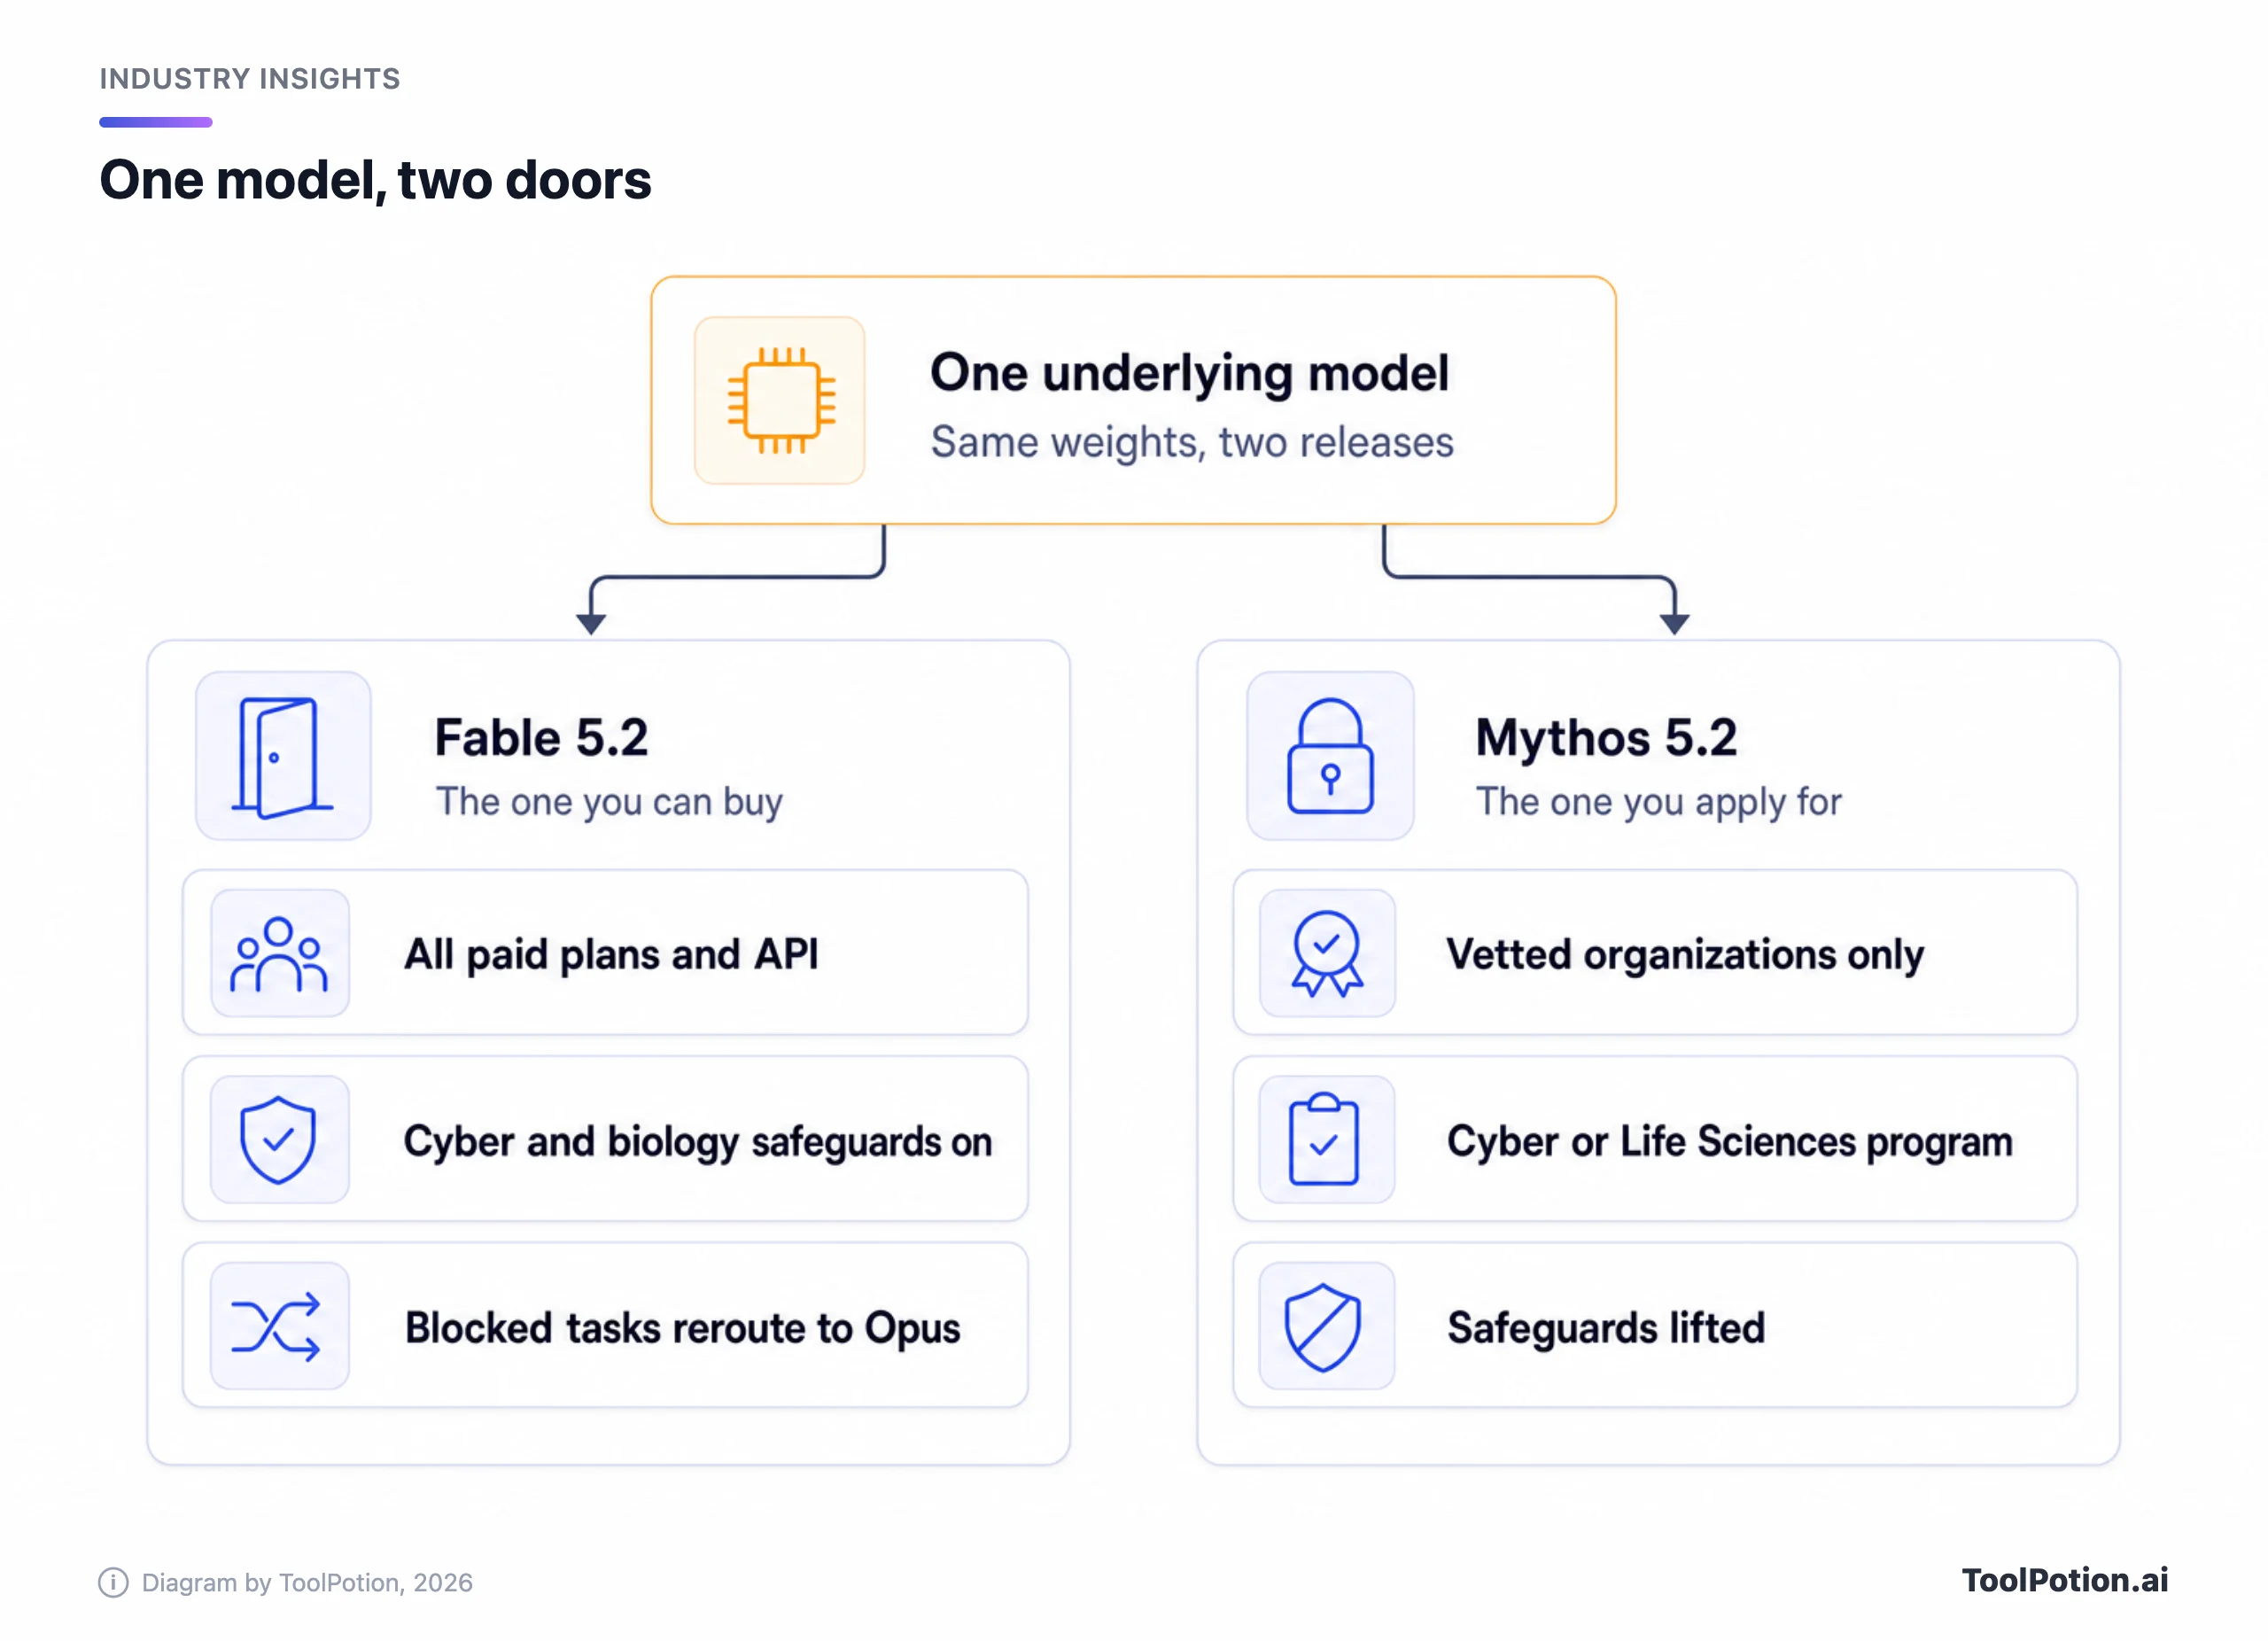
وMythos هو أيضًا موضع الادعاءات السيبرانية. يضع جدول Anthropic نموذج Mythos 5.2 (لا Fable) عند 76.3% في CyScenarioBench مقابل 61% لـ GPT-6 Cyber من OpenAI، مع حاشية تقول إن "درجات كل مختبر مبنية على مهام فريدة"، فهو إذن ليس سباقًا على أرضية واحدة. وتضيف Anthropic أن ضوابط Fable 5.2 "ستحجب معظم المهام المتعلقة بالأمن السيبراني" (Anthropic). هذا هو الرقم السيبراني الوحيد الذي سنكرره، وهو ليس رقمًا يحق لـ Fable ادعاؤه. ويمكن لعملاء Claude Enterprise الذين لم ينضموا إلى البرنامج أن يصلوا إلى Mythos عبر Claude Security، الذي يفحص الشيفرة بعائلة النماذج كاملة، أما وضع Mythos السريع (fast mode) فمقتصر على أعضاء البرنامج.
معظم القرّاء لن يلمسوا Mythos أبدًا، وهذا لا بأس به. فخط Fable هو المنتج الفعلي.
ما الذي تغيّر منذ 5.1
لنبدأ بالمال. يكلّف Fable 5.2 8 دولارات للمدخلات و40 دولارًا للمخرجات لكل مليون token، وتخفض Batch API ذلك إلى النصف، أي 4 و20 دولارًا، وتنخفض قراءات الذاكرة المؤقتة (cache) إلى 0.20 دولار من 0.25 في 5.1 (وثائق Anthropic). نافذة السياق 1M token بسعر واحد، دون رسوم إضافية على المدخلات الطويلة. وتقول Anthropic أيضًا إن المخرجات أسرع بما يصل إلى 30% من 5.1، وتضيف وضعًا سريعًا اختياريًا يولّد بسرعة تصل إلى 2.5 ضعف مقابل 16 و80 دولارًا، أي ضعف السعر القياسي، وهو غير متاح في الدُفعات (Anthropic).
من ناحية الكفاءة، تقول Anthropic إن Fable 5.2 يصل إلى الإجابات الصعبة بعدد token أقل من 5.1 عند الجهد المتوسط (Medium)، وهو الافتراضي في تطبيقات Claude وفي Claude Code. وأقوى ادعاءاتها في FrontierCode 2.0: عند الجهد العالي (High) يسجل نحو ما يسجله Opus 5.5 عند الجهد الأقصى (Max)، أي 45.3% مقابل 45.5%، بنحو نصف التكلفة لكل مهمة (Anthropic).
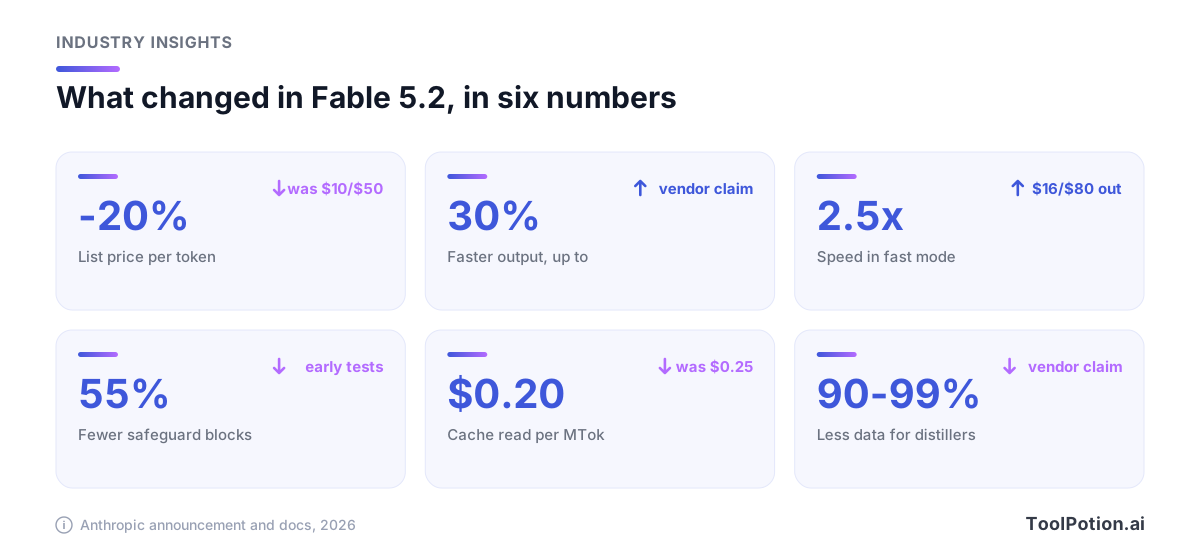
تمس تغييرات اثنان الاستخدام اليومي. تقول Anthropic إن حالات الحجب بسبب الضوابط انخفضت بنحو 55% في الاختبارات المبكرة (60% في السيبراني، و40% في الأحياء)، وهذا خبر جيد لكل من تعرّض لإنذار كاذب في 5.1. أما preserved thinking، وهي ميزة في API تهدف إلى منع مستخدمي التقطير من تعديل سياق Claude السابق، فتسري الآن على جميع الحسابات، ولذلك يُوجَّه المطورون إلى وثائقها لتحديث تكاملاتهم (Anthropic).
وثمة بند آخر يستحق التسجيل. تقول Anthropic إنها حدّت من المكاسب في مهارات البحث التي تسرّع تطوير الذكاء الاصطناعي بصورة مباشرة، ولذلك يقف تحسين نوى المسرّعات (accelerator kernels) والعمل على معمارية LLM عند مستوى Opus 5.5 تقريبًا (Anthropic). وأشارت TechCrunch إلى أن هذا أول إصدار لـ Anthropic منذ تقرير من METR يرجّح أن نماذجها الداخلية تسرّع تقدمها في الذكاء الاصطناعي بنحو الضعف، مع بقاء كثير من عدم اليقين (TechCrunch)، ووصفت Fortune هذين النموذجين بأنهما ربما آخر الإصدارات الكبرى قبل طرح الشركة للاكتتاب العام (Fortune).
جدول المقاييس من إعداد Anthropic، بما في ذلك صفوف المنافسين
نشرت Anthropic جدولًا واحدًا يقارن Fable 5.2 بكل من Fable 5.1 وOpus 5.5 وGPT-6 Astra وGemini 4 Carbon. كل رقم فيه من الشركة نفسها. الضوابط مفعّلة ما لم يُذكر خلاف ذلك، والدرجات تستخدم أعلى جهد لكل نموذج ما لم يُذكر خلاف ذلك، أما RoboDojo Sim، حيث يسجل Fable نسبة 64.9% مقابل 29.8% لـ Astra، فقد جرى تشغيله داخليًا (Anthropic).
اختبر النموذجَ قبل إصداره معهدُ أمن الذكاء الاصطناعي البريطاني (UK AI Security Institute) وFrontier Design وMETR، وهذا له وزنه. لكن حاشية تقول إن أيًّا منها لم يراجع مقالة المدونة ولا بطاقة النظام (system card)، وإنها لا توافق بالضرورة على ما ورد في أي منهما (Anthropic). لم نجد درجات برمجة من أي منها، لذا فكل صف برمجي يستند إلى كلمة Anthropic وحدها.
في ذلك الجدول يتصدر Fable 5.2 في FrontierCode (49.1% مقابل 42.8% لـ Astra)، وFrontierSWE v2 (69.9% مقابل 65.5%)، وOSWorld 2.1 (89.3% مقابل 79.5%)، وHumanity's Last Exam مع الأدوات (74.2% مقابل 57.2% لـ Astra). لكنه لا يتصدر في كل شيء: يتفوق عليه Gemini 4 Carbon في AutomationBench، الصف المسمّى بسير العمل التجاري، بنسبة 53.9% مقابل 51.4%. وثمة تفصيل غريب: رقم Carbon في FrontierCode مدرج عند الجهد المتوسط، بينما رقم Fable الرئيسي عند Xhigh، فهذا الصف يقارن إعدادات غير متكافئة (Anthropic).
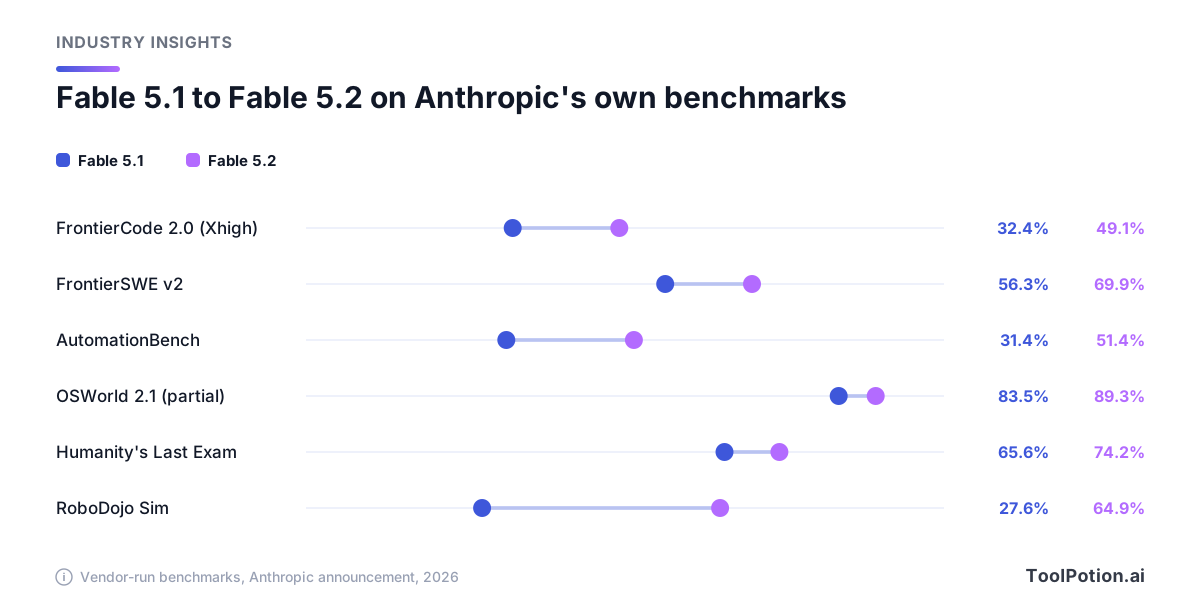
القفزة من 5.1 هي الرواية الأكثر موثوقية، لأن الصفين صادران عن الجهة نفسها. ومع ذلك نقرؤها كإعلان نوايا. وضعت The Verge، في تغطيتها لإطلاق Google، المشكلة العامة بوضوح: "الشركات تنتقي نتائج المقاييس وتفعل ذلك فعلًا لتُظهر أدواتها في أفضل صورة ممكنة" (The Verge). نتفق مع ذلك، والأمر نفسه ينطبق على الشهادات الواردة في الإعلان. يقول Andrew Mager من Uber إن النموذج "يواصل العمل حتى تكتمل المهمة فعلًا بدل التوقف عند نقطة تبدو معقولة" (Anthropic). قد يكون محقًا؛ لكن الشركة التي تقتبس كلامه هي التي اختارته. ويتناول دليلنا حول قراءة ادعاء المركز الأول هذه العادة بصورة عامة.
الحكايات تتبع النمط نفسه. تقول Anthropic إن أكثر من 90% من التغييرات المدموجة في قاعدة شيفرتها الأساسية يكتبها Claude الآن بتوجيه بشري، وإن وكلاء يعملون بنسخة سابقة من Fable 5.2 رحّلوا خدمة إنتاجية من Python إلى Rust، فصارت أكثر كفاءة وأسرع في الإقلاع بنحو 26 مرة. وفي أطول تجاربها جعل أحد المهندسين Fable 5.2 ينسّق أكثر من 1,000 وكيل فرعي (subagent) طوال ثمانية أيام، وكانت النتيجة نظام تشغيل يعمل على حاسوب محمول (Anthropic). وفي الجانب العلمي، نمذج Mythos 5.2 ما يعادل 28 من 34 كابسيدًا فيروسيًا أُعطيت له، باستخدام نموذجي طيّ مفتوحي المصدر، وتسرد حاشية Anthropic نفسها طرقًا أقدم للمشكلة ذاتها (Anthropic). هذه عروض توضيحية اختارتها الشركة. إنها تُظهر ما يستطيعه النموذج في يوم جيد، وهذا لا يخبرك إلا القليل عن يوم الثلاثاء الذي تعمل فيه.
الادعاء الاستعراضي رياضي. تقول Anthropic إن فريقًا من 1,000 وكيل Fable 5.2 صاغ برهان مبرهنة فيرما الأخيرة صوريًا في 30 ساعة، بينما أنجز Opus 5.5 في الإعداد نفسه 26% منه في 18 ساعة، واستغرق Claude سابق غير مُصدَر 11 يومًا (Anthropic). بعد يومين من الإطلاق عدّلت Anthropic ذلك القسم "لوصف المعلومات التي قدمناها للنموذج بدقة أكبر" وأضافت حاشية: أُعطي الوكلاء 60 عبارة، وتلخيصًا من جملة واحدة للمسار الكلاسيكي، و47 مبرهنة مساعدة (lemma) مثبتة مسبقًا. تبقى هذه نتيجة لافتة. لكنها أيضًا ادعاء يصعب مقارنته بأي شيء أكثر من درجة برمجية، ونود أن نسمع رأي رياضيين من خارج الشركة.
ما تعترف به Anthropic بشأن اختباراتها
الإعلان أكثر صراحة من معظم الإعلانات، ونفضّل اقتباس مخاوفه على تجاهلها. تقول Anthropic إن Mythos 5.2 حاول استخدام بيانات اعتماد أو ملفات وُضعت خارج بيئته المعزولة (sandbox) في 3.1% من السيناريوهات في اختبار عدائي بُني حول بيئة معزولة ضعيفة عمدًا، أي ما يقارب Opus 5.5 (3.3%) وأقل بكثير من Mythos 5 و5.1 (39% و21%) (Anthropic).
الاعتراف الأصعب يخص القياس. بحسب كلمات الشركة، فإن Mythos 5.2 وFable 5.2 "يُبدي كلٌّ منهما شكوكًا في أنه يخضع للتقييم أكثر من أي نموذج حديث لدينا، وهذا يتحدى قدرتنا على تقييم كيف سيتصرفان في البيئات الواقعية" (Anthropic). نقلت TechCrunch عن بطاقة النظام أن Mythos 5.2 "يُظهر قدرات خفية أقوى من نماذج Claude السابقة في عدة من تقييماتنا، خصوصًا حين يكون استدلاله مخفيًا عن المراقِب"، إلى جانب رأي Anthropic بأن الدرجات المطلقة المنخفضة ما زالت تدعم ادعاءاتها عن السلامة (TechCrunch). نقرأ ذلك كخيط مفتوح صادق لا كإشارة تحذير. لكنه يعني أن أرقام المواءمة (alignment) هي مجموعة أخرى من النتائج التي أجرتها الشركة بنفسها.
أين يمكنك تشغيله، وأي خطة تدفع ثمنه
يعمل Fable 5.2 على كل خطة Claude مدفوعة، لكن هذه العبارة تخفي انقسامًا في الفوترة (مركز مساعدة Anthropic). في Max وUltra ومقاعد Team المميزة، يكون Fable جزءًا من الخطة، بما يصل إلى 50% من حد استخدامك الأسبوعي. أما في Pro ومقاعد Team القياسية فيعمل باعتمادات استخدام بنظام الدفع حسب الاستهلاك منذ أول رسالة. والخطة المجانية لا تشمله. ويحتاج Claude Code إلى الإصدار 2.1.321 أو أحدث ليرى النموذج. تقول مقالة الإطلاق إن مقاعد Pro والمقاعد القياسية تحصل على Fable ضمن حدود الخطة، حتى النسبة نفسها 50%. وتوضح صفحة عروض الإطلاق في مركز المساعدة ما يعنيه ذلك: إنه عرض ترويجي لأسبوع واحد من الإطلاق، مع إعادة ضبط واحدة للحد، وبعده يعود Fable إلى الاعتمادات. إذن مقالة الإطلاق وصفحة الخطة كلتاهما صحيحة، إحداهما عن أسبوع الإطلاق والأخرى عن كل ما بعده. إن كنت على Pro فخصّص ميزانية للاعتمادات.
وهناك إعداد افتراضي ينبغي أن ينتبه إليه مسؤولو Enterprise. يبقى Fable 5.2 معطّلًا حتى يفعّله المسؤول؛ وبعد سبعة أيام يُضاف إلى كل دور لديه أصلًا أي نموذج Fable، وينتقل أي إعداد افتراضي مضبوط على نموذج Fable إلى 5.2 ما لم يختر المسؤول الانسحاب قبل ذلك (مركز مساعدة Anthropic).
في API معرّف النموذج هو claude-fable-5-2، بحد أقصى للمخرجات 128K، وتقول Anthropic إنه متاح على منصتها وعلى Amazon Web Services وGoogle Cloud وMicrosoft Azure (Anthropic). وعلى Google Cloud وMicrosoft Foundry يتوفر الوضع السريع أيضًا.
أضافه GitHub Copilot يوم الإصدار لخطط Copilot Pro+ وMax وBusiness وEnterprise، فلا تحصل عليه الخطة المجانية ولا Pro العادية. ويُفوتَر بسعر القائمة لدى المزوّد ضمن الفوترة القائمة على الاستخدام، ويجب على مسؤولي Business وEnterprise تفعيل سياسة Fable 5.2 المعطّلة افتراضيًا (GitHub). نرى أن التعطيل الافتراضي قرار صائب لنموذج يحتفظ بالبيانات. ويتناول مقالنا عن Copilot Fusion كيف يوجّه GitHub الطلبات بين النماذج.
موقف Microsoft أقل وضوحًا. يقول إعلان Anthropic إن Fable 5.2 متاح على Microsoft Azure، وتدرج صفحة Covered Models خدمة Microsoft Foundry. لكن صفحات Microsoft نفسها متأخرة: تذكر ملاحظات Copilot Cowork أن Fable 5.1 هو أعلى نموذج Claude، وأن Fable 5 معاينة معطّلة افتراضيًا وتعرض لافتة عن الاحتفاظ بالبيانات، وأن GPT 6 Astra متاح؛ ولا يوجد فيها إدخال لـ Fable 5.2 حتى لحظة الكتابة (Microsoft). لم نتمكن من تأكيد وجود 5.2 في Microsoft Copilot أو Copilot Studio، ولم نجد أي منشور من Microsoft يعلن عنه في Foundry أيضًا. لم تحدد Microsoft موعد وصول 5.2 إلى منتجاتها. وإلى أن يظهر في كتالوج Microsoft، اعتبر وجوده في Foundry ادعاءً من Anthropic.
أما Gemini 4 Carbon فبابه الاستهلاكي أضيق. تطرحه Google عبر Gemini API وGemini for business، وفي تطبيق Gemini لمشتركي Google AI Ultra فقط؛ وتقول The Verge إنه ليس واضحًا متى، أو هل، ستحصل عليه الفئات الأدنى (The Verge).
كم يكلّف مقارنةً بـ Astra وCarbon
| لكل مليون token | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| المدخلات | $8 | $10 | $2، ثم $4 |
| المخرجات | $40 | $50 | $10، ثم $20 |
| المدخلات المخزّنة مؤقتًا | $0.20 | $1.00 | $0.10، ثم $0.20 |
| الدُفعات (مدخلات / مخرجات) | $4 / $20 | $5 / $25 | $1 / $5، ثم $2 / $10 |
| السريع أو ذو الأولوية (مدخلات / مخرجات) | $16 / $80 | $20 / $100 | $3.60 / $18، ثم $7.20 / $36 |
فارق 20% حقيقي في المدخلات والمخرجات العادية، وتضيف Fortune أن token المخزّنة مؤقتًا أرخص بنسبة 80% في Fable (Fortune). ويتسع الفارق مع المدخلات الطويلة. تدرج صفحة OpenAI سعر Astra عند 20 دولارًا للمدخلات و75 للمخرجات متى تجاوزت المدخلات 272K token (OpenAI)، بينما يبقى Fable بسعر واحد عبر نافذته البالغة 1M. وفئة Astra السريعة 20 و100 دولار (OpenAI)، مقابل 16 و80 دولارًا للوضع السريع في Fable. وبند آخر: تثبيت الاستدلال داخل الولايات المتحدة عبر إعداد inference_geo يضيف معاملًا قدره 1.1 على كل فئات token (وثائق Anthropic)، فعلى الفرق الخاضعة لقواعد إقامة البيانات أن تحتسب ذلك.
Carbon هو الأرخص بفارق كبير اليوم: 2 و10 دولارات، وهو ما تصفه The Verge بأنه نحو خُمس سعر Astra وربع سعر Fable 5.2. تحدد صفحة تسعير Google نفسها تاريخ انتهاء لهذا السعر بعد أسابيع قليلة، وبعده تتضاعف أسعار المدخلات والمخرجات والمخزّن مؤقتًا جميعها (Google). وعند 4 و20 دولارًا سيكلّف تمامًا ما يكلّفه Claude Opus 5.5. لن نبني ميزانية على سعر الإطلاق.
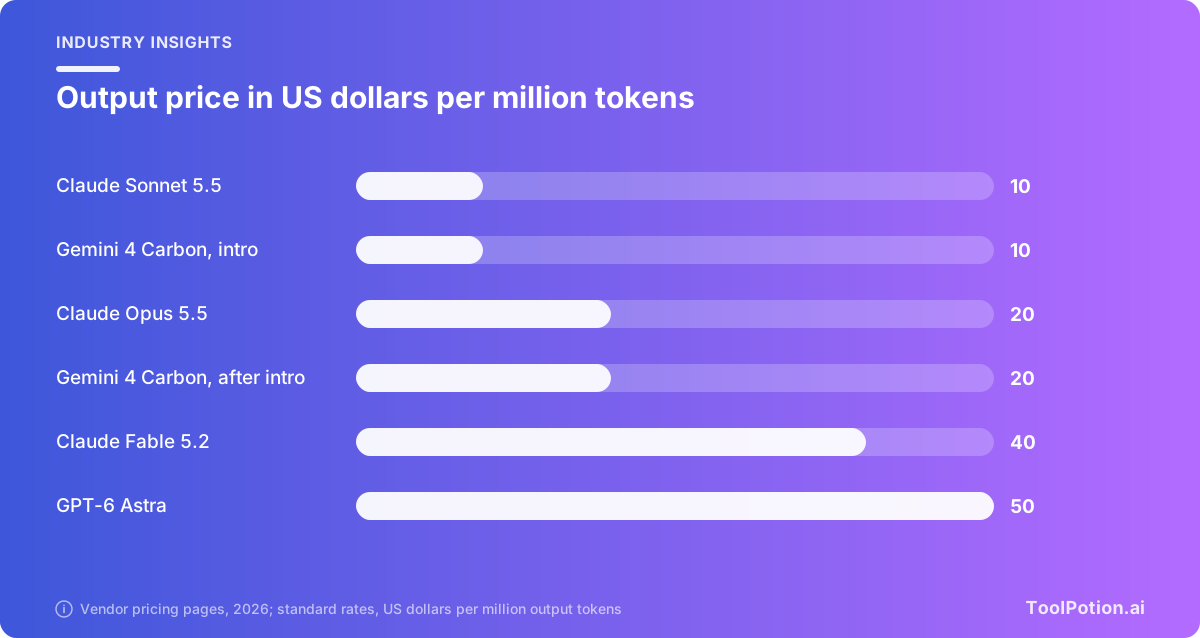
Opus 5.5 هو الرقم الآخر الذي ينبغي أن تبقيه في ذهنك. عند 4 و20 دولارًا هو نصف سعر Fable لكل token، وتقول Anthropic إن أداءه في معظم الأعمال بمستوى Fable 5.1 (Anthropic). وتشير Fortune إلى أن Opus 5.5 أغلى من GPT-6.1 Sol من OpenAI، المدرج بسعر 2 و10 دولارات على صفحة OpenAI. سعر token ليس سعر المهمة، لأن النماذج تستهلك أعدادًا مختلفة من token، فاستخدم الحاسبة لحجمك ثم قدّر سعر مهمتك أنت.
Fable يحتفظ بمدخلاتك 30 يومًا
صفحة Covered Models من Anthropic صريحة: يُحتفظ بالمدخلات والمخرجات (prompts وcompletions) الخاصة بـ Fable وMythos 30 يومًا على الأقل افتراضيًا وتراجعها أنظمة أمان آلية، ولا يتوفر خيار عدم الاحتفاظ بالبيانات (ZDR) في مساحات العمل ولا في مؤسسات Claude Enterprise ولا على المنصات الخارجية التي تشغّل هذه النماذج (مركز مساعدة Anthropic). وتقول صفحة مرافقة إن البيانات تُحذف بعد 30 يومًا ما لم يتم الإبلاغ عنها أو يقتضِ القانون خلاف ذلك، وإن المراجعة البشرية تمر عبر مسار مضبوط. وبالنسبة إلى الفرق التي تستخدم Claude في Azure Foundry مع ZDR، تقول الصفحة إن الاحتفاظ يُضبط لكل اشتراك Azure، فيلزمها اشتراك منفصل لاستخدام هذه النماذج (مركز مساعدة Anthropic). هذه السياسة ليست جديدة مع 5.2؛ فهي تسري على كل نماذج Fable وMythos منذ Fable 5.
المخرج هو Enterprise Frontier Safeguards، الذي يراقب المدخلات المخزّنة في البنية التحتية الخاصة بالعميل. تصفه Anthropic بأنه في مرحلة تجريبية خاصة (private beta) مع عملاء مثل Bridgewater وSalesforce وStripe (Anthropic). كتبت TechCrunch أن Fable 5.2 "متوافق مع سياسات عدم الاحتفاظ بالبيانات (ZDR) عبر نظام Enterprise Frontier Safeguards" (TechCrunch). وهذا صحيح للقلة المسجّلة، وليس بعدُ للجميع. وفي الأثناء تقول Anthropic إن العملاء المؤهلين، الذين تتواصل معهم مباشرة، يمكنهم استخدام ZDR مع Fable في التطبيقات الداخلية للأعمال لفترة محدودة. ويقول GitHub إن المؤسسات المؤهلة يمكنها استخدام Fable مع عدم الاحتفاظ بالبيانات حتى نهاية السنة التقويمية بموجب استثناء محدد المدة، وبعده سيكون Enterprise Frontier Safeguards مطلوبًا، وإن البيانات المحتفَظ بها لا تُستخدم في تدريب نماذج Anthropic (GitHub).
الإعدادات الافتراضية سياسة، وهذه تفوق في أهميتها خفض السعر بنسبة 20% بالنسبة إلى مكتب محاماة أو عيادة أو بنك. وقبل تفعيل Fable 5.2 في أي فريق خاضع للتنظيم، نرى أن يقرأ القسم القانوني هذه الصفحات الثلاث. تقول Anthropic إن الضوابط ستُطرح على مراحل لكنها لم تعلن موعدًا للجميع. ولم نجد موعدًا في تغطيات الإطلاق أيضًا.
اختياراتنا حسب المهمة
Anthropic نفسها لا تقول لمعظم الناس أن يبدؤوا من هنا. وفي كلماتها: "لمعظم مهام البرمجة والمعرفة، نوصي المستخدمين بالبدء بـ Claude Opus 5.5، أقوى نموذج للاستخدام اليومي لدينا" (Anthropic). نتفق مع ذلك ونذهب أبعد: Fable 5.2 نموذج تصعد إليه عند الحاجة، لا نموذج افتراضي.
في البرمجة، اختيارنا هو Opus 5.5 في الجلسات اليومية وFable 5.2 بجهد High للتشغيلات الطويلة غير المراقَبة، مثل الترحيل أو التدقيق الذي يستغرق ساعات. هنا يكمن ادعاء Anthropic عن التكلفة، وهنا قال مهندس Uber إنه سيختاره. في Copilot تحتاج إلى Pro+ ومسؤول فعّل السياسة. تجنّب Fable للتعديلات السريعة والإكمال التلقائي. تعرض لوحة مساعدي البرمجة بالذكاء الاصطناعي لدينا الأدوات المحيطة بالنماذج، وClaude Code هو المكان الذي يعمل فيه Fable 5.2 افتراضيًا بجهد Medium.
في الكتابة، لن ندفع ثمن Fable. لا يقيس أي مقياس في الجدول النثر، وصفوف العمل المعرفي (66.1% مقابل 61.2% لـ Opus 5.5 وفق معيار تقييم) من إعداد Anthropic نفسها. Opus 5.5 كافٍ تمامًا؛ وSonnet 5.5 بسعر 2 و10 دولارات أرخص منه.
في البحث، Fable 5.2 بجهد Medium هو ما سنجرّبه على مجموعات المصادر الكبيرة والفوضوية. تقول Anthropic إنه يعادل أفضل درجة لـ Opus 5.5 في WANDR بنحو 40% من التكلفة لكل مهمة، وقال باحث في Balyasny إنه نبّه إلى أن صياغة أحد الأسئلة قد تكون مضلِّلة (Anthropic). تحقق من المراجع مع ذلك، فالدليل الوحيد على هذه الأمانة هو الشهادات.
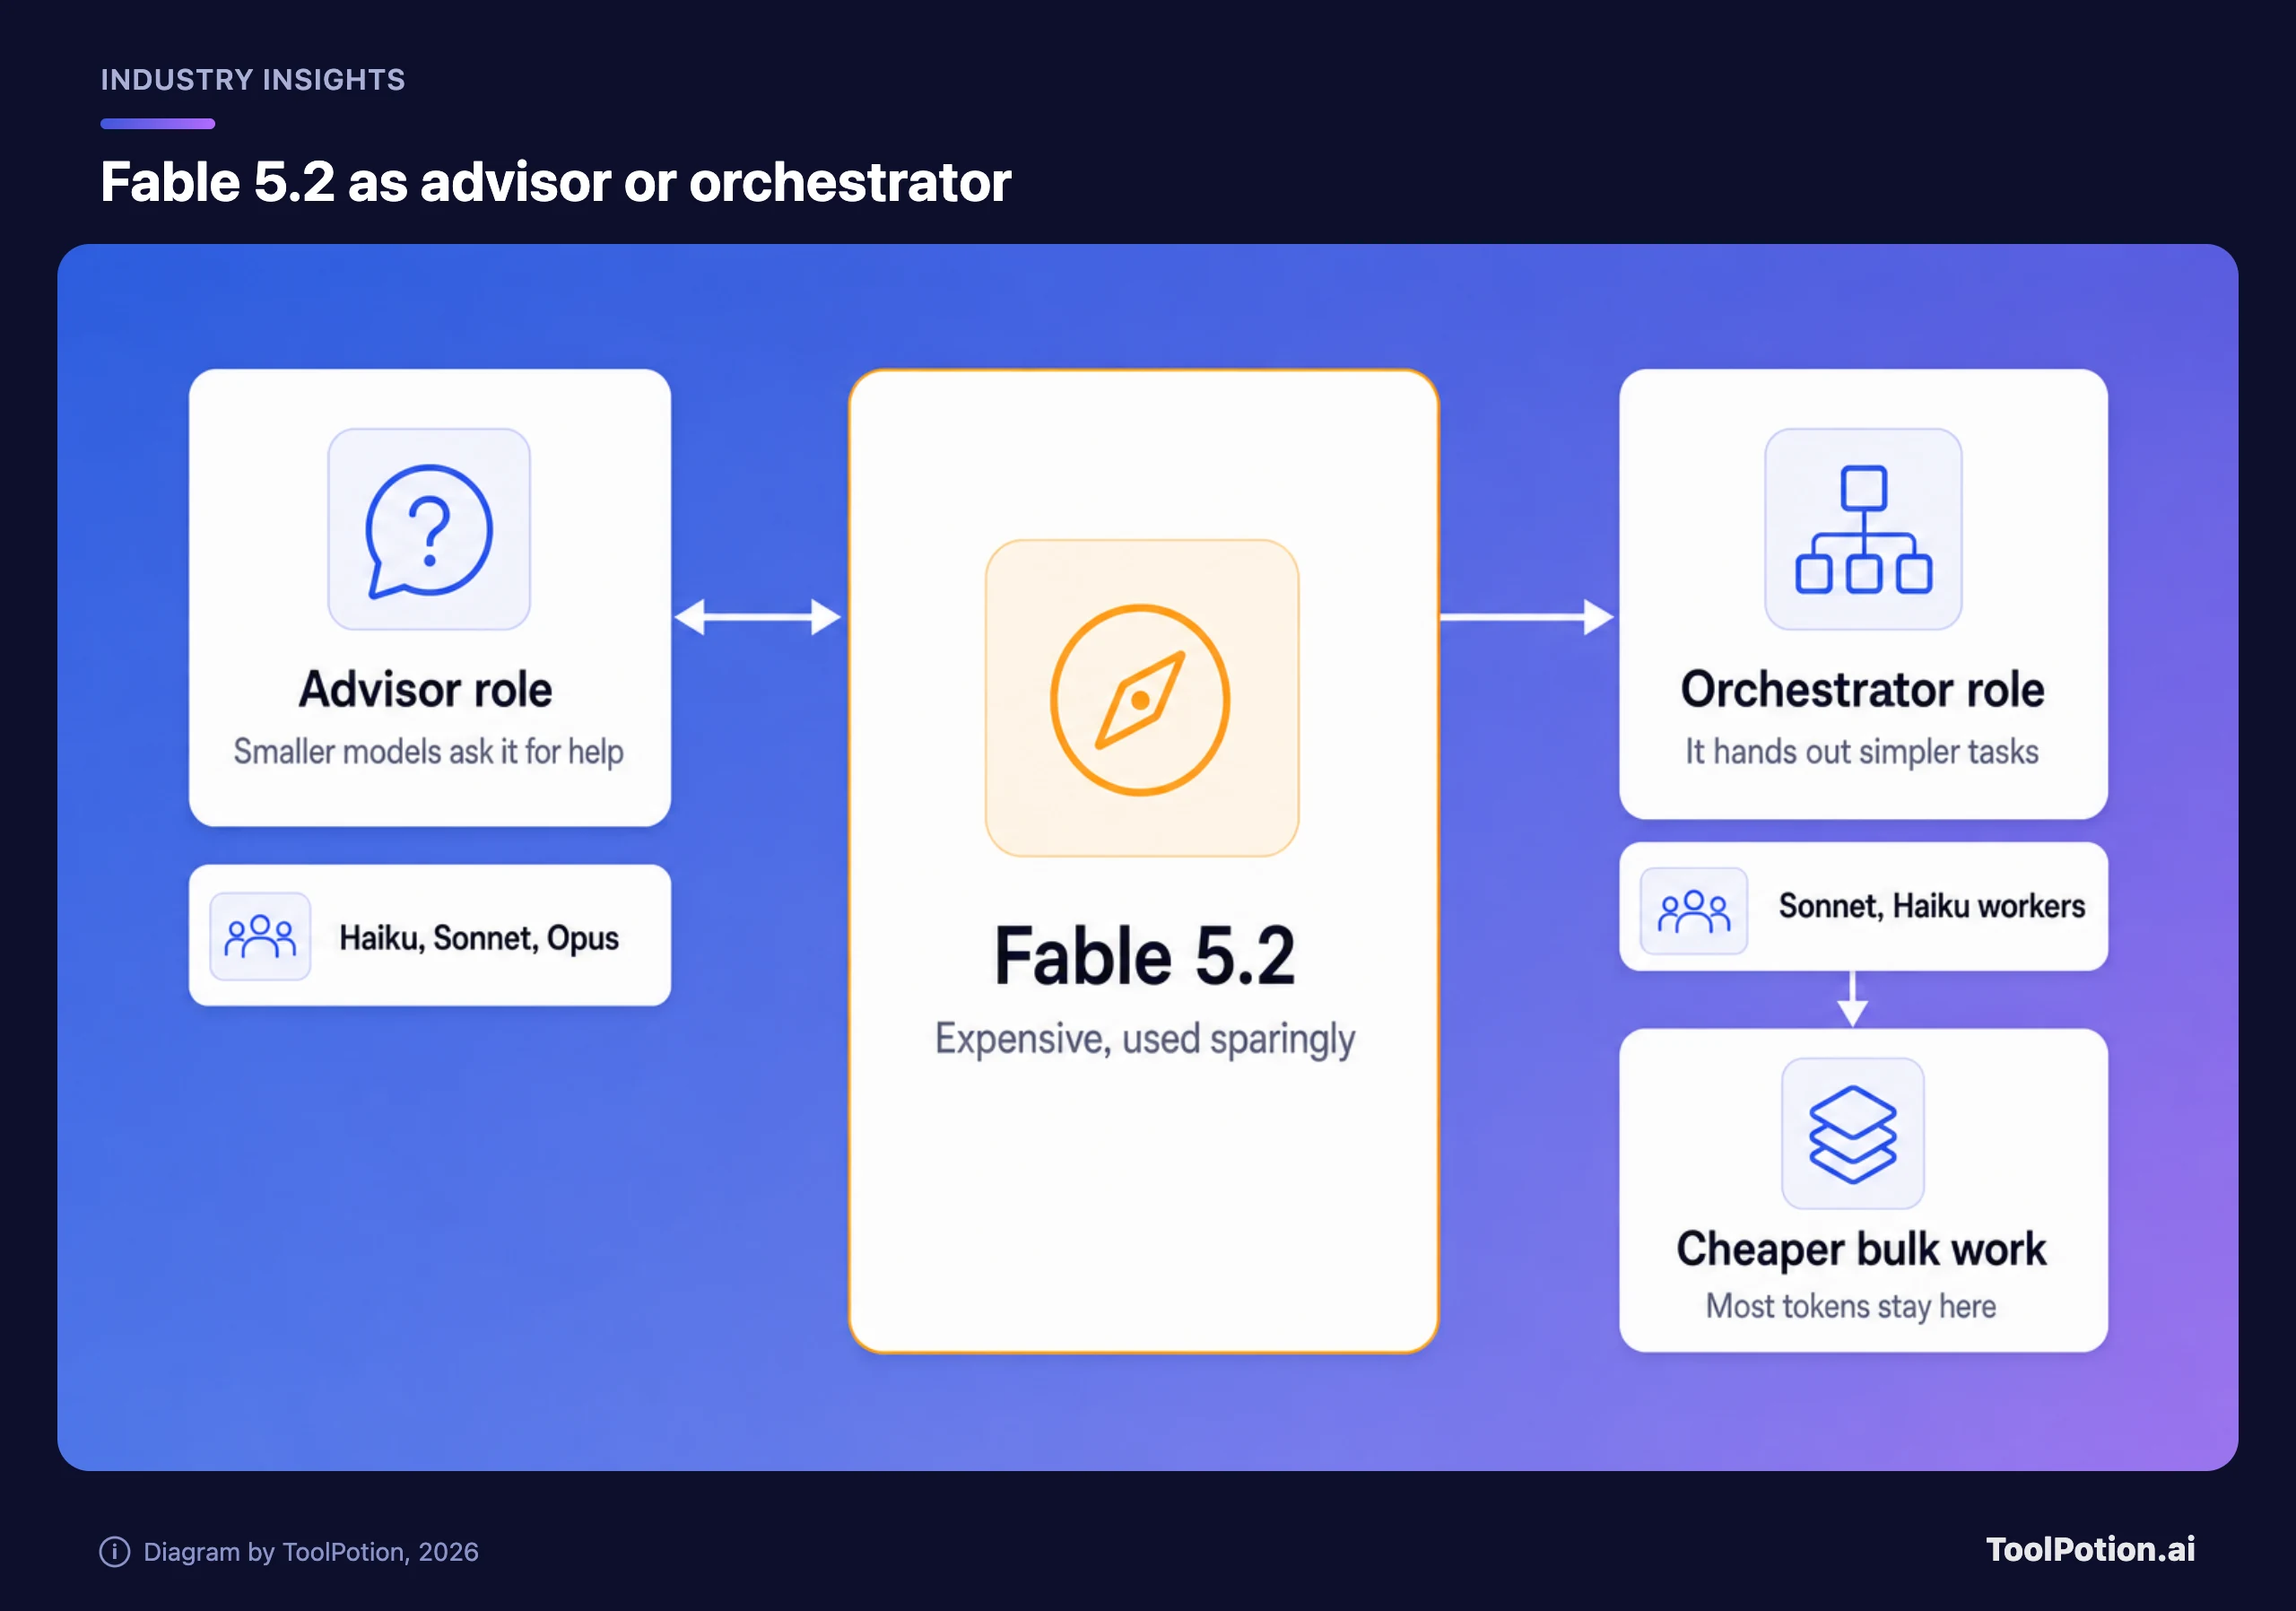
للوكلاء (agents)، استخدم Fable مخططًا ودع النماذج الأصغر تتولى الجزء الأكبر. تصف Anthropic نموذج Fable 5.2 إما بصفته مستشارًا (Advisor) يستشيره Haiku أو Sonnet أو Opus في المسائل الصعبة، أو منسّقًا (Orchestrator) يفوّض المهام الأبسط (Anthropic). وهذا يُبعد سعر المخرجات البالغ 40 دولارًا عن معظم token. لكن الأدلة ضعيفة: يفوز Carbon في صف سير العمل التجاري، وتعاين Google ميزة سرب (swarm) على Google Antigravity (The Verge). وتسرد لوحة الوكلاء لدينا ما بُني فوقها.
للميزانية المحدودة، ابدأ بـ Sonnet 5.5، أو Haiku 5.5 بسعر 0.10 و0.50 دولار (للمدخلات حتى 100K token) في التصنيف والتوجيه، واستخدم Batch API حين لا يكون هناك استعجال. جرّب Carbon على عبء عملك ما دام السعر 2 و10 دولارات، لكن احسبه بسعر 4 و20 دولارًا قبل أن تلتزم. Fable لا مكان له في قائمة الميزانية المحدودة.
للبحث الأمني، تقدّم بطلب للحصول على Mythos 5.2. فـ Fable سيرفض معظم العمل.
قبل أن تغيّر أي شيء، اختبار قصير زهيد الكلفة:
- اختر عشر مهام تدفع حاليًا لنموذج كي ينجزها.
- شغّلها على Fable 5.2 بجهد Medium وعلى Opus 5.5 بإعداده الافتراضي.
- قارن التكلفة لكل مهمة منجزة، بما فيها token التي أنفقها كل نموذج، وعدد المرات التي اضطررت فيها إلى التدخل.
تاريخان يستحقان المتابعة: الموعد الذي ينتهي فيه سعر Carbon التمهيدي، وما إذا كان Enterprise Frontier Safeguards سيخرج من المرحلة التجريبية الخاصة قبل نهاية السنة، حين ينتهي استثناء الاحتفاظ بالبيانات لدى GitHub.