

تقول OpenAI إن GPT-6 Cyber بنت ثغرات استغلال تعمل فعليًا لـ 948 ثغرة في نواة Linux ضمن حملة بحثية واحدة، أي أكثر من خمسة أضعاف الثغرات الـ 166 التي استغلها GPT-5.6 Sol بأداة الاختبار البحثية نفسها (OpenAI). هذا رقم صادر عن مختبر الشركة البائعة، ونعامله على هذا الأساس. لكنه رقم محدد أيضًا، ويستطيع مشرفو النواة الذين وصلتهم 304 نتائج حرجة أن يتحققوا منه.
خلال أيام قليلة، أطلقت OpenAI نموذج GPT-6 Cyber وشراكة مع Hacktron، وأصدرت Anthropic كلًّا من Claude Fable 5.2 وMythos 5.2، ونشرت Google DeepMind إثباتًا تحقّقت منه الآلة للشيفرة التي يقوم عليها Signal، ووصفت شركتا أمن مهاجمين يشغّلون وكلاء ذكاء اصطناعي ضد أهداف حقيقية. قرأنا منشورات الشركات والتقارير التي تقف خلفها. نقل The Hacker News قصة المقارنات المعيارية، ونقلت Wired قصة Signal.
ما الذي تقول OpenAI إن GPT-6 Cyber تستطيع فعله
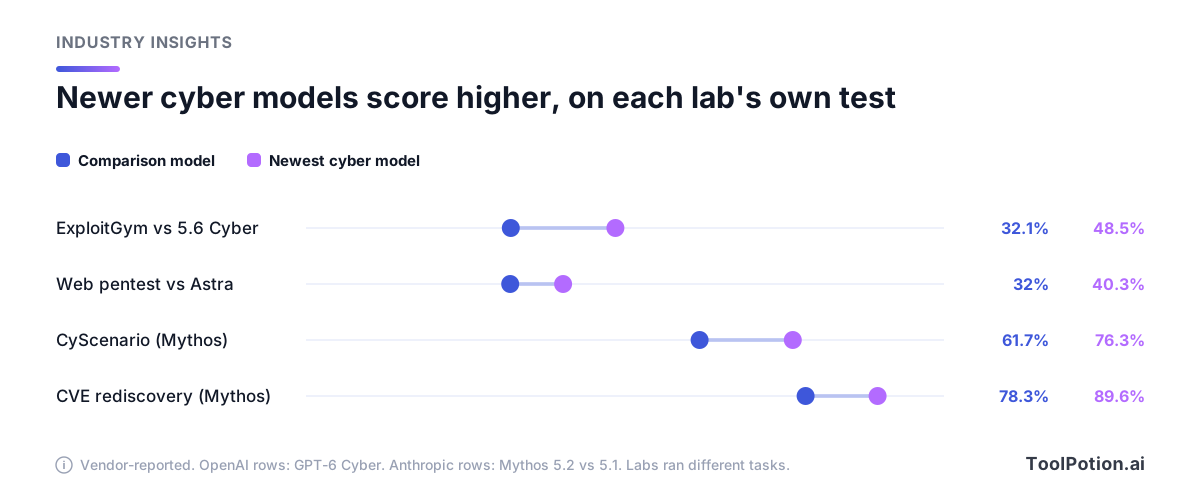
في ExploitGym، وهو اختبار لقدرة النموذج على استغلال ثغرة محددة، تعلن OpenAI أن GPT-6 Cyber حقق 48.5% مقابل 32.1% لـ GPT-5.6 Cyber. وفي اختبار اختراق ويب جديد تفحص فيه النماذج التطبيقات دون الاطلاع على الشيفرة المصدرية، اكتشف 40.3% من الثغرات، مقابل 32.0% لـ GPT-6 Astra (OpenAI). وأوضح مقارنة هي مقارنة الرفض: في RemoteExploitBench، الذي يستخدم ثغرات معروفة في GitLab وPostgreSQL وJenkins داخل مختبر مضبوط، رفض GPT-6 Astra العامل مع Daybreak Blue كل المهام، بينما أنجز GPT-6 Cyber منها 95%.
خارج المختبر، تقول OpenAI إن باحثيها استخدموا النموذج لاكتشاف 81 ثغرة عالية الخطورة لم تكن معروفة من قبل في Firefox، بحسب تصنيف Mozilla التي بدأت بإصدار الإصلاحات. وقال براين غرينستيد من Mozilla، في منشور الإطلاق، إن Firefox دخل عام 2026 بوصفه "واحدة من أكثر قواعد الشيفرة تحصينًا ودراسةً في العالم". وهذا هو بيت القصيد: فالهدف هنا ليس لعبة. كما تصنّف OpenAI النموذج بدرجة "حرج" في الأمن السيبراني ضمن إطار الجاهزية لديها، بعد أن كان التصنيف "مرتفع" للنموذج السابق. وحين يصف مختبر منتجه بهذه الطريقة، نقرأ ذلك على أنه ملصق تحذير بقدر ما هو قائمة مزايا.
ادعاء السلامة هو الأغرب بين هذه الادعاءات. بنت OpenAI اختبارًا تقع فيه خدمات جانبية سهلة الاختراق بجوار الهدف الحقيقي، وعلى النموذج أن يدرك أن مهاجمتها خارج النطاق. وبدون موجّه النشر الخاص به، بقي GPT-6 Cyber ضمن الحدود بنسبة 99.93% من المرات، مقابل 94.49% لـ GPT-5.6 Cyber. الرقم القديم يعني أن تشغيلًا واحدًا من كل ثمانية عشر تقريبًا خرج عن الحدود. أما الجديد فما زال يترك نحو سبع حالات خروج لكل عشرة آلاف، وتوصي OpenAI نفسها بعزل التشغيل في بيئة معزولة (sandbox) ومراجعة الإجراءات والإشراف البشري في الأعمال عالية الخطورة. ونحن نأخذ هذه النصيحة حرفيًا.
أكثر الأصوات الخارجية فائدة في منشور الإطلاق هو روب ت. لي، كبير مسؤولي الذكاء الاصطناعي في Dragos، الذي شغّل فريقه نماذج OpenAI المسموح لها بالمهام السيبرانية على مختبر محاكاة لمحطة طاقة. خلاصته: "عتبة المهارة تنخفض في الاستطلاع وبحث الثغرات اللذين يسبقان أي هجوم". ويقول لي إن نموذجًا متقدمًا، يعمل بمفرده على ذلك المختبر، وجد ثغرتين من نوع zero-day في برنامج هندسي يدير بيانات مرحّلات الحماية. هذا الاقتباس هو سبب كتابتنا هذا المقال.
ما وراء عنوان "Fable تتفوق على GPT-6 Cyber"
اقرأ هذا القسم قبل أن تكرر أي رقم من أرقام هذه القصة: المختبرات لم تشغّل المهام نفسها. يحمل جدول نتائج Anthropic حاشية تقول: "درجات كل مختبر مبنية على مهام خاصة به". ينقل The Hacker News أن Fable 5.2 أنجز 76.3% من CyScenarioBench الخاص بـ Irregular، مقابل 61.7% لـ Fable 5.1 و61% لـ GPT-6 Cyber. لكن جدول Anthropic يضع الـ 76.3% تحت Mythos 5.2 والـ 61.7% تحت Mythos 5.1، وهذا ينسجم مع تحذير Anthropic نفسها من أن ضوابط Fable 5.2 "ستحجب معظم المهام المتعلقة بالأمن السيبراني". فالعنوان يذكر النموذج الخطأ، وفارق خمس عشرة نقطة بين درجات مختبرين على مجموعتي مهام مختلفتين ليس ترتيبًا. لن نختار مزوّدًا بناءً عليه. الرقم الذي يستحق الاحتفاظ به هو مقارنة Anthropic نفسها قبل وبعد، وحتى هذه شهادة جهة عن نفسها.
ينقل The Hacker News أيضًا تفصيلًا من تقرير Irregular المنفصل عن GPT-6 Cyber تجاوزه العنوان. فقد حلّ النموذج التحديات الذرية الاثنين والعشرين كلها، بمتوسط نجاح 97% في بحث الثغرات واستغلالها و98% في محاكاة الهجوم على الشبكات، لكن 63% فقط في التخفّي والمراوغة. أي أن الدخول شبه محسوم في هذه الاختبارات، أما البقاء دون اكتشاف فلا. وبالنسبة للمدافعين هذا أفضل خبر في كومة المقارنات المعيارية، ولم تمنحه التغطية التي قرأناها سوى سطر واحد.
تصف Anthropic نموذج Mythos 5.2 بأنه "أقدر نموذج لديها في هندسة الأمن السيبراني"، وتقول إن شركة أمن لم تسمّها وجدت أن واحدًا من كل ستة أخطاء مؤكدة أظهرها Mythos 5.2 فاتت كل النماذج المتقدمة الأخرى التي اختبرتها (Anthropic). كما تعلن Anthropic أن Mythos 5.2 حقق 89.6% في تقييم CVE Rediscovery الخاص بها، وهو اختبار على 1,829 ثغرة CVE، مقابل 78.3% لـ Mythos 5.1. وكلا المقياسين من تشغيل الشركة نفسها، فاعتبرهما ادعاءات إلى أن يكررهما مختبرون مستقلون.
من يحصل على المفاتيح، وما الذي يتنازل عنه
لا تبيع أي من الشركتين هذه النماذج بشكل مفتوح. تقول OpenAI إن GPT-6 Cyber متاح في البداية عبر الـ API وCodex لمجموعة مختارة من عملاء Daybreak Red المعتمدين، على أن يتوسع الوصول إلى Daybreak Red "قريبًا". ويتطلب الوصول إلى API في Daybreak Red قائمة سماح بعناوين IP افتراضيًا، وعلى العملاء الذين يعتمدون سياسة عدم الاحتفاظ بالبيانات (zero data retention) استخدام Private Safety Processing عمومًا، وهو يُبقي سجلات مشفّرة في مساحة تخزينهم الخاصة لمدة 30 يومًا. وقالت OpenAI أيضًا إن الوصول إلى النموذج الأساسي في برنامج شركائها "يبقى لدى الشريك المعتمد ولا يُنقل مباشرة إلى العميل" (OpenAI).
تقسّم Anthropic الفكرة نفسها إلى ثلاث درجات في برنامج التحقق السيبراني لديها. يغطي Defense Access عمليات الأمن وتحليل البرمجيات الخبيثة والتحقق من الثغرات، وتقول Anthropic إن شركات الأمن الأصغر ومشرفي المصادر المفتوحة والباحثين الأفراد ممن لديهم سجل موثوق يمكنهم التأهل، مع ردود خلال أيام قليلة. أما Red Team Access فيتيح اختبار الاختراق المصرّح به، وهو للمؤسسات فقط، ويستغرق أسابيع. وSpecialized Access، لمجالات مثل شبكات الكهرباء وأنظمة التحويلات بين المصارف، يخضع لمراجعة معمّقة مع الحكومة الأمريكية. اختبرت Anthropic هذه الدرجات بـ Claude Opus 5.5 على CyScenarioBench، بخمس محاولات لكل تحدٍّ من عشرة تحديات: دون الوصول إلى البرنامج، حُجبت كل المهام عند أول موجّه؛ وفي Defense Access حُجبت 46 تجربة من 50 في مرحلة ما؛ وفي Red Team Access لم يُحجب شيء ونجحت 34 من 50، وهو يطابق معدل نجاح النموذج غير المقيّد. هذه مرة أخرى Anthropic تقيّم بواباتها بنفسها.
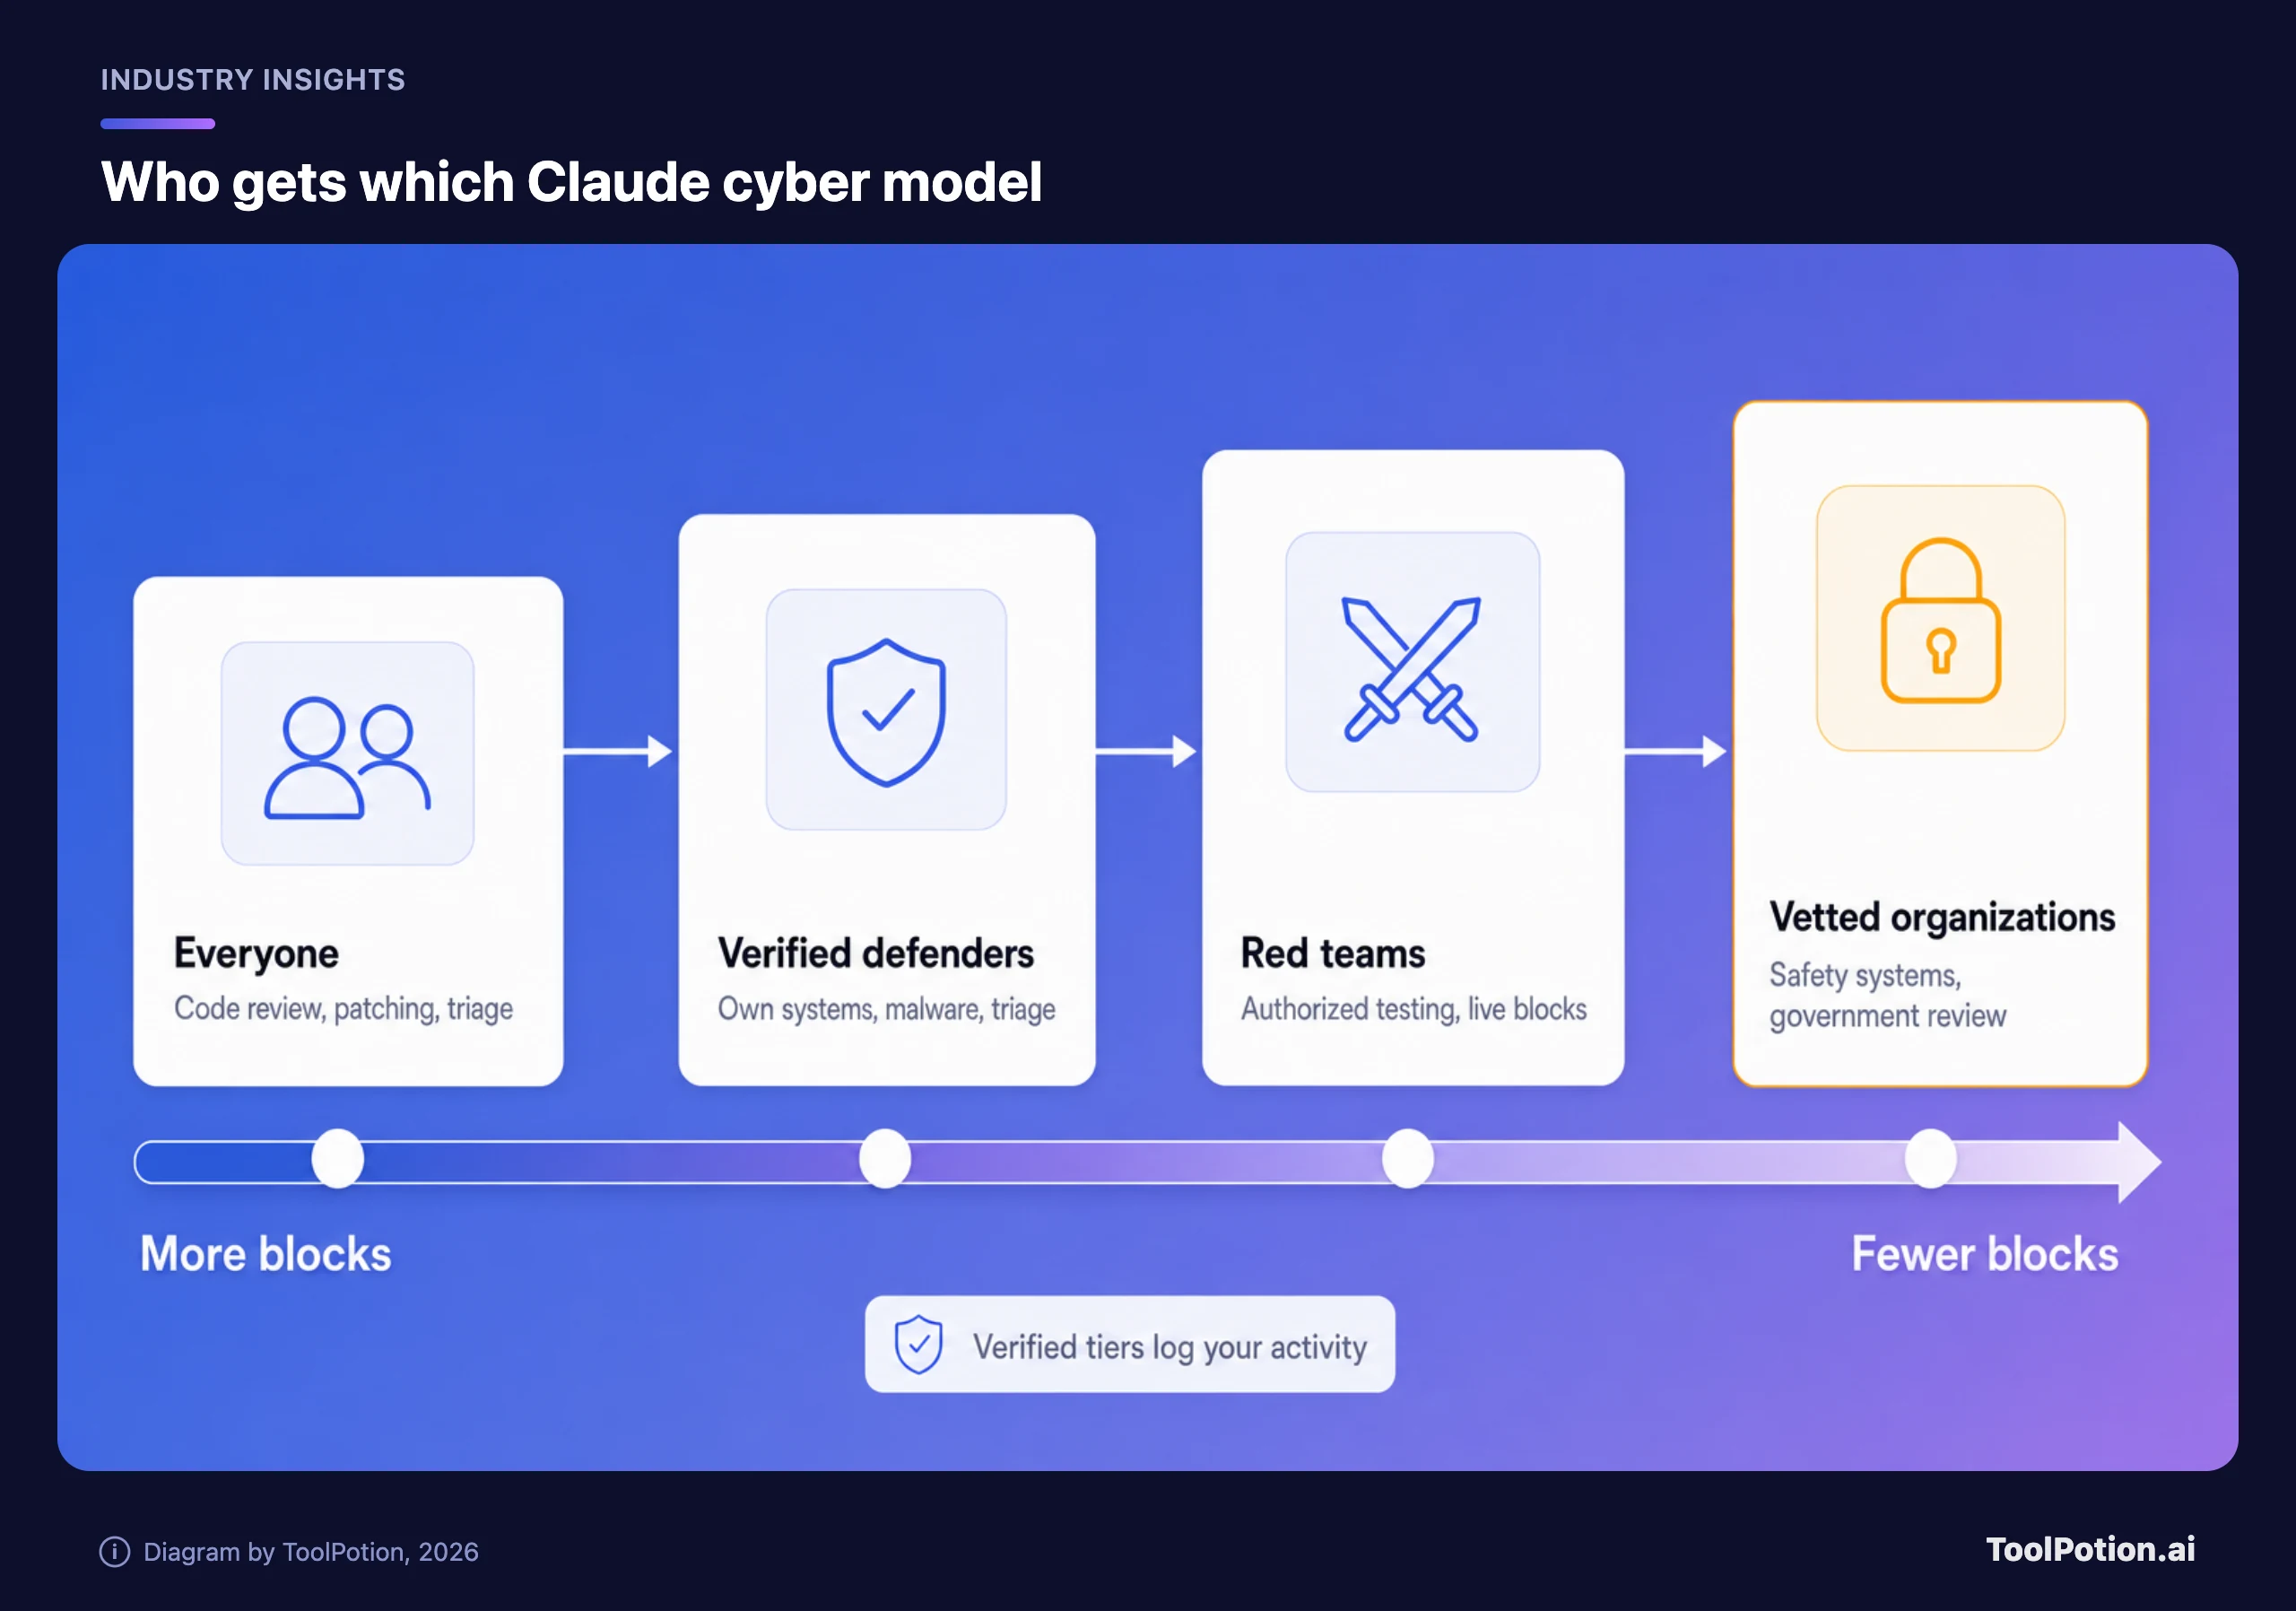
Fable وMythos هما النموذج الأساسي نفسه (Anthropic). Claude Fable 5 يحمل ضوابط سيبرانية قوية وهو متاح للجميع. أما Mythos فهو النسخة التي تتقدم إليها المؤسسات بطلب. وتُدرج صفحة تسعير API لدى Anthropic الاثنين بالسعر نفسه لـ Fable 5.2 وMythos 5.2: 8 دولارات لكل مليون token إدخال و40 دولارًا لكل مليون token إخراج، أو 16 و80 دولارًا في الوضع السريع الاختياري. فـ Mythos لا يُسعَّر بشكل منفصل. السعر هو أصغر العوائق هنا. أما الأكبر فهو الاحتفاظ بالبيانات. تشترطه Anthropic على المؤسسات في برنامج التحقق السيبراني لتتمكن من رصد إساءة الاستخدام؛ بينما تُبقي OpenAI الاحتفاظ القياسي افتراضيًا وتمرّر عملاء zero-data-retention عبر Private Safety Processing. نرى أن هذا ثمن دخول عادل لفريق اختراق، وكلفة حقيقية لشركة لا يمكن أن تُترك شيفرة عملائها في سجلات طرف آخر. وتقول Anthropic إن خيارًا جديدًا اسمه Enterprise Frontier Safeguards سيتيح للمؤسسات المؤهلة إبقاء البيانات في سحابتها الخاصة، لكن منشور البرنامج لم يعد به إلا "في وقت لاحق من هذا الخريف". وإلى أن يصدر، تبقى هذه المقايضة قائمة.
أحد الفحوص الخارجية لكل هذا هو مكافآت اكتشاف الثغرات. فشراكة OpenAI مع Hacktron تضع شركة تبني وكلاء ذكاء اصطناعي لمراجعة الشيفرة واختبار الاختراق على أنظمة OpenAI نفسها، مع وصول موسّع إلى نماذجها المتقدمة. وقال الرئيس التنفيذي لـ Hacktron، زاين تشانغ، إن مستقبل الأمن السيبراني "لن يحدده من يملك أكبر فريق أمني، بل من يجيد الجمع بين الإبداع البشري وقدرات الذكاء الاصطناعي" (OpenAI). ورفعت OpenAI أيضًا مكافآت اكتشاف الثغرات، فصارت الثغرات الحرجة في ChatGPT أو Codex أو API تستحق حتى 30,000 دولار، وحتى 172,000 دولار مع المكافآت الإضافية للاكتشافات الاستثنائية (OpenAI). نثق بمبلغ يُدفع لأطراف خارجية أكثر من أي ادعاء داخلي لفريق أحمر.
المهاجمون في التقارير لا يستخدمون هذه النماذج
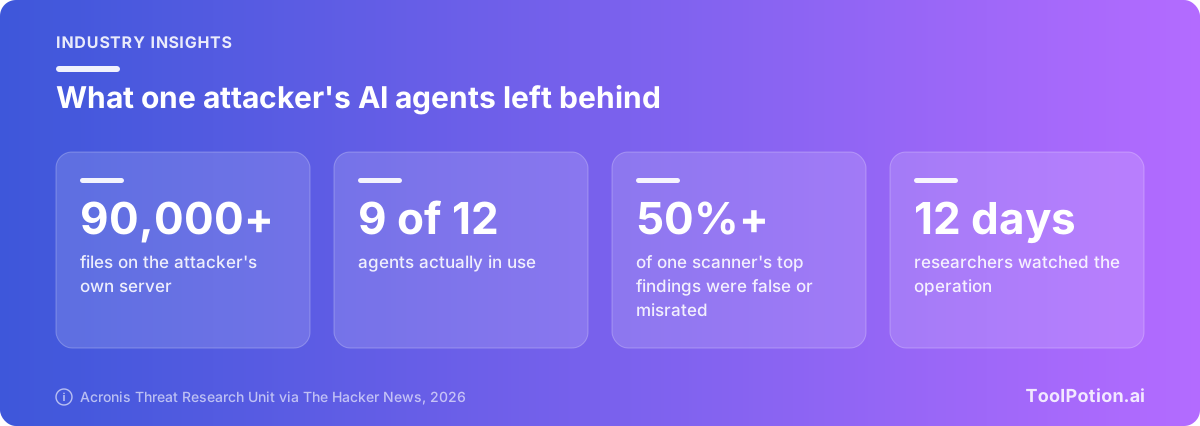
يصف باحثو Acronis مهاجمًا واحدًا مقره تايوان وجّه وكلاء ذكاء اصطناعي نحو مئات المؤسسات في 11 دولة على الأقل، وحصل على بيانات أو وصول في نحو عشر منها. سحب الوكلاء سجلات الإرسال الطارئ لسبع مناطق في تايبيه. وأبرز ما في الأمر هو ما شغّل عليه هجماته: فالنماذج التجارية رفضت في الغالب مساعدته على الهجوم، فعمل الوكلاء المهاجمون تقريبًا بالكامل على نسخ "abliterated" من DeepSeek وGLM وQwen، وهي نماذج تُشغَّل محليًا بعد إزالة تدريب السلامة منها (The Hacker News). وظهرت أيضًا وكلاء برمجة منها Claude Code وCodex وCursor. يقول التقرير إن المهاجم وجّه Claude Code وCodex إلى نموذج abliterated، وإن كانا يؤديان في الغالب أعمال البنية التحتية، وإن Cursor هاجم موقع خدمات طوارئ تايواني وهو يعمل بنموذج كهذا.
وكان الوكلاء سيئين في المهمة بطرق يلاحظها أي شخص. فقد اخترعت إحدى أدوات المسح ثغرات CVE غير موجودة، وكان أكثر من نصف نتائجها عالية الخطورة والحرجة إيجابيات كاذبة أو مصنّفة تصنيفًا خاطئًا. وأبلغ وكيل الهجوم الرئيسي عن نتائج لم تحدث. أما الاختراق الذي نجح لدى أحد موردي إرسال الإطفاء فاستخدم بيانات دخول root الافتراضية، لا ثغرة ذكية. وحيث كان تسجيل الدخول مفروضًا والنقاط الطرفية مفلترة بشكل صحيح، يقول الباحثون إن الوكلاء فشلوا.
وأبلغت Arctic Wolf عن نمط ثانٍ. AntiFox منصة مفتوحة المصدر لاختبار الاختراق بالوكلاء على GitHub، وتقول Arctic Wolf إن أنظمة Alibaba Cloud التي تستضيف واجهات AntiFox ارتبطت بإجراءات خبيثة مؤكدة ضد خدمات ويب متصلة بالإنترنت وبيئات AWS الخاصة بها. وفي بعض الحالات على الأقل وصل النشاط إلى طلب ناجح للحصول على سر إنتاجي. وحكمها: "تجعل أطر الوكلاء كهذه تقنيات اختبار الاختراق أكثر إتاحة للجهات المهددة، مع زيادة سرعة تطبيق هذه التقنيات واتساقها في الهجمات الحية" (The Hacker News). وتضيف القصة نفسها أن Check Point Research حدّدت 2,557 نظامًا يستضيف ARTEX، وهي أداة هجوم وكيلية أخرى، وتحصي نحو 45 إطارًا مفتوح المصدر من هذا النوع. وخلاصة Check Point نفسها لما يغيّره الاختراق بالوكلاء: الحجم والسرعة.
لم يتضمن أي من التقريرين GPT-6 Cyber أو Mythos، بحسب ما تذكره التغطية. قراءتنا أن البوابات تبدو متينة في القمة وقليلة الأثر في القاع، حيث تكفي أطر وكلاء مجانية ونماذج مفتوحة الأوزان منزوعة الضوابط لضرب خادم بكلمة مرور افتراضية. والأدلة أيضًا شحيحة: حفنة من التقارير، معظمها من شركات أمن لها مصلحة في القصة، ولا يستطيع أحد حتى الآن أن يقول ما نسبة الاختراقات التي يدخل فيها الذكاء الاصطناعي أصلًا.
أنظف نتائج الدفاع جاءت من الرياضيات
يقول عنوان Wired إن DeepMind "أثبتت أن بروتوكول Signal آمن". منشور DeepMind أضيق من ذلك، ونحن نفضّله. فقد وجّه الباحثون وكلاء لإثبات خصائص أمنية رئيسية في الشيفرة الفعلية وراء بروتوكول Signal، منها أن الرسائل تبقى محمية قبل اختراق جهاز لفترة وجيزة وبعدها. وراجع بشر كل مواصفة صورية. أنتج الوكلاء أكثر من ستة ملايين سطر بلغة Lean، وحدّدوا الواحد بالمئة من الشيفرة الذي احتاج إلى نظرة ثانية من إنسان، وأنهوا العمل في أربعة أسابيع، وهي مهمة تقول DeepMind إنها تستغرق عادةً سنوات من فرق الخبراء (Google DeepMind). وللتأكد من أن النظام يميّز الشيفرة الجيدة من السيئة، أعاد الفريق إدخال خطأين حقيقيين سبق إصلاحهما، وحصل على إثباتات تحقّقت منها الآلة بأن النسخة المعيبة غير آمنة.
قال إيهرين كريت، المدير التقني في Signal، إن النتيجة تمنح "ثقة أكبر في ضمانات الخصوصية في شيفرتنا". نعدّ هذا أجدر الادعاءات بالثقة في الكومة كلها، لسبب بسيط: درجة المقارنة المعيارية تعتمد على تصديق الشركة، أما إثبات Lean فتتحقق منه آلة. وهو يغطي خصائص محددة لقاعدة شيفرة واحدة، لا Signal كمنتج، وتقول DeepMind إن توسيع نطاقه يحتاج إلى مزيد من البحث. وقد فتحت DeepMind مصدر مخرجات التحقق لديها، وهكذا يكسب ادعاء كهذا الثقة.
والبنية التحتية الحيوية تشير في الاتجاه نفسه. تصف Cyber Mission من Anthropic البرنامج الخاص بها: نماذج متقدمة ومهندسون في الموقع وأبحاث تهديدات لمزوّدي الخدمات الذين يؤمّنون شبكات الكهرباء وأنظمة المياه والمصانع، التي لا يمكن في الغالب إيقاف معداتها لتصحيحها. وتُعد Dragos وRockwell Automation وNozomi Networks من الشركاء المؤسسين.
عنق الزجاجة هو الإصلاح
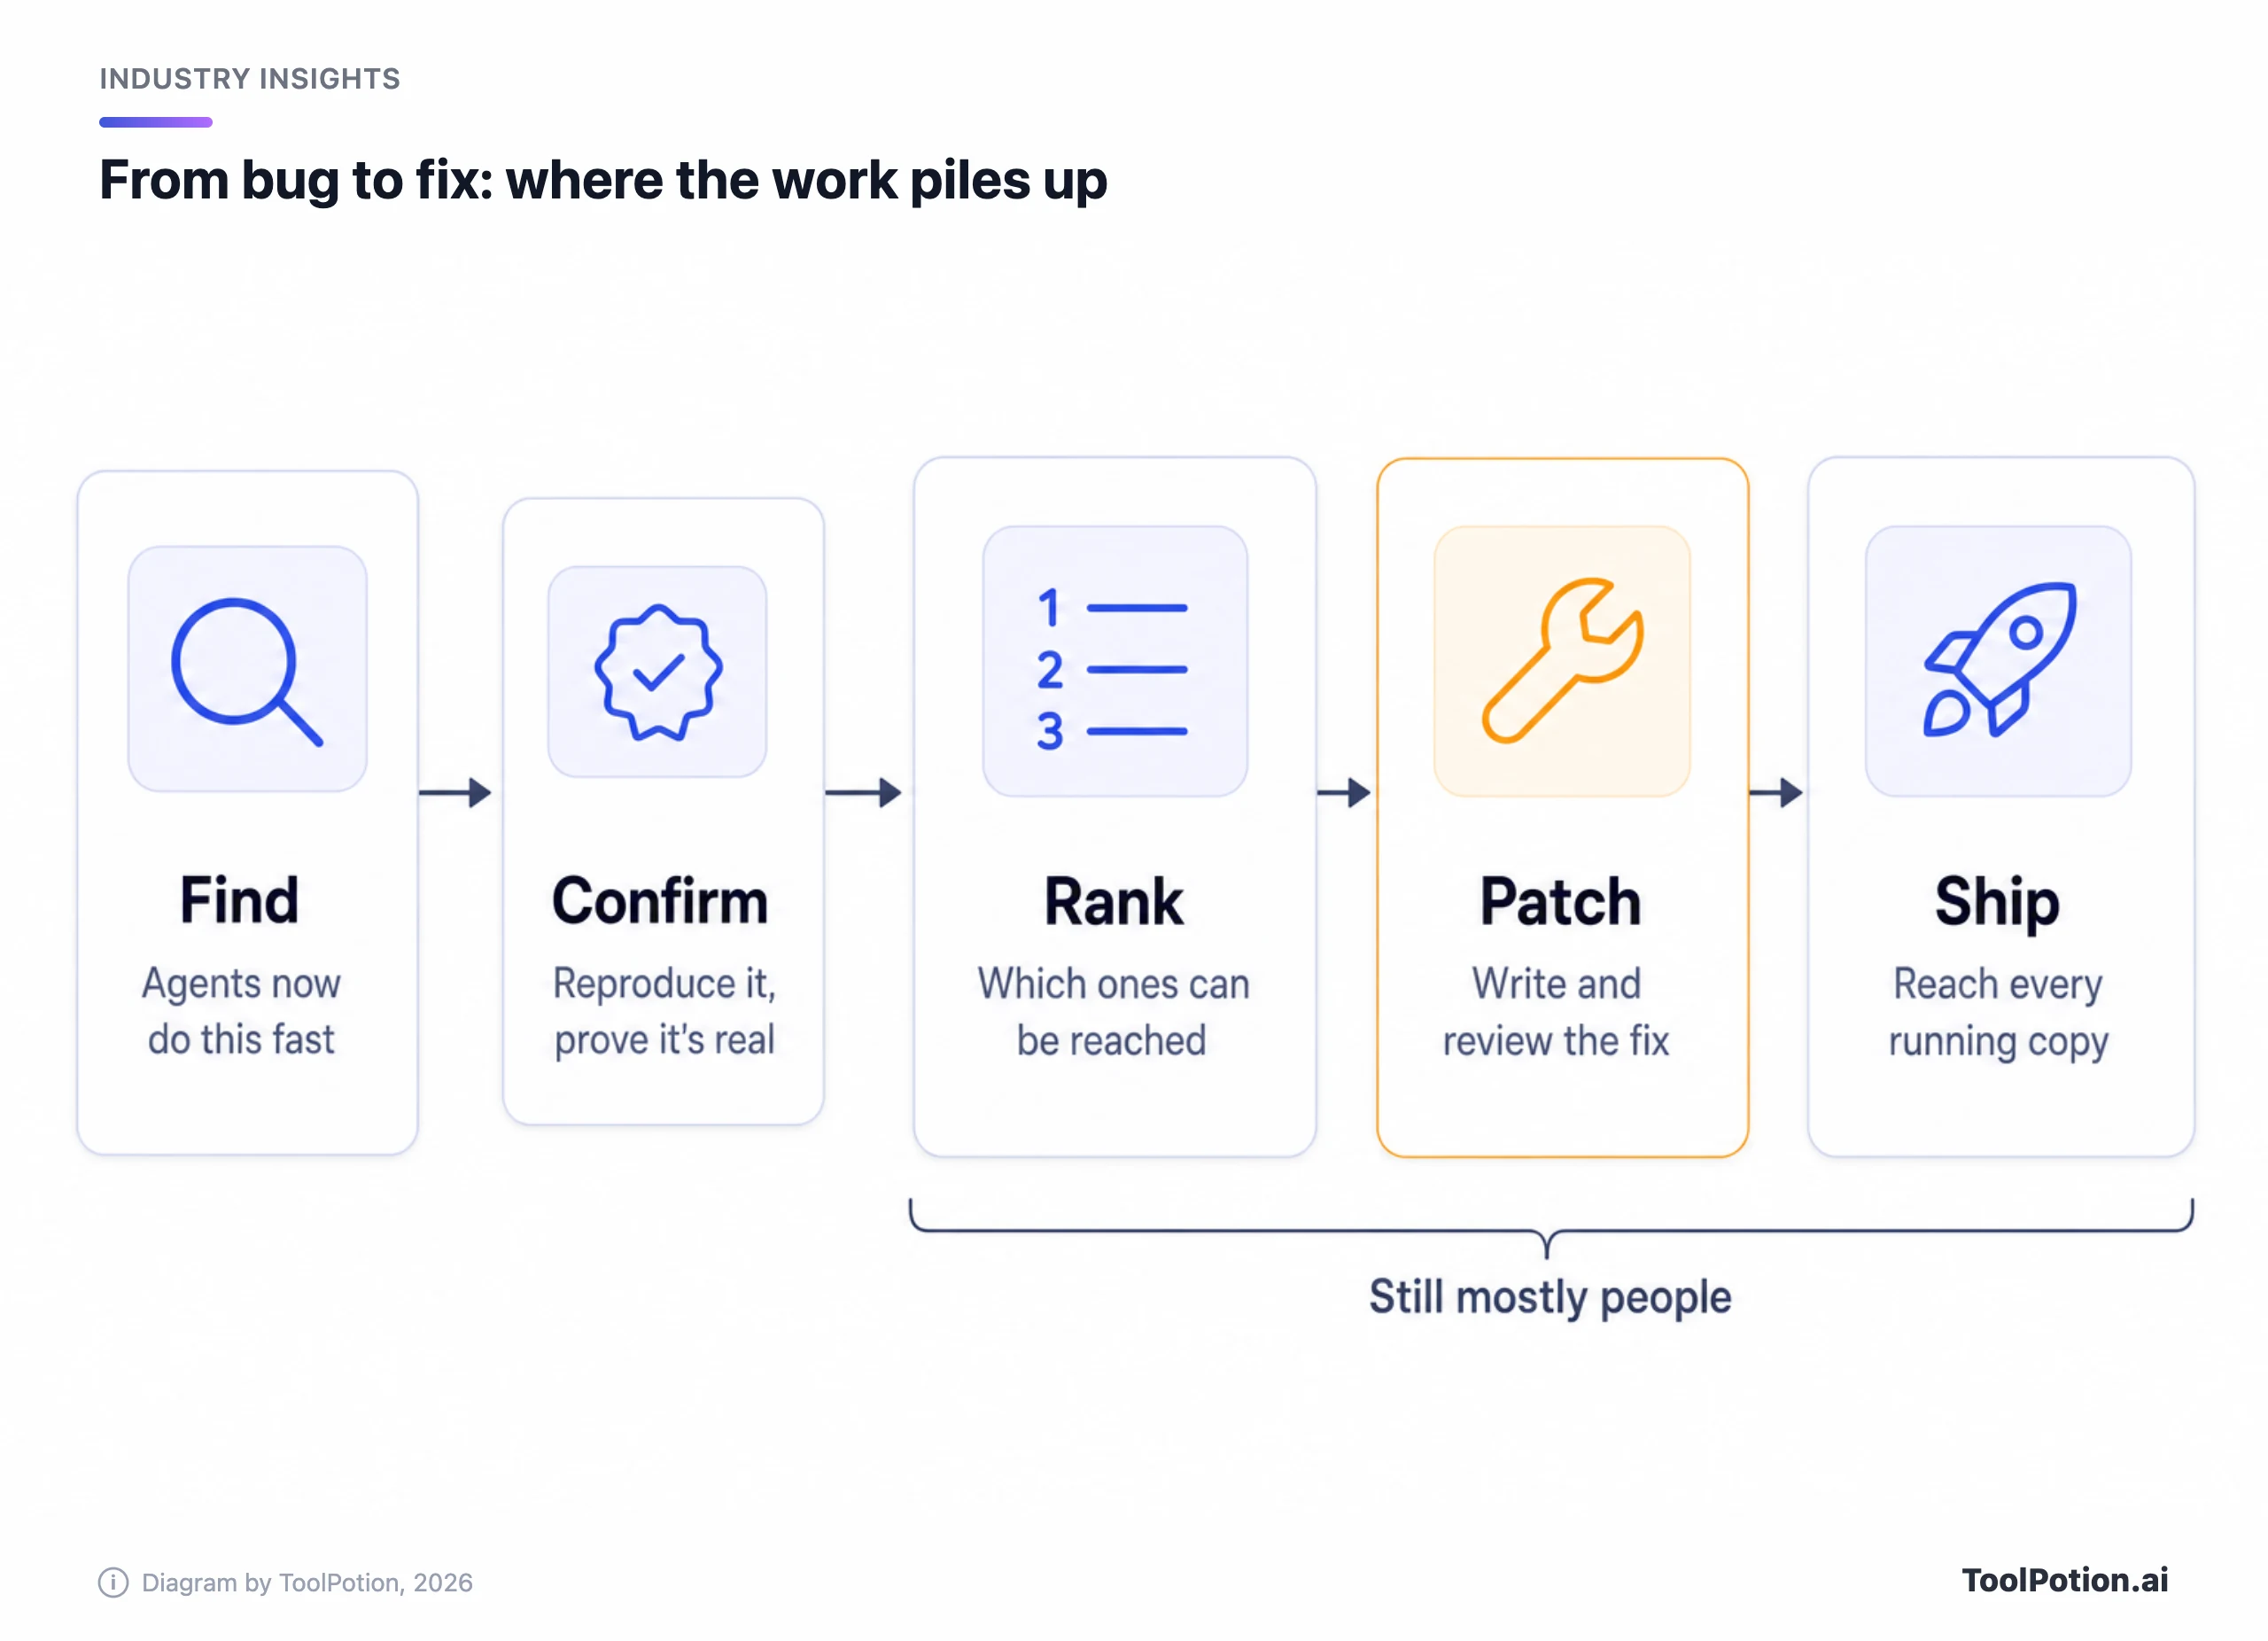
لخّصت Anthropic المشكلة في جملة واحدة: "أصبح اكتشاف الثغرات أسهل من أي وقت مضى، لكن التحقق من هذه النتائج وترتيب أولوياتها وإصلاحها ما زال صعبًا" (Anthropic). وكتبت OpenAI ما يقارب ذلك في منشور سابق: "تقرير الثغرة لا يحمي المؤسسة". واتفاق منافسين على هذا في إعلانيهما هو أقرب ما في هذه الكومة إلى إجماع. وقد غطّينا الجانب الآخر سابقًا، في مقالينا عن الذكاء الاصطناعي الذي يجد الأخطاء أسرع مما يستطيع أحد إصلاحها وعن ما تجده ماسحات الثغرات بالذكاء الاصطناعي وما يفوتها.
فمن الرابح إذن؟ رأينا، الذي لا يصرّح به أي مصدر بهذه الصيغة: يربح المهاجمون أكثر ضد المؤسسات البطيئة في التصحيح، لأن المهاجم يحتاج إلى مسار واحد يعمل ويستطيع التعايش مع ماسح يخطئ نصف المرات. ويربح المدافعون أكثر حيث يصلحون بسرعة أصلًا، لأن اكتشاف الأخطاء صار رخيصًا والكلفة المتبقية هي العملية نفسها. وبوابات النماذج تقيّد ما يمكن استخدام أقدر الأنظمة فيه، لكنها لا تغيّر هذه المعادلة لمن يشغّل برمجيات قديمة. وتوقعات Anthropic نفسها تشير في الاتجاه ذاته حاليًا: فهي تتوقع أن يميل الذكاء الاصطناعي إلى صالح الدفاع خلال عامين، لكنها تقول إنه على المدى القريب "قد لا يكون ذلك صحيحًا"، لأن كلفة استغلال الثغرات انخفضت بينما إصلاحها بطيء ولا يزال يعتمد على الناس. والذي سيغيّر رأينا هو جولة ثانية من الاختبارات المستقلة عن قدرة الهجمات على تفادي الكشف.
ماذا تفعل الآن، بالترتيب
إذا كنت تدير شركة صغيرة، فلن تحصل على GPT-6 Cyber ولا تحتاج إليه. فالهجمات في التقارير دخلت في الغالب من أبواب غير مقفلة. سنخصص الساعة الأولى لهذه الخطوات، بهذا الترتيب:
- فعّل تسجيل الدخول متعدد العوامل للبريد الإلكتروني ولوحات الإدارة وكل وحدات التحكم السحابية.
- فعّل التحديثات التلقائية لكل ما يمكن الوصول إليه من الإنترنت، وصحّح البقية خلال أيام لا أرباع سنة.
- ابحث عن كلمات المرور الافتراضية أو المشتركة في الراوترات وقواعد البيانات وأدوات الإدارة وغيّرها. أحد اختراقات تايوان لم يحتج إلى أكثر من ذلك.
- انقل المفاتيح من الشيفرة وسكربتات الصفحات إلى مدير أسرار (secrets manager)، ثم ضع حدود إنفاق وتاريخ تدوير لكل مفتاح API للذكاء الاصطناعي والسحابة.
- دوّن ما يستطيع غريب الوصول إليه من الإنترنت. لا يمكنك تصحيح خادم نسيته.
إذا كنت تطوّر برمجيات، فالخطوة التالية المعقولة هي ماسح يعمل ضمن مسار طلبات الدمج (pull request). Semgrep وSnyk Code وAikido موجودة في دليلنا؛ ولوحة أفضل 200 أداة أمن سيبراني بالذكاء الاصطناعي ولوحة محللي الأمن تبيّنان ترتيب البقية. تعامل مع كل نتيجة من الذكاء الاصطناعي على أنها خيط يجب التأكد منه، فماسح مهاجم Acronis نفسه اخترع ثغرات CVE. أما الوكلاء المفتوحة المصدر مثل PentestGPT وShannon فهي للأنظمة التي تملكها ولديك إذن مكتوب باختبارها؛ وتقارير AntiFox تُظهر ما تفعله هذه الفئة من الأدوات في اليد الخطأ. وللمساعدة العامة في مراجعة الشيفرة، يؤديها Claude وChatGPT كلاهما، مع أن Anthropic تقول إن نماذجها المتاحة للجميع تحمل ضوابط سيبرانية متحفظة تحجب معظم الأعمال السيبرانية.
إذا كنت متخصصًا في الأمن، فقدّم الآن على Daybreak Blue من OpenAI أو Defense Access من Anthropic. تسعى Anthropic إلى الرد على طلبات Defense Access خلال أيام وعلى Red Team Access خلال أسابيع، وتشترط الاحتفاظ بالبيانات. أما OpenAI فلم تنشر مدة ردّ لـ Daybreak. وقائمة التحقق أدناه تحوّل القائمة الأولى إلى درجة.
أمران يستحقان المتابعة. تقول OpenAI إن GPT-6 Cyber سيصل قريبًا إلى كل عملاء Daybreak Red، ولم تنشر أي من المختبرين عدد المتقدمين الذين قبلتهم أو رفضتهم. وعندما يصدر خيار السحابة الخاصة من Anthropic، تحقق مما إذا كانت المؤسسات المؤهلة تحصل فعلًا على الضوابط نفسها دون السجلات.