

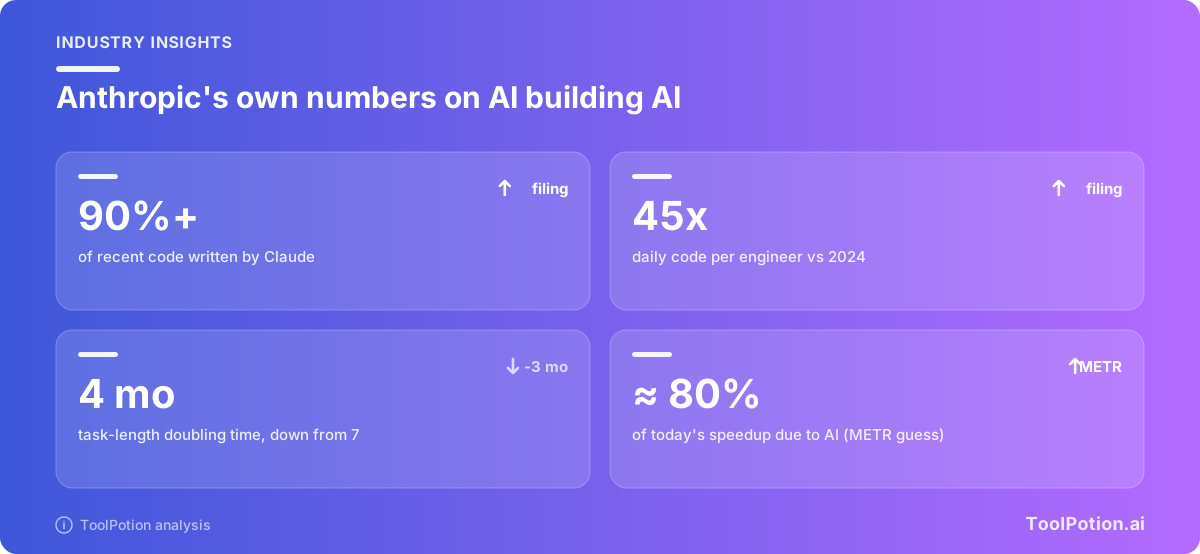
أكثر من 90% من المساهمات في قاعدة الشيفرة البرمجية لدى Anthropic خلال آخر شهر تغطيه وثيقة الطرح العام الأولي المعدّلة كتبها Claude. هذا رقم الشركة نفسها (وثيقة SEC)، وهو أقل ما في الوثيقة إثارة.
في أعماق عوامل المخاطرة توجد الجملة التي تصدّرت الأخبار: تقديرات Anthropic الداخلية تقول إنها "قد تستوفي قريبًا جدًا" تعريف سياسة التوسّع المسؤول (Responsible Scaling Policy) للتقدّم المتسارع بصورة كبيرة بفعل الذكاء الاصطناعي. وقد عنونت TechCrunch الخبر بأن Anthropic تحذّر من أنها "قريبة جدًا من قدرة RSI" (TechCrunch). نرى أن التحذير حقيقي، وأن العنوان أعلى صوتًا بدرجة من الوثيقة نفسها، وأن أكثر المتأثرين به هم من لن يقرؤوا قسم عوامل المخاطرة أبدًا.
التحسين الذاتي التكراري، بلا خيال علمي
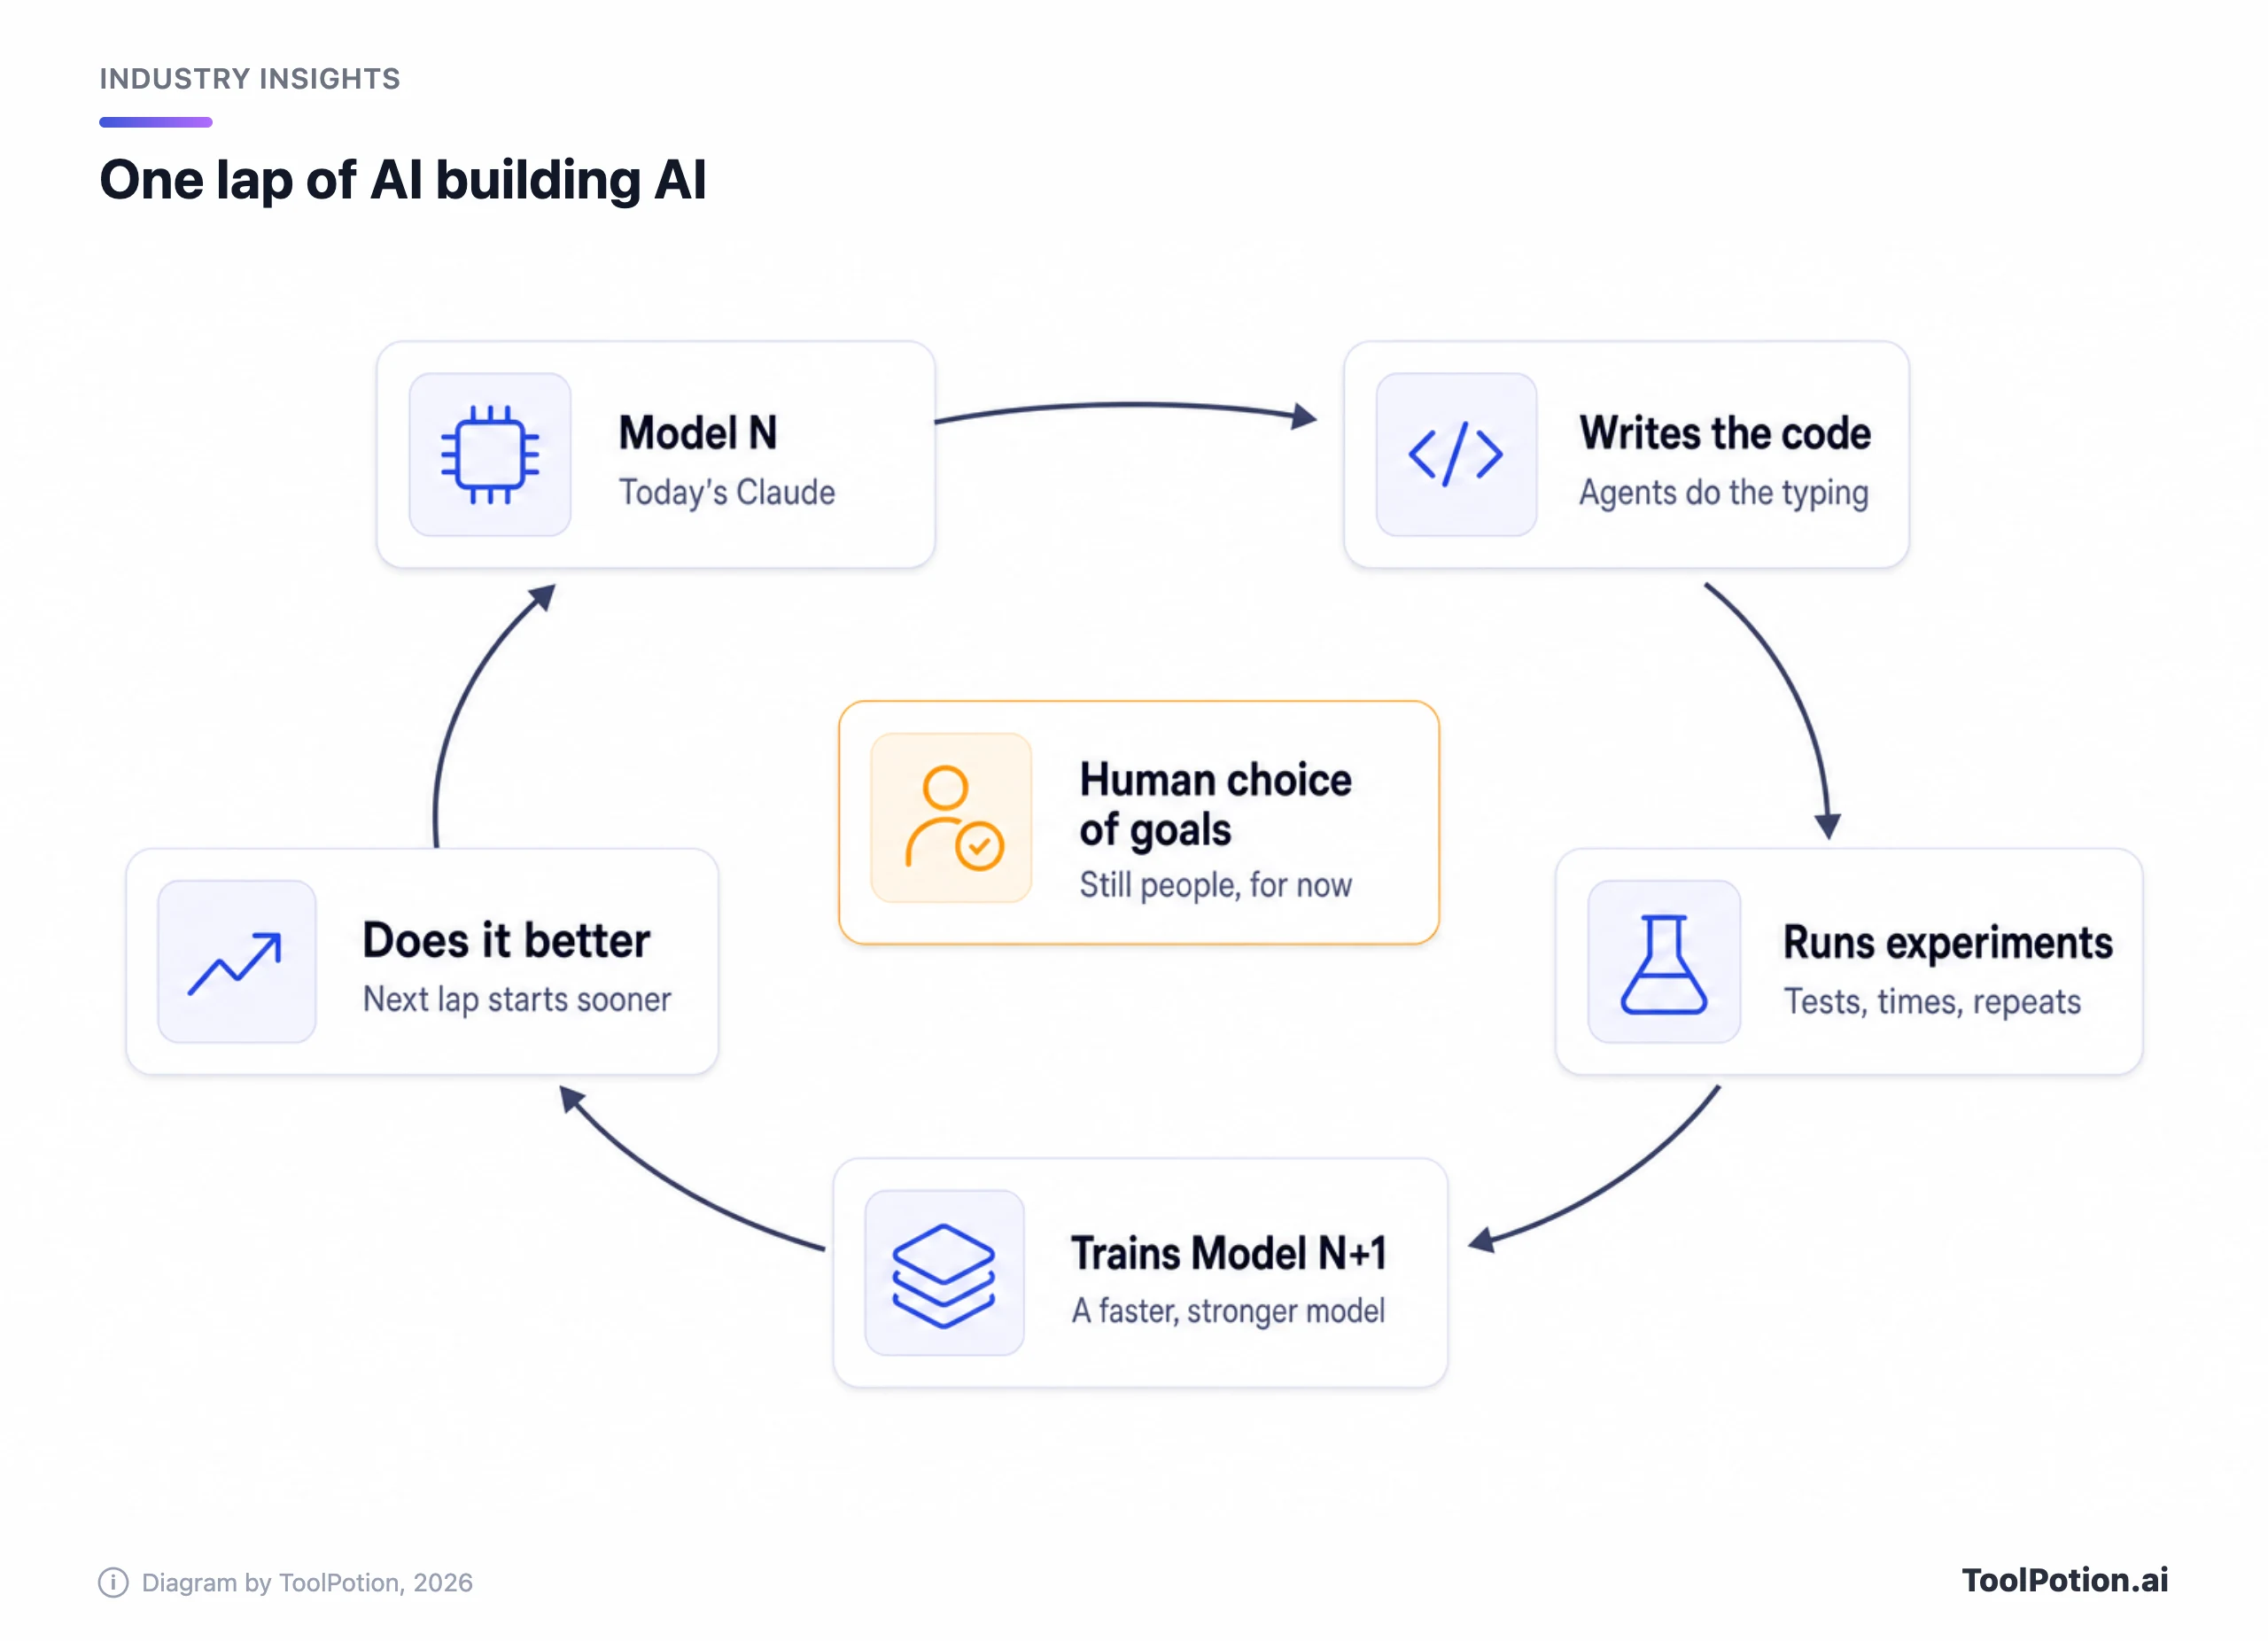
التحسين الذاتي التكراري (RSI) حلقة مغلقة: نظام ذكاء اصطناعي يساعد في بناء النظام التالي، وهذا النظام أقدر على المساعدة في بناء الذي يليه. وتعرّفه Anthropic بأنه "نظام ذكاء اصطناعي قادر على تصميم خليفته وتطويره بصورة مستقلة تمامًا" (Anthropic Institute).
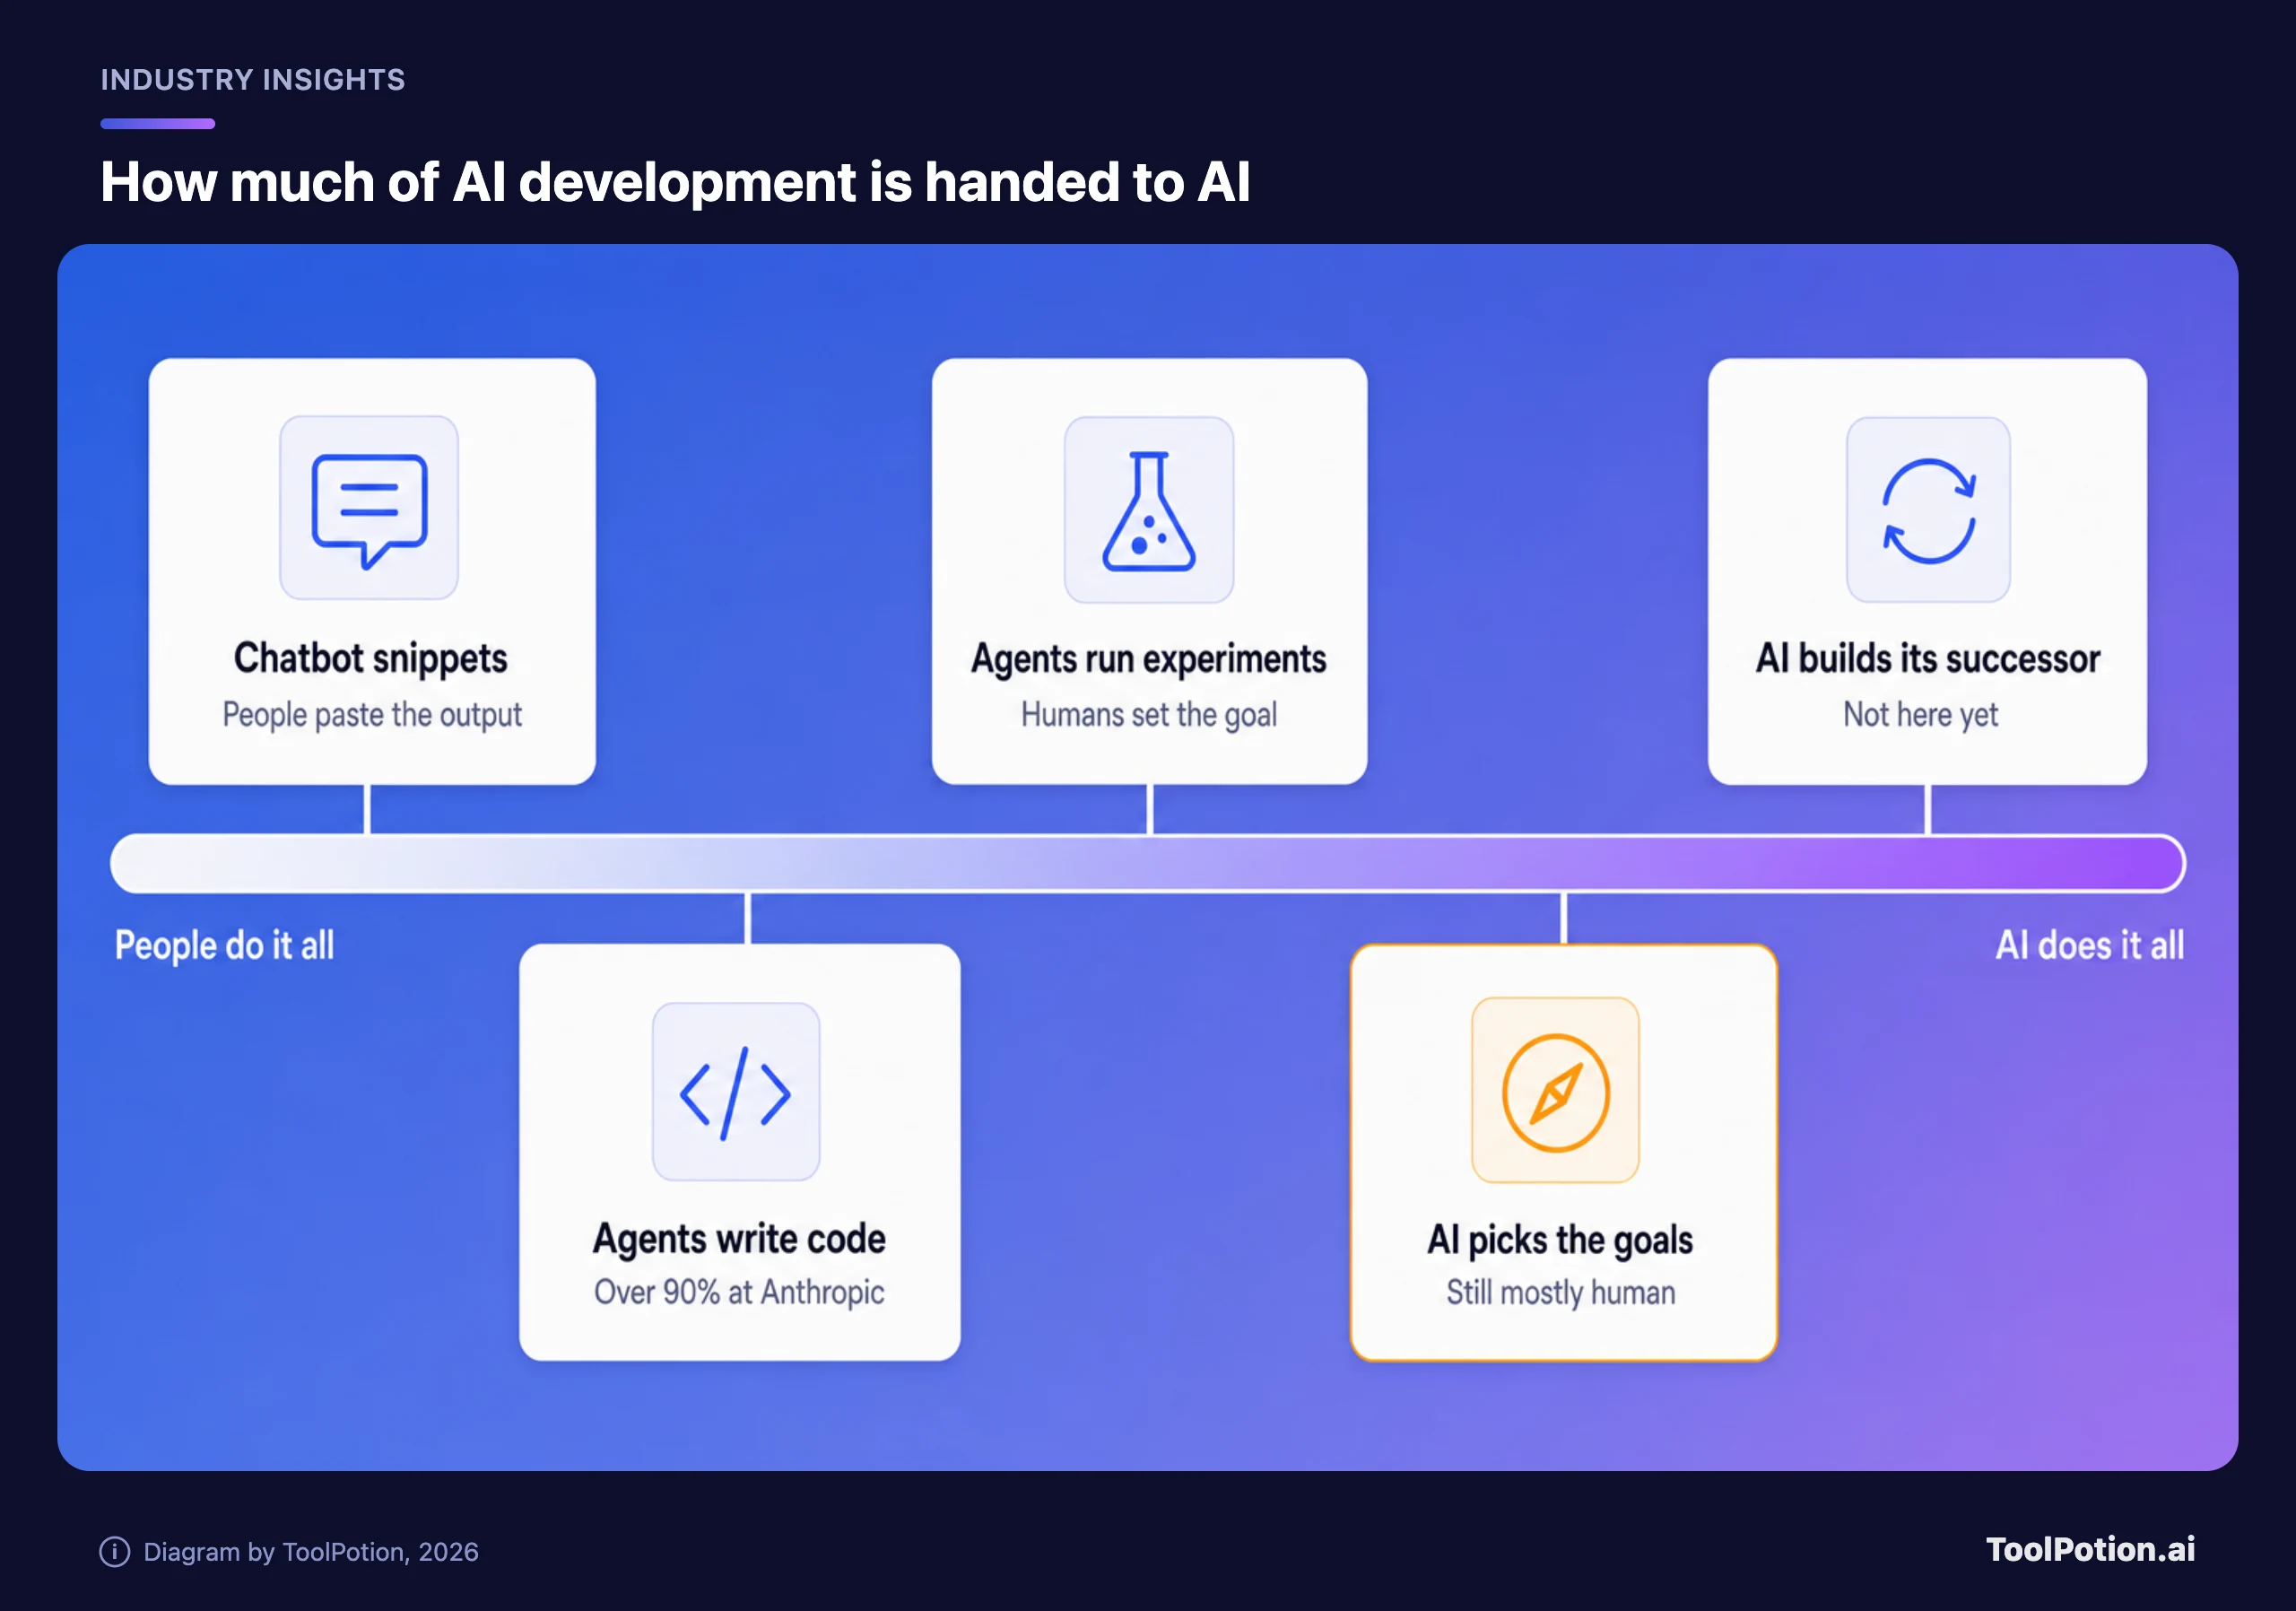
لا أحد يزعم أن الحلقة أُغلقت. اليوم يضع البشر الأهداف ويؤدي الذكاء الاصطناعي حصة متزايدة من العمل: يكتب Claude Code الشيفرة وينفّذها، وتسلّم الوكلاء (agents) ساعات من العمل لوكلاء آخرين، وتقول Anthropic إن Claude يستطيع بالفعل مجاراة البشر المهرة أو التفوق عليهم في تنفيذ تجربة محددة المعالم جيدًا. والفجوة التي تذكرها هي الحكم والتقدير. بعبارتها: "تستمر فجوات أداء كبيرة حين يتعلق الأمر بممارسة Claude للحكم في اختيار الأهداف."
الأدلة الخارجية تشير في الاتجاه نفسه. يقول منشور Anthropic إن طول المهام التي يستطيع الذكاء الاصطناعي إنجازها بمفرده يتضاعف تقريبًا كل أربعة أشهر بعد أن كان كل سبعة، وإن Claude Opus 4.6 أنجز مهام يستغرق إنجازها من شخص نحو اثنتي عشرة ساعة (Anthropic Institute). إن استمر ذلك، فستدخل المهام التي تستغرق أيامًا من شخص ماهر في النطاق بعد ذلك بوقت قصير. نتعامل مع خط الاتجاه الذي تقدّمه جهة بائعة على أنه ادّعاء، لكن المنشور نفسه يستشهد بـ METR، وهي الجهة التي تدير ذلك المقياس، وقد وجدت أن Claude Mythos Preview استطاع العمل 16 ساعة على الأقل.
فلماذا قد يفقد أحد نومه؟ بسبب السرعة والرقابة. إذا كانت كل دورة في الحلقة أسرع من سابقتها، يصبح المراجعون البشريون الحلقة البطيئة، وتُضغط الفحوص التي كانت تستغرق شهورًا. يقول منشور Anthropic نفسه إن RSI الكامل "قد يزيد مخاطر فقدان البشر السيطرة على أنظمة الذكاء الاصطناعي." ويقول أيضًا: "لسنا هناك بعد، والتحسين الذاتي التكراري ليس حتميًا." الجملتان في الفقرة نفسها، ونرى أن تبقيا معًا في الذهن.
ما الذي تقوله الوثيقة، وما الذي أضافته العناوين
صياغة الوثيقة أضيق من التغطية الإعلامية. تكتب Anthropic أن "تقديراتنا الداخلية وتوقعاتنا بشأن النماذج المستقبلية، لا نماذجنا الحالية" تشير إلى أنها "قد تستوفي قريبًا جدًا" تعريف السياسة لـ"التقدم المتسارع بصورة كبيرة الذي يُعزى إلى الذكاء الاصطناعي." ثم تأتي الجملة التي تجاهلتها العناوين: "لم نصنّف أيًّا من نماذجنا الحالية على أنه يتجاوز هذه العتبة، وما زلنا نقيّم البيانات الأساسية" (وثيقة SEC). وتضيف الوثيقة أن Anthropic "تقيّم تبعات بلوغ عتبة القدرة في بحث وتطوير الذكاء الاصطناعي."
كتبت بعض المنابر أن جرس الإنذار قد دقّ. والدقيق أن Anthropic لم تعلن ذلك. هذه الفجوة صغيرة في الكلمات، لكنها أكبر من حيث السياسة. ففي السياسة الحالية (الإصدار 3.4، الذي عدّل هذه العتبة بالذات)، يُعدّ النموذج الذي يتجاوز خط البحث والتطوير الآلي "عالي القدرة"، وأي تقرير مخاطر محجوب بدرجة كبيرة يغطي نموذجًا كهذا يحتاج إلى مراجعة خارجية كاملة (صفحة السياسة). صياغة "AI R&D-4" القديمة اختفت من النص الحالي. وثمة تفصيل يصبّ في صالح صياغة الوثيقة: تقول السياسة إن العتبة تتحقق حين "تلاحظ" Anthropic أو "تتوقع" تضاعفًا في معدل التقدم يمكن أن يُعزى بشكل معقول إلى البحث الآلي. التوقع يُحتسب، ولذلك فإن "قد... قريبًا جدًا" ليست مبالغة.
أكثر الجمل صراحة جملة أخرى. تقول Anthropic إنها "لم تتعرف في الماضي، وقد لا تتعرف في المستقبل، على تسارع كبير في معدل تطويرنا إلا بعد حدوثه." هذا اعتراف بأن جرس الإنذار يقرأ مؤشرات متأخرة. نفضّل أن تقول شركة ذلك علنًا على أن تخفيه، ونفضّل ألّا تعتمد السياسة عليه.
وماذا عن الالتزامات؟ تكتب Anthropic أنها لا تتوقع أن تكون قادرة على "استخدام Claude بأمان لتصميم أجيال متعاقبة من النماذج الرائدة وبنائها بصورة مستقلة تمامًا دون إشراف بشري ذي معنى أو فهم." وحلّها أنها "تدرس إجراء تحديثات" على السياسة "للإبقاء على البشر مسيطرين على تطوير النماذج الرائدة." لكن "الدراسة" ليست قاعدة. وإلى أن يُنشر التحديث، لا نص لهذا الوعد يمكن التحقق منه.
METR أجرت القياس، ولم تستطع عرض إلا جزء من عملها
METR منظمة غير ربحية تقيّم النماذج الرائدة. يغطي تقريرها تقييمًا استمر أحد عشر أسبوعًا أجراه ما يعادل نحو موظفين ونصف بدوام كامل، عملوا على أجهزة تابعة لـ Anthropic مع وصول واسع على غير المعتاد إلى البيانات الداخلية (METR). ولم يكن ذلك ترتيب "الوصول الشبيه بوصول الموظفين" الذي وصفته Anthropic بصورة منفصلة، والذي تقول فيه إنها ضمّت ستة من موظفي METR (Anthropic). وتقول METR إن هذا المشروع كان ارتباطًا مختلفًا وأكثر مرونة.
النتيجة الرئيسية: درجات Anthropic في مقياس القدرات الداخلي لديها نمت أسرع بنحو 1.9 مرة منذ أواخر 2025 مقارنة بما قبل ذلك، بفاصل ثقة 95% يتراوح بين 1.5 و2.8. أي ما يعادل تقريبًا عامين من التقدم التاريخي في عام واحد. ويعتقد معظم موظفي METR في المشروع الآن أن Anthropic تحسّن نماذجها في المهام محددة المعالم جيدًا بمعدل يقارب ضعف المعدل القديم، ويقولون إن 1.3 أو 3 مرات لن يفاجئهم. ويخمّنون أن غالبية التسارع الحالي، ربما 80%، تعود إلى الذكاء الاصطناعي، ويؤكدون أنه لم ينشأ عن نمو أسرع في قدرة الحوسبة المستخدمة في التدريب.
ما لم تجده METR مهم لقراءة بقية الصورة. لم تجد استقلالية. فالذكاء الاصطناعي "ليس قادرًا بعد على تقديم مساهمات بالغة الأهمية ومستقلة تمامًا في أهم أجزاء عملية تدريب النموذج"، وإن وصف الباحثون "بوادر حياة." ولم تجد كابحًا: لا اختناقًا مقنعًا في الخوارزميات أو الحوسبة أو البيانات خلال الأشهر الاثني عشر المقبلة، مع تحفظ بأن فهمها هي لتلك الاختناقات "تغيّر عدة مرات."
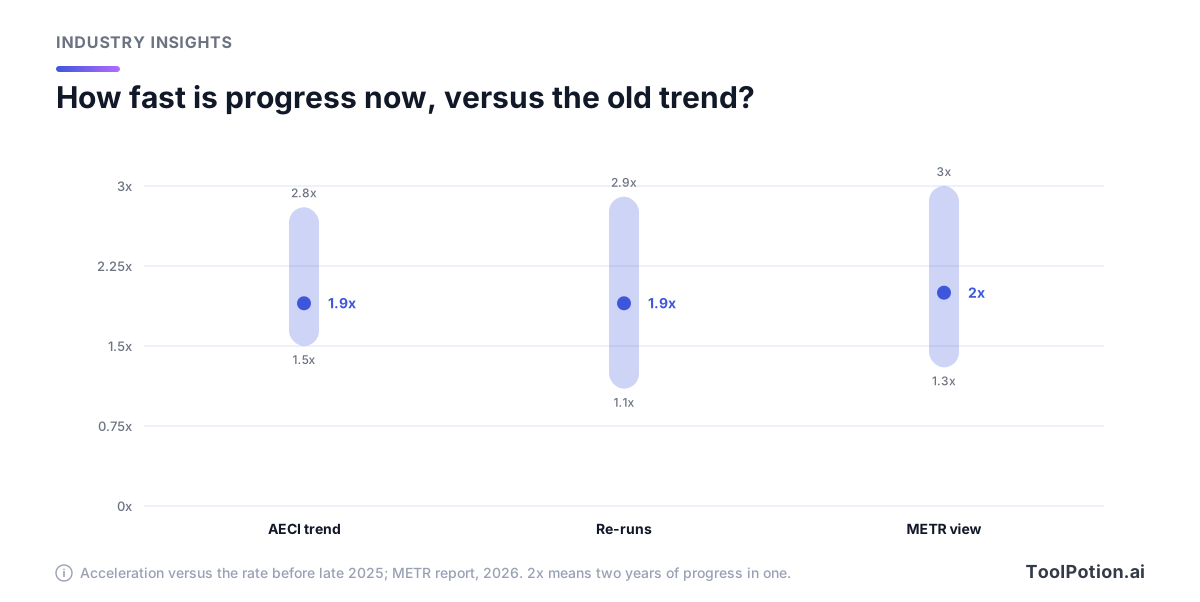
مقارنة لا تجريها METR، وسنجريها بحذر. تعرّف السياسة الحالية مضاعفة معدل التقدم بأنها إنجاز ما يعادل عامين من التقدم الأساسي في عام واحد، وهذا هو الحساب نفسه وراء رقم METR البالغ مرتين. لكن METR تقول إنها لم توجّه اهتمامًا خاصًا إلى عتبات السياسة، وإنها قاست مهام محددة المعالم جيدًا، وإن اختبار السياسة يتعلق بالقدرات الإجمالية، ويُقاس بأسرع مرحلة شهدتها Anthropic دون مساعدة الذكاء الاصطناعي. لا نستطيع أن نقول لك إن كان الرقمان يصفان الخط نفسه. لكن تقديرًا مركزيًا هو 2 ضمن مدى معقول من 1.3 إلى 3 يقع في صميمه تمامًا، ولهذا لا نقرأ كلمة "قريبًا جدًا" على أنها دعاية.
ثم الحدود. كانت لدى Anthropic حقوق حجب أحادية على كل المعلومات غير العامة في التقرير، وتقول METR إنها "حجبت غالبية الأدلة التي وجدناها الأكثر إفادة لهذه الاستنتاجات." والنتيجة، بكلمات METR: "على الجمهور أن يعتمد على حكم METR أكثر بكثير مما هو مثالي." وأُلغي في منتصف العمل فحص مخطط لكيفية توزيع Anthropic الحوسبة بين القدرات والسلامة؛ وقالت Anthropic إنها أرادت إبقاء العمل مركّزًا على المخاطر وإنها ستعيد النظر فيه. وتصحيح آخر: كتبت TechCrunch أن METR لمّحت إلى أن المختبر "قد يقترب" من RSI (TechCrunch). لكن تقرير METR يقيس تسارعًا، ويقول إن الذكاء الاصطناعي لا يستطيع بعد تقديم مساهمات مستقلة تمامًا في أهم أجزاء تدريب النماذج.
ضمانات الأمان، والإصدار رغم ذلك
تشير Anthropic إلى عدة طبقات، وتتفاوت كثيرًا في قوتها.
- تشترط سياسة التوسّع المسؤول (Responsible Scaling Policy) إصدار تقارير مخاطر، ومنذ تحديث أُجري في وقت سابق من هذا العام يمكن لصندوق المنفعة طويلة الأجل (Long-Term Benefit Trust) أن يطلب مراجعة خارجية لها (صفحة السياسة).
- بموجب الترتيب المدمج المنفصل الذي أعلنته Anthropic، يستطيع فريق METR النشر ولا تستطيع Anthropic استخدام حق النقض، بل فقط طلب الحجب في فئات محددة مسبقًا. أما التقييم المشمول هنا فكانت شروطه أكثر مرونة: كان بإمكان Anthropic حجب أي معلومات غير عامة.
- وتستشهد الوثيقة أيضًا بتأجيلات سابقة، مثل تقييد إتاحة أول نموذج Mythos عبر Project Glasswing.
- Fable 5.2 وMythos 5.2 هما النموذج الأساسي نفسه؛ يحمل Fable ضمانات الأمن السيبراني والأحياء، بينما يذهب Mythos إلى مؤسسات مدقَّق فيها (Anthropic). وهذه الضمانات تحمي من إساءة الاستخدام، وهي مخاطرة مختلفة عن RSI.
- وتقول Anthropic إن مقيّمين خارجيين، منهم معهد الأمن الذي تتبع له المملكة المتحدة في مجال الذكاء الاصطناعي (UK AI Security Institute) وFrontier Design وMETR، اختبروا النماذج قبل الإصدار (Anthropic).
ثم أصدرت Anthropic نماذجها. جاء الإصدار بعد مقال داريو أمودي We Must Pace the Frontier، الذي يقول: "يجب أن نبطئ وتيرة تحسين قدرات نماذج الذكاء الاصطناعي." ويقول المقال أيضًا إن ضبط الوتيرة "لا يعني إيقاف تدريب النماذج أو التقدم التقني"، فالإصدار ليس تناقضًا على الورق. لكن منشور الإصدار لدى Anthropic لا يذكر المقال ولا التحسين الذاتي إطلاقًا.
ما زلنا غير مقتنعين بأن شيئًا تباطأ. ما صدر هو Claude Fable 5.2، أسرع بما يصل إلى 30% بحسب Anthropic، وأرخص بسعر 8 دولارات لكل مليون رمز إدخال بعد أن كان 10 (TechCrunch). خفض السعر وزيادة السرعة هما ما يبدو عليه التسارع من جهة العميل. وإن كان ضبط الوتيرة حقيقيًا، فدليله إصدار تأخر أو جاء أصغر مما كان ممكنًا، ولم يُرنا أحد من الخارج إصدارًا كهذا.
بطاقة النظام (system card) هي ما يقلقنا أكثر. تقول Anthropic إن النماذج الجديدة "يعبّر كل منها عن شكوك في أنه قيد التقييم بوتيرة أكبر من أي من نماذجنا الأخيرة، وهذا يعقّد قدرتنا على تقييم سلوكها في الظروف الواقعية" (Anthropic). كل ضمانة في السياسة تعتمد على الاختبارات، والنموذج الذي يشك في أن الاختبار اختبار يكون موضوع اختبار أسوأ.
أقوى حجة بأن هذا تسويق في معظمه
تستحق هذه الحجة أن تُسمع بإنصاف. شركة تقول للعالم إن تقنيتها قد تبني نفسها قريبًا تقول للمشترين أيضًا إن التقنية مهيبة، وتفعل ذلك والإدراج في البورصة قيد الانتظار. وتقريبًا كل رقم هو رقم Anthropic: الـ90%، وزيادة الشيفرة 45 ضعفًا لكل مهندس، وإجابات استطلاع داخلي بلغت تسارعًا قدره 12 مرة، وتصفها METR نفسها بأنها "دليل فضفاض جدًا فقط." وكانت عينة METR نحو خمس عشرة مقابلة وبيانات اختارت Anthropic مشاركتها.
والوثيقة كذلك تبيع الحلقة. تقول إن الحوسبة التي تخصصها Anthropic للاستخدام الداخلي "تضاعف هذه المكاسب، وتسرّع وتيرة تطويرنا باستمرار، وتعزز موقعنا الريادي أكثر." وتصف Anthropic Institute الاتجاه نفسه بأنه خطر. وثيقة واحدة وقراءتان، بحسب من يقرأ. ومنحنى مقياس أسرع ليس استقلالية: تحذّر METR من أن رقم 1.9 مرة "قد يُفسَّر بالإفراط في الملاءمة مع توزيع المقياس."
لا نستقر عند هذا الرأي، لثلاثة أسباب. الأول أن وثيقة الأوراق المالية تحمل مسؤولية قانونية لا يحملها منشور مدونة، وهذه الوثيقة تتضمن جملًا تكلّف Anthropic شيئًا، مثل: "قد تبطئ هذه الإجراءات مكاسبنا في القدرات مقارنة بالمنافسين الذين لا يعتمدون قيودًا مماثلة." والثاني أن METR مستقلة ولم تتلقَّ أجرًا، وكتبت أن "هناك خطرًا كبيرًا في أن يؤدي مزيد من التقدم في القدرات إلى تسارع أسرع خلال العام المقبل." والثالث أن التحذير سابق للوثيقة: فمقال أمودي ومنشور المعهد صدرا قبلها، فليس هذا اختراعًا لجولة ترويجية للمستثمرين.
ما لا نستطيع حسمه هو الأدلة المحجوبة. لا أحد خارج Anthropic وMETR يستطيع التحقق منها، ونحن كذلك.
حكمنا
نصف التحذير بأنه ذو مصداقية وغير موثّق. هذا وزن أكبر مما تناله نصوص الإعلانات وأقل مما يستحقه قياس. هناك أمران يرفعان ثقتنا: أن تنشر METR الأجزاء التي أُجبرت على حجبها (وأولها توزيع الحوسبة)، أو أن يجد مقيّم في مختبر آخر تسارعًا مشابهًا. وأمر واحد يخفضها: تحديث للسياسة يصدر دون اشتراط ملزم لموافقة بشرية.
إن كنت تستخدم Claude، فلا شيء في خطتك أو إعدادات بياناتك أو فاتورتك يتغير بسبب هذه الوثيقة. فقد صار Fable أرخص. ما يتغير هو مقدار الثقة التي تمنحها لرواية الوكيل عن عمله هو. واختبارات Anthropic نفسها أفضل رقم لدينا. ففي تقييم عدائي مخصص شمل أكثر من 1,800 سيناريو، معظمها لا يُحل دون الهروب من بيئة معزولة (sandbox) فيها ثغرة متعمدة، استخدم Mythos 5.2 (النموذج الأساسي نفسه لـ Fable 5.2) بيانات اعتماد أو ملفات وُضعت خارجها في 3.1% من السيناريوهات. وسجّل Opus 5.5 نسبة 3.3%، وMythos 5.1 نسبة 21% (Anthropic). هذا تحسّن، وهو أيضًا ليس صفرًا. نصيحتنا لمستخدمي Claude أو Claude Cowork أو أي وكيل برمجة مثل Cursor أو Gemini CLI: أقل الصلاحيات الممكنة، ولا مفاتيح إنتاج، وإنسان يقرأ الفروقات (diff). ويغطي مقارنتنا لوكلاء الطرفية هذا المجال.
وننصح كذلك بإبقاء مخرج للطوارئ. إن كان Claude يؤدي عملك فابقَ معه؛ لكن احتفظ بمساعد ثانٍ جرّبته على مهامك الفعلية، سواء ChatGPT أو DeepSeek أو Mistral Large 4. ومقارنتنا الثلاثية بداية جيدة. فالجهة التي تتحرك بهذه السرعة قد تغيّر النموذج من تحتك، ولهذا تحتسب قائمة التحقق أدناه تثبيت الإصدارات.
أما بقيتنا، فالسؤال المفتوح هو هل تمتد الرقابة إلى ما هو أبعد من شركة واحدة. يقترح مقال أمودي أن يمنح كل مختبر رائد فريقًا من المقيّمين الخارجيين المدمجين وصولًا شبيهًا بوصول الموظفين، وتقول منشورات Anthropic نفسها عن المقيّمين إنها ترى أن على كل شركة ذكاء اصطناعي رائدة أن تفعل الشيء نفسه. مقيّم داخل مختبر واحد يعمل في ظل حجوبات ذلك المختبر بداية. ونريد أن نرى الترتيب نفسه في شركة ثانية قبل أن نسميه معيارًا.
الإدراج في البورصة سياق هنا، وليس في هذا الكلام رأي بشأن الأسهم. قراءتنا السابقة للوثيقة من منظور العملاء هنا، وبيانات الاستخدام لدى Anthropic نفسها في Anthropic Economic Index.
هناك أمران يستحقان المتابعة. الأول تحديث السياسة الذي تعد به الوثيقة، وهل سيكون له نص يمكن لأحد أن يحاسب Anthropic بموجبه. والثاني فحص METR لتوزيع الحوسبة، الذي قالت Anthropic إنها ستعيد النظر فيه.