

عبارة «في المركز الأول على لوحة التصنيف» صحيحة بالنسبة إلى اختبار واحد محدد، أُجري بطريقة واحدة محددة، في يوم واحد محدد. أما كون هذا النموذج هو الأفضل لعملك أنت، فهي تقول عنه أقل بكثير. قبل أن تبدّل أداتك أو تدفع ثمن باقة أغلى بسبب ترتيب ما، اعرف من أي لوحة جاء، ومن الذي أجرى الاختبار، وماذا يقيس.
هذا الأمر أهم في 2026 لأن لوحات التصنيف أصبحت تجارة. فقد جمعت Arena، موقع التصنيف العام المعروف سابقًا باسم LMArena، 200 مليون دولار بتقييم 3.1 مليار دولار هذا العام، أي ما يقارب ضعف تقييمها البالغ 1.7 مليار دولار في وقت سابق من 2026 (Phemex). وتقول Arena إن إيراداتها السنوية المتوقعة تجاوزت 100 مليون دولار (Arena). كل إطلاق لنموذج جديد يبدأ اليوم بذكر ترتيبه، والترتيب يبيع.
لا يعني هذا أن اللوحات مزيفة. معظمها من إعداد أشخاص جادين، وهي تقيس شيئًا حقيقيًا. المشكلة أن كل لوحة تقيس شيئًا مختلفًا، وأن منشور الإطلاق يقتبس اللوحة التي تُظهر النموذج في أفضل صورة. يشرح هذا الدليل كيف تعمل اللوحات الرئيسية، وأين تنحرف كل واحدة منها، وكيف تقرأ أي ادعاء في دقيقتين تقريبًا.
أربعة أنواع من اللوحات، وأربعة أسئلة مختلفة
تنتمي معظم التصنيفات التي ستصادفها إلى أربع مجموعات. والمجموعة أهم من أي لوحة بعينها، لأن الرقم لا يعني شيئًا حتى تعرف المجموعة التي جاء منها.
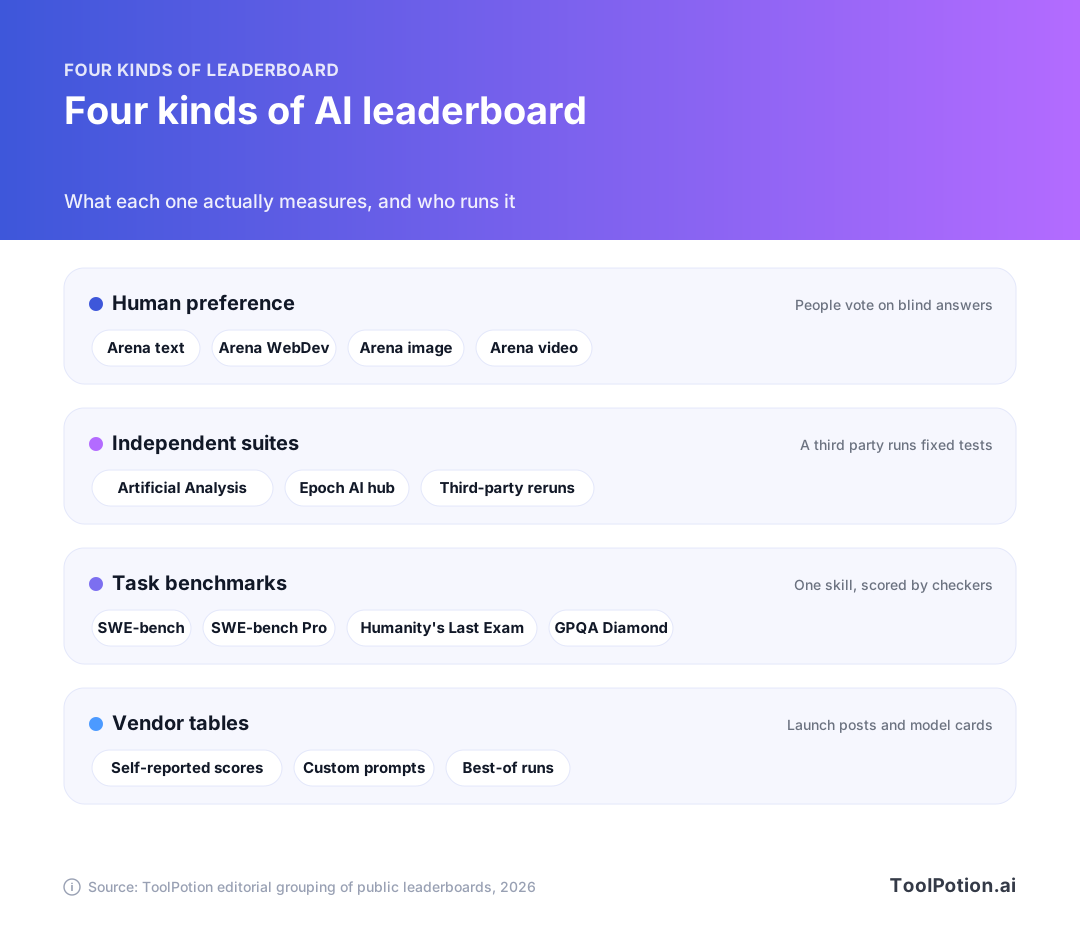
ساحات تفضيل البشر تسأل الناس عن الإجابة التي تعجبهم أكثر. المجموعات المستقلة تشغّل مجموعة ثابتة من الاختبارات على كل نموذج في الظروف نفسها. اختبارات المهام تفحص مهارة واحدة، مثل إصلاح أخطاء برمجية حقيقية، بمصحّح آلي. أما جداول الشركات المطورة فهي الدرجات التي يطبعها المختبر في منشور الإطلاق أو بطاقة النموذج، وغالبًا بإعدادات اختارها هو.
هذه المجموعات لا تتنافس بقدر ما تجيب عن أسئلة مختلفة. التفضيل يخبرك بالنموذج الذي يستمتع الناس بالحديث معه. والمجموعة المستقلة تخبرك كيف تتقارن النماذج حين يمسك طرف محايد بالساعة. واختبار المهمة يخبرك هل يستطيع النموذج أداء عمل ضيق واحد. وجدول الشركة يخبرك بما تريد الشركة أن تلاحظه.
| نوع اللوحة | مثال | ما الذي تقيسه | نقطة الضعف الرئيسية |
|---|---|---|---|
| تفضيل البشر | Arena للنصوص وWebDev | الإجابة التي يصوّت لها الناس | تكافئ الأسلوب والطول، ويمكن التلاعب بها |
| مجموعة مستقلة | Artificial Analysis ومركز Epoch AI | درجات على مجموعة اختبارات ثابتة | جودتها من جودة الاختبارات التي اختارتها |
| اختبار مهام | SWE-bench وHumanity's Last Exam | مهارة واحدة بتصحيح آلي | التلوث، والمهام المعيبة، والتشبع |
| جدول الشركة المطورة | منشورات الإطلاق وبطاقات النماذج | ما اختار المختبر الإبلاغ عنه | إعدادات وprompts لا يمكنك التحقق منها |
كيف يتحول تصويت في الساحة إلى تقييم
بدأت Arena باسم Chatbot Arena، وهو مشروع بحثي في جامعة كاليفورنيا في بيركلي. الفكرة بسيطة: تكتب prompt، فيجيب نموذجان مجهولان، وتختار الرد الأفضل. وتصف الورقة البحثية الأصلية منصة جمعت أكثر من 240,000 صوت في أشهرها الأولى، ووجدت أن أصوات الجمهور تتفق جيدًا مع أحكام الخبراء (arXiv).
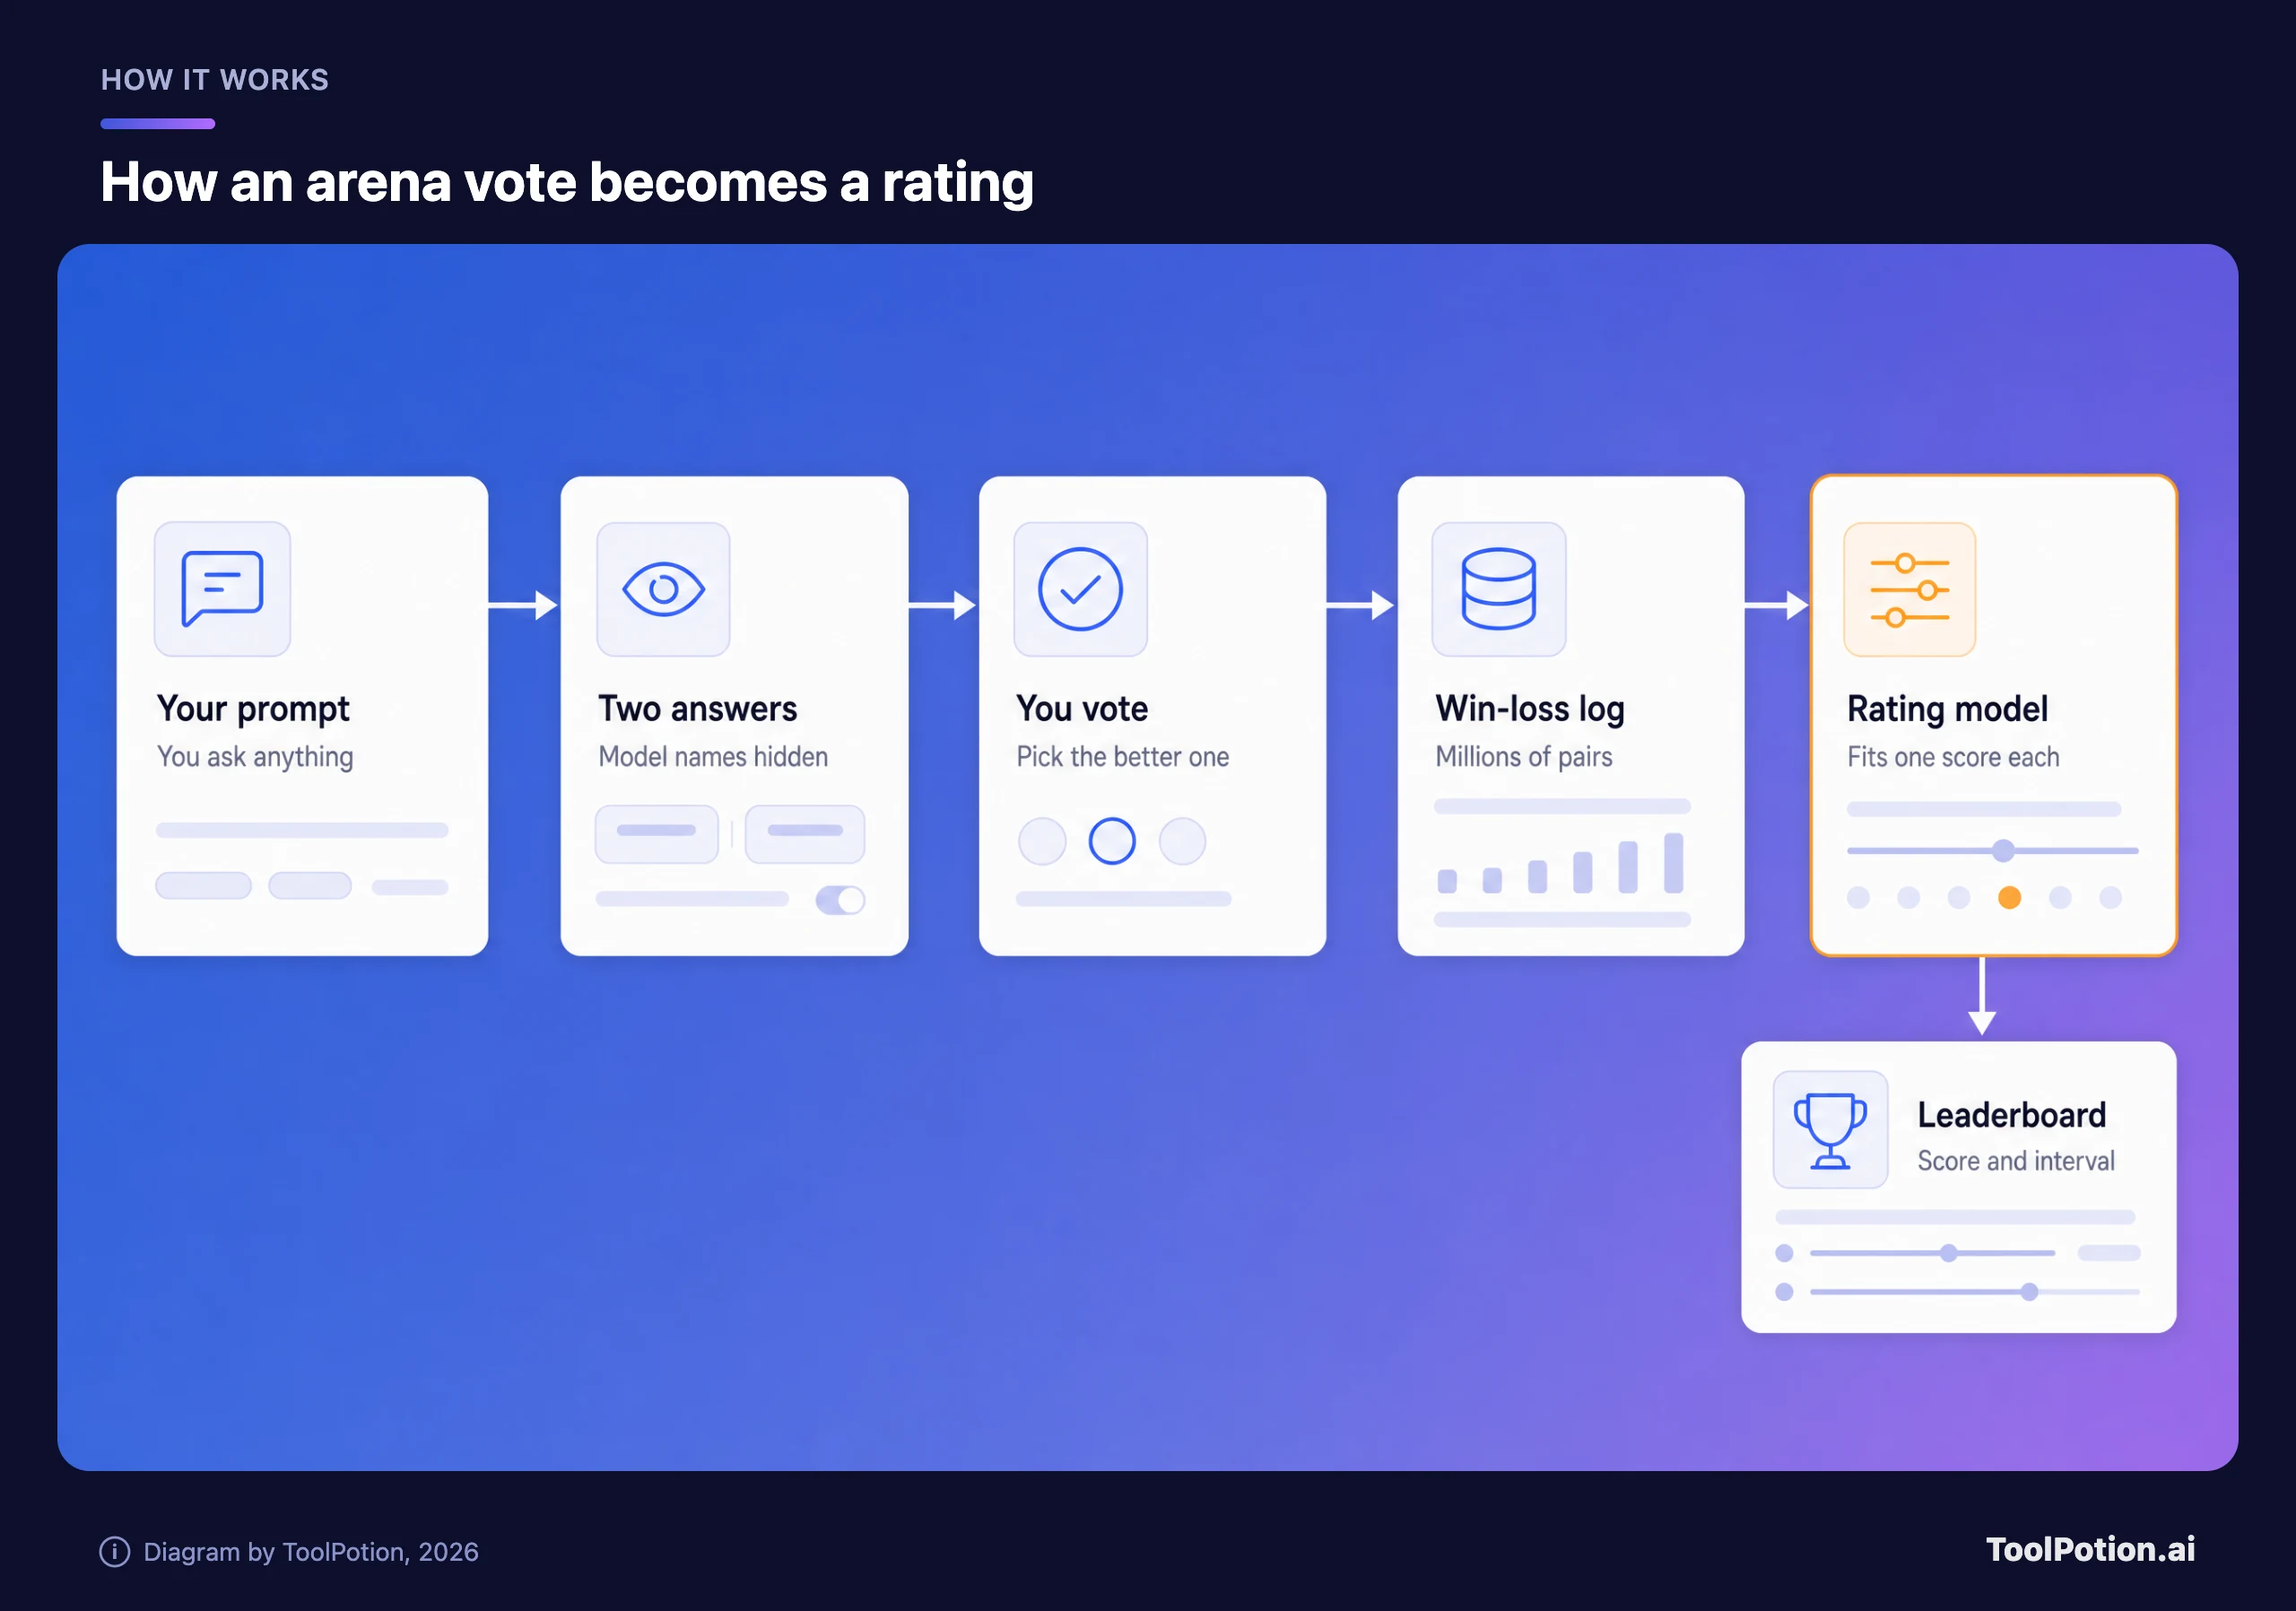
كل تصويت سجل صغير: النموذج A تفوق على النموذج B في هذا الـ prompt. وتدخل ملايين هذه السجلات في نموذج إحصائي يعطي كل نموذج درجة واحدة. وتصف كتابات Arena نفسها الطريقة بأنها انحدار Bradley-Terry، وهو قريب من نظام Elo المستخدم في الشطرنج (LMSYS). ترتفع درجة النموذج حين يتغلب على خصوم أقوياء وتنخفض حين يخسر أمام ضعفاء، وتعرض لوحة النصوص هامشًا بجانب كل درجة (رقم «±»)، لا القيمة التقديرية وحدها.
هذا الهامش هو الجزء الذي تتجاهله منشورات الإطلاق. فإذا كان نموذجان يفصل بينهما بضع نقاط وتتداخل هوامشهما، فالقراءة الأمينة أنهما متعادلان. و«المركز الأول» القائم على فارق نقطتين أو ثلاث هو في الغالب رمية عملة إحصائية.
وقد توسعت Arena كثيرًا خارج المحادثة. فلوحتها تضم الآن لوحات منفصلة للنصوص وWebDev والرؤية والبحث وتوليد الصور وتحريرها والفيديو، ولوحة أحدث للوكلاء تعرض التكلفة لكل مهمة بجانب نسبة الفوز (Arena). وعمود التكلفة يستحق القراءة. فنموذج يتقدم مركزًا واحدًا بسعر أعلى بعدة أضعاف هو توصية مختلفة.
ما لا تستطيع الساحة إخبارك به
للتصويت على التفضيل ثلاث مشكلات موثقة جيدًا. الأولى الأسلوب. فالناس يحبون الإجابات الطويلة المنسقة جيدًا، ولذلك قد يصعد النموذج بمجرد أن يكتب أكثر ويضيف عناوين. وقد وجد تحليل فريق Arena نفسه أن طول الإجابة هو أقوى تأثير للأسلوب، وأن تصحيح أثر الطول والـ markdown غيّر ترتيب النماذج. ففي ذلك التحليل من 2024 هبط GPT-4o-mini من المركز السادس إلى الحادي عشر، بينما صعد Claude 3.5 Sonnet من السادس إلى الرابع (LMSYS). وتقدم Arena الآن عروضًا مضبوطة الأسلوب، ومن المفيد استخدامها.
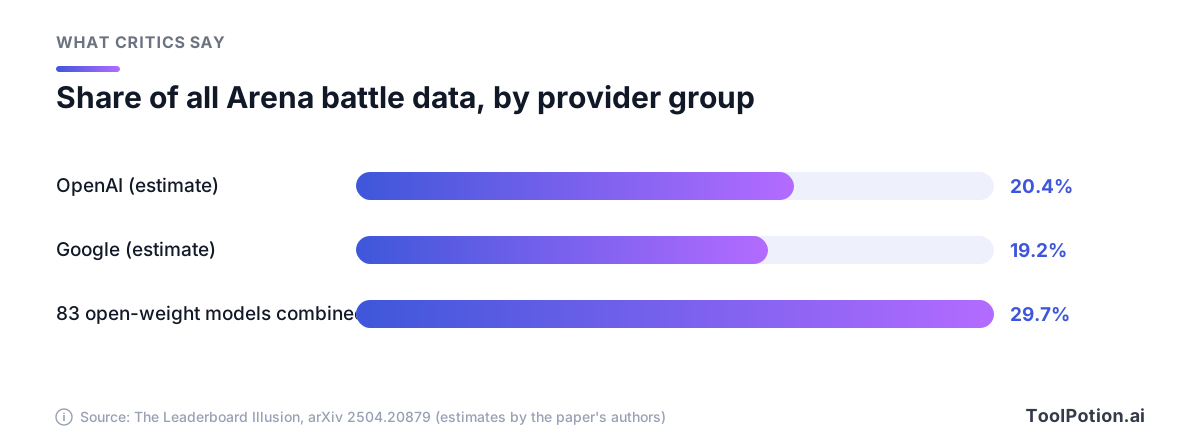
المشكلة الثانية هي الوصول. فقد ذهبت ورقة من 2025 بعنوان «The Leaderboard Illusion»، من بين مؤلفيها Sayash Kapoor وNoah Smith، إلى أن المختبرات الكبرى حصلت على مزايا بنيوية في Arena. وذكرت أن Meta اختبرت 27 نسخة خاصة من النموذج قبل إطلاق Llama 4 ولم تنشر إلا أفضل درجة، وقدّرت أن Google وOpenAI حصلتا على نحو 19.2% و20.4% من كل بيانات Arena، بينما حصلت 83 نموذجًا مفتوح الأوزان مجتمعة على نحو 29.7% (arXiv).
وذكرت الورقة أيضًا أن التدريب على بيانات شبيهة ببيانات Arena قد يرفع الأداء على توزيع Arena بما يصل إلى 112%، وهذا حافز للضبط من أجل اللوحة لا من أجل القدرة العامة. وهذه تقديرات المؤلفين وادعاءاتهم، وتعكس صورة لحظية من وقت كتابة الورقة. ومع ذلك تبقى أوضح وصف خارجي لكيفية التلاعب بلوحة تفضيل دون أن يخالف أحد قاعدة.
المشكلة الثالثة أن التفضيل ليس صحة. فقد تفوز إجابة واثقة وودودة بالتصويت وتحتوي مع ذلك على معلومة خاطئة. وفي الإحساس بالمحادثة والكتابة، التفضيل دليل معقول. أما في كود يجب أن يعمل أو رقم يجب أن يكون صحيحًا، فهو دليل ضعيف.
وتعالج صفحة السياسة الحالية في Arena بعض هذا. فهي تقول إن النماذج قبل الإطلاق تُختبر بأسماء مجهولة حتى تستقر الدرجات (بحد أدنى 1,000 صوت)، وإن هذه الدرجات تُشارك سرًّا مع المزوّد، وإن درجة النموذج توسم بـ«preliminary» بعد الإطلاق العام إلى أن تصل أصوات جديدة. وتقول أيضًا إن كل مواجهة تضم نموذجًا واحدًا على الأقل متاحًا للعامة، وإن 20% على الأقل من المواجهات تقتصر على نماذج عامة (Arena). والقاعدة العملية: وسم «preliminary» يعني أن الرقم لم يستقر بعد.
المجموعات المستقلة: Artificial Analysis وEpoch AI
إذا كانت لوحات التفضيل تسأل عمّا يحبه الناس، فالمجموعات المستقلة تسأل عمّا يستطيع النموذج فعله حين يخضع الجميع للاختبار نفسه. وArtificial Analysis هي الأشهر بينها. فمؤشر الذكاء لديها، وهو الآن بالإصدار 4.3.2، يجمع 10 تقييمات في أربع مجموعات: الوكلاء (30% من الوزن)، والمعرفة العامة والاستدلال (30%)، والبرمجة (20%)، والاستدلال العلمي (20%). ويُشغَّل كل نموذج في الظروف نفسها مع تقييم pass@1، أي محاولة واحدة لكل سؤال، ويقول الموقع إنه يحتفظ بنسخه الخاصة من مجموعات البيانات. وللتقييم الذاتي يستخدم لجنة من ثلاثة نماذج متقدمة من مختبرات مختلفة. والمؤشر في معظمه بالإنجليزية وللنصوص، ويقيس الموقع القدرات متعددة اللغات ومتعددة الوسائط على حدة (Artificial Analysis).
الأوزان اختيار تحريري. فلو اختلف التوزيع، بوزن أقل للوكلاء وأكبر للبرمجة، لأعاد ترتيب بعض النماذج. وهذا ليس عيبًا، لكنه يعني أن الرقم «الإجمالي» هو رأي واحد فيما يهم. فإذا كان اهتمامك الأكبر بالبرمجة، فاقرأ نتائج البرمجة لا العنوان الرئيسي.
تدير Epoch AI مركز اختبارات يجمع بين اختبارات تجريها بنفسها، مثل GPQA Diamond وFrontierMath وSWE-bench Verified، ونتائج من مصادر خارجية. وأفيد ما وجدته للقراء يتعلق بأرقام الشركات المطورة. فقد أُبلغ عن 65% لـ Claude 3.5 Sonnet على GPQA Diamond. وقاست Epoch نسبة 55% بزائد أو ناقص 3 عبر 16 تشغيلًا، ولاحظت أن المختبرات غالبًا لا تنشر الـ prompt أو درجة الحرارة التي استخدمتها (Epoch AI). وفجوة من 10 نقاط بسبب الإعداد وحده سبب وجيه لتفضيل إعادة التشغيل على يد طرف ثالث. ويموّل المركزَ معهد الأمن للذكاء الاصطناعي في المملكة المتحدة، وبياناته حرة لإعادة الاستخدام.
والاستقلال لا يعني الحياد. فالطرف الثالث لا يزال هو من يختار الاختبارات، وأي مؤشر يتضمن نماذج تعمل كحكّام يرث عادات هؤلاء الحكّام. وقد وجدت دراسة Arena نفسها عن الحكّام الآليين أن النماذج تفضّل إجاباتها هي. ففي 1,460 مواجهة في Text Arena حكم فيها 12 نموذجًا، اختار الحكّام إجاباتهم أكثر مما فعل البشر بنحو 70% (Arena).
الاختبارات تبلى
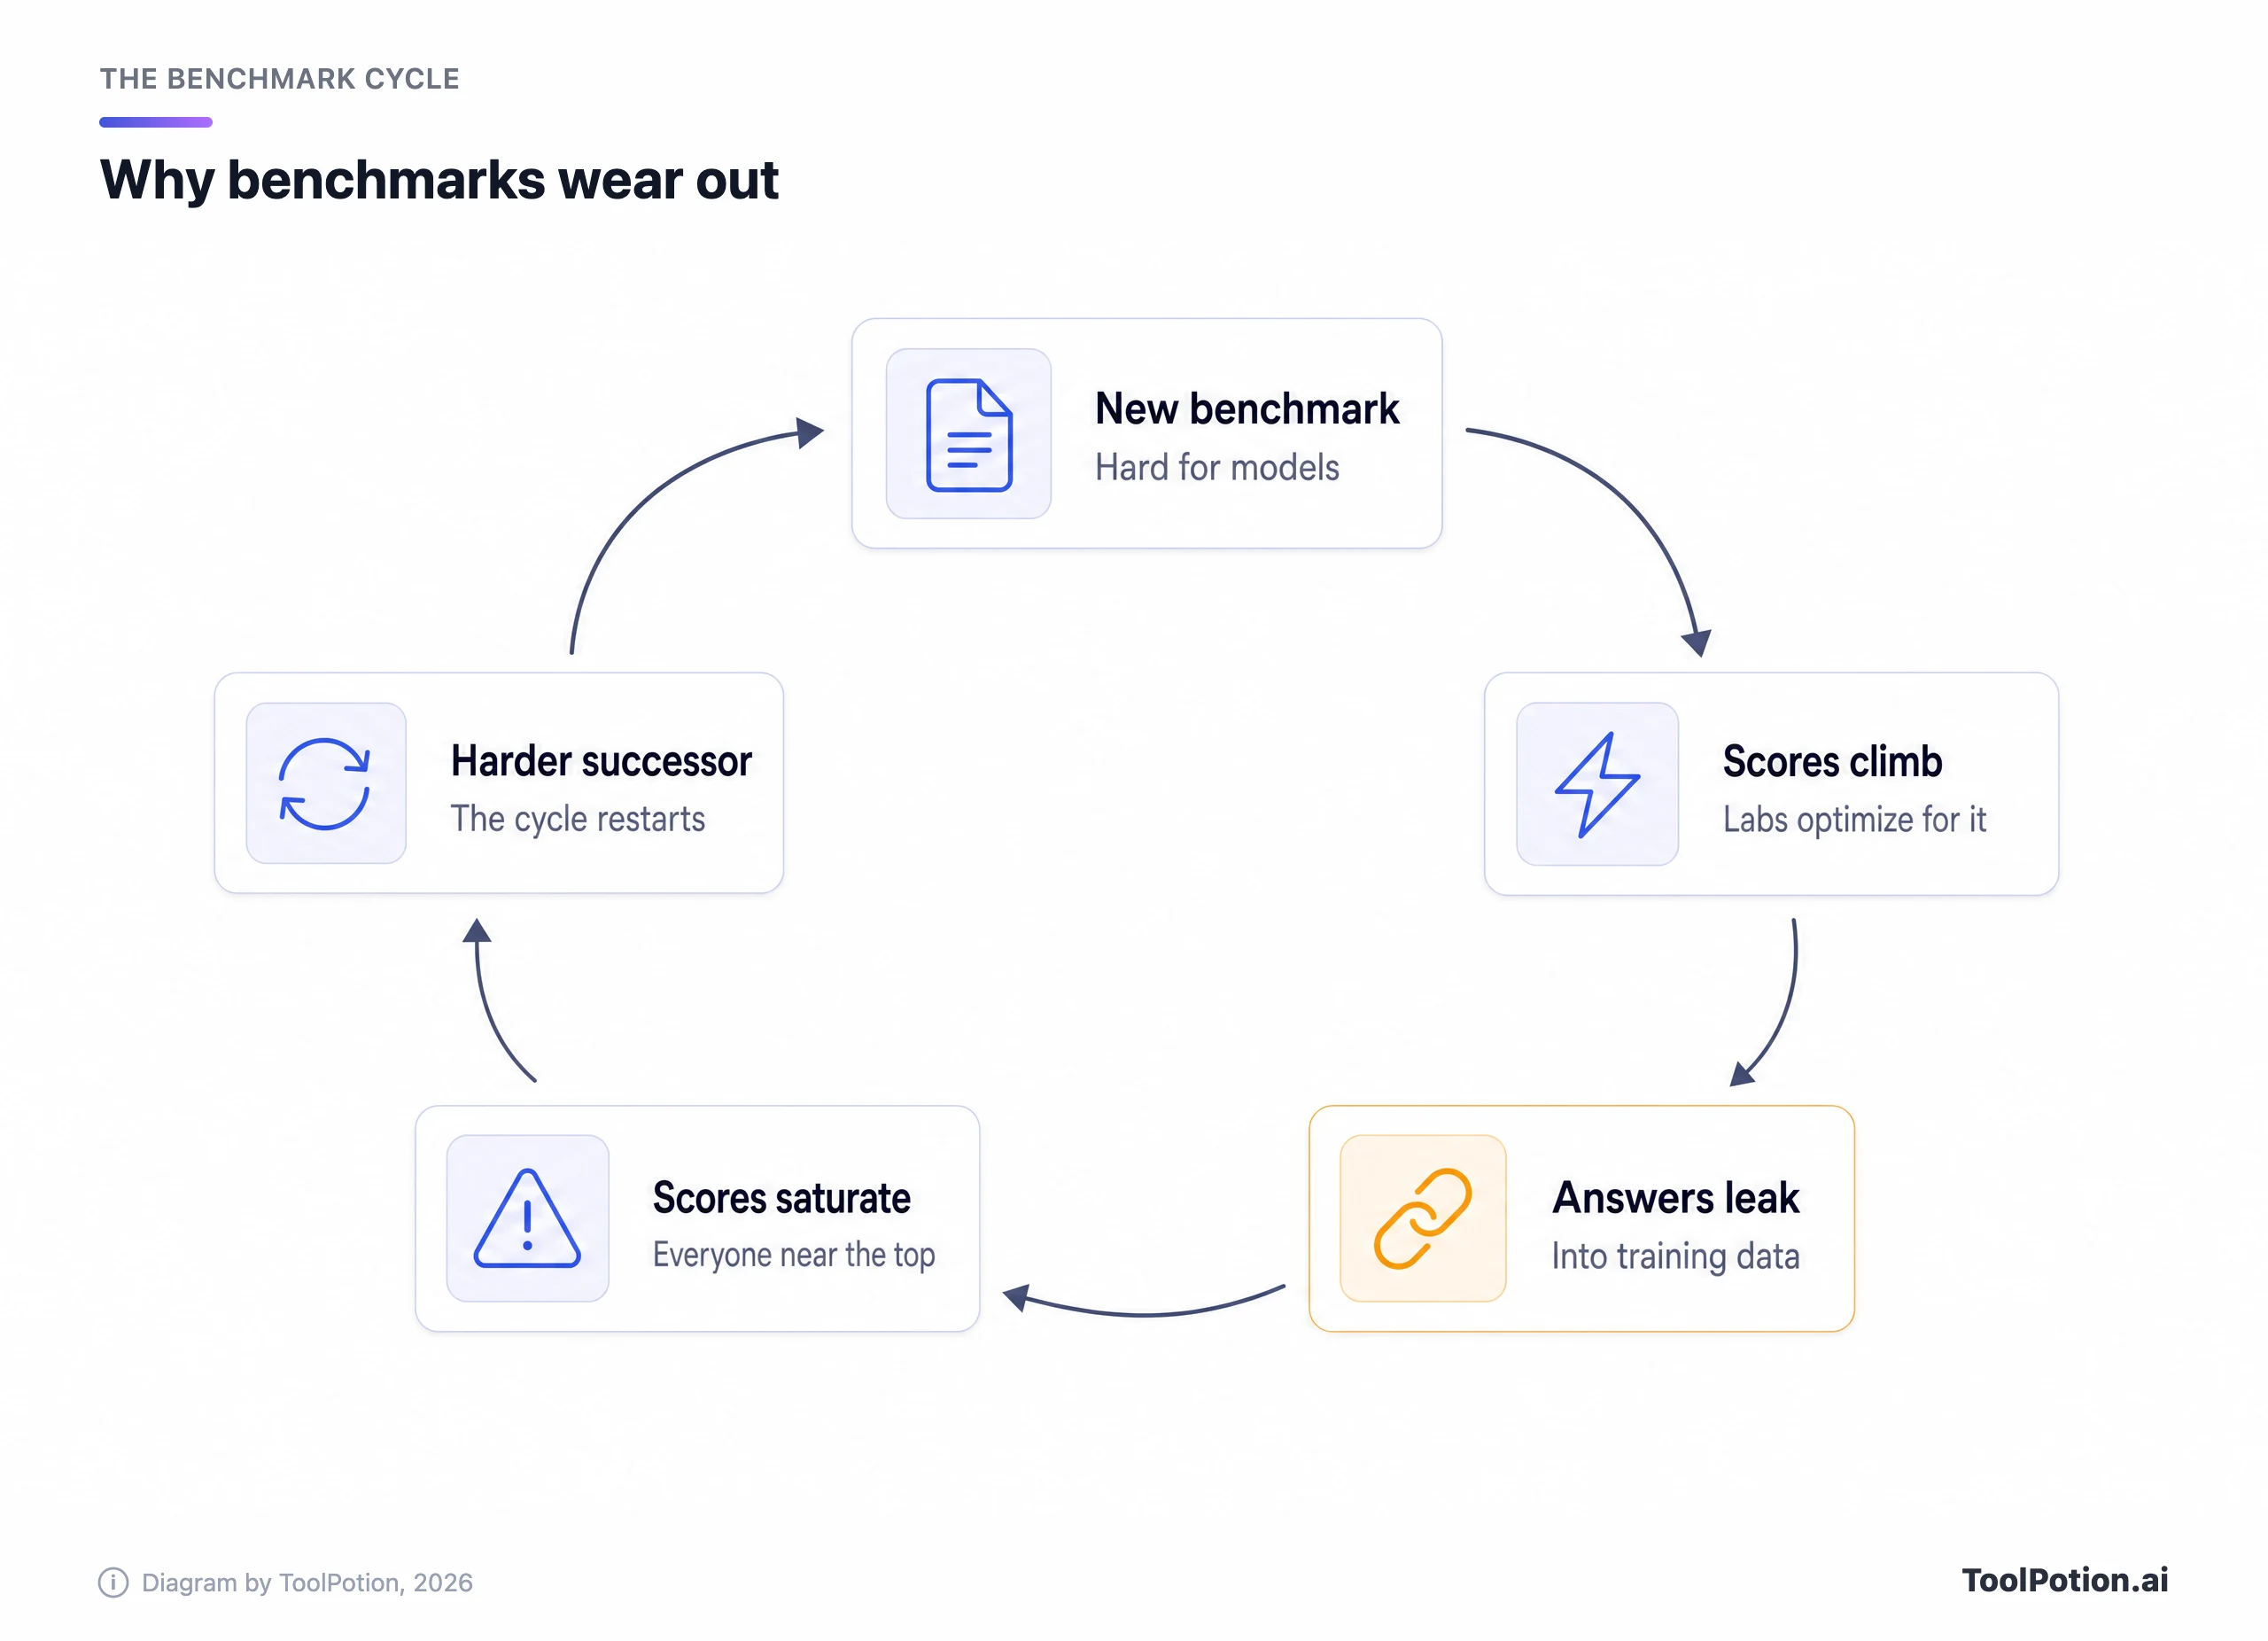
اختبارات المهام لها المشكلة المعاكسة. فهي موضوعية، لكنها تشيخ بسرعة. يُطلق الاختبار وهو صعب، وتحسّن المختبرات أداءها له، وترتفع الدرجات، ويتسرب الاختبار إلى بيانات التدريب، وسرعان ما يقف كل نموذج متقدم قرب السقف ويفقد الترتيب معناه.
Humanity's Last Exam مثال جيد على الاستجابة لذلك. فهو يضم 2,500 سؤال في أكثر من مئة مجال، كتبها قرابة 1,000 خبير من أكثر من 500 مؤسسة، ويحتفظ بمجموعة اختبار خاصة لكشف الإفراط في التكيف. وقد بناه مؤلفوه لأن اختبارات أقدم مثل MMLU تجاوزتها النماذج المتقدمة فبلغت أكثر من 90% (arXiv). ونُشر في Nature عام 2026، وحتى صنّاعه توقعوا أن ترتفع الدرجات سريعًا.
ويُظهر SWE-bench دورة الحياة كاملة. فقد ضم الاختبار الأصلي 2,294 مشكلة حقيقية من GitHub في 12 مشروع Python، وحلّ أفضل نموذج وقتها، Claude 2، نسبة 1.96% منها (بحسب الورقة الأصلية). ثم صارت مجموعة فرعية منقّحة من 500 مهمة تسمى Verified هي الرقم المعتمد في إطلاقات نماذج البرمجة. ثم جاء التدقيق.
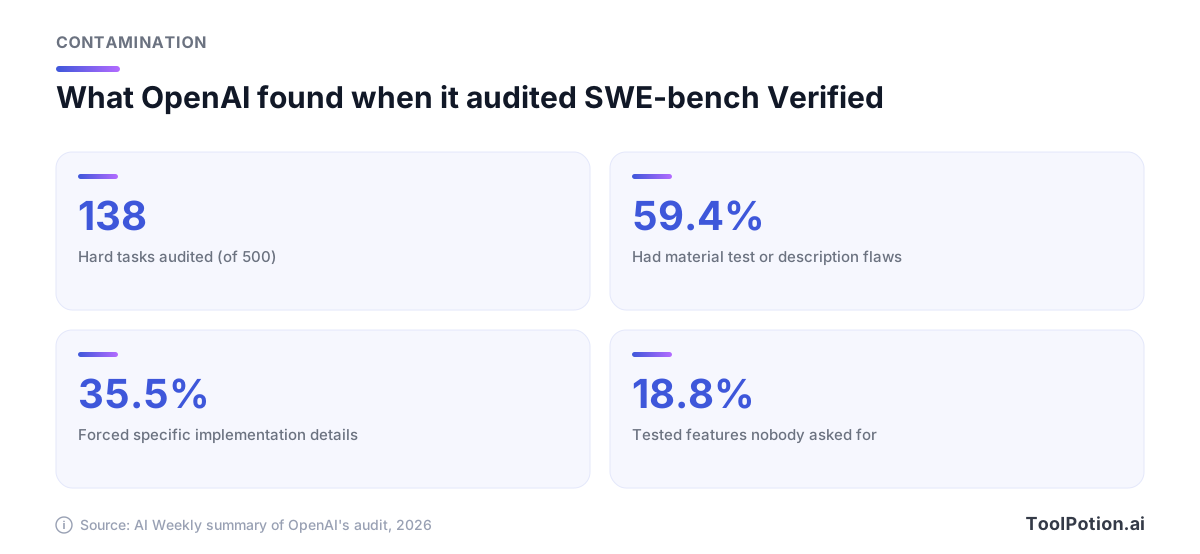
دقّقت OpenAI في 138 مسألة من Verified لم يحلّها نموذجها o3 بثبات، وراجع كلًّا منها ستة مهندسين على الأقل. ووجدت أن 59.4% منها فيها مشكلات جوهرية في اختباراتها أو أوصافها. وفي اختبار تلوث منفصل، استطاع GPT-5.2 وClaude Opus 4.5 وGemini 3 Flash Preview أن يعيد كلٌّ منها إنتاج تفاصيل من الإصلاحات الأصلية، وهذا دليل على أن المهام تسربت إلى بيانات التدريب. وتقول OpenAI إنها توقفت عن الإبلاغ عن درجات Verified وتوصي بـ SWE-bench Pro بدلًا منه (OpenAI). ويضيف ملخص AI Weekly أن أفضل النماذج كانت عند نحو 80% على Verified وأقل بنحو 35 نقطة على Pro، وأن تدقيقًا خارجيًا لاحقًا شكّك في مصحّحات Pro أيضًا (AI Weekly).
الدرس ليس أن اختبارات البرمجة عديمة الفائدة. بل أن درجة من اختبار متقاعد أو مسرّب هي رقم قديم. فحين يقتبس منشور إطلاق SWE-bench، تحقق من النسخة، وتحقق من إطار الوكيل الذي غلّف النموذج. فقد وجدت دراسة «HarnessTax» من Arena على 21 زوجًا من النموذج والإطار أن اختيار الإطار كان أثره ضئيلًا في نجاح المهمة لكنه غيّر التكلفة بما يصل إلى 5 أضعاف لنتائج متشابهة، وذلك على عينة صغيرة من 30 مهمة لكل اختبار (Arena).
قائمة تحقق لأي ادعاء بالمركز الأول
هذه نسخة الدقيقتين. مرّ عليها قبل أن تصدّق أي ترتيب، وخصوصًا قبل أن تنفق مالًا بسببه.
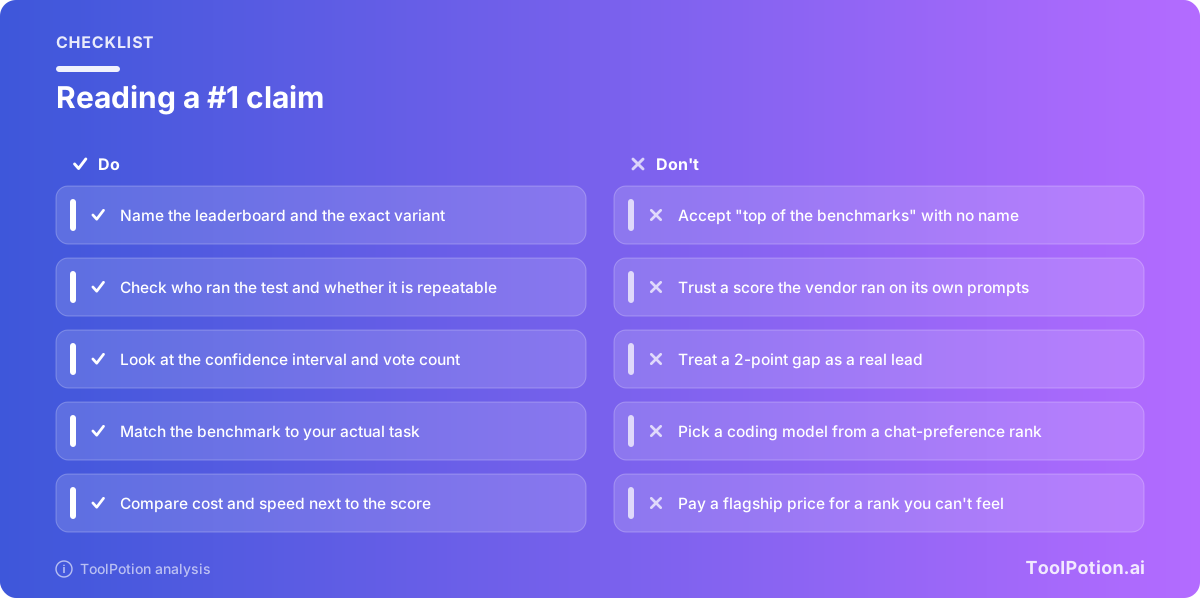
- حدد اللوحة والنسخة بدقة. «يتصدر الاختبارات» ادعاء لا يمكنك التحقق منه. أما «الأول في Arena للنصوص مع ضبط الأسلوب» فيمكنك.
- اعرف من أجرى الاختبار. تشغيل المختبر لنفسه على prompts من اختياره رقم تسويقي. وإعادة التشغيل على يد طرف ثالث أثقل وزنًا.
- اقرأ الهامش وعدد الأصوات. إذا كان التقدم أصغر من الهامش، فهو تعادل.
- تحقق هل النموذج متاح للعامة. درجة لشيء لا تستطيع تجربته اليوم لا تساعدك على الاختيار.
- اسأل هل يطابق الاختبار مهمتك. تفضيل المحادثة لن يتنبأ بكيفية تعامل النموذج مع جداولك أو قاعدة الكود لديك.
- ابحث عن لوحة ثانية مختلفة تتفق معها. قد تخطئ لوحة واحدة أو يُتلاعب بها. أما اتفاق لوحتين غير مترابطتين فتزييفه أصعب بكثير.
- ضع السعر والسرعة بجانب الدرجة. النموذج الأرخص الذي يقل مركزين هو في الغالب الصفقة الأفضل.
يمكنك تقييم أي ادعاء بنفسك بقائمة التحقق أدناه. وهي مرجّحة نحو الأشياء الأصعب تزييفًا، مثل التشغيل على يد طرف ثالث والاتفاق بين اللوحات.
اختر اللوحة التي تناسب سؤالك
بما أن اللوحات تجيب عن أسئلة مختلفة، فالخطوة المفيدة أن تبدأ من سؤالك ثم تختار اللوحة. فإذا كنت تختار مساعدًا للكتابة والمحادثة، فساحة التفضيل مرشّح أول معقول. وإذا أردت مقارنة قابلة للتكرار للقدرة الخام، فاستخدم مجموعة مستقلة. وإذا كنت تختار أداة برمجة، فانظر إلى اختبارات المهام المبنية على مستودعات حقيقية ثم جرّب على كودك أنت.
تعطيك الشجرة نقطة بداية لا حكمًا نهائيًا. ومهما كانت اللوحة التي ستصل إليها، فإن اختبارًا قصيرًا على عملك أنت أفضل من أي ترتيب عام. خذ 10 مهام حقيقية تؤديها كل أسبوع، ومرّرها عبر نموذجين أو ثلاثة من المرشحين النهائيين، وقارن المخرجات جنبًا إلى جنب. يستغرق الأمر عصرًا واحدًا، ويقيس الشيء الوحيد الذي لا تستطيع أي لوحة قياسه، وهو عملك.
وإن أردت التسوق حسب الفئة، فإن دليل نماذج الذكاء الاصطناعي وLLMs ولوحة نماذج الذكاء الاصطناعي في ToolPotion يعرضان النماذج جنبًا إلى جنب، ويتناول دليل مطابقة مستويات نماذج الذكاء الاصطناعي مع المهام متى يستحق النموذج الرائد أن تدفع ثمنه. وللاطلاع على حصيلة أوسع، راجع أفضل 15 نموذج ذكاء اصطناعي وLLM في 2026، أو بدائل ChatGPT في 2026 إن كان مساعد واحد هو نقطة انطلاقك.
حيث تقل موثوقية الأرقام
هناك مواقف تستدعي شكًّا إضافيًا. فالنماذج الجديدة في أيامها الأولى لها أصوات أقل وهوامش أوسع، وتضع Arena وسم «preliminary» على درجاتها لسبب وجيه. والنماذج مفتوحة الأوزان، التي يمكنك تنزيلها من Hugging Face، هي النقطة العمياء الأخرى: فقد قدّر مؤلفو Leaderboard Illusion أن حصتها من بيانات Arena أصغر، ولذلك قد تكون درجاتها أكثر تشويشًا. وقد تتغير النماذج المستضافة خلف الاسم نفسه، فقد لا تصف درجة من أسبوع الإطلاق النموذج الذي تستخدمه بعد أشهر.
والعمل المتخصص هو الفجوة الأكبر. فالصياغة القانونية والترميز الطبي ولغة نادرة وقاعدة الكود الداخلية لشركة ما، كلها مغطاة بصورة سيئة في اللوحات العامة. وReal-SWE Benchmark أحد الحلول: فهو يقيّم النماذج المتقدمة على قواعد كود مؤسسية خاصة، وهي أقل عرضة للتسرب إلى بيانات التدريب من المستودعات العامة. تعامل مع لوحة كهذه على أنها رأي ثانٍ مفيد، لا بديلًا عن اختبارك الخاص.
وإن كنت مستخدمًا عاديًا، فقد لا تحتاج إلى شيء من هذا. ففي الكتابة اليومية والأسئلة، تتقارب النماذج الخمسة أو الستة الأولى من OpenAI وAnthropic وGoogle إلى حد يجعل الاختيار يعود إلى السعر والواجهة والعادة. وقضاء ساعة في قراءة التصنيفات للمفاضلة بين نماذج شبه متعادلة صفقة خاسرة.
الأسئلة الشائعة
هل Arena هي نفسها LMArena؟
نعم. نشأت LMArena من مشروع Chatbot Arena البحثي في جامعة كاليفورنيا في بيركلي، وتُعرف الآن باسم Arena على arena.ai. ولا يزال الاسم القديم يظهر في المقالات وفي الأوراق الأقدم.
أي لوحة تصنيف هي الأجدر بالثقة؟
لا واحدة منها جديرة بالثقة في كل الحالات، والسؤال يعتمد على ما تريد معرفته. فللتكرارية، أقوى الخيارات مجموعة طرف ثالث تشغّل كل نموذج بنفسها. وفيما يفضّله الناس، تملك Arena أكبر قدر من البيانات. أما أوثق دليل فهو اتفاق لوحتين غير مترابطتين، ثم اختبار قصير على مهامك أنت.
ما المقصود بتلوث الاختبارات؟
هو أن يكون النموذج قد رأى أسئلة اختبار أو إجاباته أثناء التدريب، فتعكس الدرجة العالية الحفظ لا المهارة. وقد وجد تدقيق OpenAI لـ SWE-bench Verified أن النماذج المتقدمة تستطيع إعادة إنتاج الإصلاحات الأصلية لبعض المهام. ومجموعات الاختبار الخاصة، مثل التي يحتفظ بها Humanity's Last Exam، إحدى وسائل الدفاع.
هل تغش الشركات المطورة في لوحات التصنيف؟
الأدلة تدعم ادعاءً أضيق. فالمختبرات تختار الدرجات التي تنشرها، والإعدادات التي تستخدمها، وبحسب ورقة Leaderboard Illusion، النسخ الخاصة التي تكشف عنها. وهذا إبلاغ انتقائي داخل القواعد، لا خرق للقواعد بالضرورة. وهذا هو سبب أهمية إعادة التشغيل المستقلة.
هل أبدّل النموذج كلما وصل نموذج جديد إلى المركز الأول؟
لا. فكثيرًا ما يقع فارق الترتيب داخل هامش الخطأ، وللتبديل كلفة حقيقية في الـ prompts وسير العمل والاختبار. بدّل حين يتفوق نموذج على نموذجك الحالي في مهامك أنت، أو حين يضاهيه بسعر أقل بوضوح.