描述
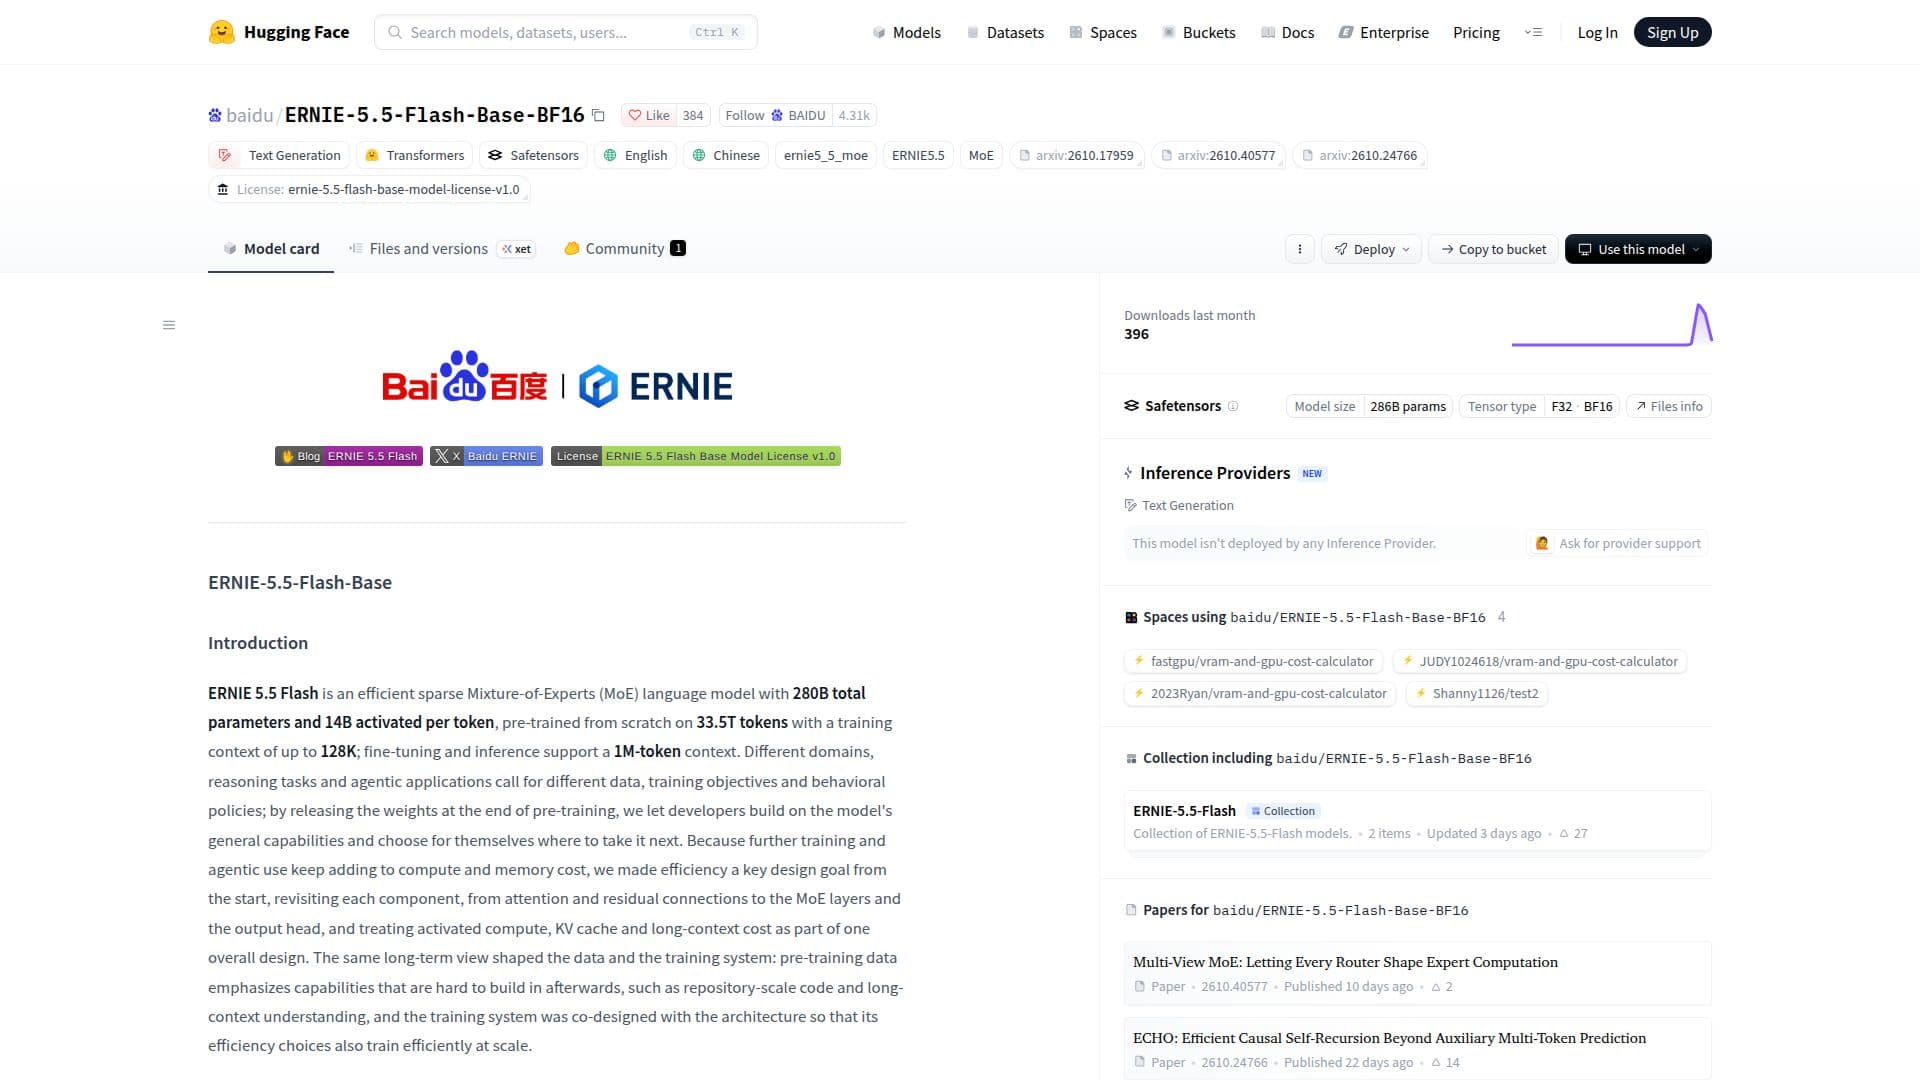
ERNIE-5.5-Flash-Base-BF16 是百度开发的一个复杂的稀疏专家混合模型(MoE)语言模型。它具有 2800 亿个总参数,每个标记激活 140 亿个参数,使其在复杂语言任务中具有高度的效率。该模型在一个广泛的数据集上从零开始进行了预训练,数据集包含 33.5 万亿个标记,训练上下文可达 128,000 个标记。对于微调和推理,它支持高达 100 万标记的上下文长度,使其能够深入理解和生成长篇内容。
阅读更多
ERNIE 5.5 Flash 以效率为核心原则,重新审视了每个组件,从注意力机制和残差连接到 MoE 层和输出头。这种整体方法确保了在管理计算、KV 缓存和长上下文成本的同时实现最佳性能。预训练数据强调了对高级应用至关重要的能力,例如库规模的代码理解和长上下文理解,使开发人员能够在其通用能力的基础上构建多样化的用例。
ERNIE-5.5-Flash-Base-BF16 代表了预训练结束时的检查点,作为任何中期或后期训练阶段之前的基础模型。这使其成为从事领域适应、指令调优和强化学习的研究人员和开发人员的理想起点。该模型在统一评估管道中表现出色,在知识、推理、数学、代码、多语言任务和长上下文理解等相关基准测试中表现优异。
该架构包含一个 280B-A14B 混合注意力 MoE,具有 43 层,包括 1 层密集 FFN 和 42 层多路由潜在 MoE 层。它具有 37 层重压缩注意力(HCA)层和 6 层多头潜在注意力(MLA + DSA)层,采用稀疏注意力。该模型在每个 MoE 层中利用 512 个路由专家(前 10)加 1 个共享专家。低秩门控注意力、虚拟头注意力(VHA)、多路由潜在 MoE、ECHO、流形约束超连接(mHC)和 MultiMax 输出头等创新为其先进的能力和效率做出了贡献。分词器支持大约 200,000 个条目,并以每组最多三位数字的方式从右到左对数字进行分词。
部署支持 SGLang 和 vLLM,允许在生产环境中提供高达 1,048,576 个标记的上下文长度。该模型根据 ERNIE 5.5 Flash Base 模型许可协议 v1.0 提供。
- 类别AI 模型与大语言模型
- 部署云端
- 平台网页版
ERNIE-5.5-Flash-Base-BF16亮点
2800 亿个总参数
每个标记激活 140 亿个参数
在 33.5 万亿个标记上进行预训练
训练上下文可达 128,000 个标记
微调和推理支持 100 万标记的上下文
高效的稀疏专家混合模型(MoE)架构
具有 43 层的混合注意力 MoE
37 层重压缩注意力(HCA)层
6 层多头潜在注意力(MLA + DSA)层
每个 MoE 层 512 个路由专家(前 10)加 1 个共享专家
低秩门控注意力和虚拟头注意力(VHA)
多路由潜在 MoE 以实现准确的专家选择
ECHO 用于多视角损失和推测解码
流形约束超连接(mHC)用于信号传播
MultiMax 输出头用于优化词汇分布
约 200,000 条目的 BPE 分词器
支持 SGLang 和 vLLM 进行生产服务
ERNIE-5.5-Flash-Base-BF16入门
访问模型页面:导航到 Hugging Face 上的 ERNIE-5.5-Flash-Base-BF16 页面。
浏览文件:查看页面上可用的模型文件和文档。
下载模型:下载 ERNIE-5.5-Flash-Base-BF16 模型检查点。
安装 vLLM 和插件:安装 vLLM 和 ERNIE 5.5 插件以进行部署。
启动服务器:使用 SGLang 或 vLLM 启动模型服务器。
发送请求:使用 curl 等工具向完成端点发送请求以进行推理。
ERNIE-5.5-Flash-Base-BF16的使用案例
- 文本生成
- 领域适应
- 指令调优
- 强化学习研究
- 代码理解
- 长上下文理解
- 多语言应用
- 推理任务
- 代理应用