

描述
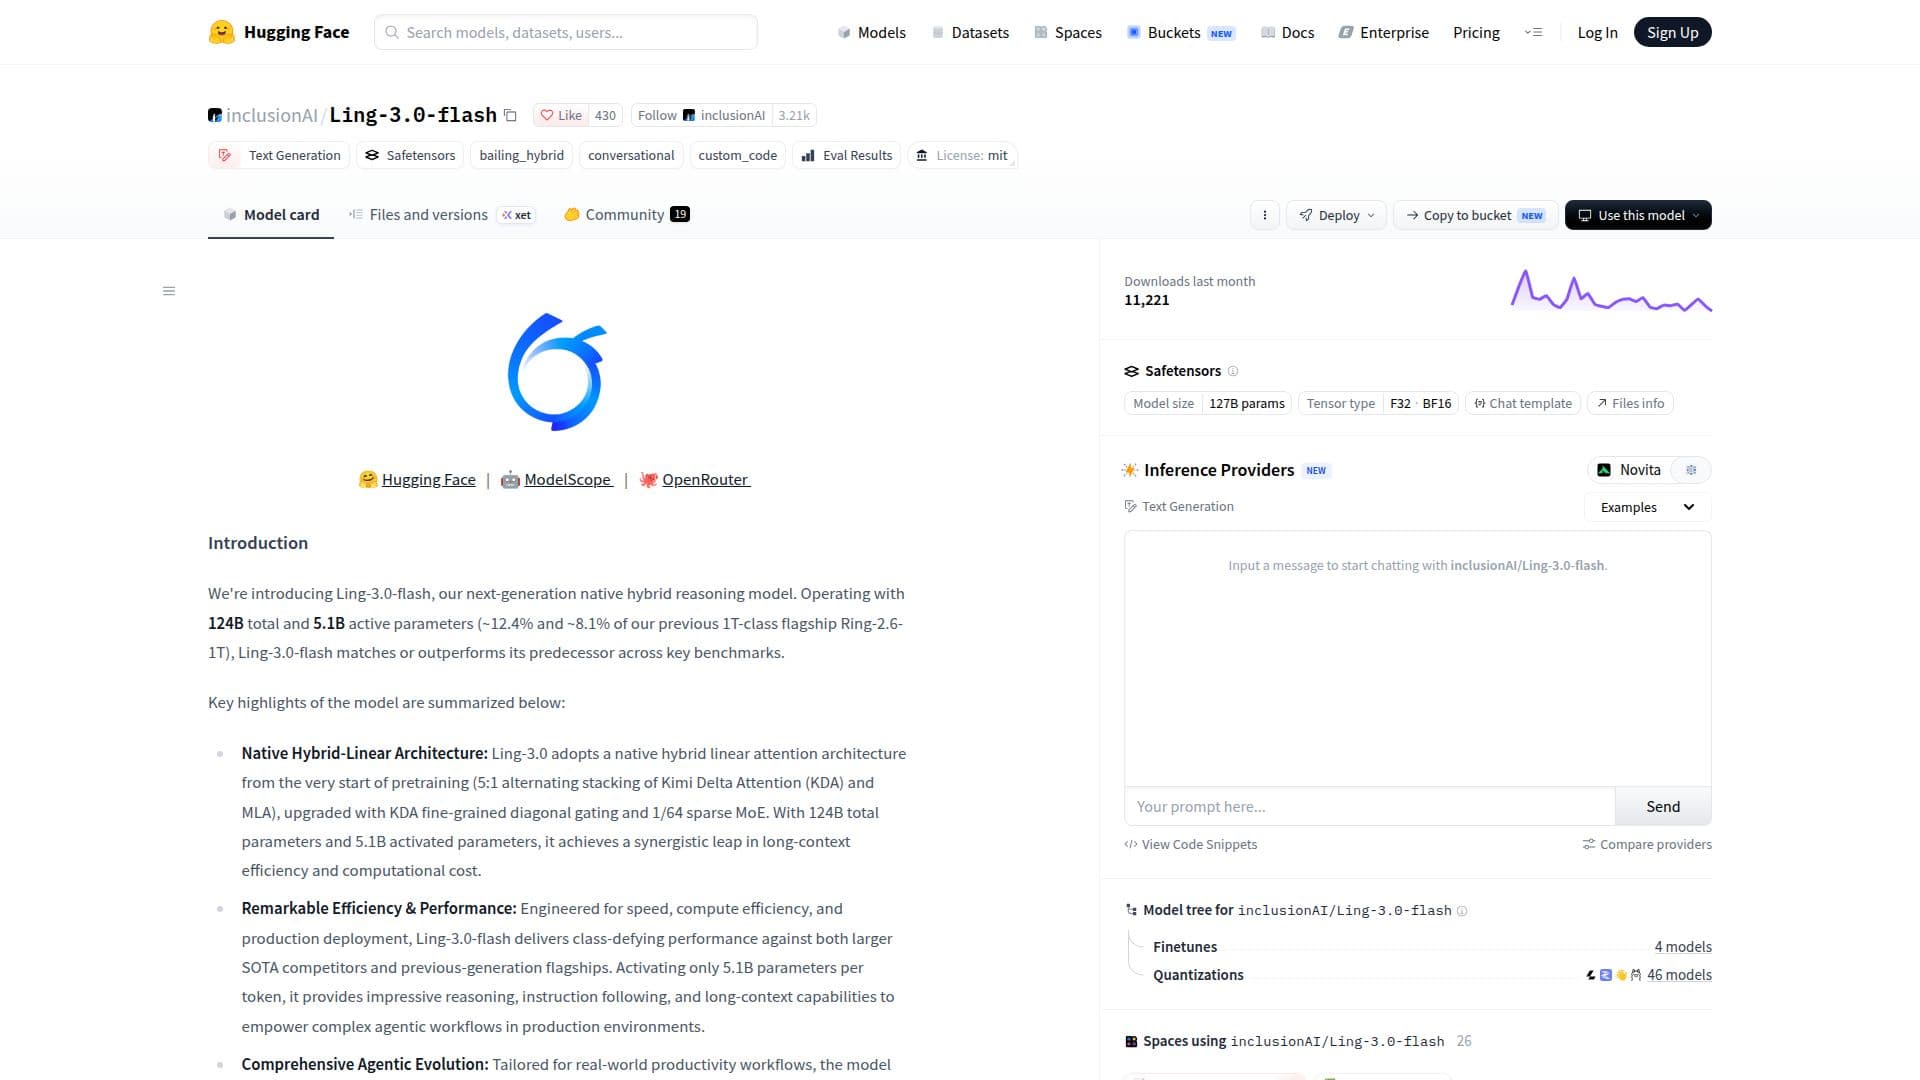
Ling-3.0-flash 是由 inclusionAI 开发并托管在 Hugging Face 上的前沿混合推理模型。它总共拥有 1240 亿个参数,每个令牌激活 51 亿个参数,提供了卓越的效率和性能。该模型采用原生混合线性注意力架构,具有 Kimi Delta Attention (KDA) 和 MLA,并通过细粒度对角门控和稀疏 MoE 进行了升级。这种架构使 Ling-3.0-flash 在长文本效率和计算成本上实现了协同飞跃。
阅读更多
Ling-3.0-flash 为速度和计算效率而设计,在与更大规模的最先进竞争对手和上一代旗舰产品的比较中,展现出超越类别的性能。它在生产环境中赋能复杂的代理工作流程,每个令牌仅激活 51 亿个参数。该模型结合了 10,000 多个互动训练环境,实现了编码、通用和深度研究代理任务的端到端闭环执行。
Ling-3.0-flash 集成了 SGLang HiCache + Mooncake 分层缓存架构,具有物理双池和集群共享的 L3 缓存。这种设置消除了长时间交互中的冗余重计算,在长输入场景中将首次令牌时间 (TTFT) 减少了 60% 至 80% 以上。该模型在多个权威基准测试中表现强劲,包括 SWE-Bench Pro、SWE-Bench Multilingual、Tau3-banking-AA、MCP-Atlas 和 SkillsBench。
该模型专为现实世界的生产力工作流程量身定制,在一般知识、数学推理、指令跟随和长文本理解方面表现出色。Ling-3.0-flash 旨在用于生产部署,提供令人印象深刻的推理能力和长文本效率,适合复杂的代理工作流程。
- 类别AI 模型与大语言模型
- 定价模式免费增值
- 部署云端
- 平台网页版
Ling-3.0-flash亮点
原生混合线性架构
卓越的效率与性能
全面的代理进化
SGLang HiCache + Mooncake 缓存
端到端闭环执行
长文本效率
指令跟随
数学推理
Ling-3.0-flash入门
访问模型页面:访问 Hugging Face
身份验证:登录您的账户
配置:设置参数和偏好
发送提示:输入您的查询
微调:调整模型设置
Ling-3.0-flash的使用案例
- 编码任务
- 研究代理
- 指令跟随
- 长文本理解
- 数学推理







