描述
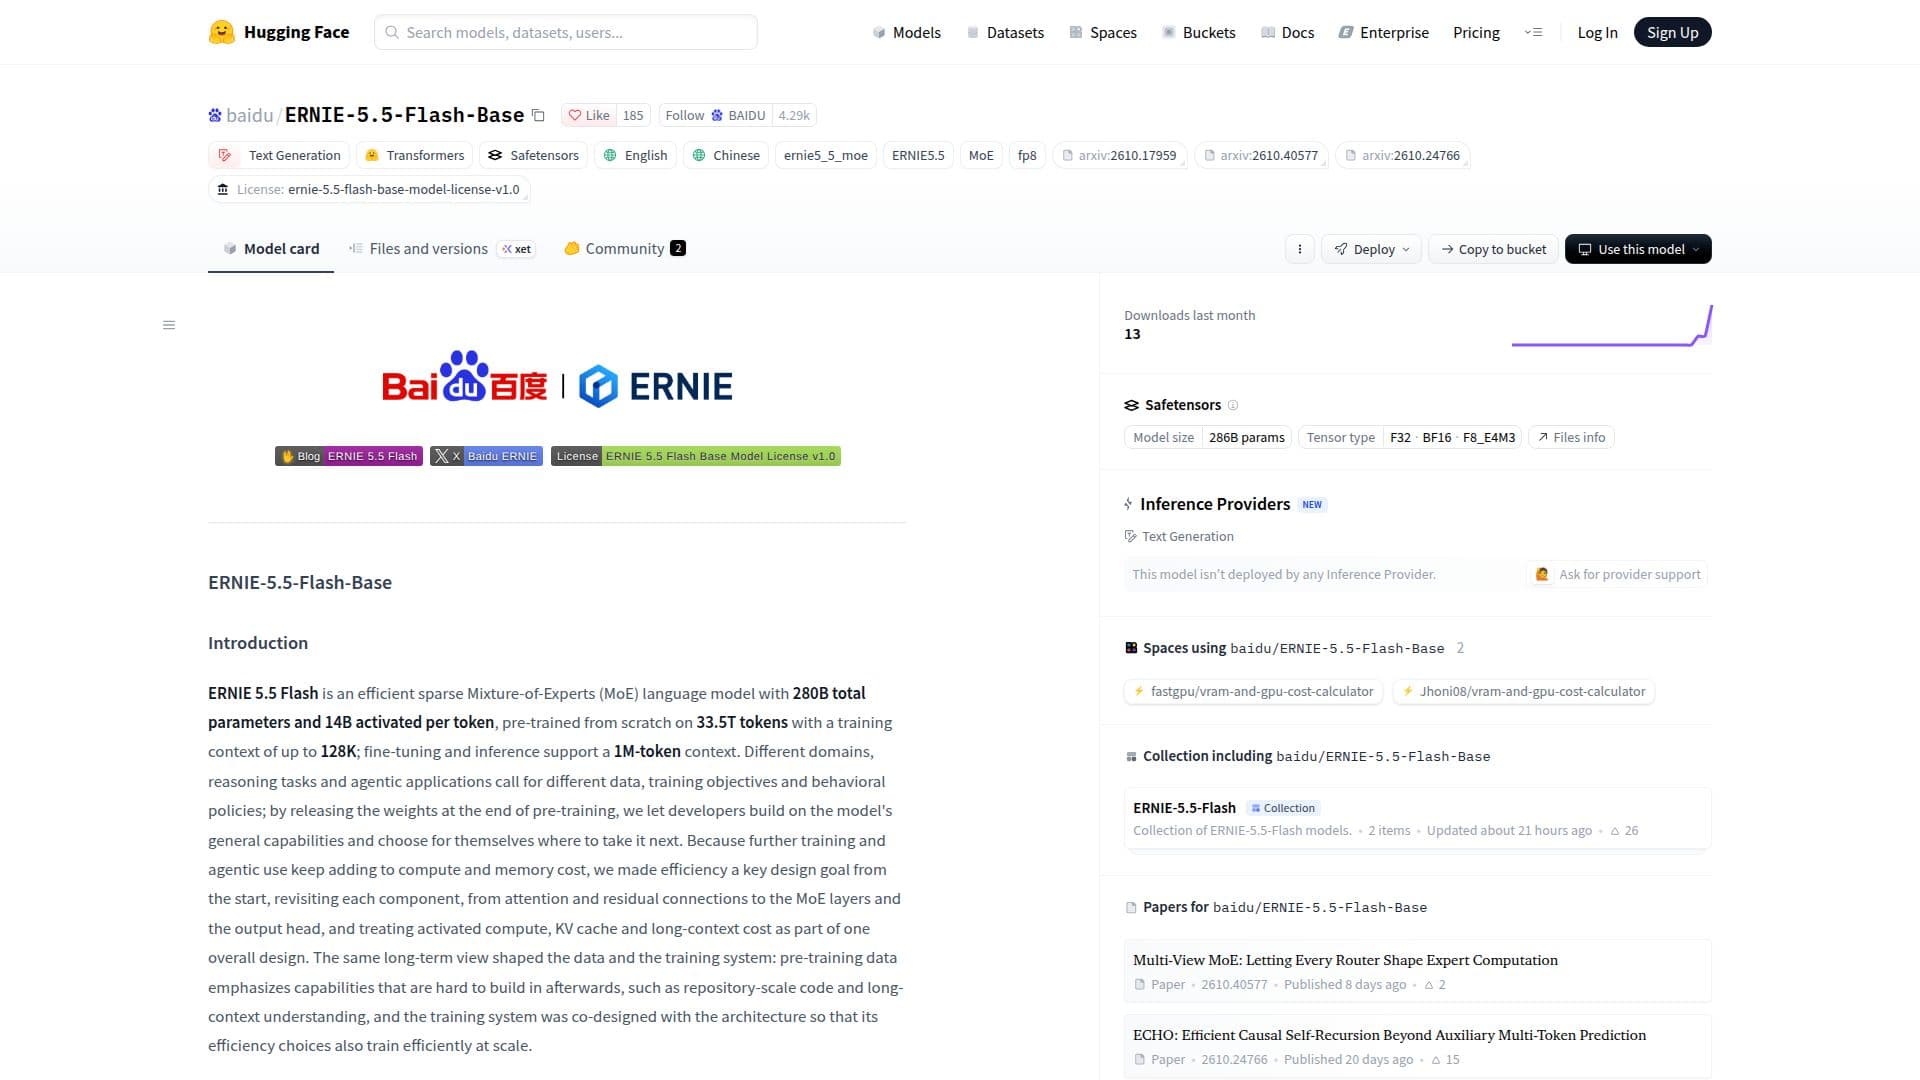
ERNIE-5.5-Flash-Base 是百度开发的一个复杂文本生成模型,现已在 Hugging Face 上提供。它是一个高效的稀疏专家混合模型(MoE)语言模型,具有 2800 亿个参数,每个标记激活 140 亿个参数。该模型在 33.5 万亿个标记的大型数据集上从头开始进行预训练,使用的训练上下文长度可达 128K。对于微调和推理,它支持令人印象深刻的 100 万标记上下文长度。
阅读更多
ERNIE 5.5 Flash 的设计以效率为核心目标,重新审视了每个组件,从注意力机制和残差连接到 MoE 层和输出头。这种整体方法将激活计算、KV 缓存和长上下文成本视为集成设计的一部分。预训练数据强调了在训练后难以构建的能力,例如库规模的代码理解和长上下文理解。训练系统与架构共同设计,以确保高效扩展。
ERNIE-5.5-Flash-Base 代表了预训练结束时的检查点,使其成为开发人员的理想基础。它允许领域适应、指令调优和强化学习研究。该模型在统一评估管道中表现出色,涵盖知识、推理、数学、代码、多语言任务和长上下文基准。其性能与其他大型模型如 DeepSeek-V4-Flash-Base、Hy3-preview-Base 和 MiMo-V2.5-Base 进行了基准测试,所有模型在一致的条件下进行评估。
该架构包含一个 280B-A14B 混合注意力 MoE,具有 43 层,包括 1 层密集 FFN 和 42 层多路由潜在 MoE 层。它具有 37 层重压缩注意力(HCA)层和 6 层具有稀疏注意力的多头潜在注意力层(MLA + DSA)。该模型利用 512 个路由专家(前 10)以及每个 MoE 层的 1 个共享专家。关键创新包括具有层特定头维度的混合 MLA + HCA 注意力、低秩门控注意力、虚拟头注意力(VHA)、多路由潜在 MoE、用于未来标记预测的 ECHO、流形约束超连接(mHC)和多最大输出头。分词器使用约 20 万条目的 BPE 分词器,以从右到左的方式对数字进行分词,最多可分为三位数字。
ERNIE-5.5-Flash-Base 的部署支持 SGLang 和 vLLM,使得在长上下文推理中支持上下文长度高达 1,048,576 个标记的生产服务。该模型根据 ERNIE 5.5 Flash Base 模型许可协议 v1.0 提供,版权归百度所有。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端
- 平台网页版
ERNIE-5.5-Flash-Base亮点
2800 亿个参数,每个标记激活 140 亿个参数
在 33.5 万亿个标记上进行预训练
支持 100 万标记上下文进行微调和推理
高效的稀疏专家混合模型(MoE)架构
具有层特定头维度的混合 MLA + HCA 注意力
低秩门控注意力和虚拟头注意力(VHA)
具有 512 个路由专家和 1 个共享专家的多路由潜在 MoE
用于多视角损失和推测解码的 ECHO
用于信号传播的流形约束超连接(mHC)
用于优化词汇分布的多最大输出头
约 20 万条目的 BPE 分词器,支持从右到左的数字分词
支持与 SGLang 和 vLLM 的部署
在知识、推理、数学、代码、多语言和长上下文基准中表现出色
提供 FP8 和 BF16 精度权重
ERNIE-5.5-Flash-Base入门
访问模型:导航到 Hugging Face 上的 ERNIE-5.5-Flash-Base 页面。
下载模型:选择 FP8(safetensors)或 BF16(safetensors)精度进行下载。
安装部署工具:安装 vLLM 和 ERNIE 5.5 插件,或使用官方 SGLang 预构建的 Docker 镜像。
启动服务器:启动 vLLM 或 SGLang 服务器以托管模型。
发送请求:使用 curl 或其他 API 客户端向文本生成的 completions 端点发送请求。
微调模型:利用预训练检查点进行领域适应、指令调优或强化学习研究。
ERNIE-5.5-Flash-Base的使用案例
- 文本生成
- 领域适应
- 指令调优
- 强化学习研究
- 代码生成与理解
- 长上下文理解
- 多语言应用
- 推理任务