描述
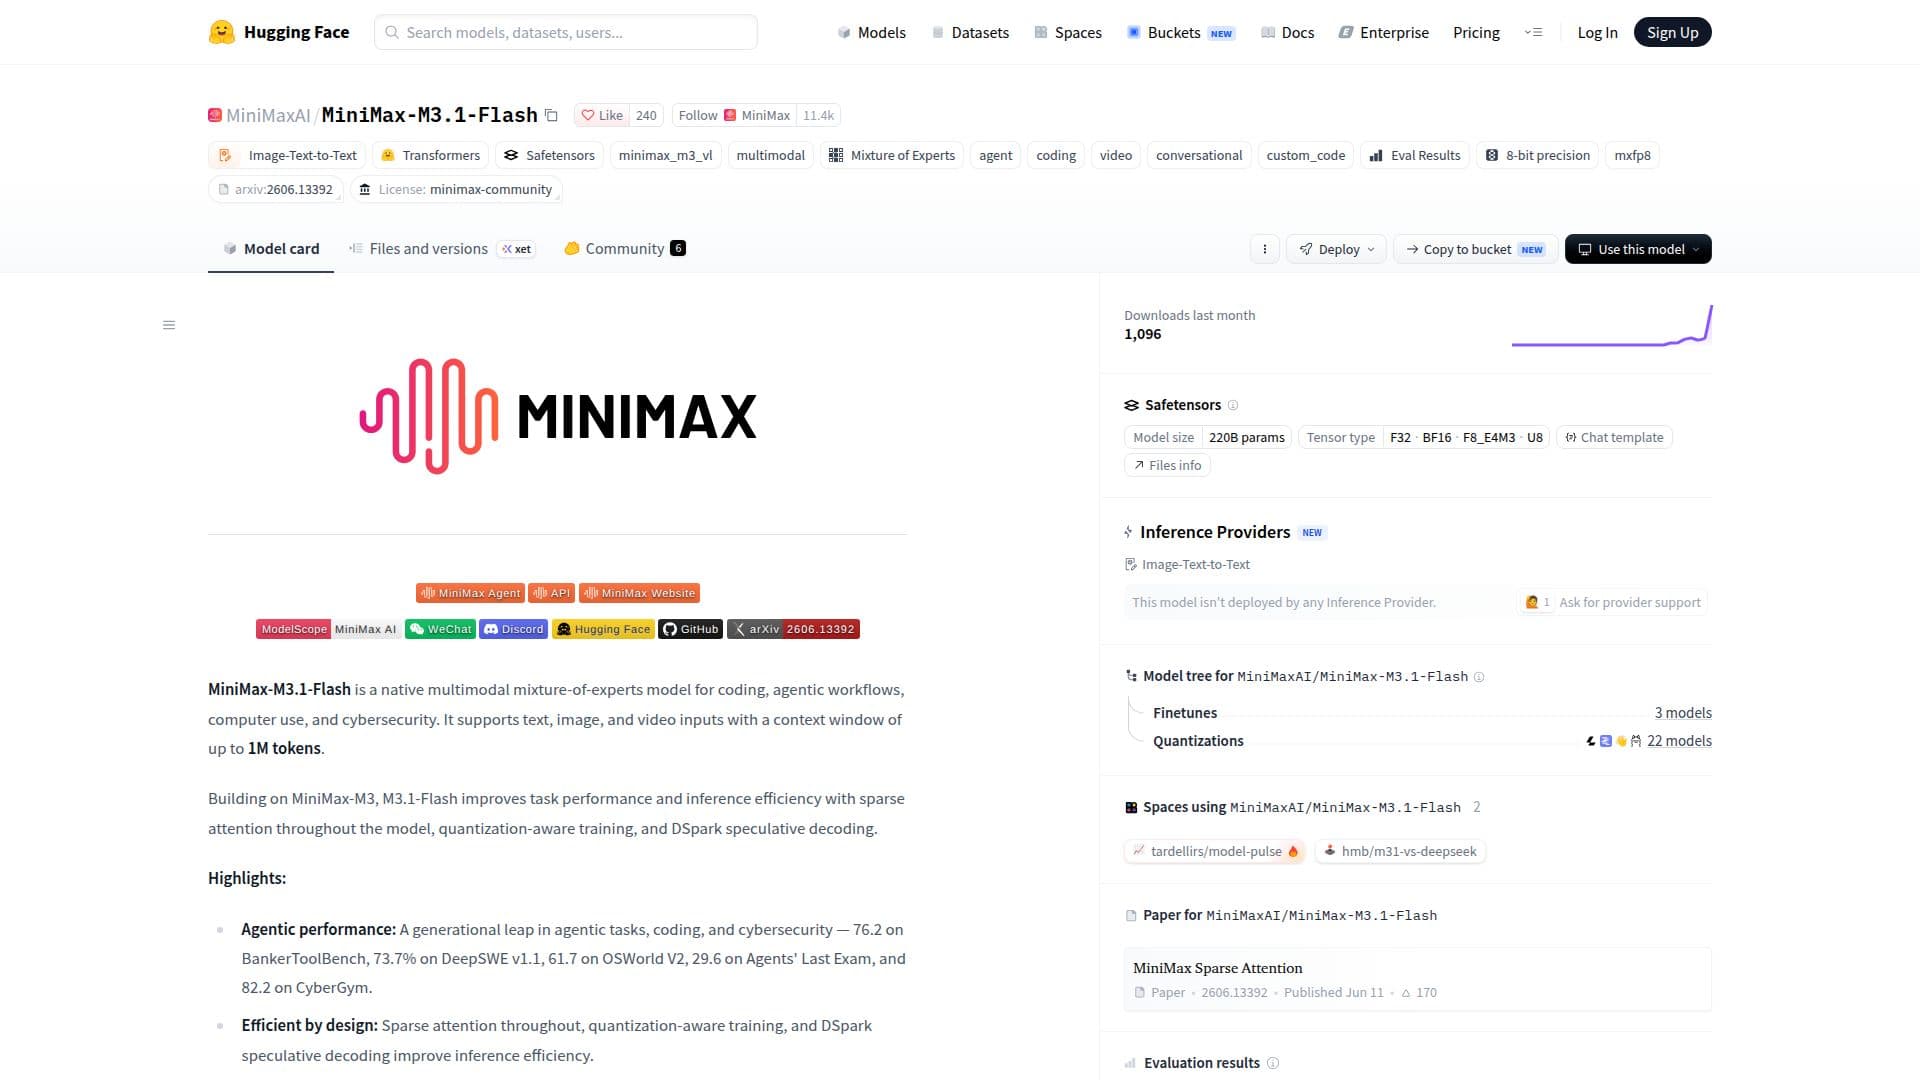
MiniMax-M3.1-Flash 是一个先进的多模态专家混合模型,旨在增强编码、代理工作流、计算机使用和网络安全。该模型支持文本、图像和视频输入,提供高达 100 万个标记的上下文窗口。基于 MiniMax-M3 架构,M3.1-Flash 通过在整个模型中使用稀疏注意力、量化感知训练和 DSpark 推测解码引入了任务性能和推理效率的改进。
阅读更多
该模型的架构旨在处理广泛的输入和输出,具有大约 4280 亿个参数,其中每个标记激活 230 亿个。这使得在多个基准测试中实现高效处理和高性能,包括在 BankerToolBench 上得分 76.2 和在 CyberGym 上得分 82.2。
M3.1-Flash 特别以其代理性能而著称,在与编码和网络安全相关的任务中实现了飞跃式的进步。它在多个基准测试中取得了高分,例如在 DeepSWE v1.1 上得分 73.7% 和在 OSWorld V2 上得分 61.7。该模型的效率通过稀疏注意力和量化感知训练等功能进一步增强,这些功能减少了内存占用并提高了服务效率。
在部署方面,MiniMax-M3.1-Flash 支持多种推理框架,包括 SGLang、vLLM 和 TokenSpeed,更多集成正在进行中。该模型设计用于多芯片部署,提供灵活的服务配置。用户可以调整推理设置,如温度和 top_p,以优化特定任务的性能。
总体而言,MiniMax-M3.1-Flash 是开发人员和研究人员希望在多模态环境中利用先进 AI 能力的强大工具,为复杂工作流和网络安全应用提供强有力的支持。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端
- 平台网页版
MiniMax-M3.1-Flash亮点
多模态专家混合架构
支持文本、图像和视频输入
上下文窗口高达 100 万个标记
模型中的稀疏注意力
量化感知训练
DSpark 推测解码
大约 4280 亿个参数
在多个基准测试中表现出色
MiniMax-M3.1-Flash入门
访问模型页面:访问 MiniMax-M3.1-Flash 的官方 Hugging Face 页面
身份验证:确保您拥有访问模型所需的凭据
配置:使用您首选的推理框架设置模型
发送提示:输入文本、图像或视频数据进行处理
微调:调整温度和 top_p 等设置以获得最佳结果
MiniMax-M3.1-Flash的使用案例
- 编码辅助
- 网络安全
- 代理工作流
- 多模态处理
- 推理效率