描述
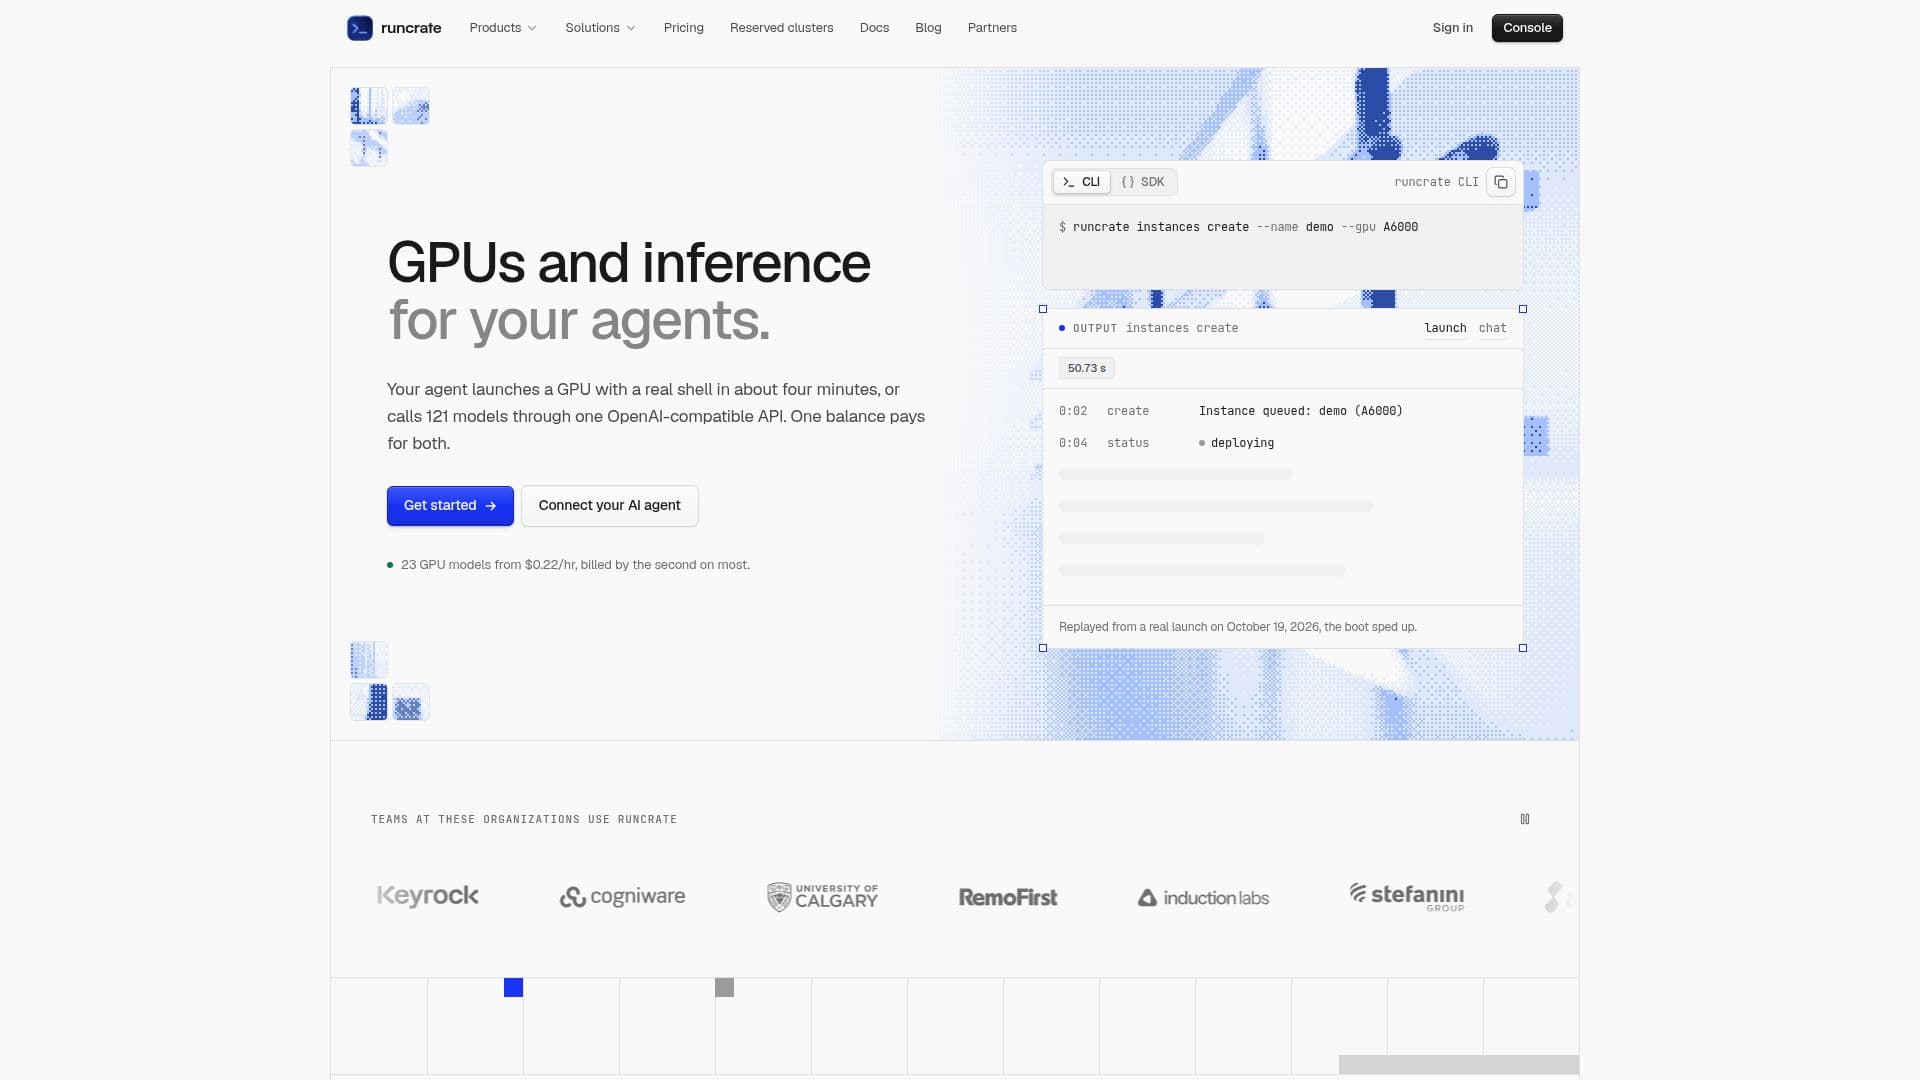
Runcrate,由 Aeonmind 开发,提供全面的 AI 云基础设施,旨在为 AI 和机器学习团队服务。它提供对强大 GPU 的按需访问,包括 H100、H200、A100、L40S 和 RTX 4090,大多数模型按秒计费。GPU 实例可以在几分钟内启动并投入使用,消除了审批队列和配额请求。
阅读更多
该平台还具有与 OpenAI 兼容的推理 API,允许用户调用 121 种不同的模型以执行各种任务,如文本生成、视觉、图像处理、视频、语音、转录和嵌入。这个统一的 API 简化了模型的集成和使用,单一余额涵盖 GPU 使用和模型推理。
Runcrate 支持广泛的 AI 开发活动。用户可以使用 LoRA 微调开放模型,如 Llama、Mistral 或 Qwen,使用 vLLM 在专用 GPU 上提供开源 LLM,并使用 Whisper API 大规模转录音频和视频文件。该平台还支持在 RTX 4090 实例上运行 ComfyUI,并通过嵌入文档和使用聊天模型进行回答来开发 RAG 管道。
为了数据持久性,Runcrate 提供存储卷,可以在实例之间保留代码、数据和检查点,确保在 GPU 被终止时工作不会丢失。计费精确,仅在实例运行时开始,通常按秒收费,启动时间不收费。该平台与 Claude Code、Codex 和 Cursor 等工具集成,允许代理直接启动和管理 GPU 实例。
Runcrate 的定价模型包括 GPU 实例的按秒计费、推理 API 调用的按令牌定价和存储卷的月费。GPU 和推理的预付费选项可用,用户可以为长期项目预留多节点集群。公司的愿景是通过消除基础设施瓶颈和促进开放模型,使 AI 开发变得更便宜、更易于获取。
- 类别机器学习平台
- 定价模式按量付费
- 部署云端
- 平台网页版
Runcrate的核心功能
按需 GPU 实例(H100、H200、A100、L40S、RTX 4090)
大多数 GPU 的按秒计费
与 OpenAI 兼容的推理 API,提供 121 种模型
快速 GPU 实例部署(通常在几分钟内)
支持使用 LoRA/QLoRA 微调 LLM(Llama、Mistral、Qwen)
使用 vLLM 在专用 GPU 上提供开源 LLM
用于音频和视频转录的 Whisper API
跨实例的持久数据存储卷
所有产品(GPU、推理、存储)的统一账户和余额
与 AI 代理和开发工具(Claude Code、Codex、Cursor)的集成
提供预付费选项和预留集群
GPU 启动时间不收费
在浏览器中访问 Jupyter 和 VS Code
用于微调和提供的准备镜像
自动充值以管理信用阈值
如何使用 Runcrate?
连接:使用一个命令将 Runcrate 添加到您首选的工具(Claude Code、Codex、Cursor 或终端)。
登录:通过浏览器批准访问,无需粘贴密钥。
启动 GPU:请求您的代理启动特定 GPU 和所需的 crate,例如,"启动一个带有微调 crate 的 H100。"
配置资源:选择您的 GPU 模型并配置所需资源。
部署:启动实例;计费在 GPU 实例运行时开始。
管理:直接从终端或集成工具部署、管理和终止 GPU 实例。
利用:使用 GPU 进行训练、提供模型或通过与 OpenAI 兼容的 API 调用模型。
存储数据:使用持久存储卷在实例之间保留您的工作。
Runcrate的使用案例
- 模型训练
- AI 推理
- 微调 LLM
- RAG 管道
- AI 代理操作
- 图像和视频生成
- 语音和音频处理
- 计算机视觉任务
- 数据处理
- 研究和实验