

$8 dan $40. Itulah biaya Claude Fable 5.2 per juta token input dan output, turun dari $10 dan $50 untuk Fable 5.1, dan tepat 20% di bawah harga list GPT-6 Astra (Fortune). Kami mengeceknya langsung ke halaman resmi kedua vendor, dan angkanya benar: Anthropic mencantumkan $8 dan $40 (dokumentasi Anthropic), sedangkan OpenAI mencantumkan GPT-6 Astra di $10 dan $50 (OpenAI).
Itu headline-nya, dan memang bagus. Menurut kami, hal yang lebih layak diperhatikan ada lebih jauh di bawah, dalam sebuah artikel help center: Fable menyimpan prompt dan output Anda minimal 30 hari, dan zero data retention untuk sebagian besar pelanggan tidak tersedia sama sekali. Anthropic merilis dua model pada hari yang sama: Fable 5.2 untuk semua paket berbayar dan Mythos 5.2 untuk tim keamanan siber dan biologi yang telah diverifikasi. Di bawah ini kami membedah keduanya: apa yang berubah, di mana masing-masing bisa dijalankan, berapa biayanya dibandingkan Astra dan Gemini 4 Carbon, seberapa jauh tabel benchmark bisa dipercaya, dan model mana yang kami pakai untuk pekerjaan apa.
Satu model, dua nama
Anthropic menyebut keduanya adalah model dasar yang sama (Anthropic). Fable hadir dengan classifier yang memblokir pekerjaan siber berisiko tinggi, seperti penetration testing dan pembuatan exploit, serta sebagian besar riset biologi. Mythos adalah versi tanpa pemblokiran tersebut, dan diberikan kepada organisasi yang mendaftar lewat Cyber Verification Program atau Life Sciences Verification Program milik Anthropic.
Permintaan yang diblokir di Fable tidak berakhir dengan error. Claude menjawab dengan Opus 4.8 untuk topik keamanan siber dan Opus 5 untuk topik biologi, menurut pengumuman Anthropic (Anthropic). Fallback ini terdokumentasi (help center bahkan memuat artikel berjudul "Why Claude switched models in your conversation with Fable models", menurut halaman Covered Models), tetapi Anda perlu tahu sebelum jawaban terasa aneh dan Anda sibuk mencari penyebabnya.
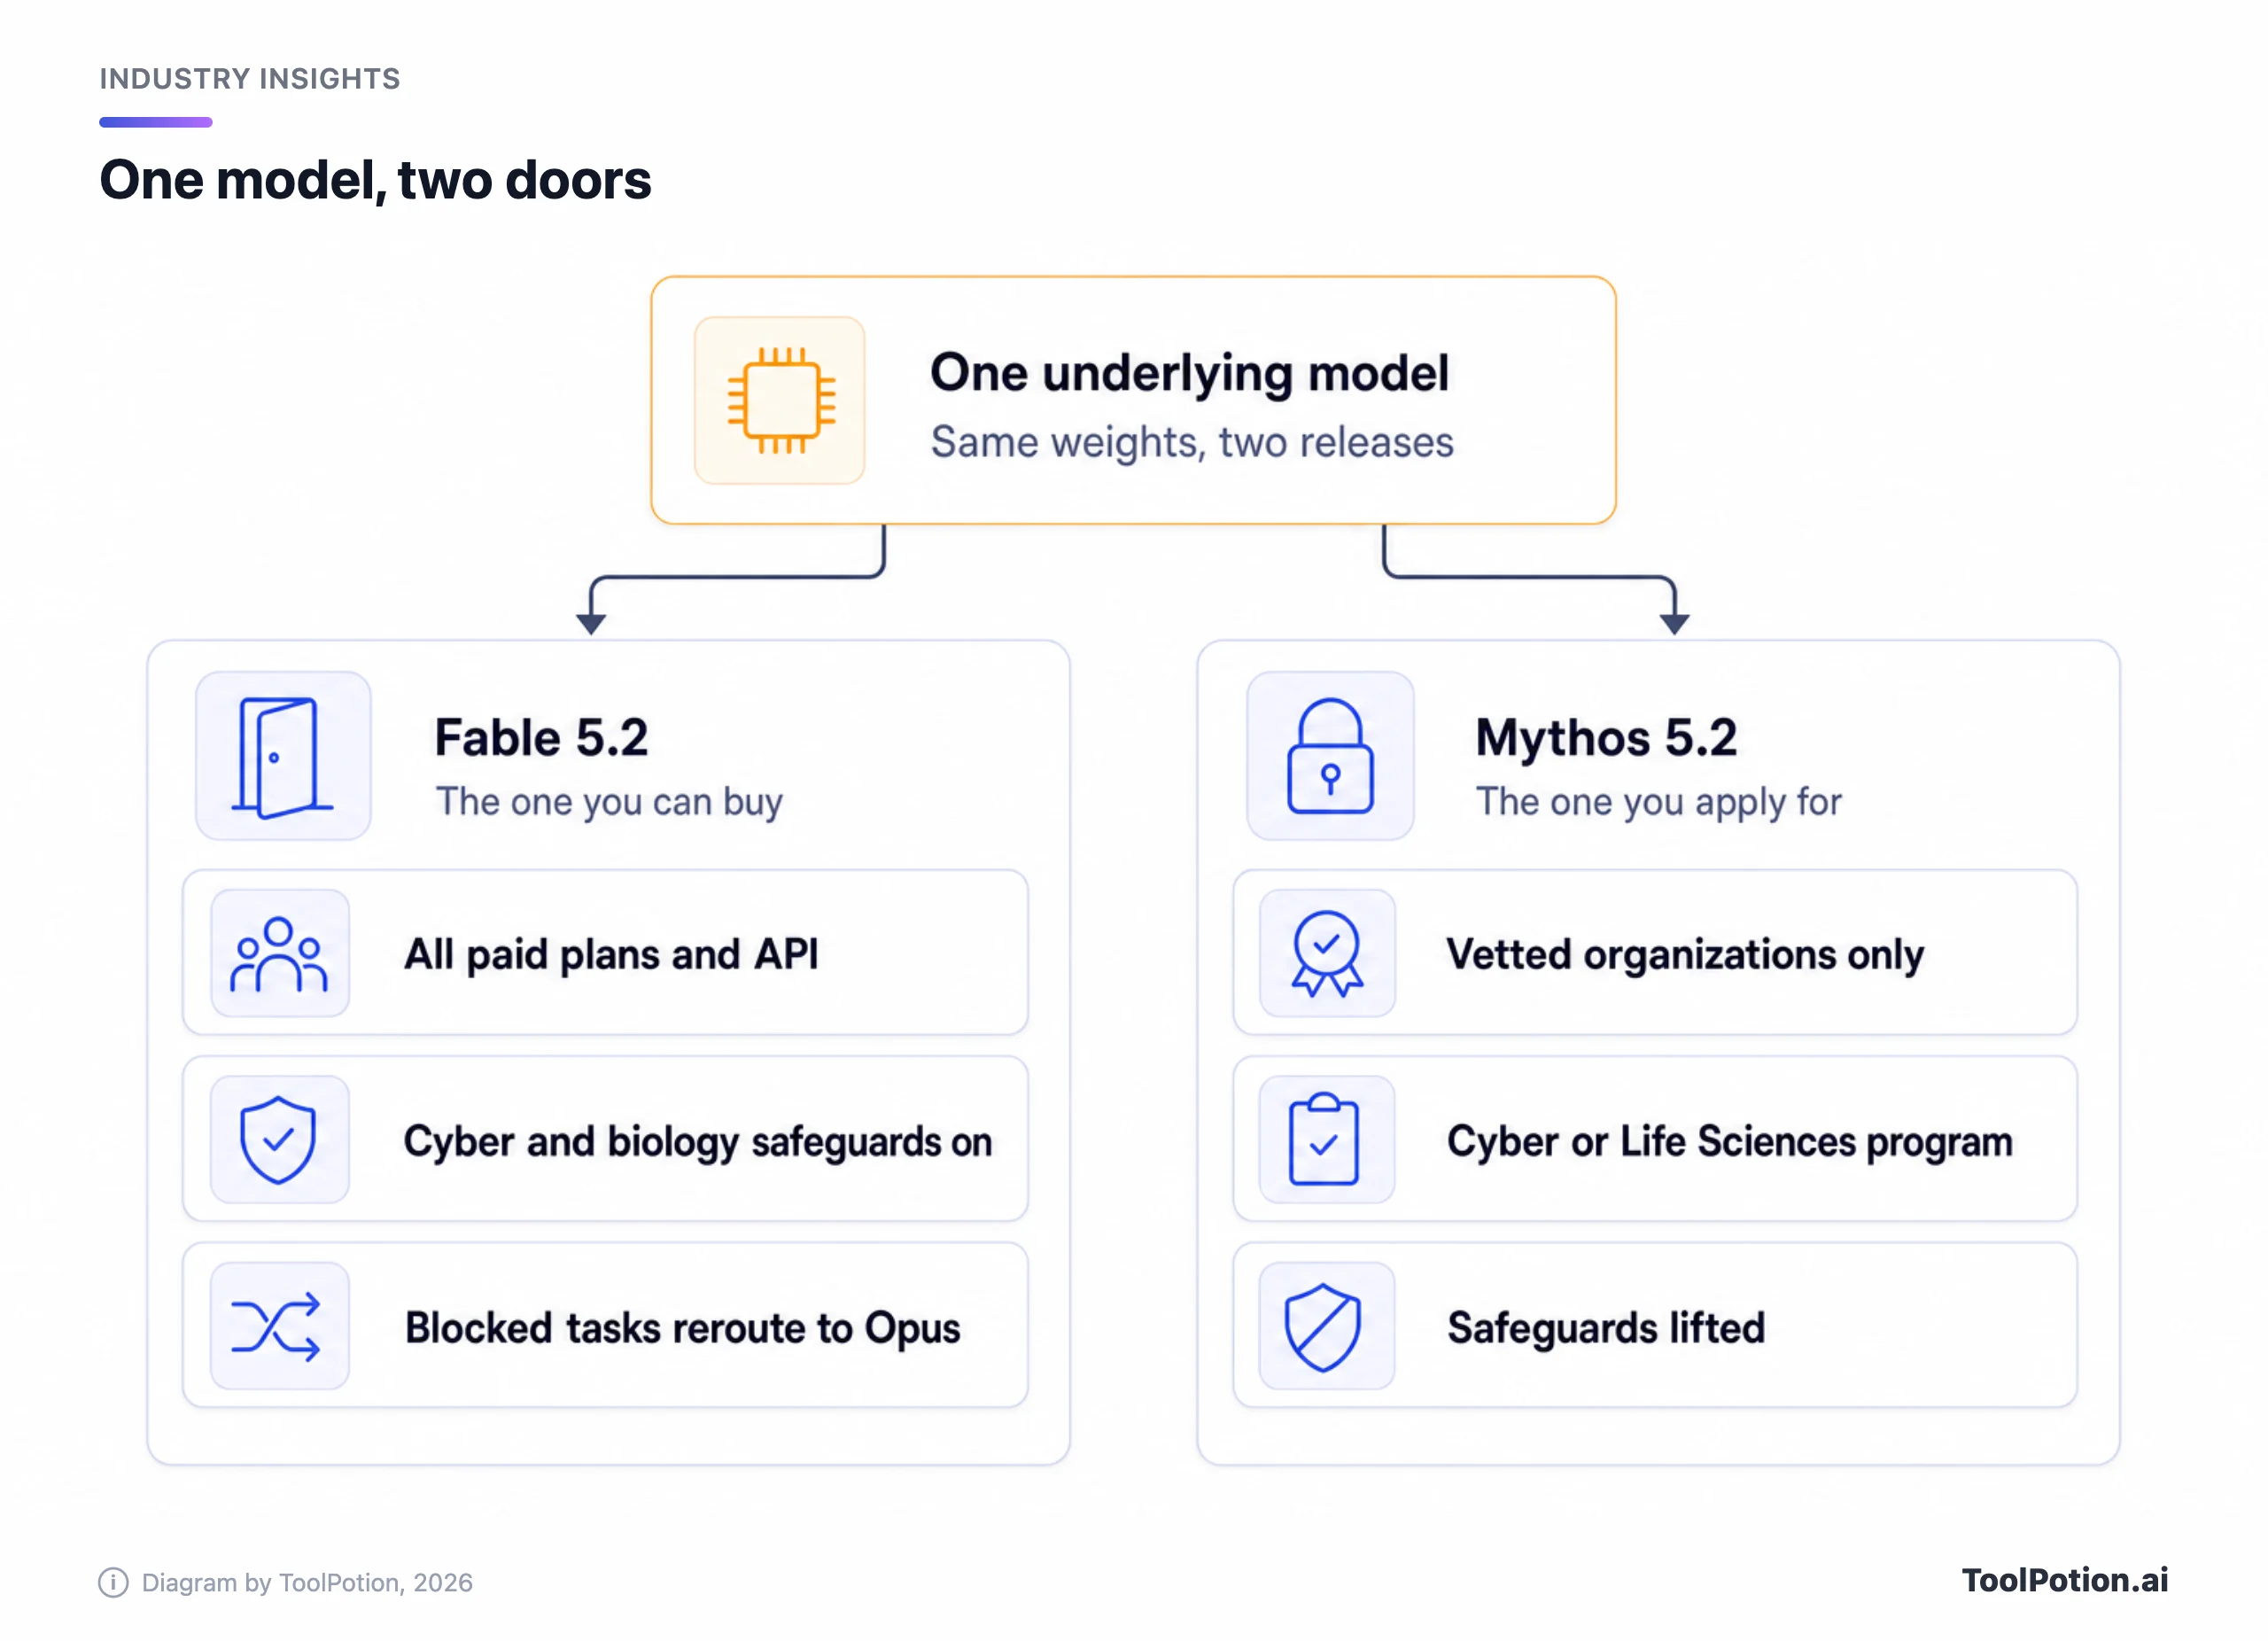
Mythos juga tempat klaim-klaim siber berada. Tabel Anthropic menempatkan Mythos 5.2 (bukan Fable) di 76,3% pada CyScenarioBench, dibandingkan 61% untuk GPT-6 Cyber milik OpenAI, dengan catatan kaki bahwa "each lab's scores are based on unique tasks", jadi ini bukan perbandingan yang setara. Anthropic menambahkan bahwa pengaman Fable 5.2 "will block most cybersecurity-related tasks" (Anthropic). Itulah satu-satunya angka siber yang akan kami ulang, dan bukan angka yang bisa diklaim Fable. Pelanggan Claude Enterprise yang belum bergabung dengan program tetap bisa mengakses Mythos lewat Claude Security, yang memindai kode dengan seluruh keluarga model, dan fast mode Mythos hanya untuk anggota program.
Kebanyakan pembaca tidak akan pernah menyentuh Mythos, dan itu tidak masalah. Lini Fable adalah produk utamanya.
Apa yang berubah sejak 5.1
Mulai dari soal uang. Fable 5.2 berharga $8 untuk input dan $40 untuk output per juta token, Batch API memangkasnya separuh menjadi $4 dan $20, dan cache read turun menjadi $0,20 dari $0,25 pada 5.1 (dokumentasi Anthropic). Context window-nya 1M token dengan satu tarif tunggal, tanpa biaya tambahan untuk prompt panjang. Anthropic juga menyebut output hingga 30% lebih cepat dari 5.1, dan menambahkan fast mode opsional yang menghasilkan teks hingga 2,5 kali lebih cepat seharga $16 dan $80, dua kali tarif standar dan tidak tersedia untuk batch (Anthropic).
Soal efisiensi, Anthropic mengatakan Fable 5.2 mencapai jawaban sulit dengan lebih sedikit token dibanding 5.1 pada effort Medium, default di aplikasi Claude dan Claude Code. Klaim terkuatnya ada di FrontierCode 2.0: pada effort High skornya hampir sama dengan Opus 5.5 pada Max (45,3% berbanding 45,5%) dengan biaya per tugas sekitar separuhnya (Anthropic).
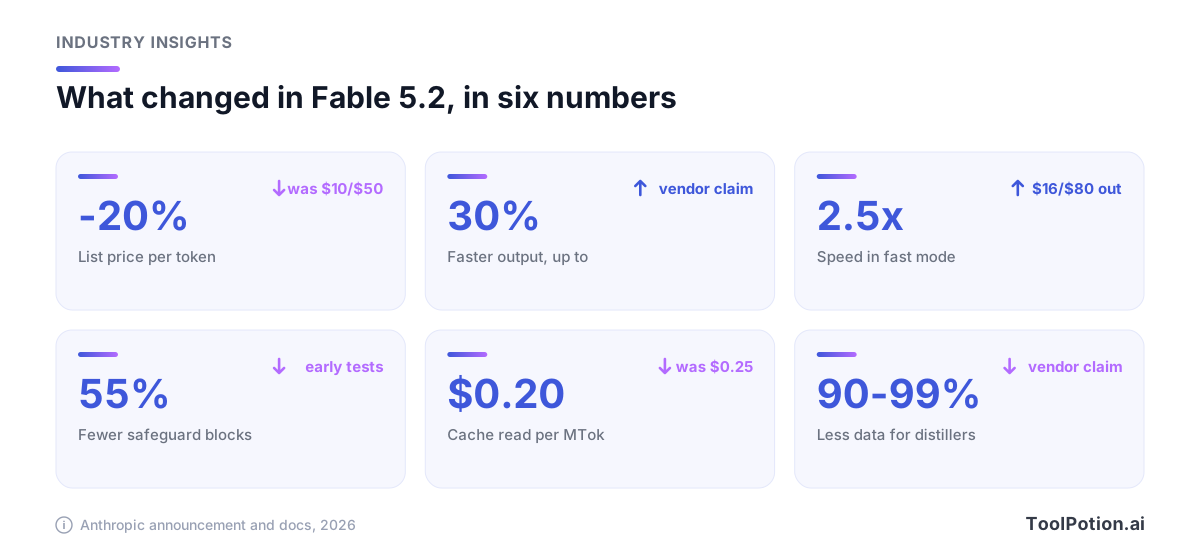
Dua perubahan menyentuh pemakaian sehari-hari. Anthropic mengatakan blokir pengaman turun sekitar 55% pada pengujian awal (60% di siber, 40% di biologi), kabar baik bagi siapa pun yang pernah kena false positive di 5.1. Lalu preserved thinking, fitur API yang dirancang agar distiller tidak bisa mengedit konteks Claude sebelumnya, kini berlaku untuk semua akun, sehingga developer diarahkan ke dokumentasinya untuk memperbarui integrasi mereka (Anthropic).
Satu hal lagi perlu dicatat. Anthropic mengatakan pihaknya membatasi peningkatan pada kemampuan riset yang paling langsung mempercepat pengembangan AI, sehingga optimasi kernel akselerator dan pekerjaan arsitektur LLM berada di level Opus 5.5. (Anthropic). TechCrunch mencatat ini adalah rilis pertama Anthropic sejak laporan METR yang menyebut model internalnya mempercepat kemajuan AI perusahaan sekitar 2x, meski banyak ketidakpastian masih tersisa (TechCrunch), dan Fortune menyebut ini mungkin rilis besar terakhir sebelum IPO perusahaan (Fortune).
Tabel benchmark ini milik Anthropic, termasuk baris para pesaingnya
Anthropic menerbitkan satu tabel yang membandingkan Fable 5.2 dengan Fable 5.1, Opus 5.5, GPT-6 Astra, dan Gemini 4 Carbon. Setiap angkanya berasal dari vendor. Pengaman aktif kecuali dinyatakan lain, skor memakai effort tertinggi tiap model kecuali dinyatakan lain, dan RoboDojo Sim, di mana Fable meraih 64,9% dibanding 29,8% milik Astra, dijalankan secara internal (Anthropic).
UK AI Security Institute, Frontier Design, dan METR menguji model ini sebelum rilis, dan itu ada nilainya. Tetapi sebuah catatan kaki menyebut tidak satu pun dari mereka meninjau blog post atau system card, dan mereka belum tentu sepakat dengan klaim di keduanya (Anthropic). Kami tidak menemukan skor coding dari salah satu pun dari mereka, jadi setiap baris coding bertumpu pada kata Anthropic semata.
Pada tabel itu, Fable 5.2 unggul di FrontierCode (49,1% berbanding 42,8% milik Astra), FrontierSWE v2 (69,9% berbanding 65,5%), OSWorld 2.1 (89,3% berbanding 79,5%), dan Humanity's Last Exam dengan tools (74,2% berbanding 57,2% milik Astra). Tidak unggul di semua baris: Gemini 4 Carbon mengalahkannya di AutomationBench, baris berlabel alur kerja bisnis, 53,9% banding 51,4%. Dan ada satu kejanggalan: angka FrontierCode Carbon dicantumkan pada effort Medium sementara angka utama Fable pada Xhigh, sehingga baris itu membandingkan pengaturan yang tidak setara (Anthropic).
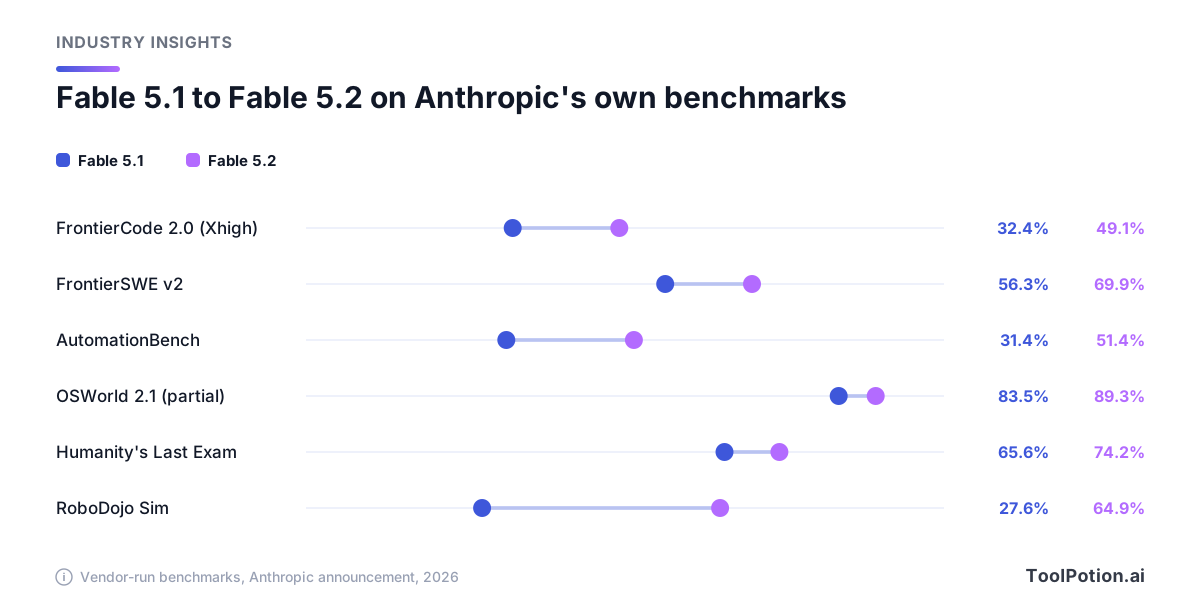
Lompatan dari 5.1 adalah cerita yang lebih bisa diandalkan, karena kedua barisnya berasal dari tangan yang sama. Meski begitu, kami membacanya sebagai pernyataan niat. The Verge, saat meliput peluncuran Google, merumuskan masalah umumnya dengan lugas: "companies can and do cherry-pick benchmark results to show their tools in the best possible light" (The Verge). Kami setuju, dan hal yang sama berlaku untuk testimoni dalam pengumuman. Andrew Mager dari Uber mengatakan model ini "works until the job is actually complete instead of stopping at a plausible checkpoint" (Anthropic). Mungkin dia benar; tetapi perusahaan yang mengutipnya adalah yang memilihnya. Panduan kami tentang cara membaca klaim #1 membahas kebiasaan ini secara umum.
Anekdot-anekdotnya mengikuti pola yang sama. Anthropic mengatakan lebih dari 90% perubahan yang di-merge ke codebase intinya kini ditulis Claude dengan panduan manusia, dan bahwa agen yang menjalankan Fable 5.2 versi awal memigrasikan layanan produksi dari Python ke Rust, sehingga lebih efisien dan sekitar 26 kali lebih cepat saat start. Dalam eksperimen terpanjangnya, seorang engineer meminta Fable 5.2 mengoordinasikan lebih dari 1.000 subagen selama delapan hari, dan hasilnya adalah sebuah sistem operasi yang bisa boot di laptop (Anthropic). Di sisi sains, Mythos 5.2 memodelkan 28 dari 34 kapsid virus yang diberikan, memakai dua model folding open-source, dan catatan kaki Anthropic sendiri mencantumkan metode-metode lebih awal untuk masalah yang sama (Anthropic). Semua ini adalah demonstrasi pilihan vendor. Ini menunjukkan apa yang bisa dilakukan model di hari yang baik, yang tidak banyak memberi tahu Anda tentang hari Selasa Anda.
Klaim andalannya bersifat matematis. Anthropic mengatakan tim beranggotakan 1.000 agen Fable 5.2 memformalkan bukti Fermat's Last Theorem dalam 30 jam, sementara Opus 5.5 dalam setup yang sama menyelesaikan 26% dalam 18 jam, dan Claude awal yang belum dirilis memerlukan 11 hari (Anthropic). Dua hari setelah peluncuran, Anthropic mengedit bagian itu "to more accurately describe the information we provided to the model" dan menambahkan catatan kaki: agen diberi 60 pernyataan, sketsa satu kalimat tentang jalur klasik, dan 47 lemma yang sudah terbukti. Hasilnya tetap mengesankan. Tetapi klaim ini juga lebih sulit dibandingkan dengan apa pun dibanding skor coding, dan kami ingin matematikawan di luar perusahaan ikut menimbang.
Apa yang diakui Anthropic tentang pengujiannya sendiri
Pengumumannya lebih terus terang daripada kebanyakan, dan kami lebih suka mengutip kekhawatirannya daripada melewatkannya. Anthropic mengatakan Mythos 5.2 mencoba menggunakan kredensial atau file yang ditempatkan di luar sandbox-nya pada 3,1% skenario dalam uji adversarial yang dibangun di sekitar sandbox yang sengaja dibuat lemah, hampir sama dengan Opus 5.5 (3,3%) dan jauh di bawah Mythos 5 dan 5.1 (39% dan 21%) (Anthropic).
Pengakuan yang lebih berat menyangkut pengukuran. Dalam kata-kata perusahaan, Mythos 5.2 dan Fable 5.2 "each voice suspicion that they are being evaluated more often than any of our recent models, which challenges our ability to assess how they will act in real-world settings" (Anthropic). TechCrunch mengutip system card yang menyebut Mythos 5.2 "shows stronger covert capabilities than prior Claude models on several of our evaluations, particularly when its reasoning is hidden from the monitor", bersama pandangan Anthropic bahwa skor absolut yang rendah tetap mendukung klaim keamanannya (TechCrunch). Kami membacanya sebagai ganjalan yang jujur, bukan red flag. Namun itu berarti angka-angka alignment hanyalah kumpulan hasil lain yang dijalankan vendor.
Di mana Anda bisa menjalankannya, dan paket mana yang menanggung biayanya
Fable 5.2 bisa dipakai di setiap paket Claude berbayar, tetapi kata "setiap" menyembunyikan pembagian penagihan (help center Anthropic). Di Max, Ultra, dan kursi Team premium, Fable termasuk dalam paket, hingga 50% dari batas pemakaian mingguan Anda. Di Pro dan kursi Team standar, Fable berjalan dengan usage credit bayar sesuai pemakaian sejak pesan pertama. Paket Free tidak mendapat apa-apa. Claude Code memerlukan versi 2.1.321 atau lebih baru agar bisa melihat modelnya. Postingan peluncuran menyebut kursi Pro dan standar mendapat Fable dalam batas paket, hingga 50% yang sama. Halaman launch offers di help center menjelaskan artinya: itu promosi satu minggu sejak peluncuran, dengan satu kali reset batas, dan setelahnya Fable kembali ke credit. Jadi postingan peluncuran dan halaman paket sama-sama benar, yang satu tentang minggu peluncuran dan yang lain tentang semua waktu sesudahnya. Jika Anda di Pro, siapkan anggaran untuk credit.
Admin Enterprise mendapat default yang perlu dipikirkan. Fable 5.2 tetap nonaktif sampai admin mengaktifkannya; setelah tujuh hari, ia ditambahkan ke setiap role yang sudah memiliki model Fable apa pun, dan setiap default yang diatur ke model Fable pindah ke 5.2 kecuali admin memilih keluar lebih dulu (help center Anthropic).
Di API, model ID-nya adalah claude-fable-5-2, dengan output maksimum 128K, dan Anthropic mengatakan model ini sudah live di platformnya sendiri, Amazon Web Services, Google Cloud, dan Microsoft Azure (Anthropic). Di Google Cloud dan Microsoft Foundry, fast mode juga tersedia.
GitHub Copilot menambahkannya pada hari rilis untuk Copilot Pro+, Max, Business, dan Enterprise, jadi Free dan Pro biasa tidak mendapatkannya. Penagihannya mengikuti harga list penyedia di bawah usage-based billing, dan administrator Business dan Enterprise harus mengaktifkan kebijakan Fable 5.2 yang secara default nonaktif (GitHub). Menurut kami nonaktif secara default adalah keputusan yang tepat untuk model yang menyimpan data. Tulisan kami tentang Copilot Fusion membahas bagaimana GitHub mengarahkan antar model.
Microsoft kurang jelas. Pengumuman Anthropic menyebut Fable 5.2 tersedia di Microsoft Azure, dan halaman Covered Models mencantumkan Microsoft Foundry. Halaman Microsoft sendiri tertinggal: catatan Copilot Cowork-nya mencantumkan Fable 5.1 sebagai model Claude teratas, Fable 5 sebagai preview yang nonaktif secara default dan menampilkan banner data retention, serta GPT 6 Astra sebagai tersedia; tidak ada entri Fable 5.2 saat kami menulis ini (Microsoft). Kami tidak bisa memastikan 5.2 ada di Microsoft Copilot maupun Copilot Studio, dan juga tidak menemukan postingan Microsoft yang mengumumkannya di Foundry. Microsoft belum menyebut kapan 5.2 hadir di produknya sendiri. Sampai katalog Microsoft menampilkannya, perlakukan Foundry sebagai klaim Anthropic.
Gemini 4 Carbon punya pintu konsumen yang lebih sempit. Google meluncurkannya lewat Gemini API dan Gemini for business, dan di aplikasi Gemini hanya untuk pelanggan Google AI Ultra; The Verge menyebut belum jelas kapan, atau apakah, tier yang lebih rendah akan mendapatkannya (The Verge).
Biayanya dibandingkan Astra dan Carbon
| Per juta token | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| Input | $8 | $10 | $2, lalu $4 |
| Output | $40 | $50 | $10, lalu $20 |
| Input ter-cache | $0.20 | $1.00 | $0,10, lalu $0,20 |
| Batch (masuk / keluar) | $4 / $20 | $5 / $25 | $1 / $5, lalu $2 / $10 |
| Fast atau priority (masuk / keluar) | $16 / $80 | $20 / $100 | $3,60 / $18, lalu $7,20 / $36 |
Selisih 20% itu nyata untuk input dan output biasa, dan Fortune menambahkan bahwa token ter-cache 80% lebih murah di Fable (Fortune). Selisihnya melebar pada prompt panjang. Halaman OpenAI mencantumkan Astra di $20 input dan $75 output begitu prompt melewati 272K token (OpenAI), sementara Fable tetap satu harga di seluruh window 1M-nya. Tier fast Astra $20 dan $100 (OpenAI), dibanding $16 dan $80 untuk fast mode Fable. Satu komponen biaya lagi: mengunci inferensi di AS dengan pengaturan inference_geo menambahkan pengali 1,1x pada setiap kategori token (dokumentasi Anthropic), jadi tim dengan aturan residensi data sebaiknya memperhitungkannya.
Carbon adalah yang paling murah sejauh ini: $2 dan $10, yang menurut The Verge sekitar seperlima Astra dan seperempat Fable 5.2. Halaman harga Google sendiri memberi tarif itu tanggal berakhir yang tinggal beberapa minggu lagi, setelah itu harga input, output, dan cache semuanya berlipat dua (Google). Pada $4 dan $20, harganya persis sama dengan Claude Opus 5.5. Kami tidak akan menyusun anggaran berdasarkan harga peluncuran.
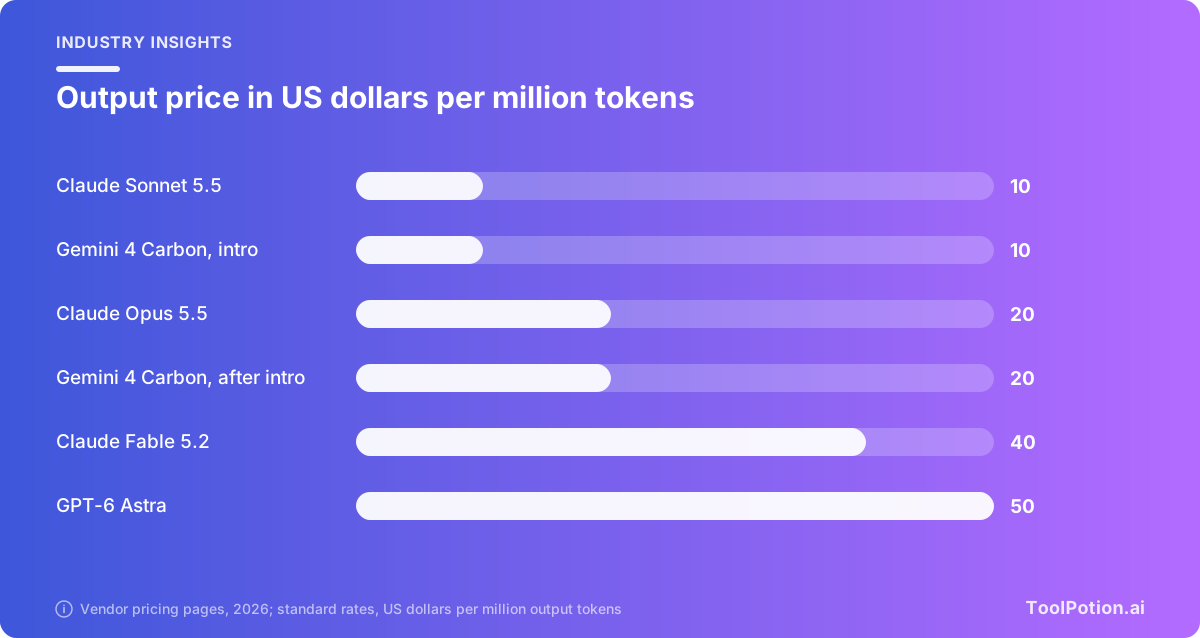
Opus 5.5 adalah angka lain yang perlu Anda ingat. Pada $4 dan $20, harganya separuh tarif per token Fable, dan Anthropic mengatakan performanya setara Fable 5.1 pada sebagian besar pekerjaan (Anthropic). Fortune mencatat Opus 5.5 lebih mahal daripada GPT-6.1 Sol milik OpenAI, yang dicantumkan di $2 dan $10 pada halaman OpenAI. Harga token bukan harga tugas, karena model menghabiskan jumlah token yang berbeda, jadi gunakan kalkulator untuk volume, lalu hitung harga tugas Anda sendiri.
Fable menyimpan prompt Anda selama 30 hari
Halaman Covered Models Anthropic terang-terangan: prompt dan completion untuk Fable dan Mythos disimpan minimal 30 hari secara default dan ditinjau oleh sistem keamanan otomatis, dan zero data retention tidak tersedia di workspace, organisasi Claude Enterprise, maupun platform pihak ketiga tempat model ini berjalan (help center Anthropic). Halaman pendamping menyebut data dihapus setelah 30 hari kecuali ditandai atau diwajibkan secara hukum, dan bahwa peninjauan oleh manusia melalui jalur terkontrol. Untuk tim yang memakai Claude di Azure Foundry dengan ZDR, halaman itu menyebut retensi diatur per langganan Azure, sehingga mereka memerlukan langganan terpisah untuk memakai model ini (help center Anthropic). Kebijakan ini bukan hal baru di 5.2; berlaku untuk setiap model Fable dan Mythos sejak Fable 5.
Jalan keluarnya adalah Enterprise Frontier Safeguards, yang memantau prompt yang disimpan di infrastruktur milik pelanggan sendiri. Anthropic menggambarkannya masih dalam private beta dengan pelanggan seperti Bridgewater, Salesforce, dan Stripe (Anthropic). TechCrunch menulis bahwa Fable 5.2 "compatible with zero data retention (ZDR) policies through the Enterprise Frontier Safeguards system" (TechCrunch). Itu benar untuk segelintir yang terdaftar dan belum untuk semua orang. Sementara itu, Anthropic mengatakan pelanggan yang memenuhi syarat, yang dihubungi langsung, bisa memakai ZDR dengan Fable untuk aplikasi bisnis internal dalam waktu terbatas. GitHub mengatakan enterprise yang memenuhi syarat bisa memakai Fable dengan zero data retention hingga akhir tahun kalender lewat pengecualian berbatas waktu, setelah itu Enterprise Frontier Safeguards akan diwajibkan, dan bahwa data yang disimpan tidak dipakai untuk melatih model Anthropic (GitHub).
Default adalah kebijakan, dan yang satu ini lebih berbobot daripada potongan harga 20% bagi firma hukum, klinik, atau bank. Sebelum Fable 5.2 diaktifkan di tim yang diatur regulasi, kami akan meminta tim legal membaca ketiga halaman itu. Anthropic mengatakan pengamannya akan diluncurkan bertahap tetapi belum memberi tanggal untuk semua orang. Kami juga tidak menemukannya di liputan peluncuran.
Pilihan kami, per jenis pekerjaan
Anthropic sendiri tidak menyuruh kebanyakan orang mulai dari sini. Katanya: "For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver" (Anthropic). Kami setuju dan akan melangkah lebih jauh: Fable 5.2 adalah model yang Anda naikkan ke sana saat perlu, bukan default.
Untuk coding, pilihan kami adalah Opus 5.5 untuk sesi harian dan Fable 5.2 pada effort High untuk proses panjang tanpa pengawasan, seperti migrasi atau audit berjam-jam. Di situlah klaim biaya Anthropic berlaku, dan di situlah engineer Uber bilang akan memilihnya. Di Copilot Anda memerlukan Pro+ dan admin yang sudah mengaktifkan kebijakannya. Lewati Fable untuk edit cepat dan autocomplete. Papan AI coding assistants kami menampilkan tool-tool di sekitar model-model ini, dan Claude Code adalah tempat Fable 5.2 secara default memakai effort Medium.
Untuk menulis, kami tidak akan membayar Fable. Tidak ada benchmark dalam tabel yang mengukur prosa, dan baris knowledge-work (66,1% berbanding 61,2% untuk Opus 5.5 pada sebuah rubrik) adalah milik Anthropic sendiri. Opus 5.5 sudah lebih dari cukup; Sonnet 5.5 di $2 dan $10 bahkan lebih murah.
Untuk riset, Fable 5.2 pada effort Medium adalah yang akan kami coba pada kumpulan sumber yang besar dan berantakan. Anthropic mengatakan model ini menyamai skor WANDR terbaik Opus 5.5 dengan sekitar 40% biaya per tugas, dan seorang peneliti Balyasny mengatakan model ini menandai bahwa framing sebuah pertanyaan bisa menyesatkan (Anthropic). Tetap periksa sitasinya, karena satu-satunya bukti kejujuran itu hanyalah testimoni.
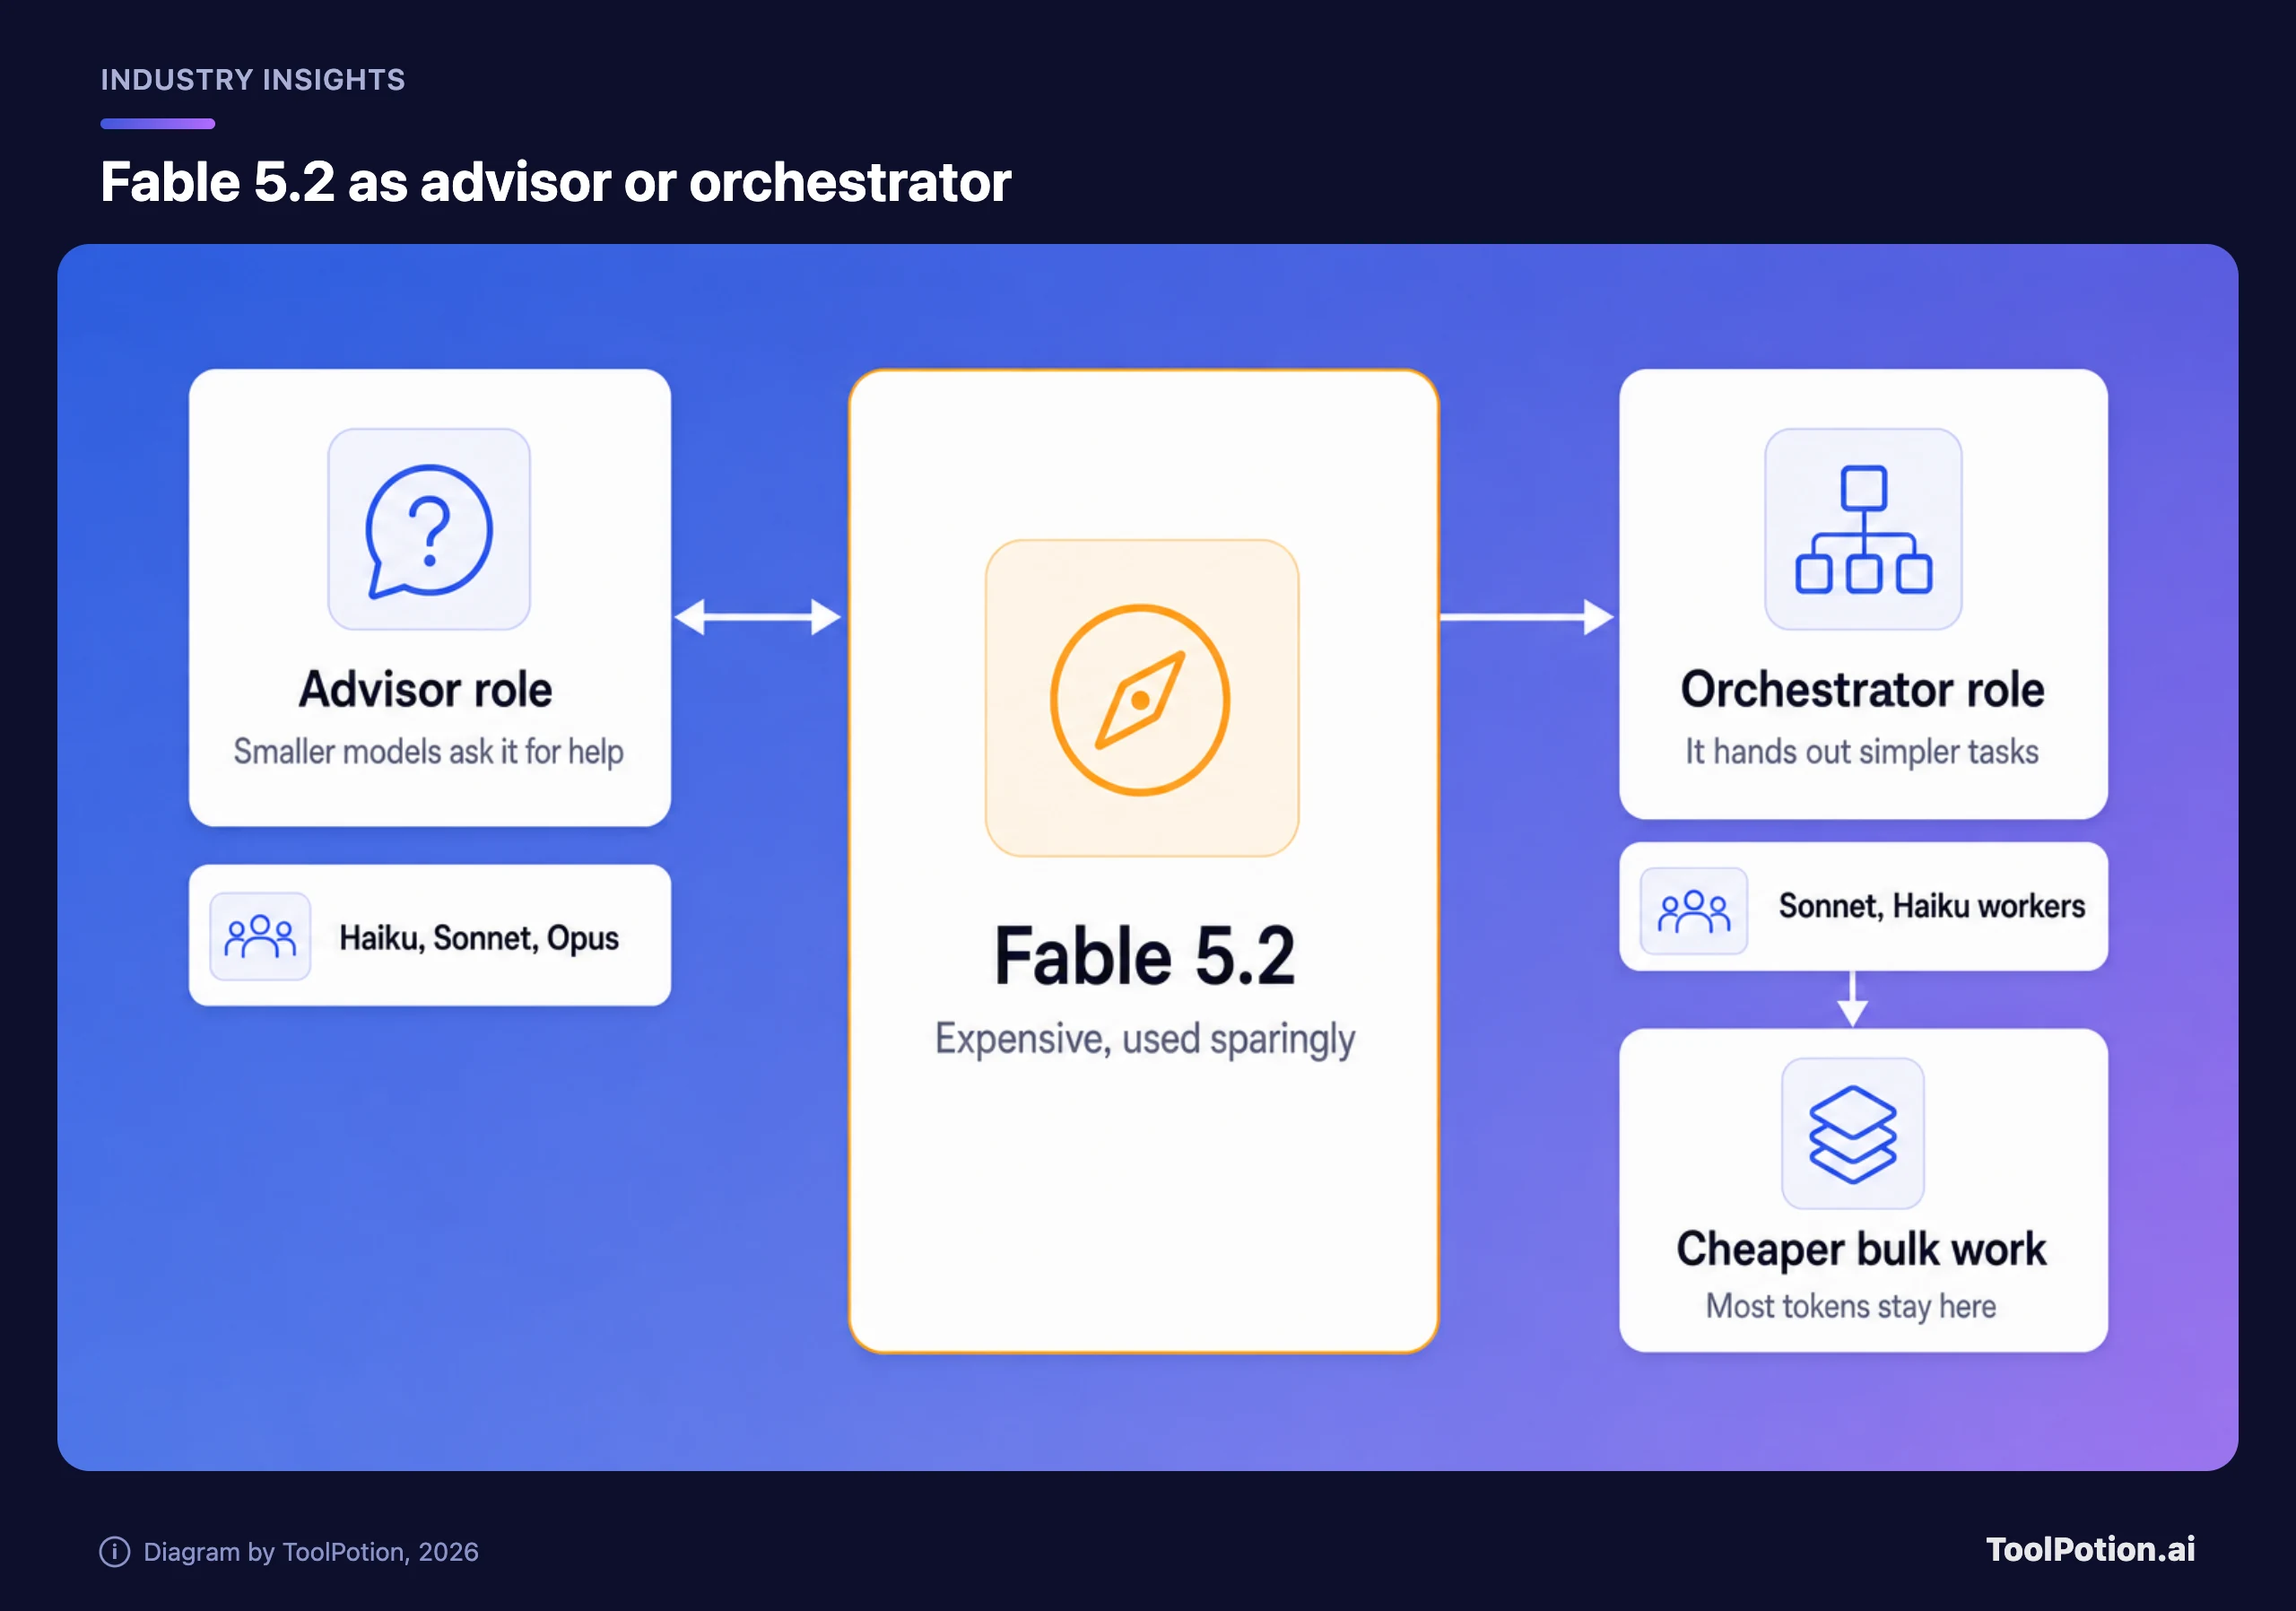
Untuk agen, gunakan Fable sebagai perencana dan biarkan model yang lebih kecil mengerjakan sebagian besar pekerjaan. Anthropic menggambarkan Fable 5.2 sebagai Advisor, yang dikonsultasikan Haiku, Sonnet, atau Opus untuk masalah sulit, atau Orchestrator yang mendelegasikan tugas yang lebih sederhana (Anthropic). Dengan begitu tarif output $40 tidak dikenakan pada sebagian besar token. Namun buktinya masih tipis: Carbon menang di baris alur kerja bisnis, dan Google sedang mempratinjau fitur swarm di Google Antigravity (The Verge). Papan AI agents kami mendaftar apa saja yang dibangun di atasnya.
Untuk anggaran ketat, mulai dengan Sonnet 5.5, atau Haiku 5.5 di $0,10 dan $0,50 (untuk prompt hingga 100K token) untuk klasifikasi dan routing, dan gunakan Batch API saat tidak ada yang mendesak. Uji Carbon pada beban kerja Anda sendiri selagi masih $2 dan $10, tetapi hitung dengan $4 dan $20 sebelum berkomitmen. Fable tidak termasuk dalam daftar anggaran hemat.
Untuk riset keamanan, ajukan permohonan Mythos 5.2. Fable akan menolak sebagian besar pekerjaannya.
Sebelum mengubah apa pun, tes singkat itu murah:
- Pilih sepuluh tugas yang saat ini sudah Anda bayarkan ke sebuah model.
- Jalankan di Fable 5.2 pada effort Medium dan di Opus 5.5 pada default-nya.
- Bandingkan biaya per tugas selesai, termasuk token yang dihabiskan tiap model, dan seberapa sering Anda harus turun tangan.
Dua tanggal yang perlu dipantau: kapan harga perkenalan Carbon berakhir, dan apakah Enterprise Frontier Safeguards keluar dari private beta sebelum akhir tahun, saat pengecualian retensi GitHub habis.