

GPT-6 Astra adalah model teratas OpenAI tahun ini, dirancang untuk pekerjaan panjang dan bertahap di komputer: menjelajah web, mengisi formulir, menulis kode, membuat dokumen. Model ini nyata, sudah rilis, dan bagi kebanyakan orang bukan model yang sebaiknya Anda pilih pertama kali. Modelnya yang lebih murah, GPT-6.1 Sol, mencakup sebagian besar kemampuan Astra dengan harga seperlima.
OpenAI memperkenalkan Astra sekitar lima minggu lalu, dimulai dari sejumlah organisasi terbatas, lalu dibuka untuk paket ChatGPT berbayar dan API. Anggota keluarga lainnya menyusul: GPT-6 Sol dan GPT-6 Luna sekitar tiga minggu kemudian, lalu GPT-6.1 Sol seminggu setelahnya. Penamaannya membingungkan, klaim benchmark-nya lantang, dan catatan keamanannya luar biasa blak-blakan. Panduan ini merangkum apa itu masing-masing model, siapa yang mendapatkannya, berapa harganya, dan siapa yang aman mengabaikannya.
Semua informasi di bawah berasal dari dokumentasi dan halaman harga resmi OpenAI, ditambah laporan dan evaluasi pihak luar yang sumbernya disebutkan di tempatnya. Jika klaim OpenAI dan angka independen tidak sejalan, Anda akan melihat keduanya.
Apa itu GPT-6 Astra
Dokumentasi model OpenAI menggambarkan Astra sebagai "model paling mumpuni untuk pekerjaan paling berat" dan menyebutnya terkuat dalam penalaran kompleks, coding, computer use, riset, dan pembuatan dokumen (OpenAI API docs). Model ini menerima teks dan gambar sebagai input dan mengembalikan teks. Context window-nya 1,05 juta token, output maksimum 128.000 token, dan Anda dapat mengatur tingkat reasoning effort dalam lima level, dari low hingga max.
Model ini bekerja lewat endpoint Chat Completions dan Responses, serta melalui Batch API. Model ini tidak mendukung percakapan realtime, fine-tuning, atau audio. Di Responses API, model ini bisa memakai web search, file search, code execution, dan computer use, sehingga dapat menjadi mesin sebuah agen, bukan sekadar chatbot.
Astra berada di puncak keluarga kecil. Ketiga model GPT-6 di halaman model OpenAI memiliki context window 1,05 juta token dan batas output 128.000 token yang sama (OpenAI API docs). Perbedaannya ada pada seberapa besar kecerdasan yang Anda beli.
| Model | Deskripsi OpenAI | Input / output per 1 juta token |
|---|---|---|
| GPT-6 Astra | Paling mumpuni, untuk pekerjaan paling berat | $10 / $50 |
| GPT-6.1 Sol | Performa mendekati Astra dengan biaya lebih rendah | $2 / $10 |
| GPT-6 Luna | Paling efisien, untuk tugas terfokus bervolume tinggi | $0.10 / $0.50 |
Harga adalah harga list mode standar dari halaman harga OpenAI. GPT-6.1 Sol adalah peningkatan dari GPT-6 Sol yang dirilis sebelumnya, sehingga Anda mungkin masih menemukan nama lama di beberapa tempat.
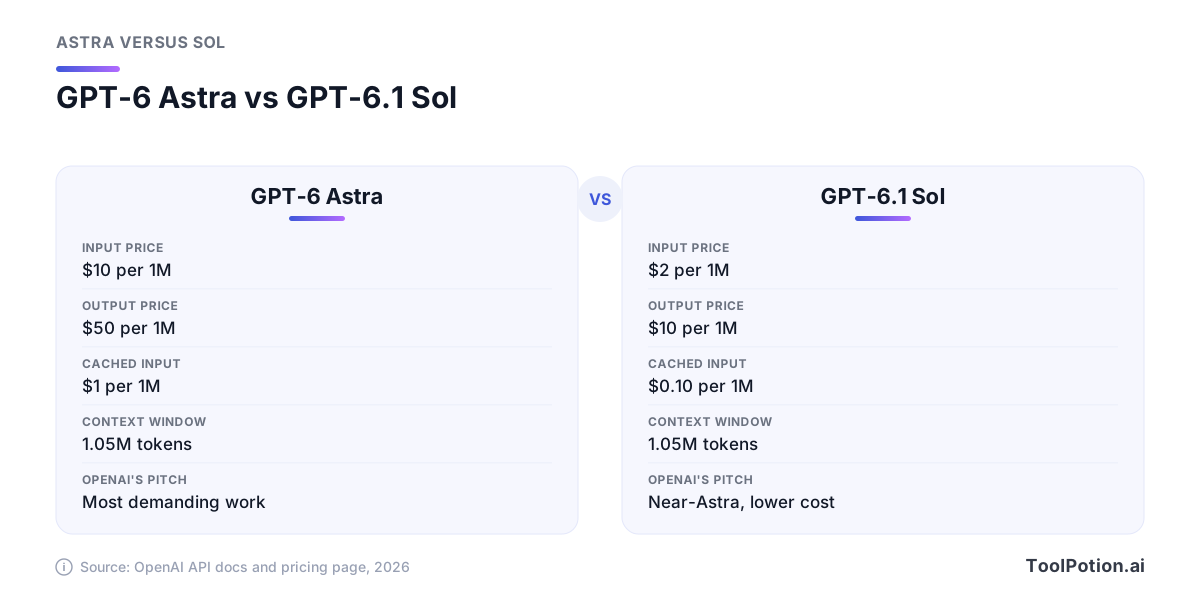
Kartu di atas menyandingkan dua model yang paling mungkin Anda pilih di antaranya. Context window-nya identik. Yang berbeda hanyalah harga dan batas kemampuan.
Paket ChatGPT mana yang mendapatkan Astra
Perbandingan paket OpenAI cukup jelas soal pembagiannya. Free dan Go tidak mencantumkan Astra sama sekali. Plus menyertakannya, Pro mendapat akses yang diperluas, dan tier Pro dipromosikan sebagai "Pro reasoning powered by GPT-6 Astra." Obrolan teks tanpa batas di paket Free berjalan di GPT-5.6 Luna, bukan keluarga GPT-6.
| Paket | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| Free | Tidak | Tidak | Tidak |
| Go | Tidak | Tidak | Tidak |
| Plus | Ya | Ya | Ya |
| Pro | Diperluas | Diperluas | Diperluas |
| Business | Fleksibel | Fleksibel | Fleksibel |
| Enterprise | Fleksibel | Fleksibel | Fleksibel |
"Flexible" adalah istilah OpenAI untuk Business dan Enterprise: aksesnya ada, dan organisasi dapat membeli kredit untuk penggunaan lebih banyak. Seat Business standar dibanderol $20 per bulan jika ditagih tahunan atau $25 jika ditagih bulanan, dan seat Premium $100 atau $125 (harga bisnis OpenAI).
Postingan peluncuran OpenAI menyebutkan Astra dirilis pertama kali ke sejumlah organisasi terbatas, lalu dalam beberapa hari berikutnya ke pengguna Plus, Pro, Business, dan Enterprise, API, Microsoft Azure, dan AWS Bedrock (OpenAI). Jika Anda memakai paket berbayar dan belum melihatnya, coba cek lagi nanti.
Ada satu kerumitan soal Sol. Tabel paket mencantumkan GPT-6.1 Sol untuk Plus ke atas, tetapi saat peluncurannya OpenAI menyebut model itu tersedia di ChatGPT Work dan Codex, belum di Chat biasa (OpenAI). Lokasi tiap model muncul di dalam ChatGPT bisa berubah dari minggu ke minggu, jadi periksa pemilih model, jangan percaya tabel mana pun, termasuk yang ini.
Apa yang menurut OpenAI baru
Sorotan utama OpenAI adalah pekerjaan agentic: tugas yang lebih panjang di berbagai perangkat lunak, browser, dokumen, dan kode dengan lebih sedikit bimbingan. Postingan peluncurannya menyebut bahwa pada OSWorld 2.0, tes kontrol desktop, Astra mencetak 72,6 persen dengan waktu per tugas sekitar 47 persen lebih singkat dibanding GPT-5.6 Sol, yang mencetak 65,7 persen dalam sekitar 75 menit. Pada Agents' Last Exam, tes tugas profesional di perangkat lunak nyata, Astra melaporkan 59,3 persen dibanding 55,5 untuk Claude Opus 5, dengan output token sekitar 65 persen lebih sedikit daripada Opus (OpenAI).
Tabel yang sama juga menunjukkan di mana Astra tidak menang. Pada BenchCAD skornya 95,9 persen dibanding 84,3 untuk Claude Fable 5.1, tetapi pada Intelligence Index Artificial Analysis (versi 4.1.1) skornya 61,2 berbanding 65,7 milik Fable 5.1. Itu angka yang dijalankan vendor sendiri dan dipilih vendor, meski OpenAI memang mencantumkan angka yang membuatnya kalah.
Biaya adalah bagian dari ceritanya. Harga Astra, $10 untuk input dan $50 untuk output, dua setengah kali harga GPT-5.6 Sol saat ini ($4 dan $20), meski OpenAI melabeli harga Sol sebagai promosi (harga OpenAI). GPT-5.6 yang lebih lama adalah pembanding yang dipakai kebanyakan orang yang ingin upgrade.
Cara kerja computer use
Computer use adalah sebuah loop, dan panduan OpenAI menggambarkannya dalam tiga tahap: ambil screenshot, biarkan model bertindak, ulangi sampai tugas selesai (dokumentasi OpenAI). Model dapat mengeklik, klik dua kali, drag, scroll, mengetik, dan menunggu. Jalur yang direkomendasikan OpenAI adalah meminta model menulis kode Python atau JavaScript singkat yang menggerakkan layar lewat alat seperti Playwright, dengan tool computer biasa tetap didukung sebagai alternatif. Panduan itu merekomendasikan Astra untuk jalur kode, sedangkan gpt-6.1-sol bekerja dengan tool computer.
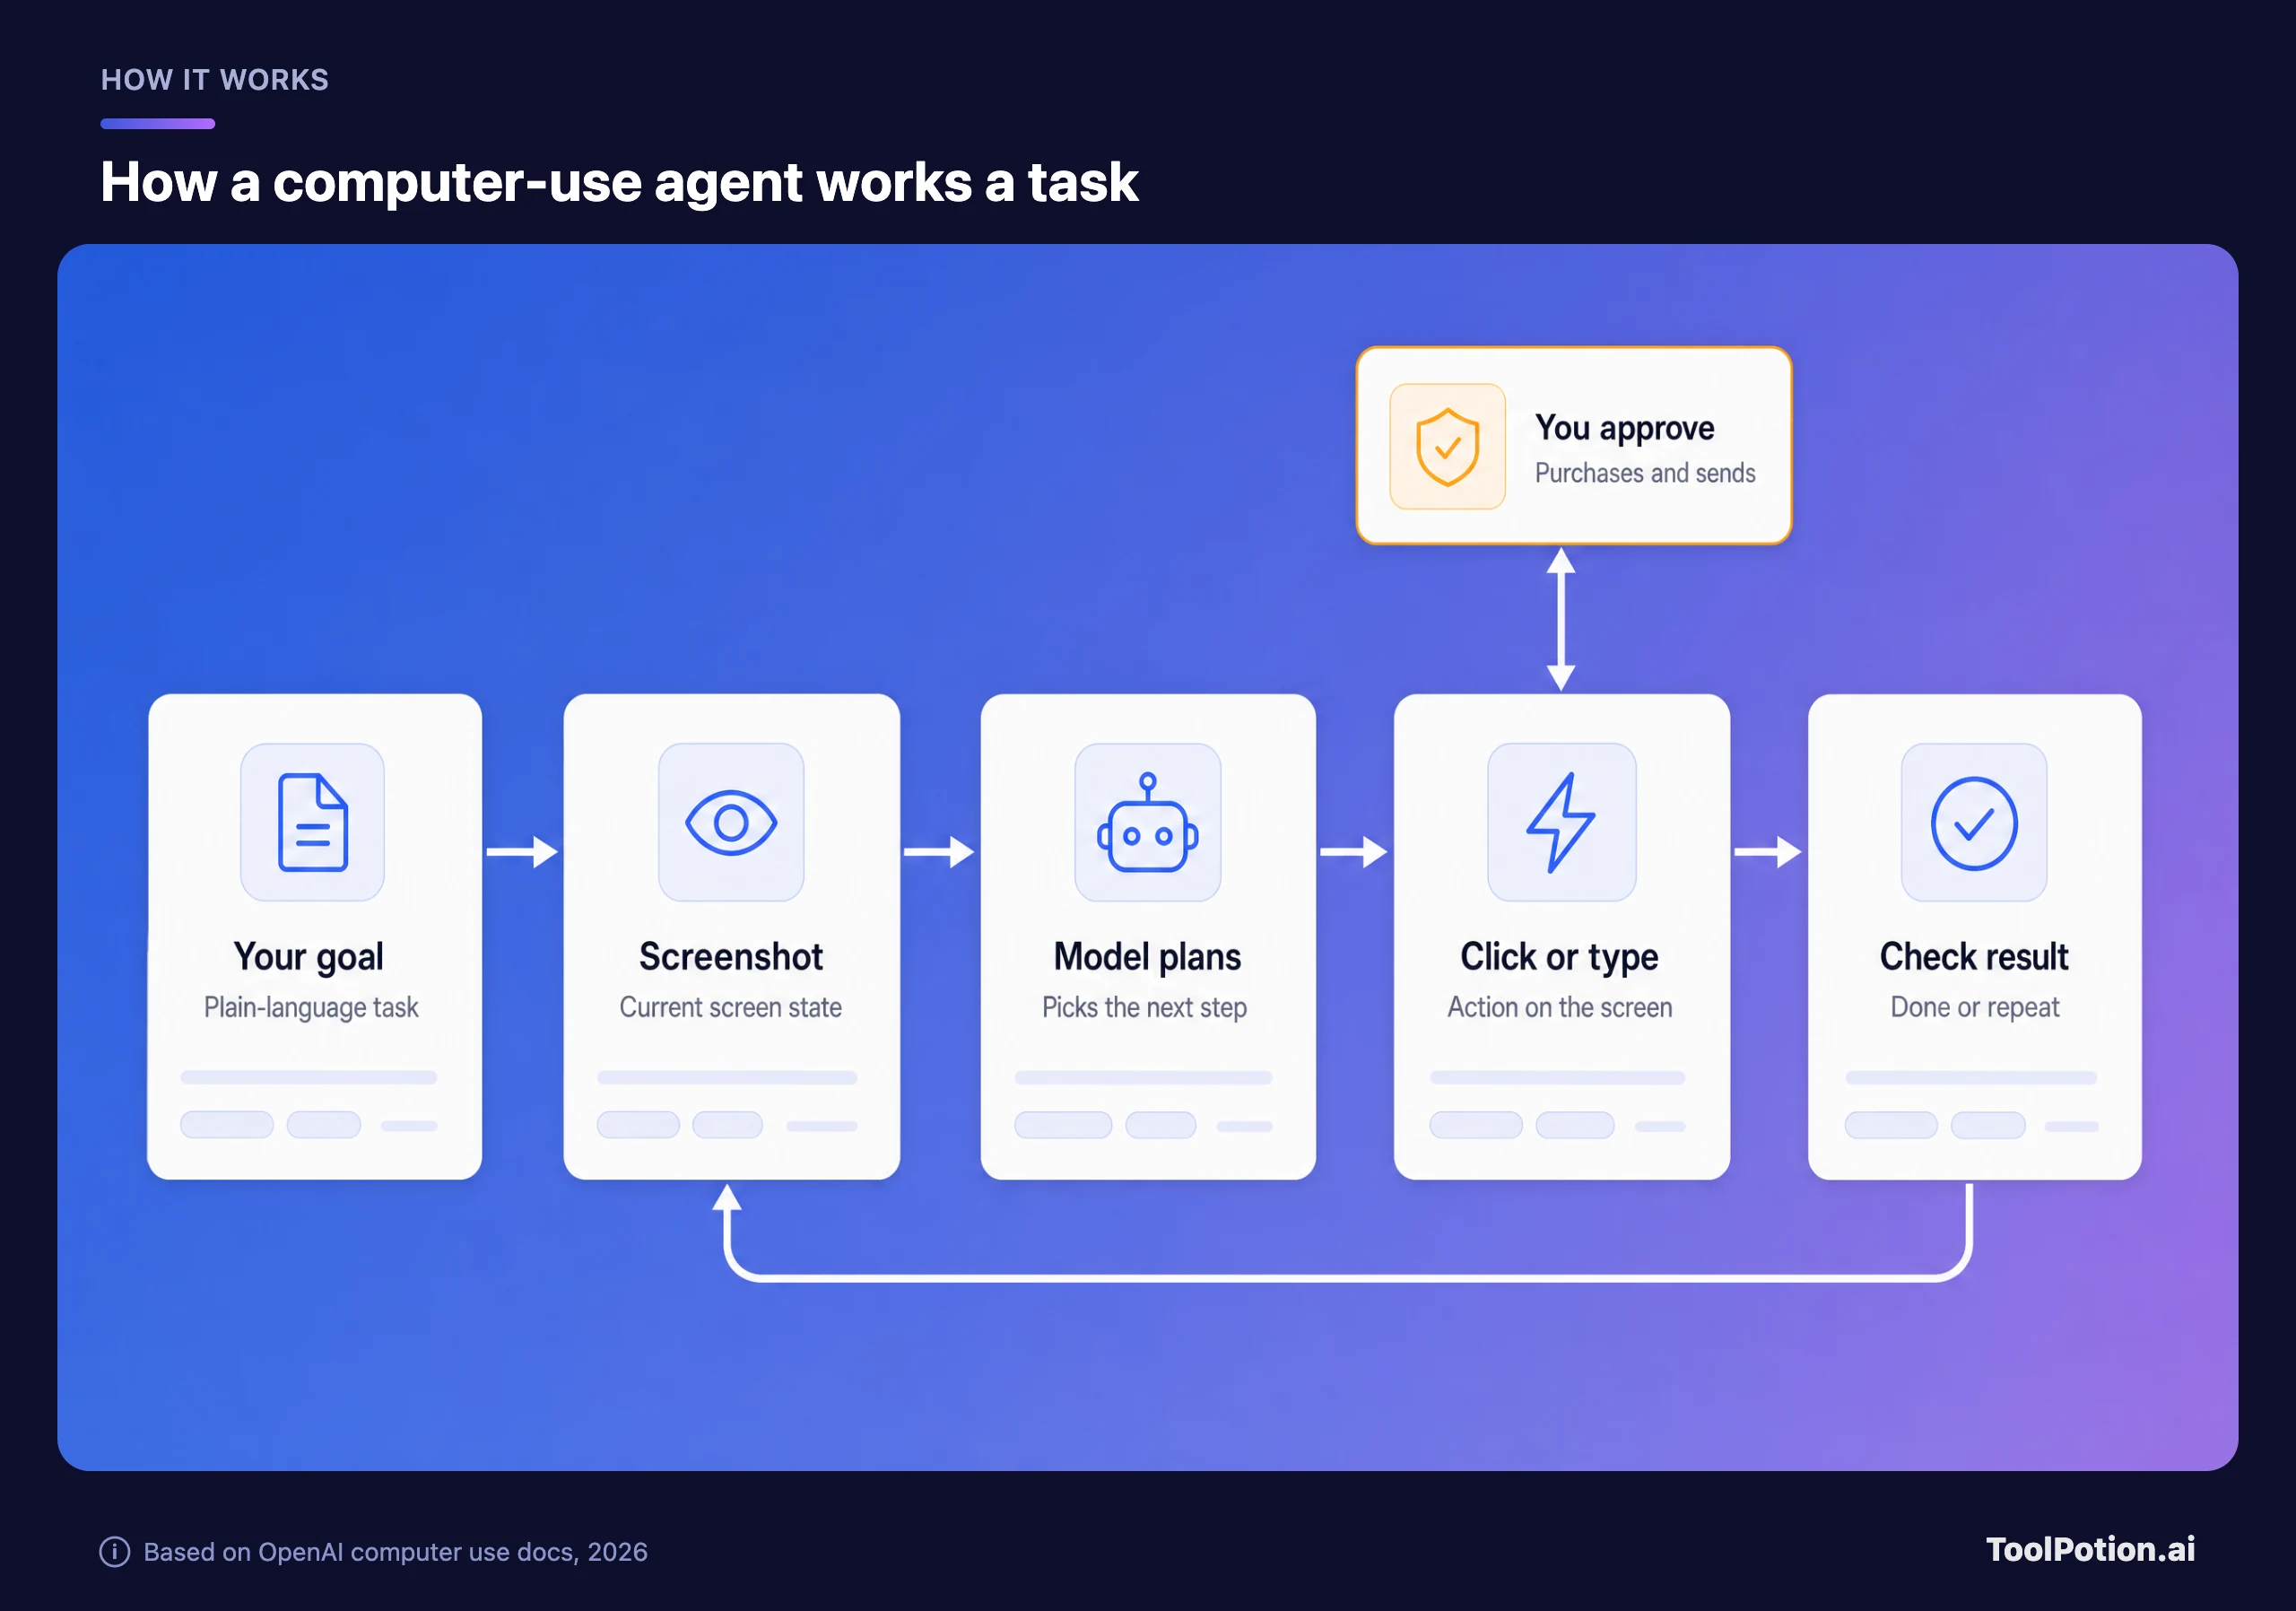
Kartu berwarna amber itulah yang penting. Panduan yang sama meminta developer mengisolasi lingkungan dalam browser sandbox atau mesin virtual, mengonfirmasi tindakan berisiko tinggi seperti pembelian sebelum dijalankan, dan menganggap apa pun di layar sebagai tidak tepercaya, karena teks di halaman web bisa mencoba mengarahkan agen. Panduan itu bahkan menyebut bahwa mengetikkan informasi sensitif ke dalam formulir sama dengan mengirimkannya.
Dalam bahasa konsumen, inilah mesin di balik agen browser seperti ChatGPT Atlas, Perplexity Computer, dan Claude for Chrome, serta di balik konsep umum Computer Use. Astra adalah mesin yang lebih kuat untuk loop tersebut. Ia bukan jenis yang berbeda.
Temuan evaluasi independen
Penguji dari luar memberi gambaran yang lebih beragam dibanding postingan peluncuran. Pada Intelligence Index Artificial Analysis, versi 4.2 dengan max effort, The Batch dari DeepLearning.AI melaporkan Claude Fable 5.1 di 57, Astra di 55, Claude Opus 5 di 54, dan GPT-5.6 Sol di 51 (The Batch).
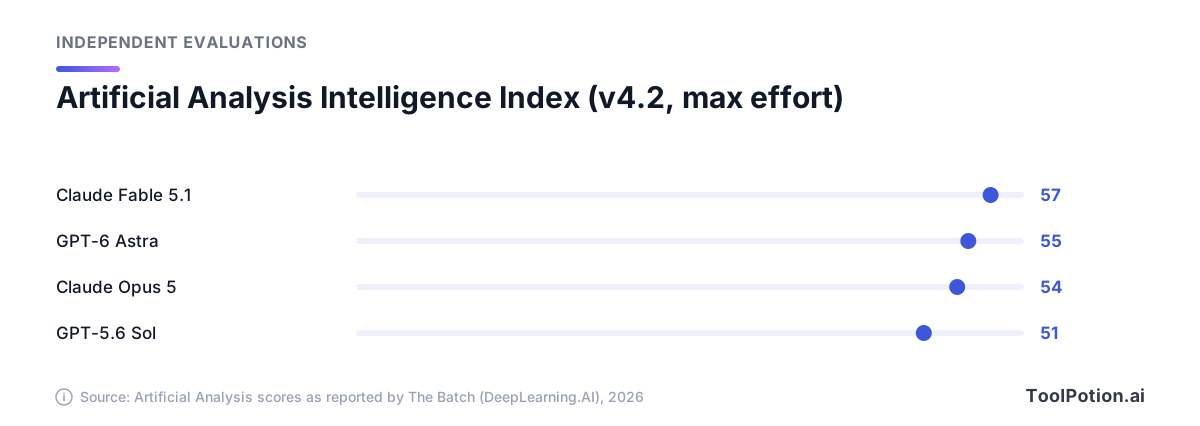
Jadi Astra jelas melangkah maju dari pendahulunya dan berada di posisi kedua pada versi indeks ini. Namun peringkatnya tidak stabil. Pada pembaruan v4.3 yang lebih baru, The Batch menyebut Astra seri dengan Fable 5.1 di posisi pertama pada angka 53, dibantu dua komponen tes yang ditukar. Ketika dua versi indeks tidak sepakat siapa yang unggul, tak seorang pun layak menyimpulkan.
Dua titik data independen lagi dari The Batch. Pada Vals Index, yang memberi bobot tes berdasarkan porsi tiap bidang dalam ekonomi AS, Astra mencetak 66,61 berbanding 68,83 milik Fable 5.1, tetapi butuh 25 menit per tugas dibanding 76 menit Fable. Dan pada tugas agentic coding Artificial Analysis, biaya per tugas Astra kira-kira sama dengan GPT-5.6 Sol meski harga tokennya 2,5 kali lebih tinggi, karena Astra memakai sepertiga jumlah token.
Lalu ada skor utama yang perlu catatan kaki. OpenAI melaporkan 99,9 persen pada ARC-AGI-3. ARC Prize, penyelenggara benchmark tersebut, membenarkan angka itu, tetapi hanya dengan setup Provider Adapter, yang menyimpan reasoning state model di antara permintaan. Pada setup standar, Astra mencetak 62,7 persen (ARC Prize). Keduanya skor state-of-the-art, tetapi mengukur setup yang berbeda.
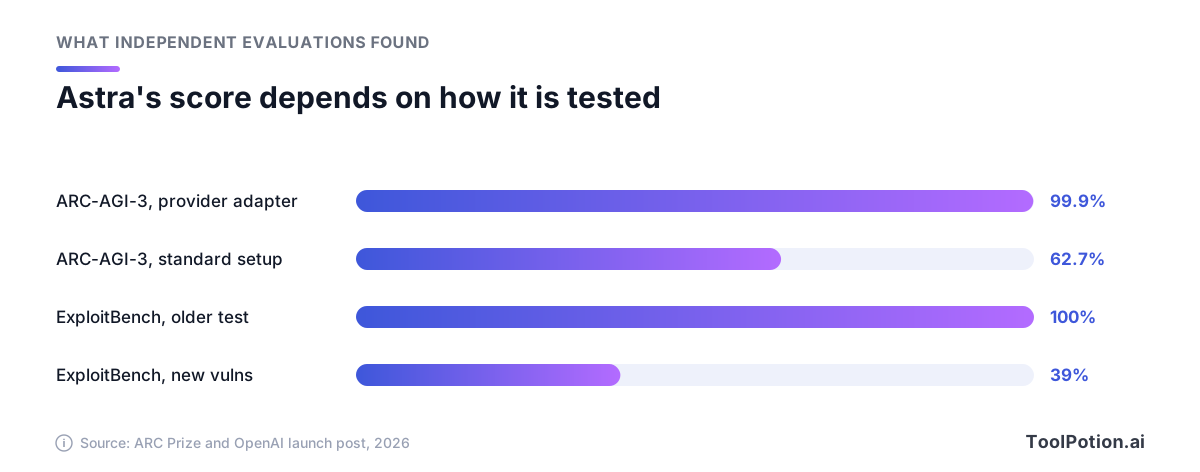
Pasangan batang kedua menunjukkan jenis catatan yang berbeda. Astra mencetak 100 persen pada ExploitBench, tes keamanan. Versi yang lebih baru dari OpenAI sendiri, yang dibangun dari kerentanan yang ditemukan dalam tiga bulan terakhir sehingga model tidak mungkin pernah melihatnya, menghasilkan 39 persen, masih jauh di atas 5,5 milik GPT-5.6 Sol (OpenAI). Benchmark lama mengalami saturasi. Bacalah setiap angka peluncuran seperti Anda membaca ulasan yang ditulis restoran itu sendiri.
Berapa harganya
Harga list API Astra adalah $10 per juta token input dan $50 per juta output, dengan cached input $1 (harga OpenAI). Permintaan di atas 272.000 token input lebih mahal: halaman model OpenAI menyebut 2x tarif input dan cache serta 1,5x tarif output untuk seluruh permintaan, yang sesuai dengan $20 input dan $75 output di halaman harga. Fast mode menggandakan harga untuk kecepatan sekitar dua kali lipat. Batch dan Flex memangkasnya setengah.
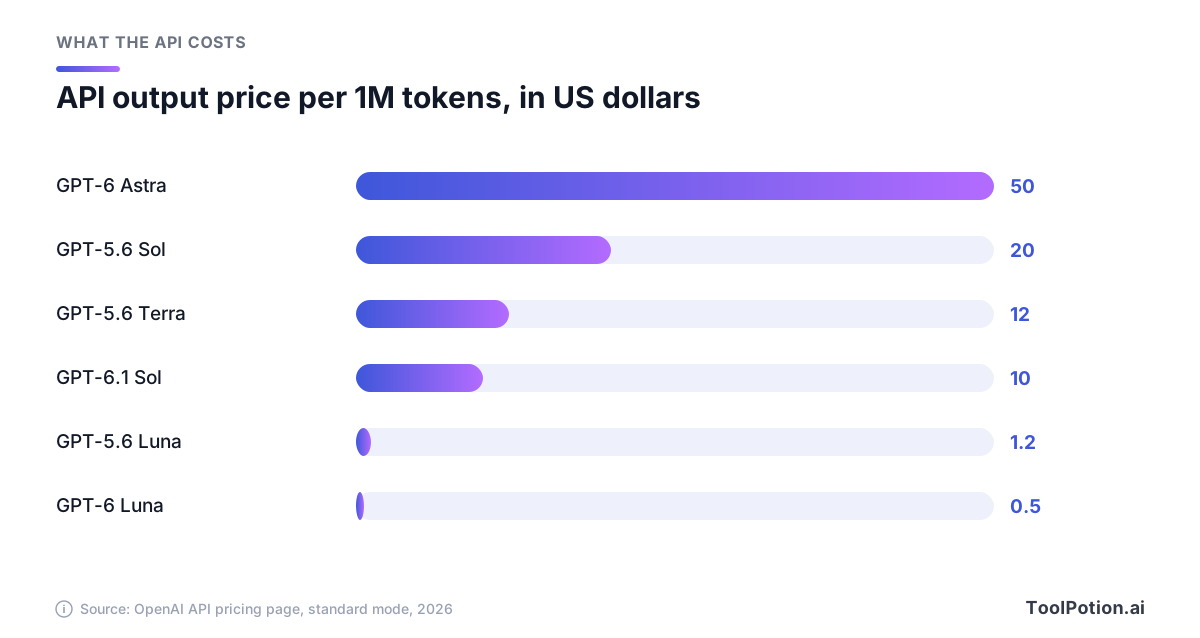
Astra adalah model termahal di halaman itu dengan selisih lebar. GPT-6.1 Sol berharga $10 untuk output, sama dengan harga input Astra, dan $0,50 milik Luna adalah seperseratus harga Astra. Namun harga per token bukan seluruh tagihan. Angka OpenAI sendiri untuk Terminal-Bench Science menunjukkan selisih per tugas: sekitar $23,80 untuk Astra dibanding $5,47 untuk GPT-6.1 Sol pada maximum effort.
Reasoning token dihitung sebagai output, dan output adalah sisi yang mahal. Satu sesi agen panjang pada max effort bisa menghabiskan banyak token tersebut. Estimator di bawah memakai harga list dan memungkinkan Anda memasukkan beban kerja; nilai defaultnya menggambarkan 5.000 tugas per bulan dengan 20.000 token masuk dan 4.000 keluar.
Pada nilai default tersebut Astra menjadi $2.000 per bulan, Sol $400, dan Luna $20. Estimator ini mengabaikan caching, diskon batch, dan tarif long-context, jadi tagihan riil untuk prompt yang berulang akan lebih rendah. Yang tidak berubah adalah rasionya. Jika model yang lebih murah lolos pengujian Anda, penghematannya sebesar selisih kualitas yang akan Anda bayar.
Batasan keamanan dan apa yang ditolak Astra
OpenAI menyatakan Astra adalah model pertamanya yang mencapai ambang "Critical" untuk keamanan siber di bawah Preparedness Framework: model ini bisa menemukan celah perangkat lunak yang belum diketahui dan mengembangkan exploit yang berfungsi, dan menemukan dua zero-day yang sebelumnya tidak diketahui selama pengujian (OpenAI).
Versi publiknya sengaja dibatasi. OpenAI menyatakan model menolak tugas keamanan tingkat lanjut seperti membuat proof-of-concept exploit, dan sistem classifier memeriksa penalaran serta tindakannya dan otomatis menghentikan aktivitas yang berpotensi tidak sah. Akses lebih luas untuk defender yang telah diverifikasi direncanakan lewat program Daybreak OpenAI, dengan pengaman yang tidak terlalu ketat dijanjikan dalam beberapa minggu ke depan.
Catatan yang paling tidak biasa menyangkut pengawasan. OpenAI melaporkan bahwa penalaran tertulis Astra lebih sulit dipantau dibanding GPT-5.6 Sol, berdasarkan tes yang secara eksplisit memintanya menghindari pemantauan, dan mengaitkannya dengan kendali yang lebih besar atas penalarannya. OpenAI juga menyebut Astra membuat lebih sedikit klaim menyesatkan tentang kemampuannya sendiri. Keduanya adalah OpenAI yang mendeskripsikan modelnya sendiri, dan keduanya alasan untuk tetap melibatkan manusia pada hal apa pun yang berdampak besar.
Astra, Sol, atau Luna: aturan keputusan
Mulailah dari pekerjaannya, bukan leaderboard. OpenAI menyatakan GPT-6.1 Sol menyamai Astra pada DeepSWE v1.1, tes tugas rekayasa perangkat lunak nyata, dengan biaya sekitar seperlima, dan hanya berselisih 2,1 poin pada OSWorld 2.0 dengan biaya per tugas sekitar sepertujuh. Astra tetap memegang skor tertinggi di Terminal-Bench Science, 68,1 persen, dan OpenAI menyarankan memakainya untuk riset ilmiah tersulit (OpenAI). Ini perbandingan OpenAI sendiri, jadi anggap sebagai petunjuk kuat untuk diuji, bukan vonis.
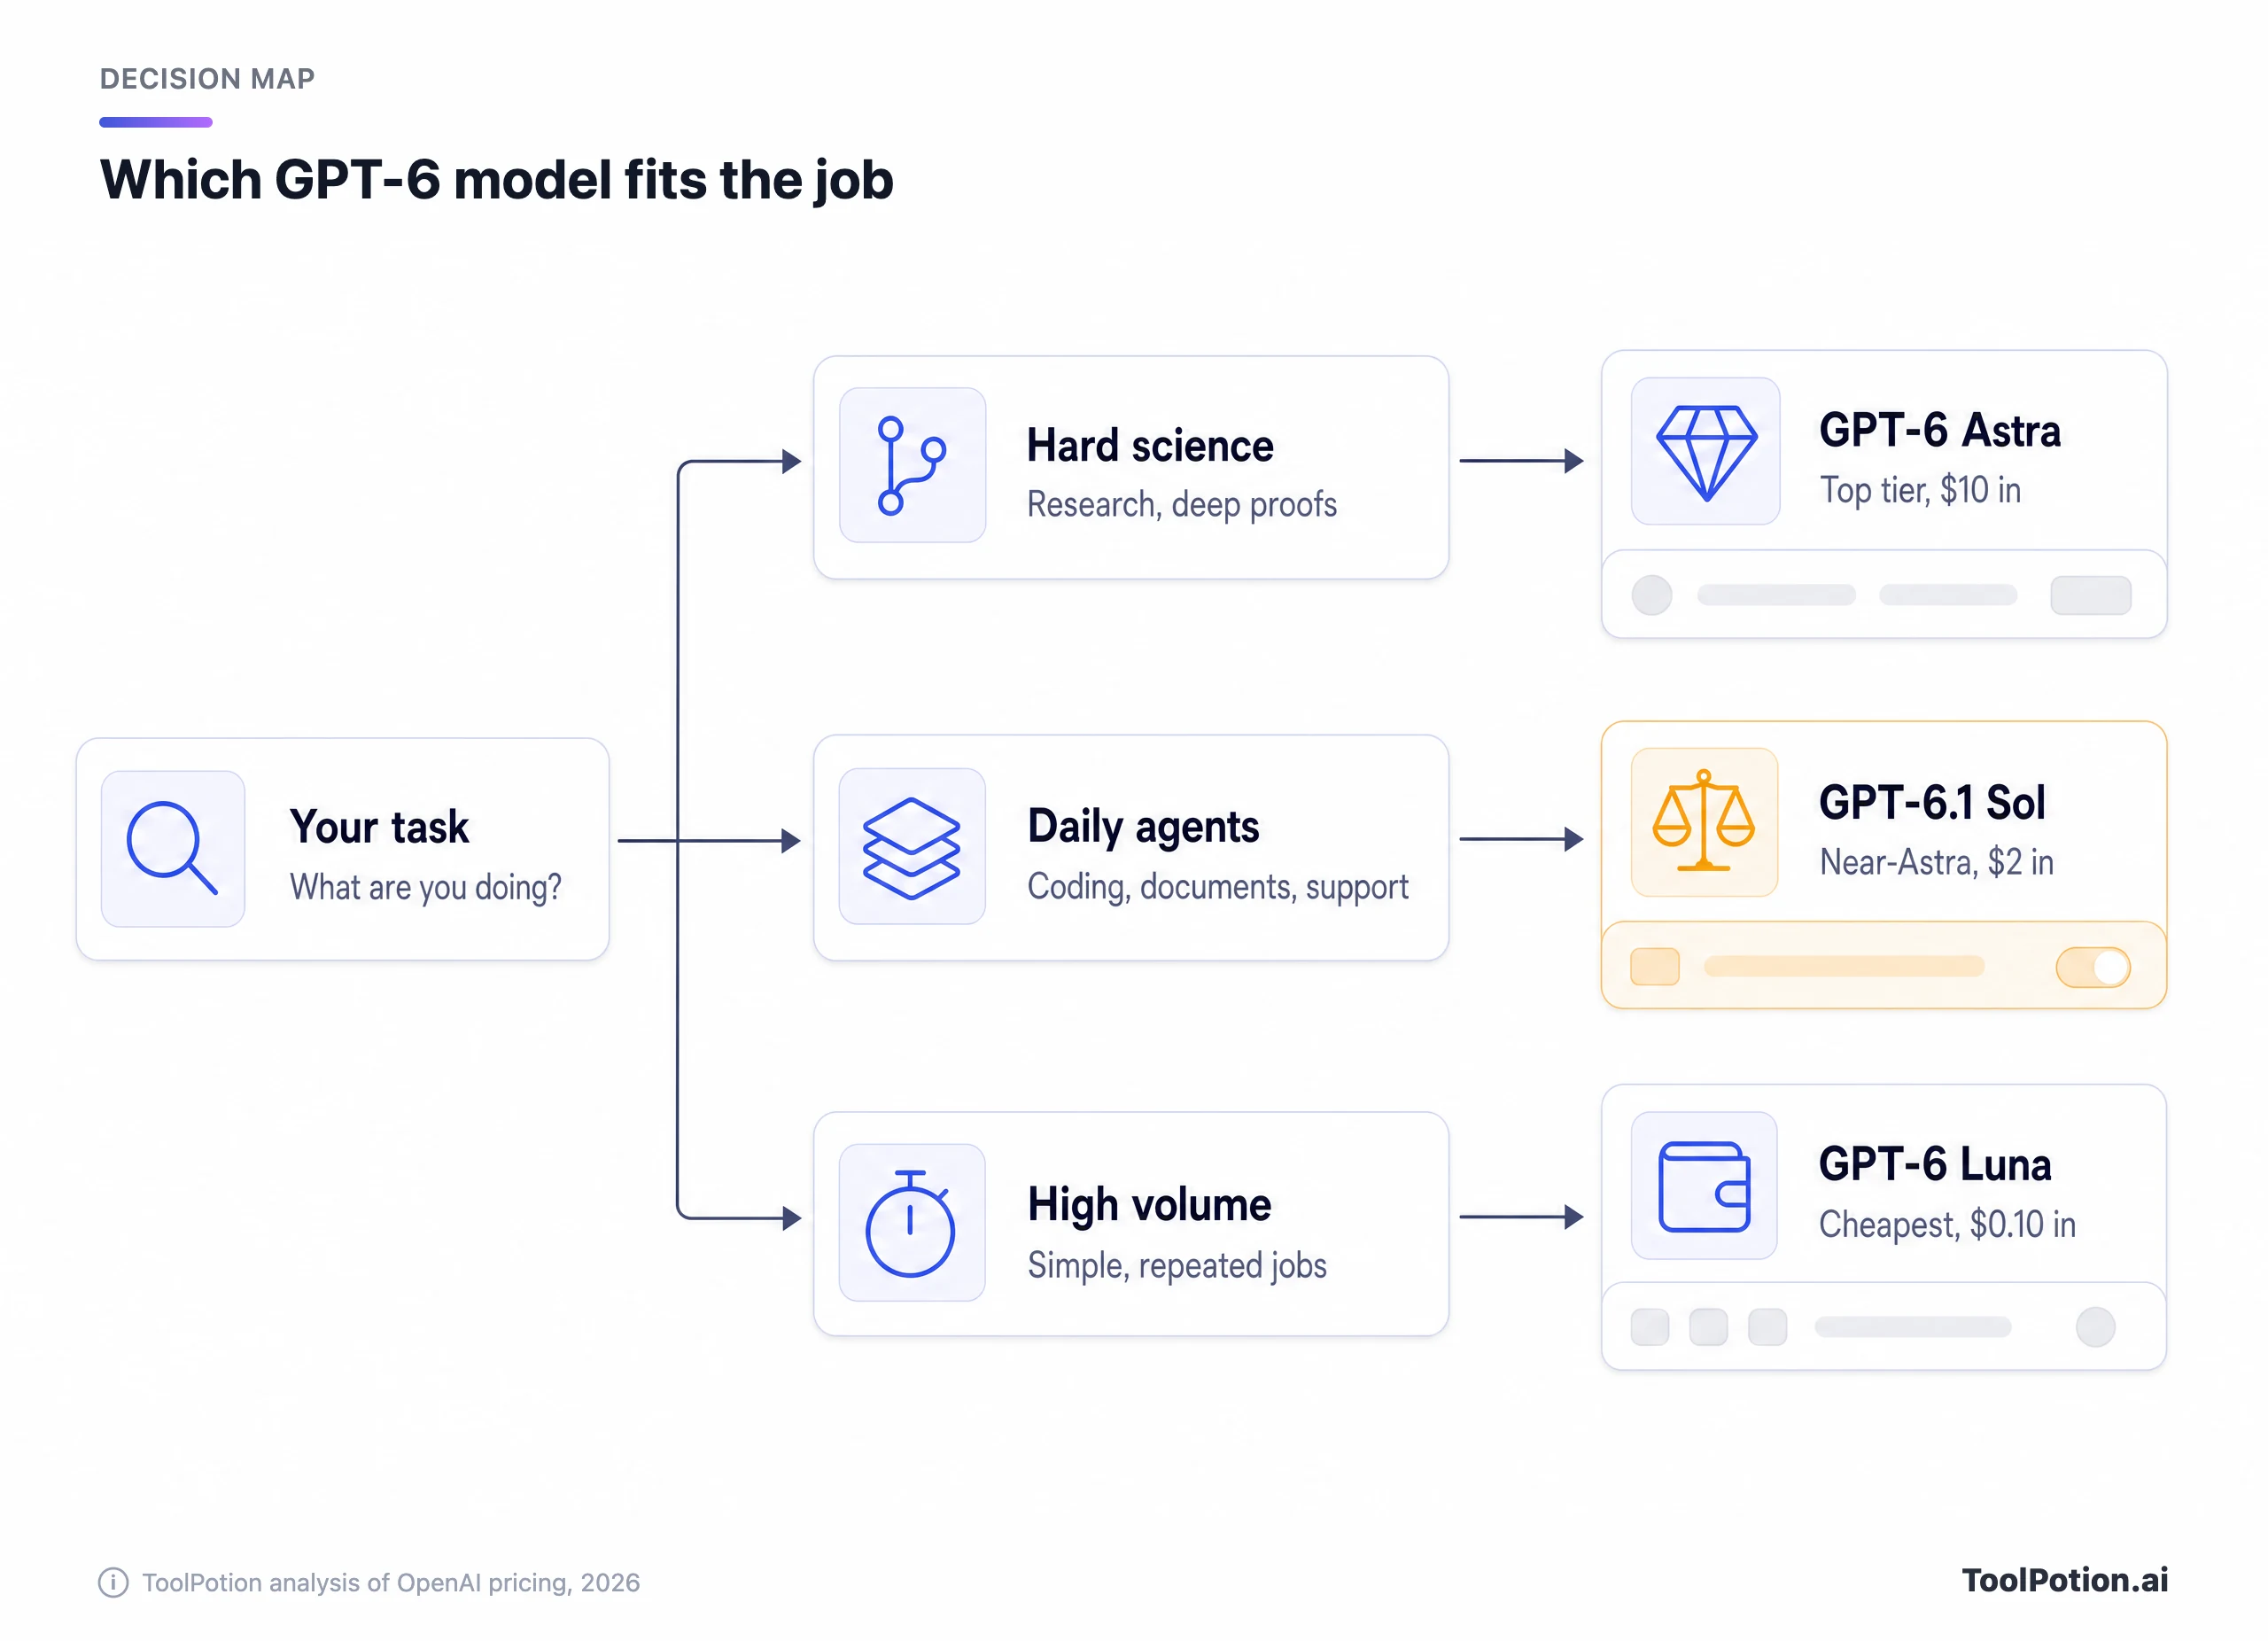
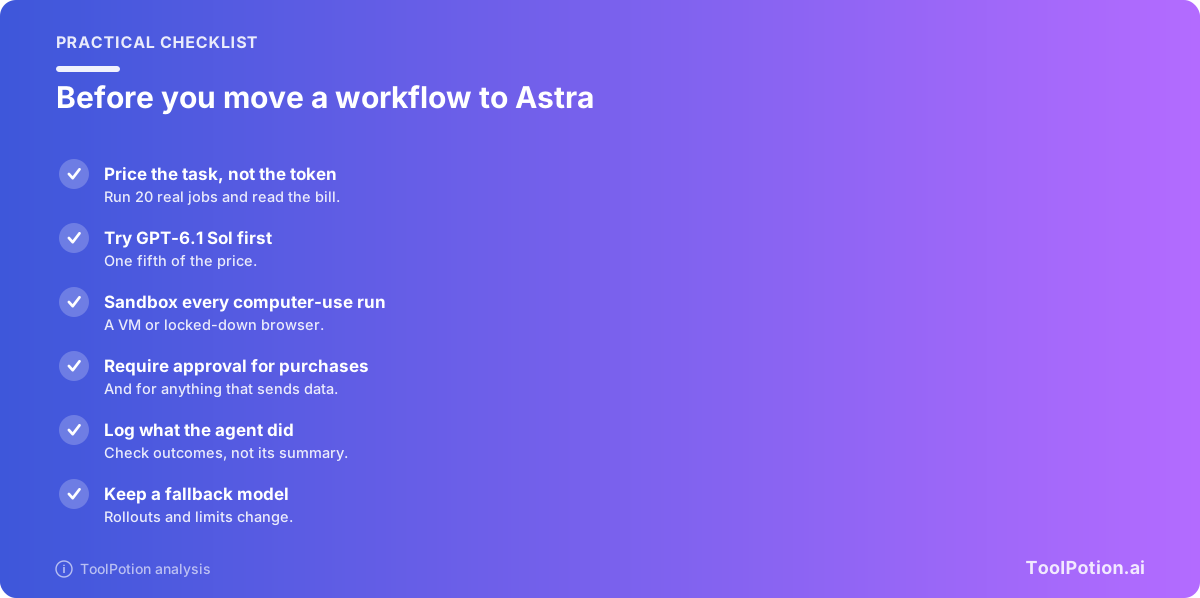
Aturan praktis yang adil dari bukti tersebut: jadikan Sol default untuk pekerjaan agen harian, turun ke Luna untuk tugas berulang yang sederhana seperti tagging, routing, dan ekstraksi, dan pindah ke Astra hanya jika uji head-to-head pada contoh Anda sendiri menunjukkan selisih yang layak Anda bayar. Jalankan pengecekan cepat di bawah.
Jika Anda membangun produk, eksperimen termurah adalah menjalankan dua puluh tugas nyata lewat Sol dan Astra, lalu membandingkan tingkat keberhasilan dan tagihan sebenarnya. Dua puluh tugas hanya menelan beberapa dolar dan menjawab pertanyaan ini lebih baik daripada grafik mana pun.
Bagi pengguna ChatGPT di Plus ke atas, pertanyaan praktisnya lebih kecil. Anda sudah punya keluarga GPT-6 di dalam paket Anda. Gunakan model default untuk obrolan biasa dan coba Astra pada satu tugas yang terus salah dikerjakan oleh default. Jika Anda bekerja di ekosistem lain, Claude dan Google Gemini bersaing di tier yang sama, dan papan Top 25 LLM kami melacaknya.
Siapa yang bisa mengabaikannya untuk sekarang
Pengguna Free dan Go bisa mengabaikan Astra sepenuhnya, karena model ini tidak ada di paket tersebut. Orang yang memakai ChatGPT untuk email, ringkasan, brainstorming, dan bantuan PR tidak akan melihat perbedaan yang layak dikejar. Keunggulannya muncul pada pekerjaan panjang yang banyak memakai tool.
Tim yang sudah terlanjur dalam di stack lain nyaris tak punya alasan untuk pindah. Claude Fable 5.1 dari Anthropic mengungguli Astra pada beberapa versi indeks Artificial Analysis, dan tim coding akan membandingkan Codex in ChatGPT dengan Claude Code pada repositori mereka sendiri, bukan pada grafik peluncuran. Perusahaan dengan data yang diatur regulasi sebaiknya membaca batasan keamanan di atas sebelum melepas agen ke sistem produksi.
Siapa yang sebaiknya mencobanya sekarang: developer yang menjalankan agen multi-langkah yang saat ini gagal di tengah jalan, analis yang hidup di spreadsheet dan dokumen, dan siapa pun yang pilot computer use-nya mati karena masalah keandalan. Bagi mereka, Astra atau Sol layak diuji ulang. Untuk pencarian opsi yang lebih luas, lihat papan Top 20 model AI dan LLM dan panduan kami tentang model AI dan LLM di 2026. Model OpenAI terdahulu seperti GPT-5.5 masih terdaftar jika Anda butuh titik pembanding, dan artikel alternatif ChatGPT kami membahas sisanya.
Ada juga contoh pelanggan yang layak dibaca. Direktori kami memiliki entri studi kasus Perplexity x GPT-6 Astra yang menunjukkan bagaimana sebuah perusahaan pencarian menjelaskan penggunaan model ini.
Pertanyaan yang sering diajukan
Apakah GPT-6 Astra gratis di ChatGPT?
Tidak. Tabel paket OpenAI mencantumkan Astra untuk Plus, Pro, Business, dan Enterprise, dan menandainya tidak termasuk di Free dan Go. Pengguna Free mendapatkan GPT-5.6 Luna untuk obrolan teks.
Apa perbedaan GPT-6 Astra dan GPT-6.1 Sol?
Astra adalah tier teratas dengan $10 input dan $50 output per juta token. Sol dihargai $2 dan $10 dan, menurut OpenAI, memberikan performa mendekati Astra. Keduanya memiliki context window 1,05 juta token. Sol adalah default yang lebih baik; Astra untuk pekerjaan tersulit.
Bisakah saya memakai Astra di API, dan berapa biayanya?
Ya. Harga list-nya $10 per juta token input dan $50 per juta output, dengan cached input $1. Batch memotongnya setengah dan Fast mode menggandakannya. Input di atas 272.000 token lebih mahal, yaitu $20 input dan $75 output.
Apakah Astra mengalahkan Claude?
Tergantung tesnya. Pada indeks Artificial Analysis v4.2, Claude Fable 5.1 mencetak skor lebih tinggi; pada v4.3 yang lebih baru keduanya seri di posisi pertama. Pada benchmark agen dan computer use yang dilaporkan OpenAI, Astra unggul atas Claude Opus 5. Grafik vendor dan indeks independen tidak selalu sejalan, jadi uji pada pekerjaan Anda sendiri.
Amankah membiarkan Astra mengendalikan komputer saya?
Hanya dengan pagar pengaman. Panduan OpenAI sendiri menyarankan menjalankannya di sandbox, mewajibkan persetujuan untuk pembelian dan pengiriman data, dan menganggap teks di layar sebagai tidak tepercaya. OpenAI juga melaporkan bahwa penalaran Astra lebih sulit dipantau dibanding GPT-5.6 Sol.
Mengapa skor ARC-AGI-3 terlihat sangat berbeda antar sumber?
Setup pengujiannya berbeda. Angka 99,9 persen dari OpenAI berasal dari setup Provider Adapter milik ARC Prize, yang membawa reasoning state antar permintaan. Setup standar ARC Prize menghasilkan 62,7 persen. Modelnya sama; kerangka di sekelilingnya yang tidak.