

“Kami belum mengklaim sepenuhnya memahami buktinya.” Kalimat itu datang dari komite yang ditunjuk OpenAI untuk menelaah klaim hasil Yang-Mills-nya, seperti dikutip Scientific American. Kelompok yang dipimpin fisikawan David Gross itu baru saja menegaskan bahwa bukti untuk salah satu bagian masalah tersebut lolos pemeriksaan di Lean, bahasa pemrograman yang dipakai untuk memeriksa pekerjaan matematika. Meski begitu, mereka tetap tidak bisa menjelaskan bagaimana bukti itu bekerja.
Kami membaca materi AI-untuk-sains terbaru: artikel tersebut, lima tulisan Anthropic, benchmark wet-lab dari OpenAI, liputan TechCrunch tentang startup bernama PSI, dan postingan seorang blogger yang agen AI-nya menandai situs Maya yang tidak tercatat di register resmi Meksiko. Judul-judul berita melaju jauh melampaui semua itu. Jadi kami mengambil enam klaim populer dan memeriksa tiap klaim terhadap apa yang sebenarnya dikatakan sumbernya.
Klaim 1: AI kini menemukan sains baru dengan sendirinya
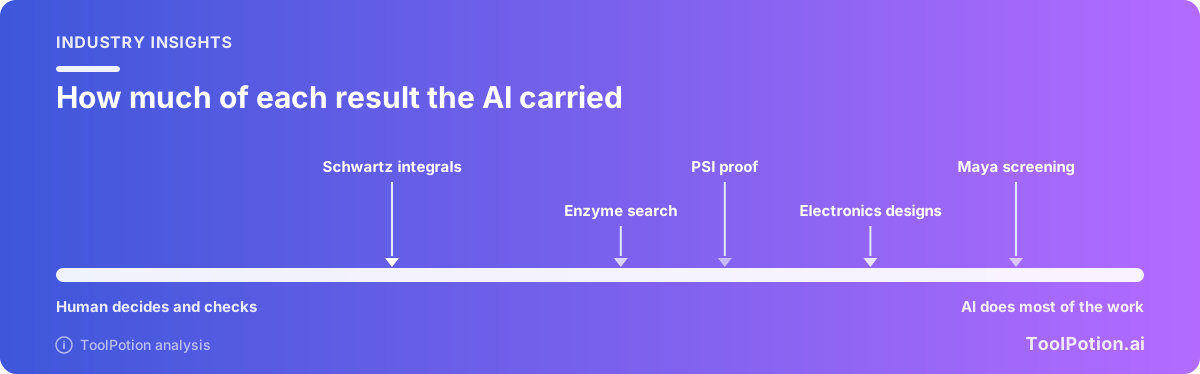
Vonis: tidak dengan sendirinya. Kasus-kasus terbaiknya nyata, dan di setiap kasus ada manusia yang memilih pertanyaan, menjalankan pemeriksaan, atau melakukan keduanya.
Mulai dari biologi. Anthropic mengatakan agen Claude menemukan sistem enzim dengan pengulangan mirip CRISPR, memakai sekitar 950 agen, 210 juta token, dan 21 jam (Anthropic). Satu agen menangkap pola pengulangannya. Ilmuwan Anthropic menyediakan prompt awal dan mengerjakan seluruh kerja lab, sebagian besar kandidat dari Claude tersingkir saat ditinjau, dan tulisan ilmiahnya masih berupa preprint. Penelitian tentang fungsi utama sistem itu masih berlangsung. Tulisan tersebut menyebut Claude “tampaknya yang pertama menyadari” ciri-ciri khas sistem itu, dan bahwa Claude “dapat mendeteksi anomali secara otonom”: wajar untuk tahap pencarian, tidak untuk tahap sisanya. Feng Zhang dari MIT dan Broad Institute, yang dikutip dalam tulisan yang sama setelah membaca preprint-nya, menyebutnya “contoh menarik tentang bagaimana agen AI dapat berkontribusi pada penemuan biologi” dan mengatakan temuan itu “layak diselidiki lebih lanjut.”
Fisikawan Matthew Schwartz, peneliti tamu di Anthropic, lebih terus terang daripada kebanyakan orang. Dalam tulisan tamu untuk Anthropic, ia melaporkan 30 integral dijalankan dari awal sampai akhir dengan Claude, 15 di antaranya mereproduksi hasil yang sudah diketahui dan 15 belum pernah dihitung sebelumnya (Anthropic). Ia menyebut target yang bagus sebagai masalah “berbentuk Claude”, dan menambahkan bahwa “butuh banyak penuntunan agar mereka menghasilkan sesuatu yang bernilai ilmiah.” Setelah ia melibatkan pakar luar, ia menemukan bahwa “hampir di semua kasus, Claude benar secara teknis, tetapi hasilnya tidak terlalu menarik sampai si pakar membantu mengarahkan kami.” Menurutnya, Claude “tampak menyukai perdebatan lama, yang banyak dikutip tetapi sudah lama terlupakan.” Penilaian tentang apa yang layak dipecahkan tetap berada di tangan manusia.
Lalu PSI. TechCrunch melaporkan bahwa David Turturean, staf teknis di lab startup Physical Superintelligence (PSI), memakai akses awal ke model Fable 5.2 milik Anthropic untuk memecahkan masalah berusia 18 tahun dari komputasi kuantum, konjektur Aaronson-Ambainis (TechCrunch). Scott Aaronson, yang mengajukan masalah itu, menulis bahwa ia belum benar-benar memahami buktinya tetapi yakin itu benar karena sudah diformalkan otomatis di Lean dan dijelaskan oleh tim peneliti papan atas yang diberi akses oleh PSI. Deskripsi Turturean sendiri sederhana: “Ini hasil negatif yang membuat orang tahu, oke, kita tidak perlu mencari ke sana lagi.” Solusi itu tampaknya menutup satu jalan menuju percepatan kuantum, bukan semuanya.
Kami menyebutnya kolaborator cepat dan tak kenal lelah yang membutuhkan orang lain untuk memilih masalahnya. Itu sudah banyak. Tapi itu bukan otonomi, dan tulisan perusahaan-perusahaan itu sendiri mengakuinya jika Anda membaca sampai bagian catatannya.
Klaim 2: Hasilnya sudah diverifikasi
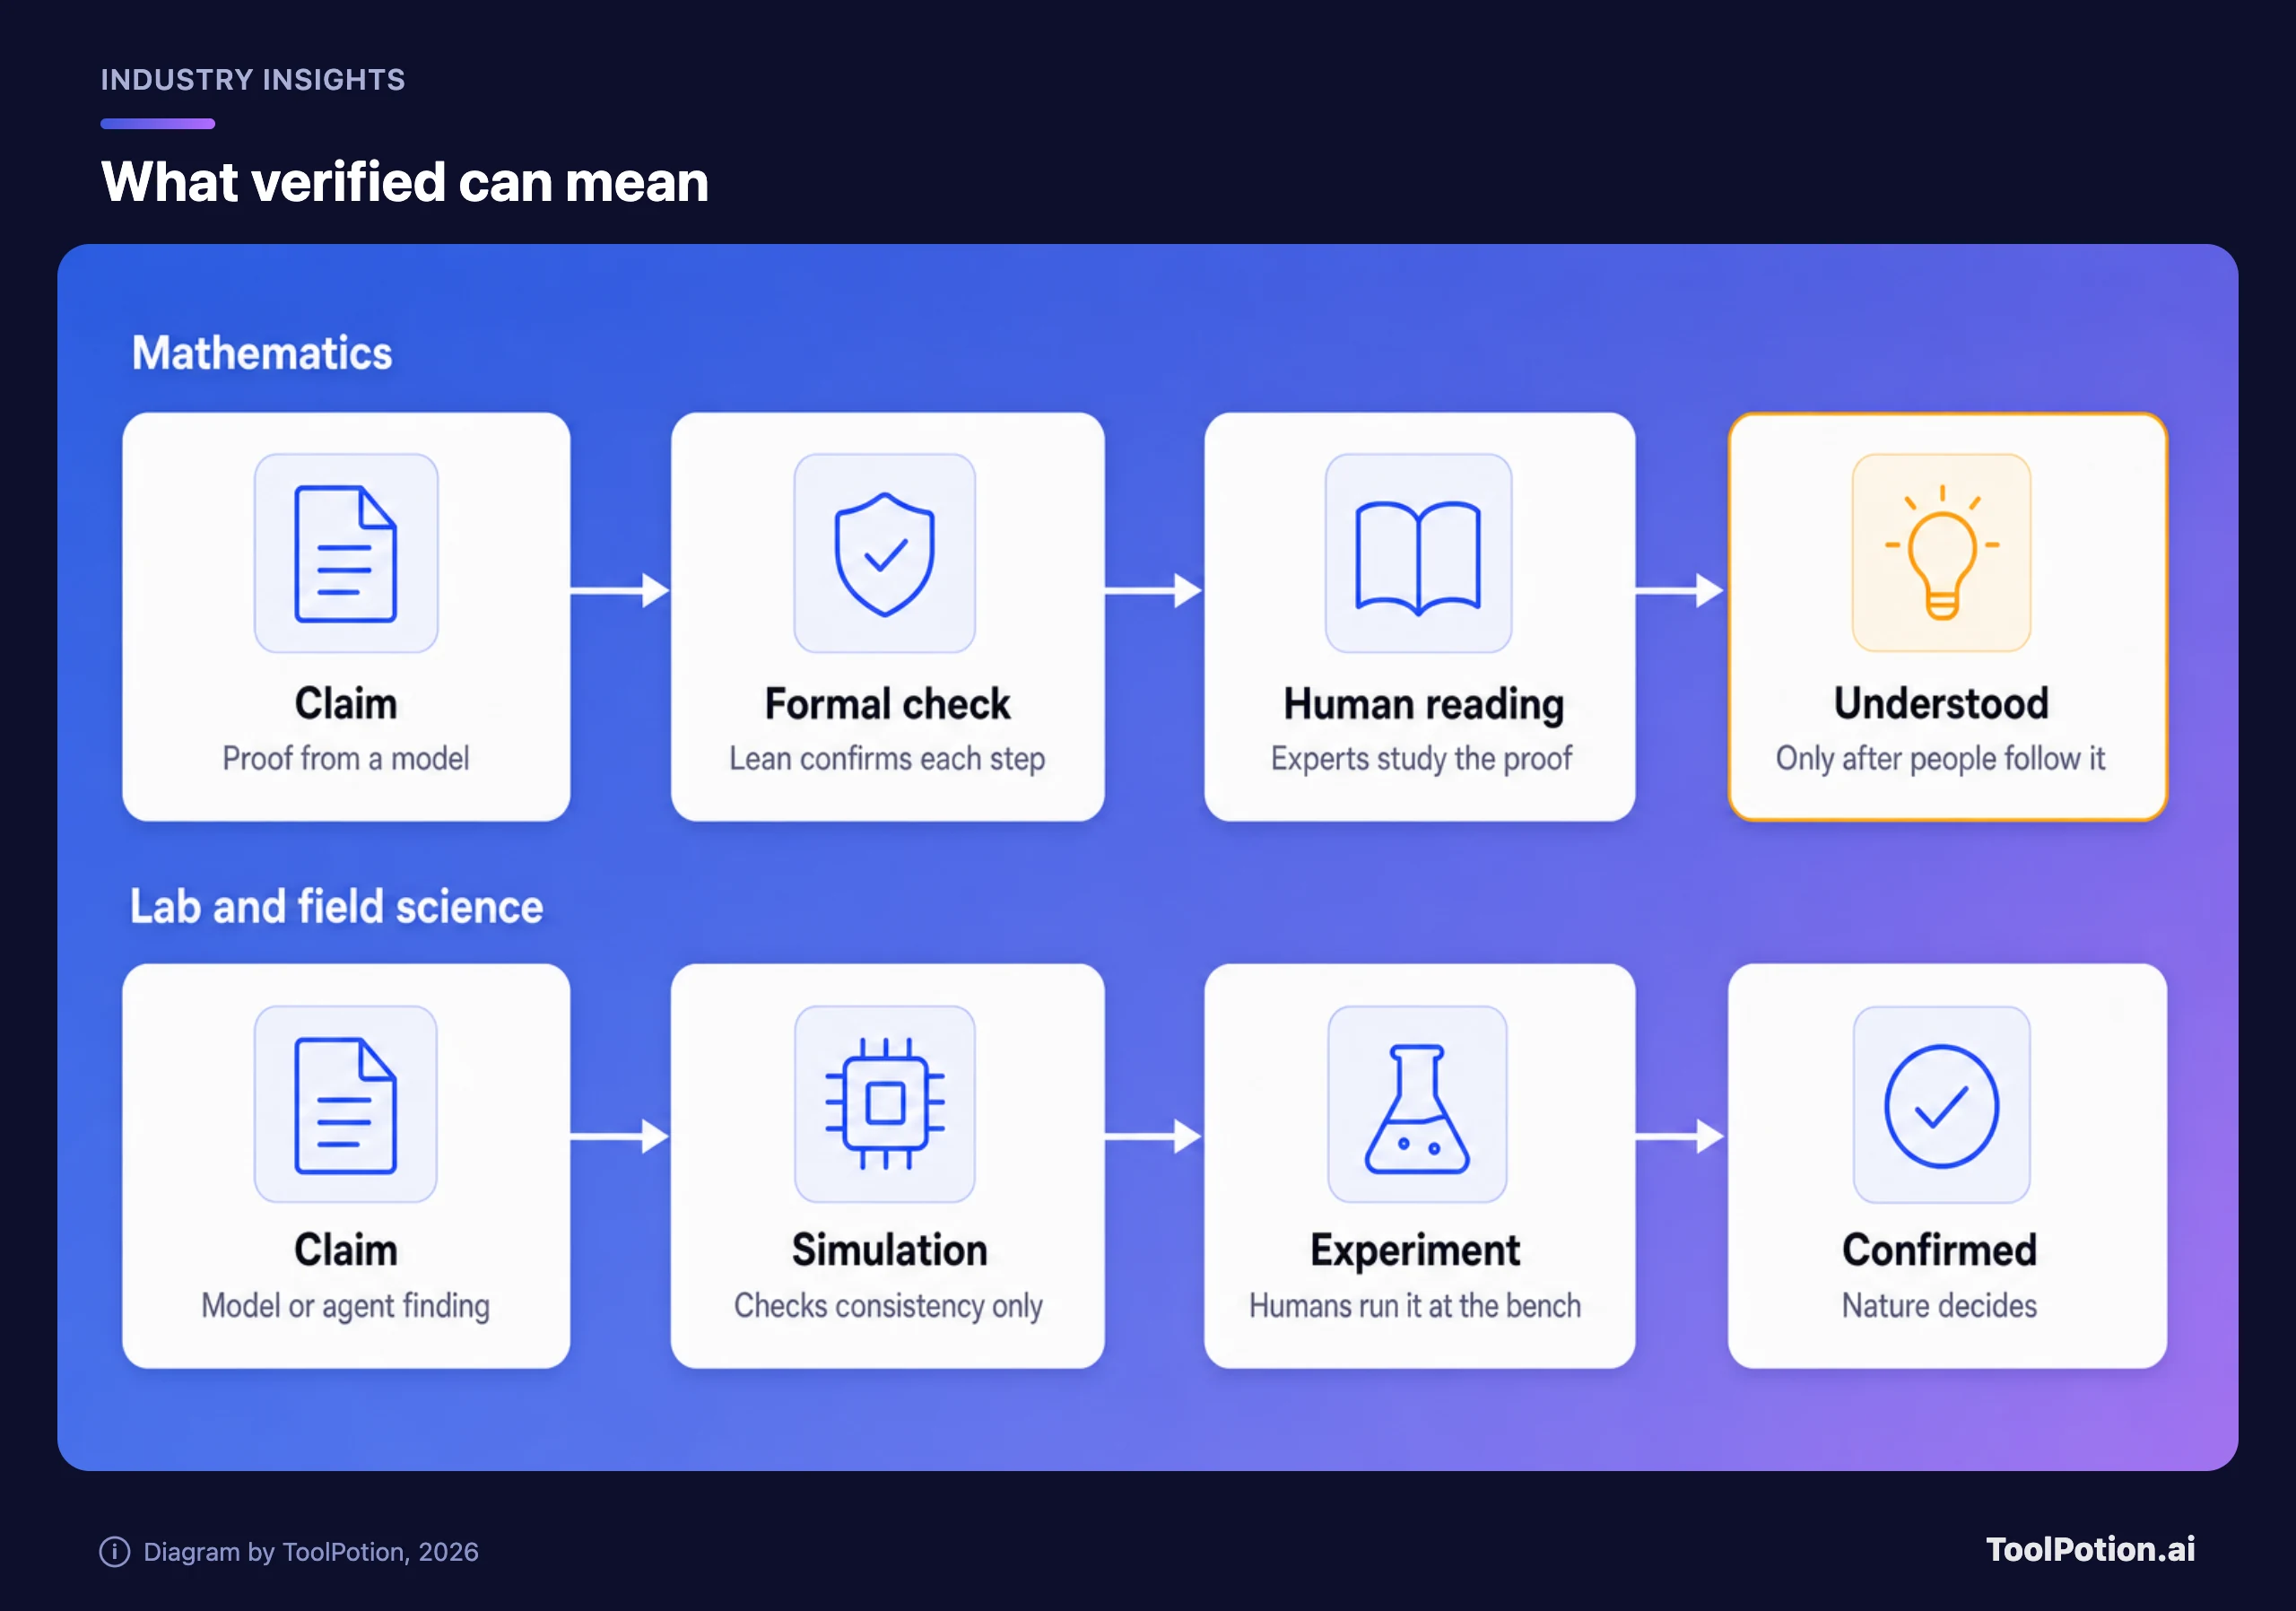
Vonis: sebagian. Pemeriksa formal adalah uji yang kuat dalam matematika. Di bidang lain, “terverifikasi” bisa berarti apa saja, dari simulasi sampai pencarian di register.
Dalam matematika, Lean bisa memastikan secara mekanis bahwa sebuah bukti memang mengikuti dari pernyataan yang diberikan. Itu pemeriksaan yang kuat, dan itulah alasan hasil PSI dan OpenAI ditanggapi serius. Namun liputan Scientific American menunjukkan batasannya. Klaim OpenAI mencakup bagian eksistensi dari masalah Yang-Mills; bagian mass-gap yang terpisah belum terpecahkan. Komite memakai model Astra milik OpenAI sendiri untuk membantu mencerna kode Lean, dan secara terang-terangan menyatakan belum mengklaim memahami buktinya.
Lalu soal keterbukaan. Scientific American mencatat bahwa pendekatan pendampingan ini bertentangan dengan rekomendasi transparansi dari kelompok penasihat yang berafiliasi dengan OpenAI dan membuat sebagian matematikawan kesal karena dianggap menutup akses. Bukti Lean-nya kini sudah publik. Scott Armstrong dari NYU mengaku senang bukti itu akhirnya dirilis dan menambahkan: “Tinjauan ini bisa dilakukan lebih efisien dan cepat secara terbuka” (Scientific American). Kami setuju dengannya. Bukti yang hanya dilihat komite bentukan OpenAI adalah klaim yang menunggu ditinjau, dan peninjauan itu akhirnya bisa dimulai.
Di luar matematika tidak ada Lean. CEO PSI Matt Pines mengatakan kepada TechCrunch bahwa fisika berbeda dari matematika karena “alam ikut punya suara dalam model realitas Anda,” dan bahwa fisika teoretis yang digerakkan mesin “belum sampai di sana, tapi sedang menuju ke sana.” Schwartz menemukan bahwa “pemeriksaan otomatis masih belum bisa dipercaya.” Dan postingan tentang Maya, yang akan kita bahas lagi, mendapat balasan resmi: lembaga Meksiko tidak menemukan situs terdaftar di lokasi yang dilaporkan. Itu mengonfirmasi ketiadaan di register. Itu tidak mengonfirmasi adanya situs.
Klaim 3: Agen bisa menjalankan lab
Vonis: belum. Mereka bisa merencanakan, mendesain, dan menganalisis. Manusia masih yang memipet dan menyolder.
Tulisan Anthropic tentang elektronik adalah contoh terkuat belakangan ini, dan layak dibaca utuh. Bekerja sama dengan pembuat papan sirkuit Diode (Anthropic mengaku punya hubungan komersial dengan perusahaan itu), Claude (model Fable 5.2) mendesain speakerphone USB-C, hub asisten suara, dan hewan peliharaan virtual genggam, dari skematik sampai layout dan firmware (Anthropic). Insinyur Diode memproduksi papan dari file desain Claude, lalu membuat dan menguji prototipenya secara manual, karena Claude tidak terhubung ke peralatan uji maupun mesin pembuat papan sirkuit. Perangkat-perangkat itu belum melalui validasi elektrik, penyetelan antena, uji termal, atau sertifikasi. Tulisan itu juga mengutip peningkatan benchmark (69% pada uji layout PCB Gym internal Diode, naik dari 25% untuk model sebelumnya), yang merupakan angka dari Anthropic pada uji yang dijalankan atas permintaannya, dan biayanya hanya muncul pada sumbu grafik, bukan di teks.
Di sisi biologi, OpenAI telah merilis BioBasicsBench, benchmark 100 tugas yang menurut mereka mengukur seberapa baik agen AI menafsirkan data eksperimen mentah dan menangani sains wet-lab sehari-hari (OpenAI). Ini uji buatan vendor, dan sebuah benchmark tetaplah klaim sampai orang di luar vendor menjalankannya.
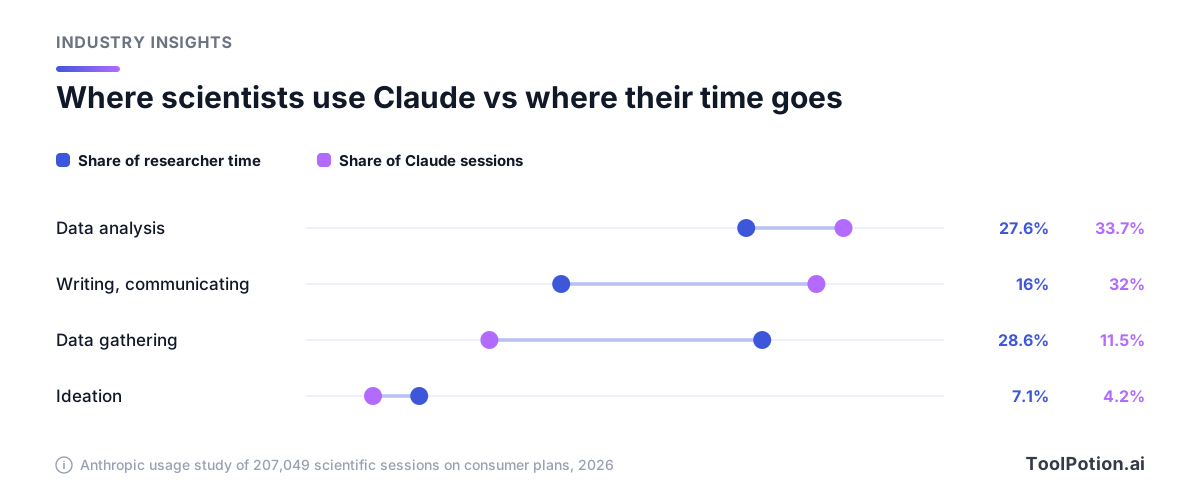
Studi penggunaan Anthropic atas 207.049 sesi ilmiah di paket konsumen menunjukkan pola yang sama di dunia nyata. Pengumpulan data memakan 28,6% waktu peneliti tetapi hanya 11,5% sesi di Claude, dan kesenjangannya paling lebar di bidang dengan hambatan fisik seperti pengumpulan data klinis atau biokimia (Anthropic). Kata-kata studi itu sendiri: “hambatan fisik tetap kuat.”
Klaim 4: Sekarang siapa pun bisa melakukannya
Vonis: siapa pun bisa memulai. Menghasilkan sesuatu yang bertahan butuh orang yang menguasai bidangnya.
Kisah Maya adalah ujian paling jernih. Pietro Miotti, yang mengaku bukan arkeolog, mengarahkan 48 agen ke sekitar 1.200 kilometer persegi data lidar publik NASA dan mendapat situs di puncak bukit dengan plaza dan piramida, lalu balasan resmi, dalam waktu kurang dari 72 jam (postingannya). Kalimat metodenya sangat lugas: “Tidak ada model atau pengklasifikasi khusus yang terlibat: agen-agen itu benar-benar melihat gambarnya.”
Lalu koreksinya, yang kini ada di bagian atas halaman. “Agen-agen itu melewatkannya saat menelusuri literatur, jadi mereka menemukannya kembali, bukan menemukannya.” Situs itu sudah dipetakan dalam makalah 2025 oleh Estrada-Belli dan rekan-rekannya; hanya saja belum masuk register Meksiko. Pujian untuk Miotti karena menaruhnya di paling atas. Ia juga mengaku tidak berbahasa Spanyol dan memercayai terjemahan laporannya oleh agen, kisah periode Klasiknya adalah “spekulasi, dari obrolan panjang dengan para agen,” dan gambar rekonstruksinya dibuat oleh AI. Tidak ada survei lapangan yang dijelaskan.
Menurut kami: ini demonstrasi yang bagus untuk penyaringan murah dan demonstrasi yang buruk untuk penemuan. Melihat kini nyaris gratis. Mengetahui apakah ada yang pernah melihatnya sebelumnya masih butuh spesialis, atau setidaknya penelusuran literatur yang tidak dilakukan agen-agen itu dengan benar. Jalur PSI berbeda dan instruktif: mereka menahan hasilnya sampai model Anthropic hampir siap dirilis, dan memakai waktu itu untuk menunjukkannya kepada peneliti yang bisa menjelaskannya. Jim Halverson, profesor Northeastern yang menasihati PSI, mengatakan kepada TechCrunch bahwa “Praktik terbaik masih terus berkembang.”
Klaim 5: Ilmuwan sebentar lagi akan diotomatisasi
Vonis: belum terbukti, dan klaim paling lantang datang dari pihak yang berkepentingan.
Turturean mengatakan kepada TechCrunch, “Saya sepenuhnya menerima gagasan bahwa ini mungkin makalah terakhir yang pernah saya terbitkan.” Pines mengatakan bahwa enam sampai sembilan bulan lalu, saat berbicara dengan investor, ia “harus agak melebih-lebihkan” untuk menyatakan fisika teoretis akan segera didominasi mesin, dan bahwa itu “belum sampai di sana.” Survei Anthropic menyebut sekitar 40% dari 528 peneliti memperkirakan AI akan menjalankan proyek riset penuh secara mandiri pada 2030, tetapi mereka direkrut dari pendaftar program hibah AI for Science milik Anthropic sendiri, jadi kemungkinan mereka pengguna AI yang lebih berat daripada kebanyakan orang (Anthropic).
Angka dari pemodelan lebih kecil. Pemodelan Anthropic menyebut kemampuan saat ini, bila diadopsi luas, bisa mengambil alih 27 sampai 52% waktu peneliti yang dibutuhkan untuk sebuah studi baru, yang berarti output naik 1,35x di bidang seni hingga 2,02x di statistika. Skenario hipotetis dalam laporan itu, di mana AI mengotomatisasi semua pekerjaan non-fisik, mencapai sekitar 15x di statistika dan ilmu komputer, tetapi hanya 3 sampai 4x di ilmu bench seperti biologi dan kimia, di mana langkah fisik tetap menjadi hambatan. Itu skenario, bukan pengukuran. Bahkan kasus yang moderat pun merupakan perubahan besar bagi sebuah bidang. Itu bukan penggantian, dan laporan itu mencatat bahwa pekerjaan AI saat ini kebanyakan bersifat membantu atau dibagi bersama. Soal siapa yang mendapat kredit, Schwartz mengatakannya lebih baik daripada kami: itu “tidak akan terselesaikan dengan berpura-pura kontribusi manusia hanyalah mengetik.”
Klaim 6: Jika model AI cocok dengan data, berarti kita memahami sistemnya
Vonis: salah, dan para penulis yang membangun sistem ini sendiri mengatakannya.
Sebuah tulisan tamu dari kelompok Tübingen (Jakob Macke, Daniel Gedon, dan Stefan Wahl, semuanya penerima hibah AI for Science Anthropic) tentang mengajari AI membangun model ilmiah menyampaikan argumennya dengan cermat. Banyak model cocok dengan data yang sama, jadi keluaran yang berguna adalah sebaran model yang masuk akal beserta daftar hal yang disepakati semuanya (Anthropic). Mereka mengakui bahwa sistem ini “sebagian besar baru diuji dalam menemukan kembali model yang sudah diketahui ilmuwan,” dengan bukti yang sedikit untuk masalah yang belum punya jawaban. Dan mereka menulis: “Sistem AI yang sekadar menyerahkan modelnya mungkin memberi Anda jawaban, tetapi tidak memberi Anda pemahaman.”
Menurut kami kalimat terakhir itu patut ditempel di atas setiap meja lab dan setiap meja belajar mahasiswa. Kecocokan hanyalah angka. Penjelasan adalah sesuatu yang bisa dipakai orang untuk memprediksi apa yang terjadi berikutnya.
Rutinitas untuk peneliti dan mahasiswa
Tidak satu pun poin di atas mengatakan jangan pakai alat-alat ini. Data penggunaan Anthropic menunjukkan ilmuwan sudah memakainya di tempat yang paling cocok, terutama analisis dan penulisan. Berikut rutinitas yang akan kami ikuti, disusun dari kesalahan-kesalahan pada kasus di atas.
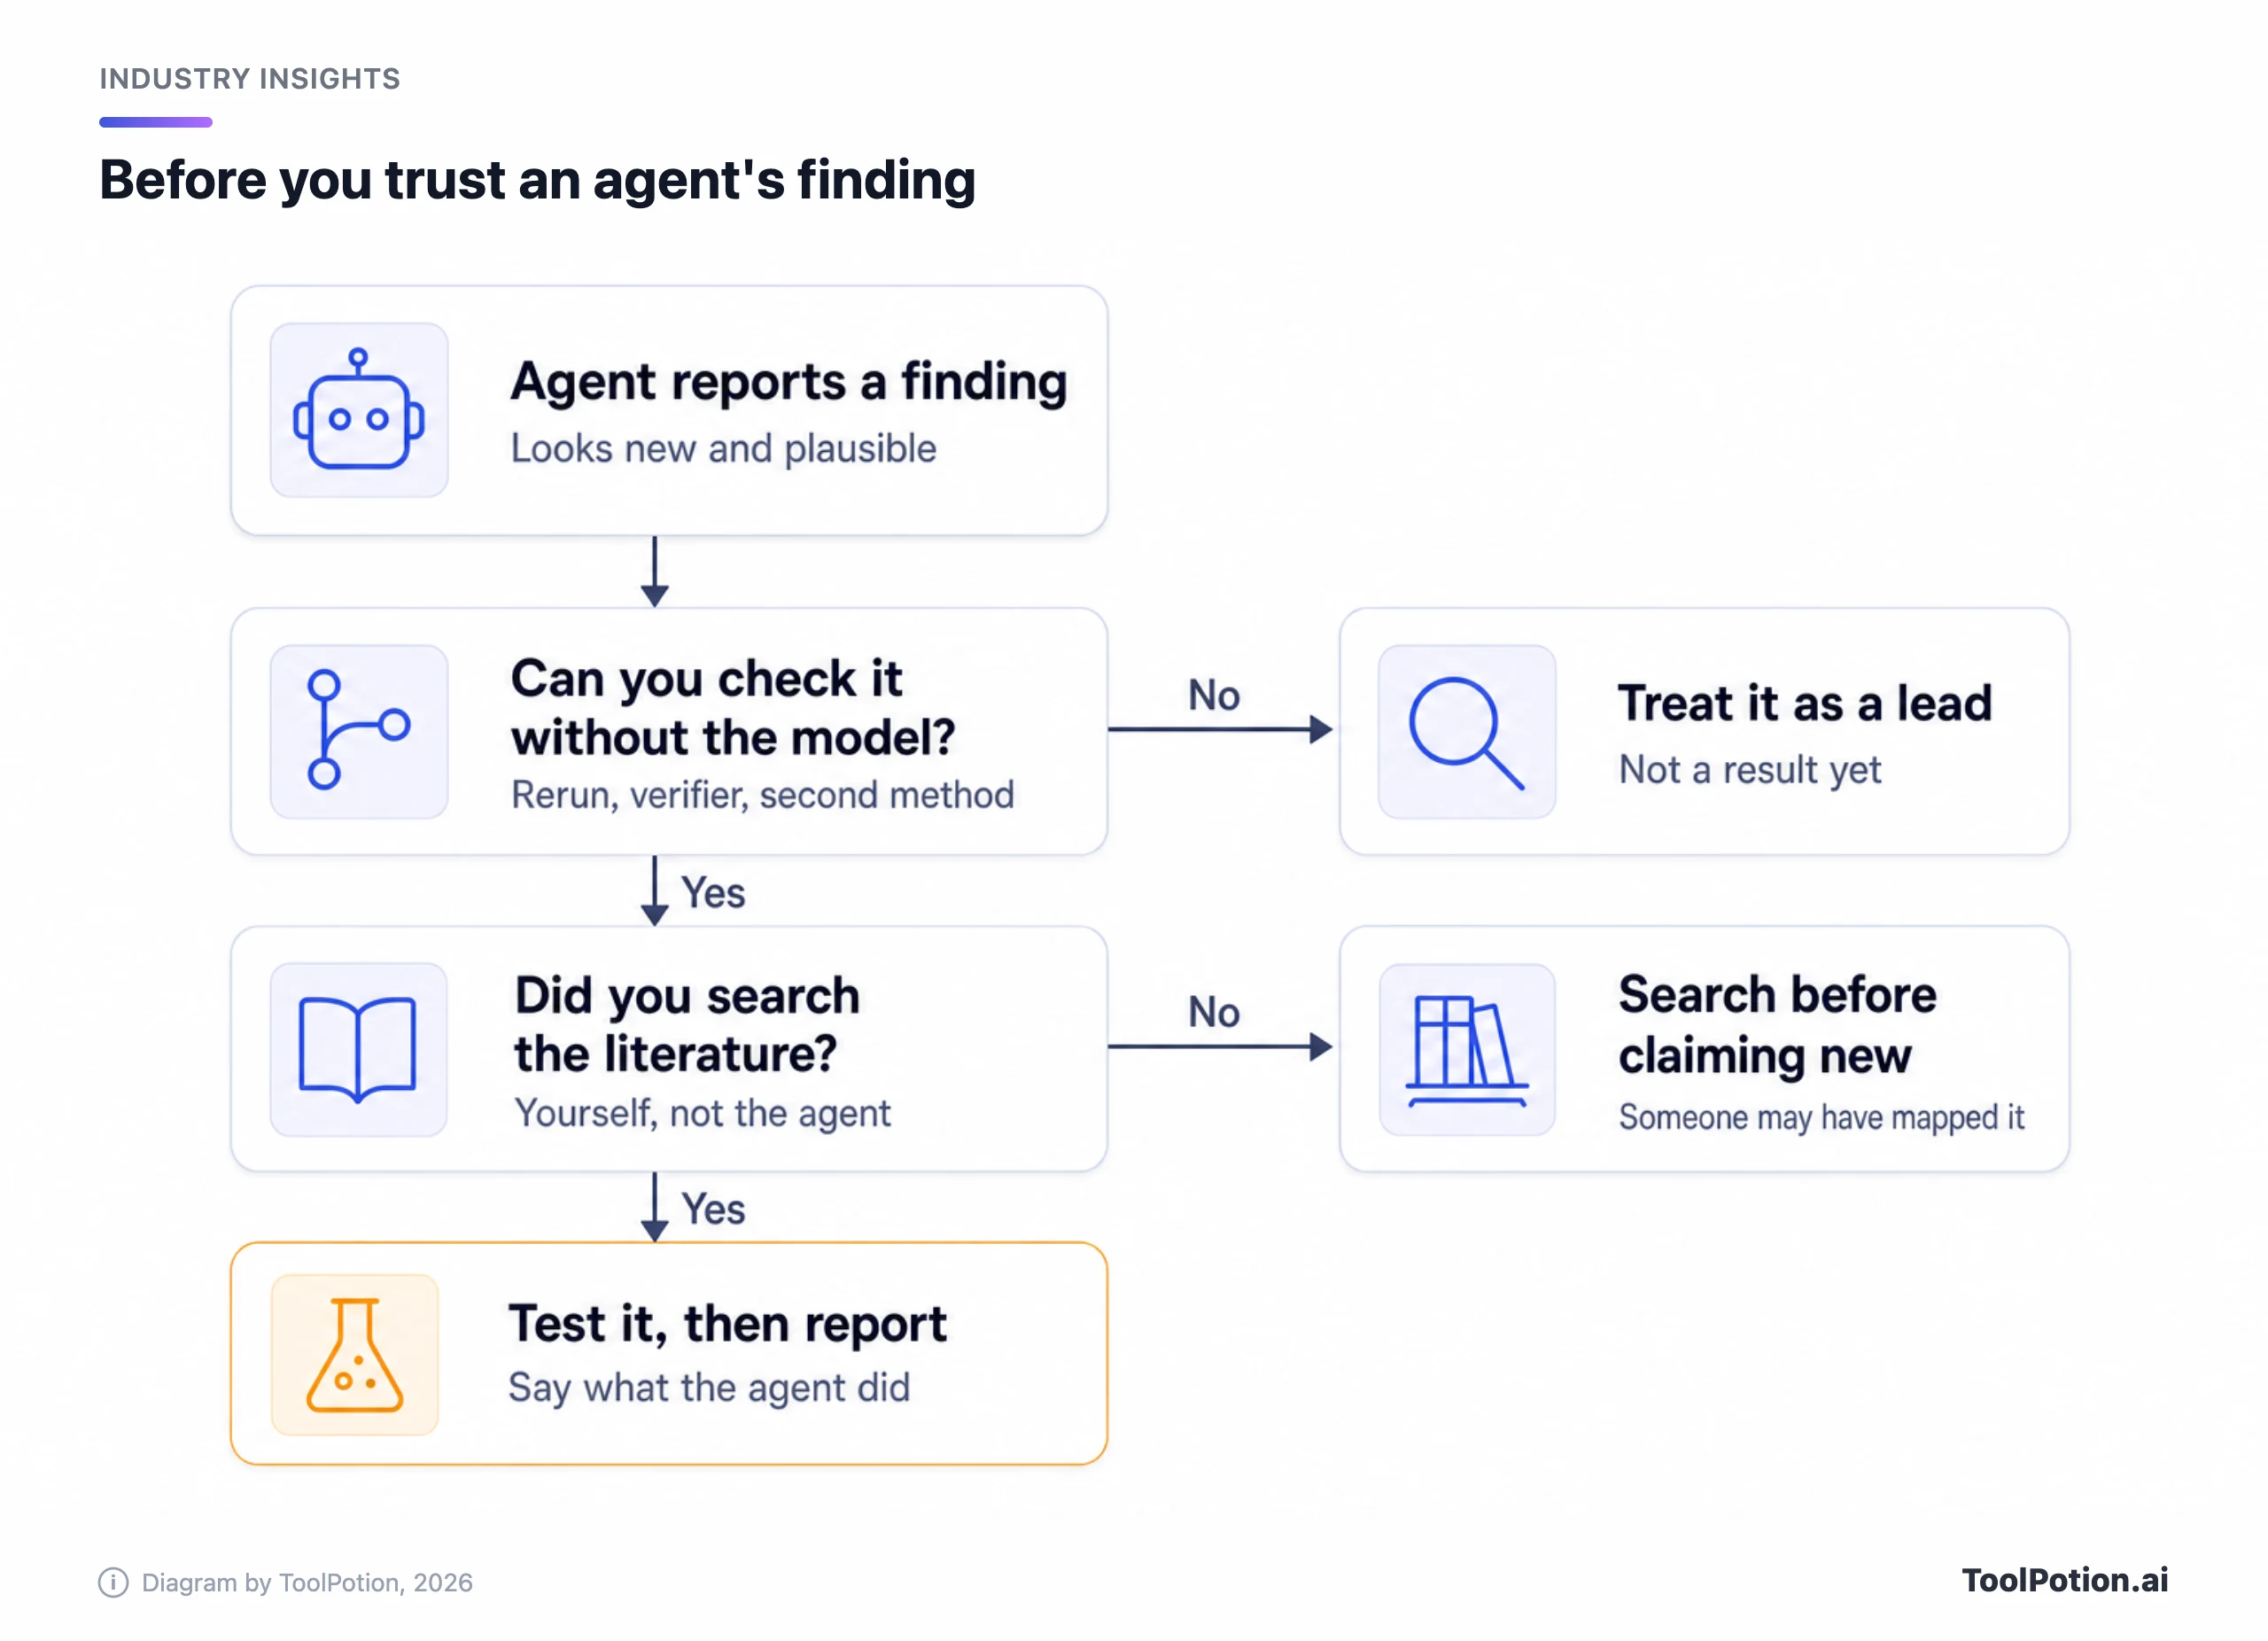
- Berikan agen pekerjaan yang hasilnya bisa Anda periksa sendiri: analisis data, memindahkan kode antarbahasa, menyaring makalah atau gambar. Claude Code dan Claude Cowork dibuat untuk pekerjaan seperti itu, dan perbandingan agen coding terminal kami membahas pilihan yang ada.
- Tentukan sebelum mulai apa yang dianggap sebagai pemeriksaan dan siapa yang melakukannya. Bukan model yang sama. Bisa pemverifikasi formal, analisis kedua, eksperimen bench, atau rekan kerja.
- Saat agen bilang sesuatu itu baru, telusuri literaturnya sendiri. Alat khusus seperti Elicit, Consensus, SciSpace atau ResearchRabbit hanya butuh beberapa menit, dan kasus Maya menunjukkan harga dari melewatkannya. Peringkat asisten riset AI kami punya daftar yang lebih panjang.
- Pertahankan langkah fisik di tangan manusia dan catat. Jika hasil bergantung pada pengukuran, sampel, atau kunjungan lapangan, di situlah hasil itu diuji.
- Sebutkan apa yang dilakukan agen saat Anda menulis laporannya, dan apa yang Anda periksa. Schwartz tegas bahwa kontribusi manusia bukan sekadar mengetik.
- Mahasiswa: bangun model pertama Anda sendiri. Penulis dari Tübingen menulis bahwa “proses membangunnya itulah yang memberikan wawasan.” Gunakan agen untuk mengkritik model Anda, bukan untuk menyerahkannya kepada Anda.
Jika Anda ingin contoh AI di biologi yang lebih lama dan lebih teruji, itu tetap AlphaFold, yang memprediksi struktur yang kemudian diuji oleh lab. Untuk pekerjaan literatur dan riset bergaya agen, ada juga Edison Scientific, Scientific Agent Skills untuk membekali agen Anda sendiri, dan papan Top 250 AI Tools for Researchers. Untuk asisten serbaguna, ChatGPT vs Claude vs Gemini membandingkan ChatGPT dengan dua pesaing utamanya, sementara papan asisten riset AI dan agen AI memeringkat alat-alat spesialis.
Kesimpulan kami, dan apa yang akan mengubah pendapat kami
Yang nyata: agen kini menjadi analis dan insinyur yang berguna dan tak kenal lelah. Prototipe elektroniknya berfungsi, petunjuk enzimnya menarik, dan bukti dari model yang diperiksa Lean adalah hasil nyata, siapa pun yang akhirnya memahaminya lebih dulu. 15 integral baru milik Schwartz adalah hasil nyata di bidang yang sempit.
Yang hype: otonomi, kata “terverifikasi” yang dipakai longgar, dan gelombang ilmuwan otomatis yang katanya akan datang. Hampir setiap hasil mengesankan di atas punya manusia dalam prosesnya yang mengerjakan bagian yang menentukan apakah hasilnya benar, dan para manusia itu sendiri mengatakannya. Kami juga ingin lab-lab mencantumkan biaya dalam dolar di samping skor benchmark. Kredit dan jumlah token menyembunyikan biaya sebuah penemuan, dan 210 juta token untuk satu pencarian enzim adalah angka yang diperhatikan anggaran lab.
Ada dua hal yang akan mengubah pendapat kami. Pertama, matematikawan di luar komite OpenAI membaca kode Lean Yang-Mills dan melaporkan bahwa mereka memahaminya. Kedua, versi peer-review dari penelitian enzim yang menjelaskan apa yang dilakukan sistem itu. Sampai saat itu, kami menganggap keduanya menjanjikan tetapi belum selesai.