

Para insinyur Anthropic pernah membiarkan lead agent memberikan instruksi singkat seperti "riset kelangkaan semikonduktor." Para subagent salah menafsirkannya: satu menelusuri krisis chip otomotif 2021, sementara dua lainnya mengerjakan hal yang sama pada rantai pasok 2025 (Anthropic Engineering). Tidak ada yang crash. Setiap agent melakukan sesuatu yang masuk akal terhadap permintaan yang cukup kabur untuk dibaca dengan beberapa cara.
Sebagian besar dari kita mengulangi kesalahan itu setiap kali menyerahkan pekerjaan ke ChatGPT, Claude, Gemini CLI, atau salah satu coding agent berbasis terminal. Kita mengetik sebuah tugas lalu menyebutnya brief. Di bawah ini: enam bagian yang dibutuhkan sebuah brief, tiga penulisan ulang yang bisa Anda pinjam, sebuah template, dan tabel berisi cara-cara brief gagal. Posisi kami, yang kami uraikan sambil jalan: tulis baris "selesai jika" lebih dulu, ganti "tanya saya kalau ragu" dengan daftar tindakan yang disebutkan satu per satu, dan hentikan tembok huruf kapital. Dokumentasi vendor yang kami kutip mendukung sebagian dari ini dan tidak membahas sisanya, dan kami sebutkan mana yang mana.
Tugas bukan brief
Tugas hanya menyebut sebuah aktivitas. Brief memberi orang yang mengerjakannya semua hal yang kalau tidak, harus ia tebak. Panduan prompting Anthropic menggambarkannya seperti karyawan baru: "Think of Claude as a brilliant but new employee who lacks context on your norms and workflows." (Anthropic docs) OpenAI menarik garis serupa antar jenis model. Model reasoning ibarat "like a senior co-worker" yang bisa menerima tujuan dan mengurus detailnya sendiri, sedangkan model GPT ibarat "like a junior coworker" yang paling baik bekerja "with explicit instructions to create a specific output" (OpenAI docs).
OpenAI mengatakan model reasoning bekerja baik dengan arahan tingkat tinggi, dan kami tidak akan sepenuhnya memercayainya begitu pekerjaan berjalan puluhan langkah dengan efek samping. Rekan senior pun tetap tidak tahu apa arti "selesai" bagi Anda, dan tebakan salah seorang junior paling hanya berbuah satu email. Agent bertindak berdasarkan salah tafsir pertamanya di setiap langkah berikutnya, seperti ditunjukkan lead agent Anthropic tadi.
Anthropic menawarkan sebuah tes yang kami sukai karena hanya butuh dua menit: "Show your prompt to a colleague with minimal context on the task and ask them to follow it. If they’d be confused, Claude will be too." (Anthropic docs) Kalau seorang kontraktor tidak bisa mulai bekerja dari pesan Anda tanpa mengirim lima pertanyaan, agent akan menjawab lima pertanyaan itu sendiri, diam-diam, dan Anda baru tahu dari hasilnya.
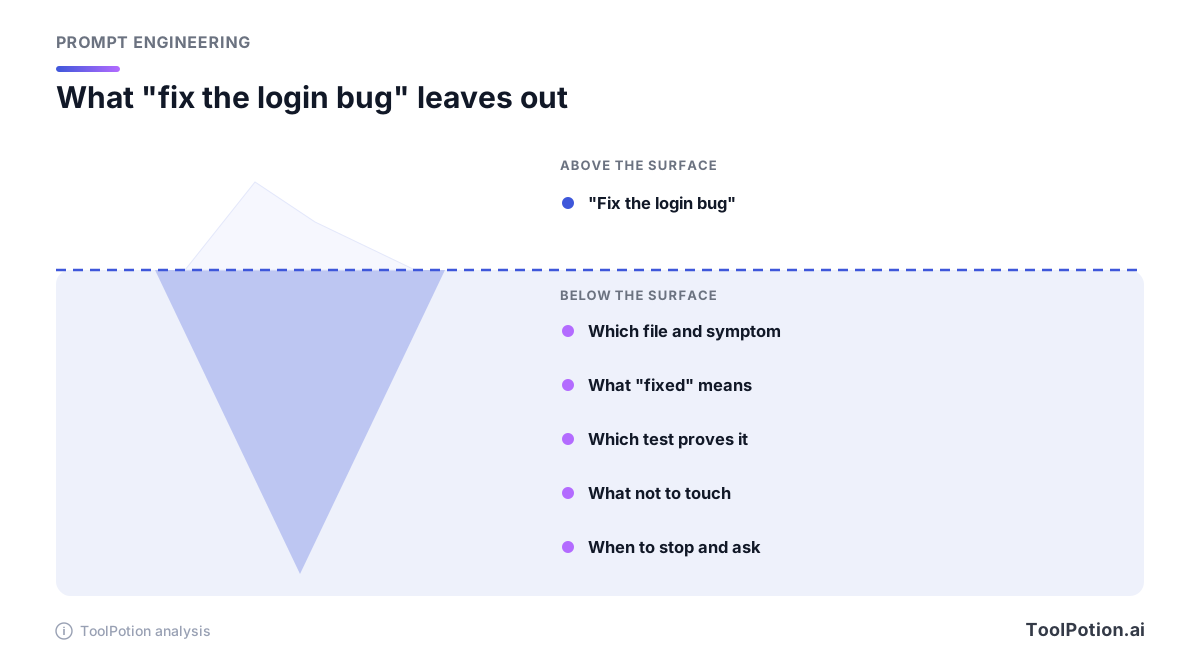
Tulis baris "selesai jika" sebelum yang lain
Halaman best practices Claude Code sendiri menyatakannya blak-blakan: "Claude stops when the work looks done." Tanpa sesuatu yang bisa dijalankan untuk menunjukkan apakah pekerjaan sudah selesai, lanjut halaman itu, "In practice that makes you the test suite, and every mistake sits there until you happen to notice it." (Claude Code docs)
Panduan Codex dari OpenAI sampai pada gagasan yang sama dari sisi lain. Panduan itu menyarankan empat hal dalam sebuah prompt: tujuan, konteks, batasan, dan "Done when," yang dirumuskannya sebagai pertanyaan tentang apa yang harus benar sebelum tugas dianggap selesai, "such as tests passing, behavior changing, or a bug no longer reproducing" (OpenAI Codex docs). Dua vendor, dua produk, satu kerangka. Kami menambahkan dua bagian sendiri (stop-and-ask dan laporan), dan kami akan menulis baris "selesai jika" lebih dulu meski posisinya keempat dalam brief jadi, karena menuliskannya memaksa Anda mencari tahu apa yang sebenarnya Anda inginkan.
Di luar coding, baris yang sama tetap berfungsi dengan pengecekan yang berbeda. "Tabel berisi dua belas vendor, tautan sumber di samping setiap harga, dan tanda pada harga yang tidak dipublikasikan" adalah sesuatu yang bisa dihitung agent. "Perbandingan yang menyeluruh" hanyalah sesuatu yang cuma bisa ia rasakan.
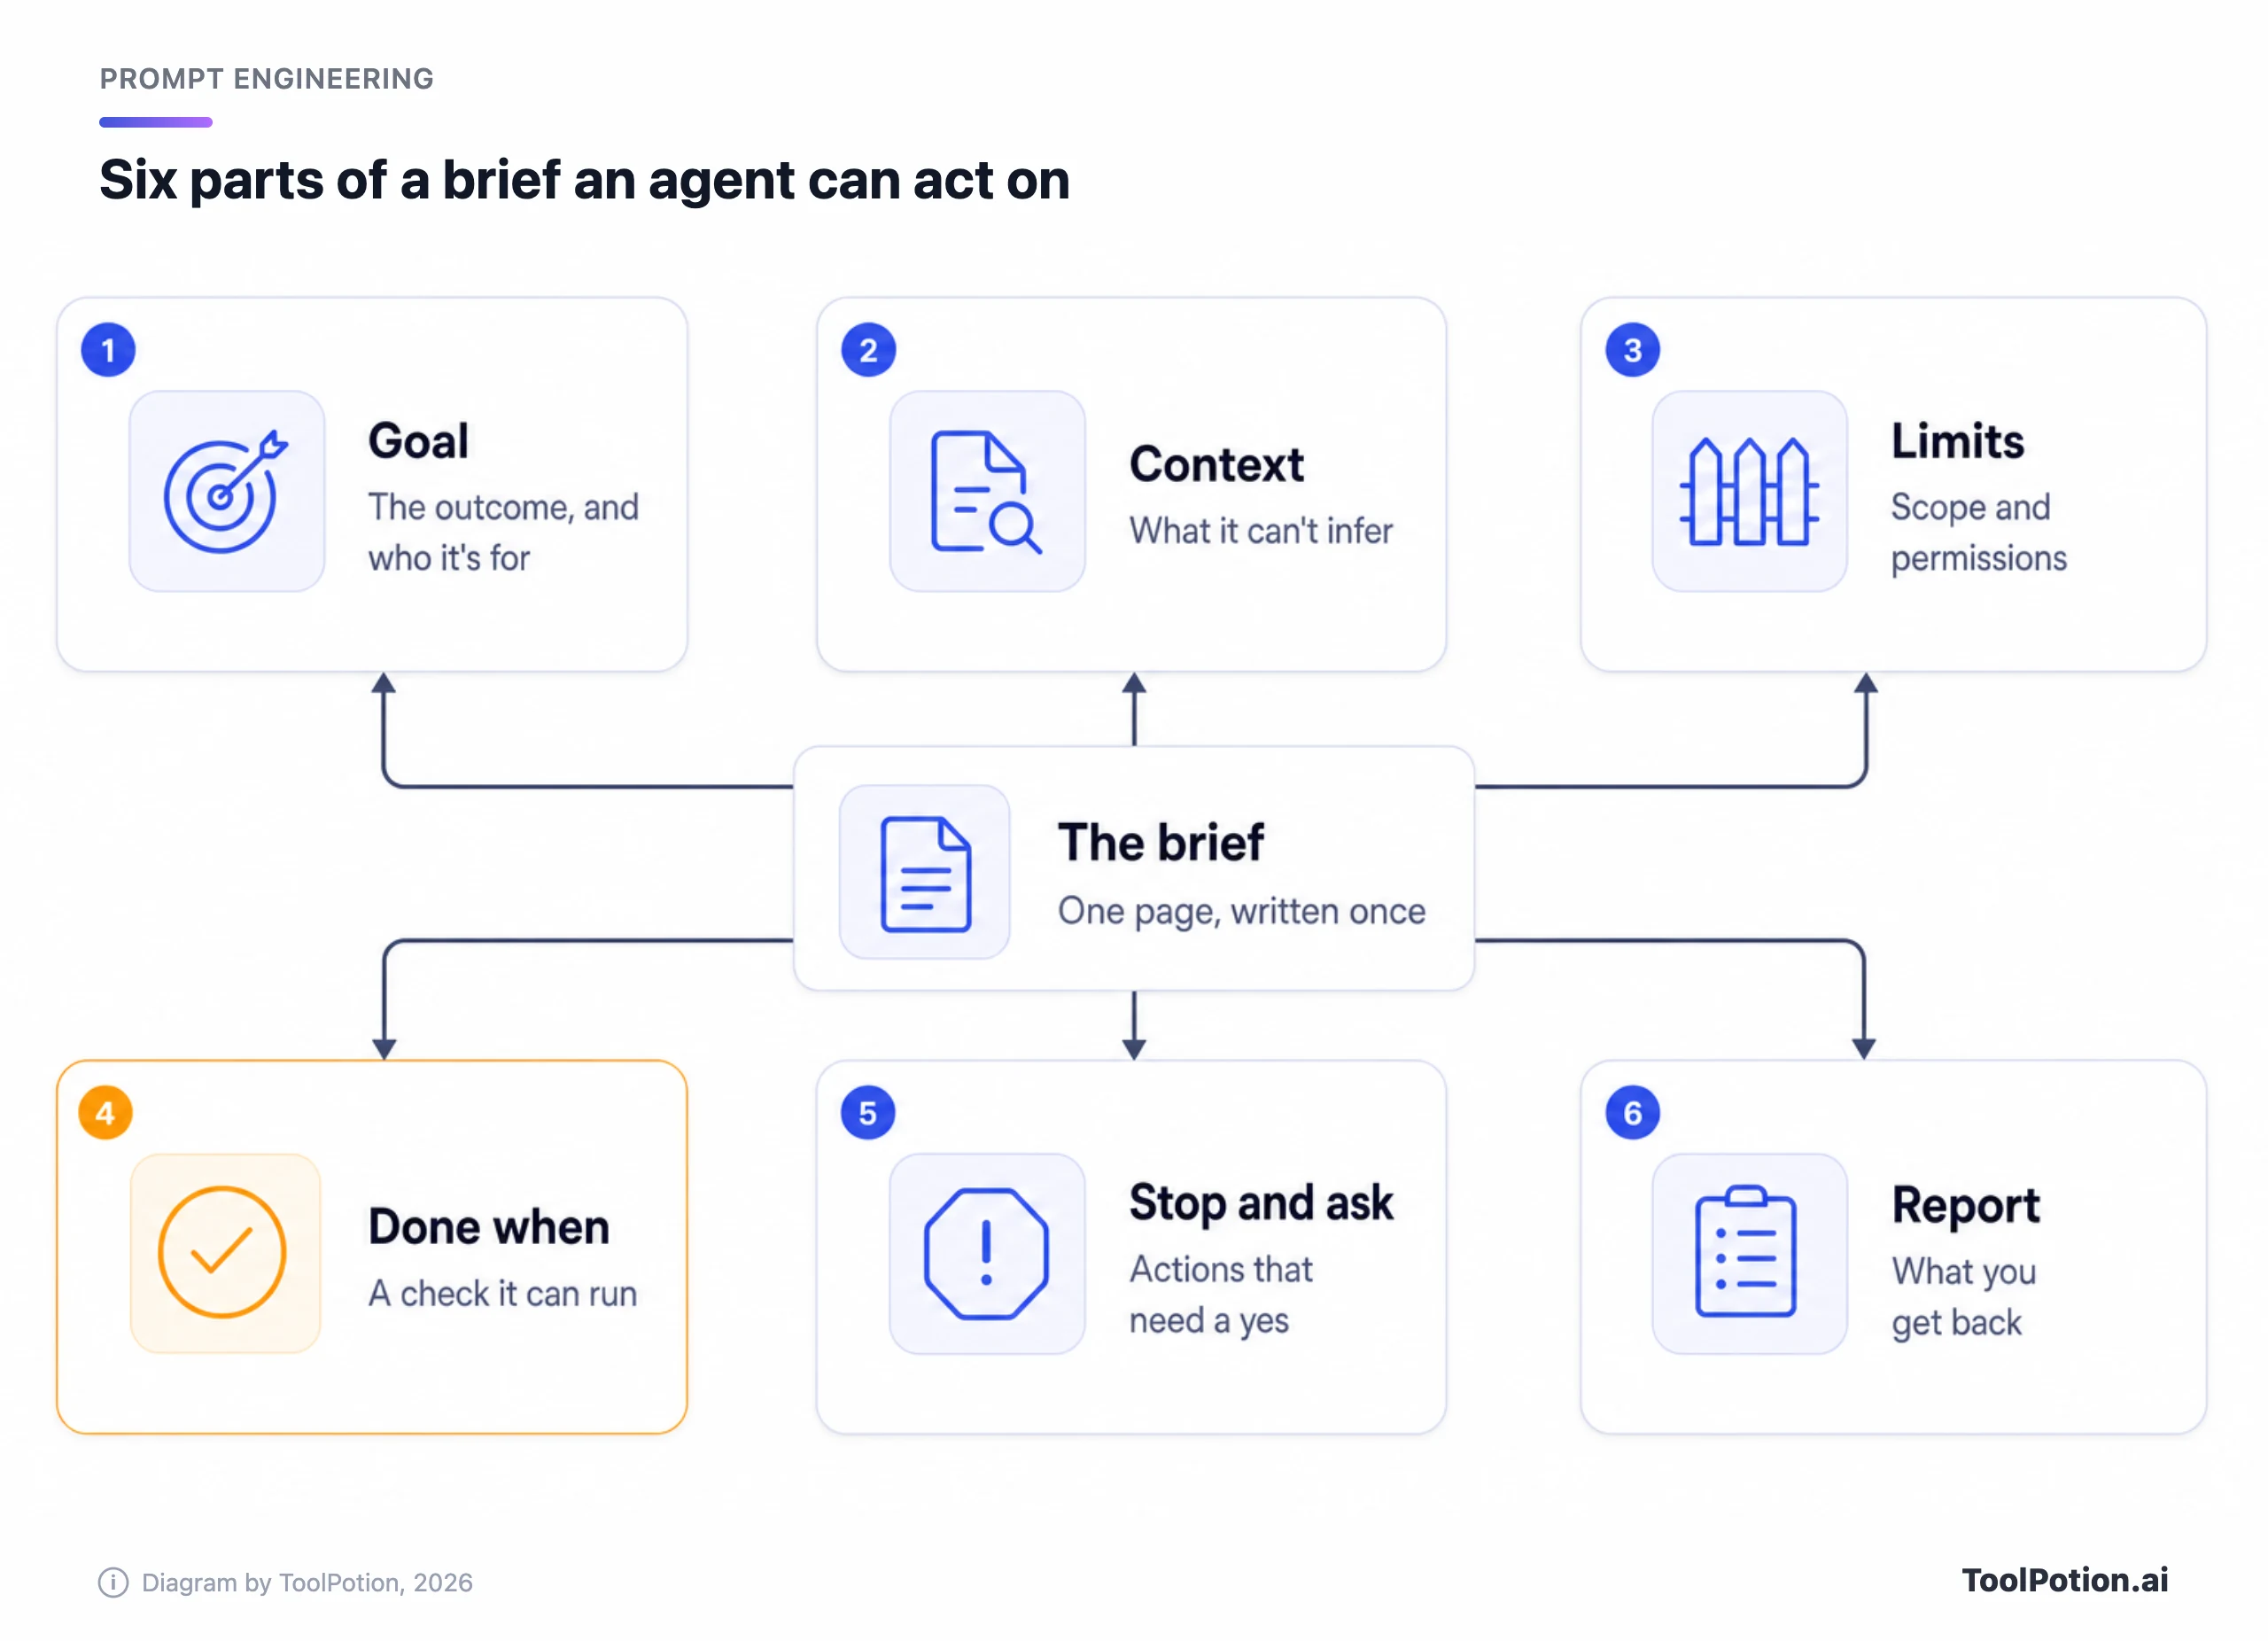
Enam bagian brief, dari atas ke bawah
Tujuan menyebut hasil dan siapa yang memakainya
Satu atau dua kalimat. Sebutkan apa yang Anda inginkan di akhir dan ke mana hasilnya mengalir: rekomendasi yang akan dibaca dua mitra dalam lima menit, perbaikan yang rilis hari Jumat, daftar pendek untuk pembelian. Tujuan akhir menentukan apa yang dimasukkan agent dan apa yang dibuangnya. "Cari tahu soal harga" menghasilkan volume. "Rekomendasikan satu tool di bawah $15 per seat" menghasilkan keputusan.
Konteks adalah apa pun yang tidak bisa ia temukan sendiri
Dokumentasi Claude Code memberi filter yang berguna: "Could it find this by reading the code? Would it actually go and look? If both are yes, leave it out." (Claude Code docs) Yang tetap dimasukkan adalah keputusan rapat yang tidak pernah sampai ke repo, akun yang harus dipakai agent, tool yang sudah Anda coba lalu tinggalkan, dan level pembacanya.
Sertakan juga alasan di balik sebuah aturan. Panduan Anthropic menyebut bahwa konteks atau motivasi di balik sebuah instruksi "can give Claude more information about your goals and help it deliver more targeted responses," dan contoh versi lemahnya sendiri adalah "NEVER use ellipses" yang telanjang tanpa alasan (Anthropic docs).
Batasan menyatakan apa yang masuk lingkup dan apa yang terlarang
Agent cenderung mengerjakan lebih dari yang Anda minta. Panduan Anthropic menyebut Claude Opus 4.5 dan 4.6 punya kecenderungan "creating extra files, adding unnecessary abstractions, or building in flexibility that wasn’t requested," dan menawarkan contoh instruksi yang memuat "Don't add features, refactor code, or make \"improvements\" beyond what was asked." (Anthropic docs) Panduan itu mengaitkan kebiasaan tersebut dengan kedua model itu, jadi periksa pada model mana pun yang Anda pakai. Kami akan meminjam kalimatnya bagaimanapun juga. Lalu tambahkan daftar Anda sendiri: folder yang boleh disentuh, sumber yang boleh dipakai, akun yang tidak boleh dimasuki.
Panduan Gemini dari Google mencantumkan penilaian risiko di antara pengaturan yang dikendalikan oleh sebuah prompt agent, dan menyebut bahwa prompt dapat secara eksplisit membedakan tindakan eksplorasi berisiko rendah (membaca) dari perubahan state berisiko tinggi (menulis) (Google AI docs). Pemisahan itulah bagian yang berguna. Membaca dan menjalankan tes tidak butuh surat izin; menghapus, mengirim, dan membayar butuh.
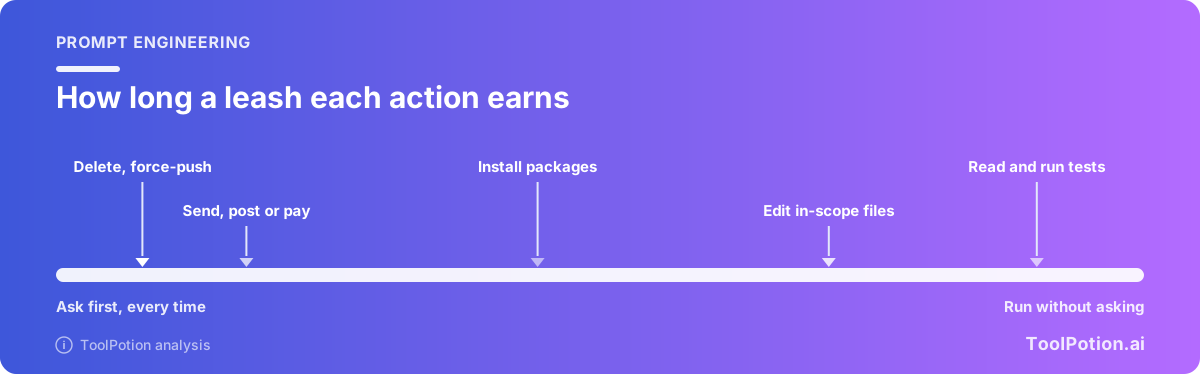
Satu catatan sebelum Anda bersandar pada semua ini. Kata-kata dalam brief hanyalah permintaan. Sandbox, token read-only, atau aturan izin adalah penegakan, dan keduanya tidak saling menggantikan. Panduan kami tentang mengurung AI agent membahas sisi penegakannya; tulisan ini hanya membahas apa yang Anda tulis.
Selesai jika adalah pengecekan yang bisa dijalankan
Sebutkan perintah, jumlah, atau file-nya. "Tes lulus" adalah awal. "pnpm test lulus dan sebuah tes baru membuktikan request ke-101 dalam semenit mendapat 429" adalah pengecekan. Untuk riset, sebutkan berapa item, field apa saja, dan apa yang harus ditulis bila sebuah field tidak ditemukan. Kalau pengecekan itu bisa gagal, beri tahu agent apa yang harus dilakukan berikutnya, dan beri batas. Panduan Google mencatat bahwa "High persistence increases success rates but risks higher token costs or loops," sehingga "ulangi tes yang gagal dua kali, lalu berhenti dan laporkan" adalah baris yang lebih baik daripada diam saja (Google AI docs).
Berhenti-lalu-tanya adalah daftar tindakan, bukan suasana hati
"Tanya saya kalau ragu" menyerahkan sebuah penilaian kepada agent, dan agent yang bersemangat jarang merasa ragu. Daftarkan tindakannya saja. Panduan Anthropic punya contoh prompt untuk hal persis ini, ditulis untuk Claude Opus 4.6: untuk tindakan "that are hard to reverse, affect shared systems, or could be destructive, ask the user before proceeding," dengan menghapus file atau branch, git push --force, dan mengirim pesan di antara contohnya (Anthropic docs). Daftar itulah bagian yang akan kami salin, apa pun modelnya.
Esai desain agent dari Anthropic menjelaskan polanya: agent "can then pause for human feedback at checkpoints or when encountering blockers" (Anthropic Engineering). Jadikan checkpoint pertama sebuah rencana. Minta langkah-langkahnya sebelum ada perubahan apa pun, baca, lalu katakan jalan. Biayanya satu kali bolak-balik, dan menurut kami itu checkpoint termurah yang ada.
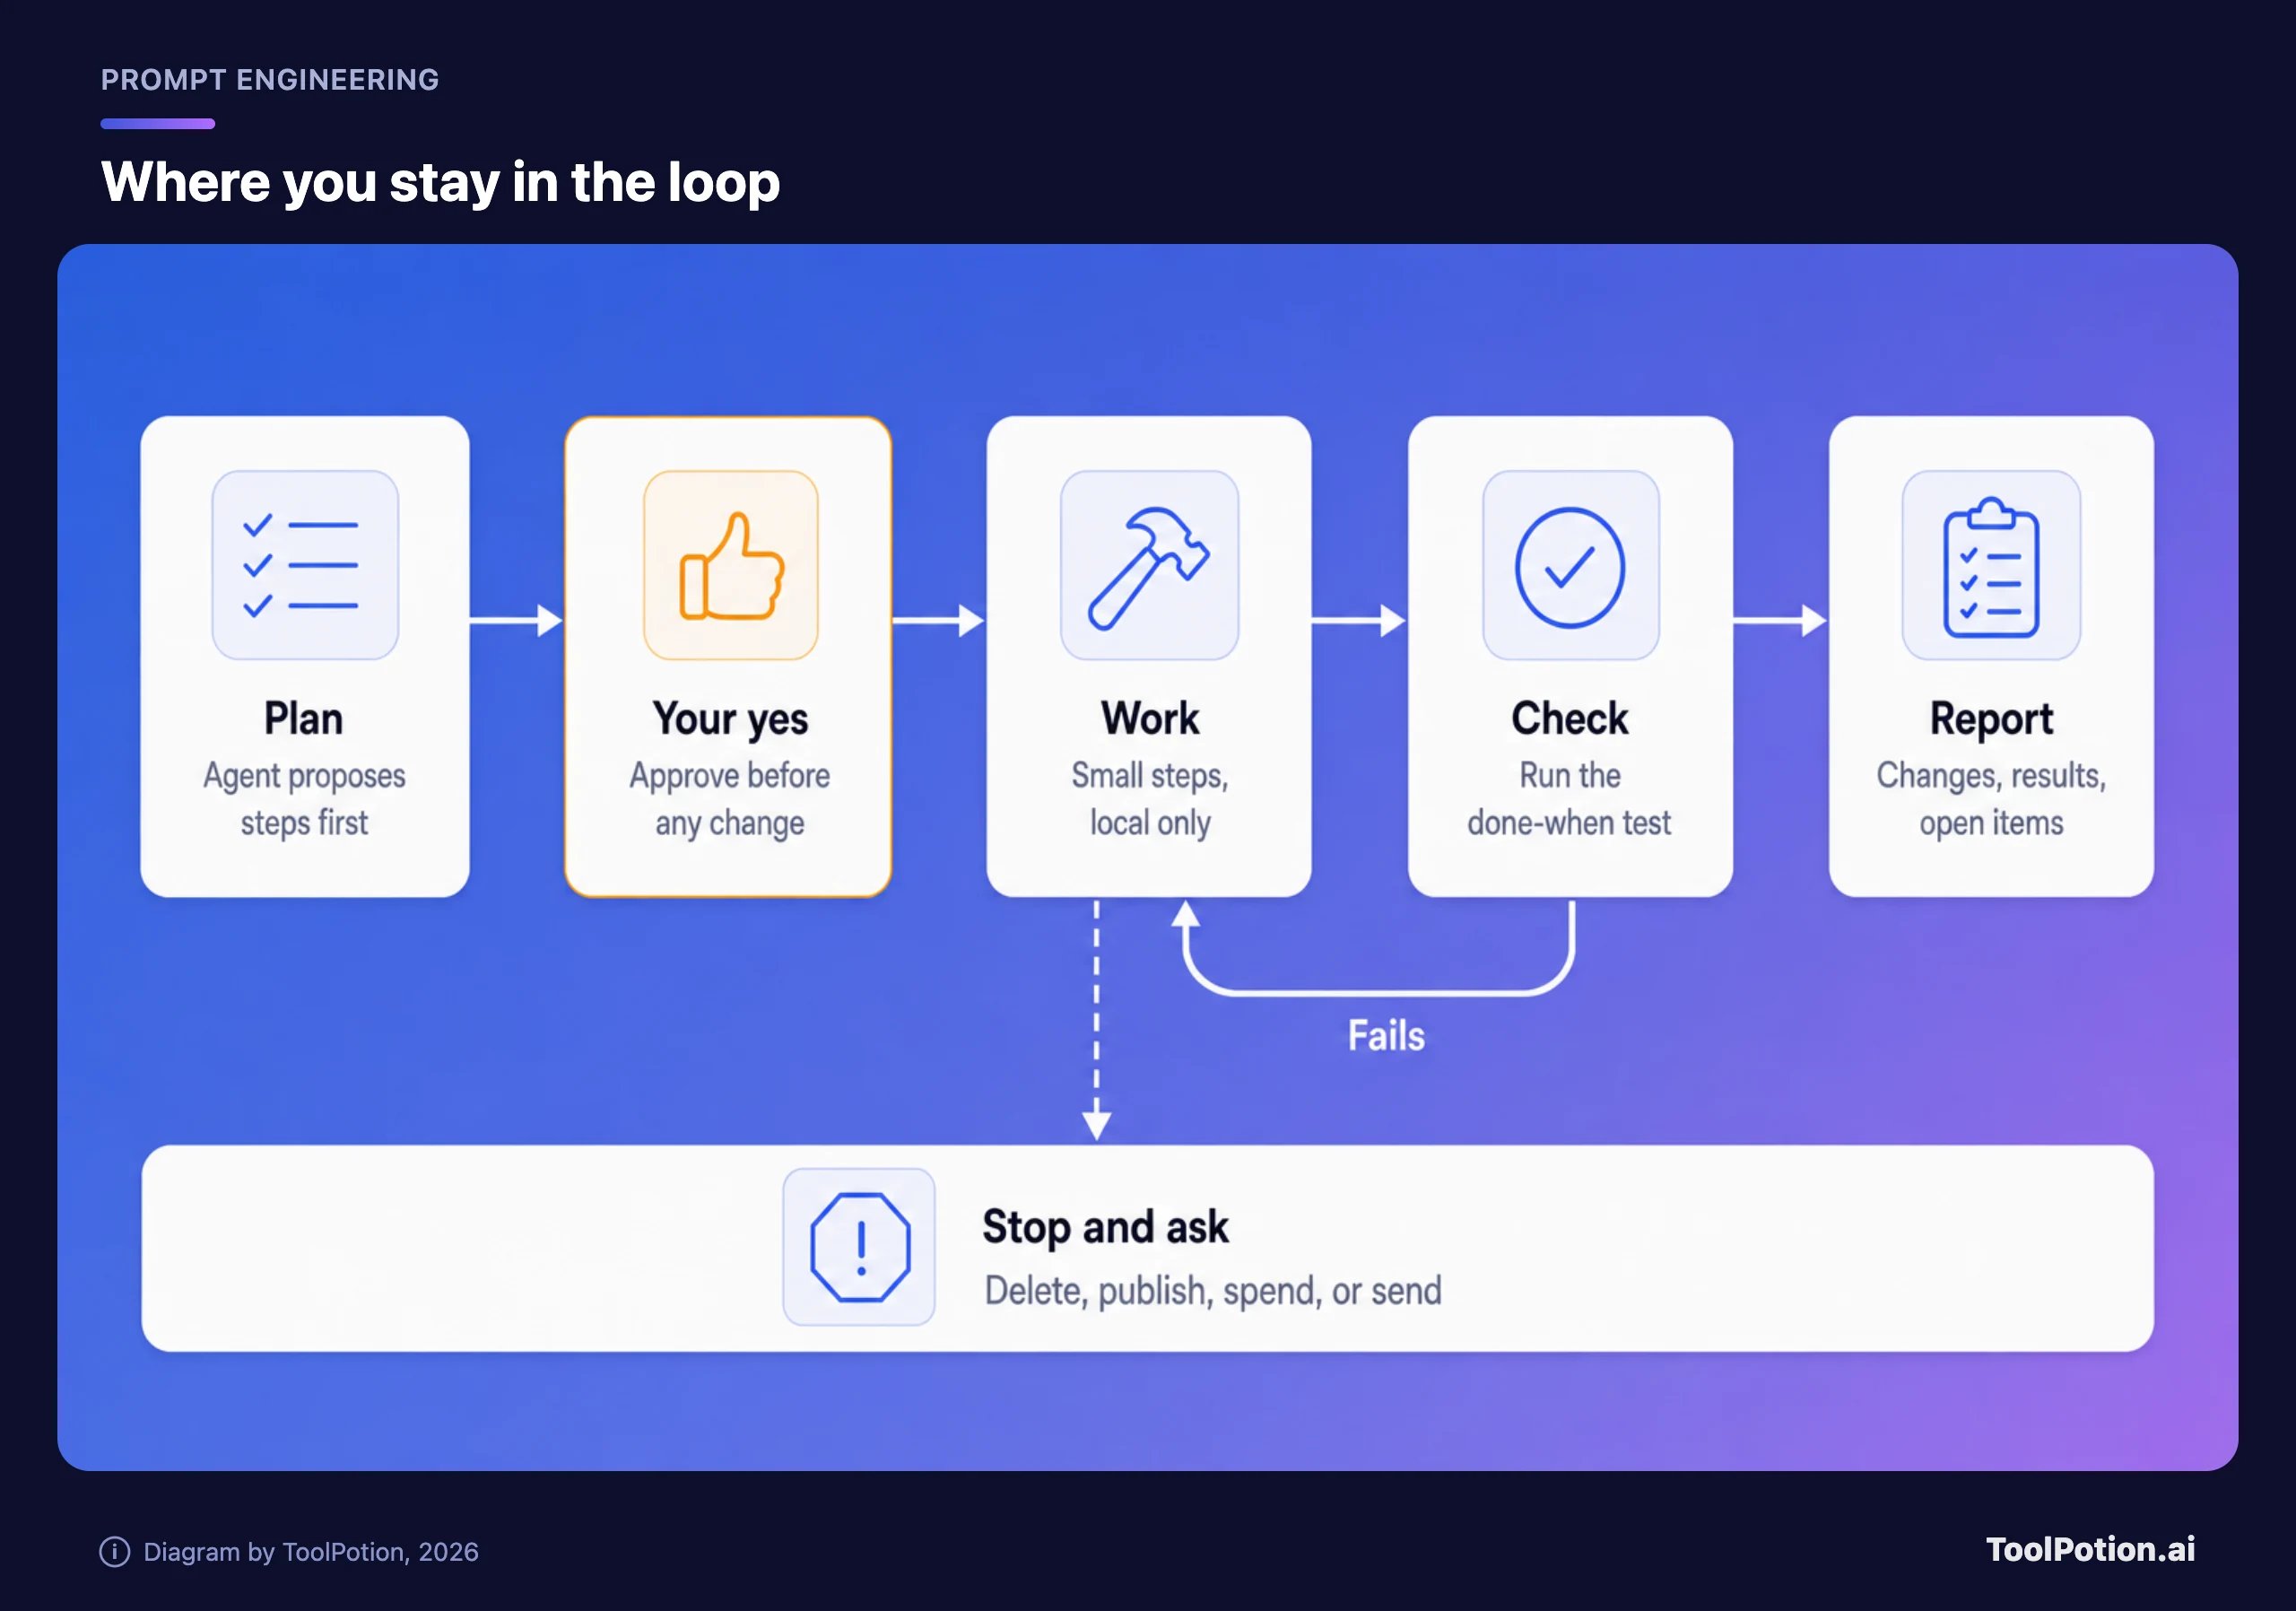
Laporan adalah tempat Anda menentukan apa yang kembali kepada Anda
Minta perubahan yang dibuat, pengecekan yang dijalankan beserta hasilnya, apa pun yang ia asumsikan, dan apa pun yang sengaja tidak ia kerjakan. Poin terakhir itulah yang sering terlupa. Di situlah agent memberi tahu Anda bahwa ia melewatkan migrasi karena Anda bilang jangan sentuh skema.
Tiga brief, sebelum dan sesudah
Setiap penulisan ulang di bawah ini sekitar 120 sampai 150 kata. Itu lebih panjang dari prompt rata-rata dan lebih pendek dari yang dikhawatirkan orang. Ketiga brief ini adalah contoh karangan kami sendiri: tugas, tool, dan angkanya dibuat-buat sebagai ilustrasi, dan tidak ada yang berasal dari vendor atau proyek nyata.
Agent riset (contoh rekaan)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.Coding agent (contoh rekaan)
Dokumentasi Claude Code punya contoh sebelum-sesudahnya sendiri: "add a calendar widget" menjadi permintaan untuk mengikuti pola di file widget yang sudah ada, dengan "no new libraries" (Claude Code docs). Berikut langkah yang sama pada pekerjaan yang lebih besar, ditulis untuk Claude Code atau Codex.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.Agent inbox (contoh rekaan)
Ini untuk asisten mana pun yang Anda izinkan mendekati email Anda, jenis pekerjaan yang membuat produk agent seperti Manus dan Claude Cowork dijual. Email adalah tempat "bersihkan" bisa diam-diam berubah menjadi "dihapus".
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.Baris Tujuan nyaris tidak berubah antara sebelum dan sesudah. Bobotnya ada di empat baris terakhir: pengecekan, penghentian, laporan, dan batasan yang menyatakan apa yang tidak boleh dilakukan agent sama sekali.
Template untuk ditempel
Hapus baris yang tidak relevan, tetapi hapuslah dengan sengaja.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
Nilai draf Anda sendiri dengan template ini. Delapan pertanyaan ya-atau-tidak, tiga puluh detik.
Cara brief gagal, dan apa yang akan kami ubah
| Kegagalan | Yang Anda lihat | Perubahan |
|---|---|---|
| Tujuannya berupa aktivitas | Berhalaman-halaman output, tanpa keputusan | Sebutkan ke mana output mengalir |
| Tanpa "selesai jika" | Berhenti di "kelihatannya selesai" atau tidak pernah berhenti | Tambahkan pengecekan yang bisa dijalankan dan batas percobaan ulang |
| Lingkup tidak dinyatakan | File tambahan, refactor, perbaikan yang tidak diminta | Daftarkan apa yang terlarang |
| Peringatan tanpa alasan | Tembok baris NEVER, diabaikan atau diterapkan berlebihan | Tambahkan alasannya dalam satu klausa |
| Persetujuan hanya tersirat | Ia menghapus, mem-push, atau mengirim atas penilaiannya sendiri | Sebutkan tindakannya dan minta rencana lebih dulu |
| Koreksi menumpuk | Instruksi saling bertentangan | Tulis ulang brief dan mulai dari awal |
Dua di antaranya layak dibahas lebih panjang. Yang pertama adalah tumpukan huruf kapital. Kami ragu penekanan yang lebih keras pernah memperbaiki alasan yang hilang, dan panduan Anthropic menunjuk ke arah yang sama: "NEVER use ellipses" yang telanjang adalah contoh lemahnya. Dokumentasi Claude Code menambahkan bahwa "Phrases like think step by step or be thorough are ordinary prompt text rather than keywords" (Claude Code docs). Karena itu kami akan membuang basa-basi "be thorough". Panduan Anthropic memang menyarankan memberi Claude sebuah peran, meski hanya satu kalimat, jadi kami tidak akan melarangnya; kami hanya melewatkan persona "pakar kelas dunia", karena keenam bagian tadi sudah memberi tahu agent lebih banyak daripada sebuah gelar.
Yang kedua adalah masalah kebalikannya. Contoh prompt agent dalam panduan OpenAI (ditampilkan untuk model gpt-6-astra, sebagai contoh dan bukan aturan) menyuruh model untuk "keep going until the user's query is completely resolved" dan menyebut "Do not stop after completing only part of the request" (OpenAI docs). Itu masuk akal untuk pekerjaan dengan garis finis yang jelas, dan jebakan untuk yang tidak. Agent yang gigih dengan tujuan kabur bisa terus menghabiskan token dalam sebuah loop; panduan Google mengatakan hal serupa tentang persistence yang tinggi. Esai Anthropic menyebut lazim untuk menyertakan "stopping conditions (such as a maximum number of iterations)" demi menjaga kendali (Anthropic Engineering).
Satu kebiasaan lagi yang akan kami tinggalkan: menempelkan brief ke thread yang sudah berisi sepuluh koreksi. Agent kini punya sebelas set instruksi dan tidak punya cara untuk memeringkatnya.
Awasi menit pertama, lalu tulis ulang
Dokumentasi Claude Code menyarankan: "Watch the first minute, press Esc the moment Claude drifts, and after two failed corrections run /clear and write a better prompt instead of a third" (Claude Code docs). Kami akan menerapkannya pada agent mana pun: rencana pertama dan beberapa tindakan awal menunjukkan apakah brief Anda dibaca sesuai maksud Anda.
Bila Anda belum bisa menulis brief-nya, biarkan agent mewawancarai Anda. Dokumentasi Claude Code menyarankan prompt semacam "Interview me until you could write the spec, then write it to SPEC.md," dan panduan Codex menyuruh memintanya bertanya kepada Anda lebih dulu dan "challenge your assumptions" (Claude Code docs, dan OpenAI Codex docs). Lalu mulai sesi baru dari spec tertulis itu.
Brief yang berhasil dua kali layak punya tempat tinggal. Aturan tetap (cara menjalankan tes, apa yang tidak boleh disentuh) masuk ke file AGENTS.md atau CLAUDE.md; OpenAI menyebut "A short, accurate AGENTS.md is more useful than a long file full of vague rules" (OpenAI Codex docs). Prosedur yang Anda ulang-ulang bisa menjadi skill, yang kami bahas di From Prompts to Skills. Apa yang perlu dimuat ke dalam sesi sejak awal adalah topik tulisan context engineering kami, dan kebiasaan yang menjaga prompt tetap bekerja lintas rilis model ada di Prompt Patterns That Survive Model Updates. Untuk tool yang dibangun di sekitar delegasi semacam ini, lihat daftar kami untuk AI agent, tugas membangun agent, dan tool prompt engineering.
Pertanyaan yang sering diajukan
Seberapa panjang sebuah brief?
Cukup panjang untuk memuat keenam bagian, yang untuk kebanyakan pekerjaan berarti 100 sampai 200 kata. Preferensi tetap sebaiknya ada di file aturan agar setiap brief hanya mencakup tugas ini. Kalau brief melebihi satu halaman, pekerjaannya mungkin perlu dipecah menjadi dua.
Apakah ChatGPT, Claude, dan Gemini membutuhkan brief yang berbeda?
Kerangkanya sama. Empat bagian dalam panduan Codex dari OpenAI, saran Anthropic untuk menyediakan konteks dan bertanya sebelum tindakan berisiko, serta dimensi agent dari Google (penanganan ambiguitas, penilaian risiko, persistence) menggambarkan satu set kebutuhan dengan kata-kata berbeda. Format berbeda sedikit: panduan Google merekomendasikan tag bergaya XML atau heading Markdown dan menyuruh untuk "Choose one format and use it consistently" (Google AI docs). Asisten mana yang cocok untuk pekerjaan apa adalah pertanyaan tersendiri yang kami bahas di ChatGPT vs Claude vs Gemini in 2026.
Apa yang harus saya suruh dilakukan agent saat ia ragu?
Beri ia aturan yang bisa diterapkan. "Asumsikan apa pun yang bisa dibatalkan dan cantumkan di laporan; tanya dulu sebelum hal yang tidak bisa" bekerja lebih baik daripada "tanya kalau ragu." Panduan Google membingkai pilihan yang sama sebagai kapan model boleh membuat asumsi dan kapan ia harus berhenti untuk meminta klarifikasi atau izin.
Apakah brief yang bagus cukup untuk membuat agent aman?
Tidak. Brief mengurangi kesalahan dan tidak mencegah satu pun. Anthropic merekomendasikan "extensive testing in sandboxed environments, along with the appropriate guardrails" (Anthropic Engineering), dan panduan containment kami membahas izin dan audit trail.
Agent-nya tetap salah. Lalu bagaimana?
Temukan langkah pertama saat ia menyimpang dan tanyakan apa yang dikatakan brief tentang langkah itu. Tambahkan satu baris yang akan mencegahnya, lalu jalankan ulang dari sesi baru.