

Agar bisa memeriksa fakta output AI tanpa kewalahan, berhentilah mencoba memverifikasi setiap kalimat. Ekstrak klaimnya, urutkan berdasarkan dampak jika salah, lalu periksa klaim yang menjadi tumpuan tulisan Anda langsung ke sumber aslinya. Sitasi yang rapi maupun jawaban "ya, saya yakin" dari model sama-sama tidak membuktikan apa pun.
Biaya karena melewatkan langkah ini terus naik. Sebuah database publik berisi putusan pengadilan yang melibatkan materi halusinasi AI telah mencatat 2.125 putusan saat artikel ini ditulis, dan 1.193 di antaranya muncul tahun ini saja (AI Hallucination Cases database). Awal tahun ini KPMG menarik laporan yang sudah terbit karena dugaan halusinasi AI, setelah organisasi yang disebut di dalamnya menyatakan klaim laporan itu tentang penggunaan AI mereka "either untrue or misleading" (TechCrunch).
Halusinasi belum hilang. Hanya saja kini lebih sulit dikenali, karena prosa di sekelilingnya mengalir lancar dan referensi palsunya tampak seperti yang asli. Di bawah ini Anda akan menemukan jenis klaim yang paling sering salah, alasan mengapa pemeriksaan mandiri oleh model tidak cukup, alur kerja berbasis tingkat risiko dengan prompt siap salin, dan ulasan jujur tentang tool grounding seperti Gemini Notebook (sebelumnya NotebookLM), Perplexity, dan Consensus.
Sitasi palsu kini jadi "genre" tersendiri di ruang sidang
Para pengacara lebih dulu mengalaminya, dan di depan publik. Database Damien Charlotin mencatat putusan di mana pengadilan atau tribunal menemukan, atau menyiratkan, bahwa salah satu pihak mengandalkan konten halusinasi, biasanya yurisprudensi karangan. Database ini tidak berusaha menghitung semua sitasi palsu yang pernah diajukan, hanya yang dibahas secara tertulis oleh pengadilan atau tribunal. Bahkan dengan filter yang sesempit itu, kurvanya tetap menanjak tajam.
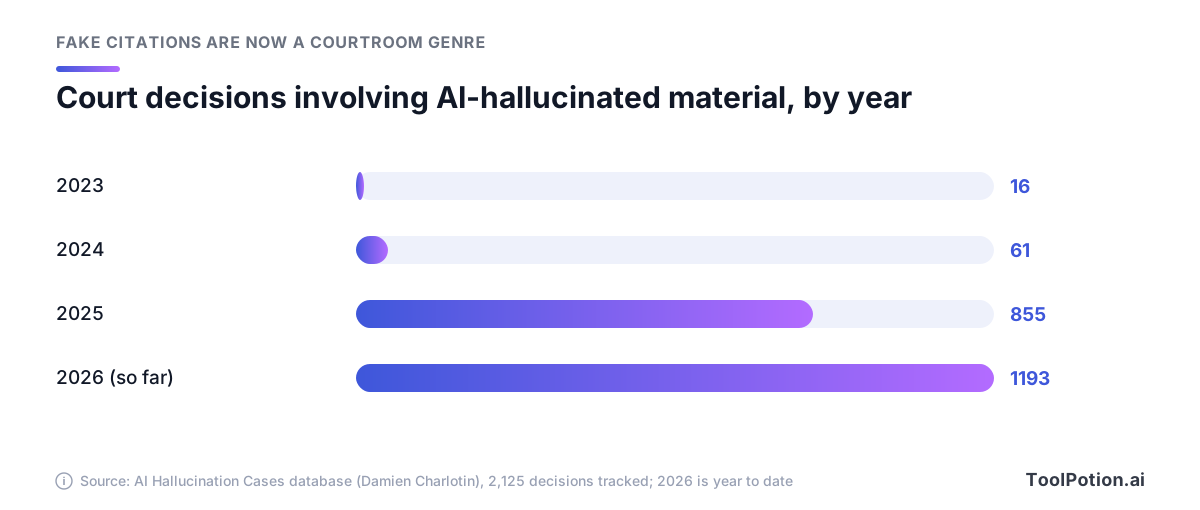
Batang 2026 baru mencakup sebagian tahun dan sudah melampaui 2025. Pihak yang mewakili diri sendiri menyumbang 1.227 putusan yang tercatat, tetapi pengacara menyumbang 840, dan daftar itu mencakup 33 putusan di mana materi halusinasinya berasal dari hakim. Amerika Serikat mendominasi dengan 1.459 putusan, disusul Kanada dengan 223 dan Australia dengan 112.
Kasus yang memulai semuanya masih menjadi pelajaran terbaik. Dalam Mata v. Avianca pada 2023, seorang pengacara dalam perkara di pengadilan federal New York bertanya kepada ChatGPT apakah salah satu kasus yang diberikannya itu nyata. Jawabannya ya. Saat didesak lagi, ChatGPT menyatakan kasus itu "does indeed exist and can be found on legal research databases such as Westlaw and LexisNexis" (CNN). Kasus itu tidak ada, dan pengadilan menjatuhkan denda $5.000 kepada para pengacara dan firma mereka. Sang pengacara menyatakan dalam affidavit bahwa ia "was unaware of the possibility that its content could be false."
Sejak itu tagihannya makin besar. Dalam Couvrette v. Wisnovsky, pengadilan federal di Oregon menemukan lima belas sitasi fiktif dan tujuh kutipan keliru di seluruh berkas para penggugat. Pengadilan mencoret berkas tersebut, menolak gugatan dengan prejudice, dan menjatuhkan sanksi serta biaya sebesar $110.204, total terbesar untuk kasus di AS dalam database itu. Jika Anda memakai AI untuk pekerjaan hukum, panduan kami tentang AI untuk pekerjaan hukum membahas setup yang lebih aman.
Pengadilan hanyalah arena yang paling kelihatan. Deloitte setuju mengembalikan sebagian biaya atas tinjauan pemerintah Australia senilai $440.000 yang mengutip laporan fiktif atas nama profesor universitas dan menyertakan referensi karangan terhadap putusan pengadilan yang nyata. Firma itu kemudian mengungkapkan bahwa mereka memakai rangkaian tool berbasis GPT-4o di Azure OpenAI (The Guardian). Tahun ini EY menarik laporan tentang program loyalitas yang tampaknya memuat catatan kaki palsu, menurut artikel TechCrunch yang sama yang membahas KPMG. Dan pada 2025, Chicago Sun-Times memuat daftar bacaan musim panas sindikasi yang 10 dari 15 bukunya ternyata fiktif, lapor NPR.
Di mana output AI sering salah
Model hampir tak pernah salah eja lagi, dan peneliti OpenAI menjelaskan mengapa kesalahannya berpindah tempat. Ejaan mengikuti pola yang dipelajari model besar, tetapi "arbitrary low-frequency facts, like a pet's birthday, cannot be predicted from patterns alone and hence lead to hallucinations" (OpenAI). Ketika mereka meminta sebuah chatbot yang banyak dipakai menyebutkan judul disertasi PhD salah satu penulis makalah itu sendiri, chatbot memberi tiga jawaban berbeda. Tidak satu pun benar.
Dari sini Anda mendapat peta. Kesalahan menumpuk pada beberapa jenis klaim, dan yang paling berisiko adalah yang tampil seperti bukti.
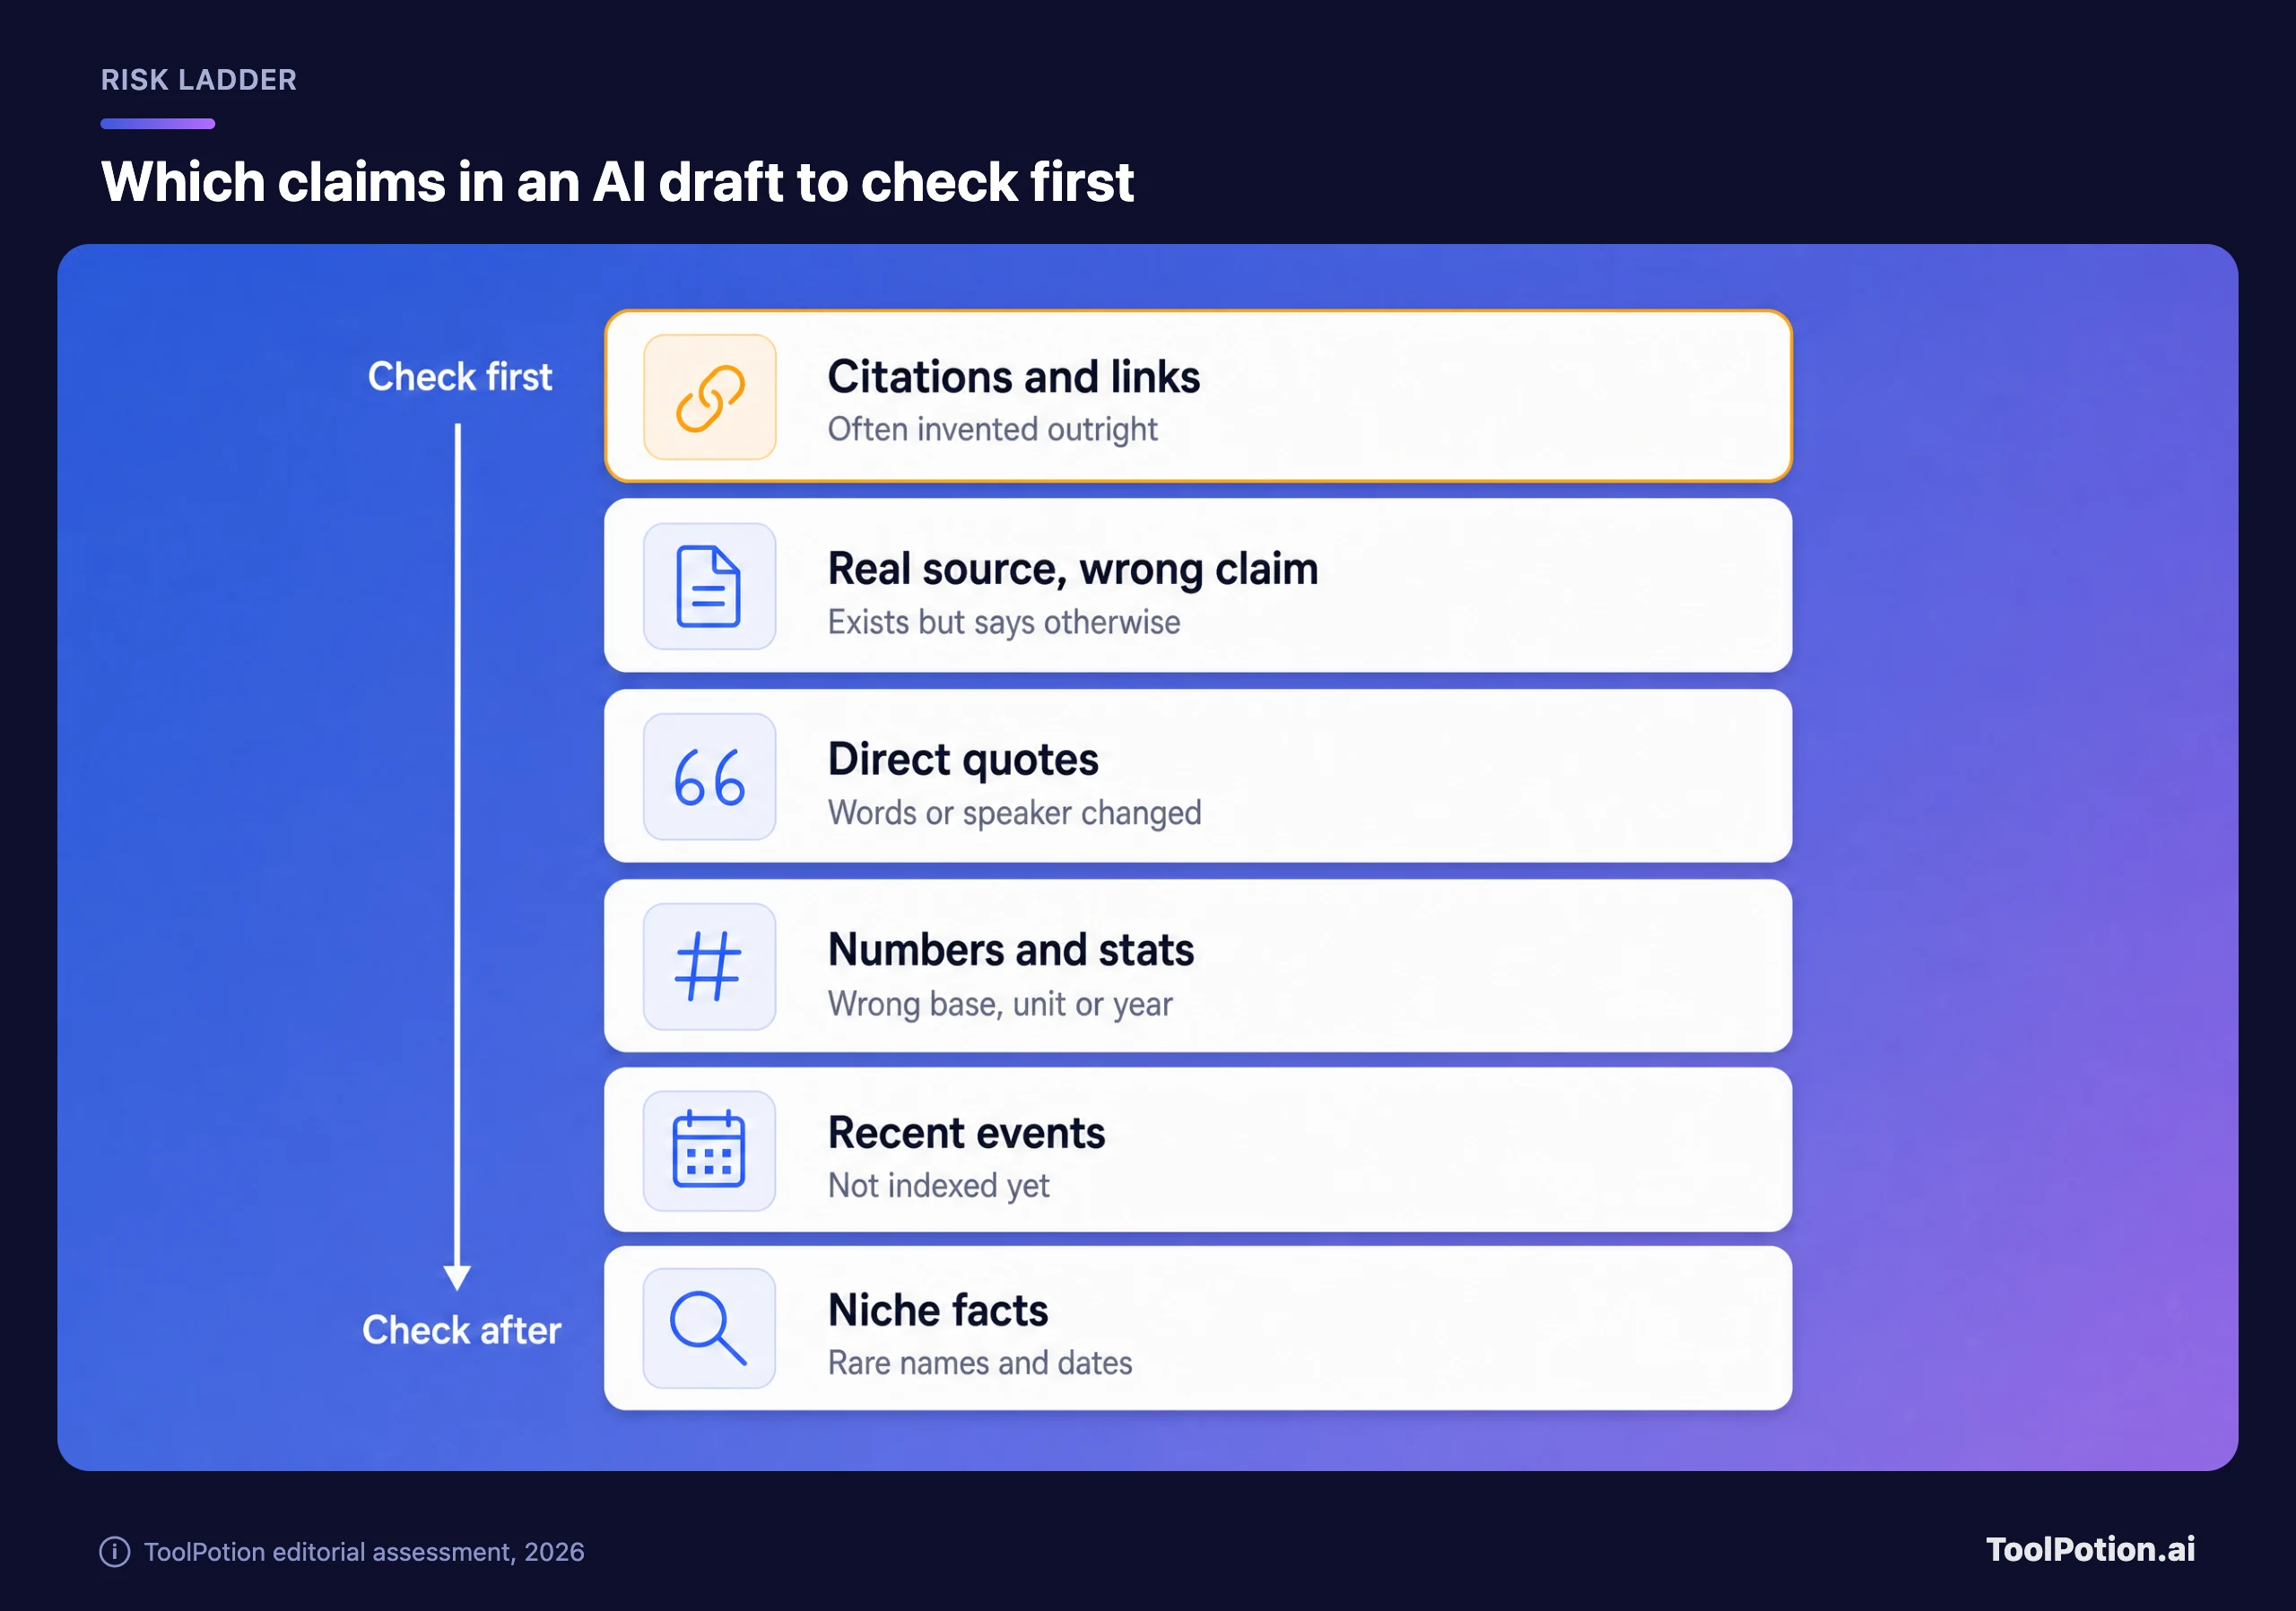
Sitasi berada di puncak karena bisa salah dengan dua cara. Sebagian dikarang mentah-mentah: ketika Tow Center di Columbia menjalankan 1.600 kueri pada delapan tool pencarian AI pada 2025, meminta masing-masing mengidentifikasi sumber kutipan berita, secara keseluruhan lebih dari 60% jawabannya salah, dan Grok 3 mengarahkan 154 dari 200 sitasinya ke halaman error (Tow Center). Sebagian lain nyata tetapi dikutip untuk hal yang tidak ia katakan. Database Charlotin mencatat 894 putusan yang melibatkan materi yang disalahgambarkan, di samping 1.752 yang melibatkan fabrikasi. Tautan yang berfungsi tidak akan menangkap jenis kedua ini.
Kutipan menyusul berikutnya. Database itu mencatat 572 putusan dengan kutipan palsu, dan pusat bantuan OpenAI sendiri menyebut "fabricated quotes, studies, citations or references to non-existent sources" sebagai salah satu mode kegagalan ChatGPT yang diketahui (OpenAI Help). Angka gagalnya lebih senyap: angka nyata dari tahun yang salah, persentase yang disajikan sebagai poin persentase, harga regional yang dijadikan harga global.
Soal keterkinian adalah jebakan tersendiri. Dokumentasi developer Perplexity menyebut halusinasi paling mungkin terjadi ketika informasi berada di balik login atau paywall, ketika pencarian mengembalikan "related but non-matching results", atau "when very recent information isn't indexed yet" (Perplexity docs). Studi 2025 yang dipimpin BBC atas lebih dari 3.000 jawaban berita dari ChatGPT, Microsoft Copilot, Google Gemini, dan Perplexity menemukan masalah akurasi besar, termasuk informasi kedaluwarsa, pada 20% di antaranya.
Lalu ada soal nada. Dalam uji Tow Center itu, ChatGPT salah mengidentifikasi 134 artikel tetapi hanya menandai ketidakpastian 15 kali dari 200 respons, dan tier berbayar dari beberapa tool menjawab lebih banyak pertanyaan dengan benar sekaligus memberi lebih banyak jawaban salah yang disampaikan dengan yakin. Halaman bantuan OpenAI menyatakannya lugas: "The model may express high confidence even in incorrect answers." Pada output AI, nada yang yakin hampir tidak memberi tahu apa pun tentang akurasi.
Mengapa meminta model memeriksa ulang tidak cukup
Jalan pintas yang paling jelas adalah menempelkan kembali draf ke model dan bertanya apakah isinya akurat. Mata v. Avianca sudah menunjukkan hasilnya, dan riset mendukungnya. Makalah yang dipresentasikan di ICLR 2024 menemukan bahwa model "struggle to self-correct their responses without external feedback, and at times, their performance even degrades after self-correction" (Huang et al.).
Penyebabnya ada pada pelatihan. Peneliti OpenAI berargumen bahwa "standard training and evaluation procedures reward guessing over acknowledging uncertainty," seperti ujian pilihan ganda yang lebih menghargai tebakan buta daripada jawaban kosong. Mereka juga mengakui bahwa akurasi "will never reach 100%" karena sebagian pertanyaan nyata memang tak bisa dijawab. Model yang meninjau drafnya sendiri memakai pengetahuan yang sama dengan yang menghasilkan kesalahan, sehingga tinjauannya cenderung mengulang kesalahan itu.
Meski begitu, self-review tetap berguna. Makalah 2023 tentang Chain-of-Verification menunjukkan bahwa versi terstrukturnya membantu: model menyusun jawaban, menulis pertanyaan verifikasi, menjawabnya terpisah dari draf, lalu merevisi. Cara ini menurunkan halusinasi di berbagai tugas. Anggap ini cara untuk menemukan tersangka, bukan untuk membebaskan mereka.
Grounded bukan berarti benar
Memberi model sumber untuk dikerjakan memang menurunkan tingkat kesalahan, tetapi tidak menjadikannya nol. Leaderboard publik Vectara meminta model meringkas lebih dari 7.700 artikel hanya dengan fakta di dalam tiap artikel, lalu menilai ringkasannya dengan model deteksi milik Vectara sendiri. Bahkan dalam skenario semudah itu, setiap model di daftar menambahkan konten tak berdasar ke sebagian ringkasannya (Vectara).
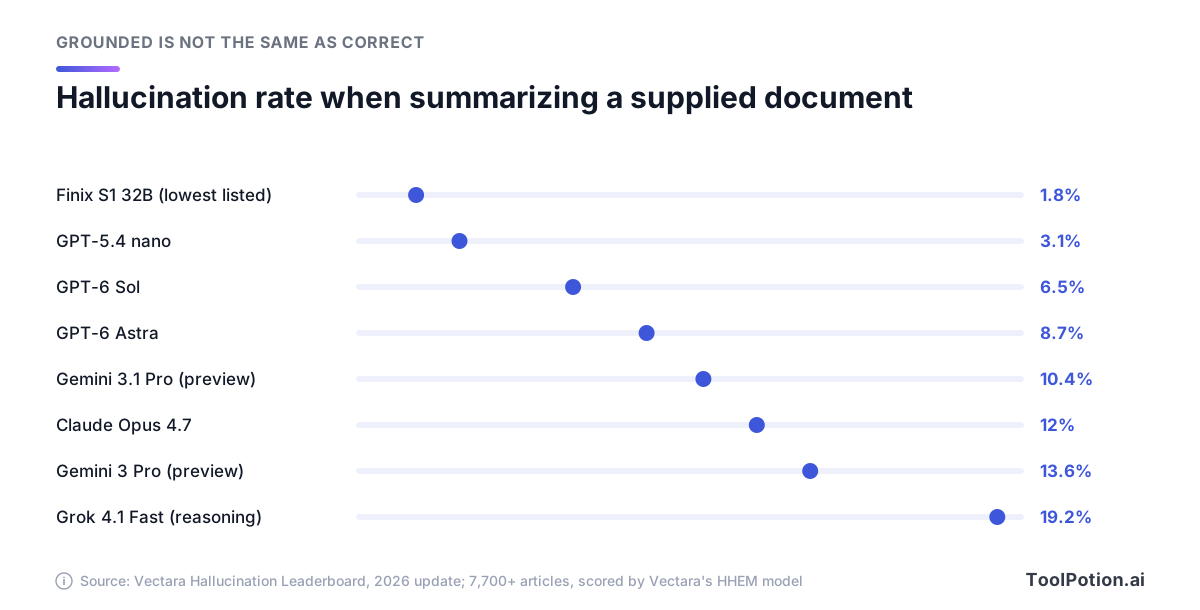
Pada pembaruan terbaru, GPT-6 Sol menambahkan materi tak berdasar pada 6,5% ringkasan dan Claude Opus 4.7 pada 12%. Model yang menilai model lain tentu tidak sempurna, Vectara sendiri menyatakan terang-terangan bahwa uji ini tidak menangkap semua jenis halusinasi, dan tabelnya belum memuat setiap rilis terkini. Arahnya tetap jelas. Studi 2024 tentang tool riset hukum yang mengambil yurisprudensi nyata, termasuk Lexis+ AI dan AI-Assisted Research milik Westlaw, menemukan mereka tetap berhalusinasi 17% hingga 33% dari waktu. Grounding mempersempit masalah menjadi satu pertanyaan: apakah sumber ini benar-benar mengatakan hal tersebut? Pertanyaan itu tetap harus Anda ajukan.
Alur verifikasi yang diurutkan berdasarkan risiko
Solusinya adalah triase. Sebagian besar draf hanyalah jaringan penghubung, seperti pembingkaian, transisi, dan opini yang toh akan Anda pertahankan. Sekumpulan kecil klaim menopang keseluruhan tulisan, dan di situlah kesalahan merusak. Pilah dulu, lalu habiskan waktu pemeriksaan di tempat yang paling berdampak.
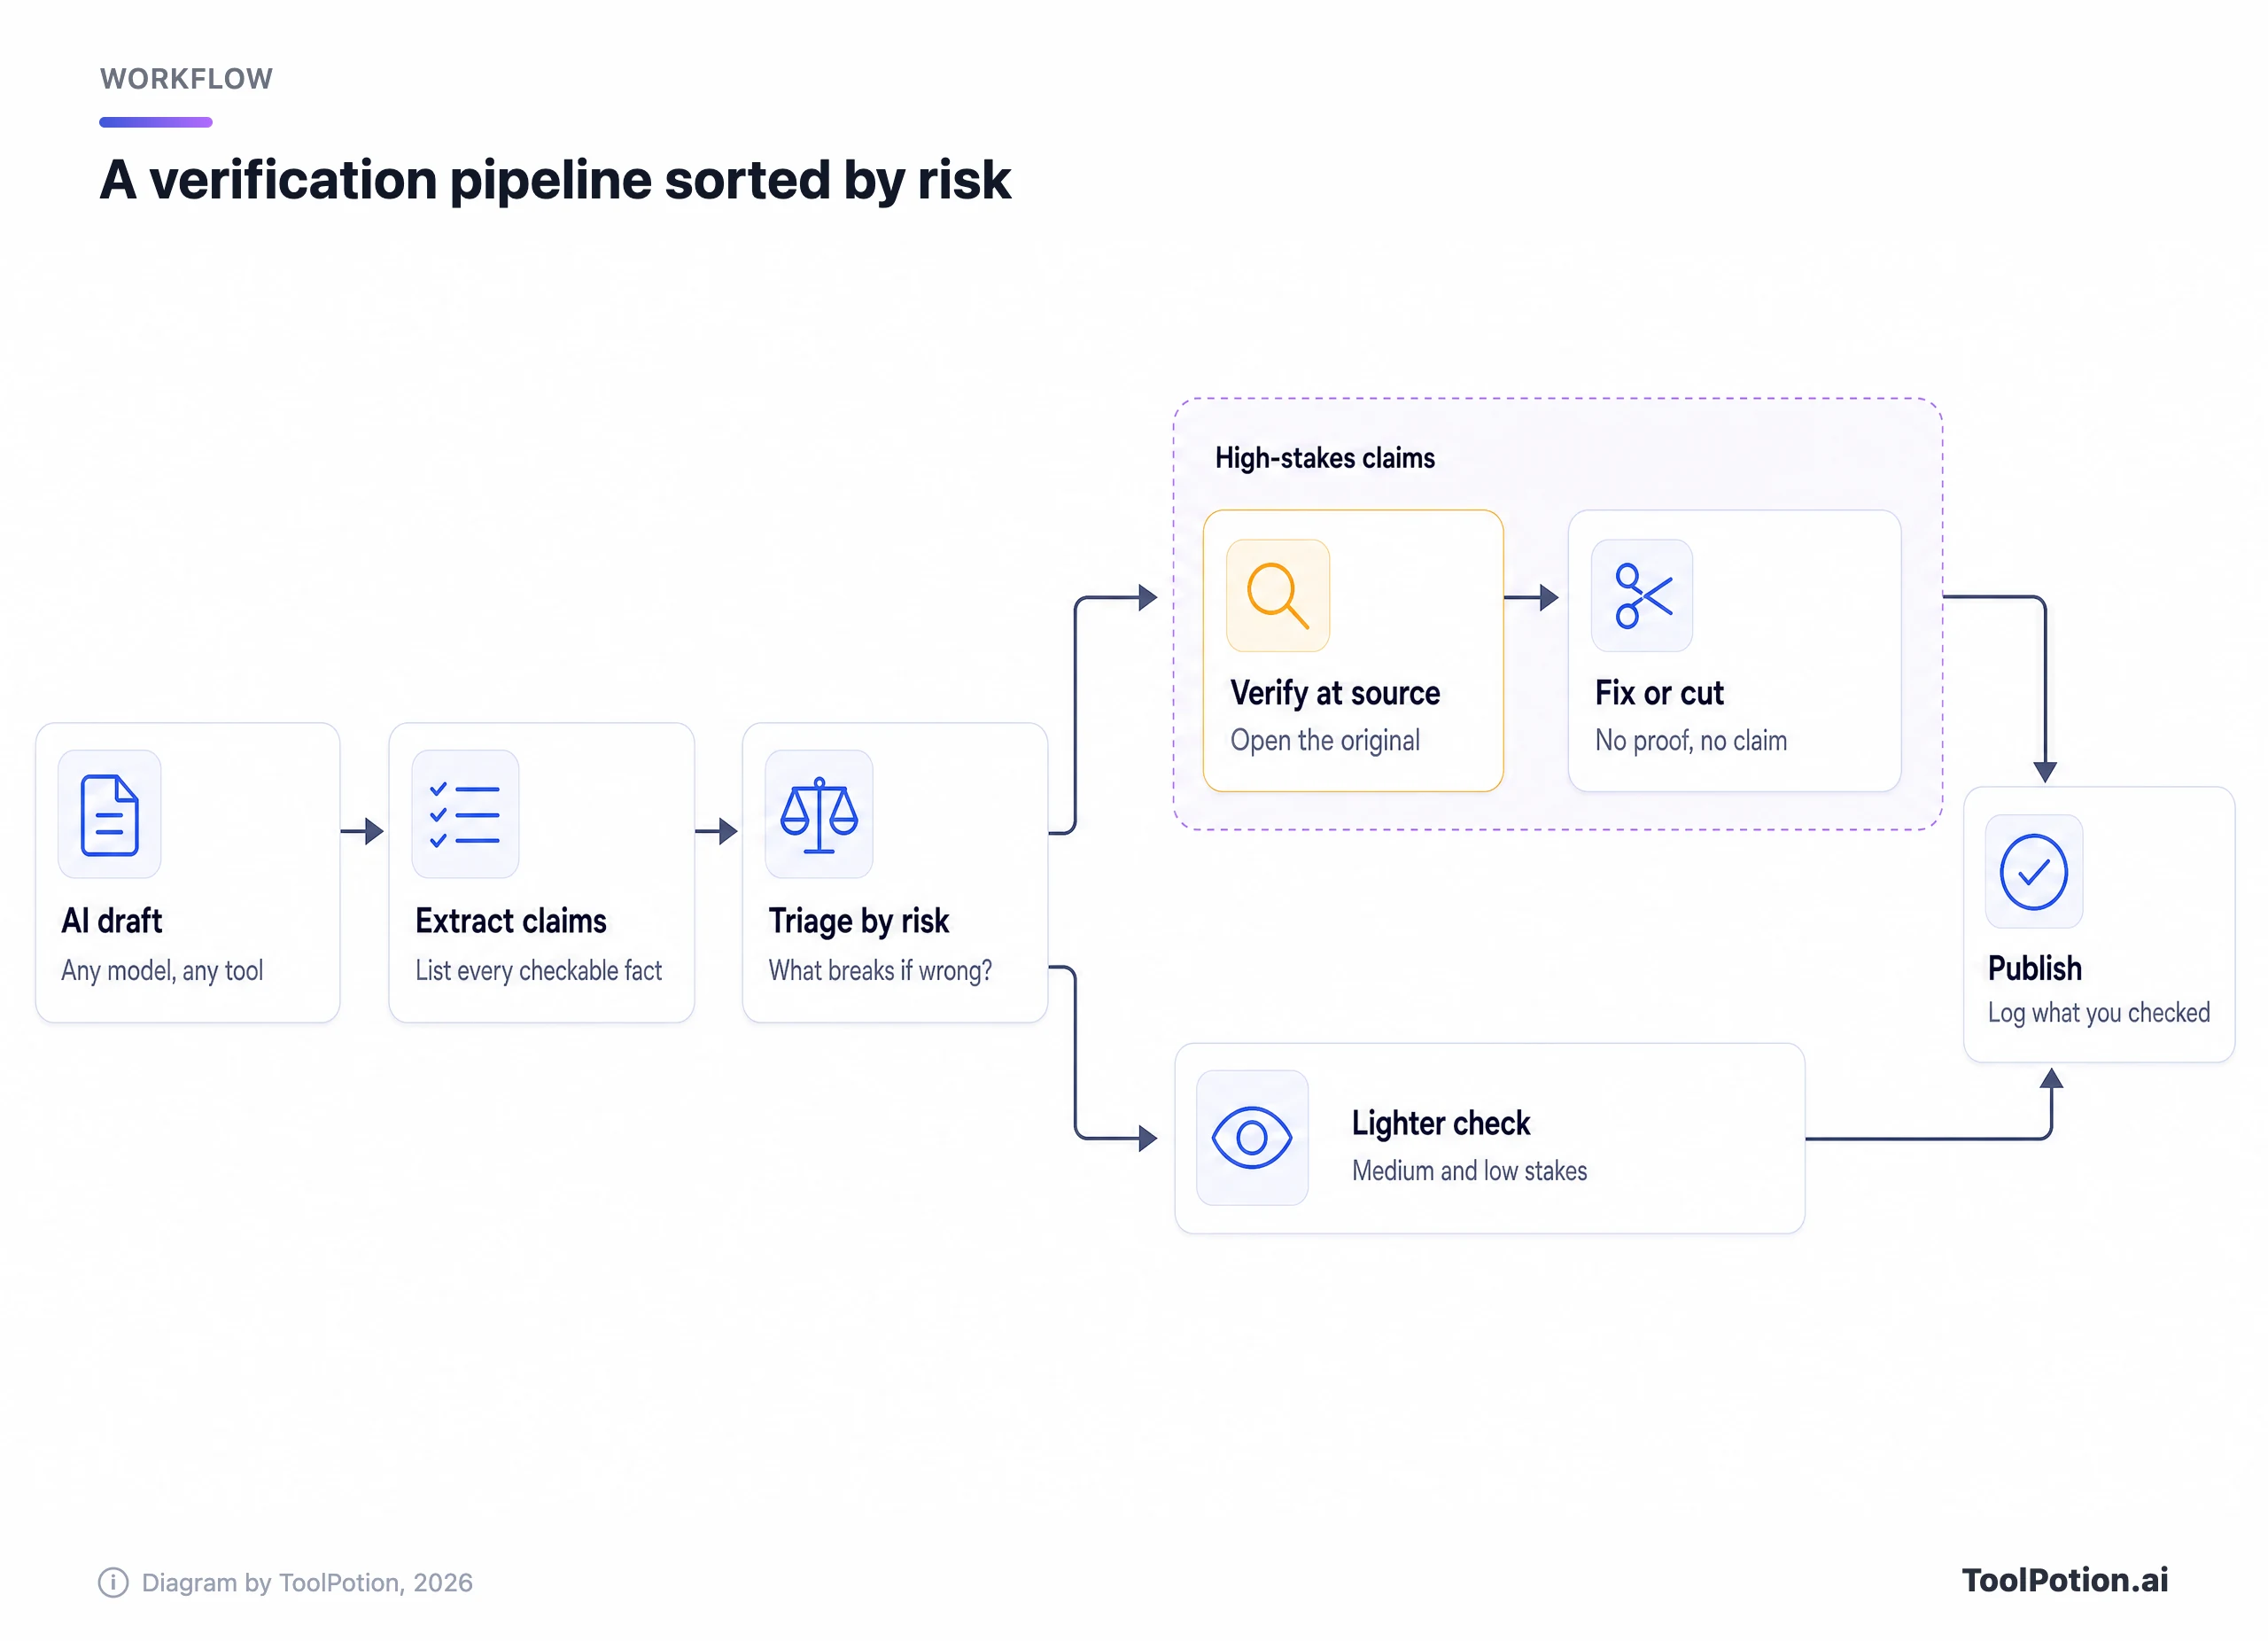
- Ekstrak klaimnya. Minta model mendaftar setiap pernyataan yang bisa diperiksa dalam draf: nama, angka, tanggal, kutipan, sitasi, dan klaim sebab-akibat. Anda akan menemukan klaim yang tidak Anda sadari sedang Anda buat.
- Triase berdasarkan taruhannya. Tanyakan apa yang terjadi jika setiap klaim salah. Segala hal yang bersifat hukum, medis, atau keuangan berisiko tinggi, demikian pula setiap sitasi, setiap kutipan langsung, statistik apa pun di judul atau ringkasan, dan klaim apa pun tentang orang atau perusahaan tertentu. Konteks pendukung yang mungkin diulang pembaca masuk tingkat sedang. Pembingkaian yang bisa Anda pertahankan dari ingatan masuk tingkat rendah.
- Verifikasi tingkat tinggi di sumber primer: putusan pengadilan, berkas pengajuan, dataset, halaman resmi perusahaan, atau makalahnya sendiri. Berita tentang sebuah studi bukanlah studinya.
- Periksa sampel tingkat sedang dengan lateral reading, yang dibahas di bawah, dan beri tingkat rendah pembacaan ala editor.
- Perbaiki, lunakkan, atau buang. Jika Anda tidak bisa mengonfirmasi sebuah klaim dalam waktu yang sepantasnya, hapus atau atribusikan dengan jelas ("menurut vendor"). Jangan pernah mempertahankan klaim hanya karena kedengarannya benar.
- Simpan log. Satu baris per klaim tingkat tinggi, berisi klaim, sumber, dan di bagian mana dukungannya berada, hanya makan beberapa menit dan menjawab pertanyaan yang pada akhirnya akan diajukan editor, klien, atau hakim.
Sesuaikan upaya dengan sejauh mana output akan beredar. Brainstorming cukup dibaca dengan cermat. Hasil kerja untuk klien menuntut setiap klaim tingkat tinggi dibuka di sumbernya. Jika beban pemeriksaannya terlihat terlalu besar, kemungkinan drafnya memuat terlalu banyak klaim, dan memangkas sering lebih cepat daripada memverifikasi.
Tidak yakin output Anda masuk tingkat mana? Jawab hingga tiga pertanyaan di bawah ini.
Perhatikan apa yang ditanyakan pohon keputusan itu: ke mana output akan pergi dan apa isinya, bukan model mana yang menulisnya. Model yang lebih kuat menggeser peluang, tetapi tidak mengubah siapa yang harus bertanggung jawab atas kesalahan.
Cara memeriksa sitasi, kutipan, dan angka
Setiap jenis klaim punya uji cepatnya sendiri. Tidak ada yang butuh software khusus, hanya disiplin untuk keluar dari chatbot dan membuka sumber aslinya.
Sitasi
Periksa dulu apakah sitasinya ada. Cari judul, DOI, nomor perkara, atau URL di database atau mesin pencari yang Anda kendalikan, jangan pernah di chatbot yang menghasilkannya. Lalu periksa dukungannya: buka sumber dan temukan bagian yang menopang kalimat itu. Jika tidak ketemu dalam beberapa menit, sitasi itu gagal. Perhatikan juga versinya. Tow Center menemukan tool pencarian AI sering mengarah ke salinan sindikasi alih-alih penerbit aslinya, dan preprint bisa berbeda dari makalah yang diterbitkan.
Kutipan
Cari frasa khas sepanjang lima atau enam kata dalam tanda kutip. Jika tidak muncul di mana pun, atau hanya di halaman yang tampak ditulis mesin, anggap kutipan itu karangan. Jika nyata, baca paragraf di sekitarnya dan pastikan pembicara, tanggal, dan maknanya. Kutipan asli yang dicabut dari konteks bisa menyesatkan sama seperti kutipan palsu.
Angka
Hitung ulang apa pun yang bisa dihitung. Pastikan satuannya (persen atau poin persentase, bulanan atau tahunan, mata uang apa), tahunnya, dan penyebutnya. Jika draf menyebut sebuah angka berlipat dua, temukan kedua angkanya. Statistik tanpa sumber yang jelas tidak boleh masuk, semasuk akal apa pun tampaknya.
Peristiwa terbaru dan klaim viral
Periksa tanggal pada setiap sumber dan utamakan pemberitaan yang terbit setelah peristiwanya. Untuk klaim yang sudah beredar di internet, Fact Check Explorer dari Google mencari hasil cek fakta yang sudah terbit dan menunjukkan organisasi mana yang menilai klaim itu serta bagaimana penilaiannya. Anda juga bisa mengunggah gambar untuk melihat apakah gambar itu pernah diperiksa.
Sebelum menekan tombol publish, jalankan draf Anda melalui checklist ini. Empat item pertama dihitung dua kali lipat.
Pembobotannya mengikuti data pengadilan: sitasi fiktif, sumber yang disalahgambarkan, dan kutipan palsu mengisi sebagian besar database itu. Jika keempat kotak itu masih kosong, tidak ada item lain dalam daftar yang membuat draf aman untuk dikirim.
Lateral reading untuk klaim tanpa jejak sumber
Sebagian klaim datang tanpa sitasi yang bisa dibuka. Untuk itu, pinjam kebiasaan para fact-checker profesional. Kelompok Civic Online Reasoning dari Stanford, setelah mengamati para fact-checker bekerja, menyimpulkan bahwa "the best way to learn about a website is lateral reading": tinggalkan halamannya dan lihat apa kata sumber lain tentangnya, alih-alih mempelajari halaman itu sendiri.
Mike Caulfield mengubah kebiasaan itu menjadi rutinitas empat langkah bernama SIFT (Caulfield). Cocok sekali untuk jawaban AI, dengan satu penyesuaian: sumber yang Anda selidiki adalah chatbot ditambah tautan apa pun yang dipilihnya.
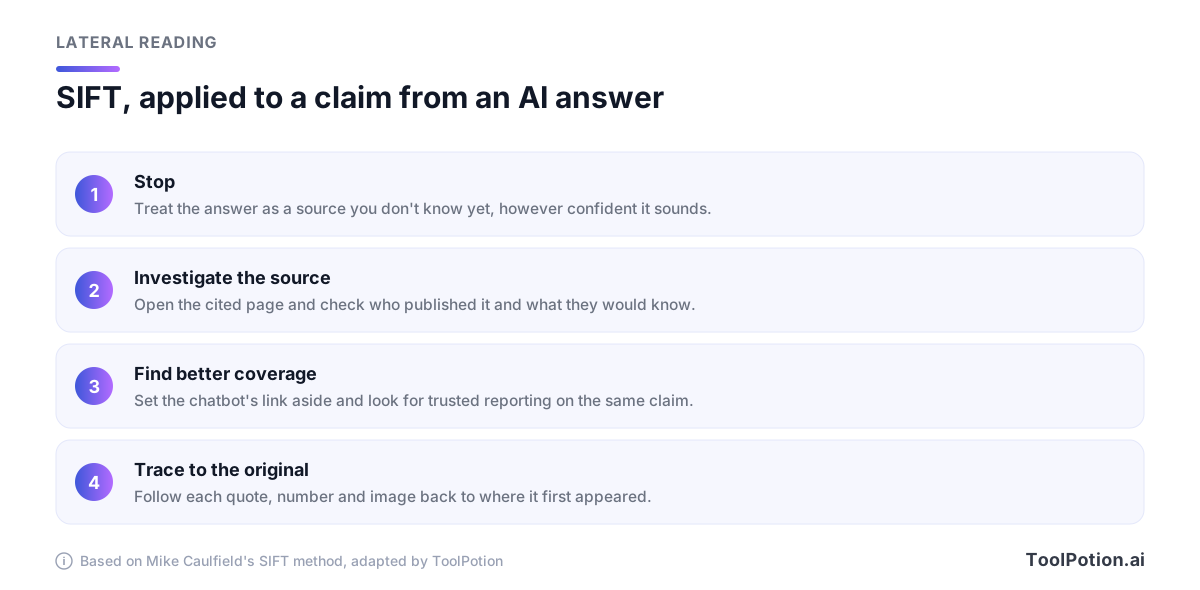
Langkah ketiga paling besar perannya dengan chatbot. Ketika klaim lebih penting daripada artikel yang membawanya, saran Caulfield adalah "ignore the source that reached you, and look for trusted reporting or analysis on the claim." Jadi cari klaimnya dari awal, dengan kata-kata Anda sendiri. Jika sesuatu yang seharusnya diliput luas ternyata tidak punya liputan independen, Anda sudah mendapat jawabannya.
Lateral reading juga menyelesaikan soal sumber yang ditemukan model sendiri. URL nyata di situs yang belum pernah Anda dengar adalah sumber yang lemah, serapi apa pun AI memformat referensinya.
Prompt yang membuat output lebih mudah diverifikasi
Anda tidak bisa menghilangkan halusinasi lewat prompt, tetapi Anda bisa membentuk output agar kesalahannya lebih mudah ditangkap. Dokumentasi resmi para vendor adalah panduan terbaik. Anthropic mengatakan teknik yang direkomendasikannya "significantly reduce hallucinations" tetapi "don't eliminate them entirely" (Anthropic docs). Untuk kebiasaan prompting yang lebih luas, lihat panduan praktis prompt engineering kami.
Beri izin untuk bilang tidak tahu
Anthropic dan Perplexity sama-sama meminta developer secara eksplisit mengizinkan model mengakui ketidakpastian atau melaporkan bahwa ia tidak menemukan apa-apa. Riset OpenAI menunjukkan mengapa ini penting. Dalam perbandingannya pada benchmark SimpleQA, model yang abstain pada 52% pertanyaan salah 26%, sedangkan model yang abstain pada 1% salah 75%, dengan akurasi yang nyaris sama. Pakai ini sebagai instruksi tetap:
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
Minta kutipan sebelum kesimpulan
Dokumentasi Anthropic menyarankan mengekstrak kutipan kata per kata dari dokumen panjang sebelum mengerjakan tugas, lalu meminta model mencari kutipan pendukung untuk setiap klaim sesudahnya dan menarik kembali klaim yang tidak bisa didukung. Dalam praktiknya seperti ini:
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
Minta model menandai kecocokan yang meleset, dan jangan paksa singkat
Panduan Perplexity menambahkan aturan yang layak dicontek: "If you find related but non-matching results (for example, a different year, a parent company, or a subsidiary), state the mismatch explicitly before answering." Itu menangkap fakta yang benar tentang entitas yang salah, salah satu kesalahan paling sulit dikenali dengan mata. Contoh aturannya juga menyuruh model mengutip sumber berdasarkan domain dan "not write full URLs."
Panjang jawaban juga berpengaruh. Giskard, perusahaan pengujian AI asal Paris, menemukan bahwa meminta GPT-4o, Mistral Large, dan Claude 3.7 Sonnet menjawab ringkas membuat mereka kurang akurat, karena "when forced to keep it short, models consistently choose brevity over accuracy." Studi yang sama menemukan model kurang mau membantah klaim kontroversial yang disampaikan pengguna dengan yakin. Rumuskan pertanyaan secara netral, "Benarkah X?", alih-alih mengasumsikan klaimnya, seperti pada "Jelaskan mengapa X."
Ekstrak klaim, lalu jalankan dua kali
Prompt ini menyuplai langkah pertama alur kerja. Jalankan pada draf apa pun, termasuk yang Anda tulis sendiri.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic juga menyarankan pemeriksaan best-of-N: jalankan prompt yang sama beberapa kali lalu bandingkan, karena jawaban yang tidak konsisten menandakan kemungkinan halusinasi. Ini gejala yang sama dengan yang dilihat OpenAI pada tiga judul disertasi tadi. Perbedaan antar-run menunjukkan di mana Anda harus melihat. Kesamaan tidak membuktikan apa pun.
Tool berbasis sumber membantu, sampai batas tertentu
Satu kelas tool yang berbeda membatasi apa yang boleh dipakai model. Itu mengubah "apakah ini benar?" menjadi "apakah sumber ini mengatakannya?", pemeriksaan yang lebih cepat. Namun pemeriksaannya tidak hilang.
Google mengganti nama NotebookLM menjadi Gemini Notebook awal tahun ini dan tetap mempertahankannya sebagai tool riset mandiri, yang menurut Google dipakai lebih dari 30 juta orang (Google). Dalam chat, ia menjawab dari sumber yang Anda tambahkan dan "uses direct quotes, text, and images from your sources as citations." Arahkan kursor ke sitasi untuk melihat teks yang dikutip, atau klik untuk melompat ke konteksnya (Gemini Notebook Help). Itu membuat pemeriksaan dukungan jadi cepat. Ketahui juga celahnya: halaman bantuan Google menyebut halaman web berpaywall tidak didukung dan catatan kaki serta komentar di file Google tidak diimpor. Fitur chat agentic yang lebih baru, yang bisa mencari di web dan menjalankan kode, diberi label eksperimental, dengan instruksi "Be sure to double check it."
Answer engine seperti Perplexity menyertakan tautan pada setiap jawaban, kemajuan nyata dibandingkan chatbot tanpa sumber. Tautannya tetap perlu dibuka. Perplexity salah pada 37% kueri dalam uji Tow Center 2025 (tool-nya sudah berubah sejak itu), dan bantuan Gemini dari Google sendiri mencatat bahwa "not all responses include related links or sources."
Untuk klaim riset, tool pencarian akademik mendasarkan jawaban pada makalah, bukan web terbuka. Consensus mencari literatur peer-reviewed dan menyatakan bahwa jika ia "can't find sufficient relevant evidence, it will tell you" alih-alih menambal celah. Elicit menyatakan mendukung setiap klaim buatan AI dengan sitasi tingkat kalimat. Scite menunjukkan apakah riset berikutnya mendukung atau membantah temuan sebuah makalah, sehingga menangkap kegagalan yang terlewat oleh yang lain: studi nyata yang kini sudah dibantah.
Jika Anda membangun pipeline sendiri, Citations API dari Anthropic mengembalikan bagian persis di balik setiap klaim, dan dokumentasi Anthropic menyebut sitasi itu "guaranteed to contain valid pointers to the provided documents." Itu menyingkirkan sumber karangan. Namun tidak memastikan bahwa bagian itu benar-benar mendukung kalimat yang ditempelinya. Reference checker berada di ujung rantai. GPTZero menawarkan pendeteksi halusinasi yang memindai daftar pustaka, dan timnya menandai laporan KPMG serta, awal tahun ini, menemukan 100 sitasi halusinasi di 51 makalah yang diterima di NeurIPS, konferensi AI terkemuka, lapor TechCrunch.
| Jenis tool | Jawaban berpijak pada | Yang tetap Anda periksa |
|---|---|---|
| Tool notebook (Gemini Notebook) | Sumber yang Anda unggah | Apakah tiap bagian yang dikutip mendukung klaimnya, dan apakah sumber Anda benar |
| Answer engine (Perplexity, ChatGPT dengan search) | Hasil web langsung | Buka setiap tautan, cek tanggalnya, dan temukan penerbit aslinya |
| Pencarian riset (Consensus, Elicit, Scite) | Makalah akademik | Temuan sebenarnya dari makalah, keterbatasannya, dan riset lanjutan yang membantahnya |
| API sitasi (Claude Citations) | Dokumen yang Anda sediakan | Dukungan terhadap klaim, di luar sekadar pointer yang valid |
| Reference checker (GPTZero) | Catatan bibliografi | Apakah referensi nyata benar-benar mengatakan seperti yang diklaim draf |
Untuk membandingkan pilihan, telusuri papan AI research assistant, papan mesin pencari AI, dan papan untuk mencari literatur akademik. Ulasan kami tentang AI research assistant dan mesin pencari AI membahas fitur dan harga lebih dalam.
Pertanyaan yang sering diajukan
Bisakah saya memakai satu model AI untuk memeriksa fakta model lain?
Sebagai penyaringan awal, bisa. Model kedua, terutama yang punya search, akan menandai sebagian kesalahan yang terlewat oleh model pertama, dan perbedaan jawaban menunjukkan di mana Anda harus melihat. Namun ia tidak bisa mengonfirmasi apa pun, karena keduanya mungkin punya celah yang sama. Anggap tanda darinya sebagai daftar tugas dan selesaikan tiap butir di sumbernya. Jika Anda sedang memilih asisten kedua, panduan alternatif ChatGPT kami membandingkan pilihan utamanya.
Apakah AI detector memeriksa fakta?
Tidak. Tool seperti Originality.ai detector memperkirakan apakah teks ditulis mesin. Itu tidak mengatakan apa pun tentang benar tidaknya sebuah klaim, dan draf tulisan manusia pun bisa sama kelirunya. Fact-checking membutuhkan sumber aslinya.
Berapa lama waktu yang pantas untuk memeriksa fakta draf AI?
Tergantung berapa banyak klaim berisiko tinggi dalam draf, bukan panjangnya. Hitung setelah triase. Penjelasan 2.000 kata dengan empat statistik dan dua kutipan adalah pekerjaan singkat, sedangkan memo satu halaman yang penuh sitasi bukan.
Bisakah saya mengutip ChatGPT atau chatbot lain sebagai sumber?
Tidak untuk fakta. Saran OpenAI sendiri adalah "use ChatGPT as a first draft, not a final source." Kutip dokumen dasar yang sudah Anda verifikasi. Jika output AI itu sendiri yang menjadi subjeknya, seperti dalam pengujian model, sebutkan model apa yang Anda pakai dan kapan.
Apakah agen deep research membuat pemeriksaan jadi tidak perlu?
Tidak. Agen seperti deep research OpenAI menyusun laporan riset bersitasi dari banyak sumber web, yang memberi Anda lebih banyak sitasi untuk dibuka, bukan lebih sedikit klaim untuk diperiksa. Masalah sumber yang disalahgambarkan berlaku untuk setiap kalimat bersitasi, jadi langkah triase makin penting seiring laporan yang makin panjang.