

Perplexity adalah asisten riset AI terbaik untuk kebanyakan orang di 2026, dan NotebookLM adalah pilihan saat jawabannya harus berasal dari file Anda sendiri. Di luar keduanya, pilihan yang tepat bergantung pada apa yang Anda teliti: makalah ilmiah, pertanyaan klinis, tumpukan PDF, atau web terbuka. Leaderboard di bawah merangking 25 teratas, dan panduan ini membahas yang layak Anda luangkan waktu untuknya.
Kategori ini terlihat ramai, tetapi sebenarnya terbagi dengan rapi. Ada tool yang menelusuri web. Ada yang hanya membaca apa yang Anda berikan. Ada yang mencari literatur akademik, dan satu nama besar dibuat khusus untuk klinisi. Yang membedakan pilihan bagus dari pilihan berisiko sama di mana pun: Anda perlu melihat dari mana setiap klaim berasal, dan Anda harus bisa memeriksanya.
Pertanyaan itu mewarnai semua pembahasan di bawah. Sitasi adalah produk utamanya di sini, dan sitasi bisa salah.
25 teratas saat ini
- # 1Pilihan TeratasPerplexity — Mesin Jawaban AIAplikasi AIPerplexity adalah mesin jawaban bertenaga AI gratis yang memberikan jawaban yang akurat, terpercaya, dan real-time untuk setiap pertanyaan, menjadikan pengambilan informasi efisien dan sederhana.92ToolRankElite
- # 2Posisi KeduaNotebookLMAplikasi SelulerNotebookLM adalah asisten penelitian AI yang dipersonalisasi yang membantu pengguna memahami topik apa pun. Ini menawarkan antarmuka yang ramah pengguna dan fitur-fitur canggih untuk meningkatkan produktivitas dan memperlancar proses penelitian.74ToolRankKuat
- # 3Posisi KetigaOpenEvidenceAplikasi AIOpenEvidence adalah platform pengetahuan medis resmi Amerika, dirancang untuk profesional kesehatan. Ini menyediakan jawaban berbasis bukti yang didasarkan pada penelitian yang telah ditinjau sejawat dari jurnal medis terkemuka, meningkatkan pengambilan keputusan klinis di titik perawatan.73ToolRankKuat
- 4OpenAI PrismAplikasi AIOpenAI Prism adalah editor LaTeX gratis dan ruang kerja berbasis AI yang dirancang untuk ilmuwan. Ini mengintegrasikan ChatGPT dan Codex untuk meningkatkan penulisan dan kolaborasi ilmiah, menyediakan pemeriksaan tata bahasa, pengelolaan kutipan, dan pemformatan yang dibantu AI.64ToolRankKuat
- 5SciSpace AI untuk PenelitianAplikasi AISciSpace adalah asisten penelitian berbasis AI yang dirancang untuk akademisi, memungkinkan tinjauan literatur sistematis pada lebih dari 280 juta makalah dan membantu dalam penulisan makalah dengan sumber yang dikutip. Dipercaya oleh jutaan mahasiswa, PhD, dan peneliti di seluruh dunia.62ToolRankKuat
- 6Google PinpointAplikasi AIGoogle Pinpoint membantu jurnalis dengan cepat menemukan cerita penting dalam koleksi besar PDF, dokumen tulisan tangan, gambar, arsip email, dan file audio menggunakan AI dan pembelajaran mesin.61ToolRankKuat
- 7ConsensusAplikasi AIConsensus adalah mesin pencari akademik bertenaga AI yang menganalisis literatur tinjauan sejawat untuk mempercepat riset. Ini membantu pengguna menemukan, mengatur, dan menganalisis makalah ilmiah 10x lebih cepat, mengubah tinjauan literatur dari berhari-hari menjadi hitungan menit. Platform ini mendukung penyelidikan akademik yang ketat dengan kemampuan pemfilteran dan peringkasan tingkat lanjut.61ToolRankKuat
- 8Westlaw Precision AIAplikasi AIWestlaw Precision AI adalah alat penelitian hukum canggih yang memanfaatkan AI dan konten terpercaya untuk memberikan wawasan tingkat ahli dengan cepat. Ini membantu profesional hukum bergerak dengan percaya diri dari penelitian ke strategi, memastikan hasil yang komprehensif dan dapat diverifikasi.60ToolRankKuat
- 9ElicitAplikasi AIElicit adalah asisten riset bertenaga AI yang membantu ilmuwan dan peneliti menemukan, meringkas, dan mengekstrak data dari lebih dari 138 juta makalah akademis. Ini mengotomatiskan tinjauan literatur sistematis, menghasilkan laporan penelitian, dan menyediakan kutipan tingkat kalimat untuk akurasi, memungkinkan penemuan yang lebih cepat dan pengambilan keputusan berbasis bukti di berbagai industri.60ToolRankKuat
- 10Gemini NotebookAplikasi AIGemini Notebook adalah buku catatan penelitian AI yang berbasis sumber dari Google, dirancang untuk ringkasan cepat dan pencatatan. Ini berfungsi sebagai asisten penelitian virtual, memberikan informasi dan wawasan yang dapat diandalkan.59ToolRankSolid
- 11PatSnap AI Innovation PlatformAplikasi AIPatSnap adalah platform yang didorong oleh AI yang menawarkan pencarian paten, penyusunan, pemantauan, dan analisis IP. Ini mempercepat produktivitas R&D hingga 75% menggunakan lebih dari 2 miliar titik data ahli, dipercaya oleh lebih dari 15.000 inovator di seluruh dunia.58ToolRankSolid
- 12Semantic ScholarAplikasi AISemantic Scholar adalah alat riset gratis yang didukung AI yang dirancang untuk membantu para sarjana menemukan literatur ilmiah yang relevan. Alat ini memanfaatkan AI dan rekayasa canggih untuk memahami semantik makalah penelitian, sehingga lebih mudah untuk menemukan dan berinteraksi dengan konten akademik di semua bidang ilmiah. Platform ini bertujuan untuk meningkatkan aksesibilitas dan konteks riset.57ToolRankSolid
- 13Platform Tinjauan AI RayyanAplikasi AIRayyan adalah platform bertenaga AI yang dirancang untuk mempercepat tinjauan sistematis dan literatur bagi para peneliti. Platform ini mengotomatiskan tugas-tugas utama seperti penyaringan, deduplikasi, dan ekstraksi data, memungkinkan tim untuk mensintesis bukti dengan lebih cepat dan efisien. Dipercaya oleh lebih dari satu juta peneliti secara global, Rayyan menyederhanakan seluruh alur kerja tinjauan.56ToolRankSolid
- 14Readwise ReaderAplikasi AIReadwise Reader adalah aplikasi baca-nanti yang komprehensif dirancang untuk pembaca yang serius. Aplikasi ini mengonsolidasikan artikel, PDF, dan lainnya dalam satu tempat, menawarkan fitur pencarian dan penyorotan yang kuat.55ToolRankSolid
- 15ResearchRabbitAplikasi AIResearchRabbit menyederhanakan tinjauan literatur dengan membantu peneliti menemukan makalah terkait, membangun peta kutipan, dan melacak tren penelitian. Ini mengubah eksplorasi literatur akademik dari tugas yang membosankan menjadi proses penemuan yang didorong oleh rasa ingin tahu, menghemat waktu berharga bagi akademisi dan mahasiswa.55ToolRankSolid
- 16SciteAplikasi AIScite adalah alat AI yang mencari lebih dari 300 juta artikel ilmiah untuk memberikan jawaban yang didukung kutipan. Ini membantu peneliti memahami kekuatan bukti di balik klaim, menjadikan pencarian literatur lebih efisien dan dapat diandalkan.55ToolRankSolid
- 17HebbiaAplikasi AIHebbia adalah platform AI yang dirancang untuk profesional keuangan, menawarkan kecerdasan institusional untuk mendukung keputusan berisiko tinggi. Platform ini terhubung ke sumber data keuangan, memungkinkan pengguna untuk menganalisis dokumen, mengungkap wawasan, dan mengotomatiskan alur kerja. Dipercaya oleh lembaga keuangan terkemuka, Hebbia bertujuan untuk meningkatkan kecepatan dan memengaruhi proses investasi.53ToolRankSolid
- 18LinerAplikasi AILiner adalah alat bertenaga AI yang dirancang untuk meningkatkan penjelajahan web dan riset. Alat ini memungkinkan pengguna untuk menyorot, mengatur, dan menyimpan konten dari halaman web, menciptakan basis pengetahuan yang dipersonalisasi. Platform ini bertujuan untuk menyederhanakan penemuan dan retensi informasi bagi siswa, peneliti, dan profesional yang ingin mengelola data online secara efisien.53ToolRankSolid
- 19Database ScopusAplikasi AIScopus adalah database abstrak dan kutipan yang komprehensif yang memberikan akses ke literatur ilmiah, teknis, medis, dan ilmu sosial. Ini menawarkan alat pencarian canggih dan metrik untuk peneliti untuk mengidentifikasi tren, menemukan kolaborator, dan mengukur dampak penelitian.53ToolRankSolid
- 20ScholarcyAplikasi AIScholarcy menyederhanakan penelitian dengan merangkum makalah, artikel, dan buku teks menjadi kartu flash interaktif. Ini membantu pengguna memahami penelitian yang kompleks dan mengatur pengetahuan mereka dengan efisien.53ToolRankSolid
- 21Dimensions AIAplikasi AIDimensions AI adalah basis data penelitian komprehensif yang menghubungkan hibah, publikasi, dataset, uji klinis, paten, dan dokumen kebijakan. Ini menyediakan alat untuk analisis penelitian, memungkinkan pengguna untuk dengan cepat menavigasi dan menginterpretasikan data penelitian global untuk wawasan strategis.52ToolRankSolid
- 22InstrumentlAplikasi AIInstrumentl adalah platform manajemen hibah yang didukung AI yang membantu organisasi nirlaba menemukan, memenangkan, dan mengelola hibah dengan efisien. Ini menawarkan database komprehensif, pencocokan berbasis AI, dan alat untuk penulisan proposal serta manajemen pasca-hibah, semuanya dalam satu ruang kerja.51ToolRankSolid
- 23GPT ResearcherRepo GitHubGPT Researcher adalah agen otonom yang dirancang untuk penelitian mendalam tentang topik apa pun, menghasilkan laporan terperinci, faktual, dan tidak memihak dengan kutipan. Ia menggunakan agen perencana dan eksekusi untuk menghasilkan pertanyaan penelitian dan mengumpulkan informasi. Alat ini menawarkan opsi penyesuaian dan mendukung berbagai format file untuk penelitian lokal.51ToolRankSolid
- 24Connected PapersAplikasi AIConnected Papers adalah alat visual yang dirancang untuk peneliti dan ilmuwan terapan untuk menemukan dan menjelajahi makalah akademis yang relevan dengan pekerjaan mereka. Alat ini menghasilkan grafik interaktif dari makalah serupa, membantu pengguna mendapatkan pemahaman visual tentang tren, karya populer, dan dinamika dalam suatu bidang, memastikan tidak ada penelitian penting yang terlewat.51ToolRankSolid
- 25Atlas.tiAplikasi AIAtlas.ti adalah perangkat lunak terkemuka untuk analisis data kualitatif, menawarkan alat berbasis AI untuk peneliti, mahasiswa, dan bisnis. Ini mendukung berbagai format data dan menyediakan fitur intuitif untuk analisis dan kolaborasi yang efisien.50ToolRankSolid





Cara kerja ToolRank
ToolRank adalah mesin pemeringkatan milik ToolPotion sendiri.
ToolRank terus menilai ratusan sinyal dari seluruh web terbuka — lalu lintas nyata dan popularitas, kekuatan audiens dan komunitas, otoritas dan ketahanan, adopsi dan keterlibatan — serta memproses jutaan titik data untuk menempatkan setiap alat di posisi yang pantas ia dapatkan.
Setiap jenis AI diukur dengan model khususnya sendiri: bukti daya tarik sebuah aplikasi SaaS tidak sama dengan bukti untuk framework open source atau kanal kreator. Tidak hadir di suatu platform tidak pernah merugikan sebuah alat — ToolRank menilai bukti yang ada.
Tanpa posisi berbayar. Tanpa angka klaim sendiri.
Pilihan cepat
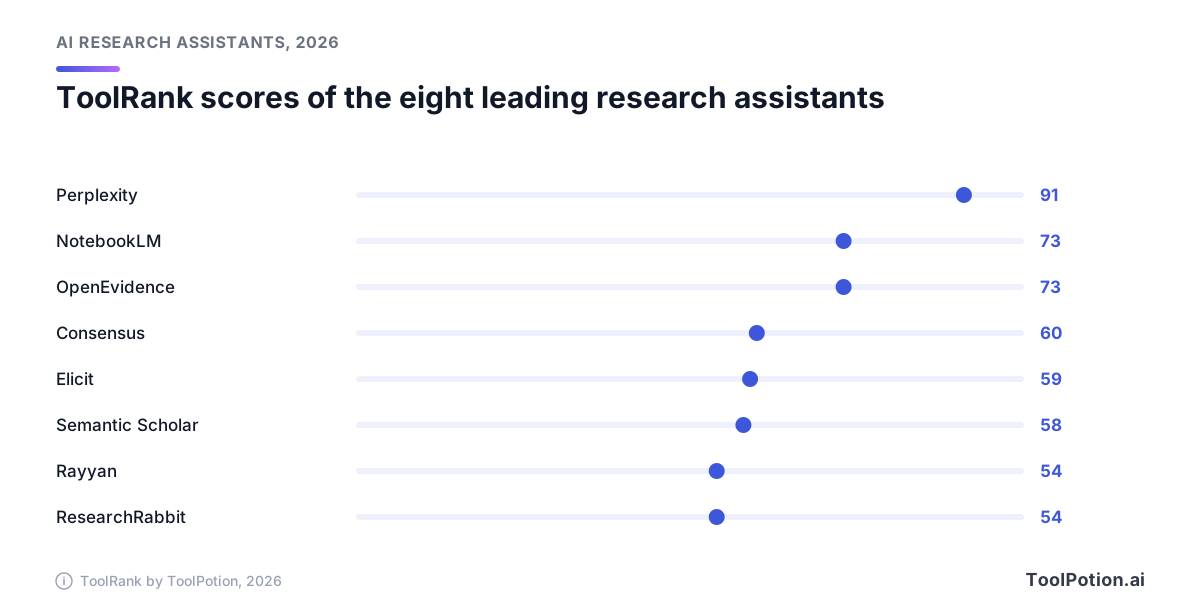
- Terbaik secara keseluruhan adalah Perplexity, yang menempati #1 di board 2026 dengan ToolRank tingkat elite 91, unggul 18 poin dari peringkat berikutnya.
- Terbaik untuk dokumen Anda sendiri adalah NotebookLM, kini bernama Gemini Notebook, karena hanya menjawab dari sumber yang Anda unggah dan tidak dari yang lain.
- Untuk literatur akademik, Consensus cocok untuk membaca cepat apa kata studi-studi yang ada, sedangkan Elicit unggul dalam mengekstrak data dari makalah.
- Semantic Scholar adalah opsi ilmiah gratis terbaik, dan pembuatnya adalah lembaga nirlaba.
- Klinisi sebaiknya melirik OpenEvidence, yang dibuat untuk pertanyaan medis.
- Siapa pun yang menjalankan systematic review sebaiknya mulai dengan Rayyan, yang menangani pekerjaan penyaringan yang melelahkan.
Itulah para pemimpin di board Top 100 AI Research Assistants. Grafik di bawah menunjukkan betapa rapatnya persaingan di papan tengah, dan seberapa jauh Perplexity berada di atasnya.
Apa yang berubah di 2026
Google mengganti nama NotebookLM menjadi Gemini Notebook pada 2026. Menurut Google, ini tetap produk mandiri yang sama, kini dengan komputer cloud aman yang menjalankan kode terhadap sumber Anda, dan mereka melaporkan lebih dari 30 juta pengguna (Google). Listing di board kami masih memakai nama NotebookLM. NotebookLM juga mencatat lonjakan terbesar di antara para pemimpin, naik dari #10 ke #2 di board 2026.
OpenEvidence tetap gratis untuk tenaga medis, dibiayai iklan dari perusahaan farmasi dan pihak lain. CEO-nya pernah menyatakan ingin mengubah model itu (NBC News). Belum ada yang menjelaskan siapa yang akan membayar sebagai gantinya.
Perubahan yang kurang menggembirakan terjadi di sisi makalah. Awal tahun ini arXiv mulai menjatuhkan larangan submit selama satu tahun kepada penulis yang makalahnya menunjukkan output AI yang tidak diperiksa, termasuk referensi halusinasi (SMU Libraries). Kalau Anda mengutipnya, Anda yang bertanggung jawab. Itulah standar baru sekarang.
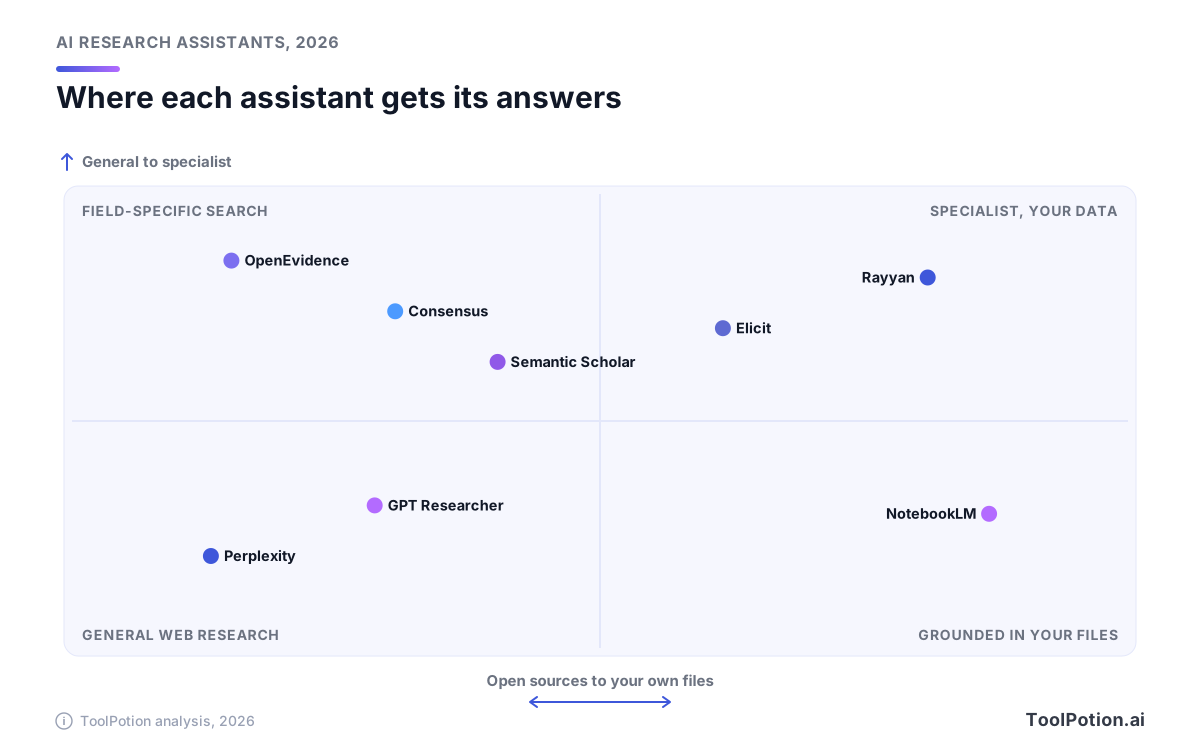
Peta di bawah mengelompokkan bidang ini berdasarkan dari mana setiap tool mendapatkan jawabannya dan seberapa spesialis cakupannya.
Masalah kepercayaan adalah masalah sitasi
Jawaban yang berpijak pada sumber dibangun dalam lima langkah, dan kesalahan bisa menyelinap di setiap langkahnya.
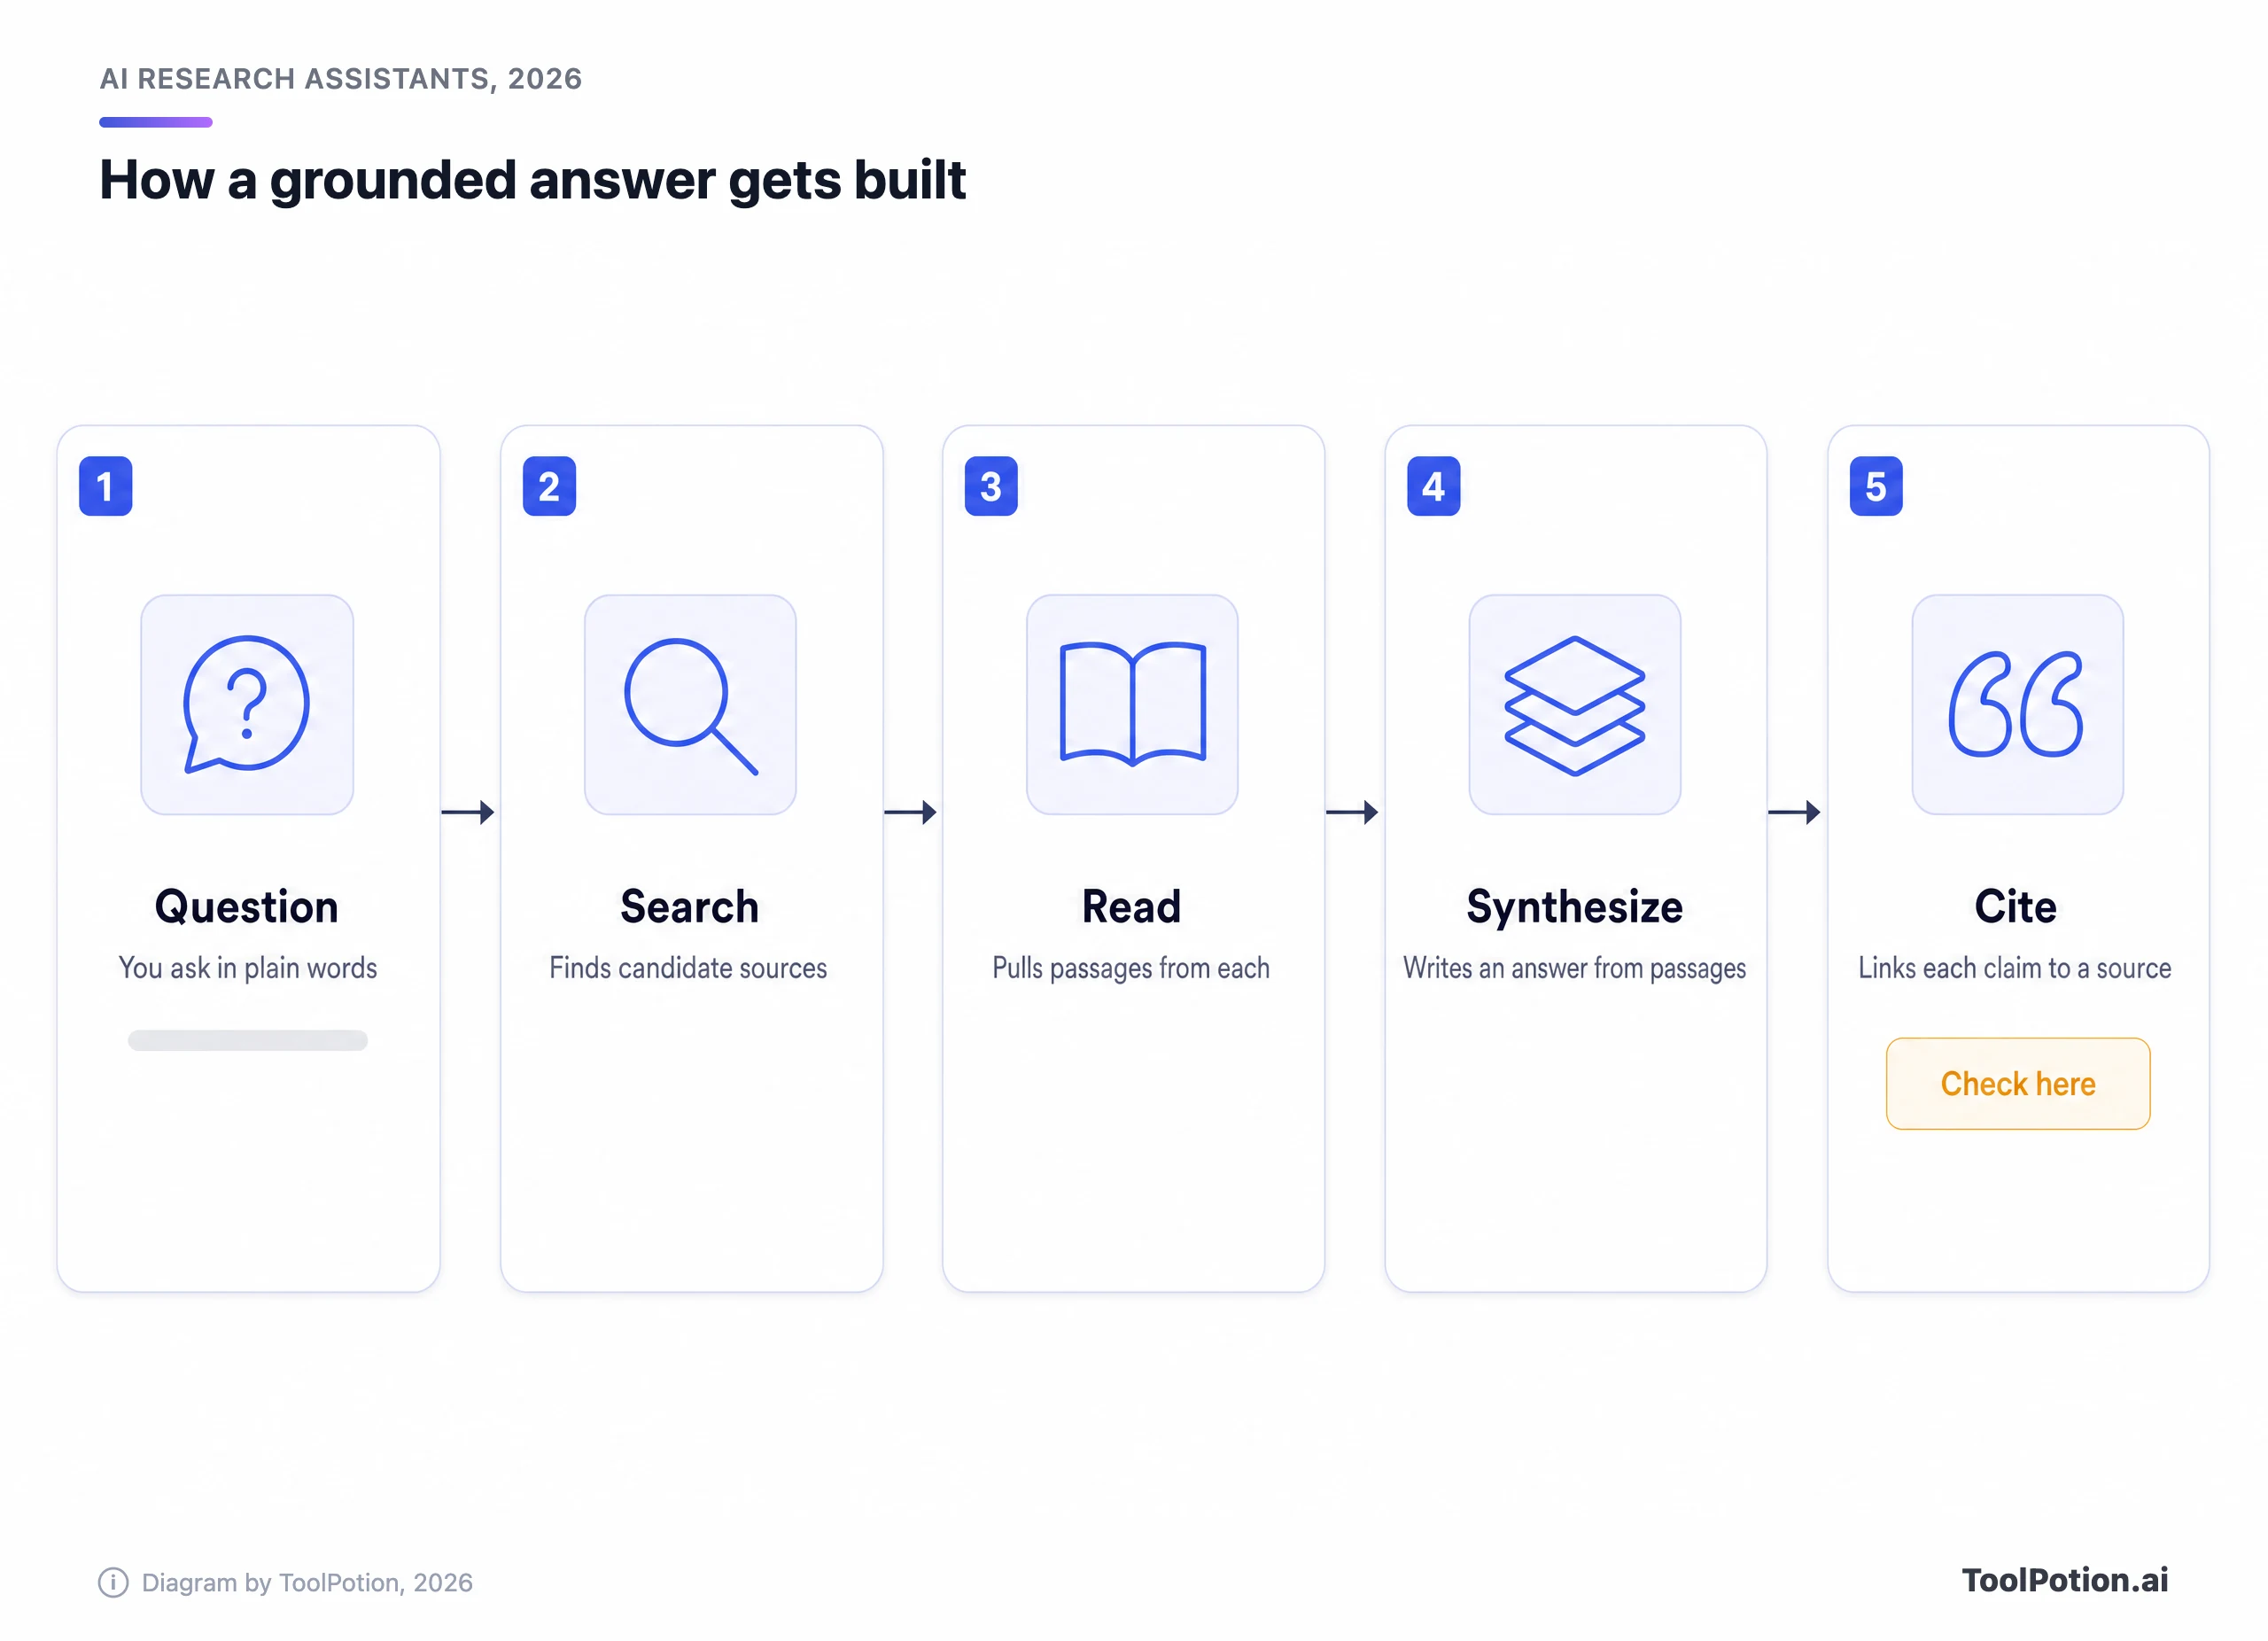
Pencarian bisa melewatkan makalah kunci. Pembacaan bisa berhenti di abstrak. Tahap penulisan bisa melenceng dari isi kutipan. Dan langkah terakhir bisa menempelkan tautan asli pada klaim yang tidak didukungnya. Tes pustakawan di HKUST menemukan bahwa Scite mengambil teks lengkap, sementara tool lain kebanyakan hanya menampilkan abstrak (HKUST Library).
Audit yang paling terkenal datang dari Tow Center Columbia. Mereka memberi delapan mesin pencari AI kutipan dari artikel berita dan meminta masing-masing mengidentifikasi judul, penerbit, tanggal, dan URL-nya. Secara kolektif mereka salah menjawab lebih dari 60% kueri. Perplexity paling baik dengan tingkat kesalahan 37%, tetapi tier berbayar Perplexity dan Grok justru lebih yakin dalam kesalahannya dibanding tier gratis, dan beberapa tool mengutip tautan rekayasa atau rusak (Columbia Journalism Review). Tes itu mengukur seberapa baik mesin mengatribusikan kutipan berita, bukan cara mereka mengutip makalah ilmiah. Anggap ini peringatan soal rasa percaya diri, bukan vonis untuk satu tool tertentu.
Untuk makalah, bukti paling tajam justru soal chatbot biasa, dan itulah alasan mengapa grounding penting. Peneliti Deakin University meminta GPT-4o menulis enam tinjauan literatur tentang topik kesehatan mental. Dari sitasi yang dihasilkannya, 19,9% adalah rekayasa, dan 45,4% dari yang asli memuat kesalahan seperti DOI yang keliru (EurekAlert). Polanya yang berguna. Tingkat rekayasa hanya 6% pada depresi, topik yang banyak diteliti, dan 28% sampai 29% pada dua topik yang kurang tercakup.
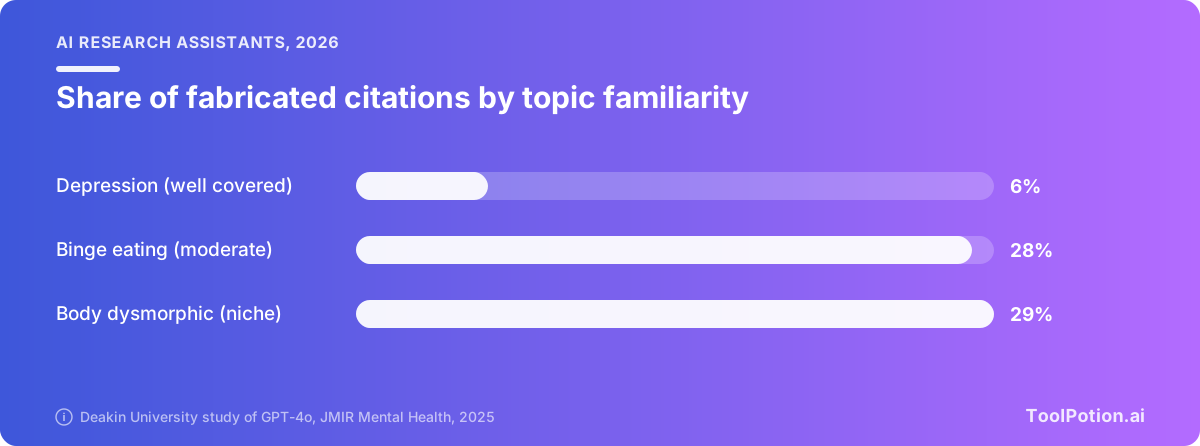
Asisten riset khusus memang lebih baik, tetapi tidak sempurna. Dalam tes HKUST, Scite, Elicit, Consensus, dan Scopus AI semuanya mengembalikan sitasi asli untuk pertanyaan tentang tidur dan kenaikan berat badan. Mencocokkan setiap argumen dengan sumbernya adalah soal lain, dan Scopus AI paling lemah, dengan argumen yang tidak didukung sumbernya. Para pustakawan menyebut hasilnya titik awal, bukan pengganti tinjauan literatur. Itu hanya satu pertanyaan pada topik yang sudah banyak diteliti, jadi harapkan hasil yang lebih kasar pada topik niche.
Jadi aturan mainnya sederhana. Buka sumbernya sebelum Anda memakai klaimnya. Jalankan ulang apa pun yang penting. Dan uji tool baru pada subjek yang sudah Anda kuasai betul.
Para pemimpin, diulas
Perplexity: terbaik untuk jawaban bersitasi yang cepat dari web terbuka
Perplexity menempati #1 di board 2026 dengan ToolRank tingkat elite 91, satu-satunya skor elite di sana. Ia menelusuri web dan menampilkan sumbernya di samping jawaban, sehingga putaran pertama jadi cepat dan putaran kedua mudah. Kekurangannya sama dengan temuan Tow Center: ia paling sedikit salah di antara delapan mesin, tetapi tetap salah 37% ketika diminta mengatribusikan kutipan berita, yang berbeda dari tugas mengutip makalah. Pro menambahkan pengalih model dan riset yang lebih mendalam seharga $20 per bulan, sedangkan Max $200, menurut panduan harga 2026 dari CloudZero, dan ada juga tier gratis.
NotebookLM: terbaik saat jawaban harus berasal dari file Anda
NotebookLM berada di #2 dengan skor 73, tier strong. Anda mengunggah makalah, catatan, atau transkrip dan ia menjawab hanya dari itu, sehingga ruang untuk fakta karangan mengecil. Sisi sebaliknya, ia tidak bisa memberi tahu apa yang lupa Anda tambahkan. Paket gratis mengizinkan 100 notebook, 50 sumber per notebook, dan 50 chat per hari, dan paket Google AI berbayar menaikkan batas tersebut (Google Help). Untuk folder skripsi atau setumpuk laporan, inilah yang paling pas di board.
OpenEvidence: terbaik untuk klinisi yang memeriksa literatur
OpenEvidence ada di #3, juga bernilai 73 dan juga tier strong, dan satu-satunya spesialis medis di dekat puncak. Ia menjawab pertanyaan klinis dari jurnal peer-reviewed dan gratis untuk tenaga medis. Bukti soal akurasinya masih tipis. Sebuah preprint yang menguji 100 skenario subspesialisasi dari dataset ujian board MedXpertQA menemukan akurasi paling tinggi 34% pada pencarian cepatnya dan 41% pada Deep Consult, dan para penulis berargumen bahwa pengawasan ahli tetap esensial (medRxiv). Itu preprint, dan soalnya sulit. Tetap saja, tool seperti ini tidak menggantikan klinisi, dan tak seorang pun boleh memakainya sebagai pengganti dokter.
Consensus: terbaik untuk membaca cepat apa kata studi-studi
Consensus ada di #4 dengan skor 60, tier strong, naik dari #6 di board 2026. Ia menelusuri makalah akademik, sehingga pertanyaan ya-atau-tidak dijawab dengan ringkasan studi, bukan tumpukan halaman web. Dalam tes HKUST, ia menghasilkan ringkasan panjang dan terstruktur dengan sekitar sepuluh sitasi masing-masing. Cek halaman harga resminya untuk paket terkini sebelum Anda berlangganan.
Elicit: terbaik untuk mengekstrak data dari banyak makalah
Elicit ada di #5, naik dari #8, dengan skor tier solid 59. Keunggulannya adalah ekstraksi: Anda membuat tabel makalah lalu menanyakan detail yang sama dari tiap makalah, seperti ukuran sampel atau hasil. Paket Basic gratis menelusuri 138 juta makalah. Pro seharga $49 per bulan ($588 per tahun) dan menambahkan alur kerja systematic review yang bisa menyaring 5.000 makalah, sedangkan Scale $169 (harga Elicit). Lompatan dari gratis ke $49 cukup curam, dan fitur-fitur serius ada di baliknya.
Semantic Scholar: terbaik untuk pencarian ilmiah gratis
Semantic Scholar ada di #6 dengan skor 58, turun dari #4 di board 2026. Ia mesin pencari dulu, asisten kemudian, dibuat oleh lembaga nirlaba Allen Institute for AI. Ia mengindeks lebih dari 200 juta makalah dan tidak dipungut biaya (Semantic Scholar). Tidak ada jendela chat yang berpikir menggantikan Anda. Bagi banyak mahasiswa, itu justru nilai plus.
Rayyan: terbaik untuk penyaringan systematic review
Rayyan ada di #8 dengan skor 54. Tim memakainya untuk menyaring ribuan judul dan abstrak berdasarkan kriteria inklusi, dengan AI menyarankan mana yang kemungkinan relevan. Paket gratis mencakup 3 review aktif dan 2 reviewer gratis, dan Essential mulai dari $4,99 per bulan dengan penagihan tahunan (Rayyan). Ini tool alur kerja, jadi jangan berharap ada kotak pertanyaan yang menuliskan jawaban untuk Anda.
ResearchRabbit: terbaik untuk memetakan suatu bidang dari beberapa makalah awal
ResearchRabbit naik dari #16 ke #9 dengan skor 54. Anda mulai dari makalah yang Anda percaya, lalu ia membangun koleksi dan peta sitasi dari karya terkait. Ia menemukan makalah. Ia tidak merangkumnya. Padukan dengan tool membaca dan ia layak dipakai di awal proyek, saat Anda belum tahu seperti apa bidang itu.
Scite: terbaik untuk melihat apakah makalah-makalah berikutnya mendukung suatu klaim
Scite ada di #10 dengan skor 54. Smart Citations-nya menunjukkan apakah karya-karya berikutnya mendukung atau membantah suatu makalah, konteks yang disembunyikan oleh jumlah sitasi mentah. Dalam perbandingan HKUST, ringkasannya paling komprehensif dari keempat tool, dan hanya ia yang mengambil teks lengkap. Pencarian dan asistennya ada di balik paket berbayar, mulai $20 per bulan dengan penagihan tahunan (harga Scite). Coba saat sebuah klaim cukup penting sehingga Anda ingin tahu siapa yang pernah membantahnya.
GPT Researcher: opsi open-source terbaik untuk riset web mendalam
GPT Researcher ada di #17 dengan skor 50, satu-satunya proyek open-source di 25 teratas. Agen perencana menulis pertanyaan riset, agen lain mengumpulkan materi, dan agen penerbit menyusun laporan bersitasi. Proyek ini berlisensi Apache-2.0 dan memiliki sekitar 29.900 bintang GitHub (GitHub). Anda menjalankannya sendiri dan menyediakan modelnya, jadi lebih cocok untuk developer dan tinkerer daripada mahasiswa yang dikejar tenggat.
Tiga lagi masuk peringkat tetapi belum diberi skor. Scopus Database (#7) adalah database sitasi, Readwise Reader (#11) adalah aplikasi baca-nanti, dan Atlas.ti (#15) untuk analisis kualitatif. Ketiganya berguna, tetapi jenisnya berbeda dari yang lain, itulah sebabnya mereka tidak masuk di grafik di atas.
Cara memilih
Mulailah dari jenis riset yang Anda lakukan, karena itu menentukan sebagian besar keputusan. Harga nomor dua, dan kemewahan tampilan tool paling akhir.
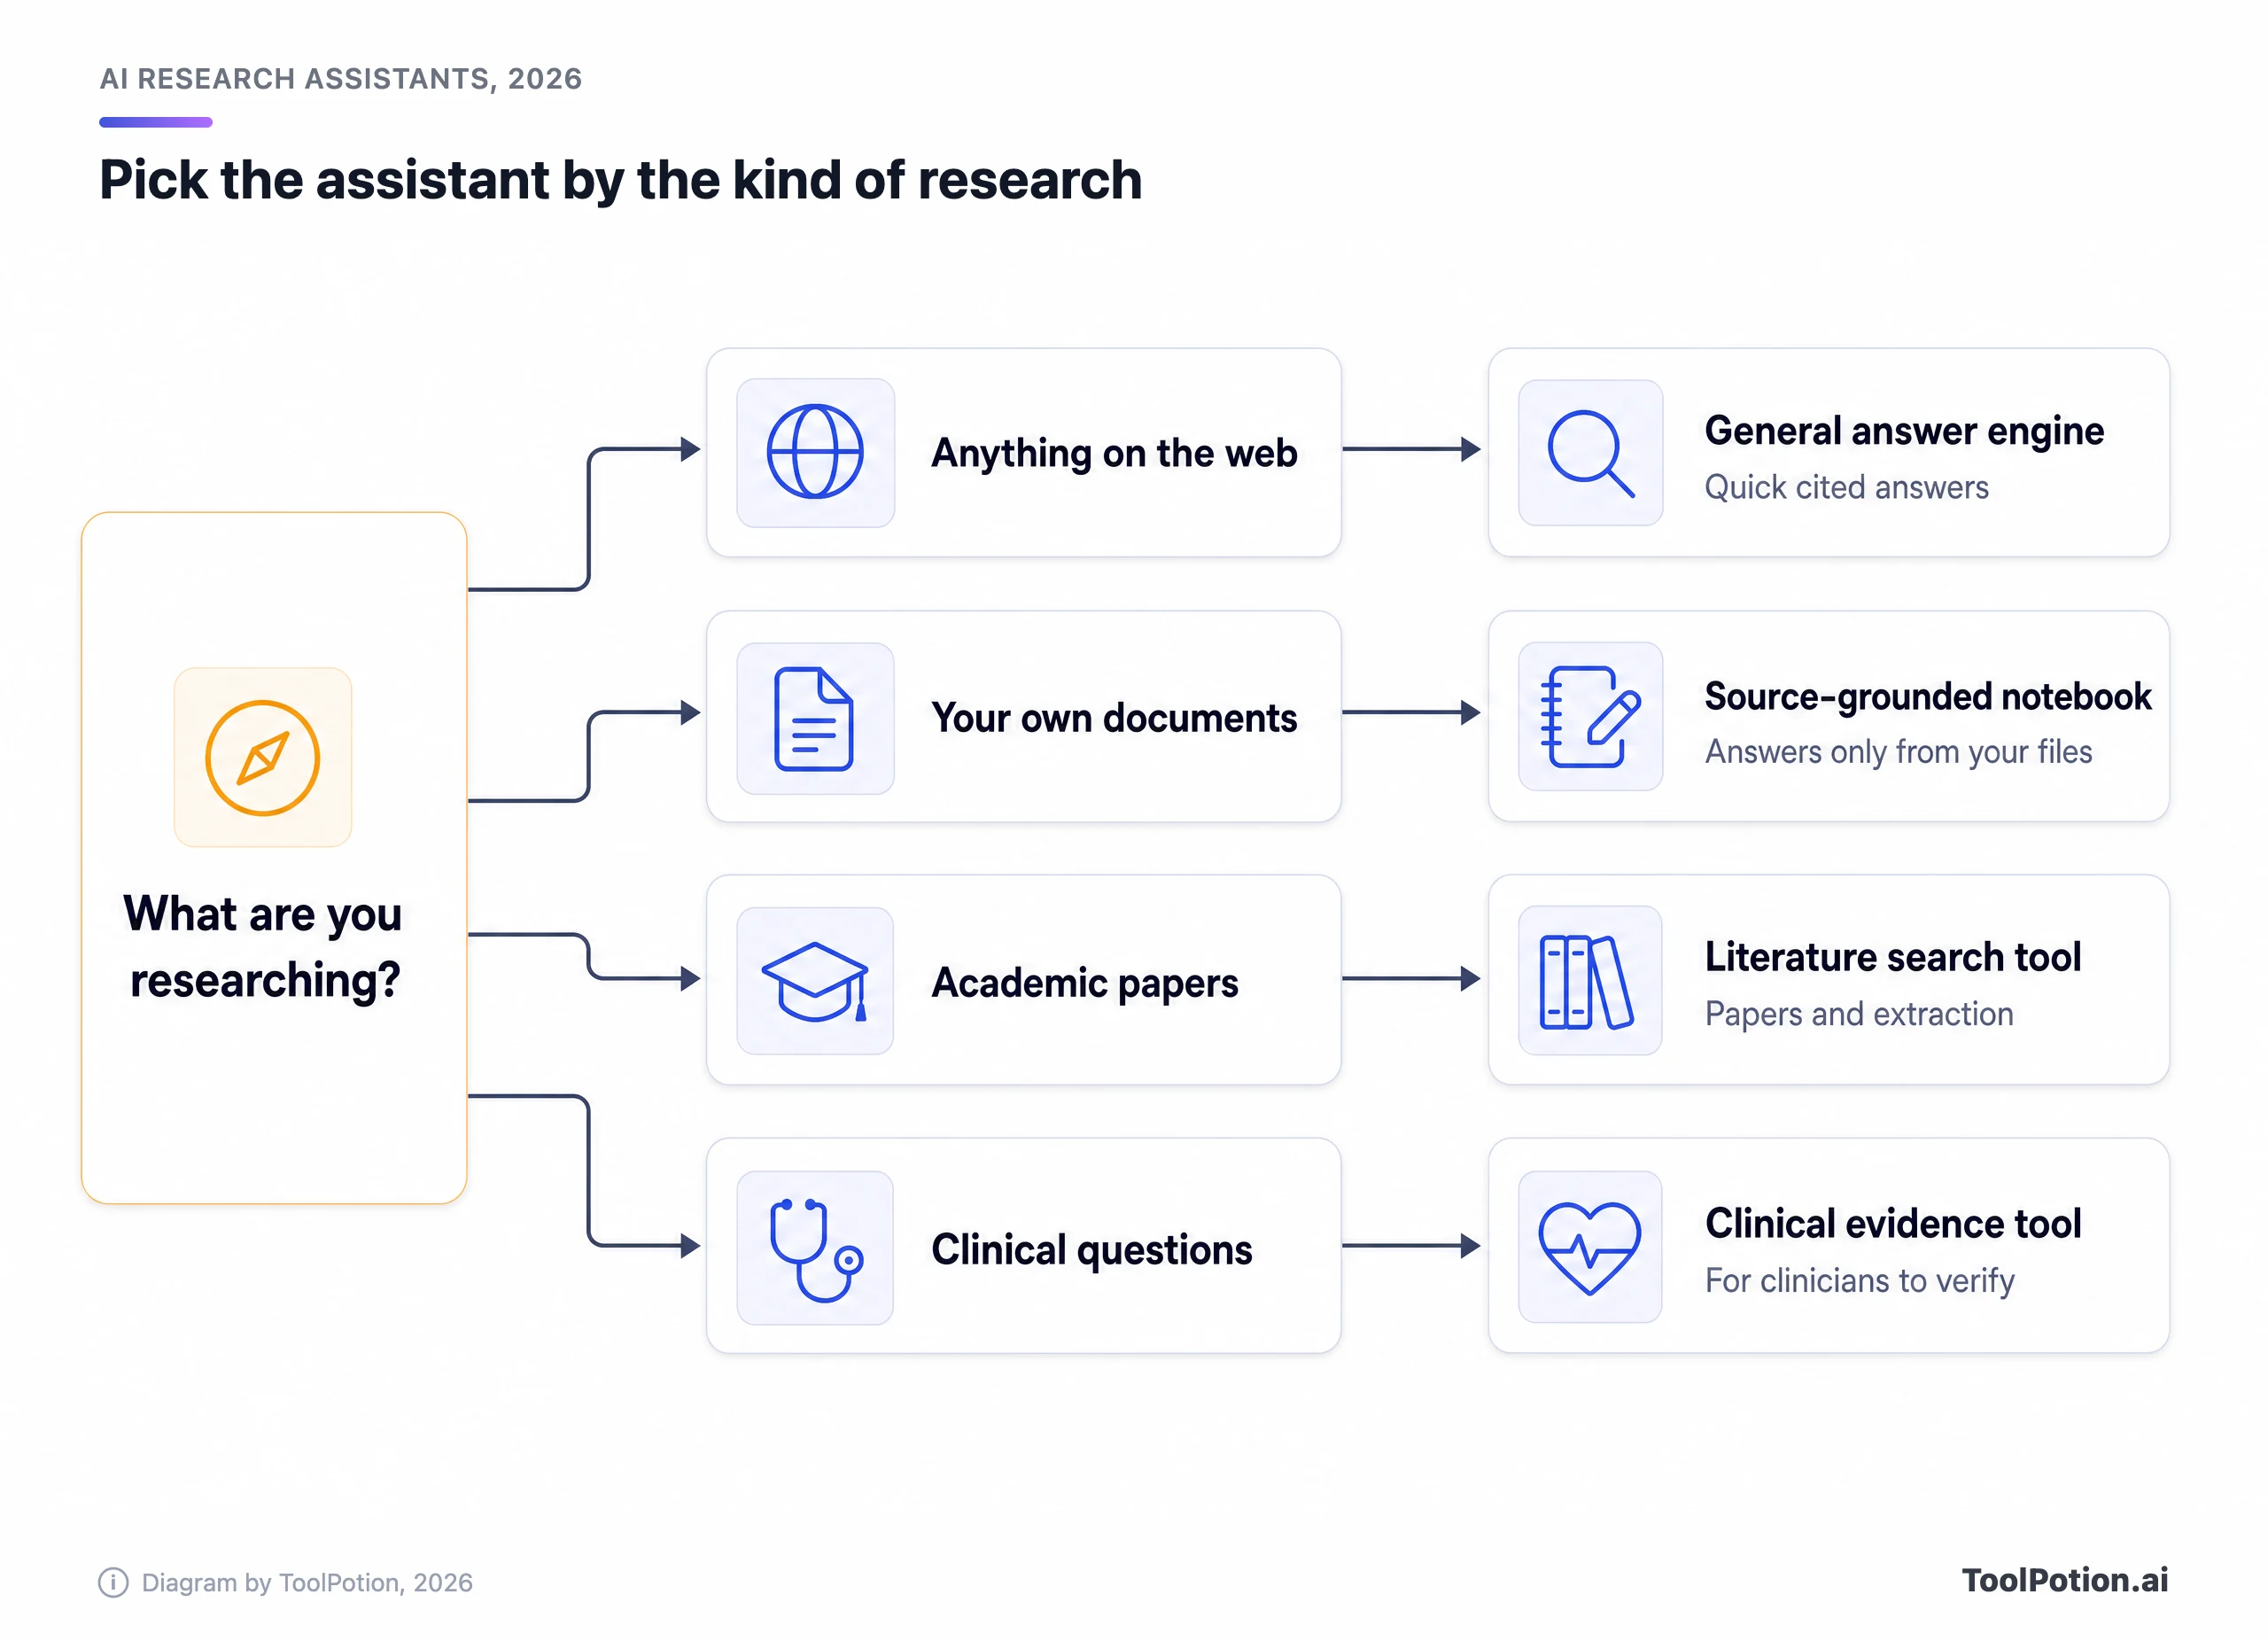
Menulis tinjauan literatur adalah kasus sulit yang paling umum. Pakai Consensus atau Semantic Scholar untuk menemukan apa yang ada, ResearchRabbit untuk mengikuti jejak sitasi, Elicit untuk mengekstrak data, dan Rayyan jika review-nya harus formal. Jika Anda bekerja dari sekumpulan laporan atau wawancara yang tetap, NotebookLM mengalahkan semuanya. Jika Anda butuh jawaban cepat pada topik yang bisa Anda verifikasi, Perplexity sudah cukup.
Dua situasi butuh kehati-hatian ekstra. Apa pun yang bersifat medis harus lewat profesional, dan OpenEvidence ditujukan untuk klinisi, bukan pasien. Dan topik niche, tempat angka Deakin melonjak, menuntut Anda membuka setiap referensi.
Harga lebih kecil artinya dibanding tier gratis, jadi coba itu dulu. Tabel ini mengurutkan sembilan pemimpin berdasarkan apa yang mereka telusuri dan berapa biayanya. Jika kami tidak bisa mengonfirmasi suatu angka, tabel menyatakannya.
Tentang ToolRank
ToolRank adalah peringkat independen ToolPotion untuk tool AI, dan posisi tidak bisa dibeli. Setiap board menampilkan skor dan tier untuk setiap entri yang diberi skor. Anda bisa menjelajahi semuanya di halaman leaderboard ToolRank.
Kesalahan yang menyita waktu peneliti
Yang paling umum adalah memakai chatbot umum untuk menghasilkan referensi. Angka Deakin menjelaskan mengapa itu gagal, dan larangan arXiv menjelaskan apa akibatnya. Asisten riset yang menunjukkan proses pengambilan sumbernya adalah titik awal yang lebih aman, dan yang hanya membaca dokumen Anda lebih aman lagi.
Yang kedua adalah membayar paket tertinggi sejak hari pertama. Tier Max Perplexity $200 per bulan dan tier Scale Elicit $169, dan keduanya dibuat untuk pemakaian berat. Kebanyakan mahasiswa dan analis tidak pernah mendekati batasnya. Mulailah dari tier gratis, tabrak batasnya, lalu bayar untuk batas yang benar-benar Anda temui.
Yang ketiga adalah menganggap ringkasan sebagai tinjauan literatur. Sebuah tool bisa memberi tahu isi sepuluh abstrak. Ia tidak bisa memberi tahu studi mana yang lemah, mana yang usang, atau apa yang hilang dari kumpulan itu. Bagian itu tetap tugas Anda, dan di situlah pembaca manusia pantas dihargai.
Yang terakhir adalah menanyakan pertanyaan medis ke tool non-medis lalu percaya pada kemasan jawabannya yang rapi. Jangan.
Nama baru dan yang sedang naik daun
Connected Papers naik dari #15 ke #13 dengan peta visual hubungan antarmakalah. Beberapa tool yang lebih muda menyusul tepat di belakang 25 teratas. Ai2 Asta (#27) berasal dari institut yang sama dengan Semantic Scholar dan memadukan pemahaman literatur dengan penemuan berbasis data. Keenious (#34) menyarankan makalah berdasarkan apa yang sedang Anda tulis dan terhubung ke Word. PapersFlow (#32) menawarkan tinjauan literatur di dalam workspace AI, dan AnswerThis (#40) menjawab dengan sitasi langsung. STORM (#33) adalah prototipe riset Stanford yang menyusun artikel ala Wikipedia lengkap dengan sumber.
Direktori lengkap asisten riset AI memuat sisanya. Jika kebutuhan Anda lebih sempit, board terkait adalah titik awal yang lebih baik, seperti tool AI untuk mencari literatur akademik, tool AI untuk peneliti, penulisan akademik dan sitasi dan tool untuk chat dengan dokumen PDF. Atau kembali ke leaderboard asisten riset langsung untuk melihat posisi semuanya.
Pertanyaan yang sering diajukan
Apa asisten riset AI gratis terbaik?
Semantic Scholar sepenuhnya gratis. Perplexity, NotebookLM, dan Elicit juga punya tier gratis, dan paket gratis NotebookLM mengizinkan 50 sumber per notebook. Mulailah dari sana sebelum membayar apa pun.
Bisakah asisten riset AI mengarang sitasi?
Bisa. Chatbot biasa paling sering melakukannya, seperti ditunjukkan studi Deakin, dan tool berbasis sumber lebih jarang. Bahkan sitasi yang asli pun bisa ditempelkan pada klaim yang tidak dibuat oleh makalahnya, jadi buka sumbernya setiap kali.
Apakah NotebookLM sama dengan Gemini Notebook?
Ya. Google mengganti namanya pada 2026 dan menyatakan ia tetap produk mandiri.
Apakah OpenEvidence gratis?
Gratis untuk tenaga medis dan dibiayai iklan. Ia dibuat untuk tenaga medis dan tidak menggantikan penilaian klinisi.
Tool mana yang terbaik untuk tinjauan literatur?
Tidak ada satu tool yang mencakup semuanya. Gabungkan tool pencarian seperti Consensus atau Semantic Scholar dengan ResearchRabbit untuk pemetaan dan Elicit untuk ekstraksi, lalu tambahkan Rayyan untuk systematic review formal.
Bagaimana cara memeriksa referensi buatan AI?
Klik sampai ke makalahnya dan pastikan makalah itu ada. Lalu pastikan isinya sesuai dengan klaim jawabannya, dan cocokkan DOI dengan situs penerbit. Sepuluh menit melakukan itu lebih baik daripada klaim yang ditarik kembali.