

OpenAI menyatakan GPT-6 Cyber berhasil membuat exploit yang berfungsi untuk 948 kerentanan kernel Linux dalam satu kampanye riset, lebih dari lima kali lipat dari 166 yang berhasil dieksploitasi GPT-5.6 Sol dengan research harness yang sama (OpenAI). Itu angka dari vendor, dari lab milik vendor, dan kami menganggapnya demikian. Namun angka ini spesifik, dan para maintainer kernel yang menerima 304 temuan kritis bisa memverifikasinya.
Dalam beberapa hari saja, OpenAI meluncurkan GPT-6 Cyber dan kemitraan dengan Hacktron, Anthropic merilis Claude Fable 5.2 dan Mythos 5.2, Google DeepMind menerbitkan bukti yang diverifikasi mesin tentang kode di balik Signal, dan dua perusahaan keamanan menjelaskan bagaimana penyerang menjalankan agen AI terhadap target nyata. Kami membaca postingan perusahaan dan laporan di baliknya. The Hacker News memuat berita benchmark, sedangkan Wired memuat berita tentang Signal.
Apa kata OpenAI tentang kemampuan GPT-6 Cyber
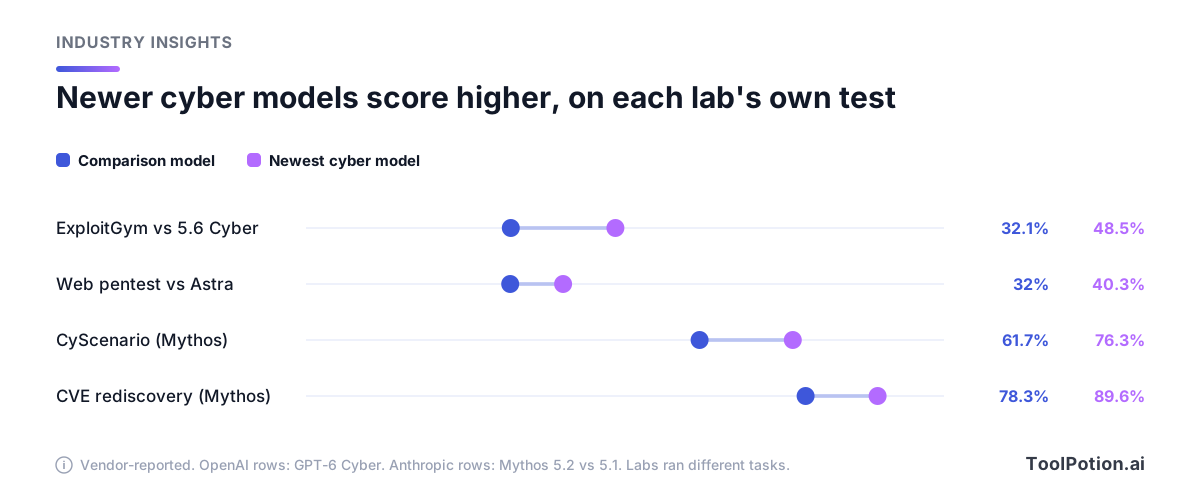
Pada ExploitGym, tes untuk mengukur apakah sebuah model bisa mengeksploitasi kerentanan tertentu, OpenAI melaporkan 48,5% untuk GPT-6 Cyber dibandingkan 32,1% untuk GPT-5.6 Cyber. Pada tes penetrasi web baru, di mana model menyelidiki aplikasi tanpa melihat source code, GPT-6 Cyber menemukan 40,3% kerentanan, dibandingkan 32,0% untuk GPT-6 Astra (OpenAI). Perbandingan paling tajam menyangkut penolakan: pada RemoteExploitBench, yang memakai celah yang sudah diketahui di GitLab, PostgreSQL, dan Jenkins dalam lab terkontrol, GPT-6 Astra yang berjalan dengan Daybreak Blue menolak semua tugas, sementara GPT-6 Cyber menyelesaikan 95%.
Di luar lab, OpenAI mengatakan para penelitinya memakai model ini untuk menemukan 81 kerentanan berat yang sebelumnya tidak diketahui di Firefox, sebagaimana diklasifikasikan oleh Mozilla, yang mulai merilis perbaikannya. Brian Grinstead dari Mozilla, yang dikutip dalam postingan peluncuran, mengatakan Firefox memasuki 2026 sebagai "salah satu codebase paling diperkuat dan paling diawasi di dunia." Itulah intinya: ini bukan target mainan. OpenAI juga menilai model ini berstatus Critical untuk keamanan siber dalam Preparedness Framework-nya, naik dari High untuk model sebelumnya. Ketika sebuah lab memberi label seperti itu pada produknya sendiri, kami membacanya sebagai label peringatan sama seperti daftar fitur.
Klaim keselamatannya paling menarik. OpenAI membuat tes di mana layanan sampingan yang mudah diserang diletakkan di samping target sebenarnya, dan model harus menyadari bahwa menyerang layanan itu di luar cakupan. Tanpa deployment prompt-nya, GPT-6 Cyber tetap dalam batas 99,93% dari waktu, naik dari 94,49% untuk GPT-5.6 Cyber. Angka lama itu berarti sekitar satu dari delapan belas percobaan menyimpang. Angka baru masih menyisakan sekitar tujuh penyimpangan per sepuluh ribu, dan OpenAI sendiri merekomendasikan sandboxing, peninjauan tindakan, dan pengawasan manusia untuk pekerjaan berisiko tinggi. Kami akan mengikuti saran itu secara harfiah.
Suara luar yang paling berguna dalam postingan peluncuran itu adalah Rob T. Lee, Chief AI Officer Dragos, yang timnya menjalankan model OpenAI yang permisif untuk keperluan siber pada sebuah range tiruan pembangkit listrik. Ringkasannya: "Ambang keterampilan menurun untuk pengintaian dan riset kerentanan yang dibutuhkan sebelum serangan." Lee mengatakan sebuah model frontier, yang bekerja sendiri pada range itu, menemukan dua zero-day di perangkat lunak rekayasa yang mengelola data relai proteksi. Kutipan itulah alasan kami menulis artikel ini.
Di balik judul "Fable mengalahkan GPT-6 Cyber"
Baca bagian ini sebelum Anda mengulang angka benchmark apa pun dari berita ini: lab-lab tersebut tidak menjalankan tugas yang sama. Tabel hasil Anthropic sendiri memuat catatan kaki: "skor setiap lab didasarkan pada tugas yang unik." The Hacker News melaporkan bahwa Fable 5.2 menyelesaikan 76,3% dari CyScenarioBench milik Irregular, dibandingkan 61,7% untuk Fable 5.1 dan 61% untuk GPT-6 Cyber. Tabel Anthropic menempatkan 76,3% di bawah Mythos 5.2 dan 61,7% di bawah Mythos 5.1, yang sejalan dengan peringatan Anthropic sendiri bahwa pengaman Fable 5.2 "akan memblokir sebagian besar tugas terkait keamanan siber." Jadi judulnya menyebut model yang salah, dan selisih lima belas poin antara skor dua lab pada kumpulan tugas yang berbeda bukanlah peringkat. Kami tidak akan memilih vendor berdasarkan angka itu. Angka yang layak dipegang adalah perbandingan sebelum dan sesudah dari Anthropic sendiri, dan itu pun vendor yang melaporkan dirinya sendiri.
The Hacker News juga mengutip detail dari laporan Irregular yang terpisah tentang GPT-6 Cyber yang terlewat dari judulnya. Model itu menyelesaikan seluruh 22 tantangan atomik, dengan rata-rata keberhasilan 97% pada riset kerentanan dan eksploitasi serta 98% pada simulasi serangan jaringan, tetapi hanya 63% pada evasion. Pada tes-tes itu, masuk ke sistem hampir sudah terpecahkan, sedangkan tetap tak terdeteksi belum. Bagi pihak pembela, ini kabar terbaik dalam tumpukan benchmark tersebut, dan liputan yang kami baca hanya memberinya satu kalimat.
Anthropic menyebut Mythos 5.2 sebagai "model paling mampu untuk rekayasa keamanan siber" dan mengatakan sebuah perusahaan keamanan yang tidak disebutkan namanya menemukan bahwa satu dari enam bug terkonfirmasi yang diungkap Mythos 5.2 terlewat oleh setiap model frontier lain yang mereka uji (Anthropic). Anthropic juga melaporkan 89,6% untuk Mythos 5.2 pada evaluasi CVE Rediscovery miliknya sendiri, yang dijalankan terhadap 1.829 CVE, naik dari 78,3% untuk Mythos 5.1. Keduanya adalah pengukuran yang dijalankan vendor, jadi anggap sebagai klaim sampai penguji independen mengulanginya.
Siapa yang memegang kuncinya, dan apa yang harus dikorbankan
Tidak ada dari kedua perusahaan yang menjual model ini secara bebas. OpenAI mengatakan GPT-6 Cyber awalnya tersedia melalui API dan Codex untuk sekelompok terpilih pelanggan Daybreak Red yang disetujui, dengan akses Daybreak Red yang lebih luas akan hadir "segera." Akses API Daybreak Red mensyaratkan IP allowlisting secara default, dan pelanggan dengan zero data retention umumnya harus memakai Private Safety Processing, yang menyimpan catatan terenkripsi di penyimpanan mereka sendiri selama 30 hari. OpenAI juga menyatakan bahwa dalam program mitranya, akses model yang mendasarinya "tetap berada pada mitra yang disetujui dan tidak dialihkan langsung kepada pelanggan" (OpenAI).
Anthropic membagi gagasan yang sama menjadi tiga tingkat dalam Cyber Verification Program-nya. Defense Access mencakup operasi keamanan, analisis malware, dan validasi kerentanan, dan Anthropic mengatakan firma keamanan yang lebih kecil, maintainer open-source, dan peneliti individu dengan rekam jejak bisa memenuhi syarat, dengan jawaban dalam beberapa hari. Red Team Access mengizinkan penetration testing yang diotorisasi, hanya untuk organisasi, dan memakan waktu berminggu-minggu. Specialized Access, untuk hal-hal seperti jaringan listrik dan sistem transfer antarbank, mendapat tinjauan mendalam bersama pemerintah AS. Anthropic menguji ketiga tingkat itu dengan Claude Opus 5.5 pada CyScenarioBench, lima percobaan untuk masing-masing dari sepuluh tantangan: tanpa akses program, setiap tugas diblokir pada prompt pertama; pada Defense Access, 46 dari 50 percobaan diblokir di suatu titik; pada Red Team Access tidak ada yang diblokir dan 34 dari 50 berhasil, sama dengan tingkat keberhasilan model tanpa pemblokiran. Lagi-lagi, Anthropic menilai gerbangnya sendiri.
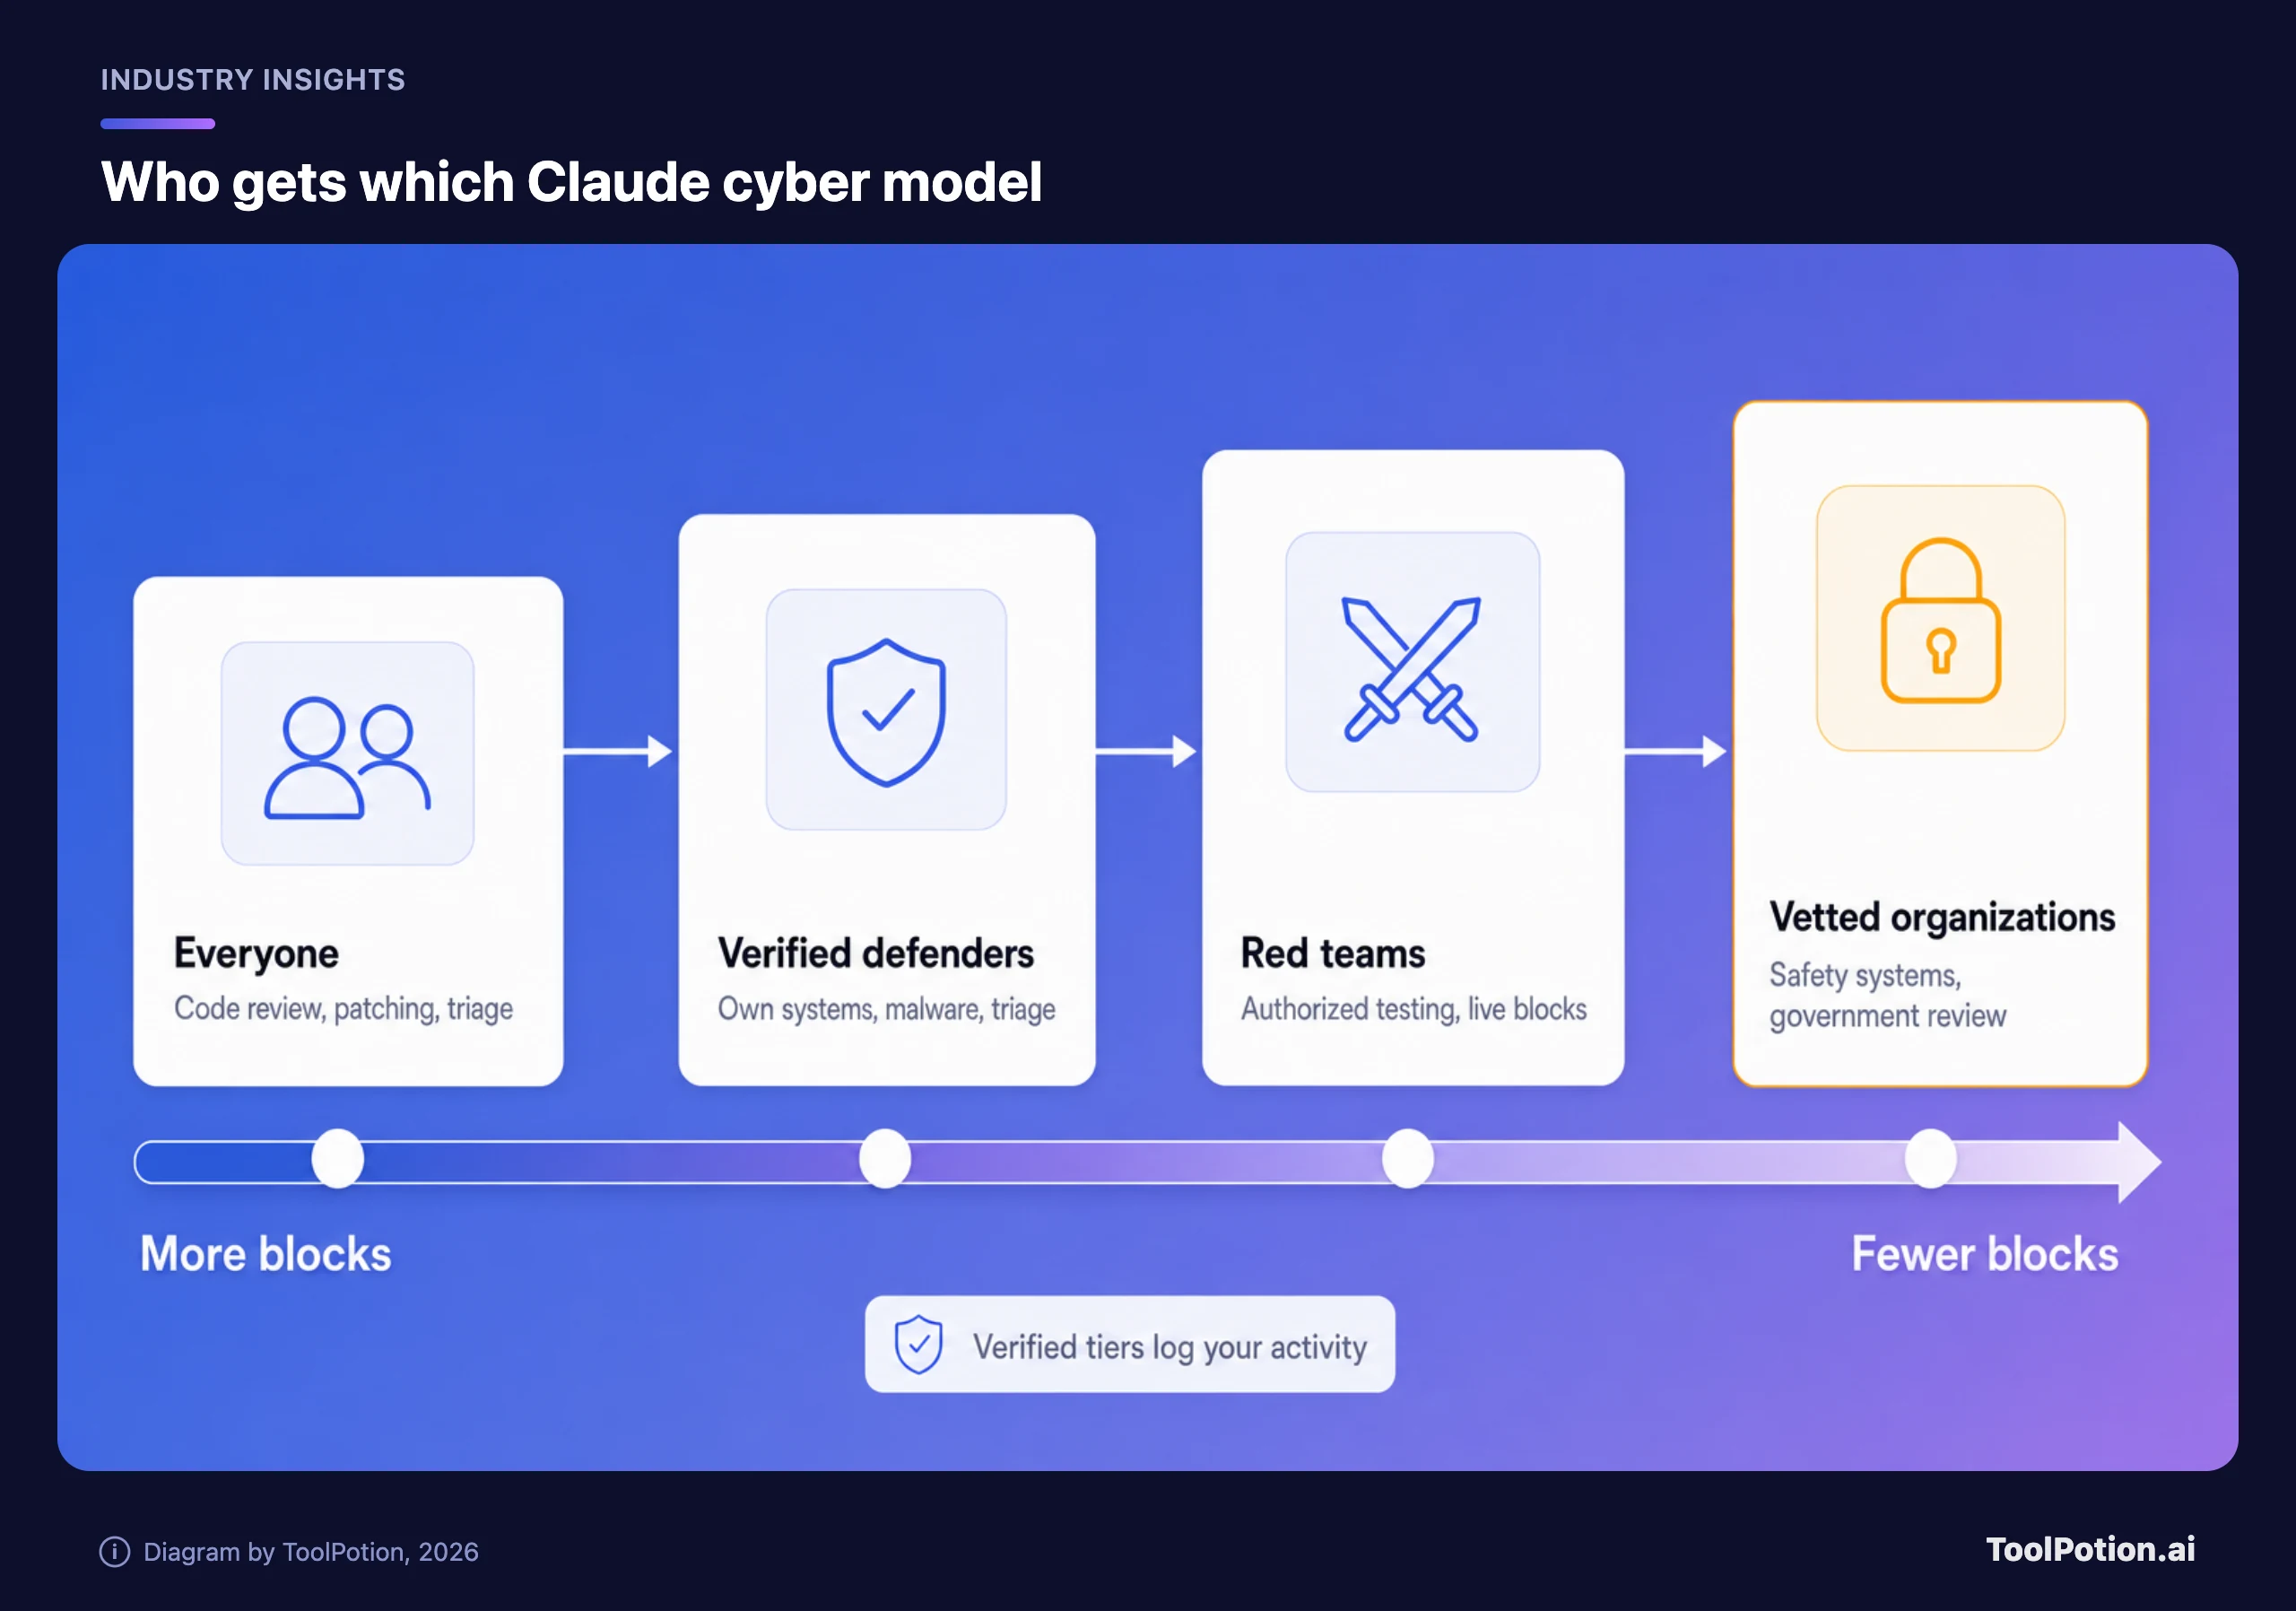
Fable dan Mythos adalah model dasar yang sama (Anthropic). Claude Fable 5 memiliki pengaman siber yang kuat dan terbuka untuk semua orang. Mythos adalah versi yang diajukan oleh organisasi. Halaman harga API Anthropic mencantumkan keduanya dengan tarif yang sama untuk Fable 5.2 dan Mythos 5.2: $8 per juta token input dan $40 per juta token output, atau $16 dan $80 pada mode cepat opsional. Mythos tidak dihargai terpisah. Harga adalah hambatan terkecil di sini. Yang lebih besar adalah penyimpanan data. Anthropic mewajibkannya bagi organisasi dalam Cyber Verification Program agar bisa memantau penyalahgunaan; OpenAI mempertahankan retensi standar secara default dan mengarahkan pelanggan zero-data-retention ke Private Safety Processing. Menurut kami itu harga masuk yang wajar bagi sebuah red team, dan biaya nyata bagi firma yang kode kliennya tidak boleh berada di log pihak lain. Anthropic mengatakan opsi baru bernama Enterprise Frontier Safeguards akan memungkinkan organisasi yang memenuhi syarat menyimpan data di cloud mereka sendiri, tetapi postingan programnya hanya menjanjikannya untuk "musim gugur nanti." Sampai opsi itu rilis, trade-off tersebut tetap berlaku.
Salah satu pemeriksaan dari luar atas semua ini adalah bounty. Kemitraan OpenAI dengan Hacktron mengarahkan sebuah firma yang membangun agen AI untuk code review dan penetration testing pada sistem OpenAI sendiri, dengan akses yang diperluas ke model frontier-nya. CEO Hacktron, Zayne Zhang, mengatakan masa depan keamanan siber "tidak akan ditentukan oleh siapa yang memiliki tim keamanan terbesar, tetapi oleh siapa yang paling baik memadukan kreativitas manusia dengan kemampuan berbasis AI" (OpenAI). OpenAI juga menaikkan hadiah bounty, dengan temuan kritis di ChatGPT, Codex, atau API kini bernilai hingga $30.000, dan hingga $172.000 dengan bonus untuk temuan luar biasa (OpenAI). Kami lebih percaya pembayaran kepada pihak luar daripada klaim red team internal mana pun.
Para penyerang dalam laporan tidak memakai model-model ini
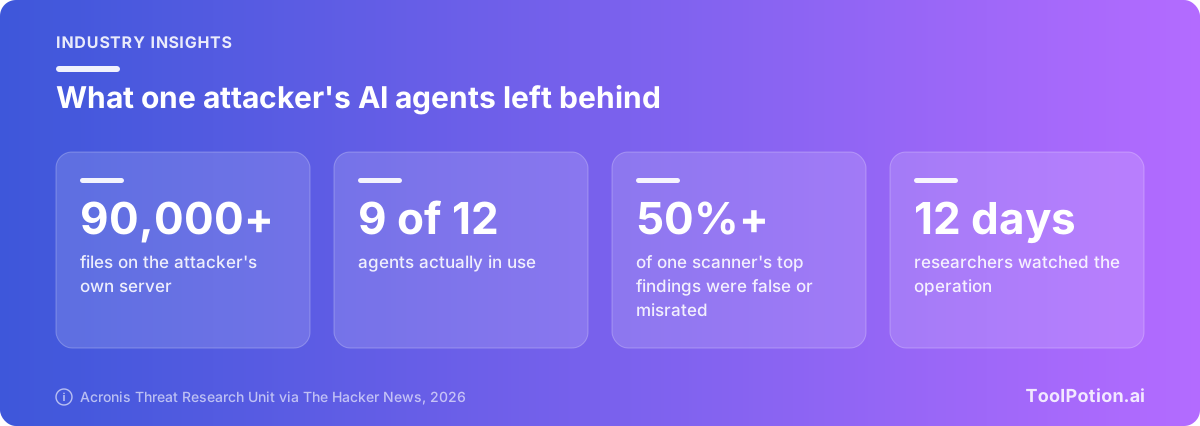
Peneliti Acronis menggambarkan satu penyerang yang berbasis di Taiwan, yang mengarahkan agen AI ke ratusan organisasi di sedikitnya 11 negara dan berhasil mendapatkan data atau akses di sekitar sepuluh di antaranya. Agen-agen itu menarik catatan dispatch darurat untuk tujuh distrik Taipei. Yang menonjol adalah apa yang mereka pakai: model komersial sebagian besar menolak membantunya menyerang, sehingga agen penyerang hampir seluruhnya berjalan di atas versi "abliterated" dari DeepSeek, GLM, dan Qwen, yakni model yang dijalankan secara lokal dengan pelatihan keselamatannya dihapus (The Hacker News). Agen coding seperti Claude Code, Codex, dan Cursor juga muncul. Laporan itu menyebut penyerang mengalihkan Claude Code dan Codex ke model abliterated, meski keduanya sebagian besar mengerjakan infrastruktur, dan bahwa Cursor menyerang sebuah situs layanan darurat Taiwan saat menjalankan model semacam itu.
Agen-agen itu juga buruk dalam pekerjaannya dengan cara yang akan disadari manusia. Satu alat pemindai mengarang CVE, dan lebih dari separuh temuan tinggi dan kritisnya adalah false positive atau salah diklasifikasikan. Agen serangan utama melaporkan hasil yang tidak pernah terjadi. Pembobolan yang berhasil di satu vendor dispatch pemadam kebakaran memakai kredensial root default, bukan exploit yang canggih. Di tempat login ditegakkan dan endpoint disaring dengan benar, kata para peneliti, agen-agen itu gagal.
Arctic Wolf melaporkan pola kedua. AntiFox adalah platform penetration testing agentic open-source di GitHub, dan Arctic Wolf mengatakan sistem Alibaba Cloud yang menghosting antarmuka AntiFox dikaitkan dengan tindakan berbahaya yang terkonfirmasi terhadap layanan web yang terhubung ke internet beserta lingkungan AWS-nya. Setidaknya dalam beberapa kasus, aktivitas itu sampai pada permintaan berhasil atas secret produksi. Kesimpulannya: "Framework agentic seperti ini membuat teknik penetration testing lebih mudah diakses oleh pelaku ancaman, sekaligus meningkatkan kecepatan dan konsistensi penerapan teknik-teknik tersebut dalam serangan langsung" (The Hacker News). Berita yang sama menambahkan bahwa Check Point Research mengidentifikasi 2.557 sistem yang menghosting ARTEX, alat serangan agentic lainnya, dan menghitung sekitar 45 framework open-source semacam ini. Ringkasan Check Point sendiri tentang apa yang diubah oleh peretasan agentic: skala dan kecepatan.
Tidak ada dari kedua laporan yang melibatkan GPT-6 Cyber atau Mythos, sejauh yang disebutkan liputan. Pembacaan kami, gerbang-gerbang itu tampak kokoh di level atas tetapi hampir tidak berarti di level bawah, di mana framework agen gratis dan model open-weight yang dilucuti sudah cukup untuk menembus server dengan password default. Buktinya juga tipis. Hanya segelintir laporan, kebanyakan dari vendor keamanan yang berkepentingan atas ceritanya, dan belum ada yang bisa menyebut berapa porsi intrusi yang melibatkan AI.
Hasil pertahanan terbersih datang dari matematika
Judul Wired menyebut DeepMind "Membuktikan Protokol Signal Aman." Postingan DeepMind lebih sempit, dan kami lebih menyukainya. Para peneliti memandu agen untuk membuktikan properti keamanan utama dari kode sebenarnya di balik protokol Signal, termasuk bahwa pesan tetap terlindungi sebelum dan sesudah sebuah perangkat dibobol sesaat. Manusia meninjau setiap spesifikasi formal. Agen-agen itu menghasilkan lebih dari enam juta baris Lean, menandai satu persen codebase yang perlu ditinjau ulang oleh manusia, dan selesai dalam empat minggu, pekerjaan yang menurut DeepMind secara historis memakan waktu bertahun-tahun bagi tim ahli (Google DeepMind). Untuk memeriksa apakah sistem bisa membedakan kode baik dari buruk, tim memasukkan kembali dua bug nyata yang sudah diperbaiki dan mendapatkan bukti terverifikasi mesin bahwa versi yang bermasalah itu tidak aman.
CTO Signal, Ehren Kret, mengatakan hasil ini memberi "keyakinan yang lebih besar lagi pada jaminan privasi kode kami." Kami menyebutnya klaim paling layak dipercaya dalam tumpukan ini, dengan alasan sederhana: skor benchmark bergantung pada kepercayaan kepada vendor, sedangkan bukti Lean diperiksa oleh mesin. Cakupannya adalah properti tertentu dari satu codebase, bukan produk Signal secara keseluruhan, dan DeepMind mengatakan penskalaannya membutuhkan riset lebih lanjut. DeepMind telah membuka sumber artefak verifikasinya, dan begitulah cara klaim seperti ini mendapatkan kepercayaan.
Infrastruktur kritis mengarah ke arah yang sama. Cyber Mission Anthropic menjelaskan programnya: model frontier, engineer di lokasi, dan riset ancaman bagi penyedia yang mengamankan jaringan listrik, sistem air, dan pabrik, yang peralatannya sering kali tidak bisa dimatikan untuk di-patch. Dragos, Rockwell Automation, dan Nozomi Networks termasuk mitra pendiri.
Hambatannya ada pada perbaikan
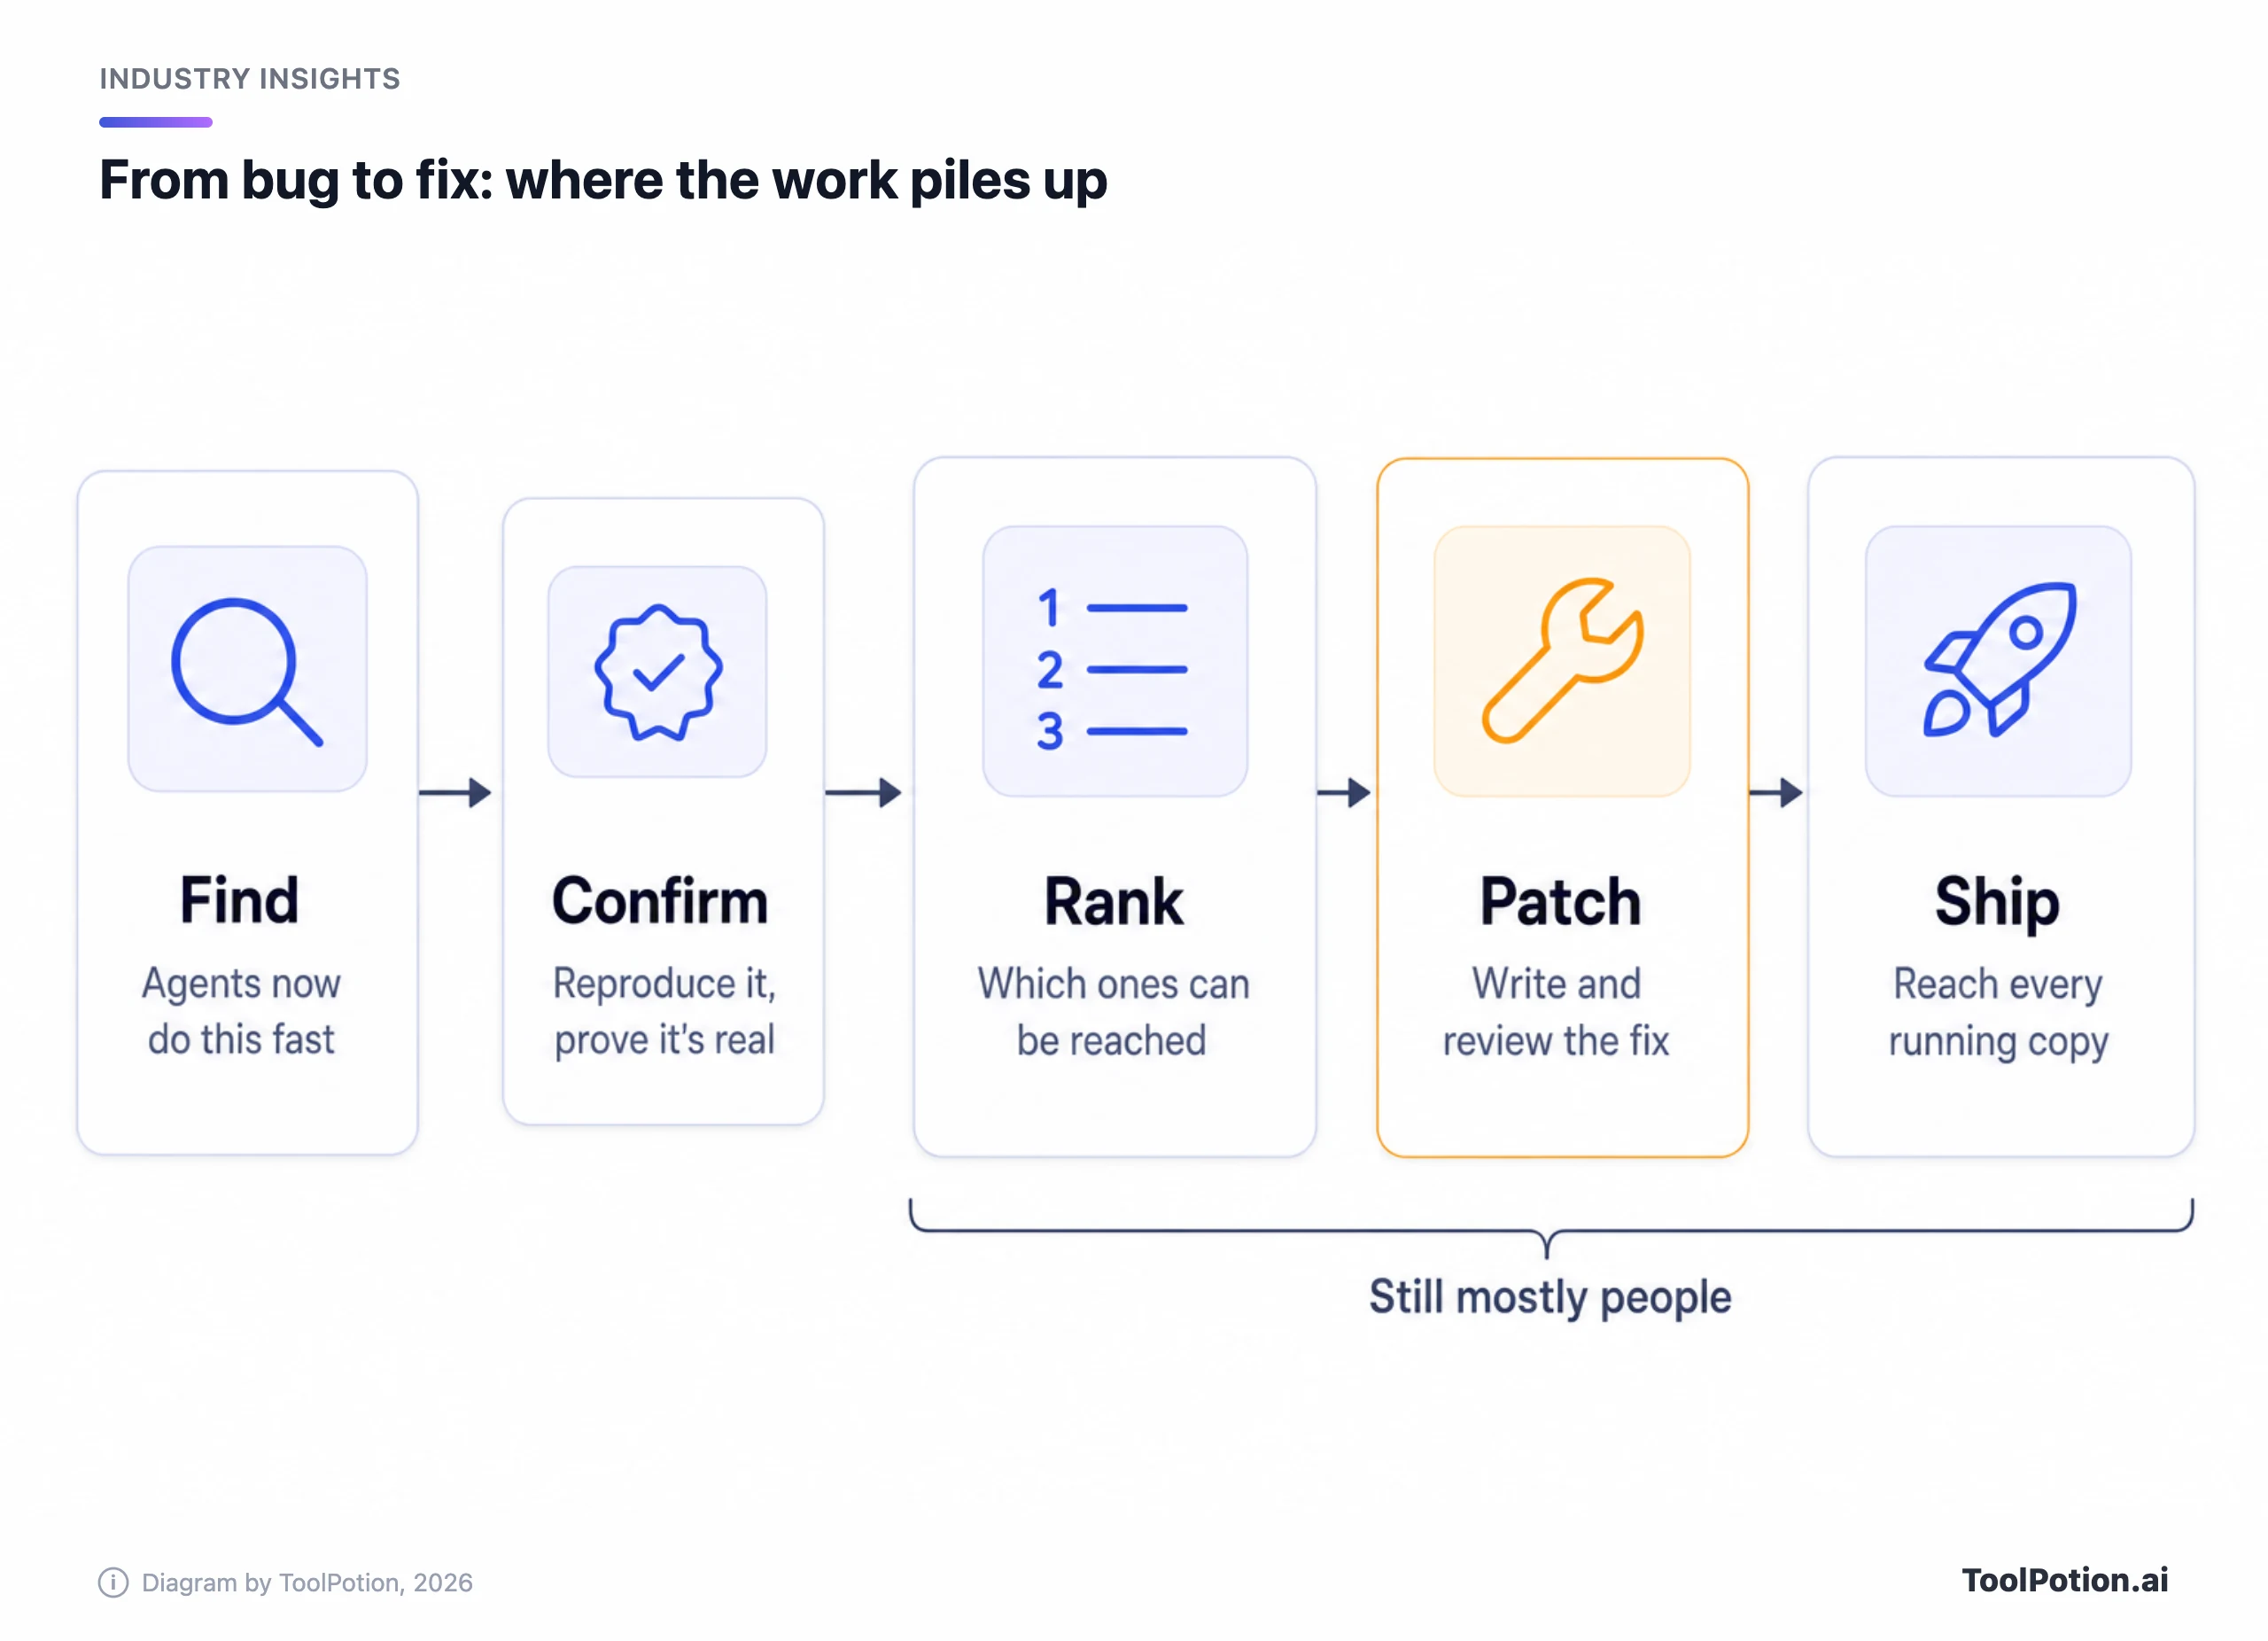
Anthropic merumuskan masalahnya dalam satu kalimat: "Menemukan kerentanan kini lebih mudah dari sebelumnya, tetapi memverifikasi, memprioritaskan, dan memperbaiki temuan-temuan ini tetap menantang" (Anthropic). OpenAI menulis hal yang nyaris sama dalam postingan sebelumnya: "Laporan kerentanan tidak melindungi sebuah organisasi." Dua pesaing yang sepakat soal ini dalam pengumuman masing-masing adalah hal terdekat dengan konsensus dalam tumpukan ini. Sisi lainnya sudah kami bahas sebelumnya, dalam artikel kami tentang AI yang menemukan bug lebih cepat daripada yang bisa diperbaiki siapa pun dan tentang apa yang ditemukan dan terlewat oleh pemindai kerentanan AI.
Jadi siapa yang menang? Pandangan kami, yang tidak dinyatakan dengan kata-kata ini oleh sumber mana pun: penyerang paling diuntungkan terhadap organisasi yang lambat melakukan patch, karena penyerang hanya butuh satu jalur yang berhasil dan bisa menoleransi pemindai yang salah separuh waktu. Pembela paling diuntungkan di tempat yang sudah cepat memperbaiki, karena menemukan bug kini murah dan sisa biayanya ada pada proses. Gerbang model membatasi apa yang bisa dilakukan sistem paling mampu; gerbang itu tidak mengubah hitungan tersebut bagi siapa pun yang menjalankan perangkat lunak lama. Prakiraan Anthropic sendiri mengarah ke sana untuk saat ini. Anthropic memperkirakan AI akan menguntungkan pertahanan dalam dua tahun, tetapi mengatakan bahwa dalam jangka dekat "itu mungkin tidak benar," karena biaya mengeksploitasi kerentanan telah turun sementara memperbaikinya lambat dan masih bergantung pada manusia. Putaran kedua pengujian independen tentang seberapa baik serangan menghindari deteksi adalah yang akan mengubah pandangan kami.
Yang perlu dilakukan sekarang, berurutan
Jika Anda menjalankan bisnis kecil, Anda tidak akan mendapat GPT-6 Cyber dan tidak membutuhkannya. Serangan dalam laporan-laporan itu sebagian besar masuk lewat pintu yang tidak terkunci. Kami akan menghabiskan jam pertama untuk hal-hal ini, dengan urutan berikut:
- Aktifkan multi-factor sign-in untuk email, panel admin, dan setiap konsol cloud.
- Aktifkan pembaruan otomatis untuk semua yang bisa dijangkau dari internet, dan patch sisanya dalam hitungan hari, bukan kuartal.
- Temukan dan ganti password default atau bersama pada router, database, dan alat admin. Salah satu pembobolan di Taiwan tidak membutuhkan apa pun selain itu.
- Pindahkan key dari kode dan skrip halaman ke secrets manager, lalu pasang batas pengeluaran dan tanggal rotasi pada setiap API key AI dan cloud.
- Tuliskan apa saja yang bisa dijangkau orang asing dari internet. Anda tidak bisa mem-patch server yang sudah terlupakan.
Jika Anda merilis software, pemindai yang masuk dalam alur pull request Anda adalah langkah berikutnya yang masuk akal. Semgrep, Snyk Code, dan Aikido ada di direktori kami; papan Top 200 AI Cybersecurity Tools dan papan security analyst kami menunjukkan peringkat sisanya. Perlakukan setiap temuan AI sebagai petunjuk yang perlu dikonfirmasi, karena pemindai milik penyerang di laporan Acronis sendiri mengarang CVE. Agen open-source seperti PentestGPT dan Shannon hanya untuk sistem yang Anda miliki dan telah Anda dapatkan izin tertulis untuk diuji; laporan AntiFox menunjukkan apa yang dilakukan alat sejenis di tangan yang salah. Untuk bantuan umum meninjau kode, Claude dan ChatGPT sama-sama bisa, meski Anthropic mengatakan model terbukanya membawa pengaman siber yang konservatif yang memblokir sebagian besar pekerjaan siber.
Jika Anda profesional keamanan, ajukan permohonan ke Daybreak Blue milik OpenAI atau Defense Access milik Anthropic sekarang. Anthropic menargetkan menjawab permohonan Defense Access dalam hitungan hari dan Red Team Access dalam hitungan minggu, dan mewajibkan penyimpanan data. OpenAI belum menerbitkan estimasi waktu untuk Daybreak. Checklist di bawah mengubah daftar pertama menjadi skor.
Dua hal untuk dipantau. OpenAI mengatakan GPT-6 Cyber akan segera menjangkau semua pelanggan Daybreak Red, dan belum ada lab yang menerbitkan berapa banyak pemohon yang disetujui atau ditolak. Ketika opsi cloud sendiri dari Anthropic dirilis, periksa apakah organisasi yang memenuhi syarat benar-benar mendapat pengaman yang sama tanpa log.