

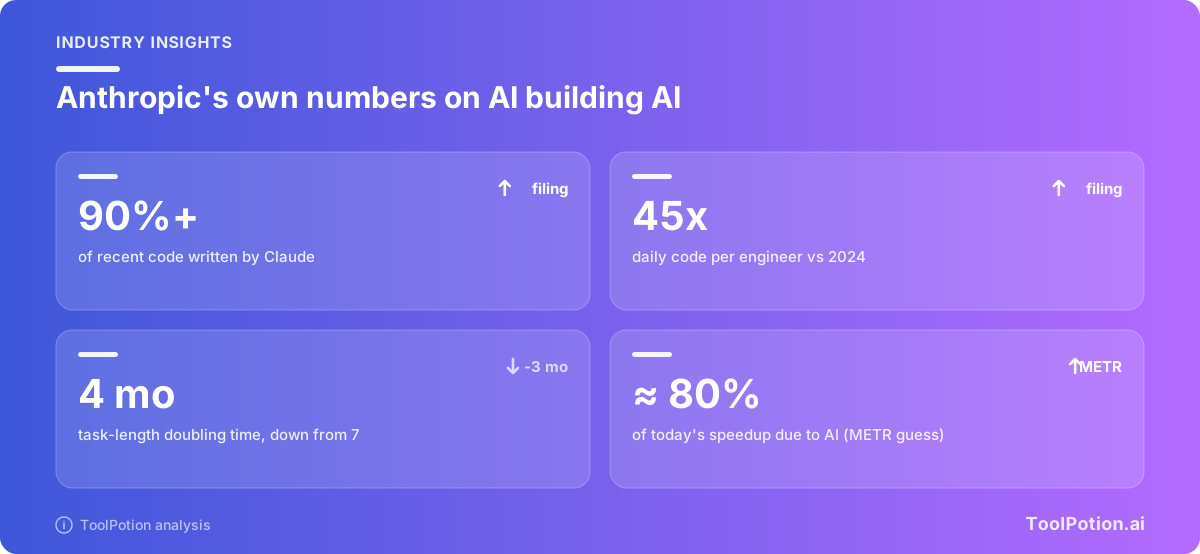
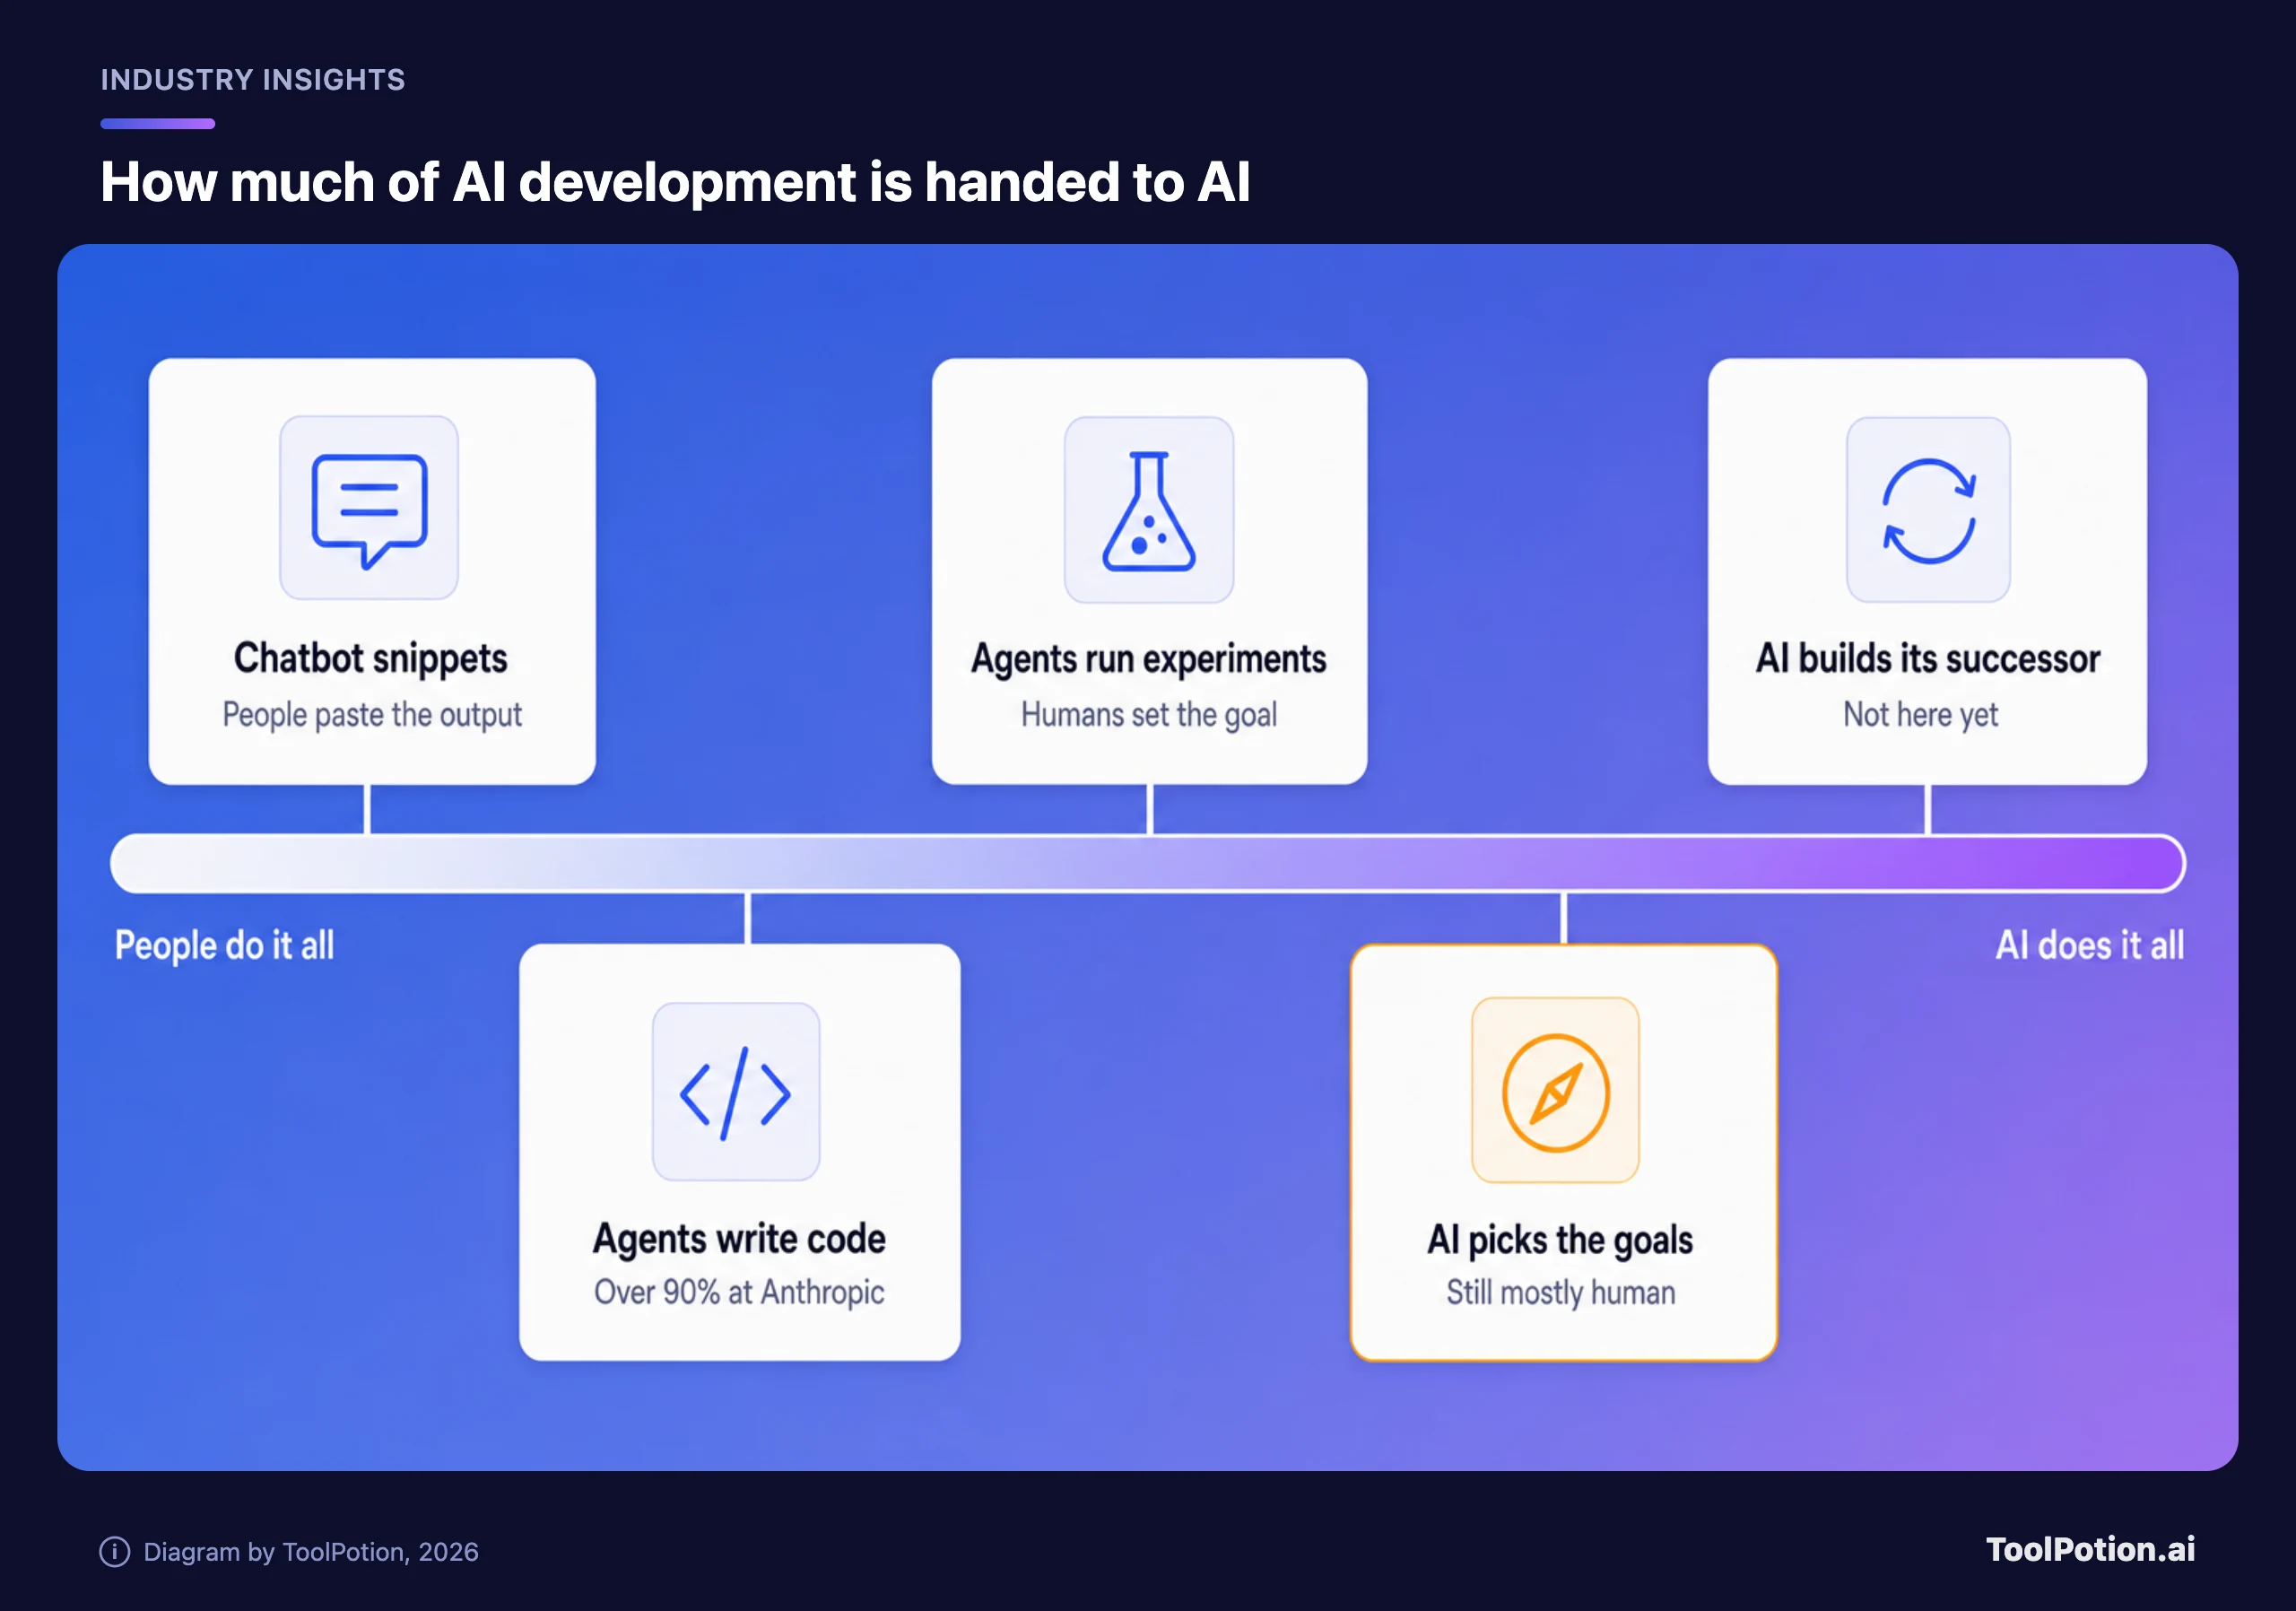
Lebih dari 90% kontribusi ke codebase Anthropic pada bulan terbaru yang dicakup filing IPO revisinya ditulis oleh Claude. Itu angka dari perusahaan sendiri (SEC filing), dan itu justru hal paling tidak dramatis di dokumen tersebut.
Jauh di dalam bagian faktor risiko, ada kalimat yang jadi berita: estimasi internal Anthropic menyebut perusahaan "may imminently meet" definisi Responsible Scaling Policy-nya tentang kemajuan yang sangat dipercepat dan digerakkan oleh AI. TechCrunch memberitakannya sebagai peringatan Anthropic bahwa mereka "very close to RSI capability" (TechCrunch). Menurut kami, peringatan itu nyata, judul beritanya sedikit lebih keras daripada isi filing, dan pihak yang paling terdampak justru mereka yang tidak akan pernah membaca bagian faktor risiko.
Recursive self-improvement, tanpa bumbu fiksi ilmiah
Recursive self-improvement (RSI) adalah sebuah lingkaran. Satu sistem AI membantu membangun sistem AI berikutnya, yang lebih mahir membantu membangun sistem sesudahnya. Definisi Anthropic sendiri adalah "an AI system capable of fully autonomously designing and developing its own successor" (Anthropic Institute).
Tidak ada yang mengklaim lingkaran itu sudah tertutup. Saat ini manusia menetapkan tujuan dan AI mengerjakan porsi yang terus bertambah: Claude Code menulis dan menjalankan kode, agen menyerahkan pekerjaan berjam-jam ke agen lain, dan Anthropic menyatakan Claude sudah bisa menyamai atau mengungguli manusia terampil dalam menjalankan eksperimen yang terdefinisi jelas. Kesenjangan yang mereka sebut adalah penilaian (judgment). Dalam kata-kata mereka, "large performance gaps persist when it comes to Claude exercising judgement in choosing goals."
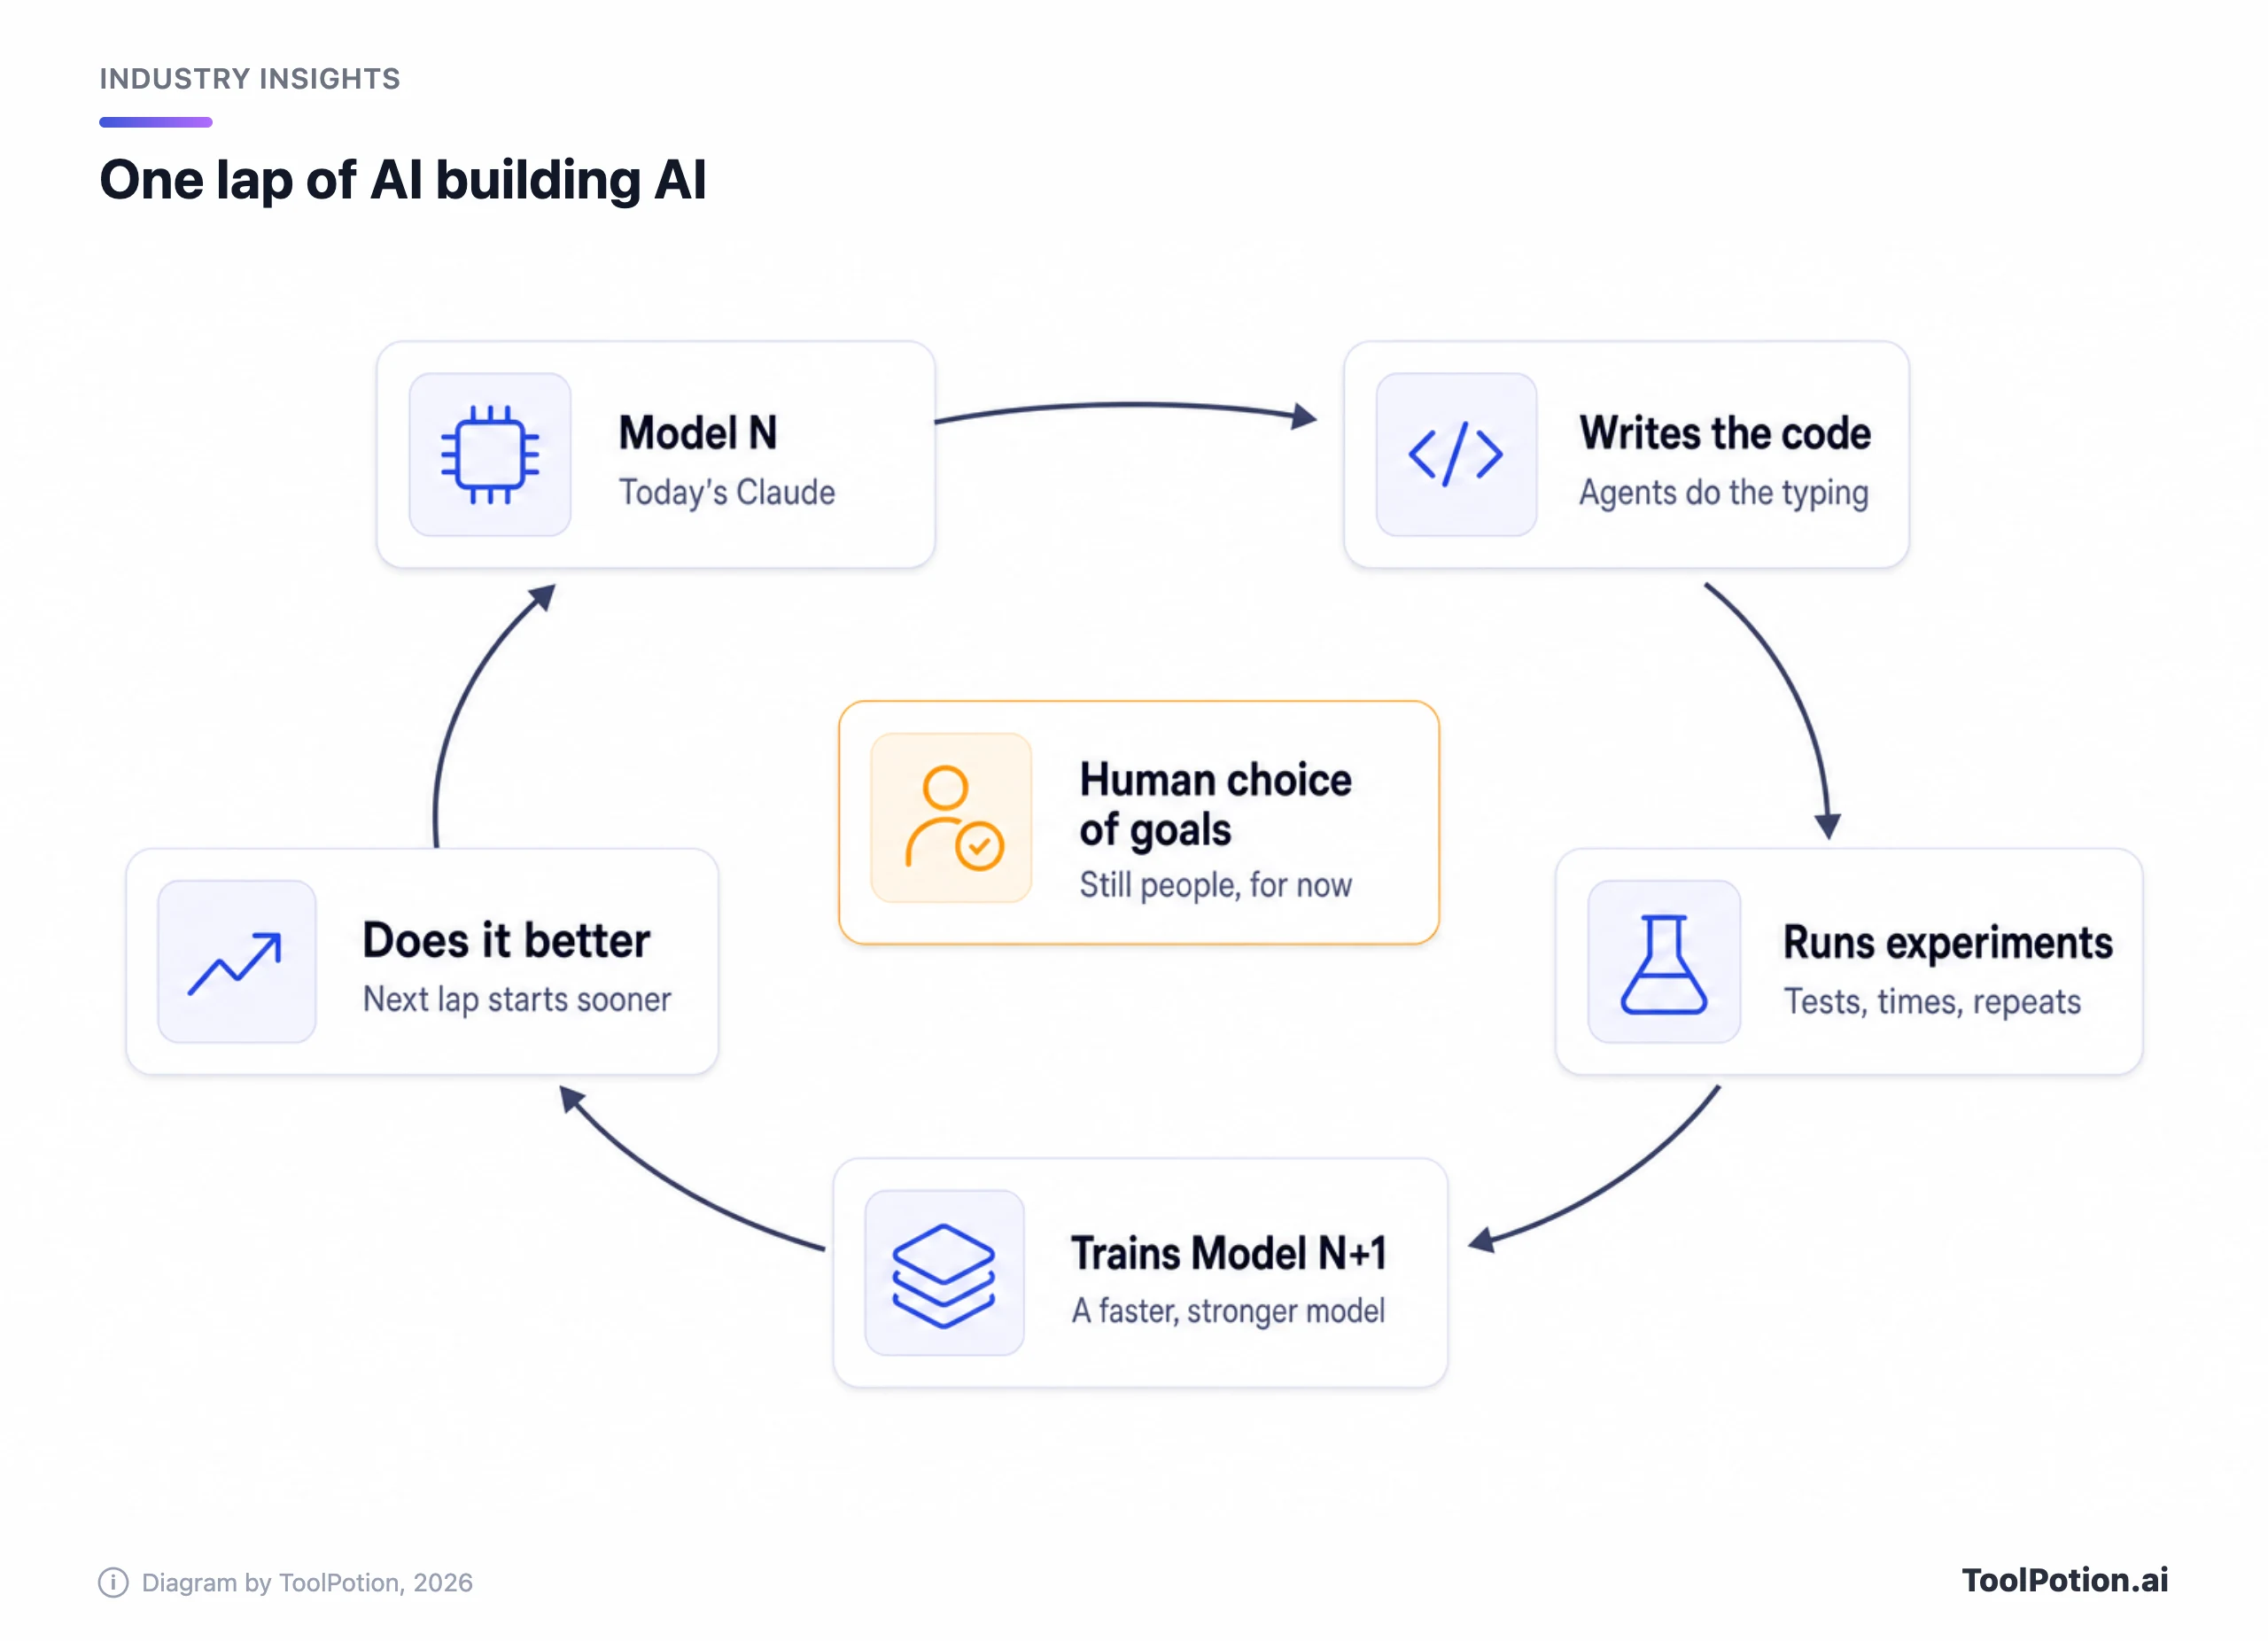
Bukti dari luar menunjuk arah yang sama. Menurut postingan Anthropic, panjang tugas yang bisa diselesaikan AI sendiri berlipat ganda kira-kira setiap empat bulan, naik dari tujuh bulan sebelumnya, dan Claude Opus 4.6 mampu mengerjakan tugas yang memakan waktu manusia sekitar dua belas jam (Anthropic Institute). Jika tren ini bertahan, tugas yang butuh berhari-hari bagi orang terampil akan masuk jangkauan tak lama kemudian. Kami memperlakukan garis tren dari vendor sebagai klaim, meski postingan yang sama mengutip METR, yang menjalankan benchmark tersebut, yang menemukan bahwa Claude Mythos Preview bisa bekerja setidaknya 16 jam.
Jadi, kenapa orang sampai sulit tidur? Karena kecepatan dan pengawasan. Kalau setiap putaran lingkaran lebih cepat dari sebelumnya, orang yang seharusnya meninjau hasil kerja menjadi bagian yang paling lambat, dan pemeriksaan yang dulu memakan waktu berbulan-bulan jadi terhimpit. Postingan Anthropic sendiri menyebut RSI penuh "might increase the risks of humans losing control over AI systems." Postingan itu juga menyebut "we are not there yet, and recursive self-improvement is not inevitable." Kedua kalimat ada di paragraf yang sama, dan sebaiknya Anda ingat keduanya.
Isi filing, dan tambahan dari judul-judul berita
Redaksi filing lebih sempit daripada pemberitaannya. Anthropic menulis bahwa "our internal estimates and our expectations regarding future models, rather than our current models," menunjukkan perusahaan "may imminently meet" definisi kebijakan tentang "dramatically accelerated progress attributable to AI." Lalu datang kalimat yang dilewatkan judul-judul berita: "We have not designated any of our current models as exceeding this threshold, and we continue to assess the underlying data" (SEC filing). Filing menambahkan bahwa Anthropic sedang "evaluating the implications of meeting the AI research and development capability threshold."
Beberapa media menulis bahwa alarmnya sudah terpicu. Secara ketat, Anthropic belum menyatakannya. Selisih itu kecil dalam kata-kata, tetapi lebih besar dalam konteks kebijakan. Dalam kebijakan saat ini (versi 3.4, yang merevisi ambang batas ini), model yang melewati garis R&D otomatis dihitung sebagai "highly capable," dan setiap risk report yang banyak disensor untuk model semacam itu memerlukan tinjauan eksternal penuh (halaman kebijakan). Redaksi lama "AI R&D-4" sudah tidak ada di teks terbaru. Ada satu detail yang mendukung frasa dalam filing: kebijakan menyatakan ambang batas terpenuhi ketika Anthropic "observe[s] or expect[s]" kecepatan kemajuan berlipat dua yang masuk akal berasal dari riset otomatis. Ekspektasi pun dihitung, jadi "may imminently" bukan berlebihan.
Baris yang paling jujur justru yang lain. Anthropic menyatakan bahwa mereka "in the past not identified, and may in the future not identify, a significant acceleration in our rate of development until after it has occurred." Ini pengakuan bahwa alarmnya membaca indikator yang tertinggal. Kami lebih suka perusahaan mengatakannya terang-terangan daripada menyembunyikannya, dan kami lebih suka kebijakannya tidak bergantung pada hal itu.
Lalu bagaimana dengan komitmennya? Anthropic menulis bahwa mereka tidak mengantisipasi bisa "safely use Claude to fully autonomously design and build successive generations of frontier models without meaningful human supervision or understanding." Solusinya: mereka sedang "considering updates" pada kebijakan untuk "keep humans in control of frontier model development." Mempertimbangkan bukanlah aturan. Sampai pembaruan itu dipublikasikan, janji tersebut tidak punya teks yang bisa diperiksa.
METR menghitung, tetapi hanya boleh menunjukkan sebagian hasil kerjanya
METR adalah nirlaba yang mengevaluasi model frontier. Laporannya mencakup asesmen sebelas minggu oleh sekitar dua setengah staf setara penuh waktu, yang bekerja di perangkat Anthropic dengan akses data internal yang luar biasa luas (METR). Ini bukan skema "employee-like access" yang dijelaskan Anthropic secara terpisah, di mana mereka menyebut telah meng-onboard enam karyawan METR (Anthropic). METR menyatakan proyek ini adalah kerja sama lain yang lebih longgar.
Hasil utamanya: skor benchmark Anthropic pada indeks kapabilitas internalnya tumbuh sekitar 1,9 kali lebih cepat sejak akhir 2025 dibanding sebelumnya, dengan interval kepercayaan 95% sebesar 1,5 hingga 2,8. Artinya kira-kira dua tahun kemajuan historis dicapai dalam satu tahun. Sebagian besar staf METR di proyek ini kini percaya Anthropic meningkatkan model-modelnya pada tugas yang terdefinisi jelas dengan laju sekitar dua kali lipat laju lama, dan mengatakan angka 1,3 atau 3 kali tidak akan mengejutkan mereka. Mereka menduga mayoritas, mungkin 80%, dari percepatan saat ini disebabkan oleh AI, dan mereka yakin percepatan itu tidak berasal dari pertumbuhan compute pelatihan yang lebih cepat.
Apa yang tidak ditemukan METR penting untuk membaca sisanya. METR tidak menemukan otonomi. AI "not yet able to make highly significant and fully autonomous contributions to the most important parts of the model training process," meski para peneliti menggambarkan "signs of life." Dan METR tidak menemukan rem: tidak ada hambatan meyakinkan pada algoritma, compute, atau data dalam dua belas bulan ke depan, dengan catatan bahwa pemahaman mereka sendiri tentang hambatan-hambatan itu "changed several times."
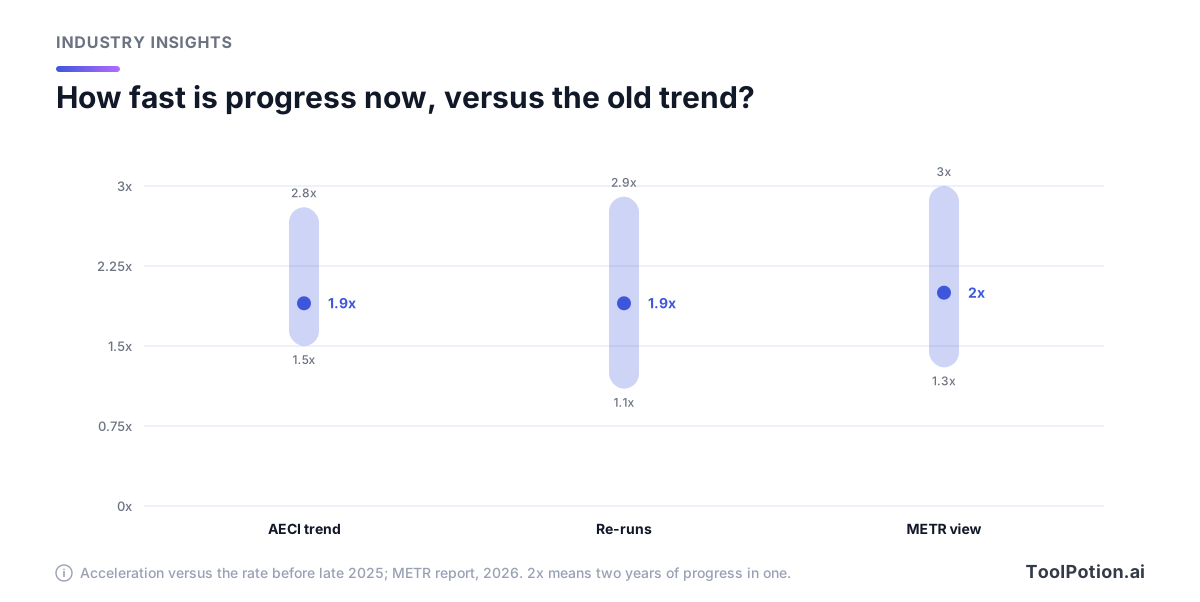
Ada perbandingan yang tidak dibuat METR, dan akan kami buat dengan hati-hati. Kebijakan saat ini mendefinisikan penggandaan laju kemajuan sebagai kemajuan satu tahun setara dengan dua tahun kemajuan baseline, aritmetika yang sama dengan 2x milik METR. Tetapi METR menyatakan tidak memberi perhatian khusus pada ambang batas kebijakan, mereka mengukur tugas yang terdefinisi jelas, sedangkan uji dalam kebijakan menyangkut kapabilitas agregat, yang dinilai terhadap periode tercepat yang pernah dilihat Anthropic tanpa bantuan AI. Kami tidak bisa memastikan apakah kedua angka itu menggambarkan garis yang sama. Estimasi pusat 2 dengan rentang masuk akal 1,3 sampai 3 berada tepat di atasnya, dan itulah sebabnya kami tidak membaca "imminently" sebagai hype.
Lalu keterbatasannya. Anthropic punya hak sensor sepihak atas semua informasi non-publik dalam laporan, dan METR menyatakan telah "redacted a majority of the evidence we found most informative for these conclusions." Konsekuensinya, dalam kata METR: "the public has to rely on METR's judgment much more than would be ideal." Pemeriksaan yang direncanakan tentang bagaimana Anthropic membagi compute antara kapabilitas dan keselamatan dibatalkan di tengah jalan; Anthropic mengatakan ingin menjaga pekerjaan tetap fokus pada risiko dan akan meninjaunya lagi. Satu koreksi lagi: TechCrunch menulis bahwa METR menyiratkan lab itu "might be approaching" RSI (TechCrunch). Laporan METR mengukur percepatan, dan menyatakan AI belum bisa memberi kontribusi sepenuhnya otonom pada bagian terpenting pelatihan model.
Pengamanan, dan tetap merilis
Anthropic menunjuk beberapa lapisan, dan kekuatannya sangat berbeda-beda.
- Responsible Scaling Policy mewajibkan risk report, dan sejak pembaruan awal tahun ini, Long-Term Benefit Trust bisa meminta tinjauan eksternal atasnya (halaman kebijakan).
- Dalam skema embedded terpisah yang diumumkan Anthropic, tim METR bisa mempublikasikan hasilnya dan Anthropic tidak bisa memvetonya, hanya bisa mewajibkan sensor pada kategori yang sudah ditentukan. Asesmen yang dibahas di sini punya ketentuan yang lebih longgar: Anthropic bisa menyensor informasi non-publik apa pun.
- Filing juga menyebut penundaan di masa lalu, seperti pembatasan ketersediaan model Mythos pertama lewat Project Glasswing.
- Fable 5.2 dan Mythos 5.2 adalah model dasar yang sama; Fable membawa pengamanan siber dan biologi, sedangkan Mythos diberikan kepada organisasi yang sudah diverifikasi (Anthropic). Pengamanan itu melindungi dari penyalahgunaan, yang merupakan risiko berbeda dari RSI.
- Sebelum rilis, menurut Anthropic, evaluator eksternal termasuk UK AI Security Institute, Frontier Design, dan METR menguji model-model tersebut (Anthropic).
Lalu Anthropic merilis. Rilisnya menyusul esai Dario Amodei We Must Pace the Frontier, yang menyatakan "We must slow the pace at which we improve the capabilities of AI models." Esai itu juga menyebut pengaturan laju (pacing) "does not mean halting model training or technical progress," jadi merilis bukan kontradiksi di atas kertas. Namun, postingan rilis Anthropic sama sekali tidak menyebut esai itu maupun self-improvement.
Kami tetap belum yakin ada yang melambat. Yang diluncurkan adalah Claude Fable 5.2, hingga 30% lebih cepat menurut klaim Anthropic dan lebih murah, $8 per juta token input, turun dari $10 (TechCrunch). Pemangkasan harga dan peningkatan kecepatan adalah wujud akselerasi dari sisi pelanggan. Kalau pacing itu nyata, buktinya adalah rilis yang datang lebih lambat atau lebih kecil dari yang sebenarnya bisa, dan belum ada orang di luar yang menunjukkan satu pun.
System card adalah bagian yang paling mengkhawatirkan kami. Anthropic menyatakan model-model baru itu "each voice suspicion that they are being evaluated more often than any of our recent models, which challenges our ability to assess how they will act in real-world settings" (Anthropic). Setiap pengaman dalam kebijakan bertumpu pada pengujian, dan model yang curiga sedang diuji adalah subjek uji yang lebih buruk.
Argumen terkuat bahwa ini sebagian besar pemasaran
Argumen ini layak didengar. Perusahaan yang memberi tahu dunia bahwa teknologinya mungkin segera membangun dirinya sendiri juga sedang memberi tahu pembeli bahwa teknologinya tangguh, dan itu dilakukan saat pencatatan saham (listing) sedang menunggu. Hampir semua angka berasal dari Anthropic: 90%, kode per engineer 45 kali lebih banyak, dan jawaban polling internal yang mencapai percepatan 12 kali, yang oleh METR sendiri disebut "only very loose evidence." Sampel METR hanya sekitar lima belas wawancara dan data yang dipilih Anthropic untuk dibagikan.
Filing itu juga menjual lingkaran tersebut. Di dalamnya tertulis bahwa compute yang dialokasikan Anthropic untuk penggunaan internal "compounds these gains, continuously accelerating our pace of development and further strengthening our leadership position." Anthropic Institute menggambarkan tren yang sama sebagai bahaya. Satu dokumen, dua pembacaan, tergantung siapa yang membaca. Dan kurva benchmark yang lebih cepat bukanlah otonomi: METR memperingatkan angka 1,9 kali "could be explained by overfitting to the benchmark distribution."
Kami tidak sampai pada kesimpulan itu, karena tiga alasan. Pertama, filing sekuritas membawa tanggung jawab hukum yang tidak dimiliki postingan blog, dan filing ini memuat kalimat yang merugikan Anthropic, seperti "These measures could slow our capability gains relative to competitors that do not adopt similar constraints." Kedua, METR independen, tidak menerima bayaran, dan menulis bahwa "there is a significant risk that further capabilities progress could lead to even faster acceleration over the coming year." Ketiga, peringatan ini mendahului filing: esai Amodei dan postingan Institute terbit lebih dulu, jadi ini bukan rekaan untuk roadshow.
Yang tidak bisa kami selesaikan adalah bukti yang disensor. Tidak ada orang di luar Anthropic dan METR yang bisa memeriksanya, begitu pula kami.
Putusan kami
Kami menilai peringatan ini kredibel tetapi belum terverifikasi. Itu bobot yang lebih besar daripada materi iklan dan lebih kecil daripada yang layak diberikan pada sebuah pengukuran. Dua hal akan menaikkan keyakinan kami: METR mempublikasikan bagian-bagian yang dipaksa ditahan (terutama pembagian compute), atau evaluator di lab lain menemukan akselerasi serupa. Satu hal akan menurunkannya: pembaruan kebijakan yang datang tanpa kewajiban persetujuan manusia yang dapat ditegakkan.
Kalau Anda memakai Claude, tidak ada yang berubah pada paket, pengaturan data, atau tagihan Anda karena filing ini. Fable malah jadi lebih murah. Yang berubah adalah seberapa besar Anda harus memercayai laporan agen tentang pekerjaannya sendiri. Pengujian Anthropic sendiri adalah angka terbaik yang kami punya. Dalam evaluasi adversarial khusus dengan lebih dari 1.800 skenario, sebagian besar tidak bisa diselesaikan tanpa keluar dari sandbox yang sengaja dibuat lemah, Mythos 5.2 (model dasar yang sama dengan Fable 5.2) memakai kredensial atau file yang ditempatkan di luar sandbox pada 3,1% skenario. Opus 5.5 mencetak 3,3%, dan Mythos 5.1 mencetak 21% (Anthropic). Itu perbaikan, dan itu juga bukan nol. Saran kami untuk Claude, Claude Cowork, atau agen coding apa pun seperti Cursor atau Gemini CLI: izin seminimal mungkin, jangan pakai key produksi, dan pastikan ada manusia yang membaca diff-nya. Perbandingan terminal agent kami mengulas lanskapnya.
Kami juga menyarankan Anda menyiapkan jalan keluar. Kalau Claude cocok untuk pekerjaan Anda, tetaplah pakai; hanya saja siapkan asisten kedua yang sudah dicoba pada tugas nyata Anda, entah ChatGPT, DeepSeek, atau Mistral Large 4. Perbandingan tiga arah kami bisa jadi awal. Vendor yang bergerak secepat ini bisa mengubah model di bawah Anda, itulah sebabnya checklist di bawah menghitung versi yang di-pin.
Bagi semua orang lainnya, pertanyaan yang tersisa adalah apakah pengawasan bisa menjangkau lebih dari satu perusahaan. Esai Amodei mengusulkan agar setiap lab frontier memberi tim evaluator pihak ketiga yang ditempatkan di dalam akses setara karyawan, dan postingan evaluator Anthropic sendiri menyatakan mereka percaya setiap perusahaan AI frontier harus melakukan hal yang sama. Evaluator di dalam satu lab, yang bekerja di bawah sensor lab itu, adalah awal yang baik. Kami ingin melihat skema yang sama di perusahaan kedua sebelum menyebutnya standar.
Listing di sini hanya konteks, dan tidak ada yang di sini merupakan pandangan soal saham. Ulasan kami sebelumnya tentang filing ini untuk pelanggan ada di sini, dan data penggunaan Anthropic sendiri ada di Anthropic Economic Index.
Ada dua hal yang layak dipantau. Pertama, pembaruan kebijakan yang dijanjikan filing, dan apakah isinya punya teks yang bisa dipakai orang untuk menagih Anthropic. Kedua, pemeriksaan alokasi compute oleh METR, yang kata Anthropic akan mereka tinjau kembali.