

Klaim "#1 di leaderboard" hanya benar untuk satu tes tertentu, yang dijalankan dengan cara tertentu, pada hari tertentu. Klaim itu belum tentu menunjukkan bahwa model tersebut yang terbaik untuk pekerjaan Anda. Sebelum berpindah tool atau membayar paket yang lebih mahal gara-gara sebuah peringkat, cari tahu dulu dari board mana peringkat itu berasal, siapa yang menjalankannya, dan apa yang diukurnya.
Hal ini makin penting di 2026 karena leaderboard sudah menjadi bisnis. Arena, situs peringkat publik yang dulu bernama LMArena, tahun ini mengumpulkan dana $200 juta dengan valuasi $3,1 miliar, hampir dua kali lipat dari valuasi $1,7 miliar di awal 2026 (Phemex). Arena menyatakan pendapatan tahunannya (annualized revenue) sudah melewati $100 juta (Arena). Kini setiap peluncuran model dibuka dengan peringkat, dan peringkat itu membantu penjualan.
Bukan berarti board-board ini palsu. Sebagian besar dibuat oleh orang-orang serius dan memang mengukur sesuatu yang nyata. Masalahnya, setiap board mengukur hal yang berbeda, dan postingan peluncuran akan mengutip board mana pun yang paling menguntungkan modelnya. Panduan ini menjelaskan cara kerja board-board utama, di mana kelemahan masing-masing, dan cara membaca sebuah klaim dalam sekitar dua menit.
Empat jenis board, empat pertanyaan berbeda
Sebagian besar peringkat yang akan Anda temui masuk ke salah satu dari empat kelompok. Kelompok ini lebih penting daripada board mana pun, karena sebuah angka baru bermakna setelah Anda tahu berasal dari kelompok mana.
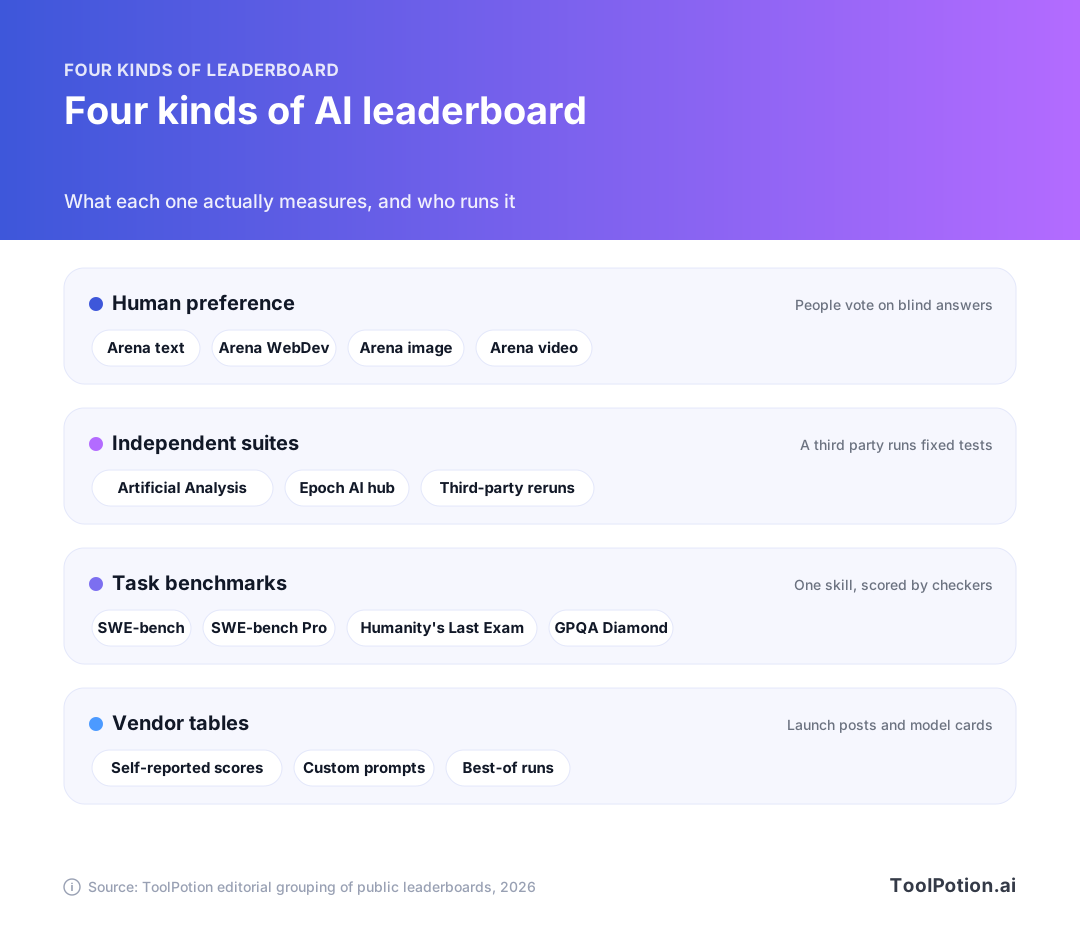
Arena preferensi manusia menanyakan kepada orang jawaban mana yang lebih mereka sukai. Suite independen menjalankan serangkaian tes yang sama pada setiap model dalam kondisi yang sama. Benchmark tugas menguji satu keterampilan, misalnya memperbaiki bug perangkat lunak yang nyata, dengan penilai otomatis. Tabel vendor adalah skor yang dicantumkan lab di postingan peluncuran atau model card miliknya sendiri, biasanya dengan pengaturan yang dipilih lab itu.
Kelompok-kelompok ini tidak saling bersaing, melainkan menjawab pertanyaan yang berbeda. Preferensi menunjukkan model mana yang enak diajak ngobrol. Suite menunjukkan bagaimana model dibandingkan ketika pihak netral yang memegang stopwatch. Benchmark tugas menunjukkan apakah model bisa mengerjakan satu pekerjaan sempit. Tabel vendor menunjukkan apa yang ingin lab itu Anda perhatikan.
| Jenis board | Contoh | Yang diukur | Kelemahan utama |
|---|---|---|---|
| Preferensi manusia | Arena text dan WebDev | Jawaban mana yang dipilih lewat voting | Menguntungkan gaya dan panjang jawaban, bisa dimanipulasi |
| Suite independen | Artificial Analysis, hub Epoch AI | Skor pada set tes yang tetap | Hanya sebaik tes yang dipilihnya |
| Benchmark tugas | SWE-bench, Humanity's Last Exam | Satu keterampilan dengan penilaian otomatis | Kontaminasi, tugas bermasalah, saturasi |
| Tabel vendor | Postingan peluncuran, model card | Apa pun yang dipilih lab untuk dilaporkan | Pengaturan dan prompt yang tidak bisa Anda periksa |
Bagaimana satu suara di arena menjadi rating
Arena bermula sebagai Chatbot Arena, proyek riset di UC Berkeley. Idenya sederhana. Anda mengetik prompt, dua model anonim menjawab, lalu Anda memilih jawaban yang lebih baik. Makalah asli para peneliti menjelaskan platform yang dalam beberapa bulan pertama sudah mengumpulkan lebih dari 240.000 suara dan menemukan bahwa suara kerumunan sejalan dengan penilaian para ahli (arXiv).
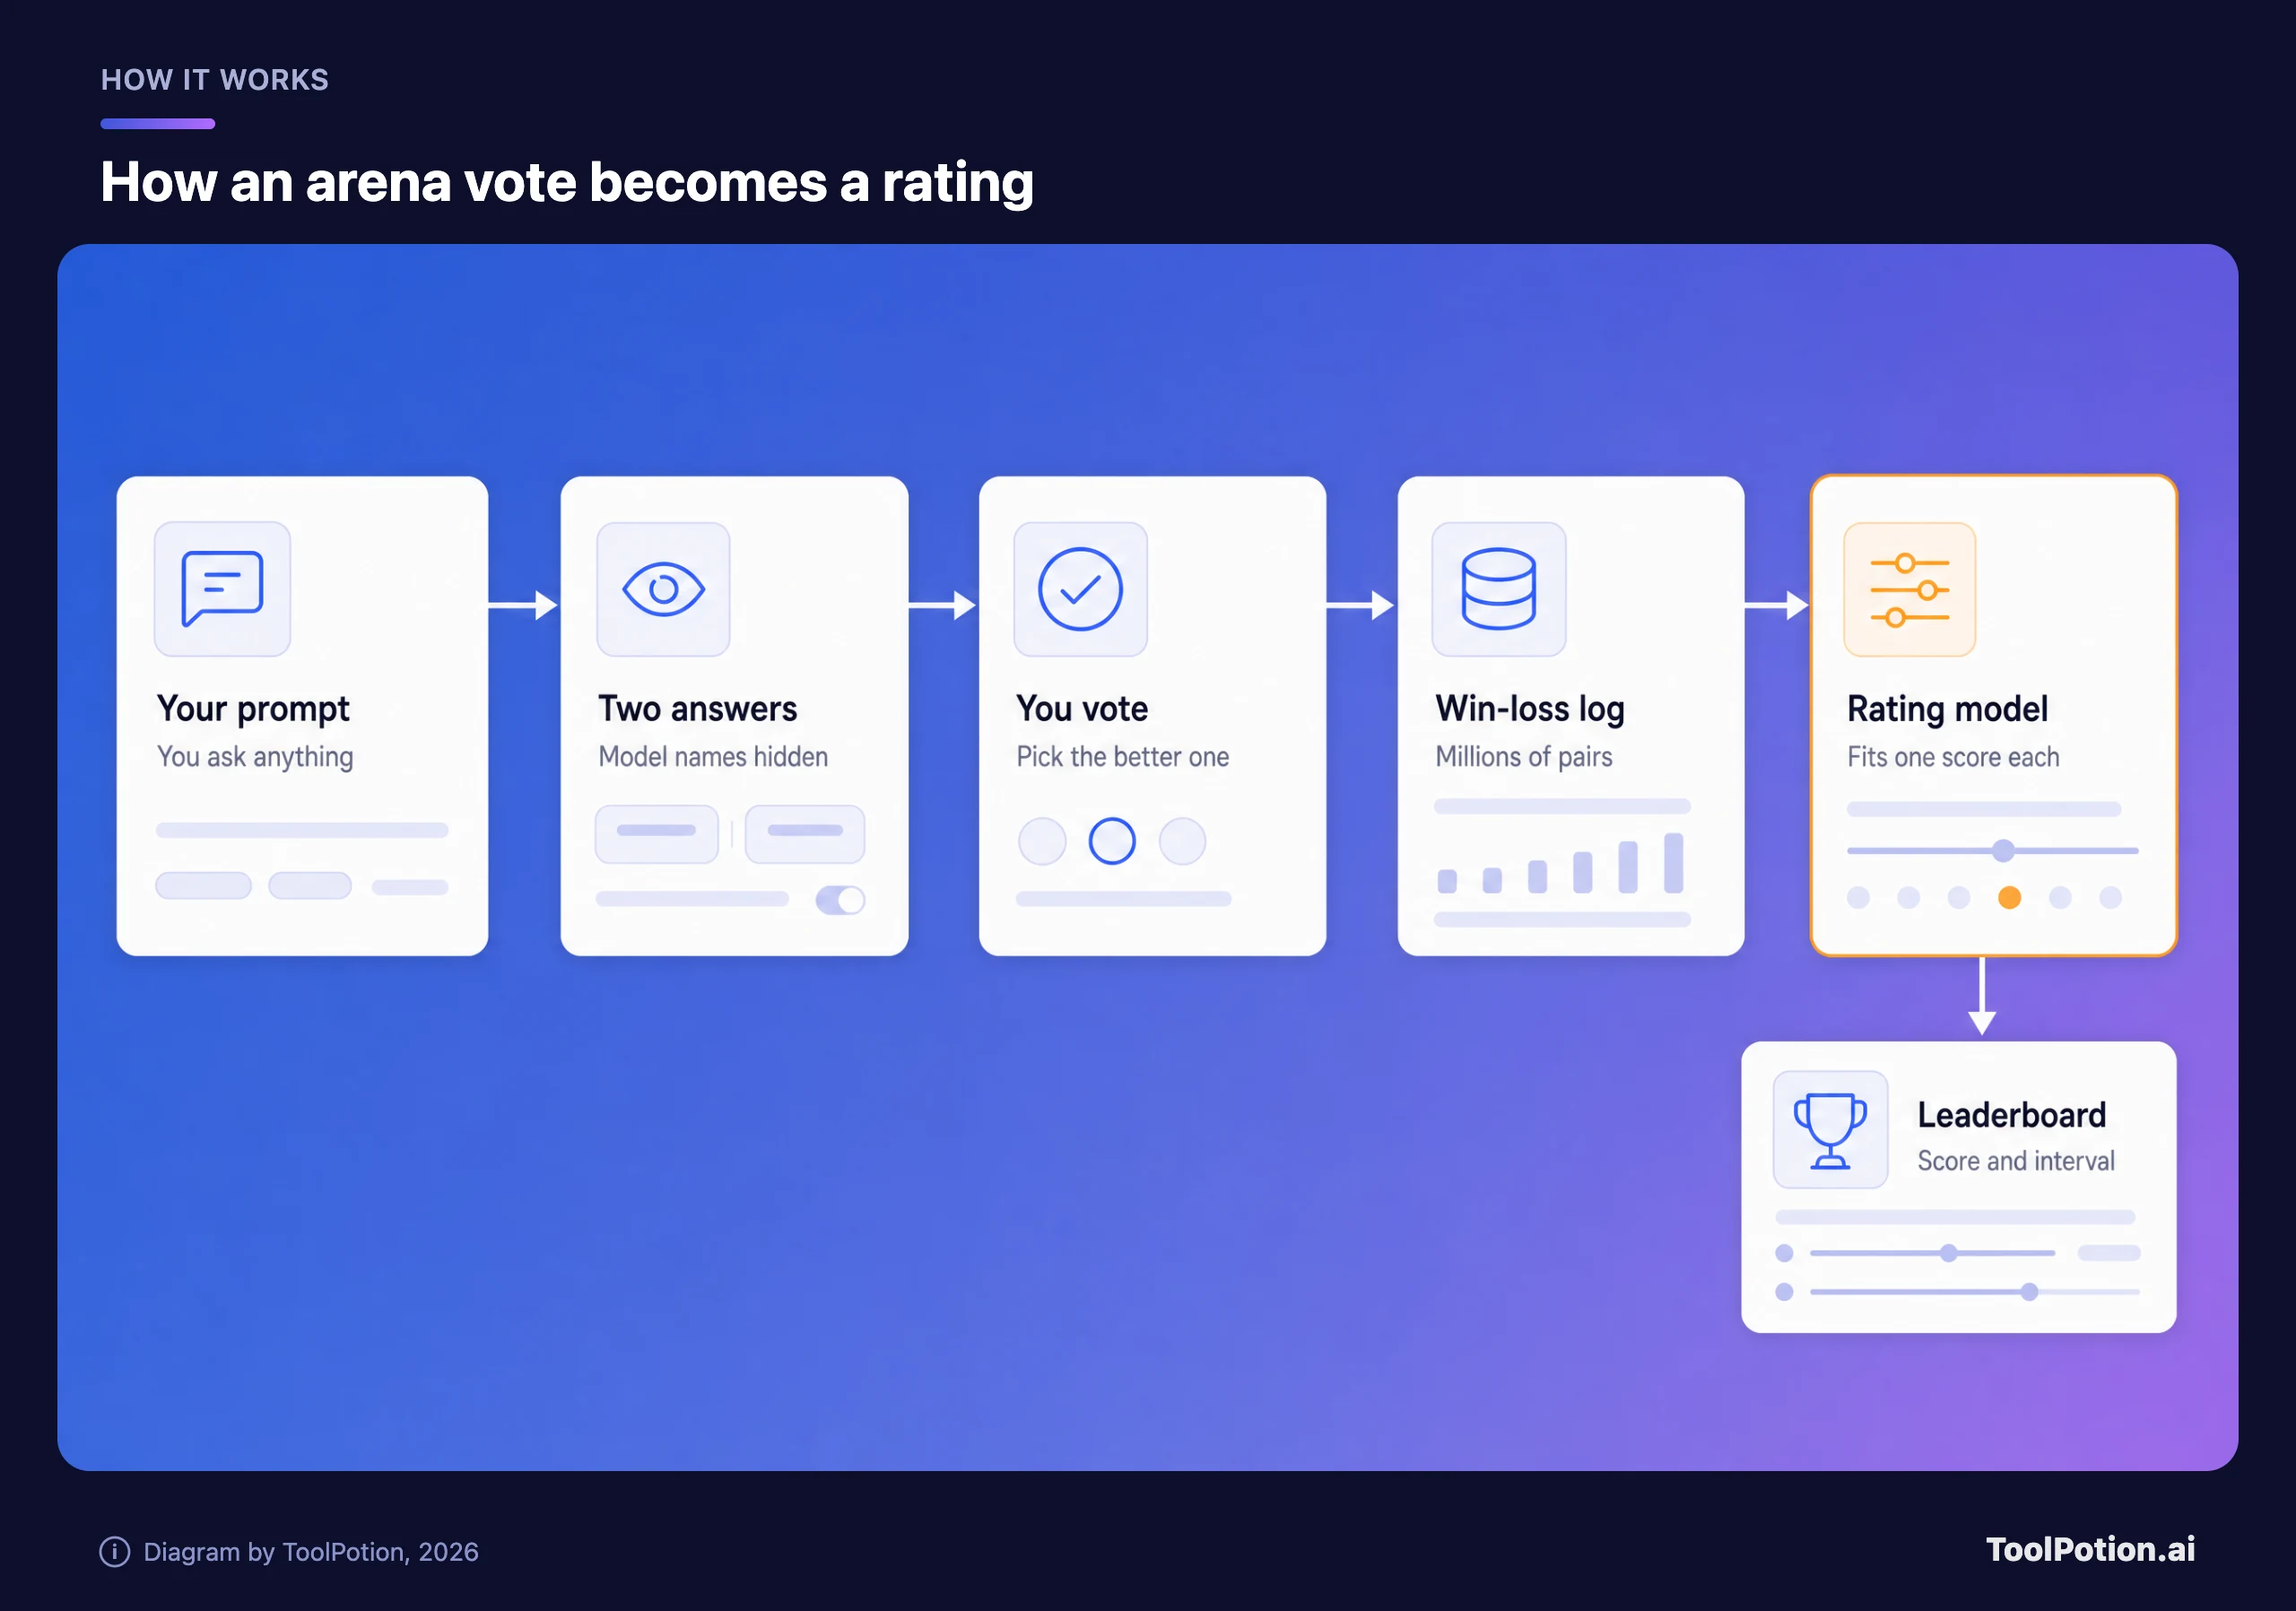
Setiap suara adalah satu catatan kecil: model A mengalahkan model B pada prompt ini. Jutaan catatan semacam itu dimasukkan ke model statistik yang memberi setiap model satu skor. Tulisan Arena sendiri menyebut metodenya regresi Bradley-Terry, kerabat dekat sistem Elo yang dipakai di catur (LMSYS). Skor model naik saat mengalahkan lawan yang kuat dan turun saat kalah dari lawan yang lemah, dan leaderboard text menampilkan interval di samping setiap skor (angka "±"), bukan hanya estimasi titiknya.
Interval itulah yang dilewatkan postingan peluncuran. Jika dua model hanya selisih beberapa poin dan intervalnya tumpang tindih, bacaan yang jujur adalah seri. Klaim "#1" yang bertumpu pada selisih dua atau tiga poin biasanya hanya lemparan koin statistik.
Arena juga sudah berkembang jauh melampaui chat. Leaderboard-nya kini punya board terpisah untuk text, WebDev, vision, search, pembuatan dan pengeditan gambar, serta video, ditambah board agent yang lebih baru yang melaporkan biaya per tugas di samping win rate (Arena). Kolom biaya ini layak dibaca. Model yang peringkatnya satu tingkat lebih tinggi tetapi harganya beberapa kali lipat adalah rekomendasi yang berbeda.
Yang tidak bisa dijawab oleh arena
Voting preferensi punya tiga masalah yang sudah terdokumentasi dengan baik. Pertama, gaya. Orang suka jawaban yang panjang dan rapi formatnya, sehingga model bisa naik peringkat hanya dengan menulis lebih banyak dan menambahkan heading. Analisis tim Arena sendiri menemukan bahwa panjang jawaban adalah efek gaya yang paling dominan, dan koreksi terhadap panjang dan markdown mengubah urutan model. Dalam analisis 2024 itu, GPT-4o-mini turun dari peringkat enam ke sebelas, sementara Claude 3.5 Sonnet naik dari enam ke empat (LMSYS). Arena kini menyediakan tampilan dengan kontrol gaya (style-controlled), dan sebaiknya Anda memakainya.
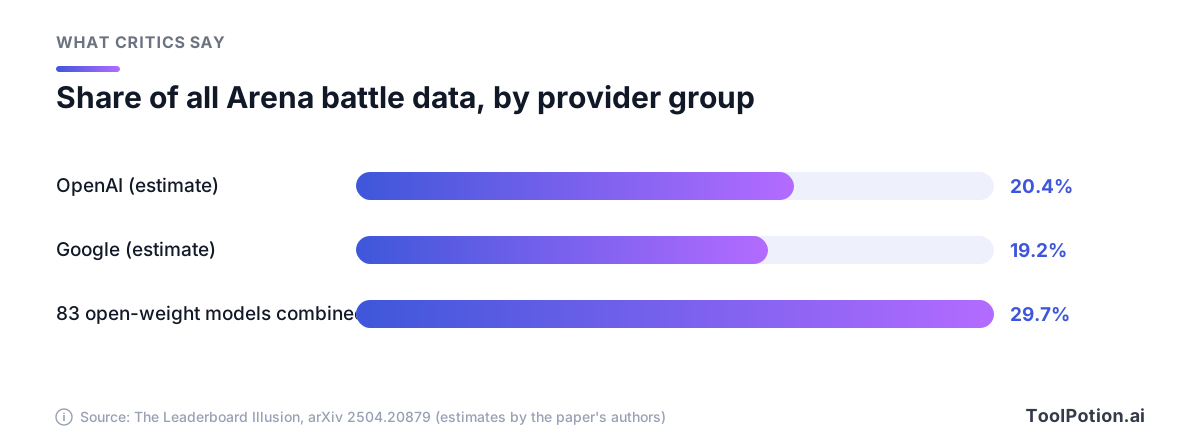
Masalah kedua adalah akses. Makalah 2025 berjudul "The Leaderboard Illusion", dengan penulis antara lain Sayash Kapoor dan Noah Smith, berargumen bahwa lab-lab besar mendapat keuntungan struktural di Arena. Makalah itu melaporkan bahwa Meta menguji 27 varian model privat sebelum rilis Llama 4 dan hanya mempublikasikan skor terbaik, serta memperkirakan Google dan OpenAI masing-masing menerima sekitar 19,2% dan 20,4% dari seluruh data Arena, sementara 83 model open-weight secara total hanya menerima sekitar 29,7% (arXiv).
Makalah itu juga melaporkan bahwa pelatihan dengan data bergaya Arena dapat mengangkat performa pada distribusi Arena hingga 112%, yang menjadi insentif untuk menyetel model demi board, bukan demi kemampuan umum. Ini adalah estimasi dan klaim para penulis, dan mencerminkan kondisi saat makalah ditulis. Meski begitu, ini tetap gambaran dari pihak luar yang paling jelas tentang bagaimana board preferensi bisa dimanipulasi tanpa ada yang melanggar aturan.
Masalah ketiga, preferensi bukanlah kebenaran. Jawaban yang percaya diri dan ramah bisa memenangkan voting meski berisi fakta yang salah. Untuk nuansa chat dan tulisan, preferensi adalah panduan yang cukup adil. Untuk kode yang harus berjalan atau angka yang harus benar, panduan ini lemah.
Halaman kebijakan Arena saat ini menjawab sebagian masalah ini. Disebutkan bahwa model pra-rilis diuji dengan nama anonim sampai skornya stabil (minimal 1.000 suara), skor tersebut dibagikan secara privat kepada penyedia model, dan skor model ditandai "preliminary" setelah rilis publik sampai ada suara baru yang masuk. Disebutkan juga bahwa setiap battle melibatkan setidaknya satu model yang tersedia untuk publik dan bahwa setidaknya 20% battle hanya melibatkan model publik (Arena). Aturan praktisnya: tag "preliminary" berarti angkanya belum final.
Suite independen: Artificial Analysis dan Epoch AI
Jika board preferensi menanyakan apa yang disukai orang, suite independen menanyakan apa yang bisa dilakukan model ketika semuanya mendapat tes yang sama. Artificial Analysis adalah yang paling dikenal. Intelligence Index-nya, kini di versi 4.3.2, menggabungkan 10 evaluasi dalam empat kelompok: agent (bobot 30%), pengetahuan umum dan penalaran (30%), coding (20%), dan penalaran ilmiah (20%). Setiap model dijalankan dalam kondisi yang sama dengan penilaian pass@1, artinya satu percobaan per pertanyaan, dan situsnya menyatakan menyimpan salinan dataset sendiri. Untuk penilaian subjektif, situs ini memakai panel tiga model frontier dari lab yang berbeda. Indeks ini sebagian besar berbahasa Inggris dan berbasis teks, dan kemampuan multibahasa serta multimodal diukur secara terpisah (Artificial Analysis).
Pembobotan adalah pilihan editorial. Bobot yang berbeda, dengan porsi agent lebih kecil dan coding lebih besar, akan mengubah urutan beberapa model. Itu bukan cacat, tetapi artinya angka "keseluruhan" hanyalah satu opini tentang apa yang penting. Jika Anda terutama peduli pada coding, baca hasil coding-nya, bukan angka utamanya.
Epoch AI menjalankan hub benchmark yang memadukan tes yang dijalankannya sendiri, seperti GPQA Diamond, FrontierMath, dan SWE-bench Verified, dengan hasil dari sumber luar. Temuannya yang paling berguna bagi pembaca menyangkut angka dari vendor. Claude 3.5 Sonnet dilaporkan meraih 65% di GPQA Diamond. Epoch mengukur 55%, plus minus 3, dalam 16 kali run, dan mencatat bahwa lab sering tidak mempublikasikan prompt atau temperature yang mereka pakai (Epoch AI). Selisih 10 poin hanya karena setup adalah alasan kuat untuk lebih memilih run ulang oleh pihak ketiga. Hub ini didanai oleh UK AI Security Institute dan datanya bebas dipakai ulang.
Independen bukan berarti tanpa bias. Pihak ketiga tetap memilih tesnya, dan indeks apa pun yang memakai LLM sebagai juri akan mewarisi kebiasaan juri tersebut. Studi Arena sendiri tentang juri AI menemukan bahwa model cenderung menyukai jawabannya sendiri. Dalam 1.460 battle Text Arena yang dinilai oleh 12 model, para juri memilih jawaban mereka sendiri sekitar 70% lebih sering daripada manusia (Arena).
Benchmark bisa usang
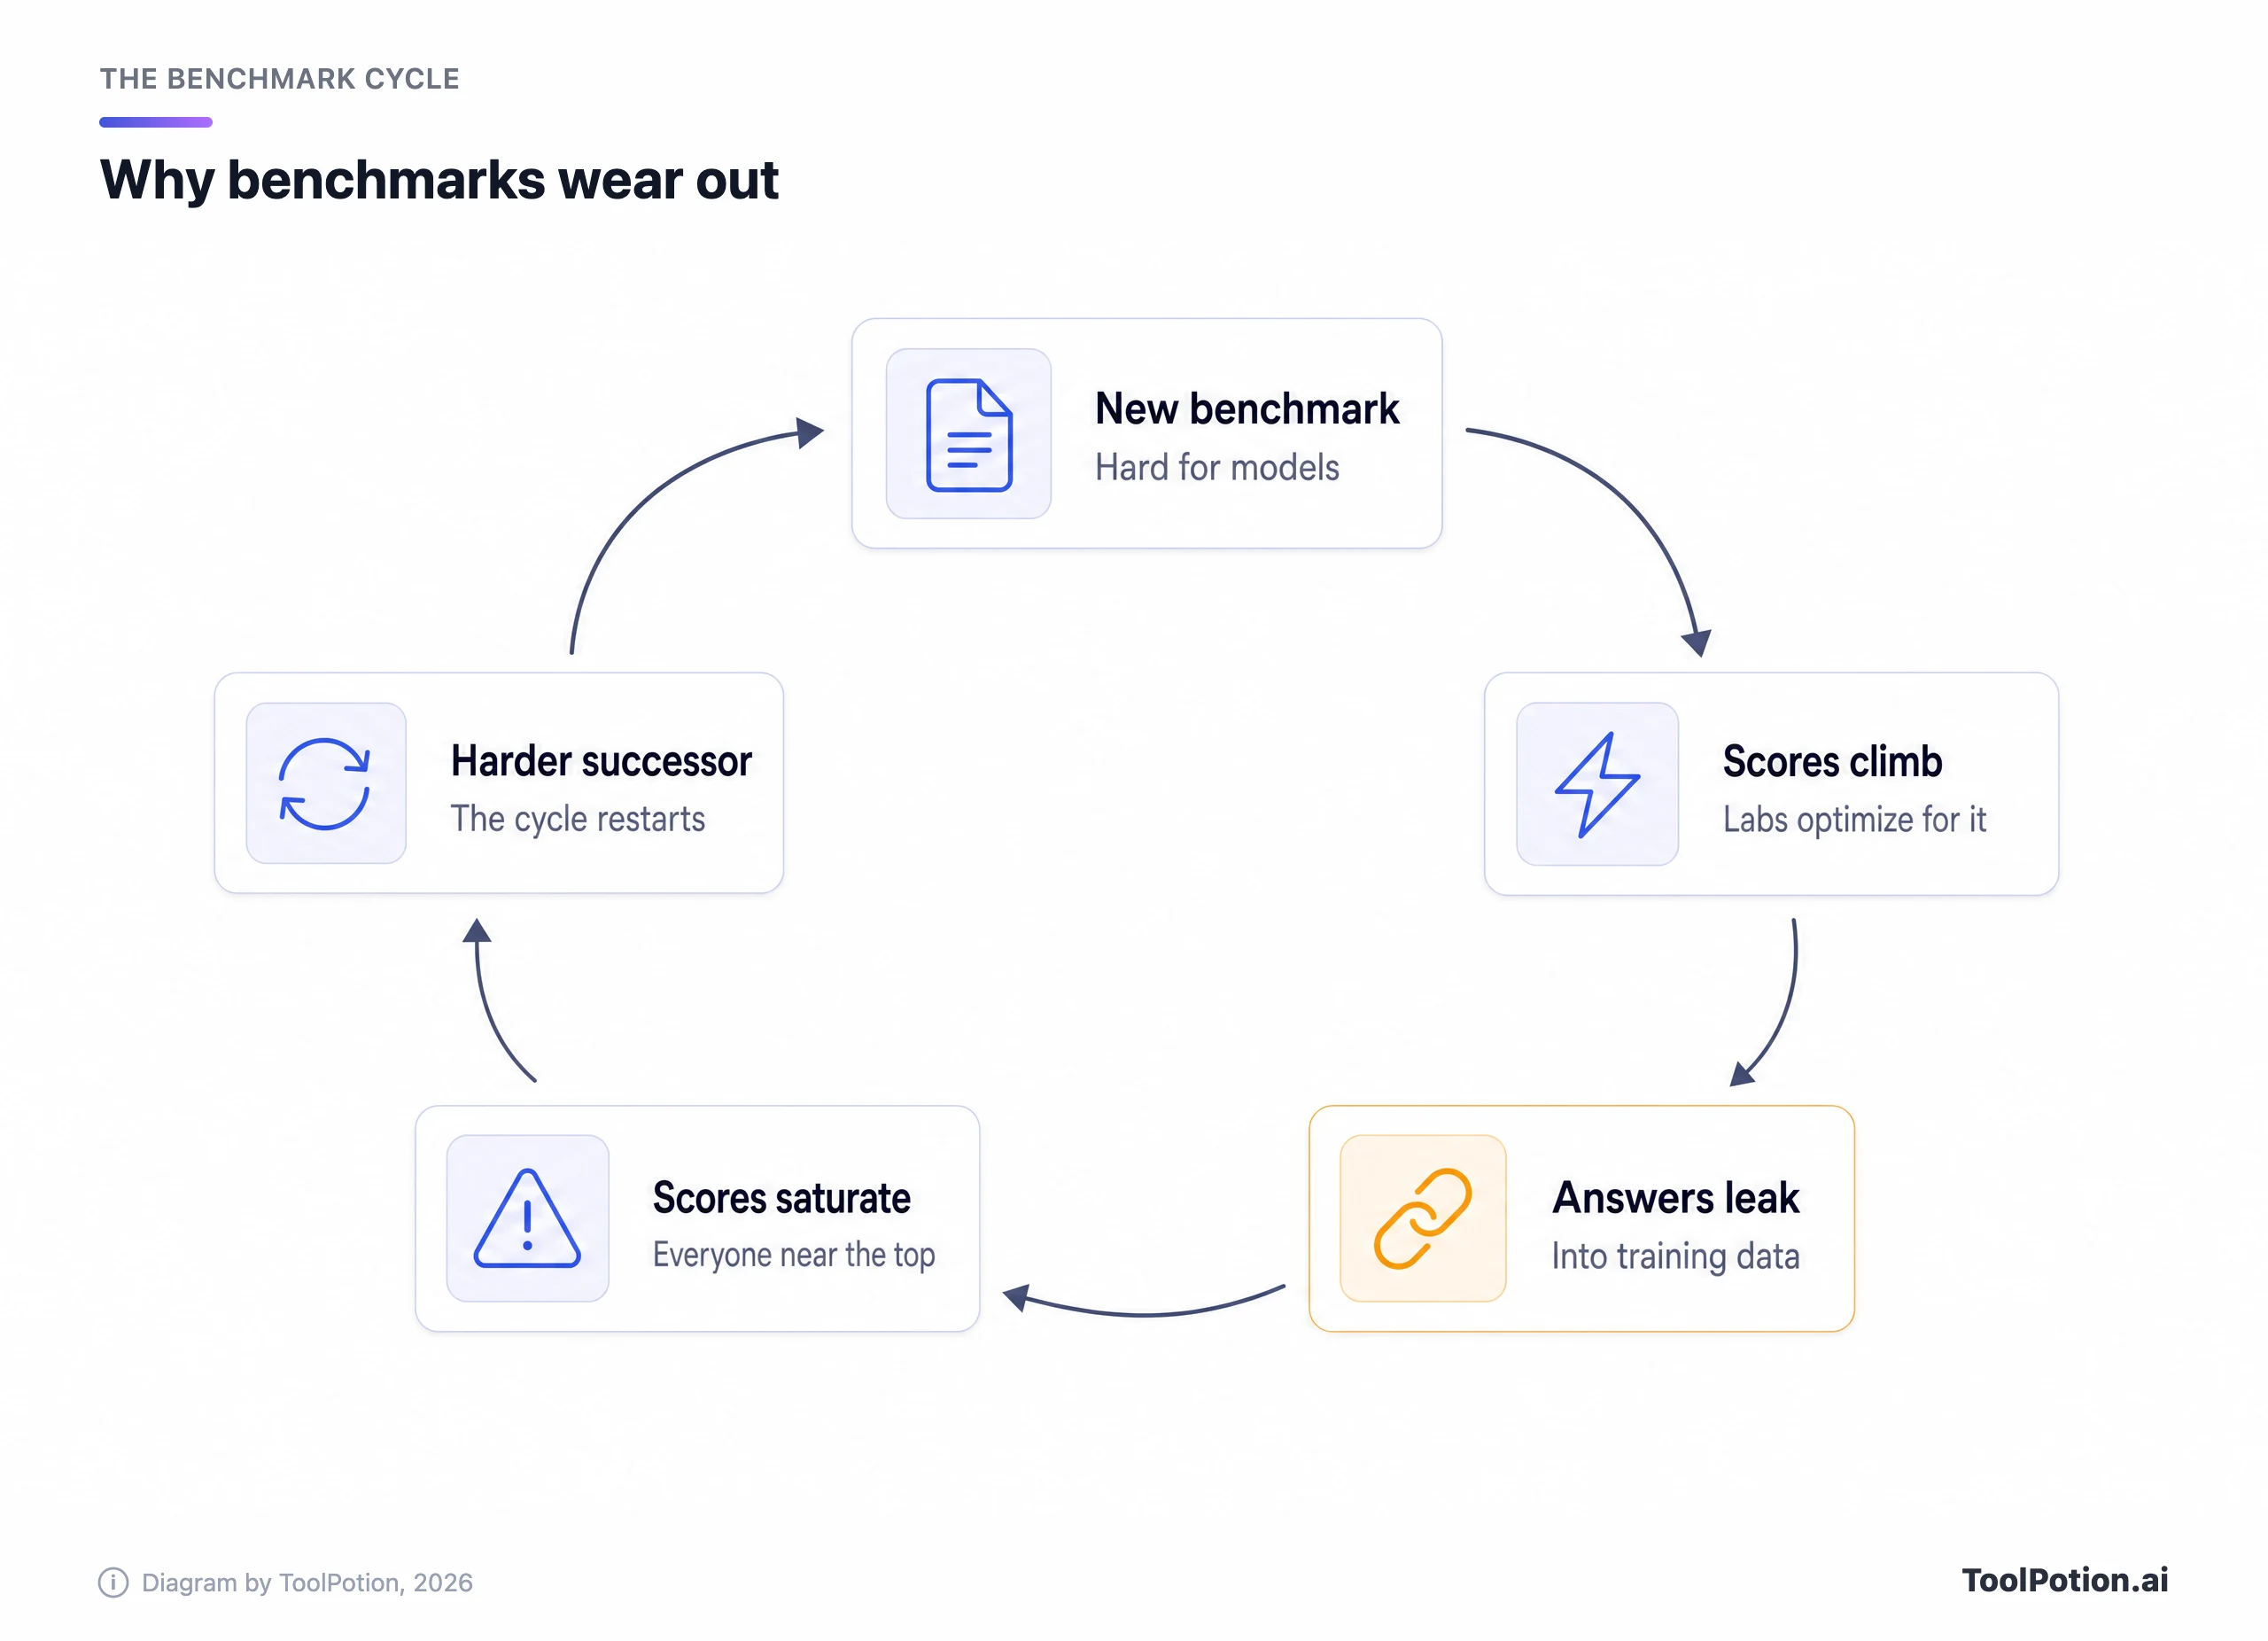
Benchmark tugas punya masalah yang berlawanan. Mereka objektif, tetapi cepat menua. Benchmark diluncurkan dalam keadaan sulit, lab mengoptimalkan modelnya untuk itu, skor naik, tes bocor ke data pelatihan, dan tak lama kemudian semua model teratas berada di dekat batas atas sehingga peringkatnya tidak lagi bermakna.
Humanity's Last Exam adalah contoh yang baik dari respons terhadap masalah ini. Isinya 2.500 pertanyaan dari lebih dari seratus bidang, ditulis oleh hampir 1.000 pakar dari lebih dari 500 institusi, dan memiliki set tes privat untuk mendeteksi overfitting. Para penulisnya membuatnya karena tes lama seperti MMLU sudah didorong melewati 90% oleh model frontier (arXiv). Benchmark ini diterbitkan di Nature pada 2026, dan para penciptanya sendiri memperkirakan skornya akan naik cepat.
SWE-bench memperlihatkan siklus hidup yang lengkap. Benchmark aslinya berisi 2.294 issue GitHub nyata dari 12 proyek Python, dan model terbaik saat itu, Claude 2, menyelesaikan 1,96% di antaranya (menurut makalah aslinya). Subset 500 tugas yang sudah dibersihkan, bernama Verified, menjadi angka standar dalam peluncuran model coding. Lalu datang audit.
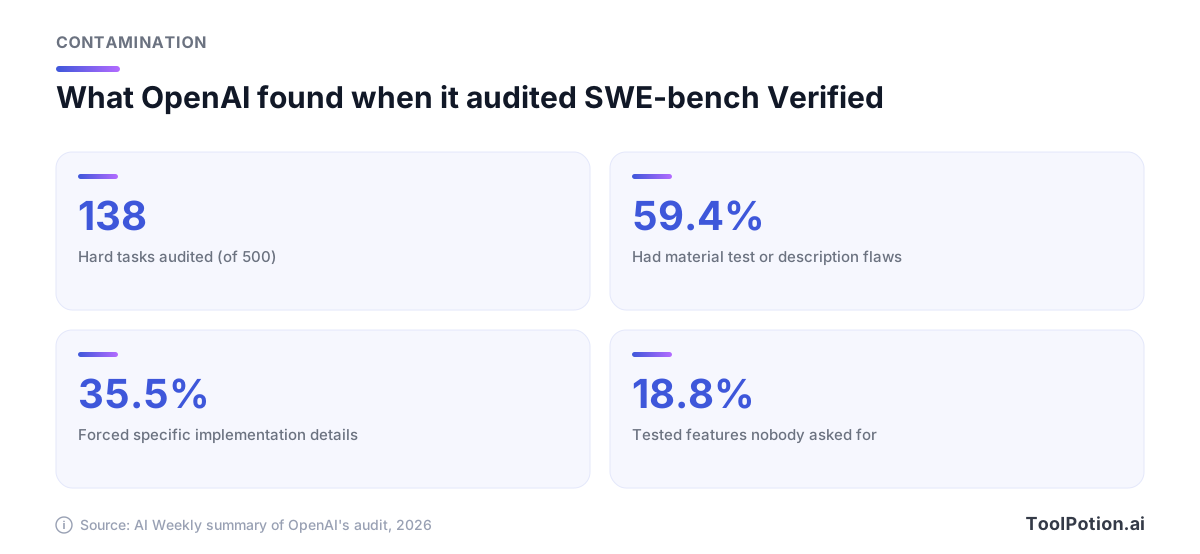
OpenAI mengaudit 138 soal Verified yang tidak bisa diselesaikan secara konsisten oleh model o3-nya, masing-masing ditinjau oleh setidaknya enam insinyur. Hasilnya, 59,4% punya masalah material pada tes atau deskripsinya. Dalam uji kontaminasi terpisah, GPT-5.2, Claude Opus 4.5, dan Gemini 3 Flash Preview masing-masing mampu mereproduksi detail perbaikan aslinya, tanda bahwa tugas-tugas itu sudah bocor ke data pelatihan. OpenAI menyatakan sudah berhenti melaporkan skor Verified dan merekomendasikan SWE-bench Pro sebagai gantinya (OpenAI). Ringkasan AI Weekly menambahkan bahwa model teratas berada di sekitar 80% pada Verified dan kira-kira 35 poin lebih rendah pada Pro, serta bahwa audit eksternal yang lebih baru mempertanyakan penilai Pro juga (AI Weekly).
Pelajarannya bukan bahwa benchmark coding tidak berguna. Skor dari tes yang sudah dipensiunkan atau bocor adalah angka lama. Saat postingan peluncuran mengutip SWE-bench, periksa variannya, dan periksa scaffolding agent apa yang membungkus modelnya. Studi "HarnessTax" dari Arena terhadap 21 pasangan model dan scaffolding menemukan bahwa pilihan scaffolding hanya sedikit memengaruhi keberhasilan tugas, tetapi mengubah biaya hingga 5x untuk hasil yang mirip, pada sampel kecil 30 tugas per benchmark (Arena).
Checklist untuk klaim #1 apa pun
Berikut versi dua menitnya. Jalankan sebelum Anda memercayai sebuah peringkat, terutama sebelum mengeluarkan uang karenanya.
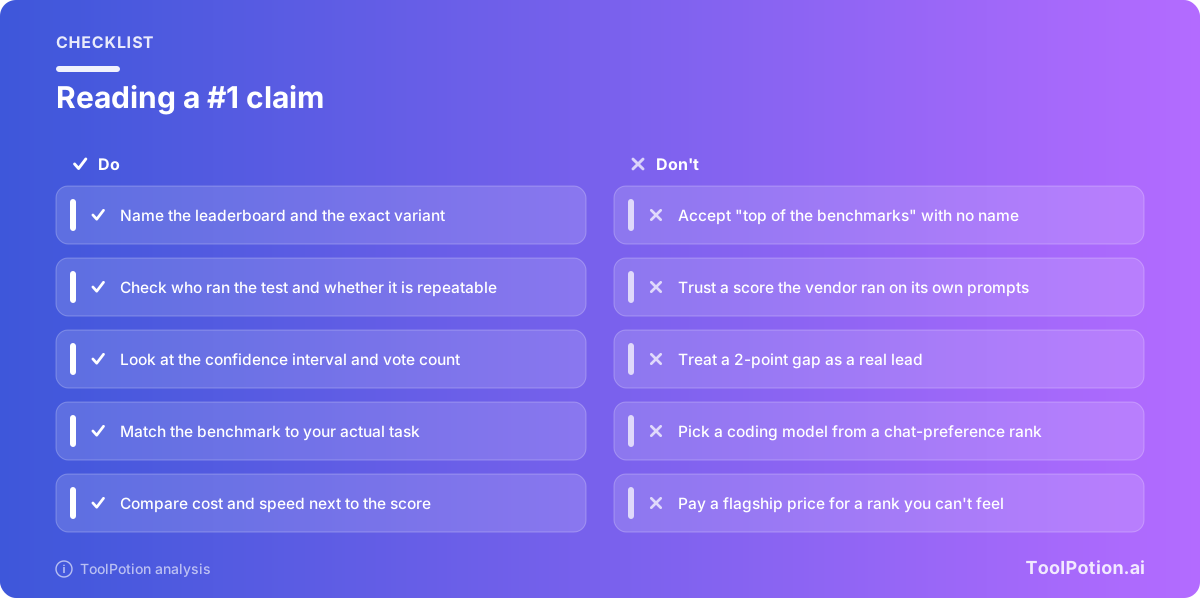
- Cari tahu board dan versi yang persis. "Memimpin semua benchmark" bukan klaim yang bisa diperiksa. "Peringkat pertama di Arena text dengan style control" bisa.
- Cari tahu siapa yang menjalankannya. Run oleh lab sendiri dengan prompt miliknya adalah angka marketing. Run ulang oleh pihak ketiga lebih berbobot.
- Baca interval dan jumlah suaranya. Jika selisih keunggulannya lebih kecil dari interval, itu seri.
- Periksa apakah modelnya sudah publik. Skor untuk sesuatu yang belum bisa Anda coba hari ini tidak membantu Anda memilih.
- Tanyakan apakah tesnya sesuai dengan tugas Anda. Preferensi chat tidak akan memprediksi bagaimana model menangani spreadsheet atau codebase Anda.
- Cari board kedua yang berbeda dan sependapat. Satu board bisa salah atau dimanipulasi. Dua board yang tidak berhubungan dan sama-sama sependapat jauh lebih sulit dipalsukan.
- Letakkan harga dan kecepatan di samping skor. Model yang lebih murah dan berada dua peringkat lebih rendah sering kali pembelian yang lebih baik.
Anda bisa menilai sebuah klaim sendiri dengan checklist di bawah ini. Bobotnya condong ke hal-hal yang paling sulit dipalsukan, seperti run pihak ketiga dan kesesuaian antarboard.
Sesuaikan board dengan pertanyaan Anda
Karena tiap board menjawab pertanyaan yang berbeda, langkah yang berguna adalah mulai dari pertanyaan Anda, baru pilih boardnya. Jika Anda memilih asisten untuk menulis dan percakapan, arena preferensi adalah filter awal yang layak. Jika Anda ingin perbandingan kemampuan mentah yang bisa diulang, pakai suite independen. Jika Anda memilih tool coding, lihat benchmark tugas yang dibangun dari repositori nyata, lalu uji pada kode Anda sendiri.
Pohon keputusan ini hanya titik awal, bukan vonis. Board mana pun yang akhirnya Anda pilih, tes singkat pada pekerjaan Anda sendiri lebih baik daripada peringkat publik mana pun. Ambil 10 tugas nyata yang Anda kerjakan tiap minggu, jalankan di dua atau tiga finalis, lalu bandingkan hasilnya berdampingan. Cukup satu sore, dan ini mengukur satu hal yang tidak bisa diukur leaderboard mana pun, yaitu pekerjaan Anda.
Untuk memilih per kategori, direktori AI Models & LLMs dan board model AI di ToolPotion menampilkan model secara berdampingan, dan panduan mencocokkan tier model AI dengan tugas membahas kapan model flagship layak dibayar. Untuk rangkuman yang lebih luas, lihat Top 15 AI Models & LLMs in 2026, atau alternatif ChatGPT di 2026 jika satu asisten menjadi titik awal Anda.
Di mana angka paling tidak bisa diandalkan
Beberapa situasi menuntut kecurigaan ekstra. Model baru di hari-hari pertamanya punya lebih sedikit suara dan interval yang lebih lebar, dan Arena menandai skor itu preliminary dengan alasan yang jelas. Model open-weight, jenis yang bisa Anda unduh dari Hugging Face, adalah titik buta lainnya: para penulis Leaderboard Illusion memperkirakan mereka mendapat porsi data Arena yang lebih kecil, sehingga skornya bisa lebih berfluktuasi. Model yang di-host juga bisa berubah perilakunya dengan nama yang sama, jadi skor dari minggu peluncuran mungkin tidak menggambarkan model yang Anda pakai berbulan-bulan kemudian.
Pekerjaan spesialis adalah celah terbesar. Penyusunan dokumen hukum, pengkodean medis, bahasa yang niche, dan codebase internal perusahaan semuanya kurang tercakup oleh board publik. Real-SWE Benchmark adalah salah satu jawabannya: benchmark ini mengevaluasi model frontier pada codebase enterprise privat, yang lebih kecil kemungkinannya bocor ke data pelatihan dibandingkan repositori publik. Anggaplah board seperti itu sebagai second opinion yang berguna, bukan pengganti tes Anda sendiri.
Dan kalau Anda pengguna kasual, Anda mungkin tidak butuh semua ini. Untuk menulis dan bertanya sehari-hari, beberapa model teratas dari OpenAI, Anthropic, dan Google cukup berimbang, sehingga pilihannya akan ditentukan oleh harga, antarmuka, dan kebiasaan. Menghabiskan satu jam membaca peringkat hanya untuk memilih di antara model yang nyaris seri adalah pertukaran yang keliru.
Pertanyaan yang sering diajukan
Apakah Arena sama dengan LMArena?
Ya. LMArena berasal dari proyek riset Chatbot Arena di UC Berkeley dan kini bernama Arena, di arena.ai. Nama lamanya masih sering muncul di artikel dan makalah lama.
Leaderboard mana yang paling bisa dipercaya?
Tidak ada yang bisa dipercaya dalam semua kasus, dan jawabannya tergantung apa yang ingin Anda ketahui. Untuk keterulangan, suite pihak ketiga yang menjalankan sendiri semua modelnya adalah yang terkuat. Untuk preferensi orang, Arena punya data paling banyak. Bukti yang paling andal adalah dua board yang tidak berhubungan sama-sama sependapat, lalu tes singkat pada tugas Anda sendiri.
Apa itu kontaminasi benchmark?
Kontaminasi terjadi ketika model sudah melihat pertanyaan atau jawaban sebuah tes selama pelatihan, sehingga skor tinggi mencerminkan hafalan, bukan kemampuan. Audit OpenAI terhadap SWE-bench Verified menemukan bahwa model frontier bisa mereproduksi perbaikan asli untuk beberapa tugas. Set tes privat, seperti yang dimiliki Humanity's Last Exam, adalah salah satu pertahanannya.
Apakah vendor berbuat curang di leaderboard?
Bukti yang ada mendukung klaim yang lebih sempit. Lab memilih skor mana yang dipublikasikan, pengaturan mana yang dipakai, dan, menurut makalah Leaderboard Illusion, varian privat mana yang diungkap. Itu pelaporan selektif di dalam aturan, belum tentu pelanggaran aturan. Itulah alasan run ulang independen penting.
Haruskah saya berpindah model setiap kali ada model baru yang menempati #1?
Tidak. Selisih peringkat sering berada dalam margin kesalahan, dan berpindah punya biaya nyata dalam prompt, alur kerja, dan pengujian. Berpindahlah ketika sebuah model mengalahkan model Anda saat ini pada tugas-tugas Anda sendiri, atau ketika performanya setara dengan harga yang jelas lebih murah.