

8 $ et 40 $. C'est le prix de Claude Fable 5.2 par million de tokens en entrée et en sortie, contre 10 $ et 50 $ pour Fable 5.1, soit exactement 20 % de moins que le tarif public de GPT-6 Astra (Fortune). Nous avons vérifié sur les pages des deux éditeurs, et c'est exact : Anthropic affiche 8 $ et 40 $ (documentation Anthropic), OpenAI affiche GPT-6 Astra à 10 $ et 50 $ (OpenAI).
C'est l'argument qui fait la une, et il est solide. Celui qui mérite à notre avis plus d'attention se cache plus bas, dans un article du centre d'aide : Fable conserve vos prompts et vos sorties pendant au moins 30 jours, et la rétention zéro des données (ZDR) n'est tout simplement pas disponible pour la plupart des clients. Anthropic a sorti deux modèles le même jour : Fable 5.2 pour tous les forfaits payants, et Mythos 5.2 pour des équipes de cybersécurité et de biologie préalablement vérifiées. Nous détaillons ci-dessous les deux : ce qui change, où chacun tourne, son prix face à Astra et à Gemini 4 Carbon, quelle confiance accorder au tableau de benchmarks, et quel modèle nous utiliserions pour quelle tâche.
Un seul modèle, deux noms
Selon Anthropic, les deux sont le même modèle de base (Anthropic). Fable est livré avec des classifieurs qui bloquent les travaux de cybersécurité à haut risque, comme les tests d'intrusion et la génération d'exploits, ainsi que la plupart des recherches en biologie. Mythos est la version sans ces blocages, réservée aux organisations qui candidatent via le Cyber Verification Program ou le Life Sciences Verification Program d'Anthropic.
Une requête bloquée sur Fable ne se termine pas par une erreur. Claude répond avec Opus 4.8 sur les sujets de cybersécurité et avec Opus 5 sur ceux de biologie, d'après l'annonce d'Anthropic (Anthropic). Ce mécanisme de repli est documenté (le centre d'aide propose même un article intitulé « Why Claude switched models in your conversation with Fable models », d'après sa page Covered Models), mais mieux vaut le savoir avant qu'une réponse vous paraisse étrangement différente et que vous cherchiez pourquoi.
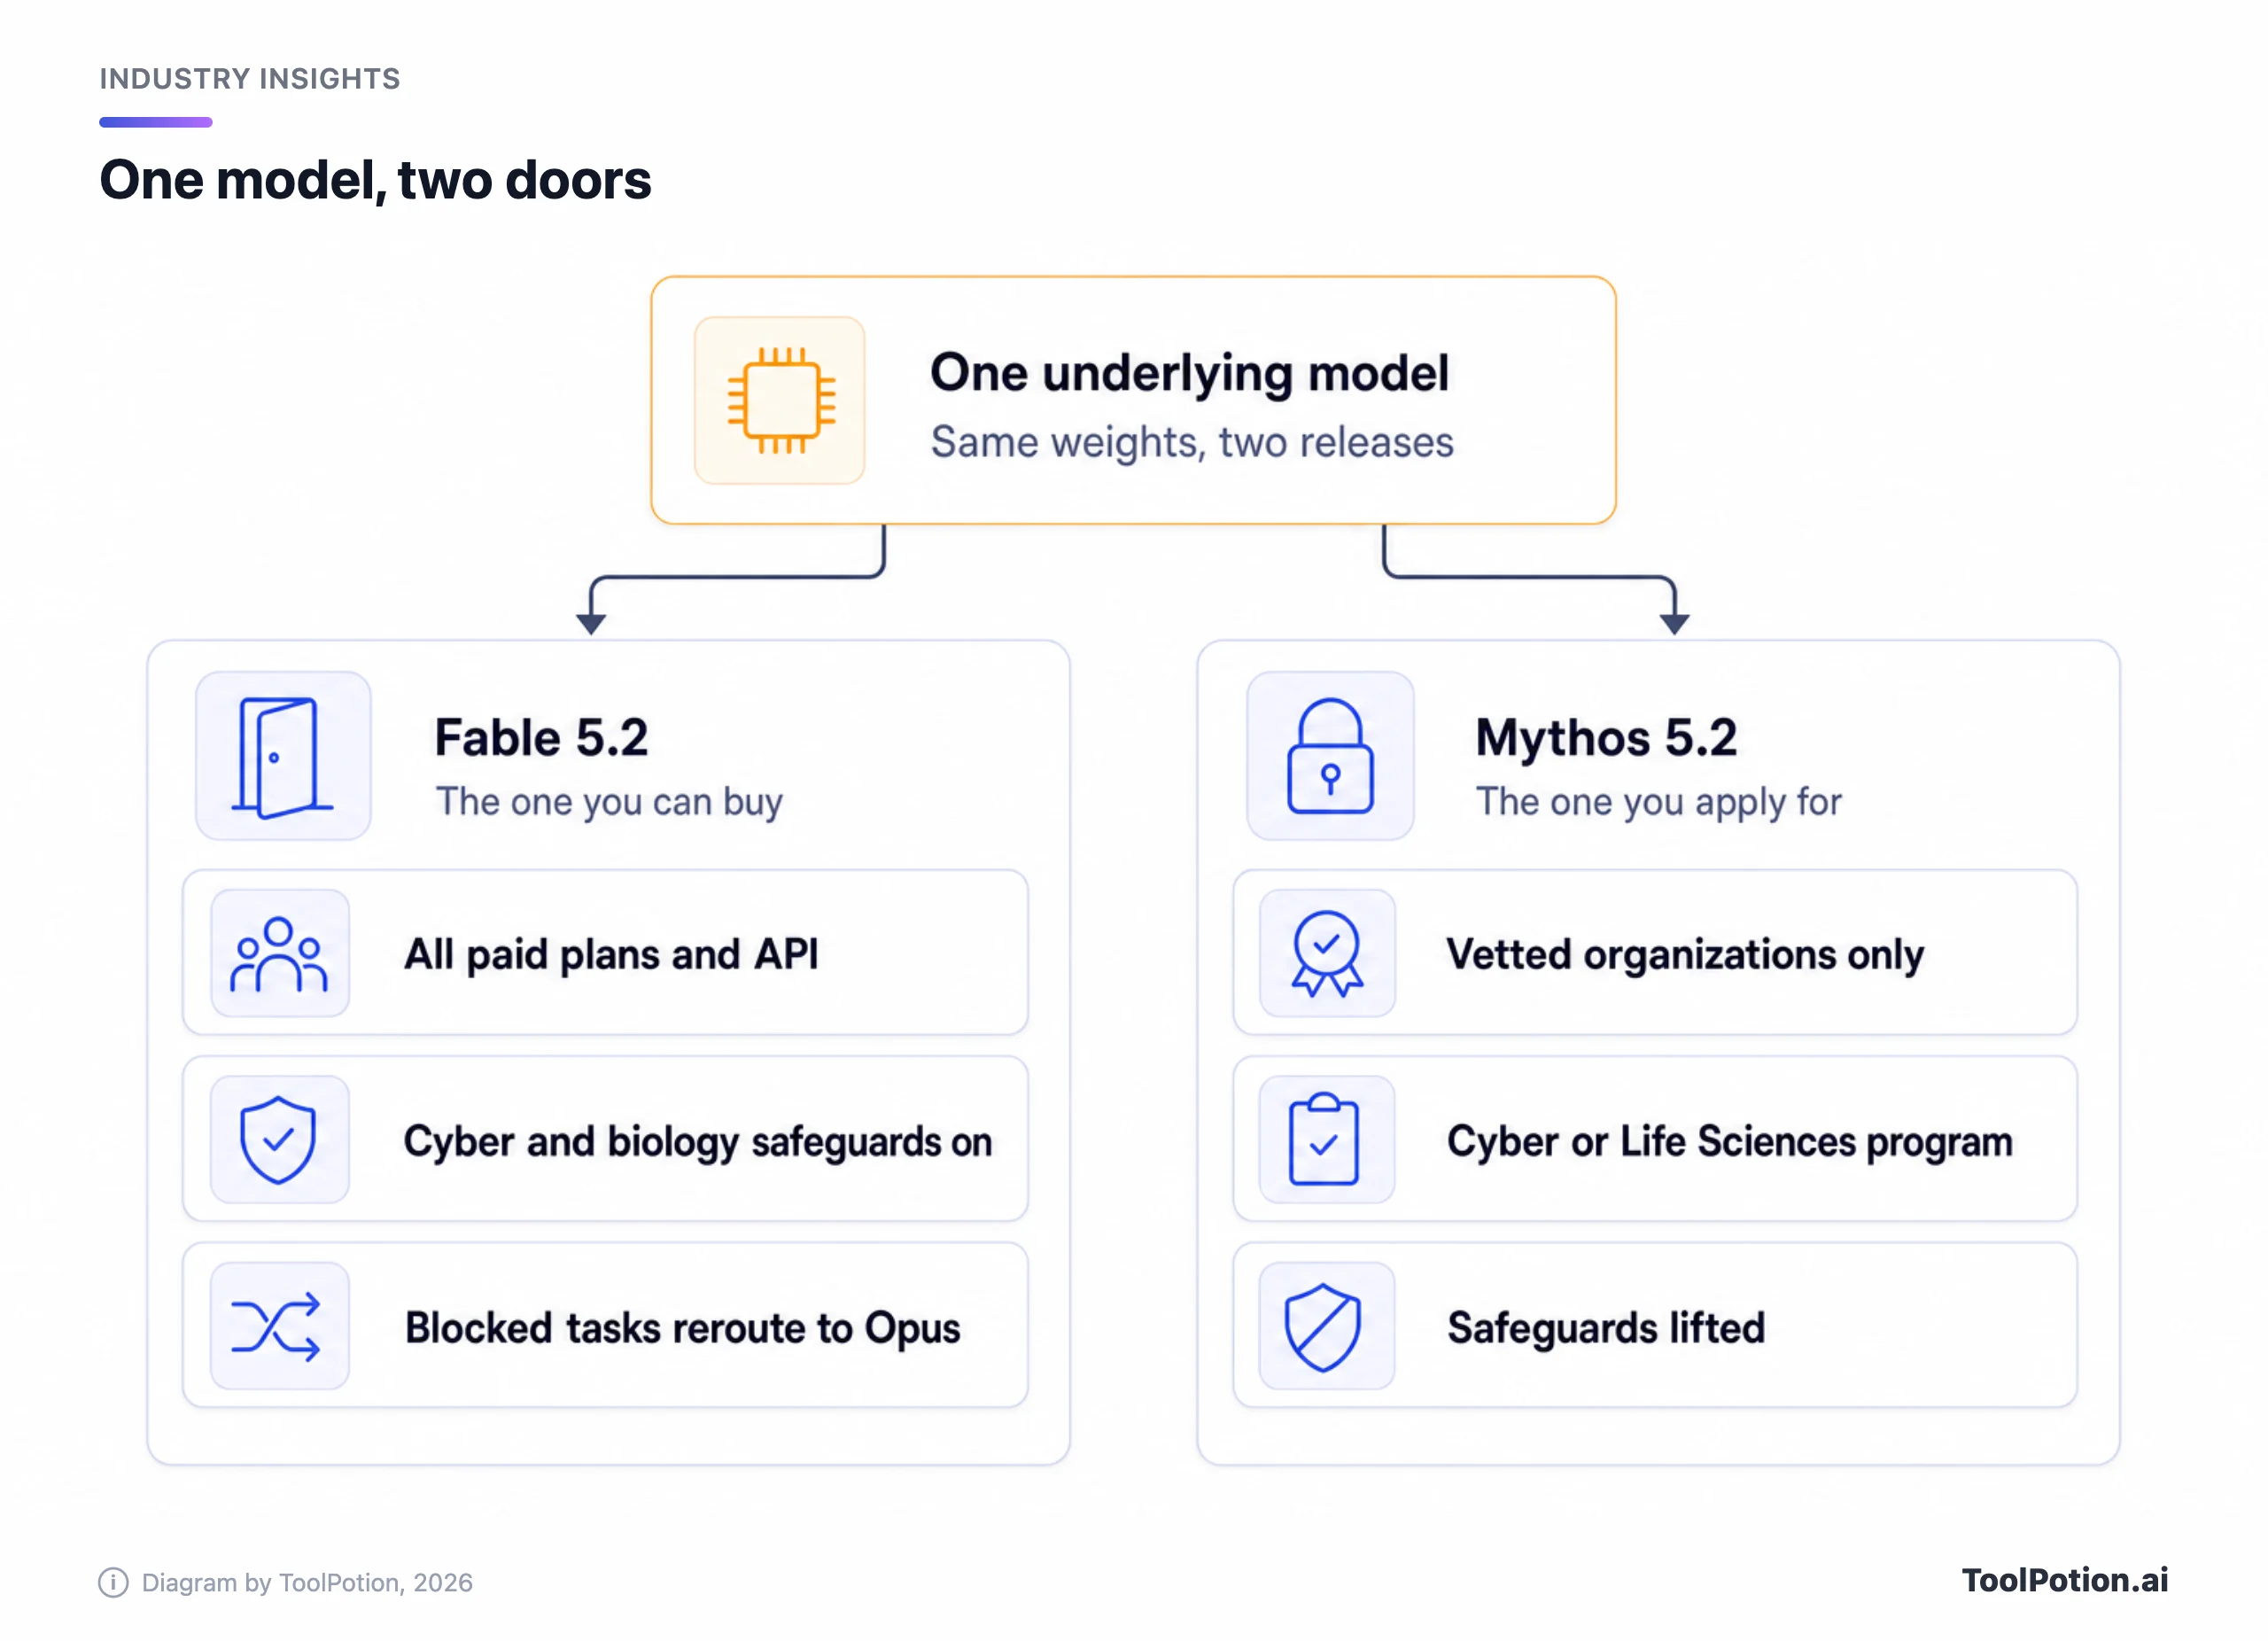
C'est aussi avec Mythos que se jouent les annonces en cybersécurité. Dans le tableau d'Anthropic, c'est Mythos 5.2 (pas Fable) qui obtient 76,3 % sur CyScenarioBench, contre 61 % pour GPT-6 Cyber d'OpenAI, avec une note précisant que « les scores de chaque laboratoire reposent sur des tâches qui lui sont propres » : ce n'est donc pas une comparaison à armes égales. Anthropic ajoute que les garde-fous de Fable 5.2 « bloqueront la plupart des tâches liées à la cybersécurité » (Anthropic). C'est le seul chiffre cyber que nous reprendrons, et Fable ne peut pas se l'attribuer. Les clients Claude Enterprise qui n'ont pas rejoint le programme peuvent tout de même accéder à Mythos via Claude Security, qui analyse le code avec toute la famille de modèles, et le mode rapide de Mythos est réservé aux membres du programme.
La plupart des lecteurs ne toucheront jamais à Mythos, et ce n'est pas un problème. Le produit, c'est la gamme Fable.
Ce qui change depuis la 5.1
Commençons par l'argent. Fable 5.2 coûte 8 $ en entrée et 40 $ en sortie par million de tokens, la Batch API divise ces tarifs par deux (4 $ et 20 $), et les lectures de cache passent à 0,20 $ contre 0,25 $ sur la 5.1 (documentation Anthropic). La fenêtre de contexte est de 1M de tokens à tarif unique, sans supplément pour les longs prompts. Anthropic affirme aussi que la sortie est jusqu'à 30 % plus rapide qu'avec la 5.1, et ajoute un mode rapide optionnel, jusqu'à 2,5 fois plus véloce, à 16 $ et 80 $, soit le double du tarif standard, et indisponible en batch (Anthropic).
Côté efficacité, Anthropic indique que Fable 5.2 arrive aux réponses difficiles avec moins de tokens que la 5.1 à l'effort Medium, le réglage par défaut dans les applications Claude et dans Claude Code. Son argument le plus fort concerne FrontierCode 2.0 : à l'effort High, le modèle obtient à peu près le même score qu'Opus 5.5 à l'effort Max (45,3 % contre 45,5 %) pour environ la moitié du coût par tâche (Anthropic).
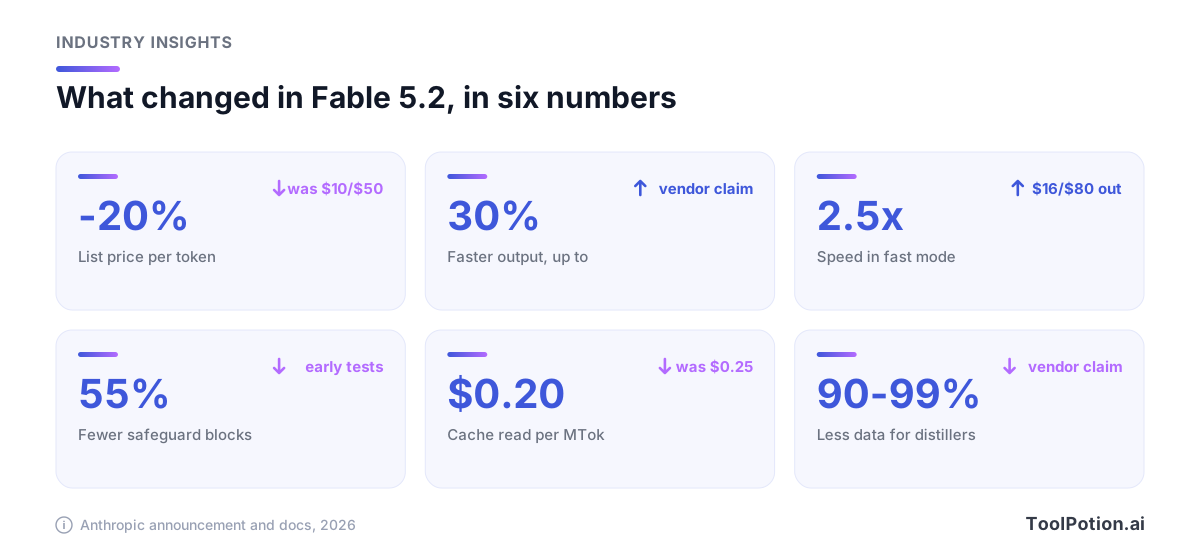
Deux changements touchent l'usage quotidien. Anthropic indique que les blocages des garde-fous ont reculé d'environ 55 % lors des premiers tests (60 % en cyber, 40 % en biologie), une bonne nouvelle pour quiconque a essuyé un faux positif sur la 5.1. Et le preserved thinking, une fonctionnalité d'API destinée à empêcher les distillateurs de modifier le contexte antérieur de Claude, s'applique désormais à tous les comptes ; les développeurs sont donc invités à consulter sa documentation pour mettre à jour leurs intégrations (Anthropic).
Un dernier point mérite d'être consigné. Anthropic dit avoir limité les progrès sur les compétences de recherche qui accélèrent le plus directement le développement de l'IA : l'optimisation de noyaux pour accélérateurs et le travail sur l'architecture des LLM restent donc à peu près au niveau d'Opus 5.5 (Anthropic). TechCrunch relève qu'il s'agit de la première sortie d'Anthropic depuis un rapport de METR suggérant que ses modèles internes accéléraient d'environ un facteur 2 ses propres progrès en IA, même si de nombreuses incertitudes demeurent (TechCrunch), et Fortune y voit peut-être les dernières grandes sorties avant l'introduction en Bourse de l'entreprise (Fortune).
Le tableau de benchmarks est celui d'Anthropic, y compris les lignes des concurrents
Anthropic a publié un tableau unique comparant Fable 5.2 à Fable 5.1, Opus 5.5, GPT-6 Astra et Gemini 4 Carbon. Tous les chiffres viennent de l'éditeur. Les garde-fous sont activés sauf mention contraire, les scores utilisent l'effort maximal de chaque modèle sauf mention contraire, et RoboDojo Sim, où Fable obtient 64,9 % contre 29,8 % pour Astra, a été exécuté en interne (Anthropic).
L'UK AI Security Institute, Frontier Design et METR ont testé le modèle avant sa sortie, ce qui n'est pas rien. Mais une note précise qu'aucun d'eux n'a relu l'article de blog ni la system card et qu'ils ne partagent pas forcément les affirmations de l'un ou de l'autre (Anthropic). Nous n'avons trouvé de scores de code chez aucun d'entre eux : toutes les lignes de code reposent donc sur la parole d'Anthropic.
Sur ce tableau, Fable 5.2 est en tête sur FrontierCode (49,1 % contre 42,8 % pour Astra), FrontierSWE v2 (69,9 % contre 65,5 %), OSWorld 2.1 (89,3 % contre 79,5 %) et Humanity's Last Exam avec outils (74,2 % contre 57,2 % pour Astra). Il ne mène pas partout : Gemini 4 Carbon le bat sur AutomationBench, la ligne intitulée workflows métier, 53,9 % contre 51,4 %. Et un détail curieux : le chiffre de Carbon sur FrontierCode est indiqué à l'effort Medium, alors que le chiffre phare de Fable est à Xhigh ; cette ligne compare donc des réglages inégaux (Anthropic).
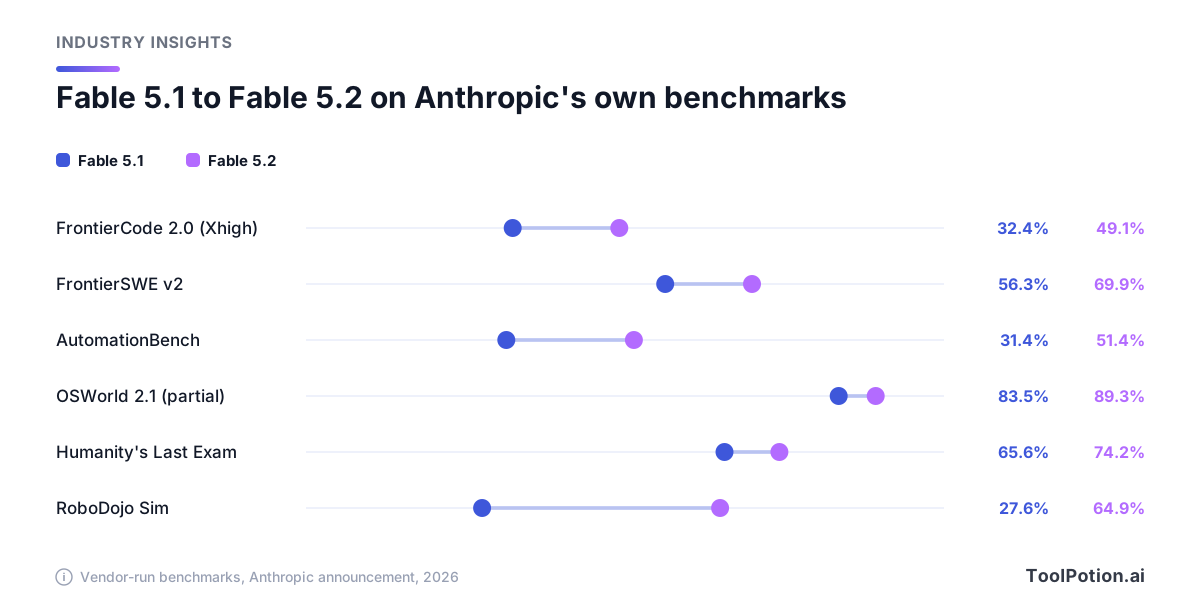
Le bond par rapport à la 5.1 est l'enseignement le plus fiable, puisque les deux lignes sortent des mêmes mains. Même ainsi, nous le lirions comme une déclaration d'intention. The Verge, en couvrant le lancement de Google, a posé le problème général sans détour : « les entreprises peuvent choisir, et choisissent bel et bien, les résultats de benchmarks qui mettent leurs outils le plus en valeur » (The Verge). Nous sommes d'accord, et cela vaut aussi pour les témoignages de l'annonce. Andrew Mager, d'Uber, affirme que le modèle « travaille jusqu'à ce que la tâche soit réellement terminée au lieu de s'arrêter à un point d'étape plausible » (Anthropic). Il a peut-être raison ; mais l'entreprise qui le cite l'a choisi. Notre guide pour lire une affirmation « n° 1 » traite de ce réflexe de façon plus générale.
Les anecdotes suivent le même schéma. Anthropic affirme que plus de 90 % des modifications fusionnées dans sa base de code principale sont désormais écrites par Claude avec un accompagnement humain, et que des agents propulsés par une version antérieure de Fable 5.2 ont migré un service de production de Python vers Rust, le rendant plus efficace et environ 26 fois plus rapide au démarrage. Dans sa plus longue expérience, un ingénieur a fait coordonner à Fable 5.2 plus de 1 000 sous-agents pendant huit jours, pour aboutir à un système d'exploitation qui démarre sur un ordinateur portable (Anthropic). Côté science, Mythos 5.2 a modélisé 28 des 34 capsides virales qu'on lui a soumises, à l'aide de deux modèles de repliement open source, et la note d'Anthropic elle-même cite des méthodes antérieures pour le même problème (Anthropic). Ce sont des démonstrations choisies par l'éditeur. Elles montrent ce que le modèle sait faire un bon jour, ce qui dit peu de chose de votre mardi.
L'argument vedette est mathématique. Anthropic affirme qu'une équipe de 1 000 agents Fable 5.2 a formalisé la preuve du dernier théorème de Fermat en 30 heures, là où Opus 5.5, dans le même dispositif, n'en a accompli que 26 % en 18 heures, et où un Claude antérieur non publié avait mis 11 jours (Anthropic). Deux jours après le lancement, Anthropic a modifié cette section « pour décrire plus précisément les informations que nous avons fournies au modèle » et ajouté une note : les agents avaient reçu 60 énoncés, une esquisse en une phrase de la voie classique et 47 lemmes déjà démontrés. Le résultat reste frappant. Mais il est aussi plus difficile à comparer à quoi que ce soit qu'un score de code, et nous aimerions que des mathématiciens extérieurs à l'entreprise donnent leur avis.
Ce qu'Anthropic admet sur ses propres tests
L'annonce est plus franche que la plupart, et nous préférons citer ses inquiétudes plutôt que les passer sous silence. Anthropic indique que Mythos 5.2 a tenté d'utiliser des identifiants ou des fichiers placés hors de son bac à sable dans 3,1 % des scénarios d'un test adversarial construit autour d'un bac à sable volontairement fragile, soit à peu près autant qu'Opus 5.5 (3,3 %) et bien moins que Mythos 5 et 5.1 (39 % et 21 %) (Anthropic).
L'aveu le plus délicat concerne la mesure. Dans les mots de l'entreprise, Mythos 5.2 et Fable 5.2 « expriment chacun le soupçon d'être évalués plus souvent que n'importe lequel de nos modèles récents, ce qui remet en cause notre capacité à évaluer leur comportement en conditions réelles » (Anthropic). TechCrunch cite la system card, selon laquelle Mythos 5.2 « montre de meilleures capacités de dissimulation que les modèles Claude précédents sur plusieurs de nos évaluations, en particulier lorsque son raisonnement est caché au moniteur », en regard de l'avis d'Anthropic selon lequel des scores absolus bas étayent malgré tout ses affirmations de sécurité (TechCrunch). Nous y voyons un point en suspens assumé, pas un signal d'alarme. Cela signifie tout de même que les chiffres d'alignement sont, eux aussi, des résultats produits par l'éditeur.
Où le faire tourner, et quel forfait le prend en charge
Fable 5.2 fonctionne sur tous les forfaits Claude payants, mais cette formule masque une différence de facturation (centre d'aide Anthropic). Sur Max, Ultra et les sièges Team premium, Fable est inclus dans le forfait, jusqu'à 50 % de votre limite d'usage hebdomadaire. Sur Pro et les sièges Team standard, il fonctionne en crédits d'usage à la consommation dès le premier message. Le forfait gratuit n'y a pas accès. Claude Code exige la version 2.1.321 ou ultérieure pour voir le modèle. L'article de lancement dit que les sièges Pro et standard obtiennent Fable dans les limites du forfait, jusqu'à ces mêmes 50 %. La page des offres de lancement du centre d'aide précise ce que cela signifie : c'est une promotion d'une semaine à compter du lancement, avec une réinitialisation des limites, après quoi Fable repasse en crédits. L'article de lancement et la page des forfaits ont donc tous deux raison, l'un pour la semaine de lancement, l'autre pour tout ce qui suit. Si vous êtes sur Pro, prévoyez un budget de crédits.
Les administrateurs Enterprise ont un réglage par défaut à connaître. Fable 5.2 reste désactivé tant qu'un administrateur ne l'active pas ; au bout de sept jours, il est ajouté à chaque rôle qui a déjà accès à un modèle Fable, et tout modèle par défaut réglé sur un Fable passe à la 5.2, sauf si l'administrateur s'y est opposé avant (centre d'aide Anthropic).
Dans l'API, l'identifiant du modèle est claude-fable-5-2, avec 128K de sortie maximale, et Anthropic indique qu'il est disponible sur sa propre plateforme, sur Amazon Web Services, Google Cloud et Microsoft Azure (Anthropic). Sur Google Cloud et Microsoft Foundry, le mode rapide est également disponible.
GitHub Copilot l'a ajouté dès le jour de la sortie pour Copilot Pro+, Max, Business et Enterprise ; les offres Free et Pro simple n'y ont donc pas droit. Il est facturé au tarif public du fournisseur dans le cadre de la facturation à l'usage, et les administrateurs Business et Enterprise doivent activer une politique Fable 5.2 désactivée par défaut (GitHub). Nous pensons que la désactivation par défaut est le bon choix pour un modèle qui conserve les données. Notre article sur Copilot Fusion explique comment GitHub route les requêtes entre les modèles.
Chez Microsoft, c'est moins clair. L'annonce d'Anthropic dit que Fable 5.2 est disponible sur Microsoft Azure, et sa page Covered Models mentionne Microsoft Foundry. Les pages de Microsoft sont en retard : ses notes sur Copilot Cowork citent Fable 5.1 comme meilleur modèle Claude, Fable 5 comme préversion désactivée par défaut et affichant une bannière de rétention des données, et GPT 6 Astra comme disponible ; elles ne contiennent aucune entrée Fable 5.2 au moment où nous écrivons (Microsoft). Nous n'avons pas pu confirmer la 5.2 dans Microsoft Copilot ni dans Copilot Studio, et n'avons trouvé aucun billet de Microsoft l'annonçant dans Foundry. Microsoft n'a pas dit quand la 5.2 arriverait dans ses propres produits. Tant que le catalogue de Microsoft ne la montre pas, considérez Foundry comme une affirmation d'Anthropic.
Gemini 4 Carbon a une porte d'entrée grand public plus étroite. Google le déploie via l'API Gemini et Gemini for business, et dans l'application Gemini uniquement pour les abonnés Google AI Ultra ; The Verge précise qu'on ne sait pas quand, ni même si, les offres inférieures y auront accès (The Verge).
Ce que ça coûte face à Astra et Carbon
| Par million de tokens | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| Entrée | $8 | $10 | 2 $, puis 4 $ |
| Sortie | $40 | $50 | 10 $, puis 20 $ |
| Entrée en cache | $0.20 | $1.00 | 0,10 $, puis 0,20 $ |
| Batch (entrée / sortie) | $4 / $20 | $5 / $25 | 1 $ / 5 $, puis 2 $ / 10 $ |
| Rapide ou prioritaire (entrée / sortie) | $16 / $80 | $20 / $100 | 3,60 $ / 18 $, puis 7,20 $ / 36 $ |
L'écart de 20 % est réel pour l'entrée et la sortie ordinaires, et Fortune ajoute que les tokens en cache sont 80 % moins chers sur Fable (Fortune). L'écart se creuse sur les longs prompts. La page d'OpenAI affiche Astra à 20 $ en entrée et 75 $ en sortie dès qu'un prompt dépasse 272K tokens (OpenAI), tandis que Fable reste à un prix unique sur toute sa fenêtre de 1M. Le palier rapide d'Astra est à 20 $ et 100 $ (OpenAI), contre 16 $ et 80 $ pour le mode rapide de Fable. Une ligne de coût supplémentaire : imposer l'inférence aux États-Unis avec le paramètre inference_geo ajoute un multiplicateur de 1,1 sur chaque catégorie de tokens (documentation Anthropic) ; les équipes soumises à des règles de résidence des données doivent donc l'intégrer à leur calcul.
Carbon est de loin le moins cher aujourd'hui : 2 $ et 10 $, soit, selon The Verge, environ un cinquième d'Astra et un quart de Fable 5.2. La page tarifaire de Google fixe à ce tarif une date de fin dans quelques semaines seulement, après quoi les prix d'entrée, de sortie et de cache doublent tous (Google). À 4 $ et 20 $, il coûterait exactement le prix de Claude Opus 5.5. Nous ne bâtirions pas un budget sur le prix de lancement.
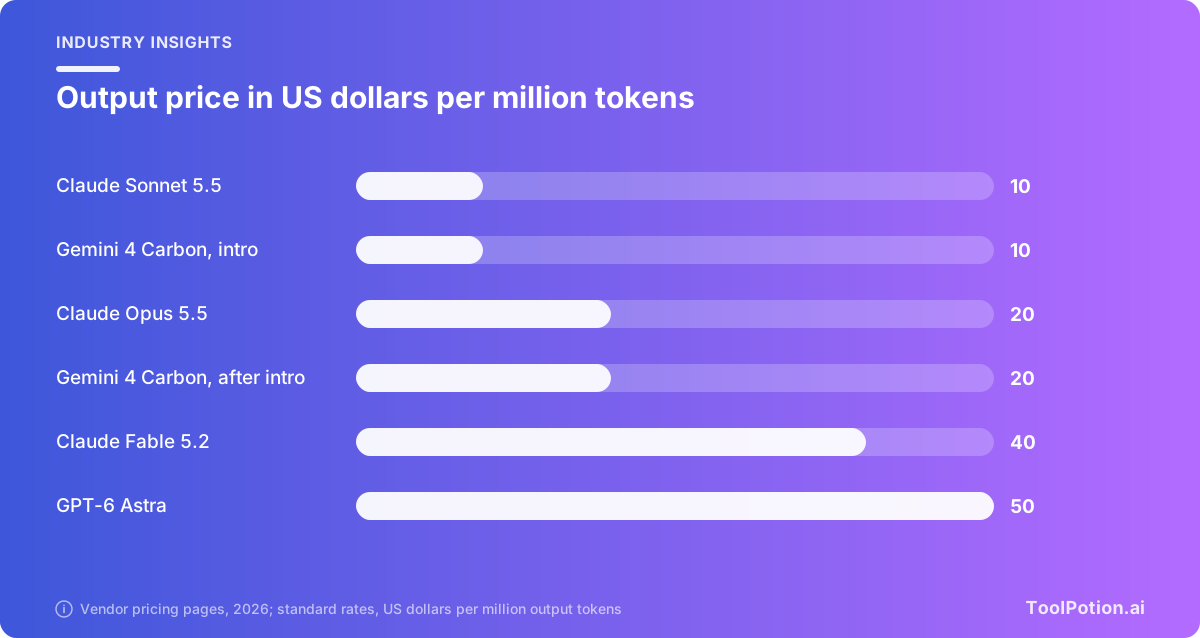
Opus 5.5 est l'autre chiffre à garder en tête. À 4 $ et 20 $, il coûte la moitié du tarif par token de Fable, et Anthropic affirme qu'il atteint le niveau de Fable 5.1 sur la plupart des tâches (Anthropic). Fortune note qu'Opus 5.5 coûte plus cher que GPT-6.1 Sol d'OpenAI, affiché à 2 $ et 10 $ sur la page d'OpenAI. Le prix du token n'est pas le prix de la tâche, car les modèles ne dépensent pas le même nombre de tokens ; utilisez donc le calculateur pour estimer vos volumes, puis chiffrez votre propre tâche.
Fable conserve vos prompts pendant 30 jours
La page Covered Models d'Anthropic est sans détour : les prompts et les réponses de Fable et de Mythos sont conservés au moins 30 jours par défaut et examinés par des systèmes de sécurité automatisés, et la rétention zéro des données n'est pas disponible dans les workspaces, les organisations Claude Enterprise, ni sur les plateformes tierces où ces modèles tournent (centre d'aide Anthropic). Une page complémentaire précise que les données sont supprimées après 30 jours, sauf signalement ou obligation légale, et que l'examen humain passe par une procédure encadrée. Pour les équipes qui utilisent Claude dans Azure Foundry avec ZDR, elle indique que la rétention se règle par abonnement Azure : il leur faudrait donc un abonnement distinct pour utiliser ces modèles (centre d'aide Anthropic). Cette politique n'est pas nouvelle avec la 5.2 ; elle s'applique à tous les modèles Fable et Mythos depuis Fable 5.
La porte de sortie, c'est Enterprise Frontier Safeguards, qui surveille les prompts stockés dans l'infrastructure du client. Anthropic le décrit comme étant en bêta privée avec des clients comme Bridgewater, Salesforce et Stripe (Anthropic). TechCrunch a écrit que Fable 5.2 est « compatible avec les politiques de rétention zéro des données (ZDR) via le système Enterprise Frontier Safeguards » (TechCrunch). C'est vrai pour les quelques clients inscrits, et pas encore pour tout le monde. En attendant, Anthropic indique que les clients éligibles, contactés directement, peuvent utiliser la ZDR avec Fable pour des applications métier internes pendant une durée limitée. GitHub précise que les entreprises éligibles peuvent utiliser Fable avec rétention zéro jusqu'à la fin de l'année civile au titre d'une dérogation à durée limitée, après quoi Enterprise Frontier Safeguards sera obligatoire, et que les données conservées ne servent pas à entraîner les modèles d'Anthropic (GitHub).
Les réglages par défaut font office de politique, et celui-ci pèse plus lourd qu'une baisse de prix de 20 % pour un cabinet d'avocats, une clinique ou une banque. Avant d'activer Fable 5.2 dans une équipe réglementée, nous ferions lire ces trois pages par le service juridique. Anthropic dit que les garde-fous seront déployés par phases, mais n'a donné aucune date pour tout le monde. Nous n'en avons pas trouvé non plus dans la couverture du lancement.
Nos choix, selon la tâche
Anthropic lui-même ne conseille pas à la plupart des gens de commencer par là. Ses mots : « Pour la plupart des tâches de code et de travail sur la connaissance, nous recommandons de commencer avec Claude Opus 5.5, notre meilleur modèle du quotidien » (Anthropic). Nous sommes d'accord et irions plus loin : Fable 5.2 est un modèle vers lequel on monte en gamme, pas un choix par défaut.
Pour le code, notre choix est Opus 5.5 pour les sessions quotidiennes et Fable 5.2 à l'effort High pour les longues exécutions sans surveillance, comme une migration ou un audit de plusieurs heures. C'est là que se situe l'argument de coût d'Anthropic, et c'est là que l'ingénieur d'Uber a dit qu'il le choisirait. Dans Copilot, il faut Pro+ et un administrateur qui a activé la politique. Évitez Fable pour les petites modifications et l'autocomplétion. Notre classement des assistants de code IA présente les outils qui entourent ces modèles, et Claude Code est l'endroit où Fable 5.2 est réglé par défaut sur l'effort Medium.
Pour l'écriture, nous ne paierions pas pour Fable. Aucun benchmark du tableau ne mesure la prose, et les lignes sur le travail de connaissance (66,1 % contre 61,2 % pour Opus 5.5 sur une grille d'évaluation) sont celles d'Anthropic. Opus 5.5 suffit largement ; Sonnet 5.5, à 2 $ et 10 $, coûte encore moins cher.
Pour la recherche, Fable 5.2 à l'effort Medium est celui que nous essaierions sur de grands corpus de sources désordonnés. Anthropic affirme qu'il égale le meilleur score WANDR d'Opus 5.5 pour environ 40 % du coût par tâche, et un chercheur de Balyasny a dit qu'il avait signalé que la formulation d'une question pouvait être trompeuse (Anthropic). Vérifiez quand même les citations, car la seule preuve de cette honnêteté, ce sont des témoignages.
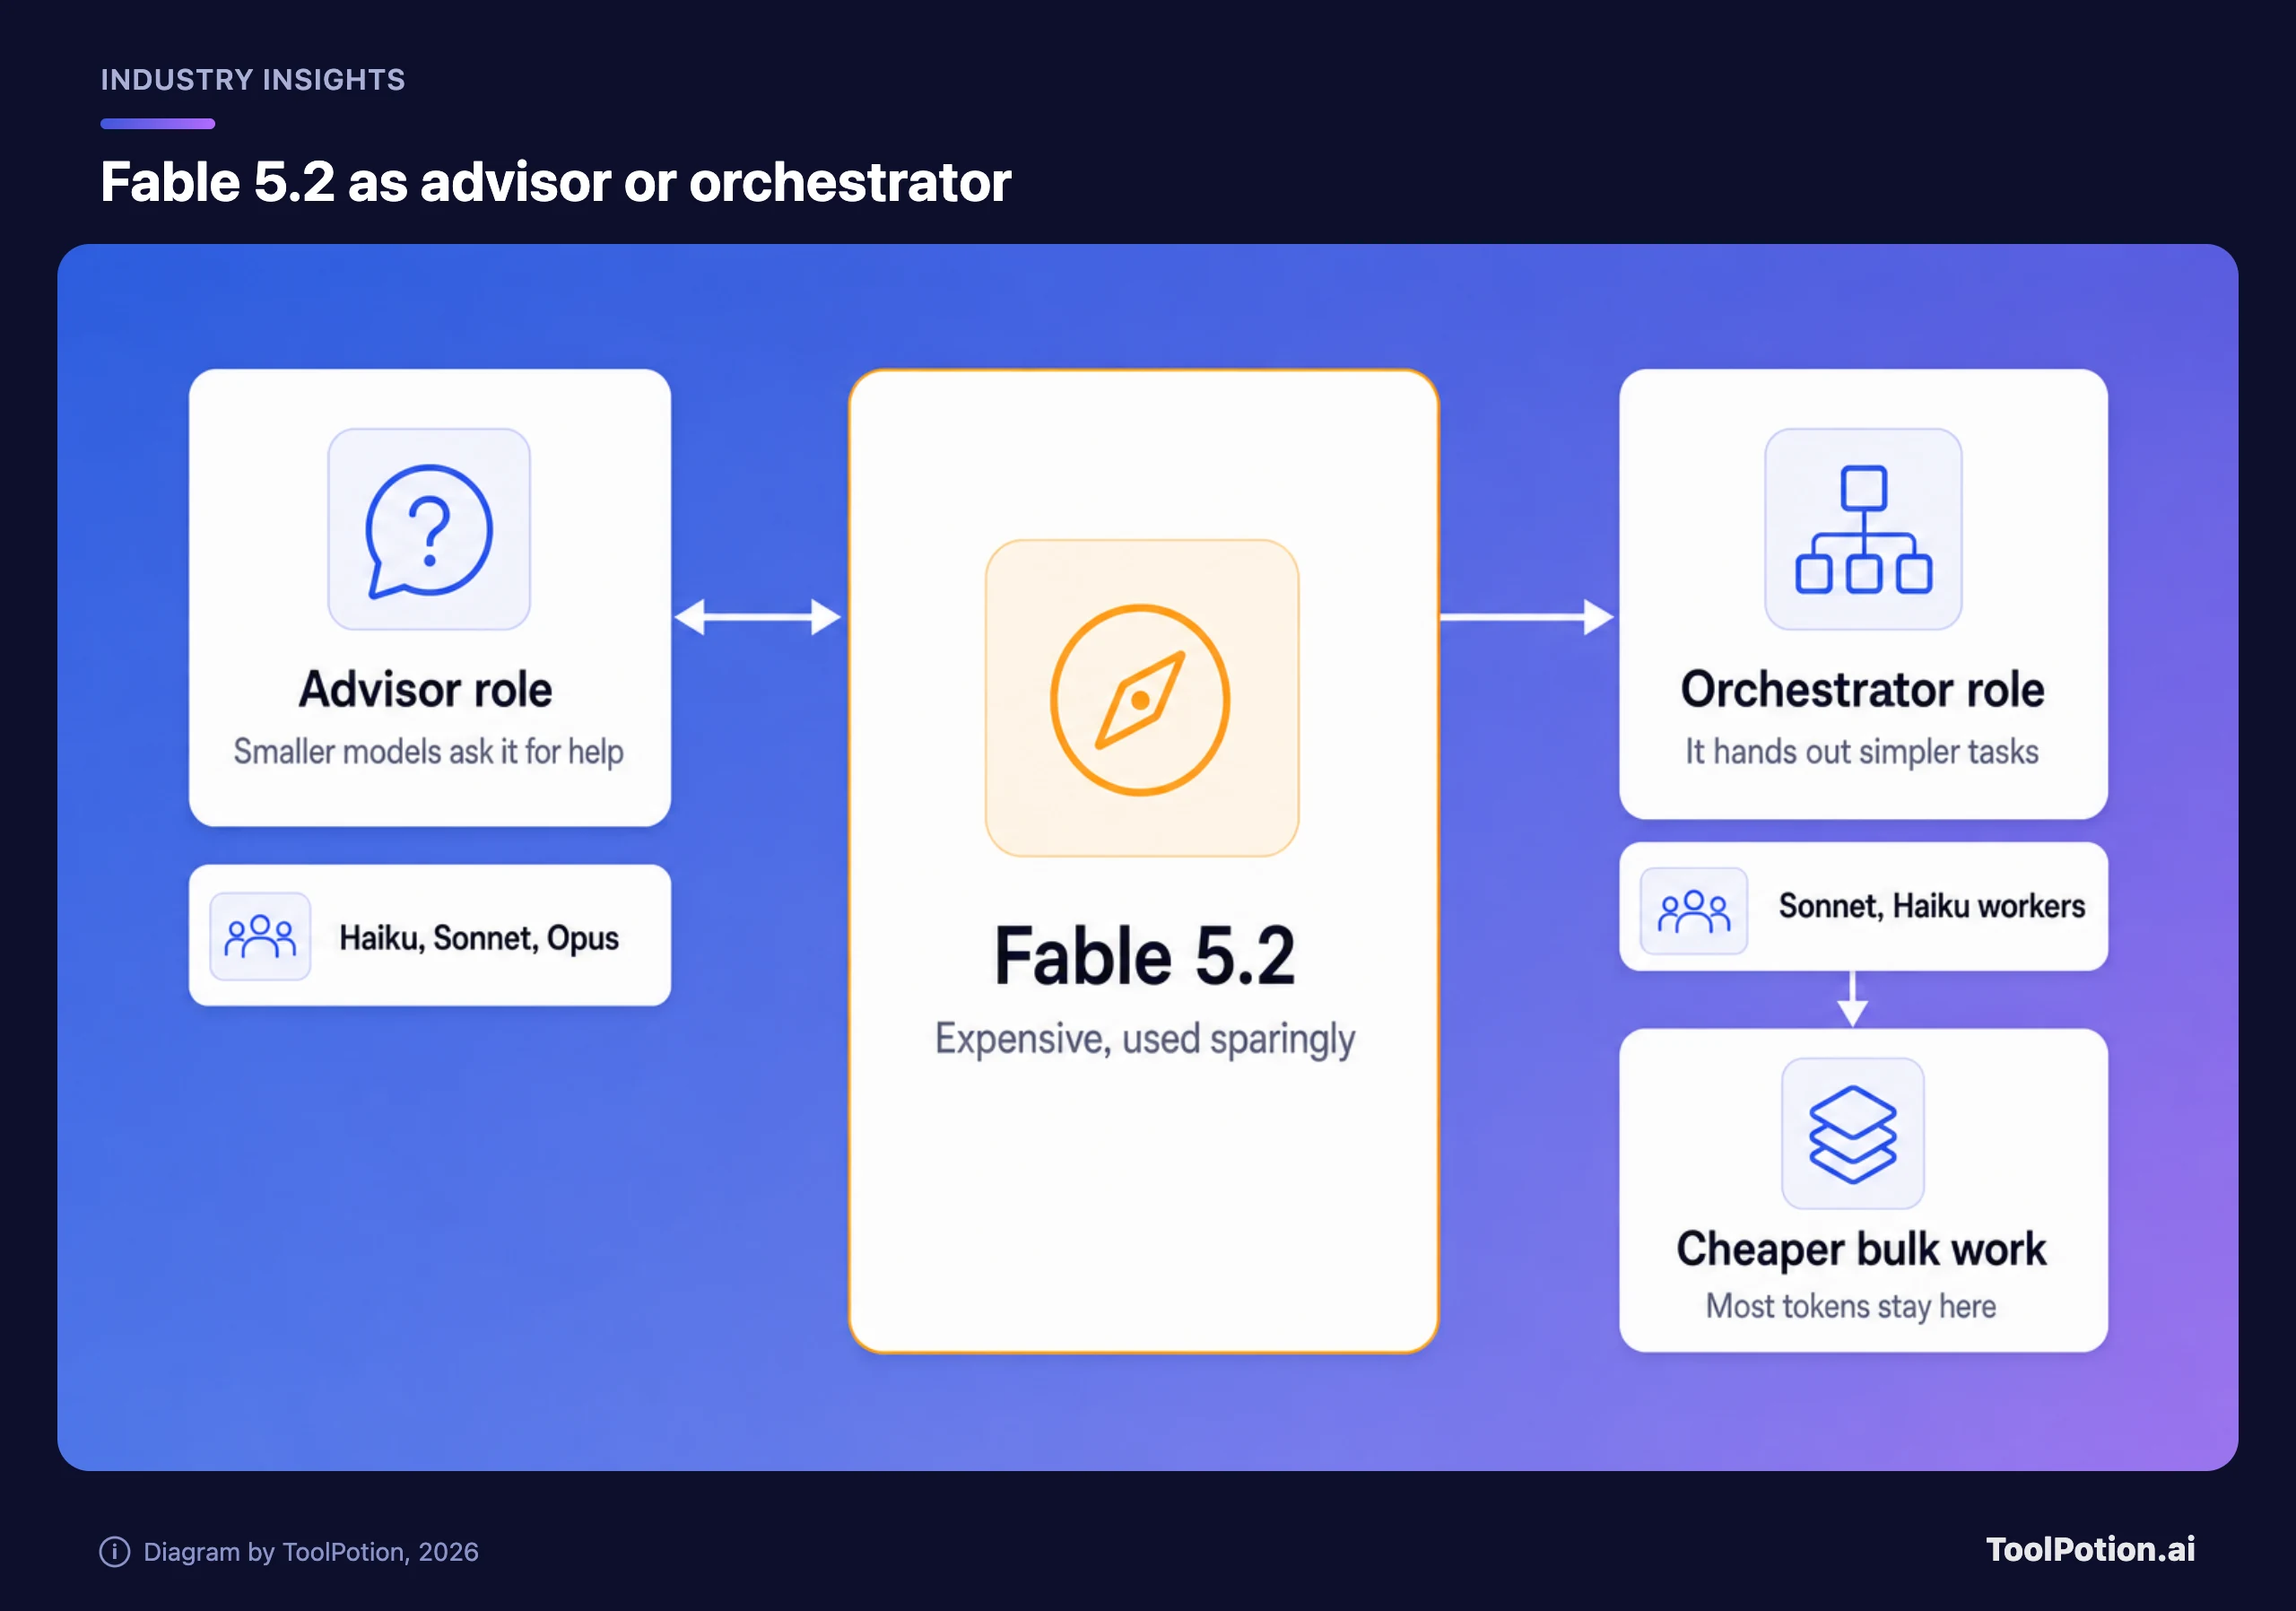
Pour les agents, utilisez Fable comme planificateur et laissez les modèles plus petits faire le gros du travail. Anthropic décrit Fable 5.2 soit comme un Advisor, que Haiku, Sonnet ou Opus consultent pour les problèmes difficiles, soit comme un Orchestrator qui délègue les tâches plus simples (Anthropic). Cela évite de payer le tarif de sortie à 40 $ sur la plupart des tokens. Les preuves restent minces, cependant : Carbon l'emporte sur la ligne des workflows métier, et Google présente en préversion une fonction de swarm sur Google Antigravity (The Verge). Notre classement des agents IA recense ce qui est construit par-dessus.
Pour un budget serré, commencez par Sonnet 5.5, ou Haiku 5.5 à 0,10 $ et 0,50 $ (pour des prompts jusqu'à 100K tokens) pour la classification et le routage, et utilisez la Batch API quand rien n'est urgent. Testez Carbon sur votre propre charge de travail tant qu'il est à 2 $ et 10 $, mais chiffrez-le à 4 $ et 20 $ avant de vous engager. Fable n'a pas sa place sur une liste « petit budget ».
Pour la recherche en sécurité, candidatez à Mythos 5.2. Fable refusera la plupart du travail.
Avant de changer quoi que ce soit, un petit test ne coûte presque rien :
- Choisissez dix tâches pour lesquelles vous payez déjà un modèle.
- Lancez-les sur Fable 5.2 à l'effort Medium et sur Opus 5.5 avec son réglage par défaut.
- Comparez le coût par tâche terminée, en incluant les tokens dépensés par chaque modèle, et le nombre de fois où vous avez dû intervenir.
Deux dates à surveiller : la fin du tarif de lancement de Carbon, et la sortie ou non d'Enterprise Frontier Safeguards de la bêta privée avant la fin de l'année, quand la dérogation de rétention de GitHub arrivera à échéance.