

GPT-6 Astra est le meilleur modèle d'OpenAI cette année, conçu pour les longues tâches en plusieurs étapes sur un ordinateur : naviguer sur le web, remplir des formulaires, écrire du code, produire des documents. Il existe bel et bien, il est disponible, et pour la plupart des gens, ce n'est pas le modèle à essayer en premier. Son petit frère moins cher, GPT-6.1 Sol, couvre l'essentiel de ce que fait Astra pour un cinquième du prix.
OpenAI a présenté Astra il y a environ cinq semaines, d'abord à un nombre limité d'organisations, puis aux offres payantes de ChatGPT et à l'API. Le reste de la famille a suivi : GPT-6 Sol et GPT-6 Luna environ trois semaines plus tard, puis GPT-6.1 Sol une semaine après. Les noms prêtent à confusion, les annonces de benchmarks sont tapageuses et les notes de sécurité sont d'une franchise inhabituelle. Ce guide fait le tri : ce qu'est chaque modèle, qui y a accès, combien il coûte et qui peut l'ignorer sans risque.
Tout ce qui suit vient de la documentation et des pages tarifaires d'OpenAI, ainsi que d'articles et d'évaluations externes, toujours attribués là où ils apparaissent. Quand les affirmations d'OpenAI et les chiffres indépendants divergent, vous verrez les deux.
Ce qu'est GPT-6 Astra
La documentation d'OpenAI décrit Astra comme son « modèle le plus capable pour les tâches les plus exigeantes » et le dit particulièrement fort en raisonnement complexe, en code, en utilisation de l'ordinateur, en recherche et en création de documents (documentation de l'API OpenAI). Il accepte du texte et des images en entrée et renvoie du texte. La fenêtre de contexte est de 1,05 million de tokens, la sortie maximale de 128 000 tokens, et vous pouvez régler l'effort de raisonnement sur cinq niveaux, de low à max.
Il fonctionne via les endpoints Chat Completions et Responses, ainsi que via l'API Batch. Il ne gère ni les conversations en temps réel, ni le fine-tuning, ni l'audio. Dans l'API Responses, il peut utiliser la recherche web, la recherche dans les fichiers, l'exécution de code et l'utilisation de l'ordinateur : il peut donc servir de moteur à un agent, pas seulement à un chatbot.
Astra se place au sommet d'une petite famille. Les trois modèles GPT-6 de la page des modèles d'OpenAI partagent la même fenêtre de 1,05 million de tokens et le même plafond de sortie de 128 000 tokens (documentation de l'API OpenAI). Ils se distinguent par la dose d'intelligence que vous achetez.
| Modèle | Description d'OpenAI | Entrée / sortie par million de tokens |
|---|---|---|
| GPT-6 Astra | Le plus capable, pour les tâches les plus exigeantes | $10 / $50 |
| GPT-6.1 Sol | Des performances proches d'Astra à moindre coût | $2 / $10 |
| GPT-6 Luna | Le plus efficace, pour les tâches ciblées à fort volume | $0.10 / $0.50 |
Les prix sont les tarifs catalogue en mode standard de la page de tarification d'OpenAI. GPT-6.1 Sol est une mise à niveau du GPT-6 Sol sorti plus tôt, d'où l'ancien nom que vous croiserez encore par endroits.
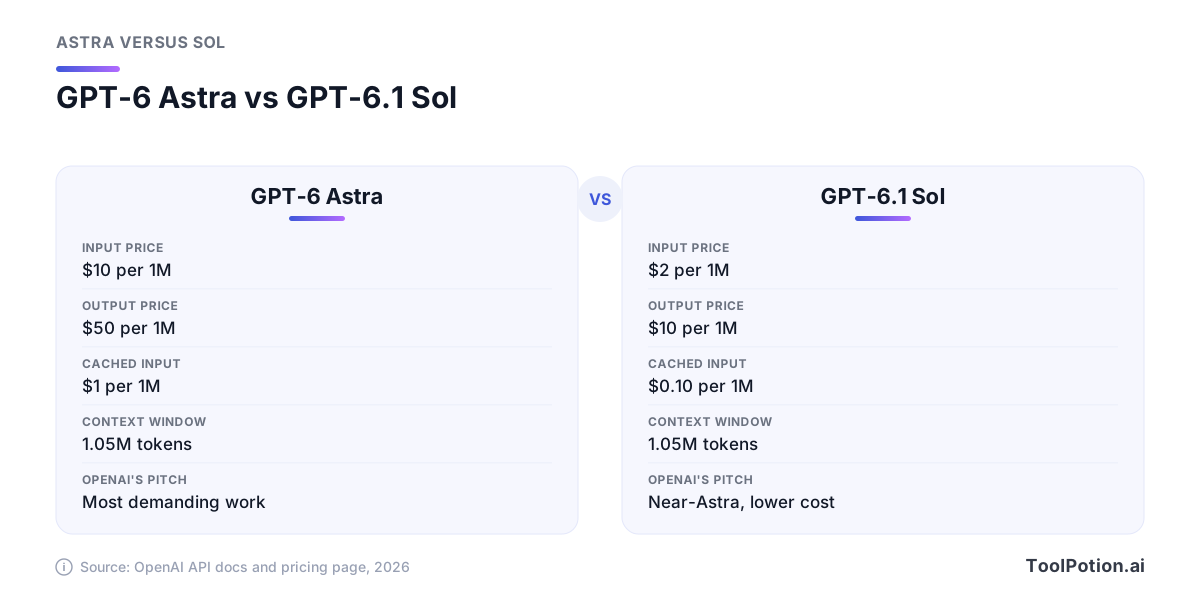
La carte ci-dessus met face à face les deux modèles entre lesquels vous hésiterez le plus probablement. La fenêtre de contexte est identique. Tout ce qui change, c'est le prix et le plafond de performance.
Quelles offres ChatGPT donnent accès à Astra
Le comparatif des offres d'OpenAI est net. Free et Go ne mentionnent pas Astra du tout. Plus l'inclut, Pro bénéficie d'un accès étendu, et l'offre Pro est présentée comme « Pro reasoning powered by GPT-6 Astra ». Les chats texte illimités de l'offre Free tournent sur GPT-5.6 Luna, pas sur la famille GPT-6.
| Offre | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| Free | Non | Non | Non |
| Go | Non | Non | Non |
| Plus | Oui | Oui | Oui |
| Pro | Étendu | Étendu | Étendu |
| Business | Flexible | Flexible | Flexible |
| Enterprise | Flexible | Flexible | Flexible |
« Flexible » est le terme d'OpenAI pour Business et Enterprise : l'accès est inclus, et les organisations peuvent acheter des crédits pour consommer davantage. Un siège Business standard est affiché à 20 $ par mois en facturation annuelle ou 25 $ en facturation mensuelle, et le siège Premium à 100 $ ou 125 $ (tarifs OpenAI Business).
Selon l'annonce de lancement d'OpenAI, Astra a d'abord été déployé auprès d'un nombre limité d'organisations, puis, dans les jours suivants, auprès des utilisateurs Plus, Pro, Business et Enterprise, de l'API, de Microsoft Azure et d'AWS Bedrock (OpenAI). Si vous êtes sur une offre payante et ne le voyez pas, revérifiez plus tard.
Une subtilité pour Sol. Le tableau des offres place GPT-6.1 Sol à partir de Plus, mais à son lancement, OpenAI indiquait qu'il était disponible dans ChatGPT Work et Codex, pas encore dans le Chat classique (OpenAI). L'emplacement de chaque modèle dans ChatGPT peut changer d'une semaine à l'autre : fiez-vous au sélecteur de modèle plutôt qu'à n'importe quel tableau, y compris celui-ci.
Ce qu'OpenAI présente comme nouveau
Le message d'OpenAI, c'est le travail agentique : des tâches plus longues à travers logiciels, navigateurs, documents et code, avec moins d'accompagnement. Son annonce indique que sur OSWorld 2.0, un test de pilotage du bureau, Astra a obtenu 72,6 % en mettant environ 47 % de temps en moins par tâche que GPT-5.6 Sol, qui a fait 65,7 % en à peu près 75 minutes. Sur Agents' Last Exam, un test de tâches professionnelles dans de vrais logiciels, il annonce 59,3 % contre 55,5 pour Claude Opus 5, avec environ 65 % de tokens de sortie en moins qu'Opus (OpenAI).
Le même tableau montre aussi où Astra ne gagne pas. Sur BenchCAD, il obtient 95,9 % contre 84,3 pour Claude Fable 5.1, mais sur l'Intelligence Index d'Artificial Analysis (version 4.1.1), il est à 61,2 contre 65,7 pour Fable 5.1. Ce sont des chiffres réalisés par le fournisseur, choisis par le fournisseur, même si OpenAI a bien publié ceux où il perd.
Le coût fait partie de l'histoire. Les 10 $ en entrée et 50 $ en sortie d'Astra représentent deux fois et demie le tarif actuel de GPT-5.6 Sol (4 $ et 20 $), bien qu'OpenAI qualifie le prix de Sol de promotionnel (tarifs OpenAI). Le GPT-5.6 plus ancien est la comparaison que font la plupart de ceux qui passent à la version supérieure.
Comment fonctionne l'utilisation de l'ordinateur
L'utilisation de l'ordinateur est une boucle, et le guide d'OpenAI la décrit en trois temps : capturer une image d'écran, laisser le modèle agir, recommencer jusqu'à ce que la tâche soit terminée (documentation OpenAI). Le modèle peut cliquer, double-cliquer, glisser, faire défiler, saisir du texte et attendre. La voie recommandée par OpenAI consiste à faire écrire au modèle de courts scripts Python ou JavaScript qui pilotent l'écran via des outils comme Playwright, l'outil computer classique restant pris en charge comme alternative. Le guide recommande Astra pour la voie par le code, tandis que gpt-6.1-sol fonctionne avec l'outil computer.
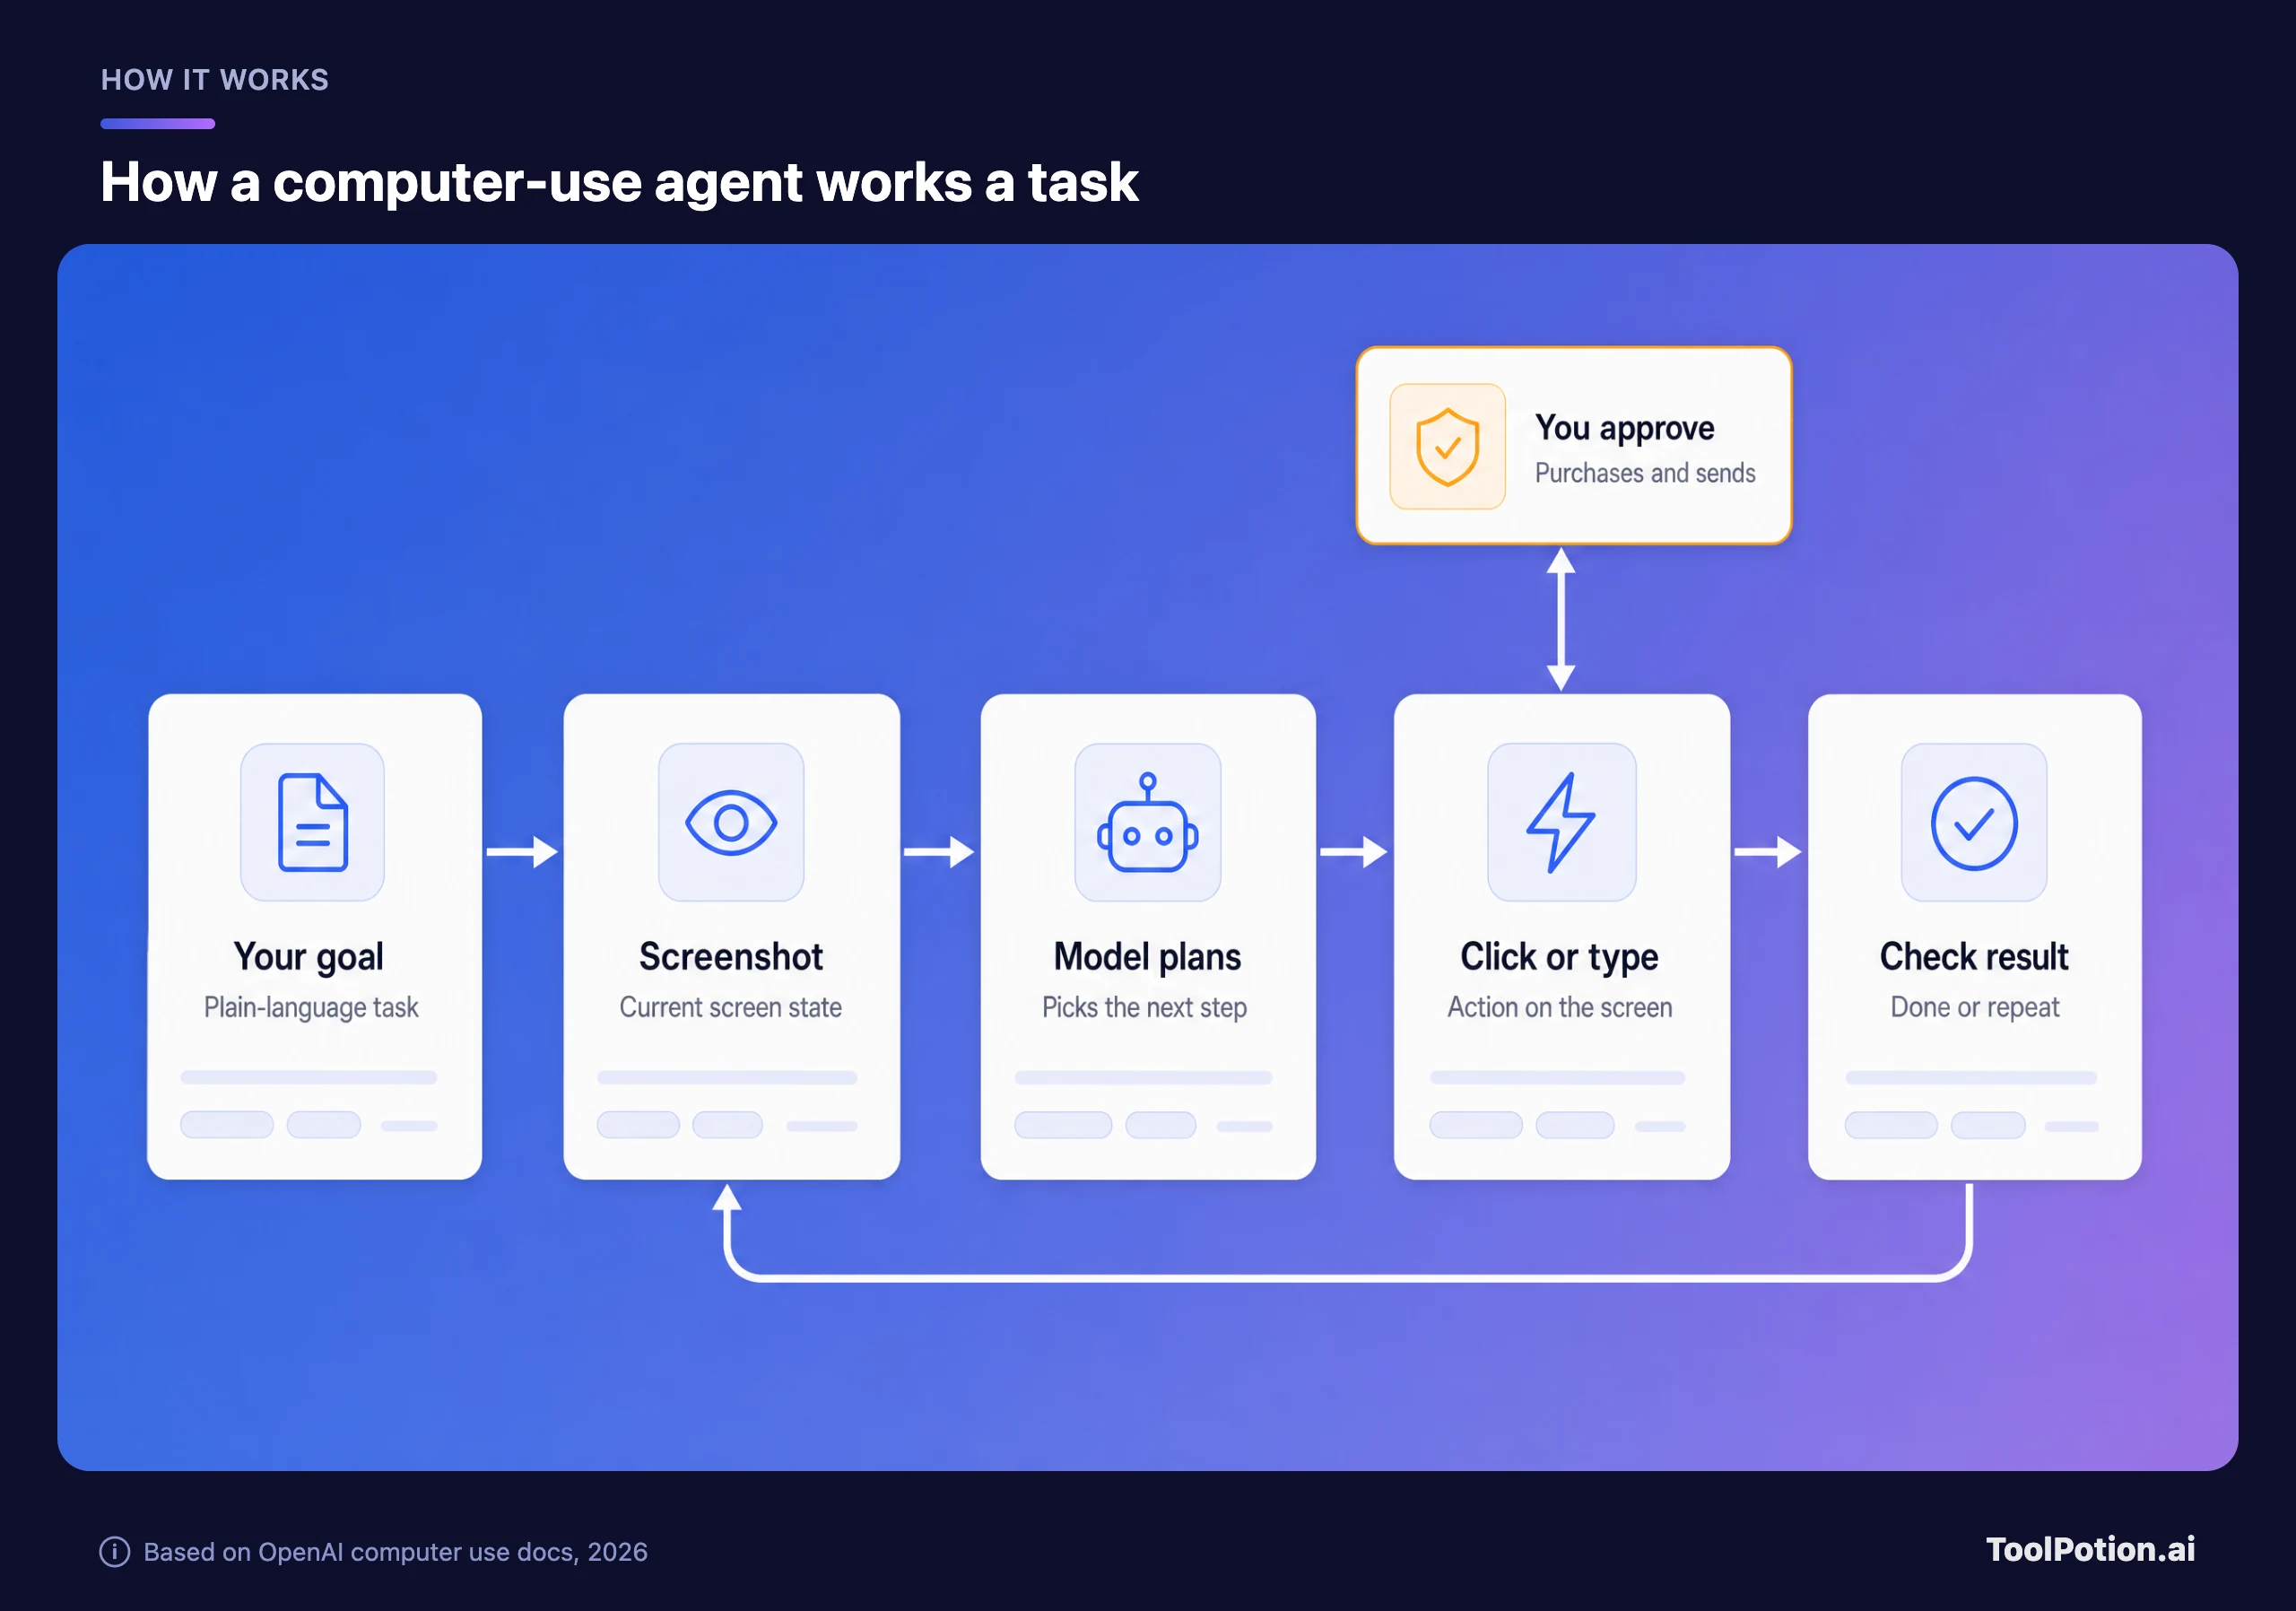
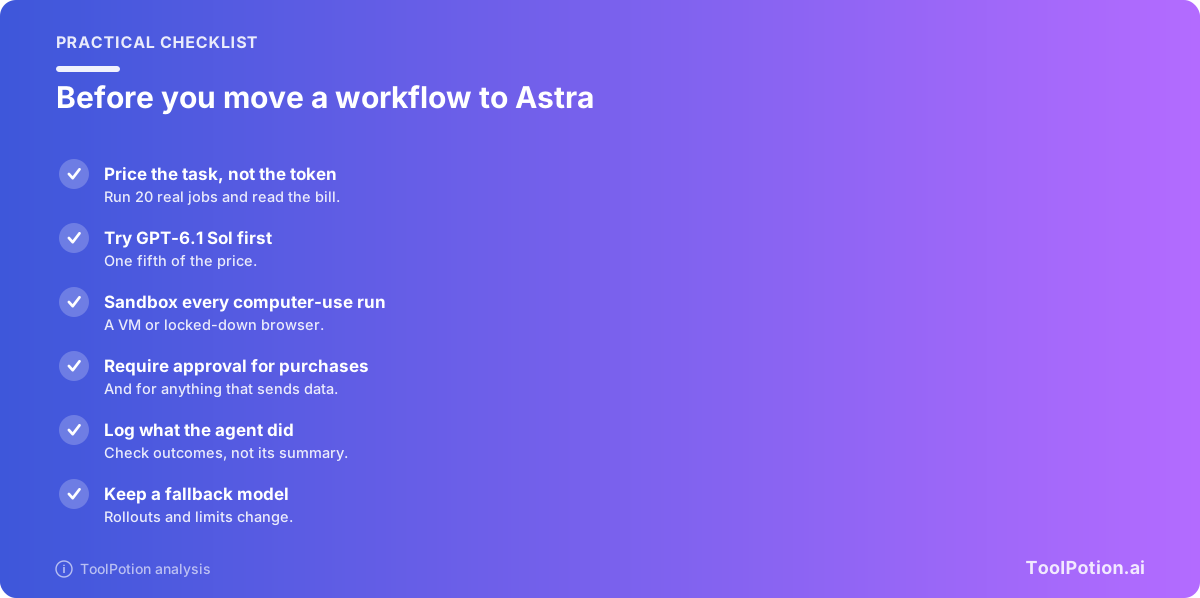
La carte ambre est celle qui compte. Le même guide demande aux développeurs d'isoler l'environnement dans un navigateur en sandbox ou une machine virtuelle, de faire confirmer les actions à risque comme les achats avant leur exécution, et de considérer tout ce qui s'affiche à l'écran comme non fiable, car le texte d'une page web peut tenter de détourner l'agent. Il précise même que saisir des informations sensibles dans un formulaire revient à les envoyer.
Côté grand public, c'est la mécanique derrière des agents de navigation comme ChatGPT Atlas, Perplexity Computer et Claude for Chrome, et derrière l'idée plus générale de Computer Use. Astra est un moteur plus puissant pour cette boucle. Ce n'est pas une chose d'une autre nature.
Ce que montrent les évaluations indépendantes
Les testeurs extérieurs dressent un tableau plus nuancé que l'annonce de lancement. Sur l'Intelligence Index d'Artificial Analysis, version 4.2 à effort max, The Batch de DeepLearning.AI rapporte Claude Fable 5.1 à 57, Astra à 55, Claude Opus 5 à 54 et GPT-5.6 Sol à 51 (The Batch).
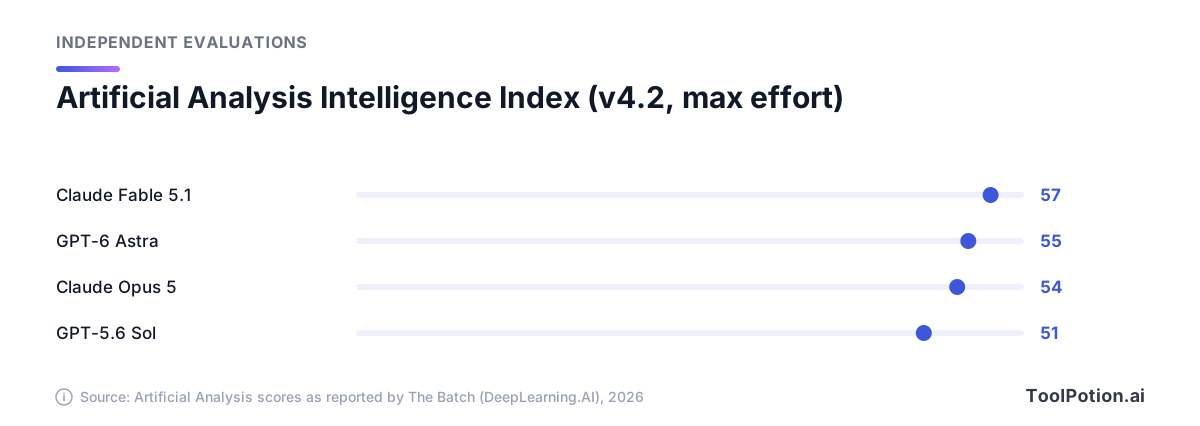
Astra fait donc un net bond par rapport à son prédécesseur et se classe deuxième sur cette version de l'index. Le classement n'est pourtant pas stable. Sur la mise à jour plus récente v4.3, The Batch indique qu'Astra est à égalité avec Fable 5.1 pour la première place, à 53, aidé par le remplacement de deux composantes de test. Quand deux versions de l'index ne s'accordent pas sur qui est devant, personne ne peut trancher.
Deux autres données indépendantes, toujours de The Batch. Sur le Vals Index, qui pondère les tests selon le poids de chaque secteur dans l'économie américaine, Astra a obtenu 66,61 contre 68,83 pour Fable 5.1, mais en 25 minutes par tâche contre 76 pour Fable. Et sur les tâches de code agentique d'Artificial Analysis, Astra a coûté à peu près autant par tâche que GPT-5.6 Sol malgré un prix par token 2,5 fois plus élevé, parce qu'il a consommé trois fois moins de tokens.
Reste le score phare qui demande une note de bas de page. OpenAI a annoncé 99,9 % sur ARC-AGI-3. ARC Prize, qui gère ce benchmark, confirme ce chiffre, mais uniquement avec son dispositif Provider Adapter, qui conserve l'état de raisonnement du modèle entre les requêtes. Dans sa configuration standard, Astra a obtenu 62,7 % (ARC Prize). Les deux sont des scores à l'état de l'art, mais ils mesurent des configurations différentes.
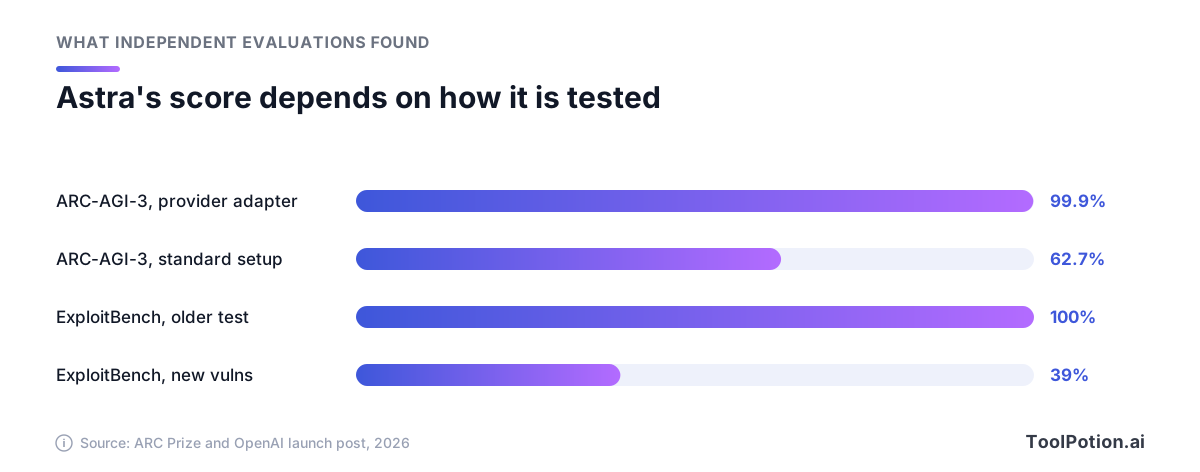
La deuxième paire de barres illustre une autre réserve. Astra a obtenu 100 % sur ExploitBench, un test de sécurité. La version plus récente d'OpenAI, construite à partir de vulnérabilités découvertes au cours des trois derniers mois pour que le modèle n'ait pas pu les voir, donne 39 %, ce qui reste très au-dessus des 5,5 de GPT-5.6 Sol (OpenAI). Les vieux benchmarks se saturent. Lisez n'importe quel chiffre de lancement comme vous liriez l'avis qu'un restaurant publie sur lui-même.
Ce que ça coûte
Le tarif catalogue de l'API pour Astra est de 10 $ par million de tokens en entrée et 50 $ par million en sortie, avec 1 $ pour l'entrée en cache (tarifs OpenAI). Les requêtes de plus de 272 000 tokens en entrée coûtent plus cher : la page du modèle indique 2x les tarifs d'entrée et de cache et 1,5x le tarif de sortie pour toute la requête, ce qui correspond aux 20 $ en entrée et 75 $ en sortie de la page de tarification. Le mode Fast double le prix pour une vitesse environ deux fois supérieure. Batch et Flex le divisent par deux.
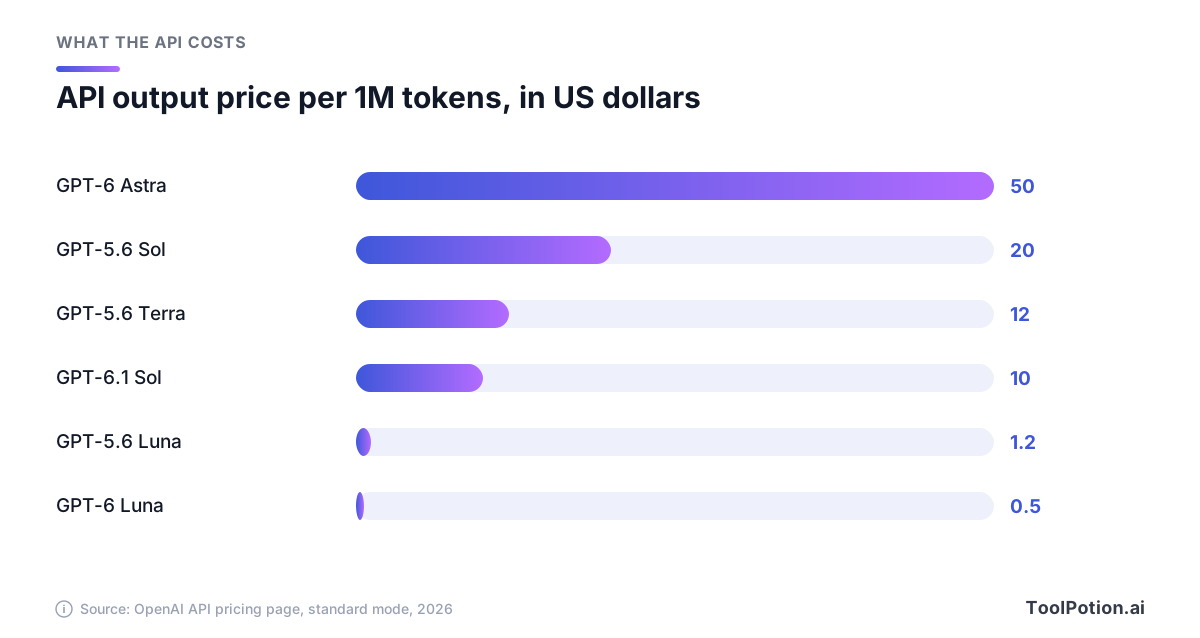
Astra est de loin le modèle le plus cher de la page. GPT-6.1 Sol coûte 10 $ en sortie, soit le prix d'entrée d'Astra, et les 0,50 $ de Luna représentent un centième de ceux d'Astra. Le prix par token ne fait pas toute la facture, cependant. Les chiffres d'OpenAI pour Terminal-Bench Science montrent l'écart par tâche : environ 23,80 $ pour Astra contre 5,47 $ pour GPT-6.1 Sol à effort maximal.
Les tokens de raisonnement comptent comme de la sortie, et la sortie est le côté coûteux. Une longue exécution d'agent à effort max peut en consommer beaucoup. L'estimateur ci-dessous utilise les tarifs catalogue et vous permet de saisir votre charge de travail ; les valeurs par défaut décrivent 5 000 tâches par mois avec 20 000 tokens en entrée et 4 000 en sortie.
Avec ces valeurs par défaut, Astra revient à 2 000 $ par mois, Sol à 400 $ et Luna à 20 $. L'estimateur ignore le cache, les remises Batch et les tarifs de contexte long : les factures réelles pour des prompts répétés seront donc plus basses. Ce qui ne change pas, c'est le ratio. Si un modèle moins cher réussit vos tests, l'économie est à la hauteur de l'écart de qualité que vous paieriez.
Limites de sécurité et ce qu'Astra refuse
OpenAI affirme qu'Astra est le premier de ses modèles à atteindre le seuil « Critical » en cybersécurité selon son Preparedness Framework : il peut trouver des failles logicielles inconnues et développer des exploits fonctionnels, et il a découvert deux zero-days jusque-là inconnus pendant les tests (OpenAI).
La version publique est volontairement bridée. OpenAI indique qu'elle refuse les tâches de sécurité avancées comme la création d'exploits de preuve de concept, et qu'un système de classifieurs surveille son raisonnement et ses actions et arrête automatiquement toute activité potentiellement non autorisée. Un accès élargi pour des défenseurs vérifiés est prévu via le programme Daybreak d'OpenAI, avec des garde-fous moins restrictifs promis dans les semaines à venir.
La note la plus inhabituelle concerne la supervision. OpenAI rapporte que le raisonnement écrit d'Astra est plus difficile à surveiller que celui de GPT-5.6 Sol, d'après des tests lui demandant explicitement d'échapper à la surveillance, et l'attribue à son meilleur contrôle de son raisonnement. Elle affirme aussi qu'Astra fait moins d'affirmations trompeuses sur ses propres capacités. Dans les deux cas, c'est OpenAI qui décrit son propre modèle, et ce sont deux raisons de garder un humain dans la boucle pour tout ce qui porte à conséquence.
Astra, Sol ou Luna : une règle de décision
Partez de la tâche, pas du classement. OpenAI affirme que GPT-6.1 Sol égale Astra sur DeepSWE v1.1, un test de tâches réelles d'ingénierie logicielle, pour environ un cinquième du coût, et reste à 2,1 points sur OSWorld 2.0 pour environ un septième du coût par tâche. Astra garde le meilleur score sur Terminal-Bench Science, à 68,1 %, et OpenAI recommande de l'utiliser pour la recherche scientifique la plus difficile (OpenAI). Ce sont des comparaisons d'OpenAI lui-même : voyez-y une forte incitation à tester, pas un verdict.
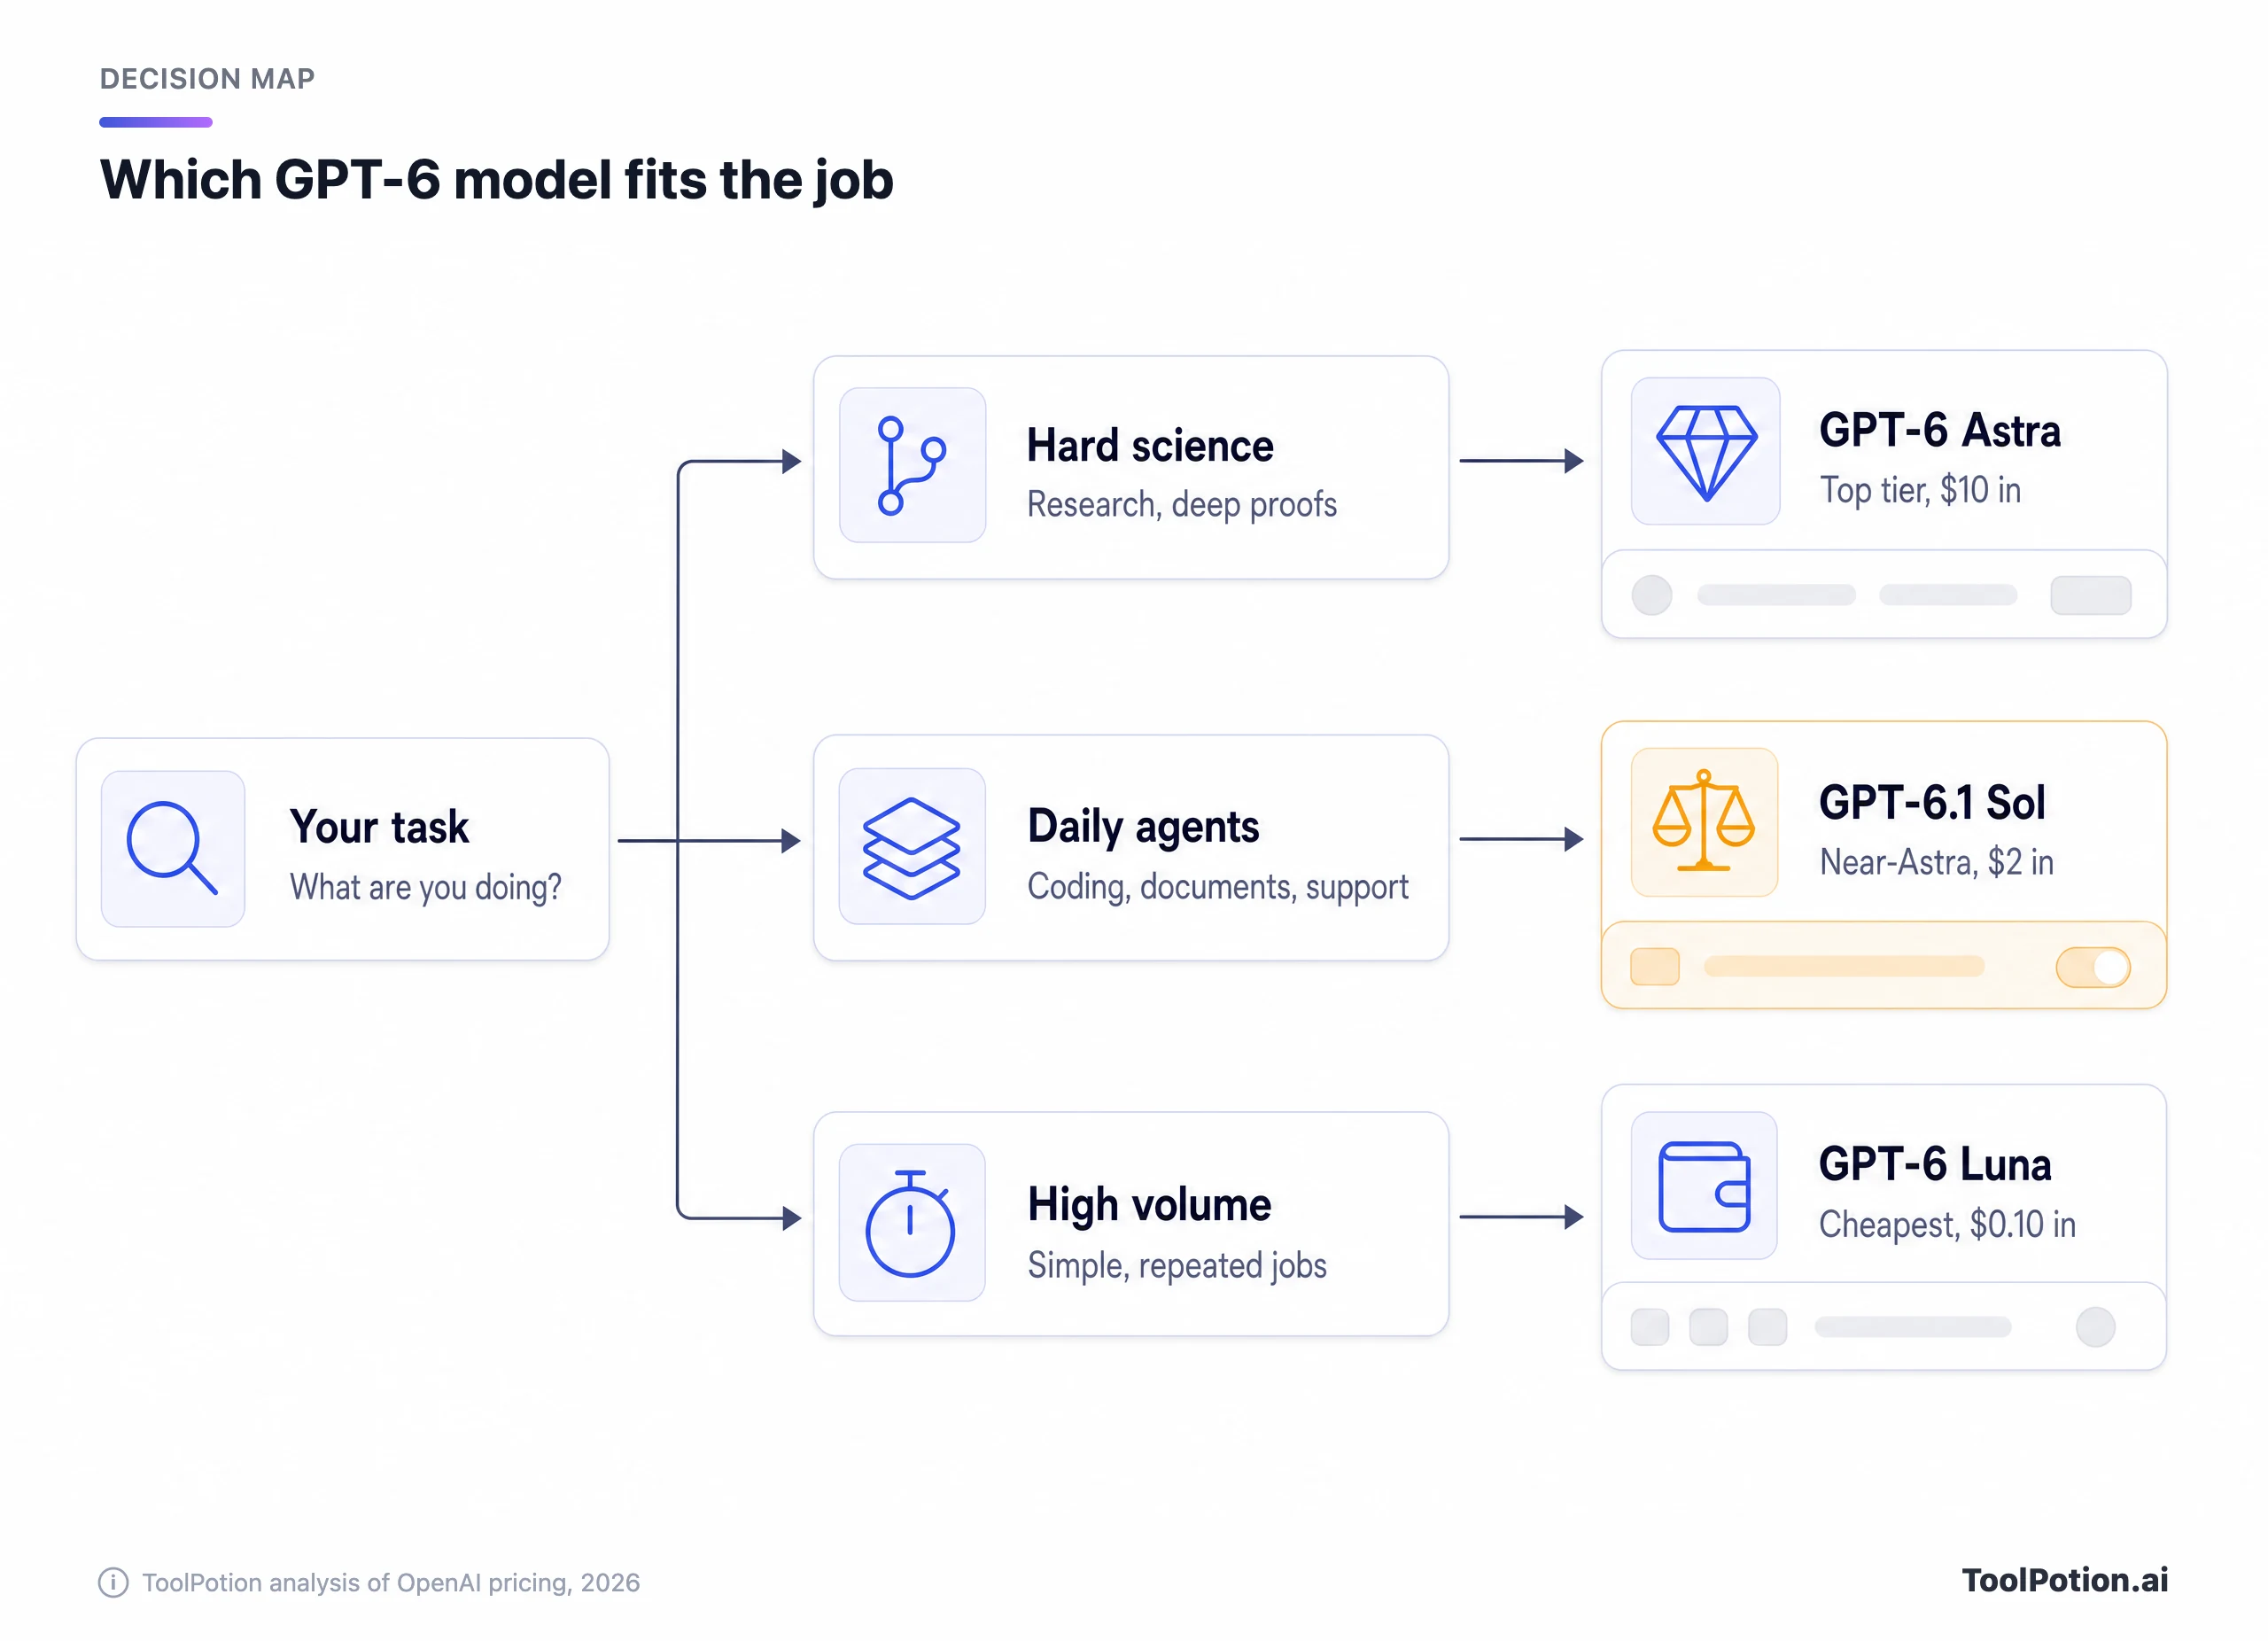
Une règle pratique raisonnable tirée de ces éléments : Sol par défaut pour le travail d'agent quotidien, Luna pour les tâches simples et répétitives comme l'étiquetage, le routage et l'extraction, et Astra seulement quand un duel sur vos propres exemples révèle un écart pour lequel vous êtes prêt à payer. Faites le test rapide ci-dessous.
Si vous construisez un produit, l'expérience la moins chère consiste à passer vingt tâches réelles dans Sol et dans Astra, puis à comparer les taux de réussite et la facture réelle. Vingt tâches coûtent quelques dollars et règlent la question mieux que n'importe quel graphique.
Pour les utilisateurs de ChatGPT sur Plus et au-delà, la question pratique est plus modeste. Vous avez déjà la famille GPT-6 dans votre offre. Utilisez le modèle par défaut pour les conversations normales et essayez Astra sur la tâche que le modèle par défaut rate sans cesse. Si vous travaillez dans d'autres écosystèmes, Claude et Google Gemini se battent dans la même catégorie, et notre classement des 25 meilleurs LLM les suit.
Qui peut l'ignorer pour l'instant
Les utilisateurs de Free et Go peuvent ignorer Astra complètement, puisqu'il n'est pas dans ces offres. Ceux qui utilisent ChatGPT pour des e-mails, des résumés, du brainstorming et de l'aide aux devoirs ne verront pas de différence qui vaille la peine. Les gains apparaissent dans le travail long et riche en outils.
Les équipes déjà bien installées dans une autre pile n'ont guère de raison de changer. Claude Fable 5.1 d'Anthropic dépasse Astra sur certaines versions de l'index d'Artificial Analysis, et les équipes de développement comparent Codex dans ChatGPT et Claude Code sur leurs propres dépôts plutôt que sur des graphiques de lancement. Les entreprises qui manipulent des données réglementées doivent lire les limites de sécurité ci-dessus avant de lâcher un agent sur des systèmes en production.
Qui devrait l'essayer maintenant : les développeurs dont les agents multi-étapes échouent aujourd'hui à mi-parcours, les analystes qui vivent dans les tableurs et les documents, et tous ceux dont le pilote d'utilisation de l'ordinateur a péri faute de fiabilité. Pour eux, Astra ou Sol vaut un nouveau test. Pour un panorama plus large, consultez le classement des 20 meilleurs modèles d'IA et LLM et notre guide des modèles d'IA et LLM en 2026. Les anciens modèles d'OpenAI comme GPT-5.5 restent référencés si vous avez besoin d'un point de comparaison, et notre article sur les alternatives à ChatGPT couvre le reste.
Il y a aussi un exemple client à lire. Notre annuaire contient une étude de cas Perplexity x GPT-6 Astra qui montre comment une entreprise de recherche décrit son usage du modèle.
Questions fréquentes
GPT-6 Astra est-il gratuit dans ChatGPT ?
Non. Le tableau des offres d'OpenAI indique Astra pour Plus, Pro, Business et Enterprise, et précise qu'il n'est pas inclus dans Free et Go. Les utilisateurs Free ont GPT-5.6 Luna pour les chats texte.
Quelle différence entre GPT-6 Astra et GPT-6.1 Sol ?
Astra est le haut de gamme, à 10 $ en entrée et 50 $ en sortie par million de tokens. Sol est à 2 $ et 10 $ et, selon OpenAI, offre des performances proches d'Astra. Les deux ont une fenêtre de contexte de 1,05 million de tokens. Sol est le meilleur choix par défaut ; Astra est réservé aux tâches les plus dures.
Puis-je utiliser Astra dans l'API, et combien ça coûte ?
Oui. Le tarif catalogue est de 10 $ par million de tokens en entrée et 50 $ par million en sortie, avec 1 $ pour l'entrée en cache. Batch le divise par deux et le mode Fast le double. Les entrées au-delà de 272 000 tokens coûtent plus cher, à 20 $ en entrée et 75 $ en sortie.
Astra bat-il Claude ?
Ça dépend du test. Sur l'index d'Artificial Analysis v4.2, Claude Fable 5.1 a obtenu un meilleur score ; sur la v4.3, plus récente, les deux sont à égalité en tête. Sur les benchmarks d'agents et d'utilisation de l'ordinateur publiés par OpenAI, Astra devance Claude Opus 5. Les graphiques des fournisseurs et les index indépendants ne s'accordent pas toujours : testez sur votre propre travail.
Est-il sûr de laisser Astra contrôler mon ordinateur ?
Seulement avec des garde-fous. Le guide d'OpenAI lui-même demande de l'exécuter en sandbox, d'exiger une approbation pour les achats et l'envoi de données, et de considérer le texte à l'écran comme non fiable. OpenAI indique aussi que le raisonnement d'Astra est plus difficile à surveiller que celui de GPT-5.6 Sol.
Pourquoi le score ARC-AGI-3 varie-t-il autant selon les sources ?
Les configurations de test diffèrent. Les 99,9 % d'OpenAI viennent du dispositif Provider Adapter d'ARC Prize, qui transmet l'état de raisonnement d'une requête à l'autre. La configuration standard d'ARC Prize donne 62,7 %. Le modèle est le même ; l'échafaudage autour, non.