

« Nous ne prétendons pas encore comprendre pleinement la preuve. » Cette phrase vient du comité que OpenAI a nommé pour examiner son prétendu résultat sur Yang-Mills, citée par Scientific American. Le groupe, dirigé par le physicien David Gross, venait de confirmer que la preuve d'une moitié du problème est valide dans Lean, un langage de programmation qui vérifie les travaux mathématiques. Il ne pouvait toujours pas expliquer comment la preuve fonctionne.
Nous avons lu les publications les plus récentes sur l'IA appliquée à la science : cet article, cinq billets d'Anthropic, un benchmark de laboratoire d'OpenAI, TechCrunch sur une startup appelée PSI, et le billet d'un blogueur dont les agents IA ont repéré un site maya absent du registre officiel du Mexique. Les titres de presse vont bien au-delà de tout cela. Nous avons donc pris six affirmations courantes et vérifié chacune d'elles par rapport à ce que disent réellement les sources.
Affirmation 1 : l'IA découvre désormais de la science nouvelle toute seule
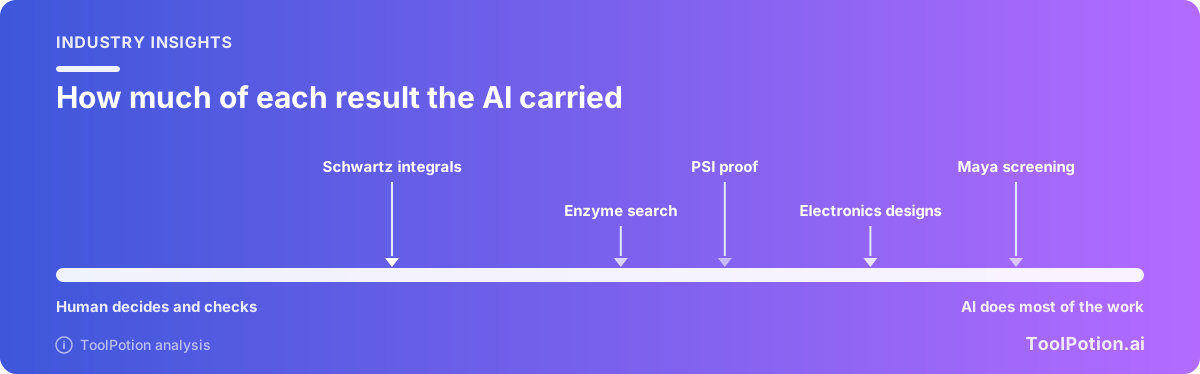
Verdict : pas toute seule. Les meilleurs cas sont réels, et dans chacun d'eux, un humain a choisi la question, effectué les vérifications, ou les deux.
Commençons par la biologie. Anthropic affirme que des agents Claude ont trouvé un système enzymatique avec des répétitions de type CRISPR, en mobilisant environ 950 agents, 210 millions de tokens et 21 heures (Anthropic). Un agent a repéré le motif de répétition. Les scientifiques d'Anthropic ont fourni le prompt de départ et fait tout le travail en laboratoire, la plupart des candidats de Claude ont été écartés à la relecture, et l'article est un preprint. Les travaux sur la fonction principale du système sont toujours en cours. Le billet dit que Claude « semble être le premier à avoir remarqué » les caractéristiques déterminantes du système, et qu'il « peut détecter des anomalies de manière autonome » : c'est juste pour l'étape de recherche, pas pour le reste. Feng Zhang, du MIT et du Broad Institute, cité dans le même billet après avoir lu le preprint, y voit « un exemple enthousiasmant de la façon dont les agents IA peuvent contribuer à la découverte biologique » et estime que la trouvaille « mérite une investigation plus poussée ».
Le physicien Matthew Schwartz, chercheur invité chez Anthropic, est plus franc que la plupart. Dans un billet invité pour Anthropic, il rapporte 30 intégrales traitées de bout en bout avec Claude : 15 reproduisaient des résultats connus et 15 n'avaient jamais été calculées auparavant (Anthropic). Il qualifie les bonnes cibles de problèmes « Claude-shaped », et ajoute qu'« il peut falloir beaucoup d'accompagnement pour qu'ils produisent quoi que ce soit de valeur scientifique ». Après avoir fait venir des experts extérieurs, il a constaté que « dans presque tous les cas, Claude avait techniquement raison, mais le résultat n'était pas très intéressant tant que l'expert ne nous avait pas aidés à orienter le travail ». Claude, dit-il, « semble privilégier les vieux débats, très cités mais oubliés depuis longtemps ». Le jugement sur ce qui vaut la peine d'être résolu est resté aux humains.
Passons à PSI. TechCrunch rapporte que David Turturean, membre de l'équipe technique du laboratoire startup Physical Superintelligence (PSI), a utilisé un accès anticipé au modèle Fable 5.2 d'Anthropic pour résoudre un problème vieux de 18 ans issu de l'informatique quantique, la conjecture d'Aaronson-Ambainis (TechCrunch). Scott Aaronson, qui a posé le problème, écrit qu'il ne comprend pas tout à fait la preuve mais la croit correcte, parce qu'elle a été autoformalisée dans Lean et expliquée par une équipe de chercheurs de haut niveau à qui PSI l'a soumise. La description qu'en fait Turturean lui-même est modeste : « C'est un résultat négatif qui permet aux gens de savoir : ok, inutile de chercher de ce côté-là. » La solution semble fermer une voie vers les accélérations quantiques, pas toutes.
Nous parlerions d'un collaborateur rapide et infatigable, qui a besoin que quelqu'un d'autre choisisse le problème. C'est déjà beaucoup. Mais ce n'est pas de l'autonomie, et les billets des entreprises elles-mêmes le disent si on lit jusqu'aux réserves.
Affirmation 2 : les résultats sont vérifiés
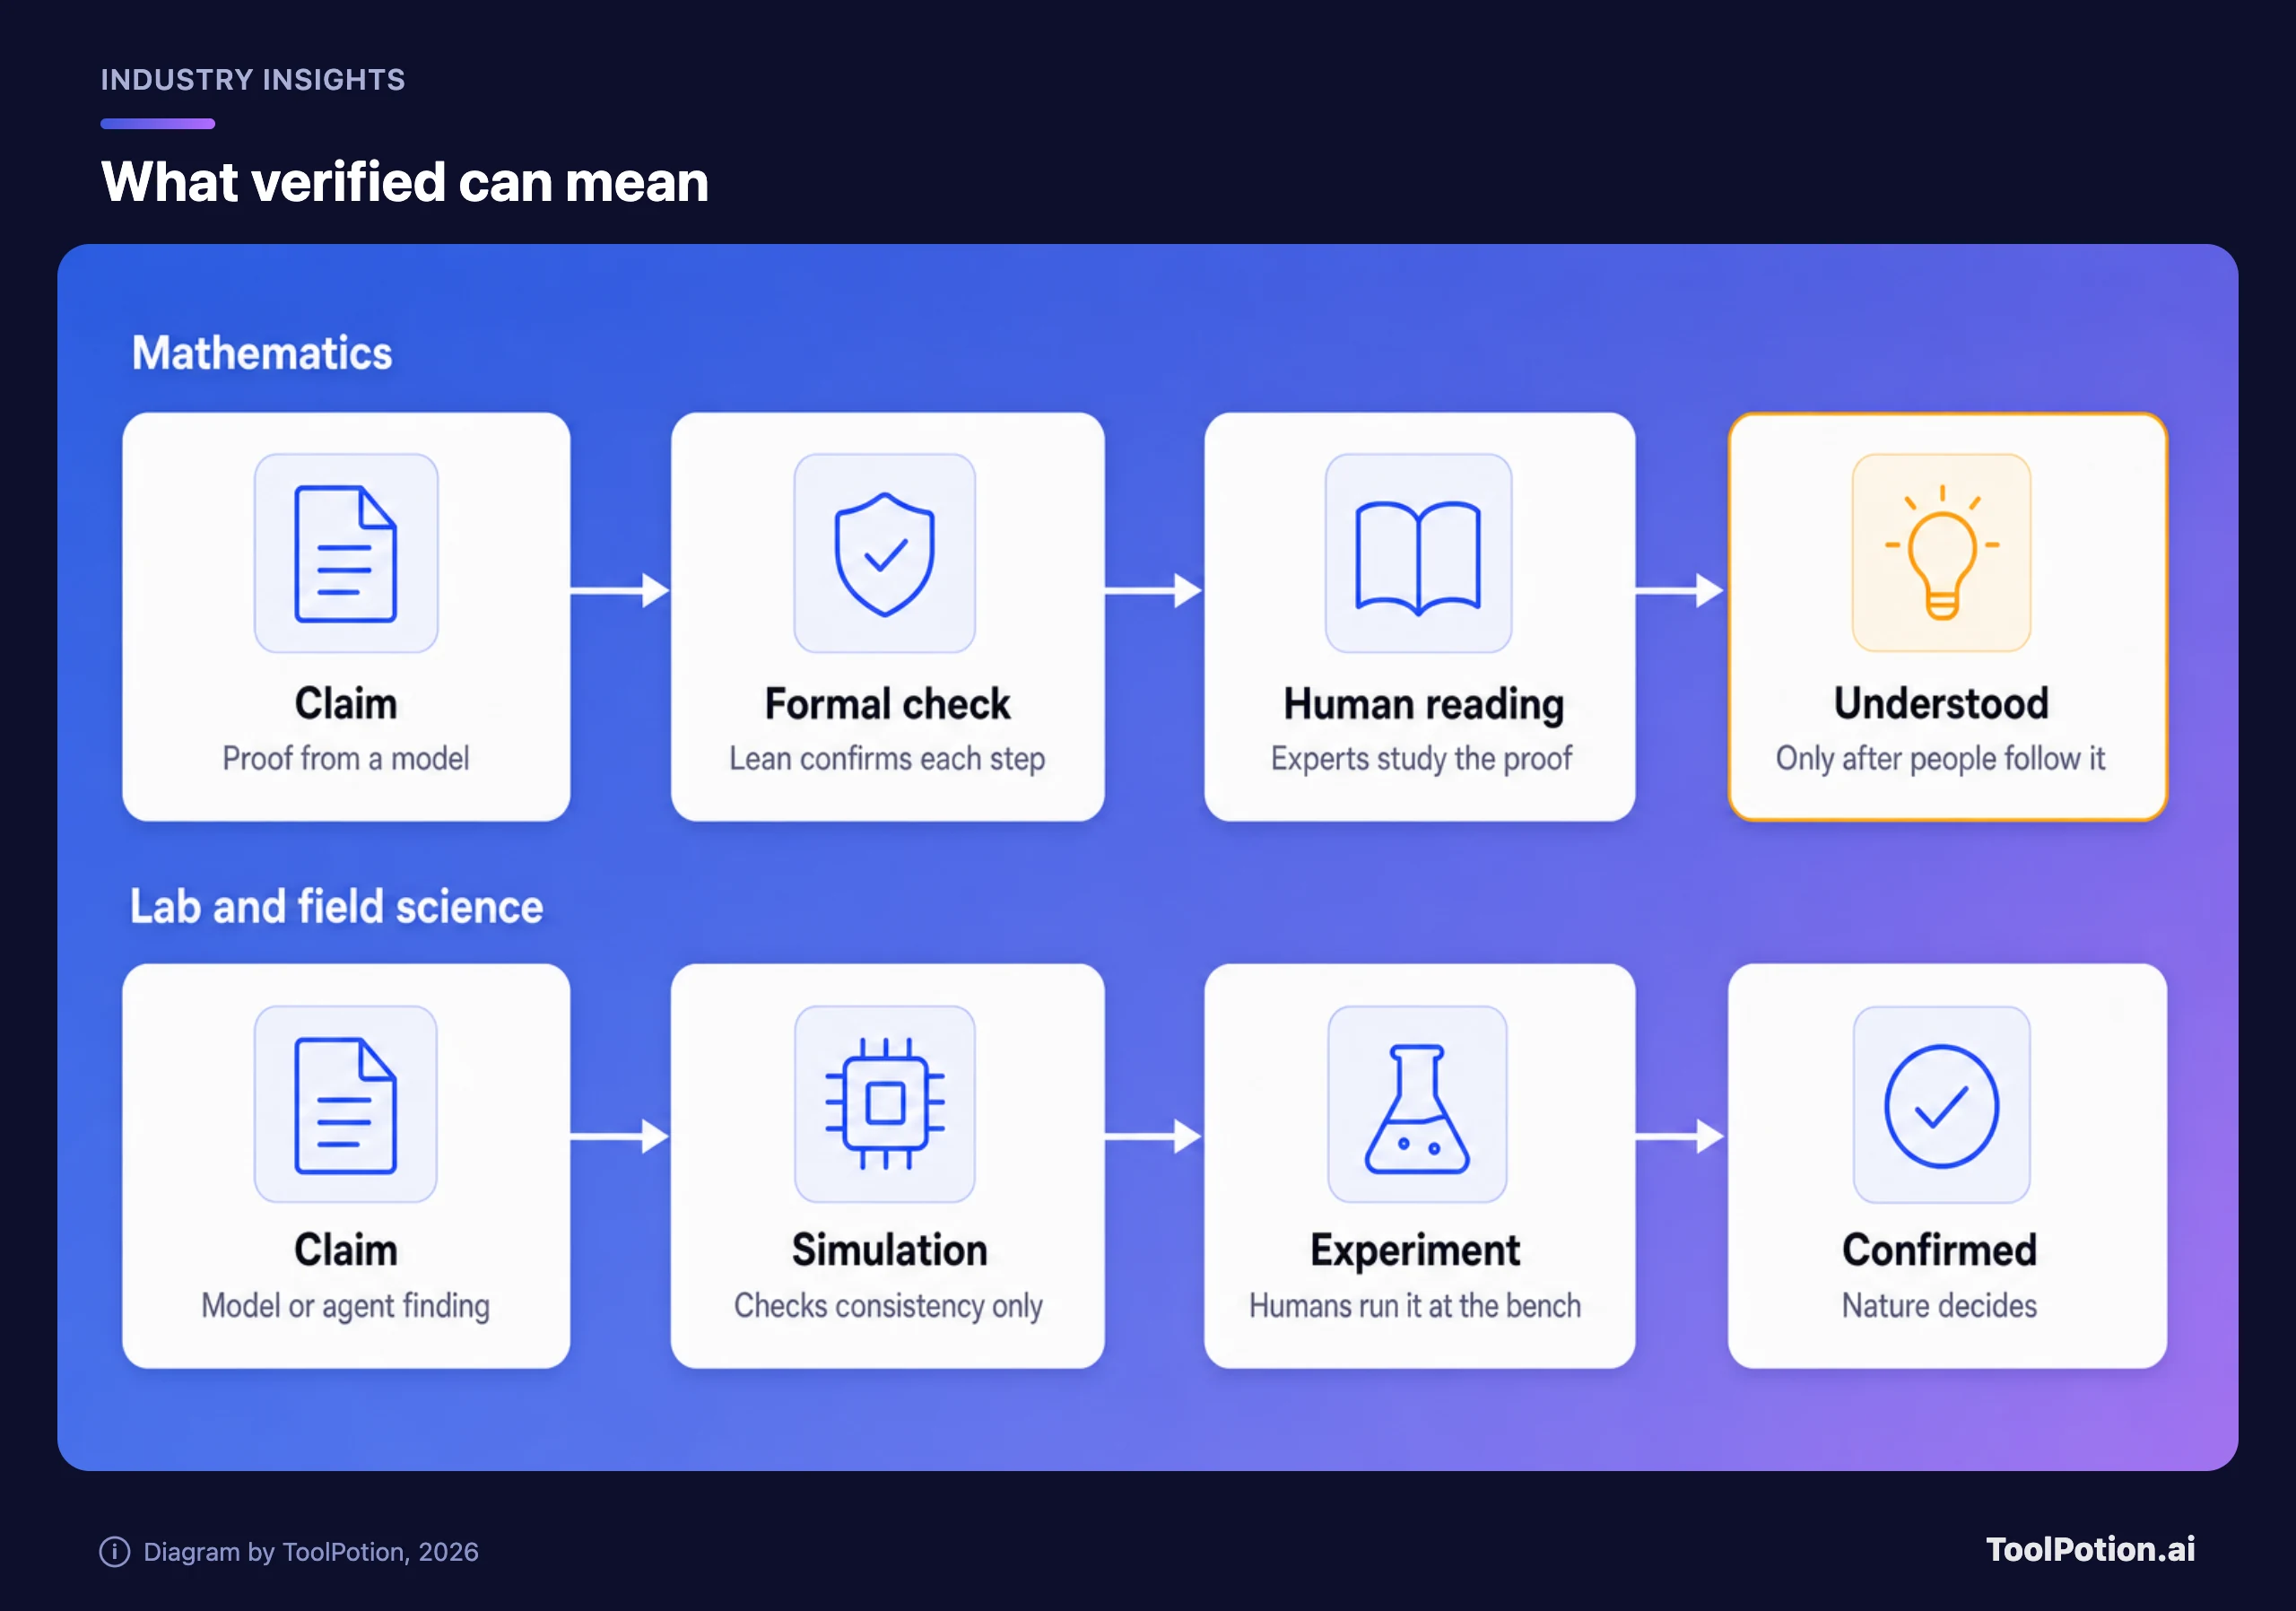
Verdict : en partie. En mathématiques, un vérificateur formel est un test solide. Ailleurs, « vérifié » peut vouloir dire n'importe quoi, d'une simulation à une consultation de registre.
En mathématiques, Lean peut confirmer mécaniquement qu'une preuve découle de l'énoncé qu'on lui a donné. C'est un contrôle solide, et c'est la raison pour laquelle les résultats de PSI et d'OpenAI sont pris au sérieux. Mais l'article de Scientific American en montre les limites. L'affirmation d'OpenAI porte sur la moitié « existence » du problème de Yang-Mills ; l'autre moitié, celle du « mass gap », reste non résolue. Le comité a utilisé le propre modèle Astra d'OpenAI pour l'aider à digérer le code Lean, et dit sans détour qu'il ne prétend pas encore comprendre la preuve.
Reste la question de l'ouverture. Scientific American note que l'approche par « accompagnement » va à l'encontre des recommandations de transparence d'un groupe consultatif affilié à OpenAI, et a irrité certains mathématiciens qui y voient du gatekeeping. La preuve Lean est désormais publique. Scott Armstrong, de NYU, s'est dit content qu'elle soit enfin sortie et a ajouté : « Cette revue peut se faire plus efficacement et plus vite en public » (Scientific American). Nous sommes d'accord avec lui. Une preuve que seul le comité nommé par OpenAI avait vue n'était qu'une affirmation en attente de relecture, et la relecture peut enfin commencer.
Hors des mathématiques, il n'y a pas de Lean. Matt Pines, le CEO de PSI, a dit à TechCrunch que la physique diffère des maths parce que « la nature a son mot à dire sur vos modèles de la réalité », et que la physique théorique pilotée par des machines, « ce n'est pas encore ça, mais on y va ». Schwartz a constaté que « les vérifications automatisées ne sont toujours pas fiables ». Quant au billet sur les Mayas, sur lequel nous reviendrons, il a reçu une réponse officielle : l'institut mexicain n'a trouvé aucun site enregistré à l'emplacement signalé. Cela confirme une absence dans un registre. Cela ne confirme pas l'existence d'un site.
Affirmation 3 : les agents peuvent faire tourner un labo
Verdict : pas encore. Ils savent planifier, concevoir et analyser. Ce sont toujours des humains qui pipettent et soudent.
Le billet d'Anthropic sur l'électronique est l'exemple récent le plus solide, et il mérite d'être lu en entier. En collaboration avec le fabricant de cartes Diode (Anthropic précise avoir une relation commerciale avec cette entreprise), Claude (le modèle Fable 5.2) a conçu un haut-parleur de conférence USB-C, un hub d'assistant vocal et un animal virtuel de poche, du schéma au routage en passant par le firmware (Anthropic). Les ingénieurs de Diode ont fabriqué les cartes à partir des fichiers de conception de Claude, puis construit et testé les prototypes à la main, car Claude n'était relié ni à des équipements de test ni aux machines qui produisent les circuits imprimés. Les appareils n'ont pas subi de validation électrique, de réglage d'antenne, de tests thermiques ni de certification. Le billet cite aussi des gains sur benchmark (69 % sur le test interne de routage PCB Gym de Diode, contre 25 % pour le modèle précédent), qui sont des chiffres d'Anthropic sur un test réalisé à sa demande, et il n'indique le coût que sur l'axe d'un graphique, pas dans le texte.
Côté biologie, OpenAI a publié BioBasicsBench, un benchmark de 100 tâches qui, selon elle, mesure la capacité des agents IA à interpréter des données expérimentales brutes et à gérer la science de paillasse du quotidien (OpenAI). C'est un test conçu par l'éditeur, et un benchmark reste une affirmation tant que des tiers n'ont pas pu le faire tourner.
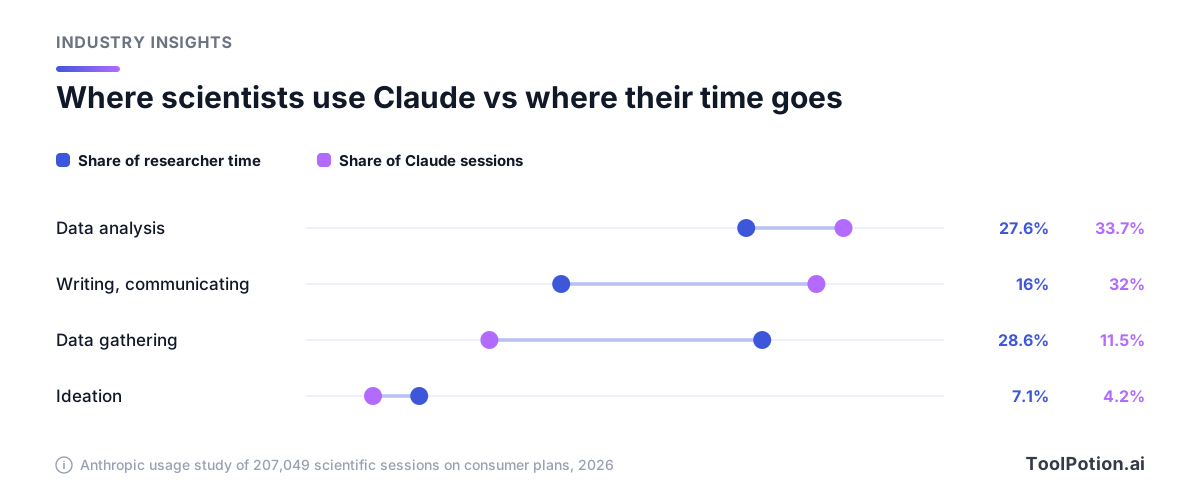
L'étude d'usage d'Anthropic, portant sur 207 049 sessions scientifiques sur des forfaits grand public, montre la même configuration en conditions réelles. La collecte de données représente 28,6 % du temps des chercheurs, mais seulement 11,5 % des sessions sur Claude, et l'écart est le plus large là où il y a des obstacles physiques, comme la collecte de données cliniques ou biochimiques (Anthropic). Selon les termes de l'étude : « les goulots d'étranglement physiques restent puissants ».
Affirmation 4 : n'importe qui peut le faire maintenant
Verdict : n'importe qui peut se lancer. Obtenir un résultat qui tient la route demande quelqu'un qui connaît le domaine.
L'histoire des Mayas est le test le plus net. Pietro Miotti, qui dit ne pas être archéologue, a lancé 48 agents sur environ 1 200 kilomètres carrés de données lidar publiques de la NASA et a obtenu un site au sommet d'une colline, avec une place et une pyramide, puis une réponse officielle, en moins de 72 heures (son billet). Sa description de la méthode est d'une simplicité admirable : « Aucun modèle spécial ni classifieur n'était impliqué : les agents ont littéralement regardé les images. »
Vient ensuite la correction, qui figure désormais en haut de la page. « Les agents l'ont manqué en parcourant la littérature, ils l'ont donc redécouvert plutôt que découvert. » Le site était déjà cartographié dans un article de 2025 d'Estrada-Belli et ses collègues ; il n'était simplement pas encore dans le registre mexicain. Bravo à Miotti de l'avoir mis en premier. Il précise aussi qu'il ne parle pas espagnol et qu'il a fait confiance à la traduction de son rapport par les agents, que l'histoire de la période classique relève de la « spéculation, issue d'une longue conversation avec les agents », et que l'image de reconstitution est générée par IA. Aucune prospection sur le terrain n'est décrite.
Notre lecture : c'est une bonne démonstration de criblage à bas coût et une piètre démonstration de découverte. Regarder est désormais presque gratuit. Savoir si quelqu'un a déjà regardé avant vous demande toujours un spécialiste, ou au moins une recherche bibliographique que les agents n'ont pas faite correctement. La démarche de PSI était différente et instructive : l'entreprise a gardé le résultat sous le coude jusqu'à ce que le modèle d'Anthropic soit presque prêt à sortir, et a mis ce temps à profit pour le montrer à des chercheurs capables de l'expliquer. Jim Halverson, professeur à Northeastern et conseiller de PSI, a dit à TechCrunch que « les bonnes pratiques sont encore en train d'émerger ».
Affirmation 5 : les scientifiques vont bientôt être automatisés
Verdict : non démontré, et les affirmations les plus bruyantes viennent de gens qui y ont intérêt.
Turturean a dit à TechCrunch : « J'accepte tout à fait l'idée que ce soit peut-être le dernier article que je publie. » Pines a raconté qu'il y a six à neuf mois, face à des investisseurs, il « devait un peu forcer le trait » pour dire que la physique théorique serait bientôt surtout le domaine des machines, et que ce n'est « pas encore ça ». L'enquête d'Anthropic indique qu'environ 40 % de 528 chercheurs s'attendent à ce que l'IA mène seule des projets de recherche complets d'ici 2030, mais ils ont été recrutés parmi les candidats aux programmes de subventions AI for Science d'Anthropic, ce sont donc probablement des utilisateurs d'IA plus assidus que la moyenne (Anthropic).
Les chiffres modélisés sont plus modestes. Selon la modélisation d'Anthropic, les capacités actuelles, si elles étaient largement adoptées, pourraient prendre en charge 27 à 52 % du temps de chercheur nécessaire à une nouvelle étude, ce qui implique une production multipliée par 1,35 dans les arts et jusqu'à 2,02 en statistiques. Le scénario hypothétique du rapport, où l'IA automatise tout le travail non physique, atteint environ 15x en statistiques et en informatique, mais seulement 3 à 4x dans les sciences de paillasse comme la biologie et la chimie, où les étapes physiques restent le goulot d'étranglement. C'est un scénario, pas une mesure. Même le cas modeste représente un grand changement pour une discipline. Ce n'est pas un remplacement, et le rapport note que le travail de l'IA aujourd'hui est surtout d'assistance ou partagé. Sur la question de savoir à qui revient le mérite, Schwartz le dit mieux que nous : cela « ne se réglera pas en prétendant que la contribution humaine, c'était la frappe au clavier ».
Affirmation 6 : si le modèle de l'IA colle aux données, nous comprenons le système
Verdict : faux, et les auteurs qui construisent ces systèmes le disent eux-mêmes.
Un billet invité d'un groupe de Tübingen (Jakob Macke, Daniel Gedon et Stefan Wahl, tous bénéficiaires de subventions AI for Science d'Anthropic) sur l'apprentissage de la construction de modèles scientifiques par l'IA développe l'argument avec soin. De nombreux modèles s'ajustent aux mêmes données, si bien que le résultat utile est un éventail de modèles plausibles et la liste de ce sur quoi ils s'accordent (Anthropic). Ils reconnaissent que ces systèmes « ont surtout été testés sur la redécouverte de modèles que les scientifiques connaissent déjà », avec peu d'éléments sur des problèmes sans réponse connue. Et ils écrivent : « Un système d'IA qui se contente de vous remettre le modèle peut vous donner une réponse, mais il ne vous donne pas de compréhension. »
Nous pensons que cette dernière phrase devrait être affichée au-dessus de chaque paillasse de labo et de chaque bureau d'étudiant. Un ajustement n'est qu'un chiffre. Une explication, c'est ce qu'une personne peut utiliser pour prédire la suite.
Une routine pour chercheurs et étudiants
Rien de tout cela ne dit qu'il faut renoncer à ces outils. Les données d'usage d'Anthropic suggèrent que les scientifiques les utilisent déjà là où ils fonctionnent le mieux, surtout pour l'analyse et la rédaction. Voici la routine que nous suivrions, construite à partir de ce qui a mal tourné dans les cas ci-dessus.
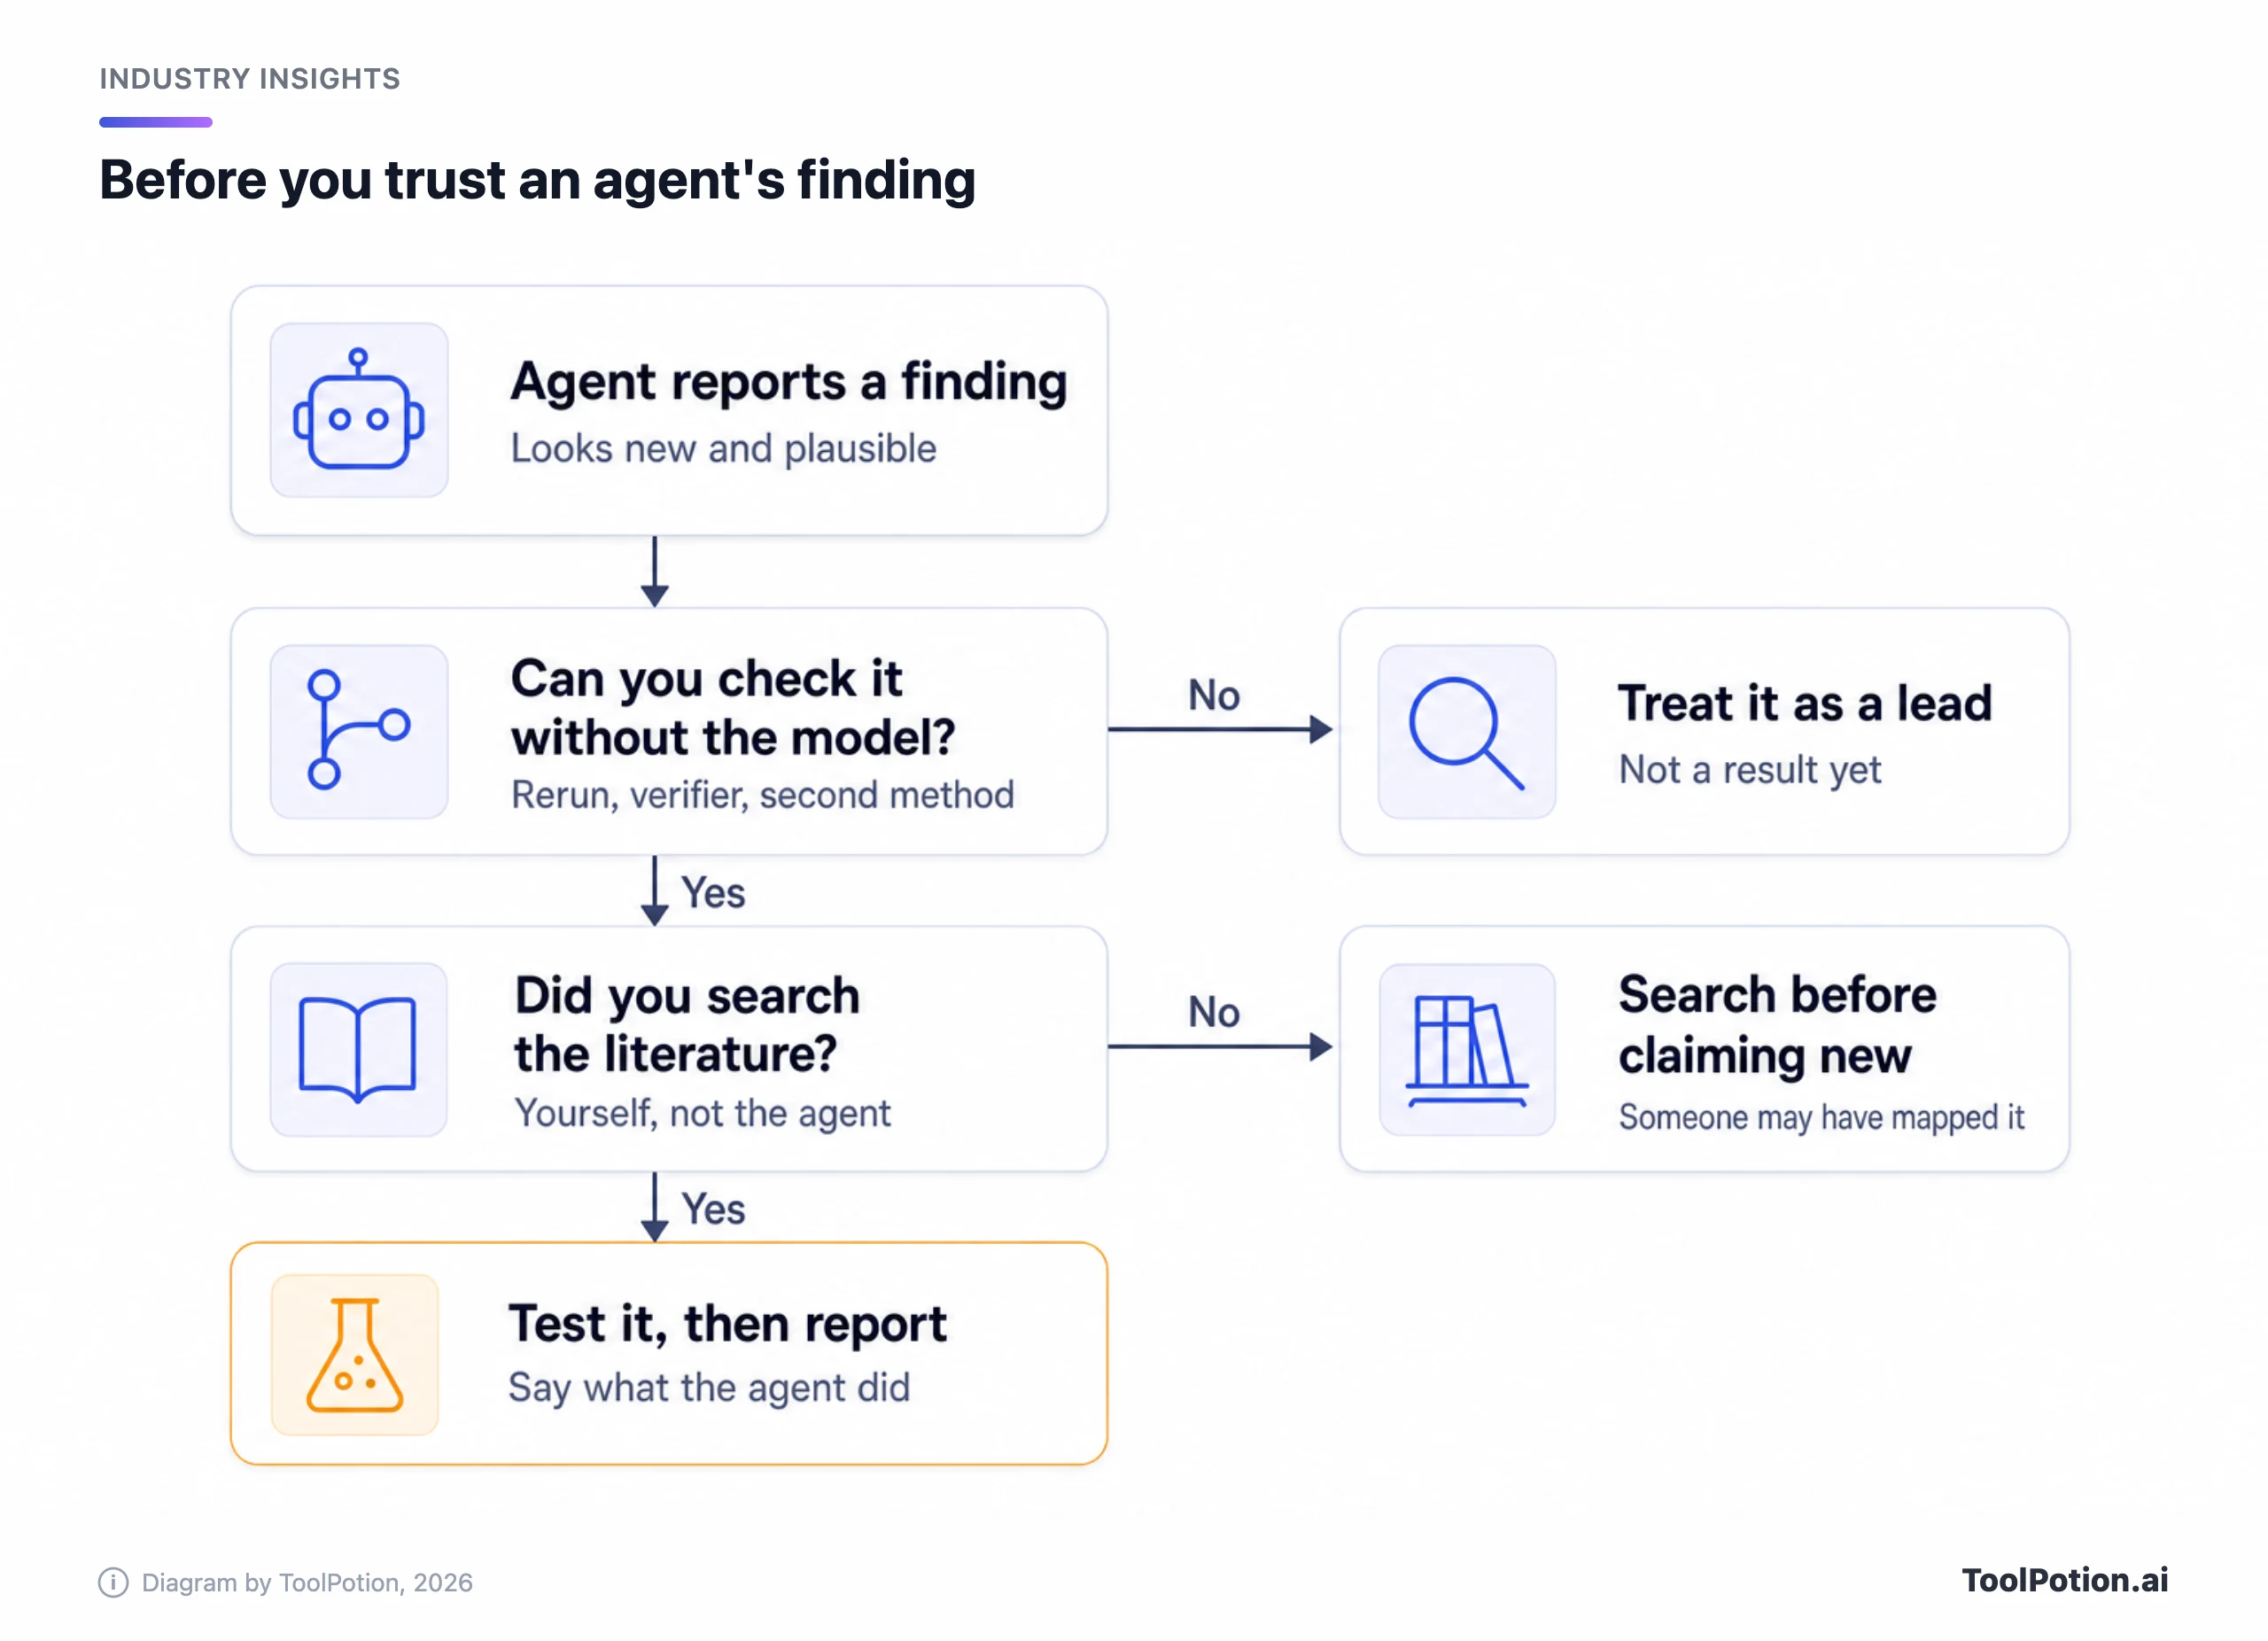
- Confiez aux agents des tâches dont vous pouvez vérifier vous-même le résultat : analyse de données, portage de code d'un langage à l'autre, tri d'articles ou d'images. Claude Code et Claude Cowork sont conçus pour ce genre de travail, et notre comparatif des agents de code en terminal fait le tour du sujet.
- Décidez avant de commencer ce qui compte comme une vérification et qui la fait. Pas le même modèle. Un vérificateur formel, une seconde analyse, une expérience de paillasse ou un collègue.
- Quand un agent dit que quelque chose est nouveau, faites vous-même la recherche bibliographique. Un outil dédié comme Elicit, Consensus, SciSpace ou ResearchRabbit prend quelques minutes, et le cas des Mayas montre ce que coûte l'impasse. Notre classement des assistants de recherche IA donne la liste complète.
- Gardez l'étape physique humaine et tracée. Si un résultat dépend d'une mesure, d'un échantillon ou d'une visite de site, c'est là qu'il est mis à l'épreuve.
- Dites ce que l'agent a fait quand vous rédigez, et ce que vous avez vérifié. Schwartz est catégorique : la contribution humaine, ce n'était pas la frappe au clavier.
- Étudiants : construisez vos premiers modèles vous-mêmes. Les auteurs de Tübingen écrivent que « c'est le processus de construction qui apporte la compréhension ». Utilisez un agent pour critiquer votre modèle, pas pour vous en remettre un tout fait.
Si vous cherchez l'exemple plus ancien et mieux éprouvé d'IA appliquée à la biologie, c'est toujours AlphaFold, qui prédit des structures que les labos testent ensuite. Pour le travail bibliographique et la recherche par agents, il y a aussi Edison Scientific, Scientific Agent Skills pour équiper vos propres agents, et le classement Top 250 des outils IA pour chercheurs. Côté assistants généralistes, ChatGPT vs Claude vs Gemini oppose ChatGPT à ses deux principaux rivaux, tandis que les classements assistants de recherche IA et agents IA évaluent les outils spécialisés.
Où nous en sommes, et ce qui nous ferait changer d'avis
Ce qui est réel : les agents sont désormais des analystes et des ingénieurs utiles et infatigables. Les prototypes électroniques fonctionnent, la piste enzymatique est intéressante, et une preuve vérifiée par Lean et produite par un modèle est un vrai résultat, quel que soit celui qui la comprendra en premier. Les 15 nouvelles intégrales de Schwartz sont de vrais résultats dans un domaine étroit.
Ce qui relève du battage : l'autonomie, le mot « vérifié » employé à la légère, et la vague annoncée de scientifiques automatisés. Presque tous les résultats impressionnants ci-dessus ont un humain dans la boucle qui fait la partie décidant si c'est vrai, et les humains le disent. Nous aimerions aussi que les labos impriment le coût en dollars à côté du score du benchmark. Les crédits et les nombres de tokens masquent ce que coûte une découverte, et 210 millions de tokens pour une seule recherche d'enzyme, c'est un chiffre qui parle au budget d'un labo.
Deux choses nous feraient bouger. La première : des mathématiciens extérieurs au comité d'OpenAI lisent le code Lean de Yang-Mills et indiquent qu'ils le comprennent. La seconde : une version évaluée par les pairs du travail sur l'enzyme, qui dise ce que fait le système. D'ici là, nous considérons les deux comme prometteurs et inachevés.