

Perplexity est le meilleur assistant de recherche IA pour la plupart des gens en 2026, et NotebookLM est celui à choisir quand la réponse doit venir de vos propres fichiers. Au-delà de ces deux-là, le bon choix dépend de ce que vous cherchez : des articles scientifiques, une question clinique, une pile de PDF ou le web ouvert. Le classement ci-dessous présente le top 25, et ce guide détaille ceux qui méritent votre temps.
La catégorie paraît encombrée, mais elle se découpe nettement. Certains outils cherchent sur le web. D'autres lisent uniquement ce que vous leur donnez. D'autres encore explorent la littérature académique, et un grand nom est conçu pour les cliniciens. Ce qui distingue un bon choix d'un choix risqué est partout pareil : vous devez voir d'où vient chaque affirmation, et pouvoir la vérifier.
Cette question traverse tout ce qui suit. Les citations sont le produit ici, et les citations peuvent être fausses.
Le top 25 du moment
- # 1Premier choixPerplexity — Moteur de Réponses IAApp d’IAPerplexity est un moteur de réponses gratuit alimenté par l'IA qui fournit des réponses précises, fiables et en temps réel à toute question, rendant la récupération d'informations efficace et simple.92ToolRankÉlite
- # 2Deuxième placeNotebookLMApp mobileNotebookLM est un assistant de recherche AI personnalisé qui aide les utilisateurs à comprendre n'importe quel sujet. Il offre une interface conviviale et des fonctionnalités puissantes pour améliorer la productivité et rationaliser les processus de recherche.74ToolRankFort
- # 3Troisième placeOpenEvidenceApp d’IAOpenEvidence est la plateforme officielle de connaissances médicales des États-Unis, conçue pour les professionnels de la santé. Elle fournit des réponses basées sur des preuves ancrées dans des recherches évaluées par des pairs provenant de revues médicales de premier plan, améliorant ainsi la prise de décision clinique au point de soins.73ToolRankFort
- 4OpenAI PrismApp d’IAOpenAI Prism est un éditeur LaTeX gratuit et un espace de travail natif AI conçu pour les scientifiques. Il intègre ChatGPT et Codex pour améliorer l'écriture scientifique et la collaboration, offrant une correction assistée par IA, des citations et un formatage.64ToolRankFort
- 5SciSpace AI pour la rechercheApp d’IASciSpace est un assistant de recherche alimenté par l'IA conçu pour les universitaires, permettant des revues systématiques de la littérature sur plus de 280 millions d'articles et aidant à la rédaction de documents avec des sources citées. Fiable pour des millions d'étudiants, de doctorants et de chercheurs dans le monde entier.62ToolRankFort
- 6Google PinpointApp d’IAGoogle Pinpoint aide les journalistes à trouver rapidement des histoires importantes au sein de grandes collections de PDF, de documents manuscrits, d'images, d'archives d'e-mails et de fichiers audio en utilisant l'IA et l'apprentissage automatique.61ToolRankFort
- 7ConsensusApp d’IAConsensus est un moteur de recherche académique basé sur l'IA qui analyse la littérature évaluée par des pairs pour accélérer la recherche. Il aide les utilisateurs à trouver, organiser et analyser des articles scientifiques 10 fois plus rapidement, transformant les revues de littérature de jours en minutes. La plateforme soutient une recherche académique rigoureuse grâce à des capacités avancées de filtrage et de résumé.61ToolRankFort
- 8Westlaw Precision AIApp d’IAWestlaw Precision AI est un outil de recherche juridique avancé qui utilise l'IA et un contenu de confiance pour fournir des informations rapides et de niveau expert. Il aide les professionnels du droit à passer en toute confiance de la recherche à la stratégie, garantissant des résultats complets et vérifiables.60ToolRankFort
- 9ElicitApp d’IAElicit est un assistant de recherche alimenté par l'IA qui aide les scientifiques et les chercheurs à trouver, résumer et extraire des données de plus de 138 millions d'articles universitaires. Il automatise les revues systématiques de la littérature, génère des rapports de recherche et fournit des citations au niveau de la phrase pour plus de précision, permettant une découverte plus rapide et une prise de décision basée sur des preuves dans diverses industries.60ToolRankFort
- 10Gemini NotebookApp d’IAGemini Notebook est un carnet de recherche IA ancré dans les sources, développé par Google, conçu pour la synthèse rapide et la prise de notes. Il sert d'assistant de recherche virtuel, fournissant des informations et des perspectives fiables.59ToolRankSolide
- 11Plateforme d'Innovation AI PatSnapApp d’IAPatSnap est une plateforme alimentée par l'IA offrant des recherches de brevets, de la rédaction, de la surveillance et des analyses de propriété intellectuelle. Elle accélère la productivité de la R&D de 75 % en utilisant plus de 2 milliards de points de données d'experts, approuvée par plus de 15 000 innovateurs dans le monde.58ToolRankSolide
- 12Semantic ScholarApp d’IASemantic Scholar est un outil de recherche gratuit, alimenté par l'IA, conçu pour aider les chercheurs à découvrir la littérature scientifique pertinente. Il exploite l'IA et l'ingénierie avancées pour comprendre la sémantique des articles de recherche, facilitant ainsi la recherche et l'engagement avec le contenu académique dans tous les domaines scientifiques. La plateforme vise à améliorer l'accessibilité et le contexte de la recherche.57ToolRankSolide
- 13Plateforme d'examen par IA RayyanApp d’IARayyan est une plateforme alimentée par l'IA conçue pour accélérer les revues systématiques et de littérature pour les chercheurs. Elle automatise les tâches clés telles que le criblage, la déduplication et l'extraction de données, permettant aux équipes de synthétiser les preuves plus rapidement et plus efficacement. Approuvée par plus d'un million de chercheurs dans le monde, Rayyan rationalise l'ensemble du flux de travail de revue.56ToolRankSolide
- 14Readwise ReaderApp d’IAReadwise Reader est une application complète de lecture ultérieure conçue pour les lecteurs assidus. Elle regroupe des articles, des PDF et plus encore en un seul endroit, offrant des fonctionnalités de recherche et de surlignage puissantes.55ToolRankSolide
- 15ResearchRabbitApp d’IAResearchRabbit rationalise les revues de littérature en aidant les chercheurs à découvrir des articles pertinents, à construire des cartes de citations et à suivre les tendances de recherche. Il transforme l'exploration de la littérature académique d'une tâche fastidieuse en un processus de découverte axé sur la curiosité, économisant ainsi un temps précieux pour les universitaires et les étudiants.55ToolRankSolide
- 16SciteApp d’IAScite est un outil d'IA qui recherche plus de 300 millions d'articles académiques pour fournir des réponses basées sur des citations. Il aide les chercheurs à comprendre la force des preuves derrière les affirmations, rendant les recherches littéraires plus efficaces et fiables.55ToolRankSolide
- 17HebbiaApp d’IAHebbia est une plateforme d'IA conçue pour les professionnels de la finance, offrant une intelligence institutionnelle pour soutenir les décisions à enjeux élevés. Elle se connecte aux sources de données financières, permettant aux utilisateurs d'analyser des documents, de découvrir des informations et d'automatiser les flux de travail. Approuvée par les principales institutions financières, Hebbia vise à améliorer la rapidité et à influencer les processus d'investissement.53ToolRankSolide
- 18LinerApp d’IALiner est un outil alimenté par l'IA conçu pour améliorer la navigation et la recherche sur le Web. Il permet aux utilisateurs de surligner, d'organiser et d'enregistrer du contenu à partir de pages Web, créant ainsi une base de connaissances personnalisée. La plateforme vise à rationaliser la découverte et la rétention d'informations pour les étudiants, les chercheurs et les professionnels cherchant à gérer efficacement les données en ligne.53ToolRankSolide
- 19Base de données ScopusApp d’IAScopus est une base de données complète d'abstracts et de citations qui donne accès à la littérature scientifique, technique, médicale et en sciences sociales. Elle offre des outils de recherche avancés et des métriques pour aider les chercheurs à identifier les tendances, trouver des collaborateurs et mesurer l'impact de la recherche.53ToolRankSolide
- 20ScholarcyApp d’IAScholarcy simplifie la recherche en résumant des articles, des documents et des manuels en cartes mémoire interactives. Il aide les utilisateurs à comprendre des recherches complexes et à organiser efficacement leurs connaissances.53ToolRankSolide
- 21Dimensions AIApp d’IADimensions AI est une base de données de recherche complète qui relie des subventions, des publications, des ensembles de données, des essais cliniques, des brevets et des documents politiques. Elle fournit des outils pour l'analyse de la recherche, permettant aux utilisateurs de naviguer rapidement et d'interpréter les données de recherche mondiales pour des insights stratégiques.52ToolRankSolide
- 22InstrumentlApp d’IAInstrumentl est une plateforme de gestion de subventions alimentée par l'IA qui aide les organisations à but non lucratif à trouver, obtenir et gérer des subventions de manière efficace. Elle offre une base de données complète, un appariement basé sur l'IA et des outils pour la rédaction de propositions et la gestion post-attribution, le tout dans un seul espace de travail.51ToolRankSolide
- 23GPT ResearcherDépôt GitHubGPT Researcher est un agent autonome conçu pour la recherche approfondie sur n'importe quel sujet, produisant des rapports détaillés, factuels et impartiaux avec des citations. Il utilise des agents de planification et d'exécution pour générer des questions de recherche et collecter des informations. L'outil offre des options de personnalisation et prend en charge divers formats de fichiers pour la recherche locale.51ToolRankSolide
- 24Connected PapersApp d’IAConnected Papers est un outil visuel conçu pour les chercheurs et les scientifiques appliqués afin de découvrir et d'explorer des articles universitaires pertinents pour leur travail. Il génère des graphiques interactifs d'articles similaires, aidant les utilisateurs à acquérir une compréhension visuelle des tendances, des travaux populaires et de la dynamique au sein d'un domaine, garantissant qu'aucune recherche importante n'est manquée.51ToolRankSolide
- 25Atlas.tiApp d’IAAtlas.ti est un logiciel de premier plan pour l'analyse des données qualitatives, offrant des outils alimentés par l'IA pour les chercheurs, les étudiants et les entreprises. Il prend en charge divers formats de données et propose des fonctionnalités intuitives pour une analyse et une collaboration efficaces.50ToolRankSolide





Comment fonctionne ToolRank
ToolRank est le moteur de classement propriétaire de ToolPotion.
Il évalue en continu des centaines de signaux issus de tout le web ouvert — trafic réel et popularité, poids de l’audience et de la communauté, autorité et longévité, adoption et engagement — et traite des millions de données pour placer chaque outil à la place qu’il a méritée.
Chaque type d’IA est mesuré par son propre modèle : ce qui prouve l’adoption d’une app SaaS ne vaut pas pour un framework open source ou une chaîne de créateur. L’absence sur une plateforme ne pénalise jamais un outil — ToolRank juge les preuves qui existent.
Aucun placement payant. Aucun chiffre autodéclaré.
Les choix rapides
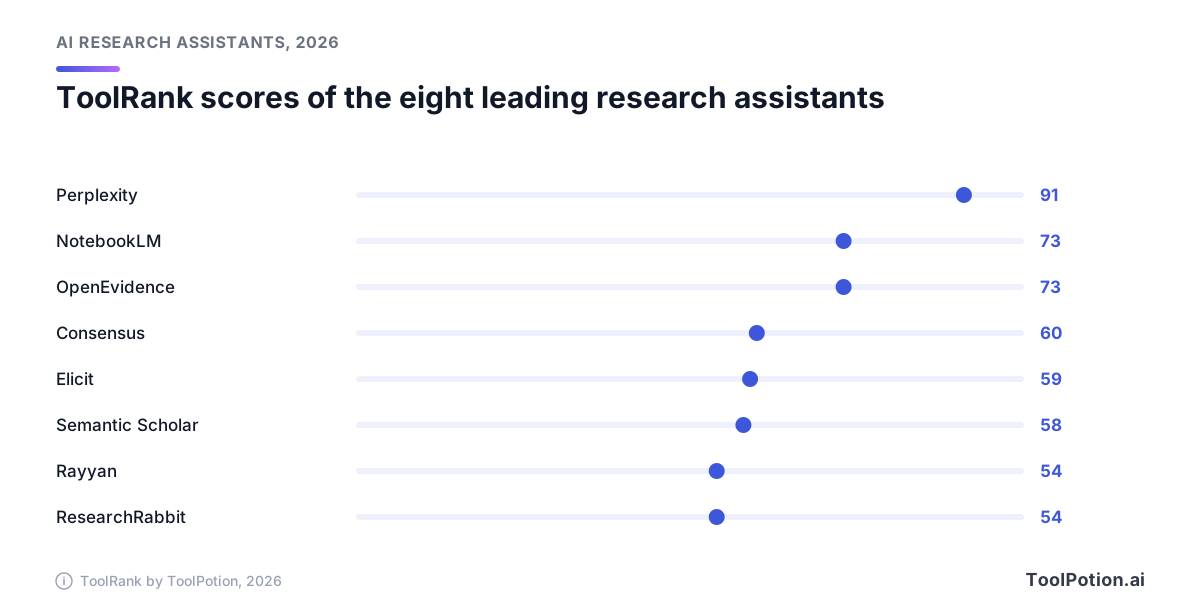
- Le meilleur choix global est Perplexity, qui occupe la première place du classement 2026 avec un ToolRank de 91 (niveau élite), soit 18 points d'avance sur le suivant.
- Le meilleur pour vos propres documents est NotebookLM, désormais rebaptisé Gemini Notebook, parce qu'il répond à partir des sources que vous importez, et rien d'autre.
- Pour la littérature académique, Consensus donne une lecture rapide de ce que disent les études et Elicit extrait les données des articles.
- Semantic Scholar est la meilleure option scientifique gratuite, et son éditeur est un institut à but non lucratif.
- Les cliniciens devraient regarder OpenEvidence, conçu pour les questions médicales.
- Quiconque mène une revue systématique devrait commencer par Rayyan, qui s'occupe de la corvée du tri.
Ce sont les leaders du classement Top 100 des assistants de recherche IA. Le graphique montre à quel point le milieu du peloton est serré, et combien Perplexity le domine.
Ce qui a changé en 2026
Google a rebaptisé NotebookLM en Gemini Notebook en 2026. L'entreprise affirme qu'il s'agit toujours du même produit autonome, désormais doté d'un ordinateur cloud sécurisé qui exécute du code sur vos sources, et annonce plus de 30 millions d'utilisateurs (Google). Notre classement utilise encore le nom NotebookLM. C'est aussi lui qui a fait le plus grand bond parmi les leaders, passant de la 10e à la 2e place du classement 2026.
OpenEvidence reste gratuit pour les professionnels de santé, financé par la publicité de laboratoires pharmaceutiques et d'autres annonceurs. Son PDG a dit qu'il aimerait changer ce modèle (NBC News). Personne n'a dit qui paiera à la place.
Le changement moins réjouissant concerne les articles scientifiques. Plus tôt cette année, arXiv a commencé à infliger des interdictions de soumission d'un an aux auteurs dont les articles montrent une sortie d'IA non vérifiée, références hallucinées comprises (SMU Libraries). Si vous le citez, vous en répondez. C'est la nouvelle norme.
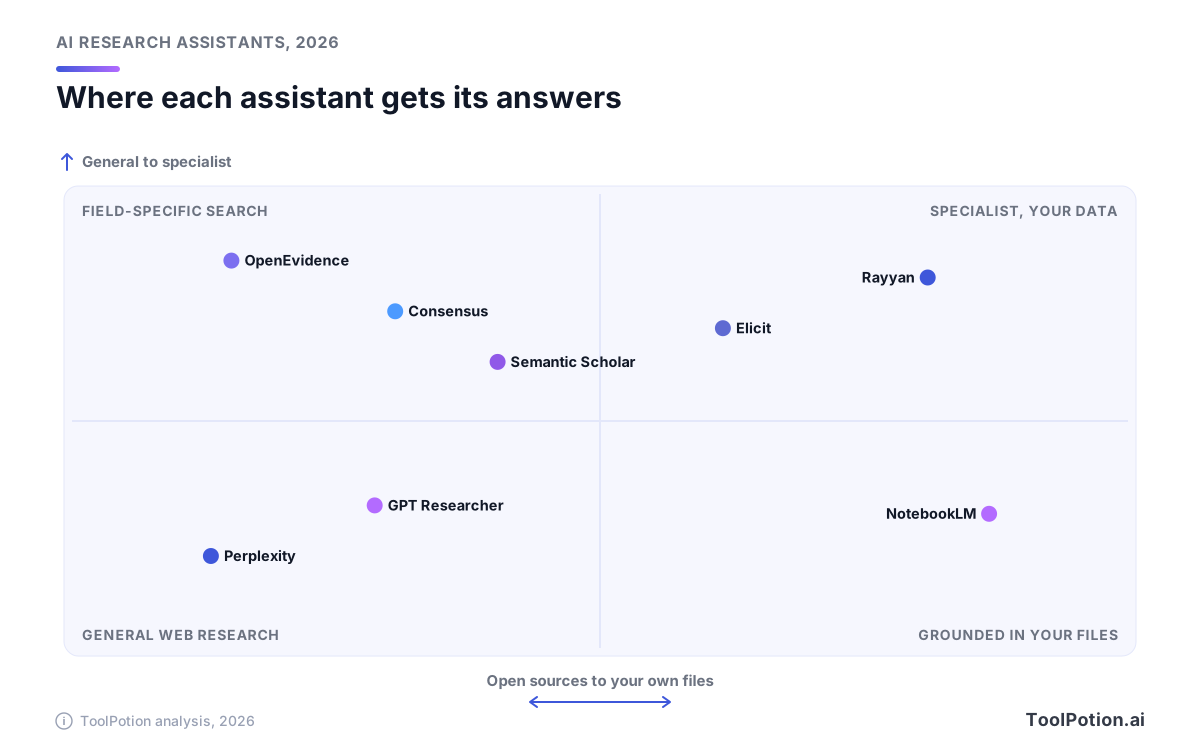
La carte ci-dessous classe le domaine selon l'origine des réponses de chaque outil et son degré de spécialisation.
Le problème de confiance est un problème de citations
Une réponse ancrée dans des sources se construit en cinq étapes, et une erreur peut se glisser à chacune d'elles.
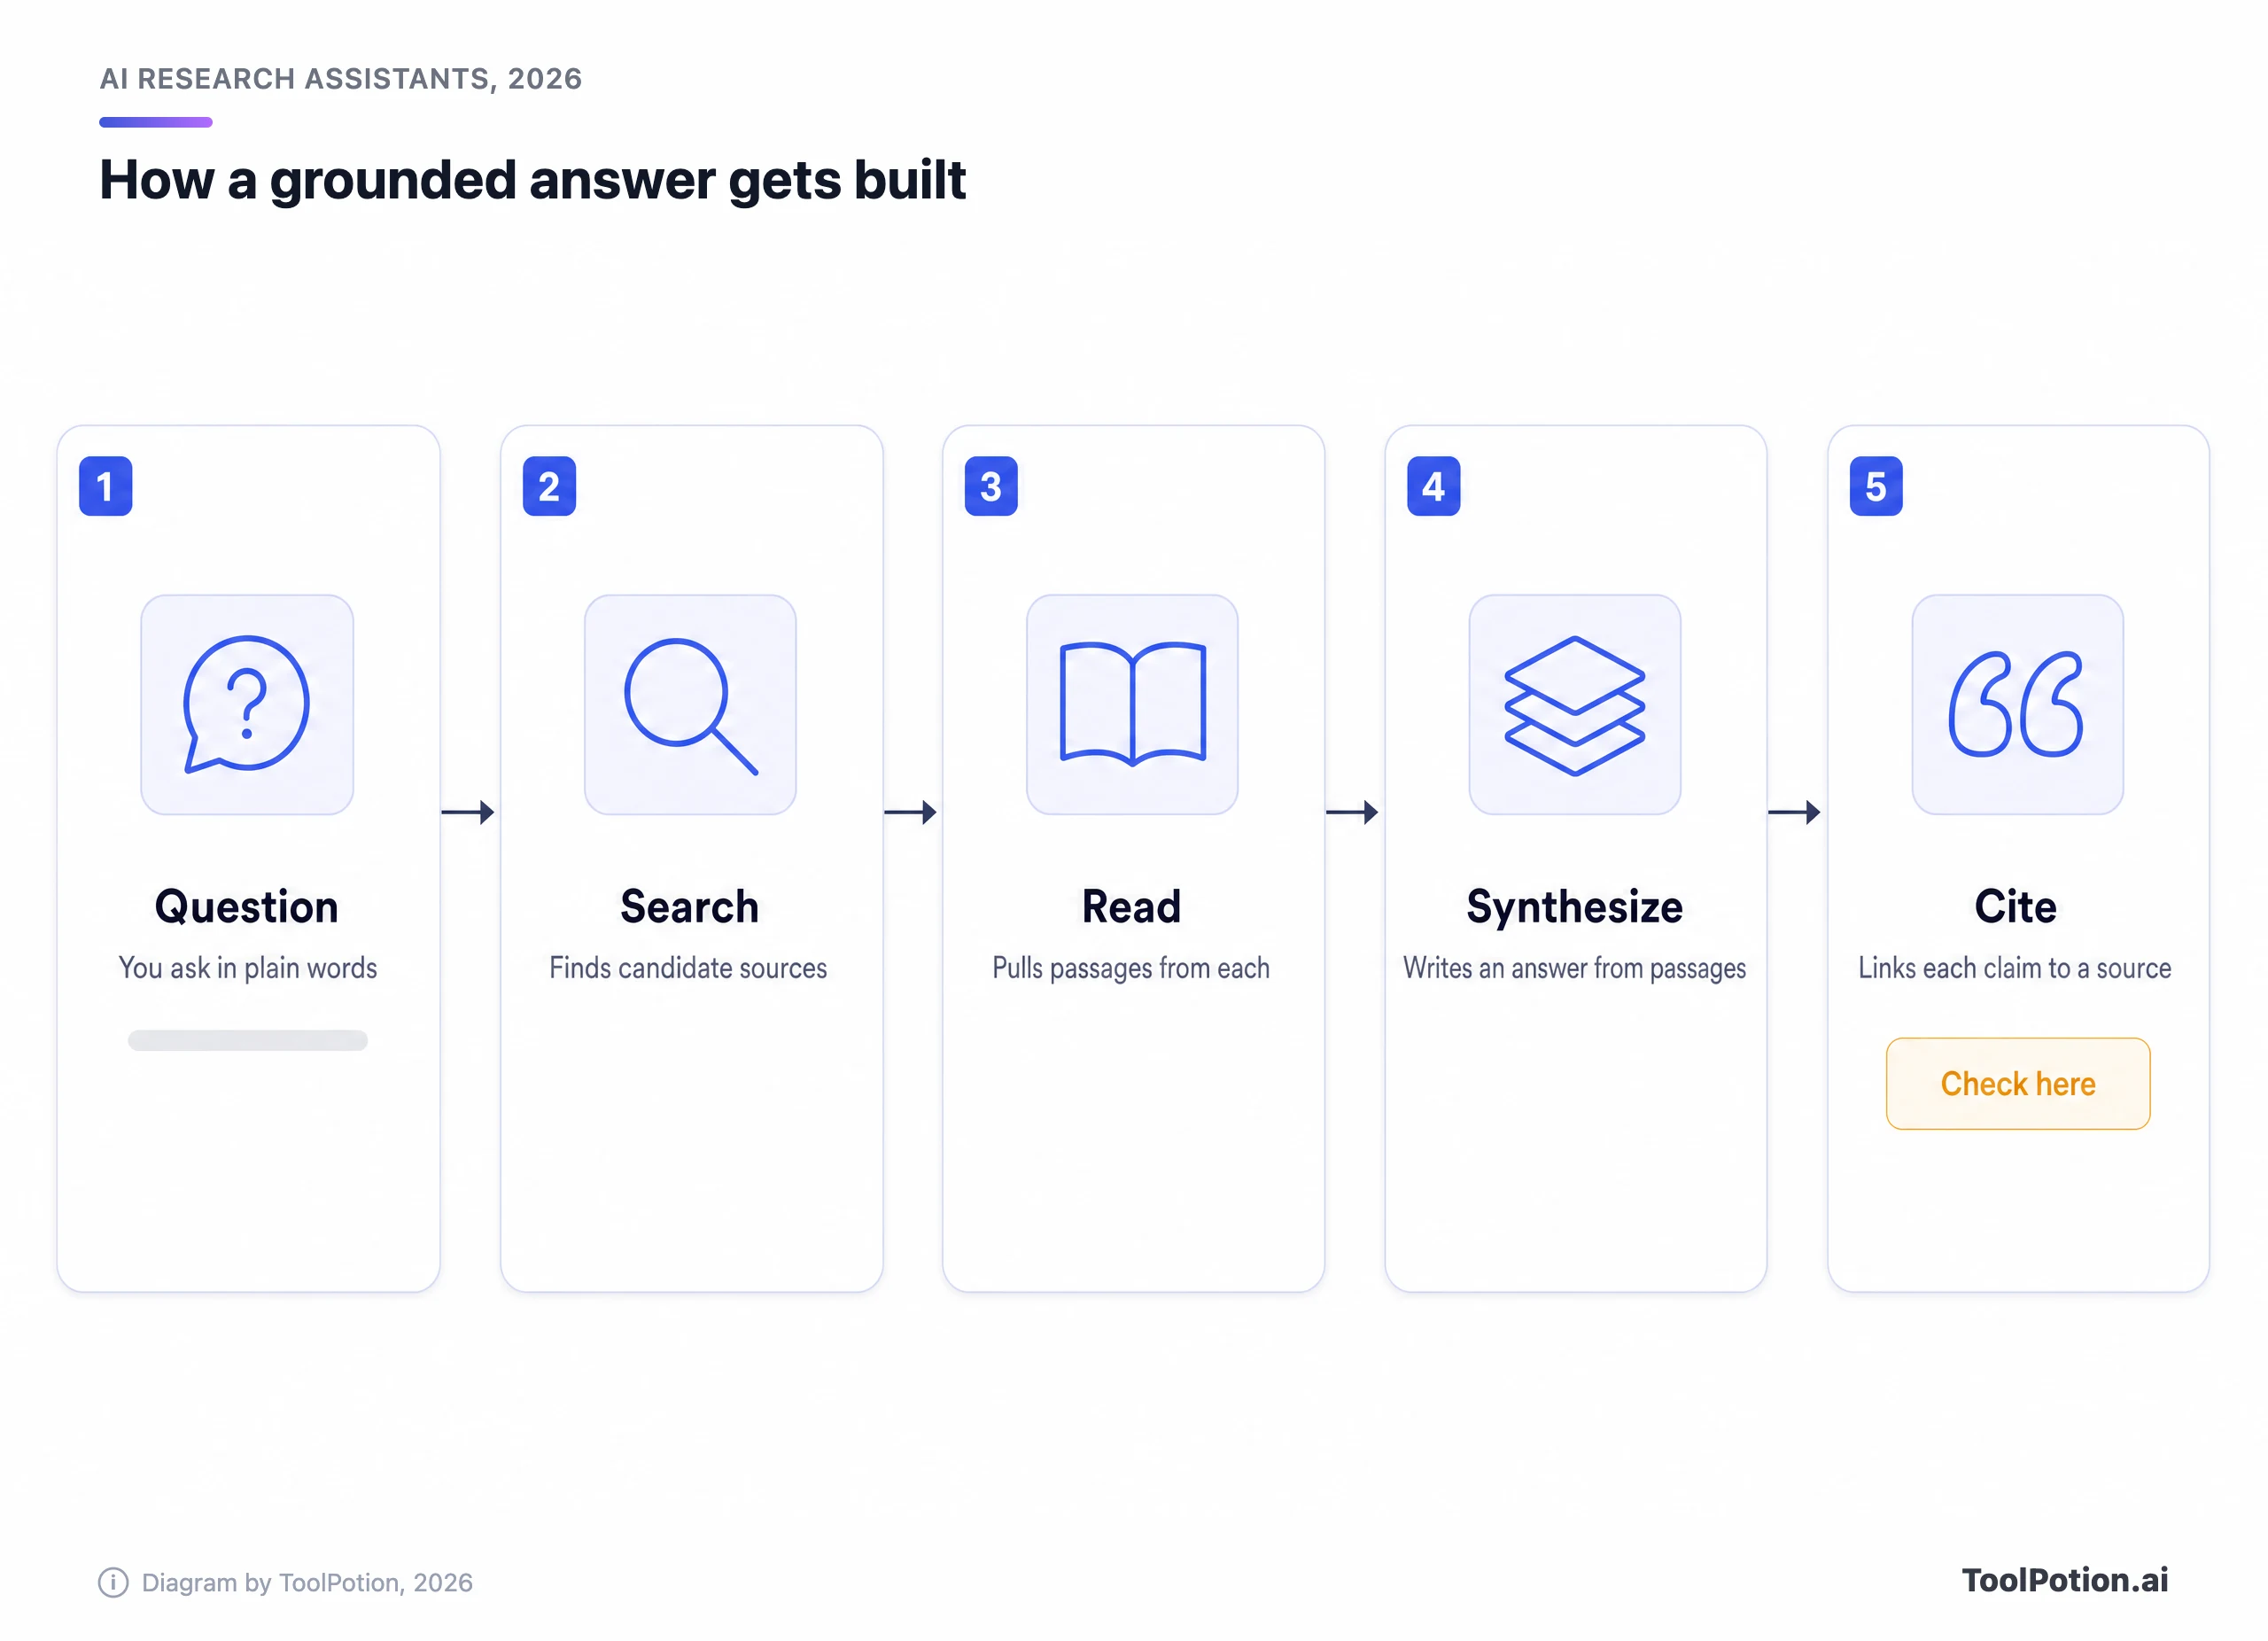
La recherche peut passer à côté de l'article clé. La lecture peut s'arrêter au résumé. La rédaction peut s'éloigner de ce que disent les passages. Et la dernière étape peut associer un vrai lien à une affirmation qu'il ne soutient pas. Un test mené par des bibliothécaires à la HKUST a montré que Scite récupérait le texte intégral là où les autres outils remontaient surtout des résumés (HKUST Library).
L'audit le plus connu vient du Tow Center de Columbia. Il a fourni à huit moteurs de recherche IA des extraits d'articles de presse en leur demandant d'identifier le titre, l'éditeur, la date et l'URL. Ensemble, ils se sont trompés sur plus de 60 % des requêtes. Perplexity s'en est le mieux sorti avec un taux d'erreur de 37 %, mais les offres payantes de Perplexity et de Grok se sont montrées plus sûres d'elles à tort que les gratuites, et plusieurs outils ont cité des liens inventés ou cassés (Columbia Journalism Review). Ce test mesurait la façon dont les moteurs attribuent des extraits de presse, pas la façon dont ils citent des articles scientifiques. Voyez-y un avertissement sur l'excès de confiance, pas un verdict sur tel ou tel outil.
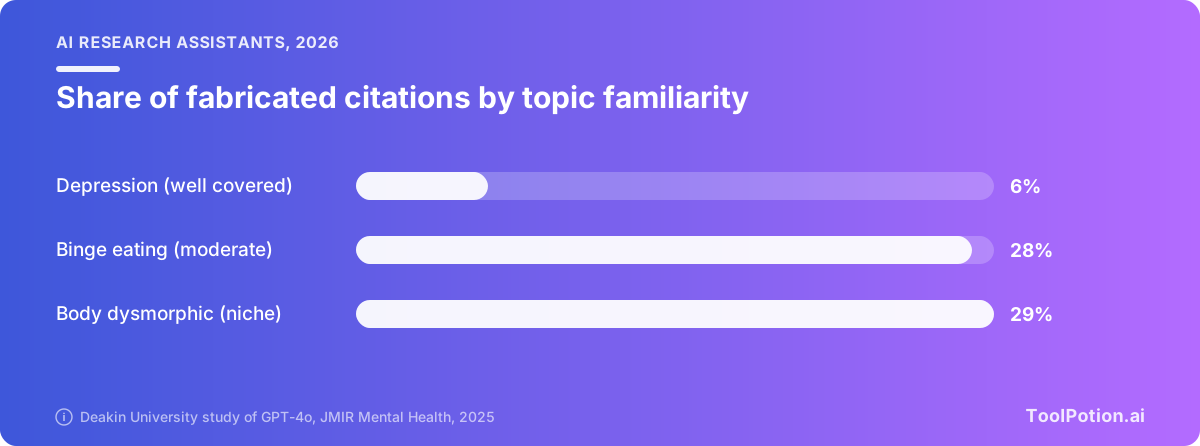
Pour les articles scientifiques, les preuves les plus nettes concernent les chatbots classiques, et c'est justement pourquoi l'ancrage dans des sources compte. Des chercheurs de l'Université Deakin ont demandé à GPT-4o de rédiger six revues de littérature sur des sujets de santé mentale. Parmi les citations produites, 19,9 % étaient inventées, et 45,4 % des citations réelles comportaient des erreurs, comme des DOI incorrects (EurekAlert). Le plus utile, c'est le schéma : 6 % de fabrication sur la dépression, un sujet très étudié, contre 28 à 29 % sur deux sujets moins couverts.
Les assistants de recherche dédiés font mieux, sans être parfaits. Dans le test de la HKUST, Scite, Elicit, Consensus et Scopus AI ont tous renvoyé de vraies citations sur une question concernant le sommeil et la prise de poids. Associer chaque argument à sa source était une autre affaire, et Scopus AI a été le plus faible, avec des arguments que ses sources ne soutenaient pas. Les bibliothécaires ont qualifié le résultat de point de départ, pas de substitut à une revue de littérature. C'était une seule question sur un sujet bien étudié : attendez-vous à des résultats plus approximatifs sur des sujets de niche.
La règle de travail est donc simple. Ouvrez la source avant d'utiliser l'affirmation. Relancez tout ce qui est important. Et testez un nouvel outil sur un sujet que vous maîtrisez parfaitement.
Les leaders, testés
Perplexity : le meilleur pour des réponses citées et rapides sur le web ouvert
Perplexity est numéro 1 du classement 2026 avec un ToolRank de 91 (niveau élite), le seul score élite du classement. Il cherche sur le web et affiche ses sources à côté de la réponse, ce qui rend un premier passage rapide et un second passage facile. Le bémol est celui qu'a relevé le Tow Center : c'était le moins mauvais des huit moteurs, et il se trompait quand même 37 % du temps lorsqu'il fallait attribuer des extraits de presse, une tâche différente de la citation d'articles scientifiques. Pro ajoute un sélecteur de modèle et des recherches approfondies, et coûte 20 $ par mois, tandis que Max coûte 200 $, d'après le guide des prix 2026 de CloudZero ; il existe aussi une offre gratuite.
NotebookLM : le meilleur quand la réponse doit venir de vos fichiers
NotebookLM est 2e avec un score de 73, niveau fort. Vous importez des articles, des notes ou des transcriptions, et il ne répond qu'à partir de ceux-ci, ce qui réduit la marge pour les faits inventés. Revers de la médaille : il ne peut pas vous dire ce que vous avez oublié d'ajouter. L'offre gratuite autorise 100 carnets, 50 sources par carnet et 50 conversations par jour, et les forfaits Google AI payants relèvent ces limites (Google Help). Pour un dossier de thèse ou une pile de rapports, c'est le meilleur choix du classement.
OpenEvidence : le meilleur pour les cliniciens qui vérifient la littérature
OpenEvidence se place 3e, avec aussi un score de 73 et le niveau fort, et c'est le seul spécialiste médical près du sommet. Il répond aux questions cliniques à partir de revues à comité de lecture et il est gratuit pour les professionnels de santé. Les preuves sur sa précision restent minces. Un preprint qui a testé 100 scénarios de sous-spécialités issus du jeu de données d'examens MedXpertQA a mesuré une précision d'au plus 34 % pour sa recherche rapide et de 41 % pour Deep Consult, et ses auteurs jugent que la supervision d'un expert reste indispensable (medRxiv). C'est un preprint, et les questions étaient difficiles. Reste que ces outils ne remplacent pas un clinicien, et personne ne devrait en utiliser un à la place d'un médecin.
Consensus : le meilleur pour une lecture rapide de ce que disent les études
Consensus est 4e avec un score de 60, niveau fort, en hausse par rapport à la 6e place dans le classement 2026. Il cherche dans les articles académiques, si bien qu'une question fermée revient sous forme de synthèse d'études plutôt que de pile de pages web. Dans le test de la HKUST, il a produit de longues synthèses structurées avec une dizaine de citations chacune. Consultez sa page de tarifs en ligne pour connaître les offres actuelles avant de vous engager.
Elicit : le meilleur pour extraire des données de nombreux articles
Elicit est 5e, contre 8e auparavant, avec un score de 59, niveau solide. Son atout, c'est l'extraction : vous construisez un tableau d'articles et demandez les mêmes informations pour chacun, comme la taille de l'échantillon ou le résultat. L'offre gratuite Basic explore 138 millions d'articles. Pro coûte 49 $ par mois (588 $ par an) et ajoute un workflow de revue systématique capable de trier 5 000 articles, tandis que Scale coûte 169 $ (Elicit pricing). Le saut du gratuit à 49 $ est raide, et les fonctions sérieuses se trouvent derrière.
Semantic Scholar : la meilleure recherche scientifique gratuite
Semantic Scholar est 6e avec un score de 58, en baisse par rapport à la 4e place du classement 2026. C'est d'abord un moteur de recherche et ensuite un assistant, conçu par l'institut à but non lucratif Allen Institute for AI. Il indexe plus de 200 millions d'articles et ne coûte rien (Semantic Scholar). Pas de fenêtre de chat qui réfléchit à votre place. Pour beaucoup d'étudiants, c'est un avantage.
Rayyan : le meilleur pour le tri des revues systématiques
Rayyan est 8e avec un score de 54. Les équipes l'utilisent pour trier des milliers de titres et de résumés selon des critères d'inclusion, l'IA suggérant ceux qui sont probablement pertinents. L'offre gratuite couvre 3 revues actives et 2 relecteurs gratuits, et Essential démarre à 4,99 $ par mois en facturation annuelle (Rayyan). C'est un outil de workflow : n'attendez pas une zone de question qui rédige la réponse pour vous.
ResearchRabbit : le meilleur pour cartographier un domaine à partir de quelques articles de départ
ResearchRabbit est passé de la 16e à la 9e place, avec un score de 54. Vous partez d'articles auxquels vous faites confiance, et il construit des collections et des cartes de citations des travaux connexes. Il trouve des articles. Il ne les résume pas. Associé à un outil de lecture, il mérite sa place en début de projet, quand vous ne savez pas encore à quoi ressemble le domaine.
Scite : le meilleur pour voir si des articles ultérieurs confirment une affirmation
Scite se place 10e avec un score de 54. Ses Smart Citations montrent si les travaux ultérieurs appuient ou contredisent un article, un contexte que le simple nombre de citations masque. Dans la comparaison de la HKUST, sa synthèse était la plus complète des quatre, et c'était le seul à récupérer le texte intégral. La recherche et l'assistant sont réservés à un forfait payant, à partir de 20 $ par mois facturés annuellement (Scite pricing). Essayez-le quand une affirmation compte assez pour que vous vouliez savoir qui l'a contestée.
GPT Researcher : la meilleure option open source pour la recherche web approfondie
GPT Researcher est 17e avec un score de 50, le seul projet open source du top 25. Un agent planificateur rédige les questions de recherche, d'autres agents rassemblent la matière, et un éditeur assemble un rapport cité. Le projet est sous licence Apache-2.0 et compte environ 29 900 étoiles sur GitHub (GitHub). Vous l'hébergez vous-même et fournissez le modèle : il convient donc davantage aux développeurs et aux bricoleurs qu'à un étudiant pressé par une échéance.
Trois autres outils sont classés mais pas encore notés. Scopus Database (7e) est une base de données de citations, Readwise Reader (11e) est une application de lecture différée et Atlas.ti (15e) sert à l'analyse qualitative. Ils sont utiles, mais ce n'est pas le même type d'outil que les autres, d'où leur absence des graphiques ci-dessus.
Comment choisir
Partez du type de recherche que vous faites, car c'est ce qui tranche l'essentiel. Le prix vient en second, et le soin apporté à l'interface en dernier.
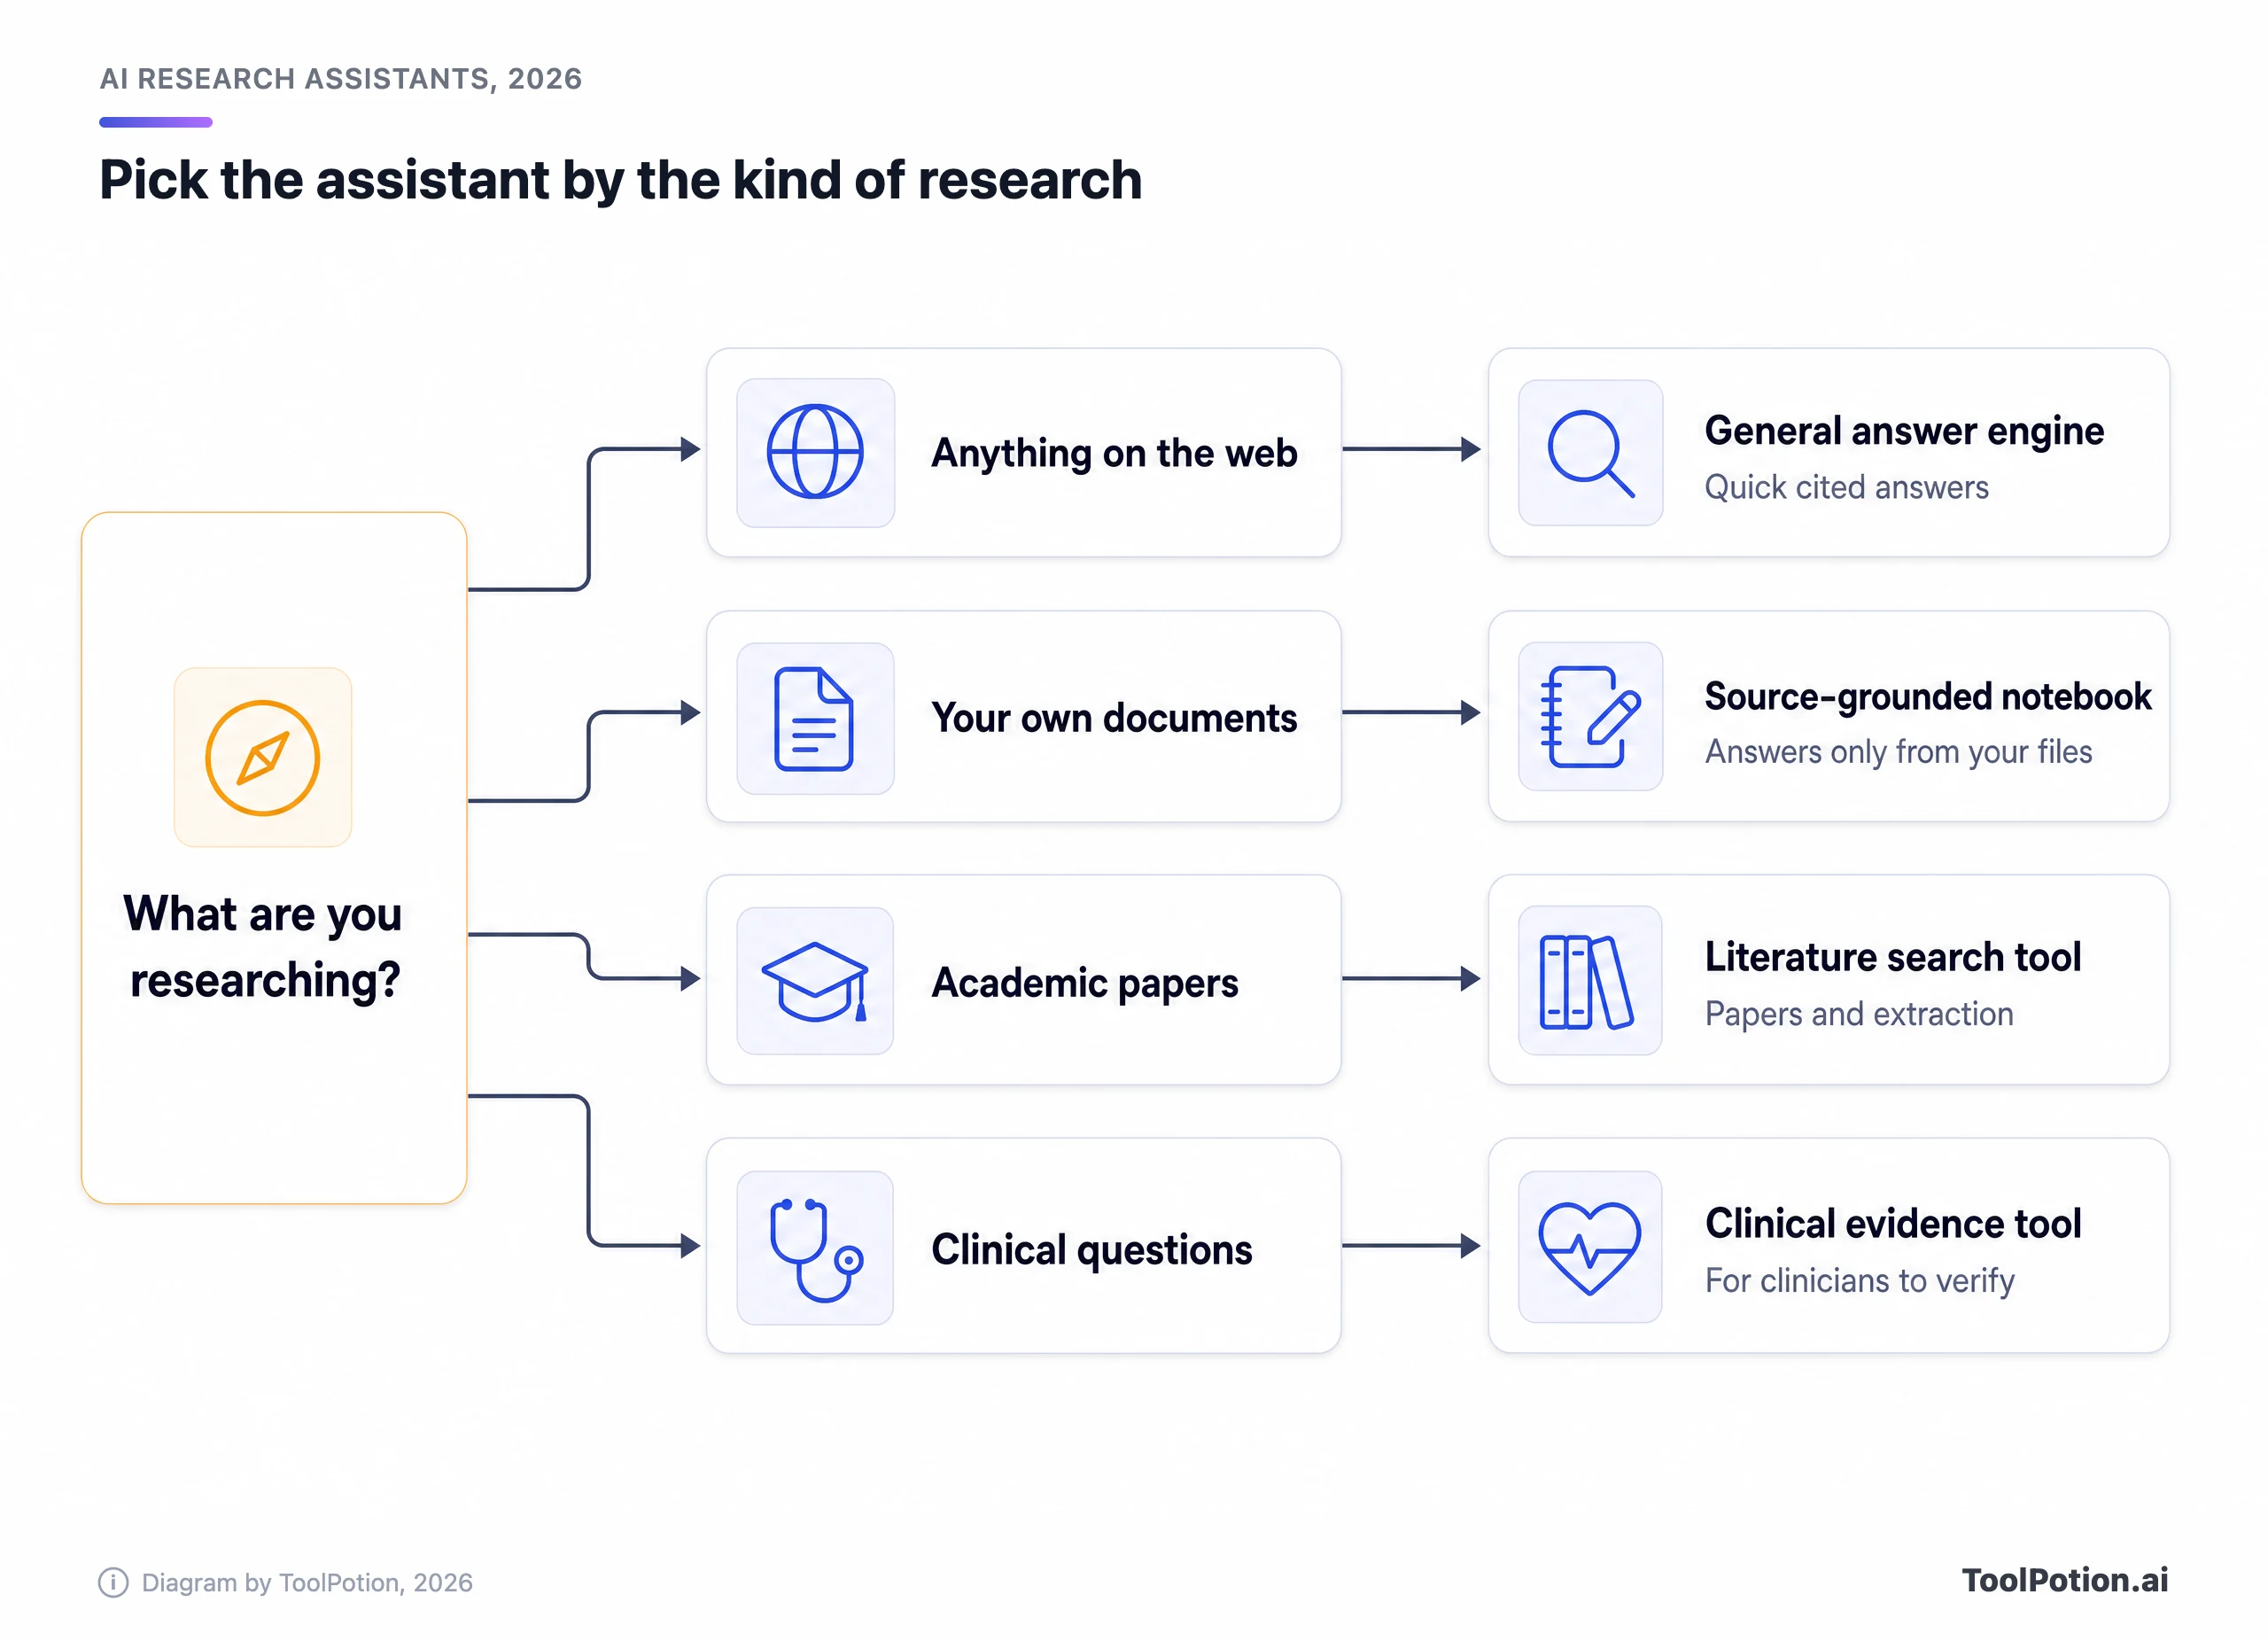
La rédaction d'une revue de littérature est le cas difficile le plus courant. Utilisez Consensus ou Semantic Scholar pour trouver ce qui existe, ResearchRabbit pour suivre la piste des citations, Elicit pour extraire les données, et Rayyan si la revue doit être formelle. Si vous travaillez à partir d'un ensemble fixe de rapports ou d'entretiens, NotebookLM les bat tous. Si vous avez besoin d'une réponse rapide sur un sujet que vous pouvez vérifier, Perplexity fait très bien l'affaire.
Deux situations demandent une vigilance supplémentaire. Tout ce qui est médical doit passer par un professionnel, et OpenEvidence s'adresse aux cliniciens, pas aux patients. Quant aux sujets de niche, là où les chiffres de Deakin ont grimpé, ils imposent d'ouvrir chaque référence.
Les prix comptent moins que les offres gratuites, alors essayez-les d'abord. Le tableau classe neuf des leaders selon ce qu'ils explorent et ce qu'ils facturent. Quand nous n'avons pas pu confirmer un chiffre, c'est indiqué.
À propos de ToolRank
ToolRank est le classement indépendant des outils d'IA de ToolPotion, et une place ne s'achète pas. Chaque classement affiche un score et un niveau pour chaque entrée notée. Vous pouvez les parcourir tous sur la page des classements ToolRank.
Les erreurs qui font perdre du temps aux chercheurs
La plus courante consiste à utiliser un chatbot généraliste pour produire des références. Les chiffres de Deakin expliquent pourquoi cela échoue, et l'interdiction d'arXiv dit ce que cela peut coûter. Un assistant de recherche qui montre ce qu'il a récupéré est un point de départ plus sûr, et un assistant qui ne lit que vos documents l'est encore plus.
La deuxième est de payer le forfait le plus cher dès le premier jour. Le niveau Max de Perplexity coûte 200 $ par mois et le niveau Scale d'Elicit 169 $, et les deux sont conçus pour un usage intensif. La plupart des étudiants et des analystes n'approchent jamais ces limites. Commencez par une offre gratuite, cognez le mur, puis payez pour le mur que vous avez réellement rencontré.
La troisième est de prendre un résumé pour une revue de littérature. Un outil peut vous dire ce que disent dix résumés. Il ne peut pas vous dire quelles études sont faibles, lesquelles sont dépassées, ni ce qui manque à l'ensemble. Cette partie reste votre travail, et c'est là qu'un lecteur humain gagne ses galons.
La dernière est de poser une question médicale à un outil non médical et de se fier au vernis de la réponse. Ne le faites pas.
Les noms montants et récents à surveiller
Connected Papers est passé de la 15e à la 13e place avec une carte visuelle des liens entre articles. Quelques outils plus jeunes talonnent le top 25. Ai2 Asta (27e) vient du même institut que Semantic Scholar et associe compréhension de la littérature et découverte guidée par les données. Keenious (34e) suggère des articles en fonction de ce que vous écrivez et s'intègre à Word. PapersFlow (32e) propose des revues de littérature dans un espace de travail IA, et AnswerThis (40e) répond avec des citations directes. STORM (33e) est un prototype de recherche de Stanford qui rédige des articles de style Wikipédia avec sources.
Le répertoire complet des assistants de recherche IA contient le reste. Si votre travail est plus ciblé, les classements connexes sont un meilleur point de départ, comme les outils d'IA pour chercher dans la littérature académique, les outils d'IA pour les chercheurs, la rédaction académique et les citations et les outils pour discuter avec des documents PDF. Ou remontez au classement en direct des assistants de recherche pour voir où se situe chaque outil.
Questions fréquentes
Quel est le meilleur assistant de recherche IA gratuit ?
Semantic Scholar est entièrement gratuit. Perplexity, NotebookLM et Elicit ont aussi des offres gratuites, et celle de NotebookLM autorise 50 sources par carnet. Commencez par là avant de payer quoi que ce soit.
Les assistants de recherche IA peuvent-ils inventer des citations ?
Oui. Les chatbots classiques le font le plus, comme l'a montré l'étude de Deakin, et les outils ancrés dans des sources le font moins. Même une vraie citation peut être rattachée à une affirmation que l'article ne fait pas : ouvrez donc la source à chaque fois.
NotebookLM, c'est la même chose que Gemini Notebook ?
Oui. Google l'a rebaptisé en 2026 et affirme qu'il reste un produit autonome.
OpenEvidence est-il gratuit ?
Il est gratuit pour les professionnels de santé et financé par la publicité. Il est conçu pour eux et ne remplace pas le jugement d'un clinicien.
Quel outil est le meilleur pour une revue de littérature ?
Aucun ne couvre tout seul. Combinez un outil de recherche comme Consensus ou Semantic Scholar avec ResearchRabbit pour la cartographie et Elicit pour l'extraction, et ajoutez Rayyan pour une revue systématique formelle.
Comment vérifier une référence générée par une IA ?
Cliquez jusqu'à l'article et confirmez qu'il existe. Vérifiez ensuite qu'il dit bien ce que prétend la réponse, et comparez le DOI avec le site de l'éditeur. Dix minutes de ce travail valent mieux qu'une affirmation rétractée.