

Chez Anthropic, des ingénieurs ont un jour laissé un agent principal distribuer de courtes consignes du genre « fais des recherches sur la pénurie de semi-conducteurs ». Les sous-agents l'ont mal comprise : l'un a exploré la crise des puces automobiles de 2021, tandis que deux autres faisaient le même travail sur les chaînes d'approvisionnement de 2025 (Anthropic Engineering). Rien n'a planté. Chaque agent a fait quelque chose de sensé avec une demande assez floue pour être lue de plusieurs façons.
La plupart d'entre nous répètent cette erreur dès qu'on confie un travail à ChatGPT, Claude, Gemini CLI ou à l'un des agents de code en terminal. On tape une tâche et on appelle ça un brief. Ci-dessous : les six parties d'un brief, trois réécritures à emprunter, un modèle, et un tableau des façons dont les briefs échouent. Nos positions, défendues au fil de l'article : écrivez d'abord la ligne « terminé quand », remplacez « demandez-moi en cas de doute » par une liste nommée d'actions, et supprimez les murs de majuscules. Les documentations des éditeurs que nous citons confirment une partie de tout cela et ne couvrent pas le reste ; nous précisons à chaque fois lequel des deux cas s'applique.
Une tâche n'est pas un brief
Une tâche nomme une activité. Un brief donne à celui qui l'exécute tout ce qu'il devrait sinon deviner. Le guide de prompting d'Anthropic le formule ainsi, en parlant d'un nouvel employé : « Pensez à Claude comme à un employé brillant mais nouveau, qui ne connaît ni vos normes ni vos méthodes de travail. » (Anthropic docs) OpenAI trace une ligne comparable entre les types de modèles. Un modèle de raisonnement est « comme un collègue senior » à qui l'on peut donner un objectif et qui trouve les détails, alors qu'un modèle GPT est « comme un collègue junior » qui donne ses meilleurs résultats « avec des instructions explicites pour produire un résultat précis » (OpenAI docs).
OpenAI affirme que les modèles de raisonnement s'en sortent bien avec des consignes de haut niveau ; nous ne ferions pas confiance à cette idée dès qu'une tâche dure des dizaines d'étapes avec des effets de bord. Le collègue senior ne peut toujours pas savoir ce que « terminé » signifie pour vous, et la mauvaise intuition d'un junior coûte un e-mail. Un agent, lui, agit sur sa première mauvaise lecture à chacune des étapes suivantes, comme l'a montré l'agent principal d'Anthropic.
Anthropic propose un test que nous aimons parce qu'il prend deux minutes : « Montrez votre prompt à un collègue qui connaît peu la tâche et demandez-lui de le suivre. S'il est perdu, Claude le sera aussi. » (Anthropic docs) Si un prestataire ne pouvait pas démarrer à partir de votre message sans envoyer cinq questions, l'agent répondra lui-même à ces cinq questions, en silence, et vous ne le saurez que par le résultat.
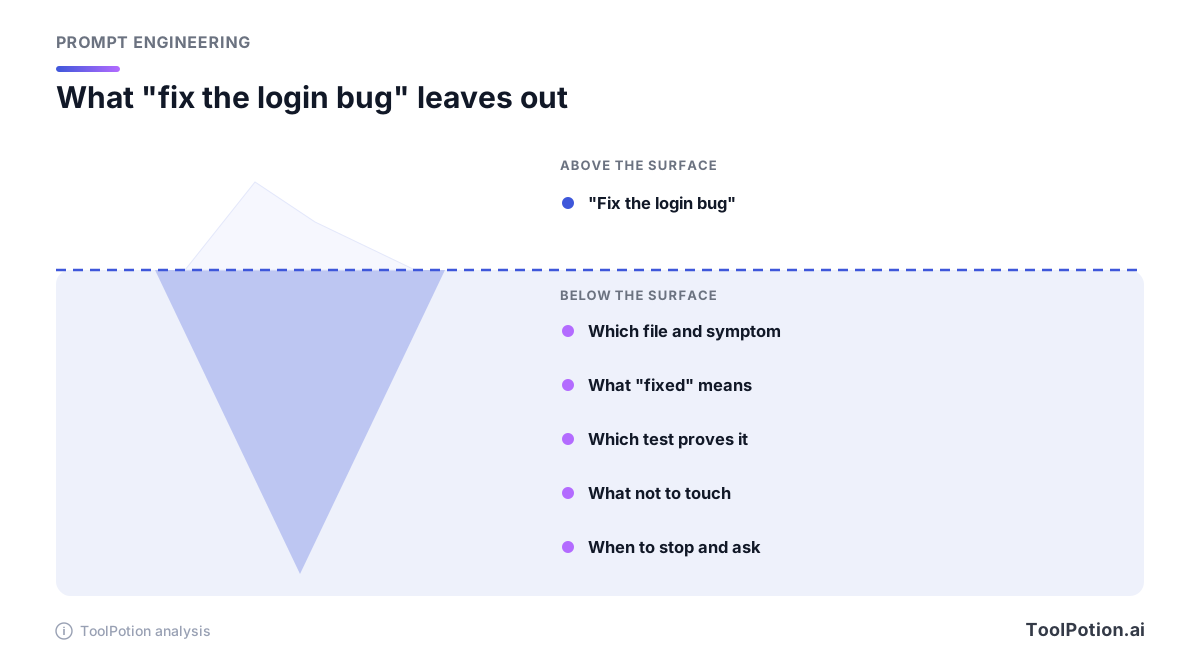
Écrivez d'abord la ligne « terminé quand »
La page de bonnes pratiques de Claude Code le dit sans détour : « Claude s'arrête quand le travail a l'air terminé. » Sans quelque chose à exécuter qui dise si le travail est fini, poursuit la page, « en pratique, c'est vous qui devenez la suite de tests, et chaque erreur reste là jusqu'à ce que vous finissiez par la remarquer. » (Claude Code docs)
Les consignes Codex d'OpenAI arrivent à la même idée par l'autre bout. Elles suggèrent quatre éléments dans un prompt : un objectif, du contexte, des contraintes et « Done when » (terminé quand), formulé comme une question sur ce qui doit être vrai avant que la tâche soit achevée, « par exemple des tests qui passent, un comportement qui change ou un bug qui ne se reproduit plus » (OpenAI Codex docs). Deux éditeurs, deux produits, un seul squelette. Nous y ajoutons deux parties de notre cru (stop-and-ask et rapport), et nous écririons la ligne « terminé quand » en premier même si elle arrive quatrième dans le brief fini, parce que l'écrire vous oblige à découvrir ce que vous voulez.
En dehors du code, la même ligne fonctionne avec un autre contrôle. « Un tableau de douze fournisseurs, un lien source à côté de chaque prix, et un signalement sur tout prix non public » est quelque chose qu'un agent peut compter. « Une comparaison approfondie » est quelque chose qu'il ne peut que ressentir.
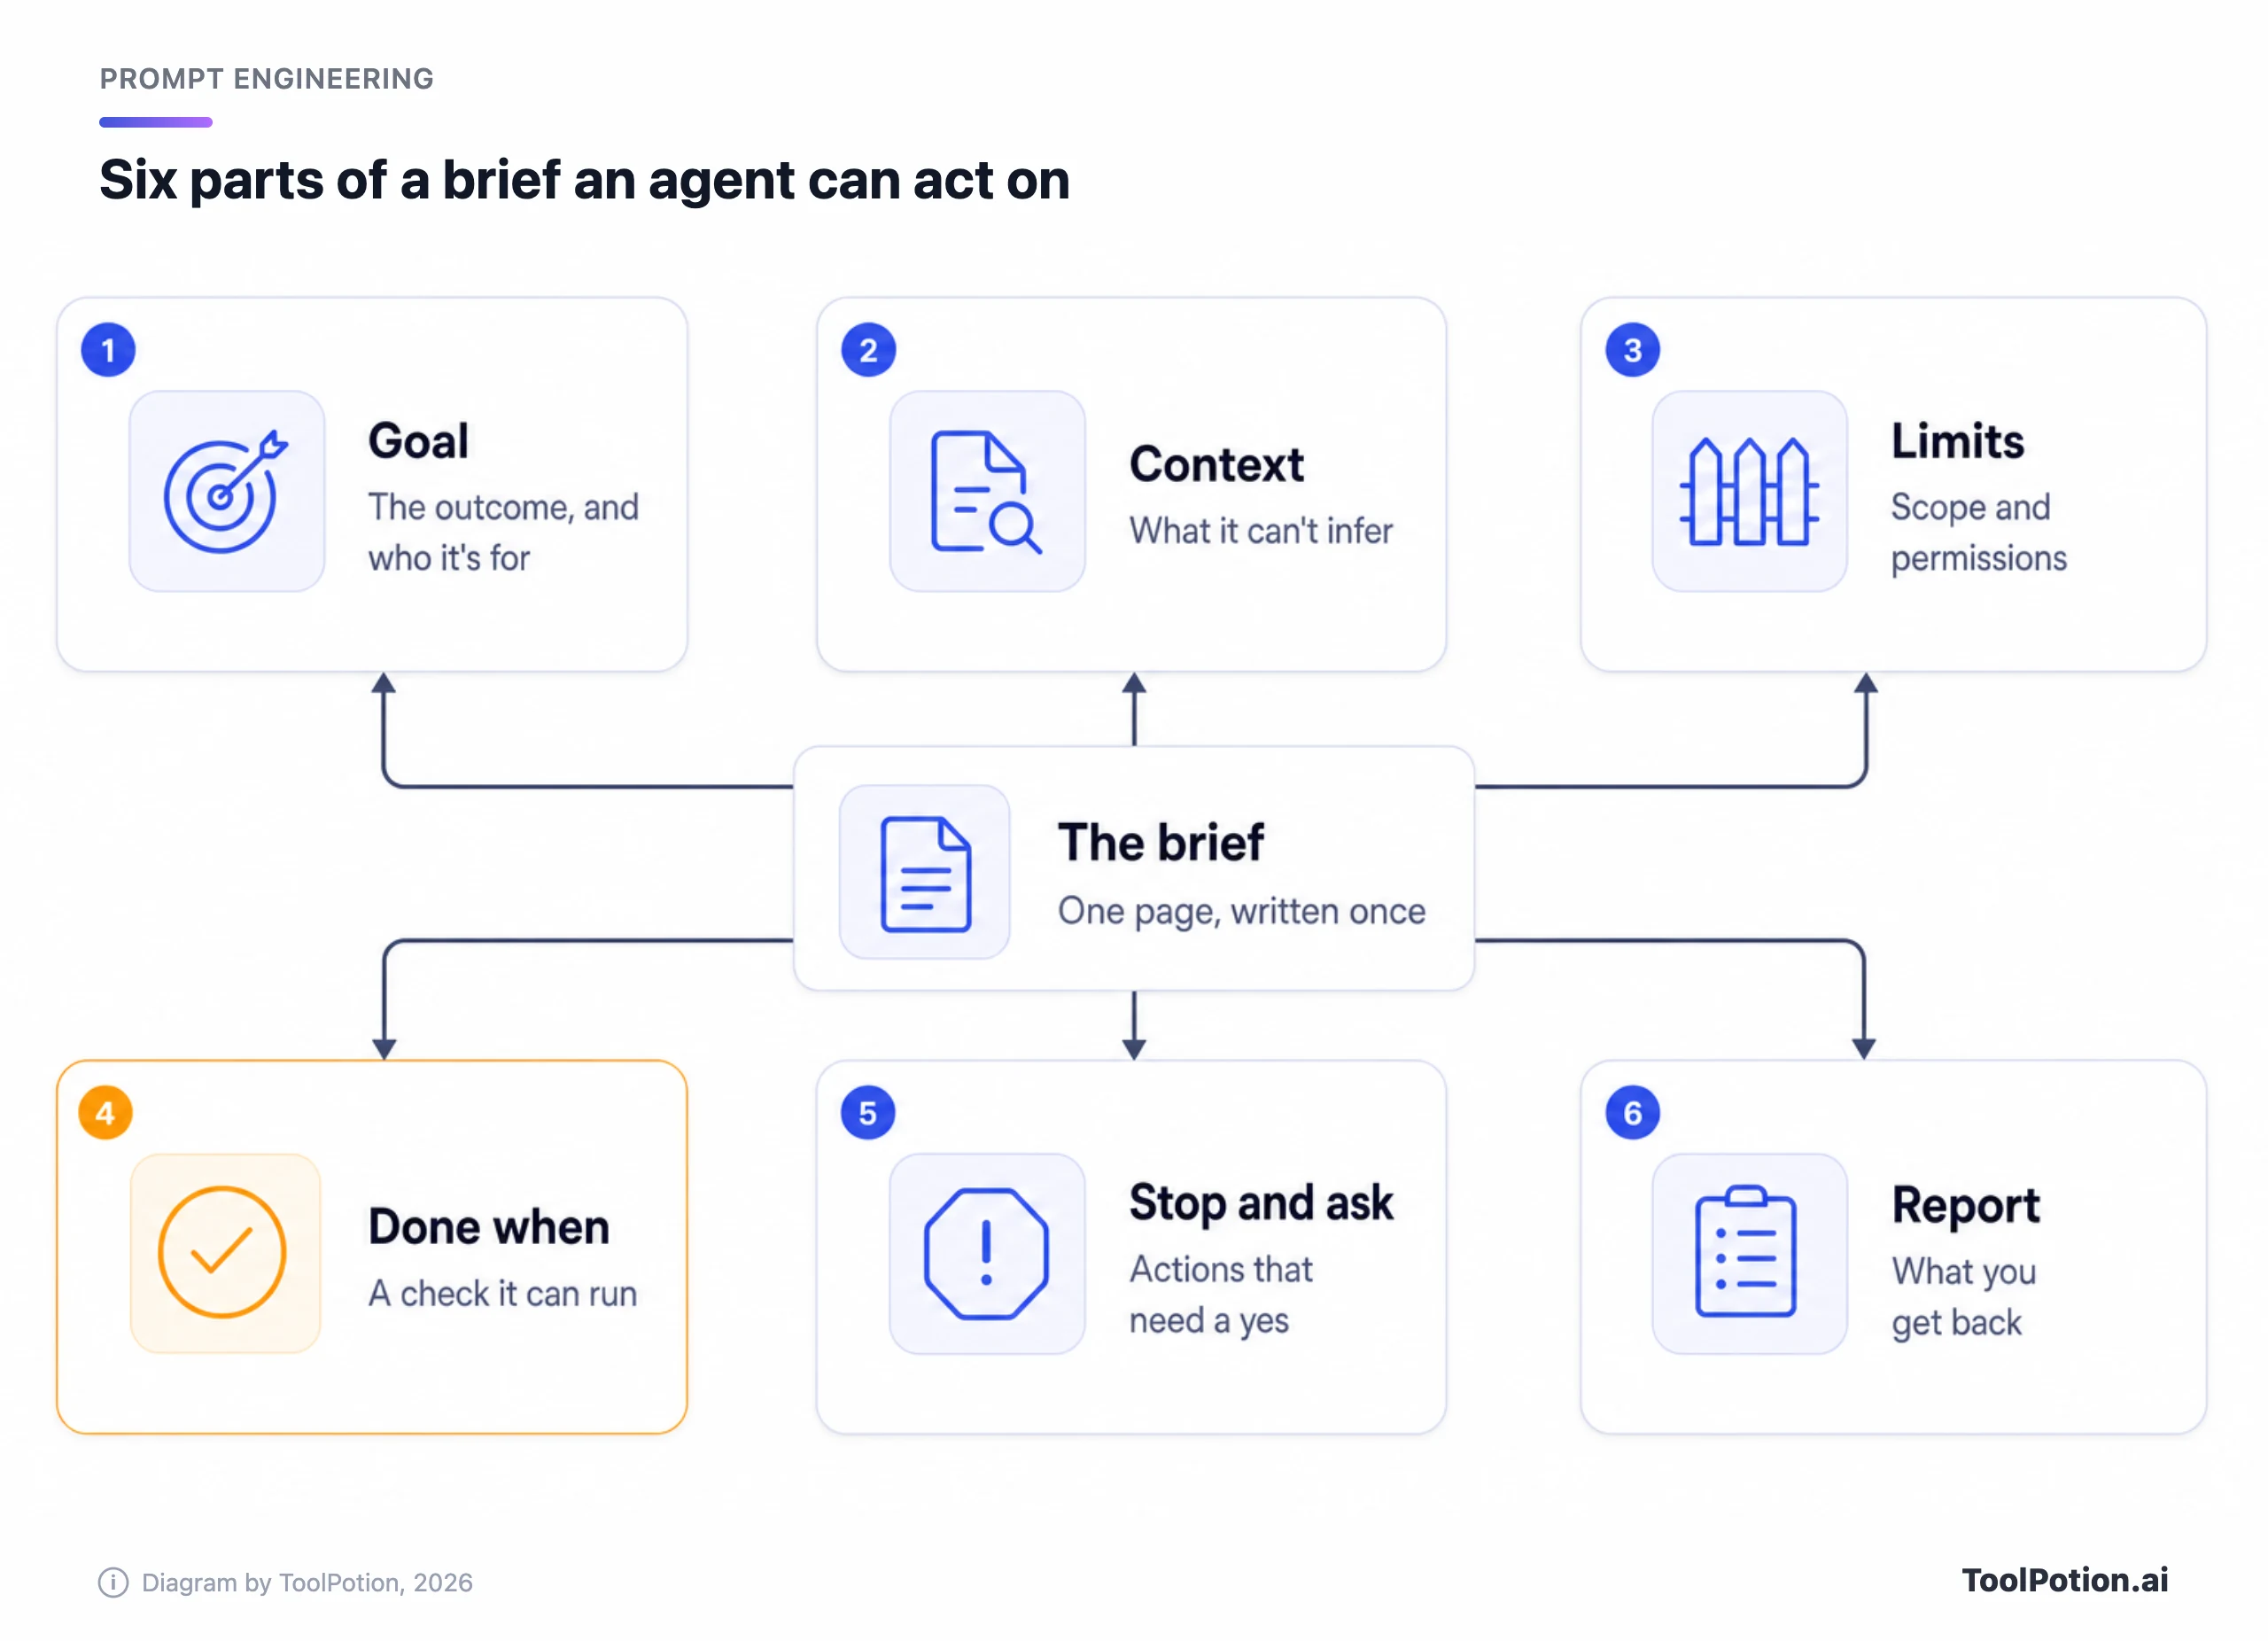
Les six parties d'un brief, de haut en bas
L'objectif nomme le résultat et son utilisateur
Une ou deux phrases. Dites ce que vous voulez à l'arrivée et ce que cela alimente : une recommandation que deux associés liront en cinq minutes, un correctif qui part en production vendredi, une présélection pour un achat. La destination change ce que l'agent inclut et ce qu'il coupe. « Regarde les tarifs » produit du volume. « Recommande un seul outil à moins de 15 $ par utilisateur » produit une décision.
Le contexte, c'est ce qu'il ne peut pas trouver seul
La documentation de Claude Code donne un filtre utile : « Pourrait-il le trouver en lisant le code ? Irait-il vraiment regarder ? Si les deux réponses sont oui, laissez-le de côté. » (Claude Code docs) Ce qui reste, c'est la décision de réunion qui n'est jamais arrivée dans le dépôt, le compte que l'agent doit utiliser, l'outil que vous avez déjà essayé et abandonné, le niveau du lecteur.
Donnez aussi la raison derrière une règle. Le guide d'Anthropic explique que le contexte ou la motivation derrière une instruction « peut donner à Claude plus d'informations sur vos objectifs et l'aider à fournir des réponses plus ciblées », et son propre exemple de version plus faible est un simple « NEVER use ellipses » (Anthropic docs).
Les limites disent ce qui est dans le périmètre et ce qui est interdit
Les agents ont tendance à en faire plus que ce que vous avez demandé. Le guide d'Anthropic indique que Claude Opus 4.5 et 4.6 ont une propension à « créer des fichiers superflus, ajouter des abstractions inutiles ou prévoir une flexibilité que personne n'a demandée », et propose une instruction type qui inclut « Don't add features, refactor code, or make "improvements" beyond what was asked. » (Anthropic docs) Le guide rattache cette habitude à ces deux modèles : vérifiez-la donc avec celui que vous utilisez. Nous emprunterions cette phrase dans tous les cas. Ajoutez ensuite votre propre liste : les dossiers qu'il peut toucher, les sources qu'il peut utiliser, les comptes sur lesquels il ne doit pas se connecter.
Le guide Gemini de Google range l'évaluation du risque parmi les réglages qu'un prompt d'agent contrôle, et indique qu'il peut distinguer explicitement les actions exploratoires à faible risque (lectures) des changements d'état à haut risque (écritures) (Google AI docs). Cette séparation est la partie utile. Lire et lancer des tests ne demande aucune autorisation ; supprimer, envoyer et payer, si.
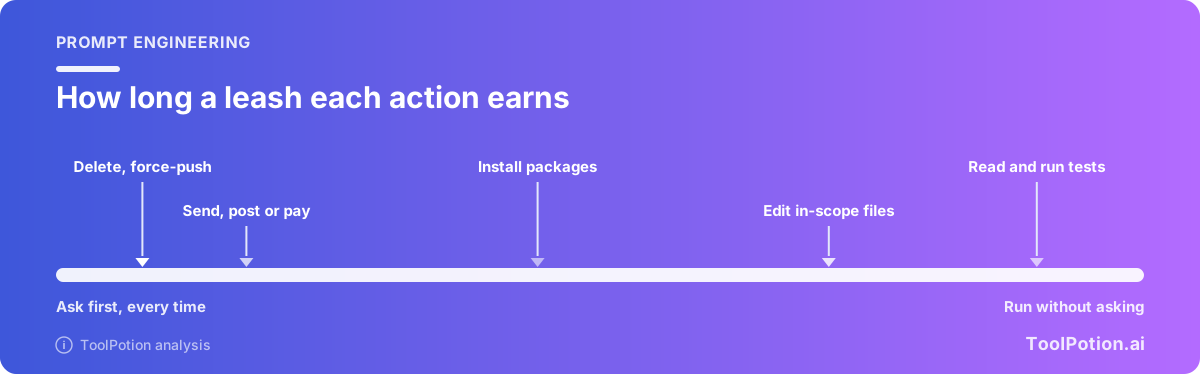
Une mise en garde avant de vous appuyer sur tout cela. Les mots d'un brief sont des demandes. Un sandbox, un jeton en lecture seule ou une règle de permission relèvent de l'application stricte, et les deux ne se remplacent pas. Notre guide pour contenir les agents IA couvre le versant application ; cet article s'en tient à ce que vous écrivez.
« Terminé quand » est un contrôle qu'il peut exécuter
Nommez la commande, le nombre ou le fichier. « Les tests passent » est un début. « pnpm test passe et un nouveau test prouve que la 101e requête en une minute reçoit un 429 » est un contrôle. Pour une recherche, dites combien d'éléments, quels champs, et quoi écrire quand un champ reste introuvable. Si le contrôle peut échouer, dites à l'agent quoi faire ensuite, et plafonnez. Le guide de Google note que « une forte persistance augmente les taux de réussite mais risque d'entraîner des coûts en tokens plus élevés ou des boucles », donc « réessaie deux fois un test qui échoue, puis arrête-toi et fais un rapport » vaut mieux que le silence (Google AI docs).
Stop-and-ask, c'est une liste d'actions, pas une humeur
« Demande-moi si tu as un doute » laisse à l'agent un jugement à porter, et un agent zélé a rarement des doutes. Listez plutôt les actions. Le guide d'Anthropic propose un exemple de prompt pour exactement ce cas, écrit pour Claude Opus 4.6 : pour les actions « difficiles à annuler, qui touchent des systèmes partagés ou pourraient être destructrices, demander à l'utilisateur avant de continuer », avec parmi les exemples la suppression de fichiers ou de branches, git push --force et l'envoi de messages (Anthropic docs). La liste est la partie que nous copierions, quel que soit le modèle.
L'essai d'Anthropic sur la conception d'agents décrit ce schéma : les agents « peuvent alors faire une pause pour recueillir un retour humain à des points de contrôle ou face à des blocages » (Anthropic Engineering). Faites du premier point de contrôle un plan. Demandez les étapes avant toute modification, lisez-les, puis dites « go ». Cela coûte un aller-retour, et c'est selon nous le point de contrôle le moins cher qui existe.
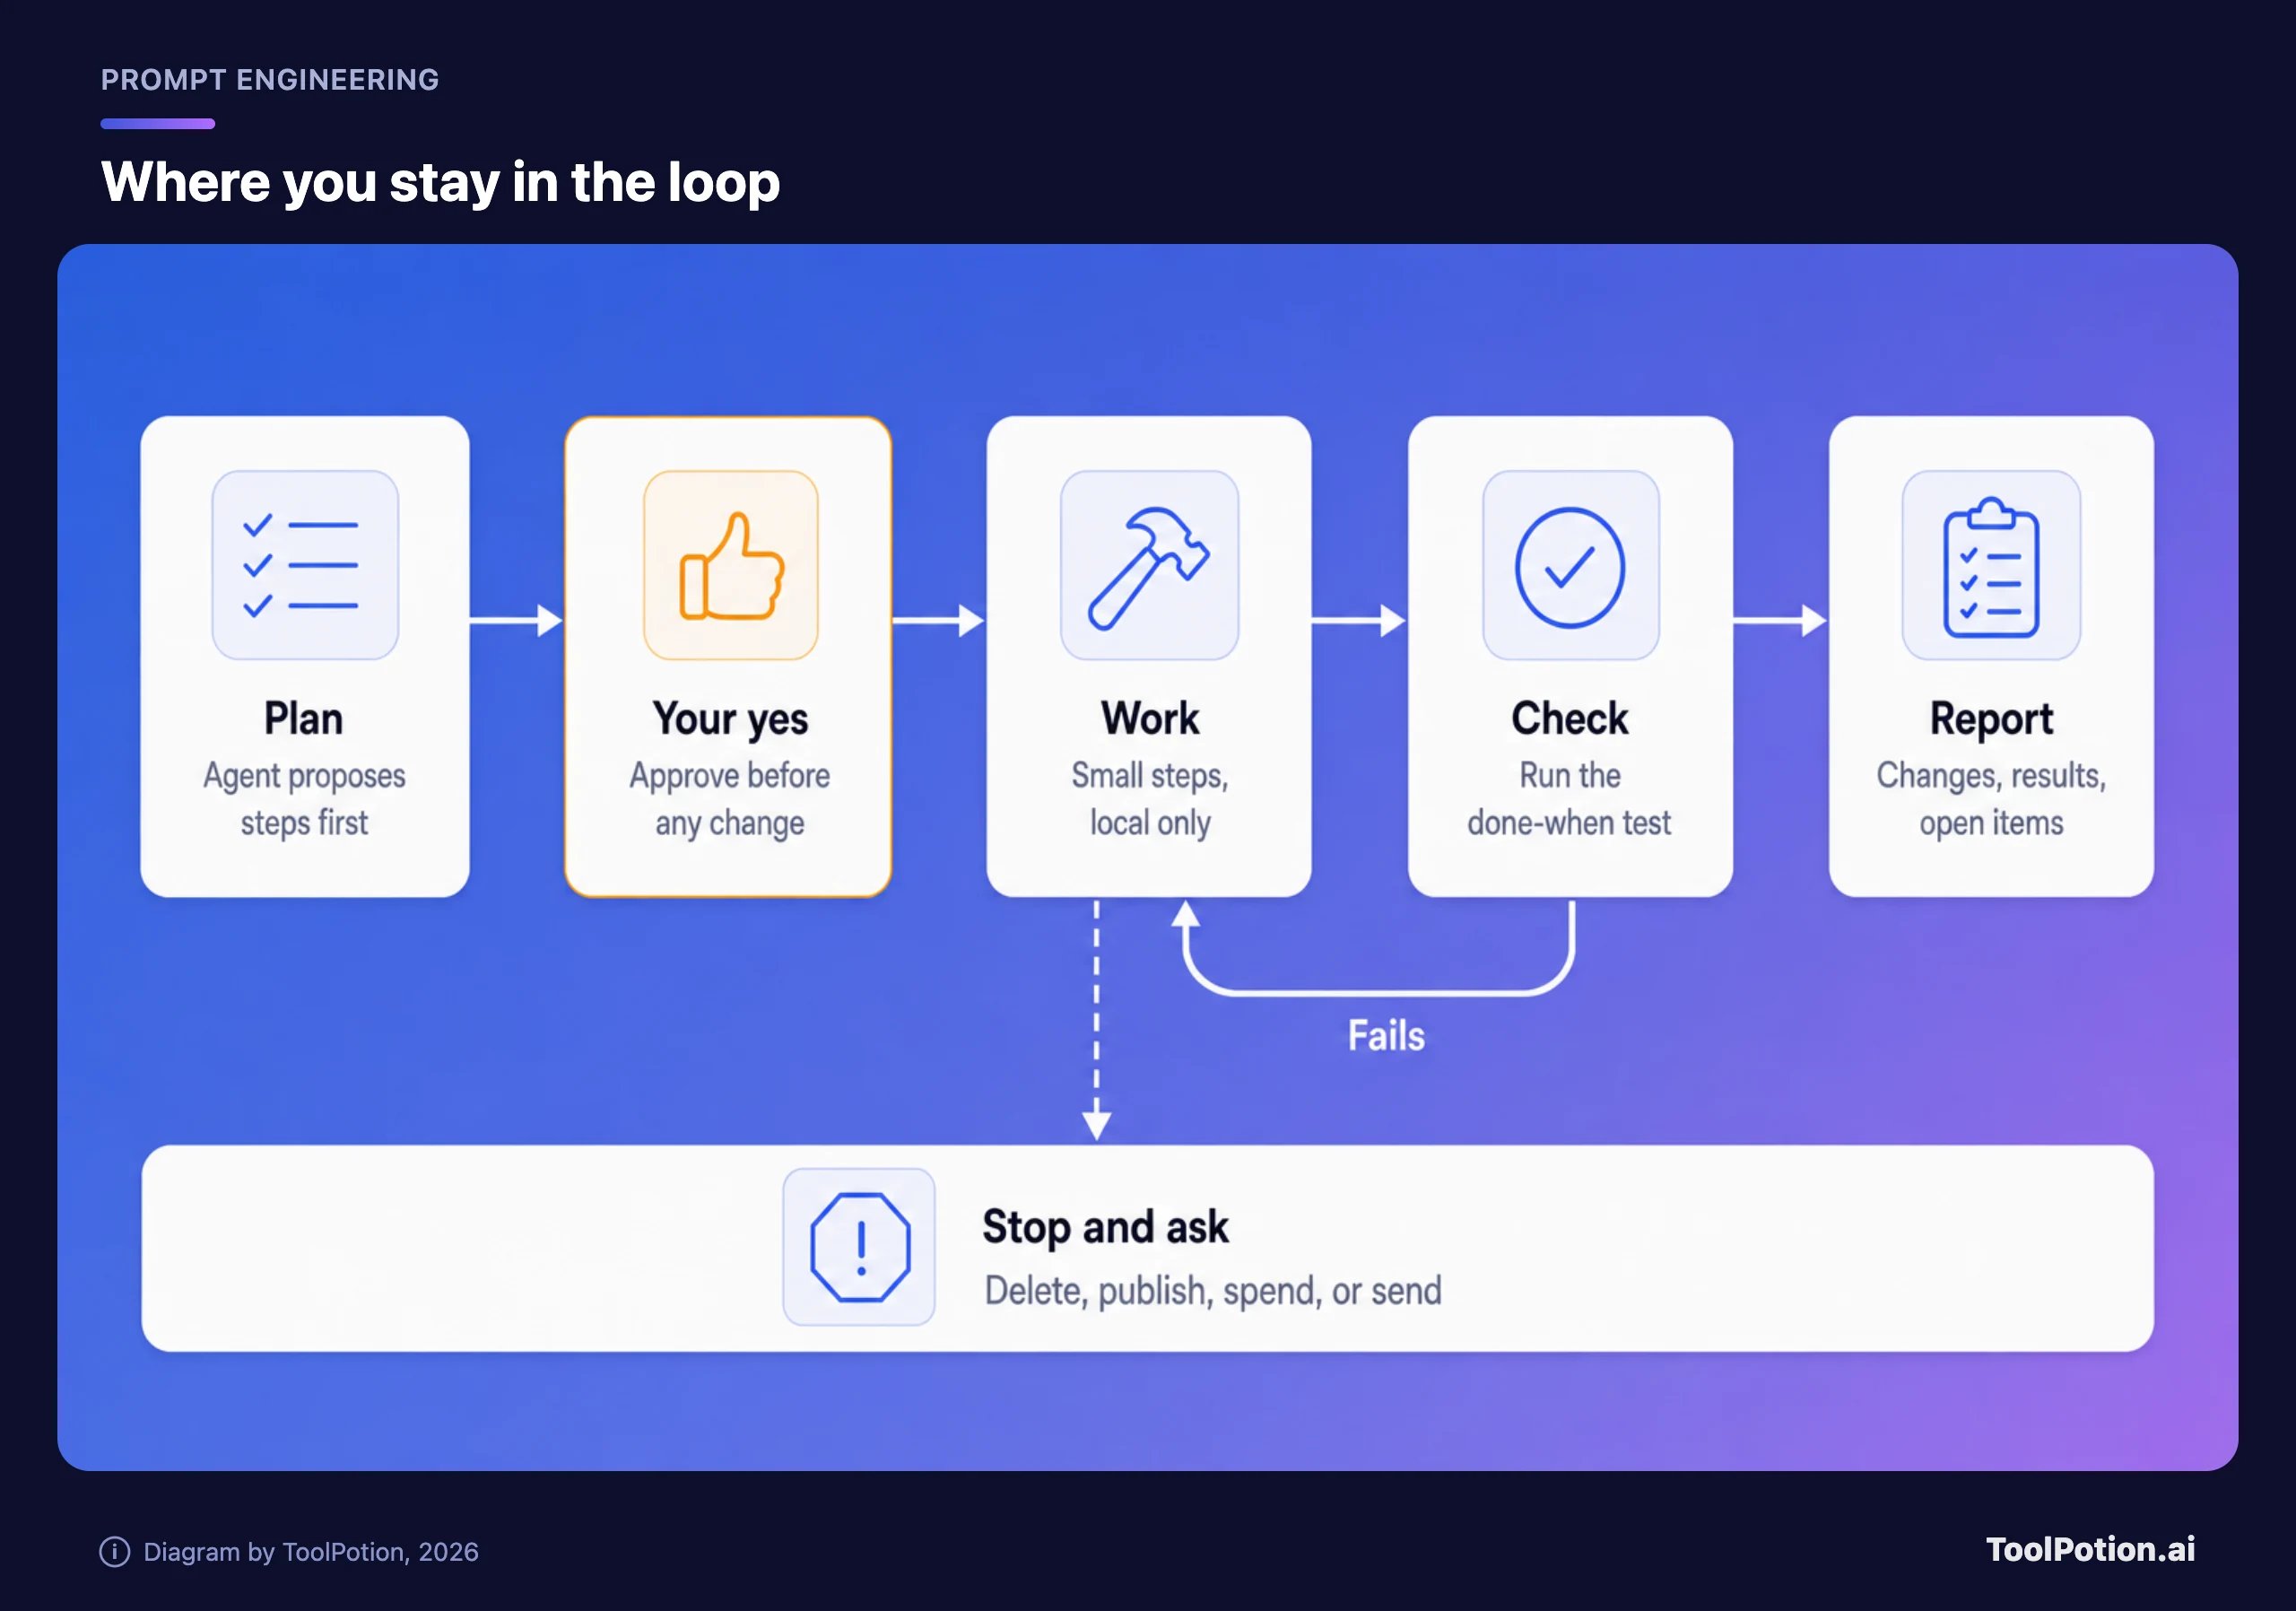
Le rapport, c'est là que vous dites ce qui doit revenir
Demandez les modifications effectuées, les contrôles lancés avec leurs résultats, tout ce qu'il a supposé et tout ce qu'il a choisi de ne pas faire. Ce dernier point est celui que les gens oublient. C'est là que l'agent vous dit qu'il a sauté la migration parce que vous aviez interdit de toucher au schéma.
Trois briefs, avant et après
Chaque réécriture ci-dessous fait environ 120 à 150 mots. C'est plus long que le prompt moyen et plus court que ce que l'on craint. Les trois briefs sont des exemples inventés par nos soins : les tâches, les outils et les chiffres sont fictifs, à titre d'illustration, et aucun ne vient d'un éditeur ni d'un vrai projet.
Un agent de recherche (exemple inventé)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.Un agent de code (exemple inventé)
La documentation de Claude Code contient son propre avant/après : « ajoute un widget calendrier » devient une demande de suivre le modèle d'un fichier de widget existant, avec « aucune nouvelle bibliothèque » (Claude Code docs). Voici le même geste sur un travail plus gros, écrit pour Claude Code ou Codex.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.Un agent de messagerie (exemple inventé)
Celui-ci vaut pour tout assistant que vous laissez approcher votre messagerie, le genre de tâche pour laquelle des produits d'agents comme Manus et Claude Cowork sont vendus. C'est dans les e-mails que « faire du ménage » peut discrètement devenir « supprimer ».
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.La ligne Objectif change à peine entre l'avant et l'après. Tout le poids est dans les quatre dernières lignes : un contrôle, un arrêt, un rapport, et une limite qui dit ce que l'agent ne doit jamais faire.
Un modèle à copier-coller
Supprimez toute ligne qui ne s'applique pas, mais faites-le exprès.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
Notez votre propre brouillon avec ce modèle. Huit questions oui/non, trente secondes.
Comment les briefs échouent, et ce que nous changerions
| Échec | Ce que vous voyez | Correctif |
|---|---|---|
| L'objectif est une activité | Des pages de résultats, aucune décision | Préciser ce que le résultat alimente |
| Pas de « terminé quand » | Il s'arrête à « a l'air fini » ou ne s'arrête jamais | Ajouter un contrôle exécutable et un plafond de tentatives |
| Périmètre non précisé | Fichiers en trop, refactorisations, améliorations non demandées | Lister ce qui est interdit |
| Avertissements sans raisons | Un mur de lignes NEVER, ignorées ou appliquées à l'excès | Ajouter la raison en une proposition |
| Approbation seulement sous-entendue | Il supprime, pousse ou envoie selon son propre jugement | Nommer les actions et demander d'abord un plan |
| Les corrections s'accumulent | Les consignes se contredisent | Réécrire le brief et repartir de zéro |
Deux de ces points méritent qu'on s'y attarde. Le premier, c'est l'empilement de majuscules. Nous doutons qu'un surcroît d'emphase ait jamais réparé une raison manquante, et le guide d'Anthropic va dans le même sens : un simple « NEVER use ellipses » est son exemple faible. La documentation de Claude Code ajoute que « des formules comme "réfléchis étape par étape" ou "sois rigoureux" sont du texte de prompt ordinaire, pas des mots-clés » (Claude Code docs). Nous supprimerions pour cette raison le « sois rigoureux » passe-partout. Le guide d'Anthropic recommande bien de donner un rôle à Claude, même en une phrase, donc nous ne l'interdirions pas ; nous éviterions en revanche le personnage d'« expert de classe mondiale », parce que les six parties en disent déjà plus à l'agent qu'un titre.
Le second est le problème inverse. L'exemple de prompt d'agent du guide d'OpenAI (présenté pour son modèle gpt-6-astra, comme un exemple et non comme une règle) demande au modèle de « continuer jusqu'à ce que la demande de l'utilisateur soit entièrement résolue » et précise « Do not stop after completing only part of the request » (OpenAI docs). C'est raisonnable pour un travail avec une ligne d'arrivée claire, et un piège pour un travail qui n'en a pas. Un agent persistant avec un objectif flou peut continuer à dépenser des tokens en boucle ; le guide de Google dit la même chose de la forte persistance. L'essai d'Anthropic indique qu'il est courant d'inclure des « conditions d'arrêt (comme un nombre maximal d'itérations) » pour garder le contrôle (Anthropic Engineering).
Une autre habitude que nous abandonnerions : coller le brief dans un fil qui contient déjà dix corrections. L'agent a désormais onze jeux d'instructions et aucun moyen de les hiérarchiser.
Surveillez la première minute, puis réécrivez
La documentation de Claude Code conseille : « Surveillez la première minute, appuyez sur Échap dès que Claude dérive, et après deux corrections ratées lancez /clear et écrivez un meilleur prompt plutôt qu'une troisième correction » (Claude Code docs). Nous appliquerions cela à n'importe quel agent : le premier plan et les premières actions montrent si votre brief a été lu comme vous l'entendiez.
Quand vous ne pouvez pas encore écrire le brief, laissez l'agent vous interviewer. La documentation de Claude Code suggère un prompt du genre « Interview me until you could write the spec, then write it to SPEC.md », et les consignes de Codex disent de lui demander de vous questionner d'abord et de « remettre en question vos hypothèses » (Claude Code docs, et OpenAI Codex docs). Repartez ensuite d'une nouvelle session à partir de la spécification écrite.
Les briefs qui servent deux fois méritent un foyer. Les règles permanentes (comment lancer les tests, ce qu'il ne faut jamais toucher) vont dans un fichier AGENTS.md ou CLAUDE.md ; OpenAI affirme qu'« un AGENTS.md court et exact est plus utile qu'un long fichier plein de règles vagues » (OpenAI Codex docs). Une procédure que vous répétez peut devenir un skill, ce que nous abordons dans From Prompts to Skills. Ce qu'il faut charger dans la session au départ est le sujet de notre article sur le context engineering, et les habitudes qui font tenir les prompts d'une version de modèle à l'autre sont dans Prompt Patterns That Survive Model Updates. Pour les outils conçus autour de ce type de délégation, consultez nos classements d'agents IA, de tâches de création d'agents et d'outils de prompt engineering.
Questions fréquentes
Quelle longueur doit avoir un brief ?
Assez pour contenir les six parties, soit 100 à 200 mots pour la plupart des tâches. Les préférences permanentes ont leur place dans un fichier de règles, pour que chaque brief ne couvre que la tâche en cours. Si le brief dépasse une page, il faut probablement scinder le travail en deux.
ChatGPT, Claude et Gemini demandent-ils des briefs différents ?
Le squelette est le même. Les quatre parties du guide Codex d'OpenAI, le conseil d'Anthropic de fournir du contexte et de demander avant les actions risquées, et les dimensions d'agent de Google (gestion de l'ambiguïté, évaluation du risque, persistance) décrivent un même ensemble de besoins avec des mots différents. La mise en forme varie un peu : le guide de Google recommande des balises de type XML ou des titres Markdown et dit de « choisir un format et de l'utiliser de façon cohérente » (Google AI docs). Savoir quel assistant convient à quel travail est une autre question, que nous traitons dans ChatGPT vs Claude vs Gemini in 2026.
Que dire à l'agent de faire quand il a un doute ?
Donnez-lui une règle applicable. « Pars du principe que tout ce qui est réversible passe, et note-le dans le rapport ; demande avant tout ce qui ne l'est pas » fonctionne mieux que « demande en cas de doute ». Le guide de Google présente le même choix comme la question de savoir quand le modèle peut faire des hypothèses et quand il doit s'arrêter pour demander une clarification ou une autorisation.
Un bon brief suffit-il à rendre un agent sûr ?
Non. Un brief réduit les erreurs et n'en empêche aucune. Anthropic recommande « des tests approfondis dans des environnements sandbox, ainsi que des garde-fous appropriés » (Anthropic Engineering), et notre guide sur le confinement couvre les permissions et les pistes d'audit.
L'agent s'est quand même trompé. Que faire ?
Trouvez la première étape où il a dévié et demandez-vous ce que le brief disait à ce sujet. Ajoutez la ligne qui l'aurait évité, puis relancez depuis une nouvelle session.