

Pour vérifier les contenus générés par l'IA sans vous noyer, cessez de vouloir contrôler chaque phrase. Extrayez les affirmations, classez-les selon ce qui s'effondre si elles sont fausses, puis vérifiez à la source originale celles sur lesquelles repose votre texte. Ni une citation bien rangée ni le « oui, j'en suis sûr » du modèle ne prouvent quoi que ce soit.
Le coût de cette étape sautée ne cesse d'augmenter. Une base de données publique de décisions de justice impliquant des contenus hallucinés par l'IA en recensait 2 125 au moment de la rédaction, dont 1 193 rien que cette année (AI Hallucination Cases database). Plus tôt cette année, KPMG a retiré un rapport publié en raison d'hallucinations apparentes de l'IA, après que des organisations citées dans ce rapport ont jugé ses affirmations sur leur usage de l'IA « soit fausses, soit trompeuses » (TechCrunch).
Les hallucinations n'ont pas disparu. Elles sont devenues plus difficiles à repérer, parce que le texte qui les entoure est fluide et que les fausses références ressemblent à de vraies. Vous trouverez ci-dessous les types d'affirmations qui échouent le plus, pourquoi l'autovérification ne suffit pas, un workflow par niveaux de risque avec des prompts prêts à copier, et un regard honnête sur les outils d'ancrage dans les sources comme Gemini Notebook (anciennement NotebookLM), Perplexity et Consensus.
Les fausses citations, un genre judiciaire à part entière
Les avocats ont été les premiers à l'apprendre, et en public. La base de données de Damien Charlotin recense les décisions dans lesquelles un tribunal a constaté, ou laissé entendre, qu'une partie s'était appuyée sur du contenu halluciné, le plus souvent de la jurisprudence inventée. Elle ne cherche pas à compter toutes les fausses citations jamais déposées, seulement celles qu'une juridiction a traitées par écrit. Même avec ce filtre étroit, la courbe est vertigineuse.
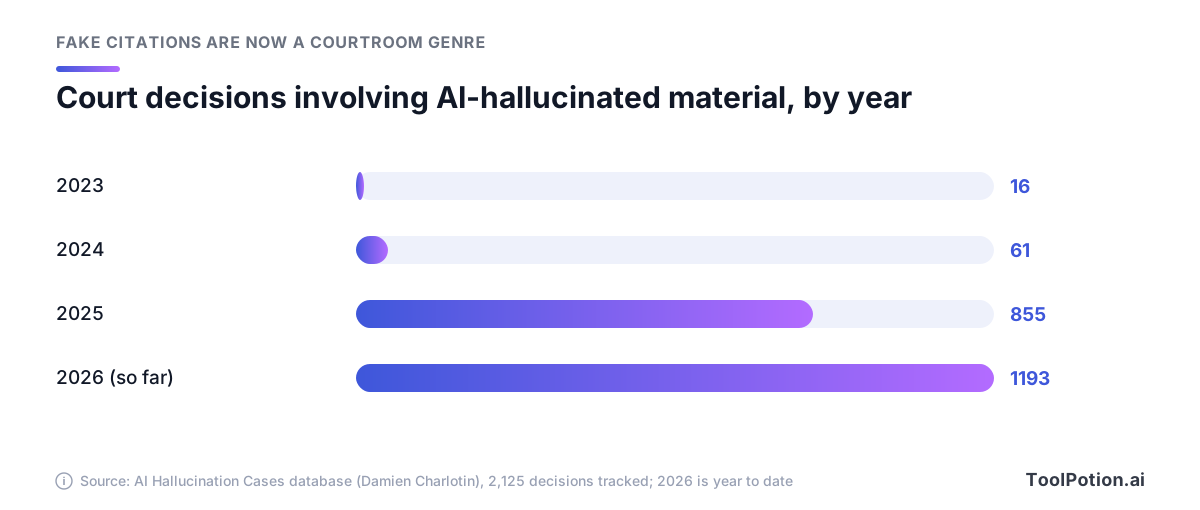
La barre de 2026 ne couvre qu'une partie de l'année et dépasse déjà 2025. Les personnes qui se représentent elles-mêmes comptent pour 1 227 des décisions recensées, mais les avocats pour 840, et la liste en contient 33 où le contenu halluciné venait d'un juge. Les États-Unis dominent avec 1 459 décisions, suivis du Canada avec 223 et de l'Australie avec 112.
L'affaire qui a tout déclenché reste la meilleure leçon. Dans Mata v. Avianca, en 2023, un avocat d'un tribunal fédéral de New York a demandé à ChatGPT si l'une des affaires qu'il lui avait fournies était réelle. Réponse : oui. Relancé, l'outil a affirmé qu'elle « existe bel et bien et se trouve dans des bases de recherche juridique comme Westlaw et LexisNexis » (CNN). L'affaire n'existait pas, et le tribunal a condamné les avocats et leur cabinet à 5 000 $ d'amende. L'avocat a déclaré dans une attestation sous serment qu'il « ignorait que son contenu puisse être faux ».
La facture a grossi depuis. Dans Couvrette v. Wisnovsky, un tribunal fédéral de l'Oregon a relevé quinze citations fabriquées et sept fausses citations de passages dans les mémoires des demandeurs. Il a écarté les mémoires, rejeté les demandes avec autorité de chose jugée et imposé 110 204 $ de sanctions et de frais, le total le plus élevé pour une affaire américaine dans la base. Si vous utilisez l'IA dans un contexte juridique, notre guide sur l'IA pour le travail juridique détaille les configurations les plus sûres.
Les tribunaux ne sont que l'arène la plus visible. Deloitte a accepté un remboursement partiel sur une étude de 440 000 $ commandée par le gouvernement australien, qui citait des rapports inexistants attribués à des professeurs d'université et contenait une référence inventée à une vraie décision de justice. Le cabinet a ensuite reconnu avoir utilisé une chaîne d'outils reposant sur GPT-4o d'Azure OpenAI (The Guardian). EY a retiré cette année un rapport sur les programmes de fidélité qui semblait contenir de fausses notes de bas de page, selon le même article de TechCrunch qui évoquait KPMG. Et en 2025, le Chicago Sun-Times a publié une liste de lectures d'été syndiquée dont 10 des 15 livres étaient inventés, a rapporté NPR.
Là où les contenus d'IA se trompent
Les modèles font rarement des fautes d'orthographe, et les chercheurs d'OpenAI expliquent pourquoi les erreurs se sont déplacées. L'orthographe suit des régularités qu'un grand modèle apprend, mais « les faits arbitraires et peu fréquents, comme la date d'anniversaire d'un animal de compagnie, ne peuvent pas être prédits à partir de régularités seules et conduisent donc à des hallucinations » (OpenAI). Lorsqu'ils ont demandé à un chatbot très utilisé le titre de la thèse de doctorat de l'un des auteurs de l'article, il a donné trois réponses différentes. Aucune n'était la bonne.
Cela vous donne une carte. Les erreurs se concentrent sur quelques types d'affirmations, et les plus risquées sont celles qui se présentent comme des preuves.
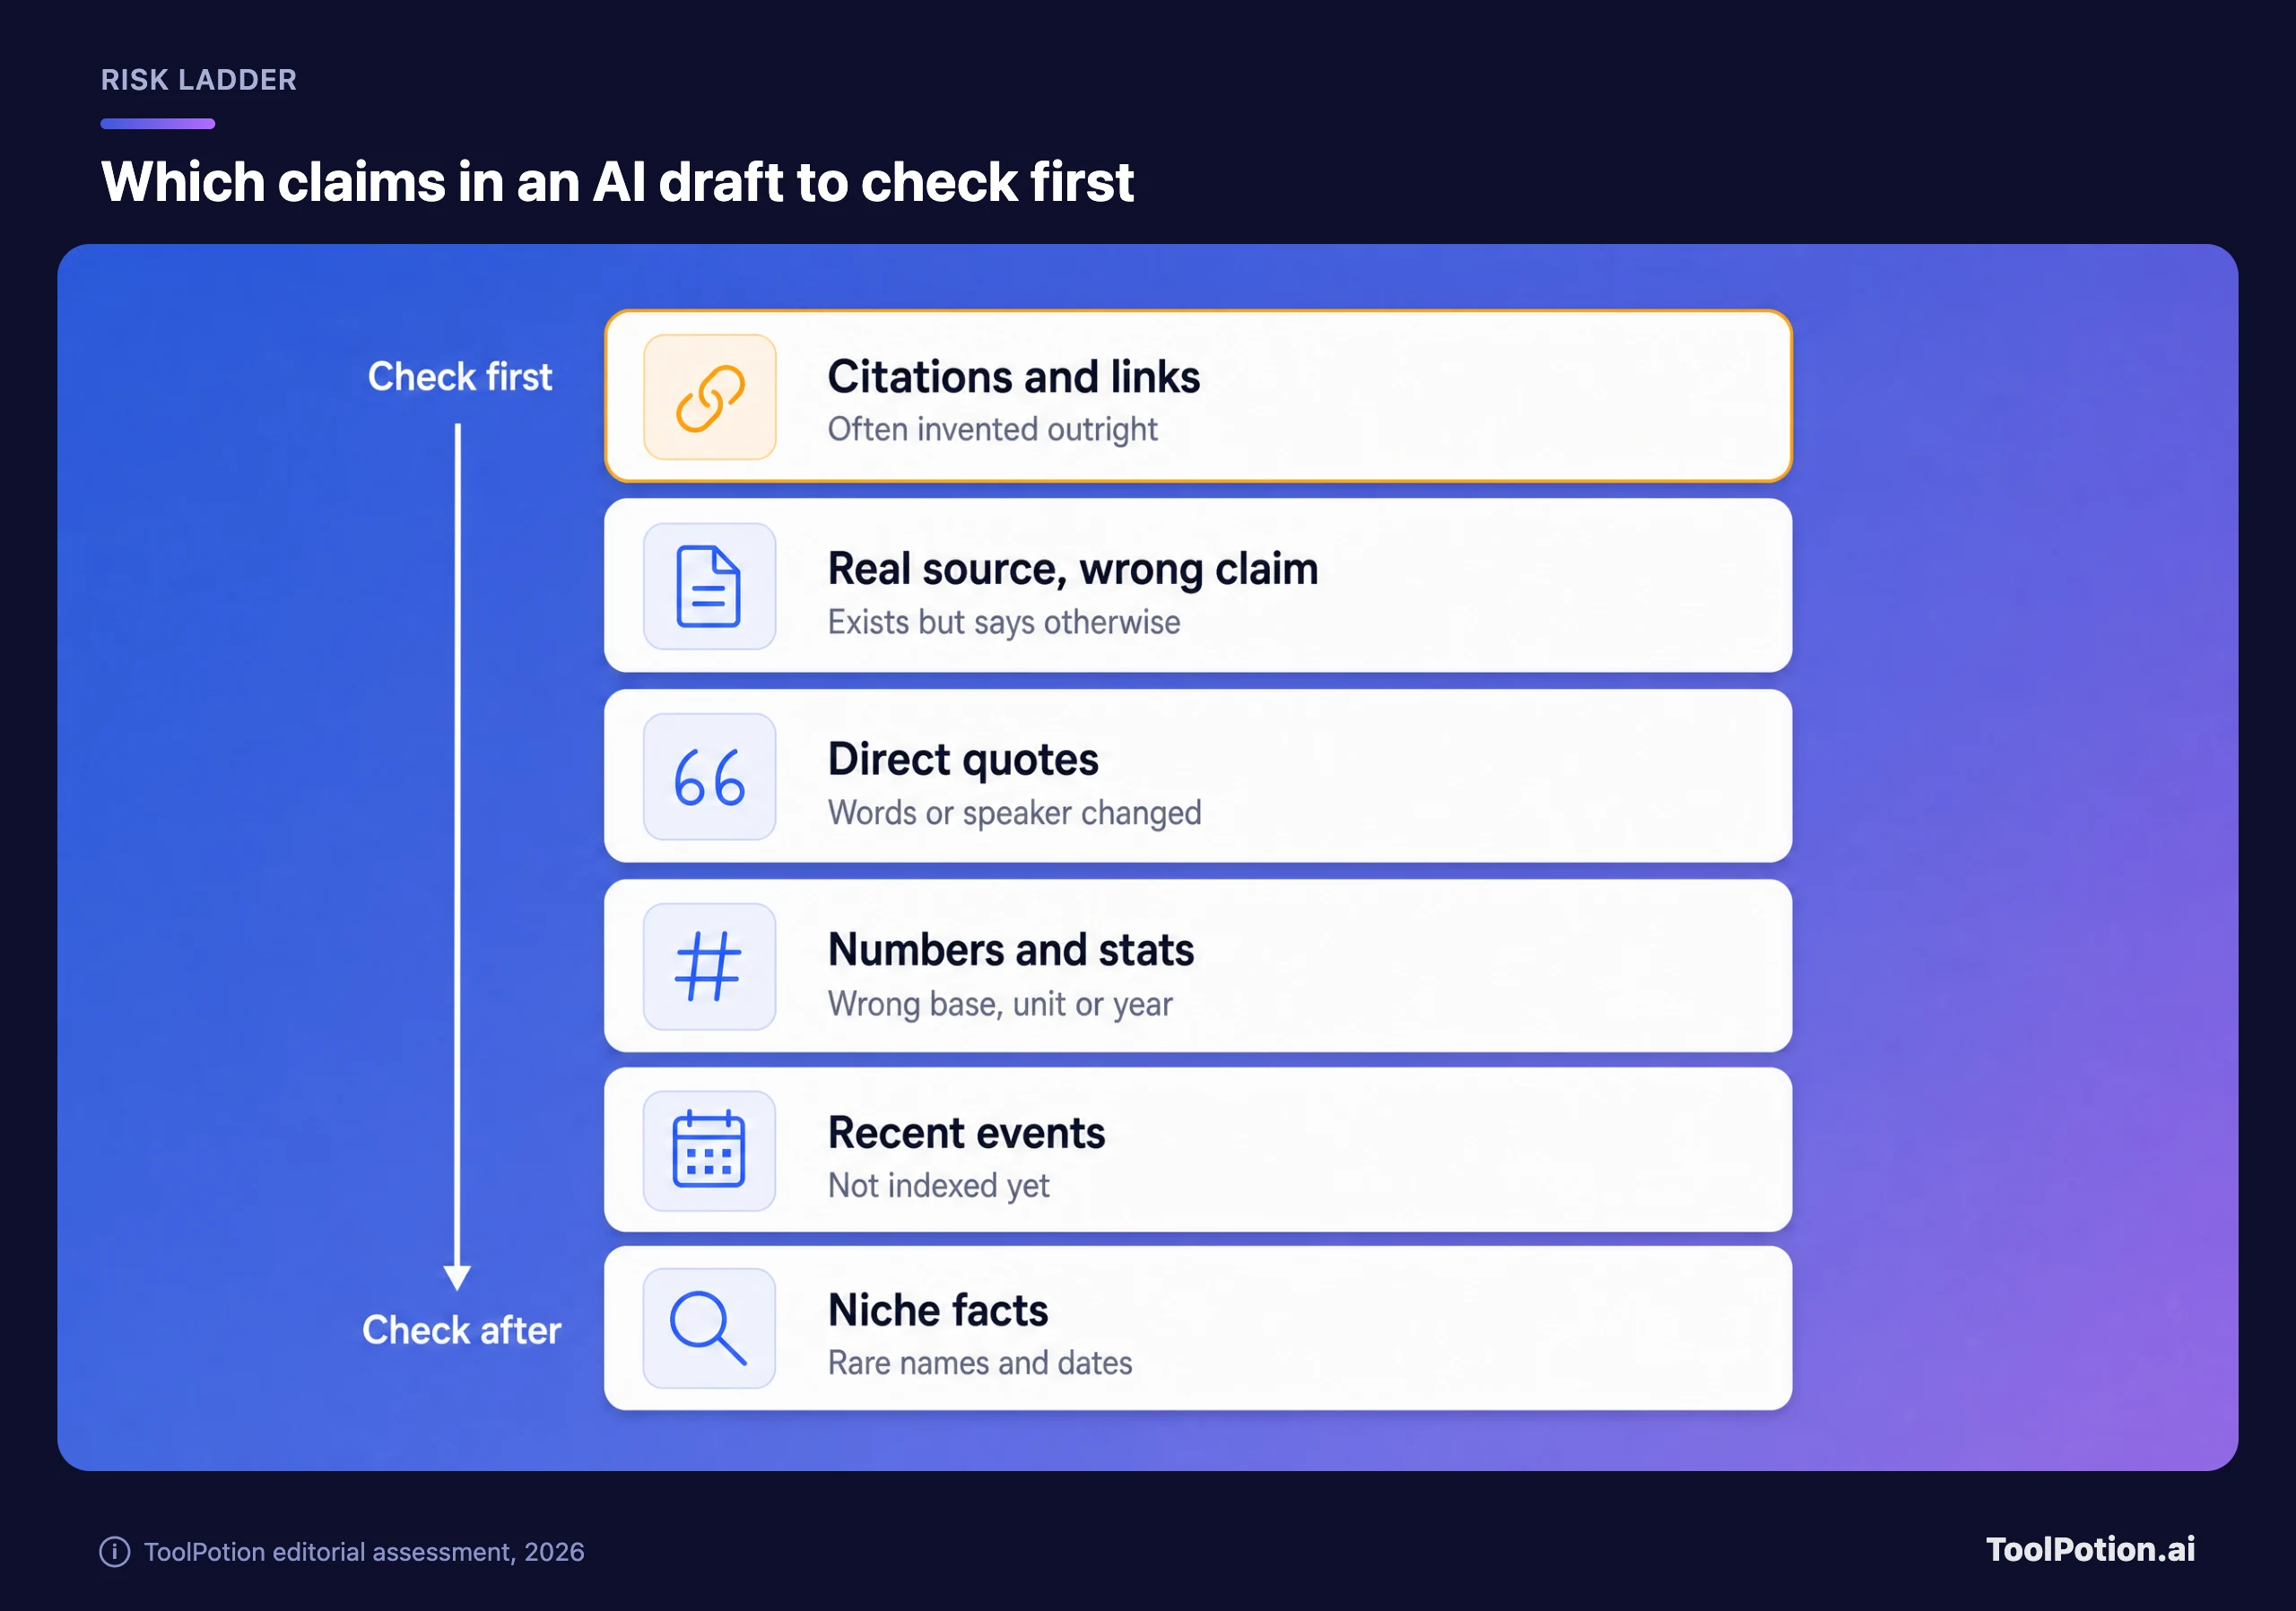
Les citations sont en haut parce qu'elles échouent de deux façons. Certaines sont purement inventées : quand le Tow Center de Columbia a soumis 1 600 requêtes à huit outils de recherche IA en 2025, en demandant à chacun d'identifier la source d'un extrait d'article, les outils se sont trompés collectivement plus de 60 % du temps, et Grok 3 a renvoyé 154 de ses 200 citations vers des pages d'erreur (Tow Center). D'autres sont réelles mais citées pour quelque chose qu'elles ne disent pas. La base de Charlotin compte 894 décisions impliquant des contenus dénaturés, contre 1 752 impliquant des fabrications. Un lien qui fonctionne ne détecte pas ce second cas.
Viennent ensuite les verbatims. La base recense 572 décisions avec de fausses citations de passages, et le centre d'aide d'OpenAI lui-même range « les citations, études, références ou renvois à des sources inexistantes, fabriqués » parmi les défaillances connues de ChatGPT (OpenAI Help). Les chiffres échouent plus discrètement : un vrai chiffre mais d'une autre année, un pourcentage présenté comme des points de pourcentage, un prix régional passé pour un prix mondial.
L'actualité récente est un piège à part. La documentation développeur de Perplexity indique que l'hallucination est la plus probable quand l'information est derrière une connexion ou un paywall, quand les recherches renvoient des « résultats proches mais non correspondants », ou « quand des informations très récentes ne sont pas encore indexées » (Perplexity docs). Une étude menée en 2025 par la BBC sur plus de 3 000 réponses d'actualité de ChatGPT, Microsoft Copilot, Google Gemini et Perplexity a trouvé de gros problèmes d'exactitude, dont des informations périmées, dans 20 % d'entre elles.
Reste le ton. Dans ce test du Tow Center, ChatGPT a mal identifié 134 articles mais n'a signalé son incertitude que 15 fois sur 200 réponses, et les offres payantes de certains outils répondaient correctement à davantage de questions tout en donnant aussi plus de réponses fausses avec aplomb. La page d'aide d'OpenAI le dit sans détour : « Le modèle peut exprimer une grande confiance même dans des réponses incorrectes. » Dans un contenu d'IA, un ton assuré ne vous dit presque rien sur l'exactitude.
Pourquoi demander au modèle de revérifier ne suffit pas
Le raccourci évident consiste à recoller le brouillon et à demander si c'est exact. Mata v. Avianca a déjà montré ce que ça donne, et la recherche le confirme. Un article présenté à l'ICLR 2024 a constaté que les modèles « peinent à corriger leurs réponses sans retour externe, et que leurs performances se dégradent parfois même après autocorrection » (Huang et al.).
La cause se trouve dans l'entraînement. Les chercheurs d'OpenAI soutiennent que « les procédures standard d'entraînement et d'évaluation récompensent la devinette plutôt que l'aveu d'incertitude », un peu comme un QCM récompense une réponse au hasard plutôt qu'une case vide. Ils reconnaissent aussi que la précision « n'atteindra jamais 100 % », parce que certaines vraies questions n'ont pas de réponse. Un modèle qui relit son propre brouillon puise dans les mêmes connaissances que celles qui ont produit l'erreur, si bien que la relecture tend à la reproduire.
L'autorelecture a quand même son utilité. Un article de 2023 sur la Chain-of-Verification a montré qu'une version structurée aide : le modèle rédige une réponse, écrit des questions de vérification, y répond indépendamment du brouillon, puis révise. Cela a réduit les hallucinations sur plusieurs tâches. Voyez-y un moyen de trouver des suspects, jamais de les innocenter.
Ancré dans une source ne veut pas dire exact
Fournir une source au modèle fait baisser le taux d'erreur. Pas à zéro. Le classement public de Vectara demande aux modèles de résumer plus de 7 700 articles en n'utilisant que les faits de chacun, puis note les résumés avec le propre modèle de détection de Vectara. Même dans ce cadre facile, chaque modèle de la liste ajoute du contenu non étayé dans une partie de ses résumés (Vectara).
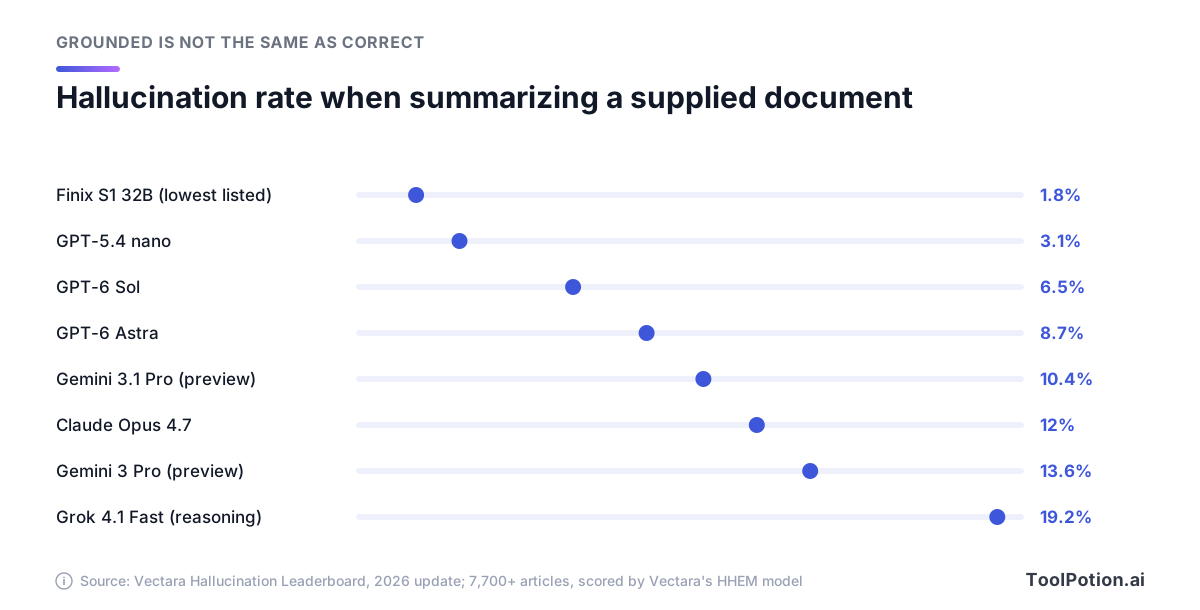
Dans la dernière mise à jour, GPT-6 Sol a ajouté du contenu non étayé dans 6,5 % des résumés et Claude Opus 4.7 dans 12 %. Un modèle qui en note un autre reste imparfait, Vectara précise clairement que le test ne capture pas tous les types d'hallucination, et le tableau n'inclut pas encore toutes les versions actuelles. La tendance reste claire. Une étude de 2024 sur des outils de recherche juridique qui s'appuient sur de la vraie jurisprudence, dont Lexis+ AI et l'AI-Assisted Research de Westlaw, a montré qu'ils hallucinaient quand même entre 17 % et 33 % du temps. L'ancrage réduit le problème à une seule question : la source dit-elle bien cela ? À vous de la poser.
Un workflow de vérification classé par risque
La solution, c'est le triage. L'essentiel d'un brouillon est du tissu conjonctif : cadrage, transitions, opinions que vous défendriez de toute façon. Un petit ensemble d'affirmations porte le texte, et c'est là qu'une erreur fait des dégâts. Triez d'abord, puis consacrez votre temps de vérification là où il rapporte.
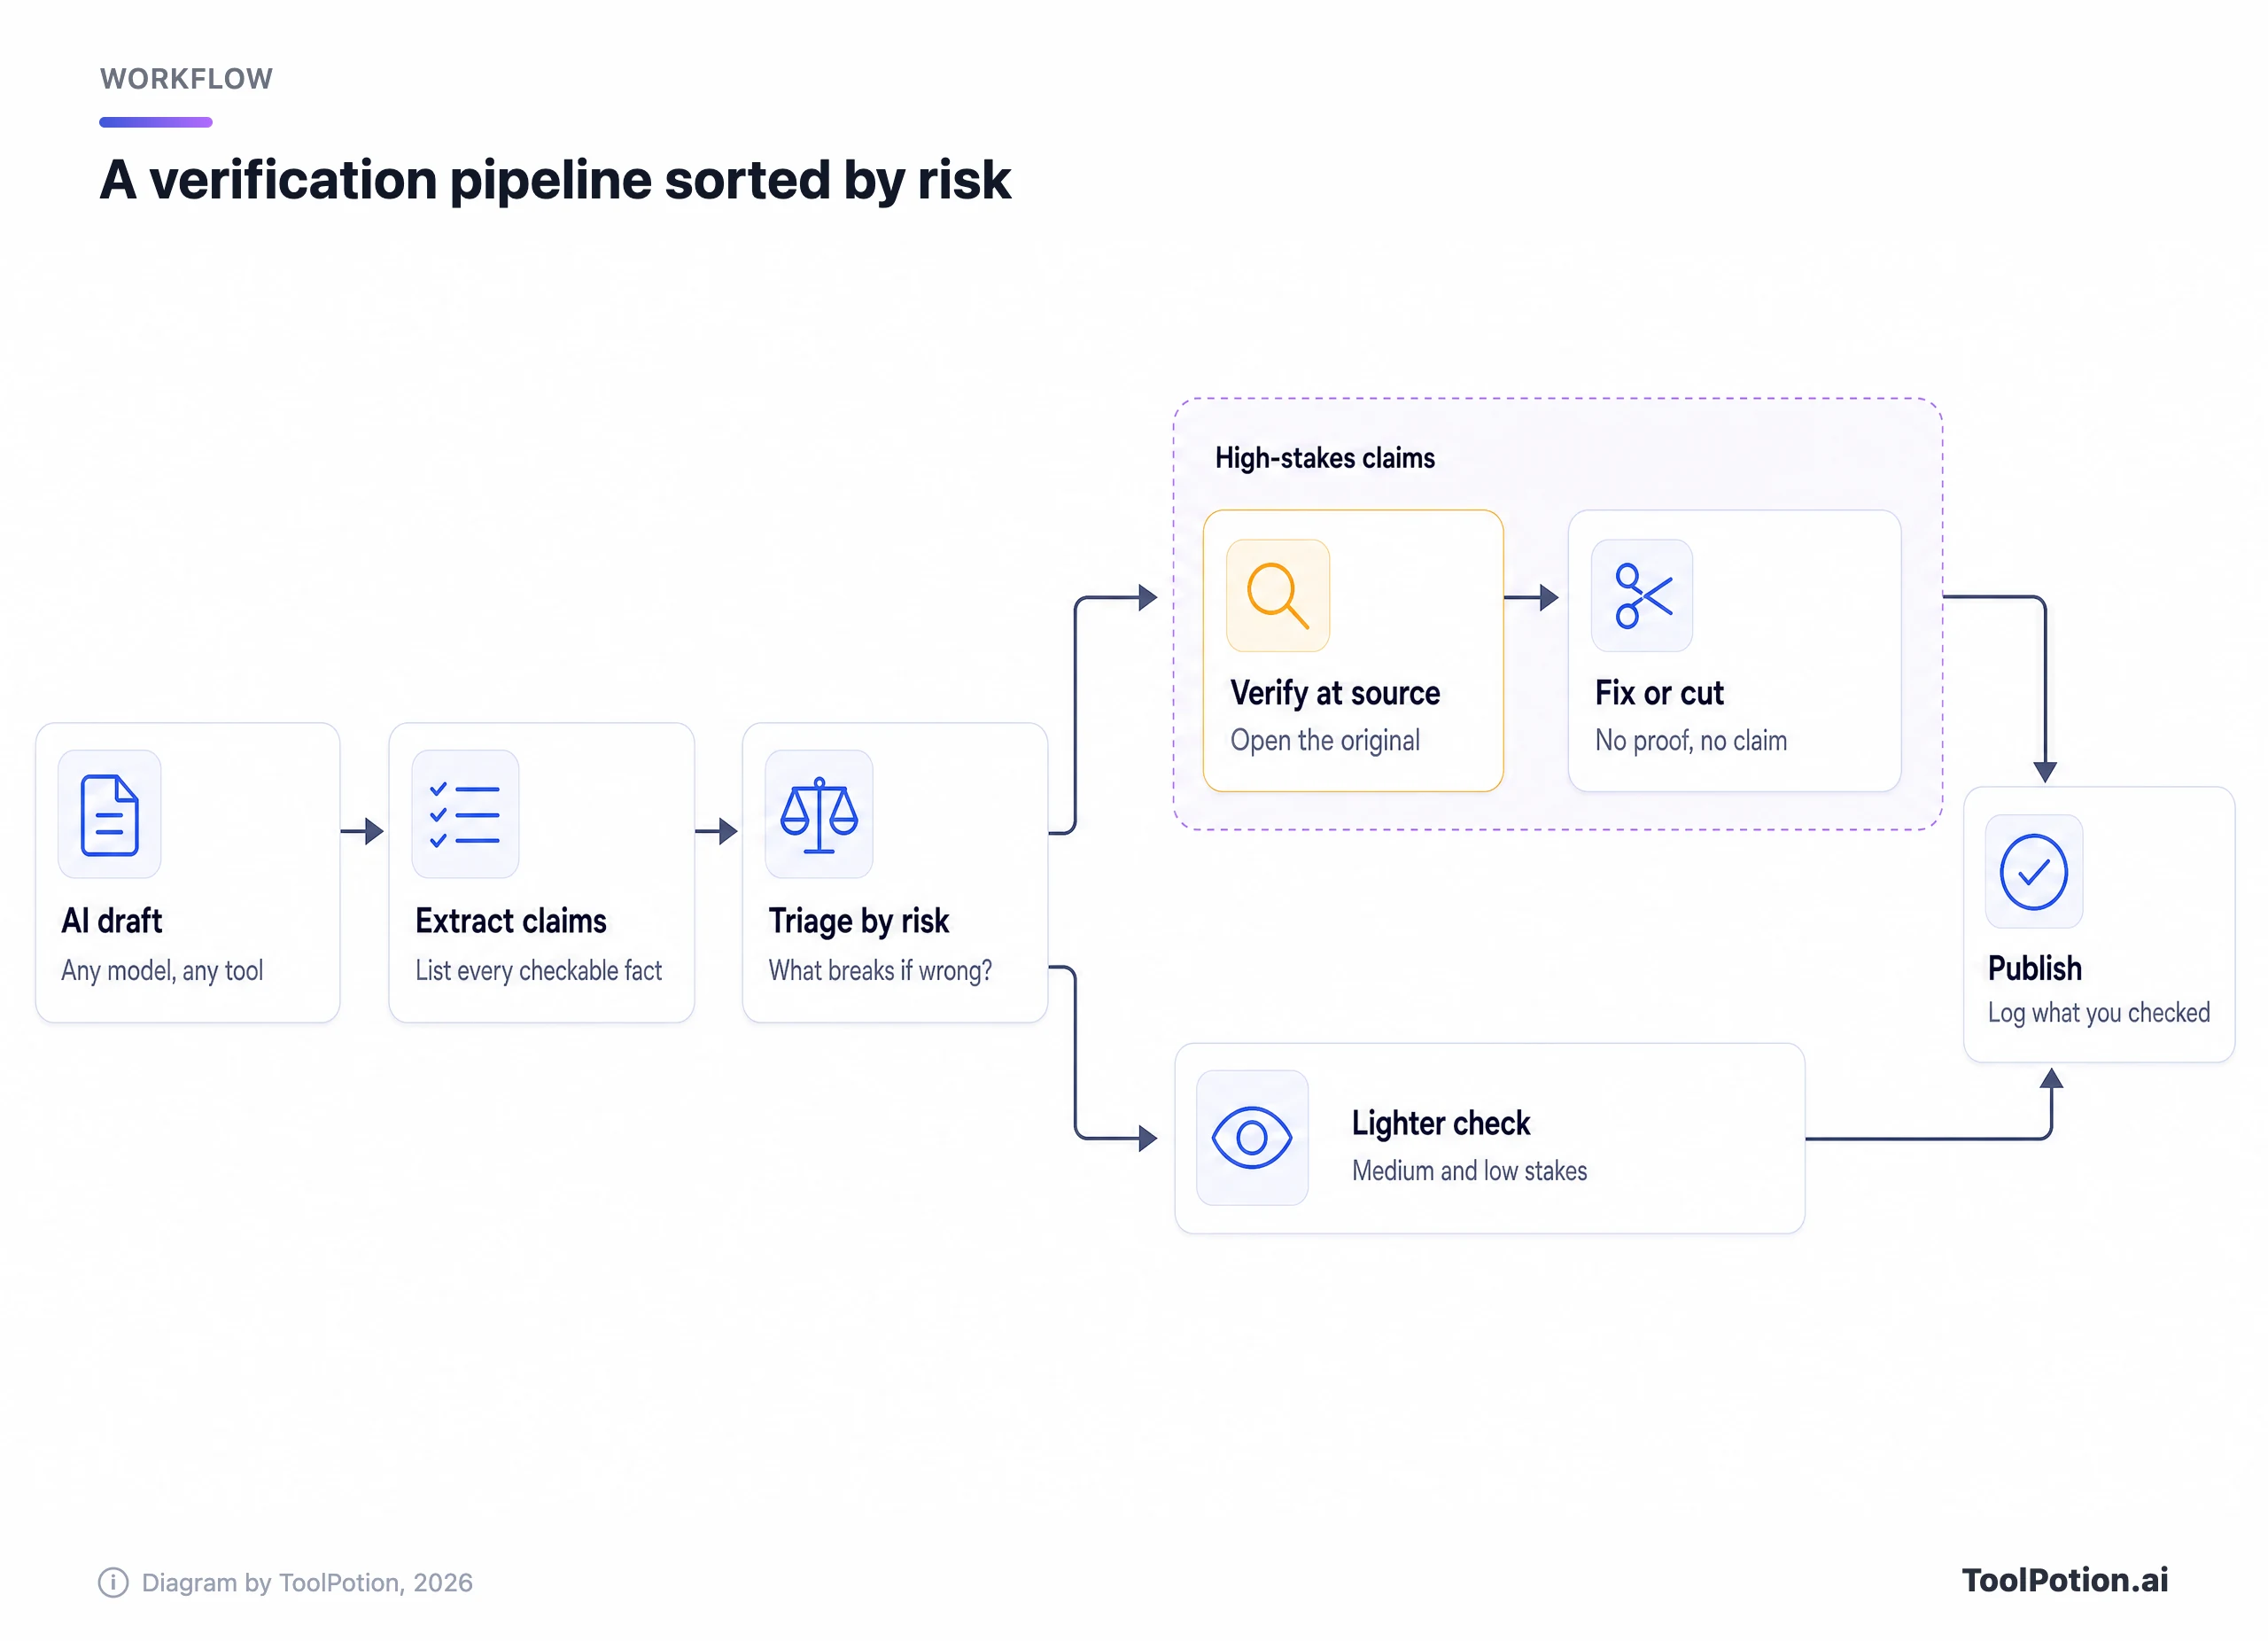
- Extrayez les affirmations. Demandez à un modèle de lister chaque énoncé vérifiable du brouillon : noms, chiffres, dates, citations, références et relations de cause à effet. Vous y trouverez des affirmations que vous ne saviez pas faire.
- Triez selon l'enjeu. Demandez-vous ce qui se passe si chaque affirmation est fausse. Tout ce qui est juridique, médical ou financier est à fort enjeu, de même que chaque référence, chaque citation directe, toute statistique d'un titre ou d'un résumé, et toute affirmation sur une personne ou une entreprise nommée. Le contexte complémentaire qu'un lecteur pourrait répéter est à enjeu moyen. Le cadrage que vous pourriez défendre de mémoire est à enjeu faible.
- Vérifiez le niveau élevé à la source primaire : la décision de justice, le dépôt, le jeu de données, la page de l'entreprise elle-même, l'étude elle-même. Un article de presse sur une étude n'est pas l'étude.
- Contrôlez par sondage le niveau moyen avec la lecture latérale, expliquée plus bas, et réservez au niveau faible une relecture d'éditeur.
- Corrigez, nuancez ou coupez. Si vous ne pouvez pas confirmer une affirmation dans le temps qu'elle mérite, retirez-la ou attribuez-la clairement (« selon l'éditeur »). Ne gardez jamais une affirmation parce qu'elle sonne juste.
- Tenez un journal. Une ligne par affirmation de niveau élevé, avec l'affirmation, la source et l'endroit précis qui l'étaye, prend quelques minutes et répond à la question qu'un éditeur, un client ou un juge finira par poser.
Adaptez l'effort à la distance que parcourra le contenu. Un brainstorming demande une lecture attentive. Un livrable client exige que chaque affirmation de niveau élevé soit ouverte à sa source. Si la facture de vérification paraît trop lourde, le brouillon contient probablement trop d'affirmations, et couper est souvent plus rapide que vérifier.
Vous ne savez pas dans quel niveau classer un contenu ? Répondez à trois questions au maximum ci-dessous.
Remarquez ce que l'arbre demande : où va le contenu et ce qu'il contient, jamais quel modèle l'a écrit. Un modèle plus performant modifie les probabilités. Il ne change pas qui répond de l'erreur.
Comment vérifier citations, verbatims et chiffres
Chaque type d'affirmation a son test rapide. Aucun ne demande de logiciel spécial, seulement la discipline de quitter le chatbot pour ouvrir l'original.
Citations et références
Vérifiez d'abord l'existence. Cherchez le titre, le DOI, le numéro d'affaire ou l'URL dans une base de données ou un moteur de recherche que vous maîtrisez, jamais dans le chatbot qui l'a produit. Vérifiez ensuite l'appui : ouvrez la source et trouvez le passage qui étaye la phrase. Si vous ne le trouvez pas en quelques minutes, la référence ne passe pas. Surveillez aussi la version. Le Tow Center a constaté que les outils de recherche IA renvoyaient souvent vers des copies syndiquées plutôt que vers l'éditeur d'origine, et qu'un preprint peut différer de l'article publié.
Verbatims
Cherchez entre guillemets une expression distinctive de cinq ou six mots. Si elle n'apparaît nulle part, ou seulement sur des pages qui semblent écrites par une machine, considérez la citation comme inventée. Si elle est réelle, lisez le paragraphe autour et confirmez la personne qui parle, la date et le sens. Une vraie citation sortie de son contexte trompe autant qu'une fausse.
Chiffres
Recalculez tout ce que vous pouvez. Confirmez l'unité (pourcentage ou points de pourcentage, mensuel ou annuel, quelle devise), l'année et le dénominateur. Si le brouillon dit qu'un chiffre a doublé, retrouvez les deux nombres. Une statistique sans source nommée n'entre pas dans le texte, aussi plausible soit-elle.
Événements récents et affirmations virales
Vérifiez la date de chaque source et privilégiez les articles publiés après l'événement. Pour une affirmation qui circule déjà en ligne, le Fact Check Explorer de Google fouille les vérifications publiées et montre quelle organisation a évalué l'affirmation, et comment. Vous pouvez aussi importer une image pour voir si elle a déjà été vérifiée.
Avant de publier, passez le brouillon au crible de cette checklist. Les quatre premiers points comptent double.
La pondération suit les données judiciaires : citations fabriquées, sources dénaturées et fausses citations de passages remplissent l'essentiel de cette base. Si ces quatre cases restent vides, rien d'autre dans la liste ne rend le brouillon sûr à envoyer.
La lecture latérale pour les affirmations sans trace écrite
Certaines affirmations arrivent sans référence à ouvrir. Pour celles-là, empruntez l'habitude des vérificateurs professionnels. Le groupe Civic Online Reasoning de Stanford, après avoir observé des fact-checkers au travail, a conclu que « la meilleure façon d'en apprendre sur un site web est la lecture latérale » : quitter la page et regarder ce que disent d'elle d'autres sources, plutôt que d'étudier la page elle-même.
Mike Caulfield a transformé cette habitude en une routine en quatre étapes baptisée SIFT (Caulfield). Elle convient bien aux réponses d'IA, avec un ajustement : la source que vous examinez est le chatbot plus le lien qu'il a choisi.
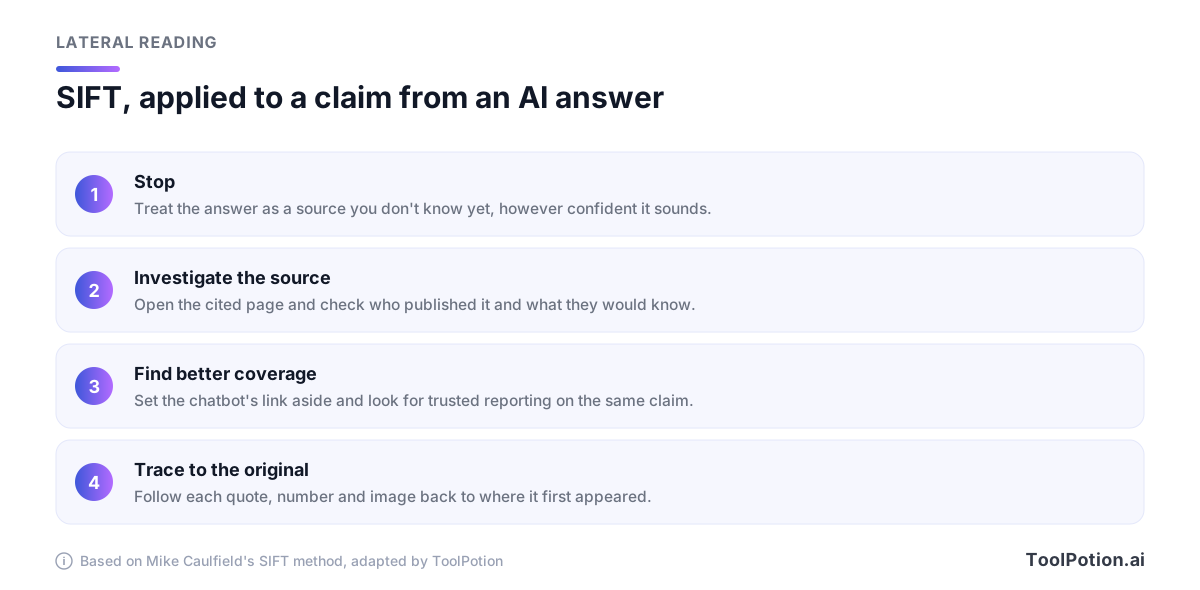
La troisième étape est la plus utile avec les chatbots. Quand l'affirmation compte plus que l'article qui la portait, le conseil de Caulfield est d'« ignorer la source qui vous est parvenue et de chercher des reportages ou analyses fiables sur l'affirmation ». Cherchez donc l'affirmation à neuf, avec vos propres mots. Si un sujet censé être largement couvert n'a aucune couverture indépendante, vous avez votre réponse.
La lecture latérale tranche aussi pour les sources que le modèle trouve seul. Une URL réelle sur un site dont vous n'avez jamais entendu parler est une source faible, même si l'IA a joliment mis en forme la référence.
Des prompts qui facilitent la vérification
Vous ne ferez pas disparaître les hallucinations par le prompt, mais vous pouvez structurer la sortie pour que les erreurs se repèrent plus facilement. La documentation des éditeurs est le meilleur guide. Anthropic affirme que ses techniques recommandées « réduisent significativement les hallucinations » mais « ne les éliminent pas entièrement » (Anthropic docs). Pour des habitudes de prompting plus larges, consultez notre guide pratique du prompt engineering.
Autorisez-le à dire qu'il ne sait pas
Anthropic comme Perplexity recommandent aux développeurs d'autoriser explicitement le modèle à admettre son incertitude ou à signaler qu'il n'a rien trouvé. Les recherches d'OpenAI montrent pourquoi c'est important. Dans sa comparaison sur le benchmark SimpleQA, un modèle qui s'abstenait sur 52 % des questions se trompait 26 % du temps, contre 75 % pour un modèle qui s'abstenait sur 1 %, pour une précision quasi identique. Utilisez ceci comme consigne permanente :
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
Demandez les citations avant les conclusions
La documentation d'Anthropic recommande d'extraire des citations mot pour mot des longs documents avant d'accomplir la tâche, puis de demander au modèle de trouver ensuite une citation à l'appui de chaque affirmation et de retirer toute affirmation qu'il ne peut pas étayer. Concrètement, cela donne ceci :
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
Faites-lui signaler les quasi-correspondances, et ne forcez pas la brièveté
Le guide de Perplexity ajoute une règle à piquer : « Si vous trouvez des résultats proches mais non correspondants (par exemple une autre année, une société mère ou une filiale), indiquez explicitement l'écart avant de répondre. » Cela attrape le bon fait attribué à la mauvaise entité, l'une des erreurs les plus difficiles à repérer à l'œil nu. Ses exemples de règles demandent aussi au modèle de citer les sources par domaine et de « ne pas écrire les URL complètes ».
La longueur compte aussi. Giskard, une société parisienne de test d'IA, a constaté que demander des réponses concises à GPT-4o, Mistral Large et Claude 3.7 Sonnet les rendait moins exacts, car « lorsqu'on les force à faire court, les modèles choisissent systématiquement la brièveté au détriment de l'exactitude ». La même étude a montré que les modèles contredisaient moins volontiers une affirmation controversée énoncée avec assurance par l'utilisateur. Formulez vos questions de façon neutre, « Est-il vrai que X ? », plutôt qu'en présupposant l'affirmation, comme dans « Explique pourquoi X. »
Extrayez les affirmations, puis lancez deux fois
Ce prompt alimente la première étape du workflow. Lancez-le sur n'importe quel brouillon, y compris un texte que vous avez écrit vous-même.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic suggère aussi la vérification best-of-N : lancer plusieurs fois le même prompt et comparer, car des réponses incohérentes signalent des hallucinations probables. C'est le même symptôme qu'OpenAI a observé avec les trois titres de thèse. Un désaccord entre les exécutions vous indique où regarder. Un accord ne prouve rien.
Les outils ancrés dans les sources aident, jusqu'à un certain point
Une autre catégorie d'outils restreint ce sur quoi le modèle peut s'appuyer. Cela transforme « est-ce vrai ? » en « la source dit-elle cela ? », une vérification plus rapide. Elle ne supprime pas la vérification.
Google a rebaptisé NotebookLM en Gemini Notebook plus tôt cette année et l'a conservé comme outil de recherche autonome, que, selon Google, plus de 30 millions de personnes utilisent (Google). Dans le chat, il répond à partir des sources que vous ajoutez et « utilise des citations directes, du texte et des images de vos sources comme références ». Survolez une citation pour voir le texte cité, ou cliquez pour y accéder en contexte (Gemini Notebook Help). Les vérifications d'appui sont donc rapides. Connaissez aussi les limites : les pages d'aide de Google indiquent que les pages web payantes ne sont pas prises en charge et que les notes de bas de page et commentaires des fichiers Google ne sont pas importés. Les fonctions de chat agentiques plus récentes, qui peuvent chercher sur le web et exécuter du code, sont étiquetées expérimentales, avec la consigne « Pensez à bien revérifier ».
Les moteurs de réponse comme Perplexity joignent des liens à chaque réponse, un vrai progrès par rapport à un chatbot sans sources. Les liens, il faut quand même les ouvrir. Perplexity s'est trompé sur 37 % des requêtes dans le test 2025 du Tow Center (les outils ont changé depuis), et l'aide de Google Gemini note elle-même que « toutes les réponses n'incluent pas de liens ou de sources associés ».
Pour les affirmations de recherche, les outils de recherche académique ancrent les réponses dans des articles scientifiques plutôt que sur le web ouvert. Consensus interroge la littérature évaluée par les pairs et affirme que s'il « ne trouve pas de preuves pertinentes suffisantes, il vous le dira » au lieu de combler les trous. Elicit affirme appuyer chaque affirmation générée par l'IA sur des citations au niveau de la phrase. Scite montre si des recherches ultérieures ont confirmé ou contredit les conclusions d'un article, ce qui rattrape un échec que les autres ratent : une étude réelle mais depuis contestée.
Si vous construisez votre propre pipeline, l'API Citations d'Anthropic renvoie le passage exact derrière chaque affirmation, et la documentation d'Anthropic indique que ces citations sont « garanties de contenir des pointeurs valides vers les documents fournis ». Cela exclut les sources inventées. Cela ne confirme pas que le passage étaye la phrase à laquelle il est rattaché. Les vérificateurs de références sont en bout de chaîne. GPTZero propose un détecteur d'hallucinations qui analyse les bibliographies, et son équipe a signalé le rapport KPMG et, plus tôt cette année, trouvé 100 citations hallucinées dans 51 articles acceptés à NeurIPS, une conférence de premier plan en IA, a rapporté TechCrunch.
| Type d'outil | Ancre les réponses dans | Ce qu'il vous reste à vérifier |
|---|---|---|
| Outils de type notebook (Gemini Notebook) | Les sources que vous importez | Que chaque passage cité étaye bien l'affirmation, et que vos sources sont fiables |
| Moteurs de réponse (Perplexity, ChatGPT avec recherche) | Résultats web en direct | Ouvrir chaque lien, vérifier sa date et retrouver l'éditeur d'origine |
| Recherche scientifique (Consensus, Elicit, Scite) | Articles académiques | Les vrais résultats de l'article, ses limites et d'éventuels travaux ultérieurs qui le contredisent |
| API de citations (Claude Citations) | Les documents que vous fournissez | L'appui réel de l'affirmation, au-delà d'un pointeur valide |
| Vérificateurs de références (GPTZero) | Notices bibliographiques | Si une référence réelle dit bien ce que le brouillon prétend |
Pour comparer les options, parcourez le classement des assistants de recherche IA, le classement des moteurs de recherche IA et le classement pour rechercher dans la littérature académique. Nos comparatifs d'assistants de recherche IA et de moteurs de recherche IA détaillent davantage fonctionnalités et tarifs.
Questions fréquentes
Puis-je utiliser un modèle d'IA pour vérifier un autre ?
Comme première passe, oui. Un second modèle, surtout avec accès à la recherche, repérera certaines erreurs que le premier a laissées passer, et les désaccords vous montrent où regarder. Il ne peut rien confirmer, puisque les deux peuvent partager les mêmes lacunes. Prenez ses signalements comme une liste de tâches et réglez chacun à la source. Si vous choisissez un second assistant, notre guide des alternatives à ChatGPT compare les principales options.
Les détecteurs d'IA vérifient-ils les faits ?
Non. Des outils comme le détecteur Originality.ai estiment si un texte a été écrit par une machine. Cela ne dit rien sur la véracité d'une affirmation, et un brouillon écrit par un humain peut être tout aussi faux. La vérification des faits exige la source originale.
Combien de temps faut-il pour vérifier un brouillon d'IA ?
Cela dépend du nombre d'affirmations à fort enjeu qu'il contient, pas de sa longueur. Comptez-les après le triage. Un article explicatif de 2 000 mots avec quatre statistiques et deux citations est un travail court, alors qu'une note d'une page truffée de références ne l'est pas.
Puis-je citer ChatGPT ou un autre chatbot comme source ?
Pas pour des faits. Le conseil d'OpenAI lui-même est d'« utiliser ChatGPT comme premier jet, pas comme source finale ». Citez le document sous-jacent que vous avez vérifié. Si la sortie de l'IA est elle-même le sujet, comme dans un test de modèle, indiquez quel modèle vous avez utilisé et quand.
Les agents de recherche approfondie rendent-ils la vérification inutile ?
Non. Des agents comme la recherche approfondie d'OpenAI compilent des rapports de recherche cités à partir de nombreuses sources web, ce qui vous donne plus de références à ouvrir, pas moins d'affirmations à vérifier. Le problème des sources dénaturées concerne chaque phrase citée, donc le triage compte d'autant plus que les rapports s'allongent.