

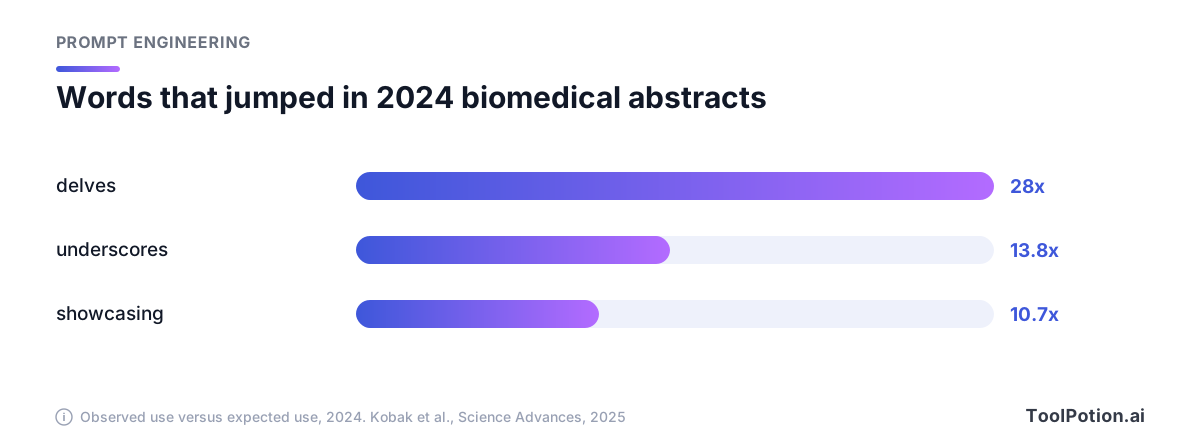
Des chercheurs ont passé au crible plus de 15 millions de résumés biomédicaux sur PubMed, à la recherche des mots dont la fréquence avait bondi depuis l'arrivée de ChatGPT. Un verbe, celui-là même qui donne son titre à l'article, apparaît dans les résumés de 2024 à un rythme 28 fois supérieur à ce que prédisait la tendance antérieure. Deux autres tournent à 13,8 et 10,7 fois. À partir de ce seul glissement de vocabulaire, Dmitry Kobak et ses coauteurs estiment qu'au moins 13,5 % des résumés de 2024 ont été traités avec un LLM, et jusqu'à 40 % dans certains recoins de la littérature (Science Advances, copie ouverte sur PubMed Central).
Ces mots ne disent rien de ce que ces scientifiques avaient à dire. Ils montrent seulement qu'une machine a touché la phrase et que personne n'est repassé derrière.
Ce guide explique comment obtenir un brouillon qui vous ressemble et, surtout, qui dit ce que vous pensez. Il ne s'agit pas de déjouer les détecteurs d'IA. Si vous êtes dans une école, une revue ou un poste où l'aide de l'IA est interdite ou doit être déclarée, respectez cette règle. Nous n'aiderons personne à faire passer un travail de machine là où ce n'est pas permis, et rien de ce qui suit ne sert à contourner un règlement. Pour tout le reste (e-mails, posts, rapports, propositions commerciales), voici le workflow que nous utiliserions, construit à partir du catalogue des éditeurs de Wikipédia sur l'écriture IA, des recherches sur le vocabulaire et des pages d'aide de chaque éditeur.
Pourquoi chaque brouillon par défaut sonne comme la même personne
Les éditeurs bénévoles de Wikipédia nettoient du texte de chatbot à longueur de journée, et leur guide de terrain explique bien le mécanisme. Les modèles de langage, écrivent-ils, « régressent vers la moyenne » : la sortie tend vers ce qui est statistiquement le plus probable sur le plus large éventail de cas. Un second tour d'entraînement l'ajuste vers « la prose la plus largement acceptable ».
La conséquence est précise. Les faits rares sont remplacés par des descriptions courantes. Les éditeurs donnent un exemple : l'ultra-précis « inventeur du premier dispositif d'attelage de trains » devient « un titan révolutionnaire de l'industrie ». Le sujet, selon leur image, passe d'une photo nette à un croquis flou, tandis que les éloges montent d'un cran.
Votre voix vit précisément dans ce que la moyenne efface. Le chiffre inattendu, le nom propre, l'opinion que vous assumez avec une pointe de gêne, la phrase courte après la longue.
Il y a une seconde raison de ne pas bâtir votre correction sur une liste de mots : les mots bougent. La même page Wikipédia indique que ce fameux verbe était massivement surutilisé par ChatGPT en 2023 et 2024, puis a nettement reculé en 2025, et elle recense des favoris différents pour chaque génération de modèles. Quant au tiret cadratin, que tout le monde a accusé, la page précise que ce signe est surtout utile en combinaison avec d'autres, et que certains chatbots récents sont conçus pour le supprimer. Traquez la forme, pas le vocabulaire.
Les humains sont mauvais à ce jeu. La page cite une étude de 2025 où les participants ne font pas mieux que le hasard, et une autre sur des mémoires allemands où les lecteurs identifient correctement 57 % des textes IA et 64 % des textes humains. Elle cite aussi un preprint de 2025 dans lequel un groupe d'annotateurs experts repère 90 % du texte IA.
Partez de cinq textes que vous avez écrits
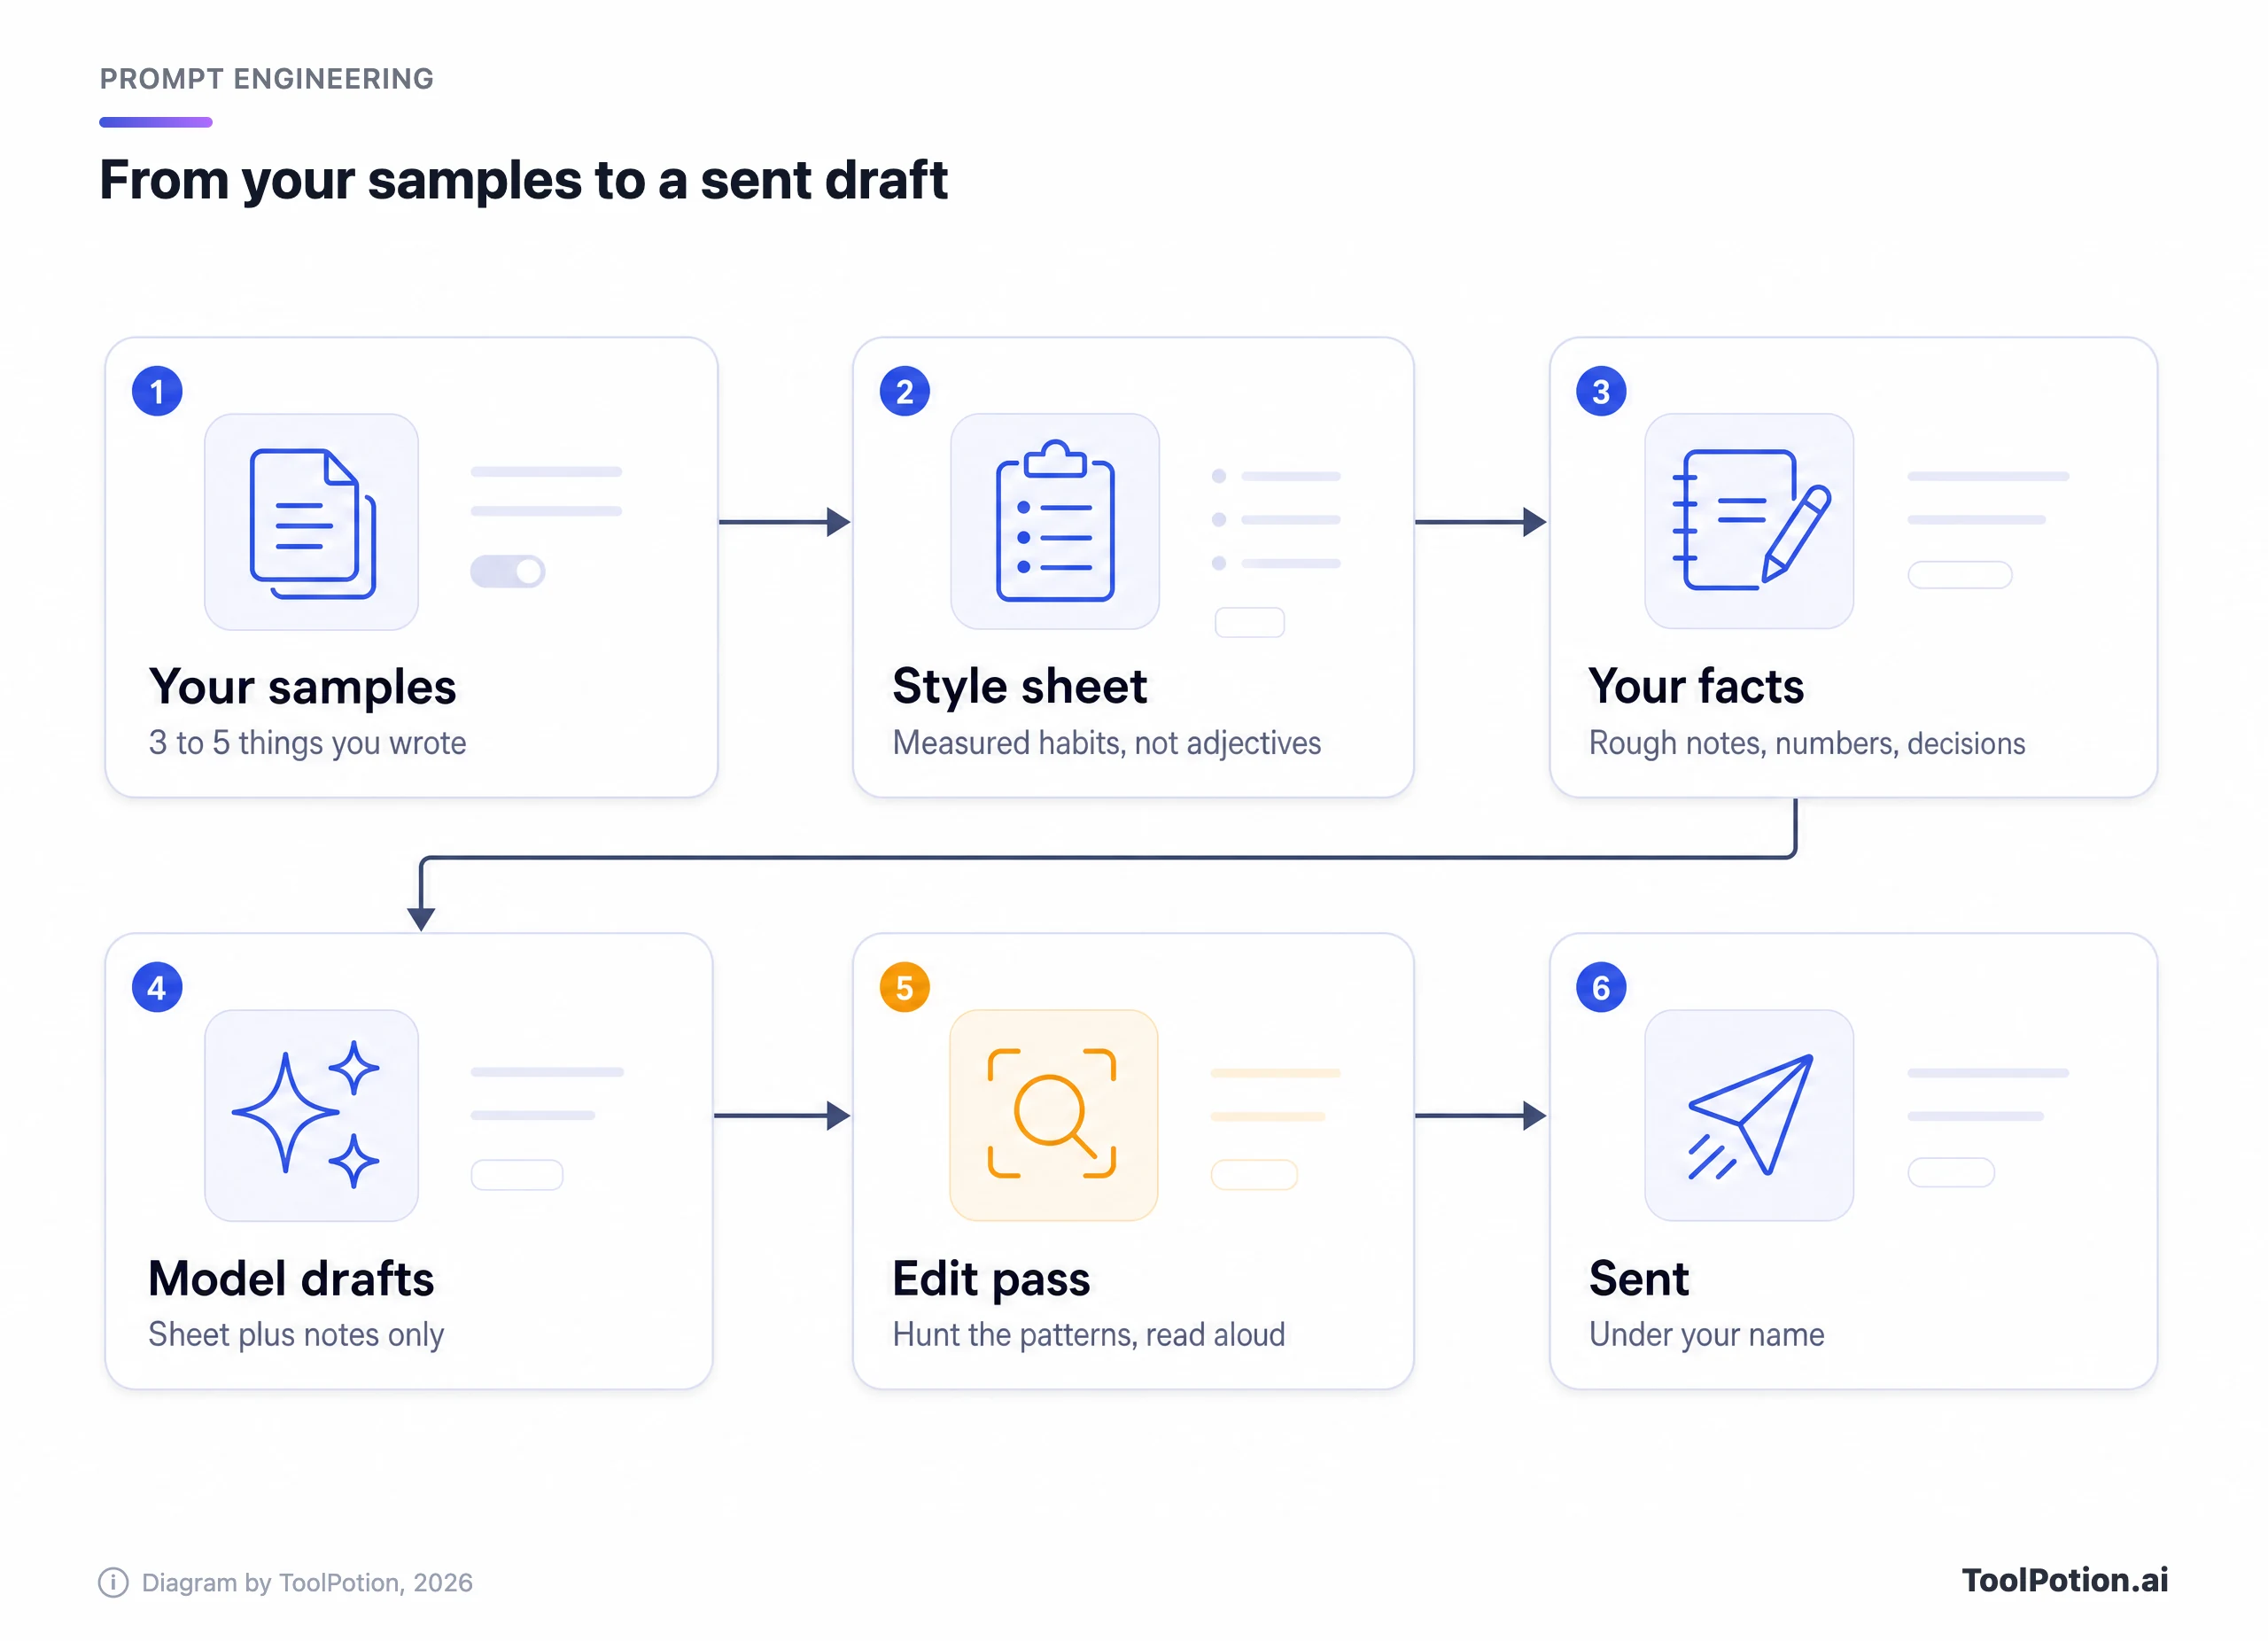
Rassemblez trois à cinq textes écrits par vous, pour un vrai lecteur, sans modèle dans la boucle. Des e-mails à un collègue, un post dont vous étiez content, le message Slack où vous avez expliqué un sujet à une nouvelle recrue, de 300 à 600 mots chacun. Aucune des pages d'aide que nous avons lues ne précise combien d'échantillons suffisent. Notre règle empirique : assez pour qu'une manie apparaisse deux fois.
Choisissez les textes rapides et bruts. Un mot jeté à la hâte à un collègue sympa vaut mieux que le paragraphe sur lequel vous avez peiné pour un client. Écartez tout ce qui a commencé comme un brouillon d'IA que vous avez ensuite lissé : vous apprendriez au modèle ses propres habitudes.
Retirez les noms et tout ce qui est confidentiel avant de coller, puis relisez le tas comme le ferait un inconnu. Cherchez ce que vous faites et qu'un brouillon par défaut ne fait jamais.
Une fiche de style consigne des habitudes, pas des adjectifs
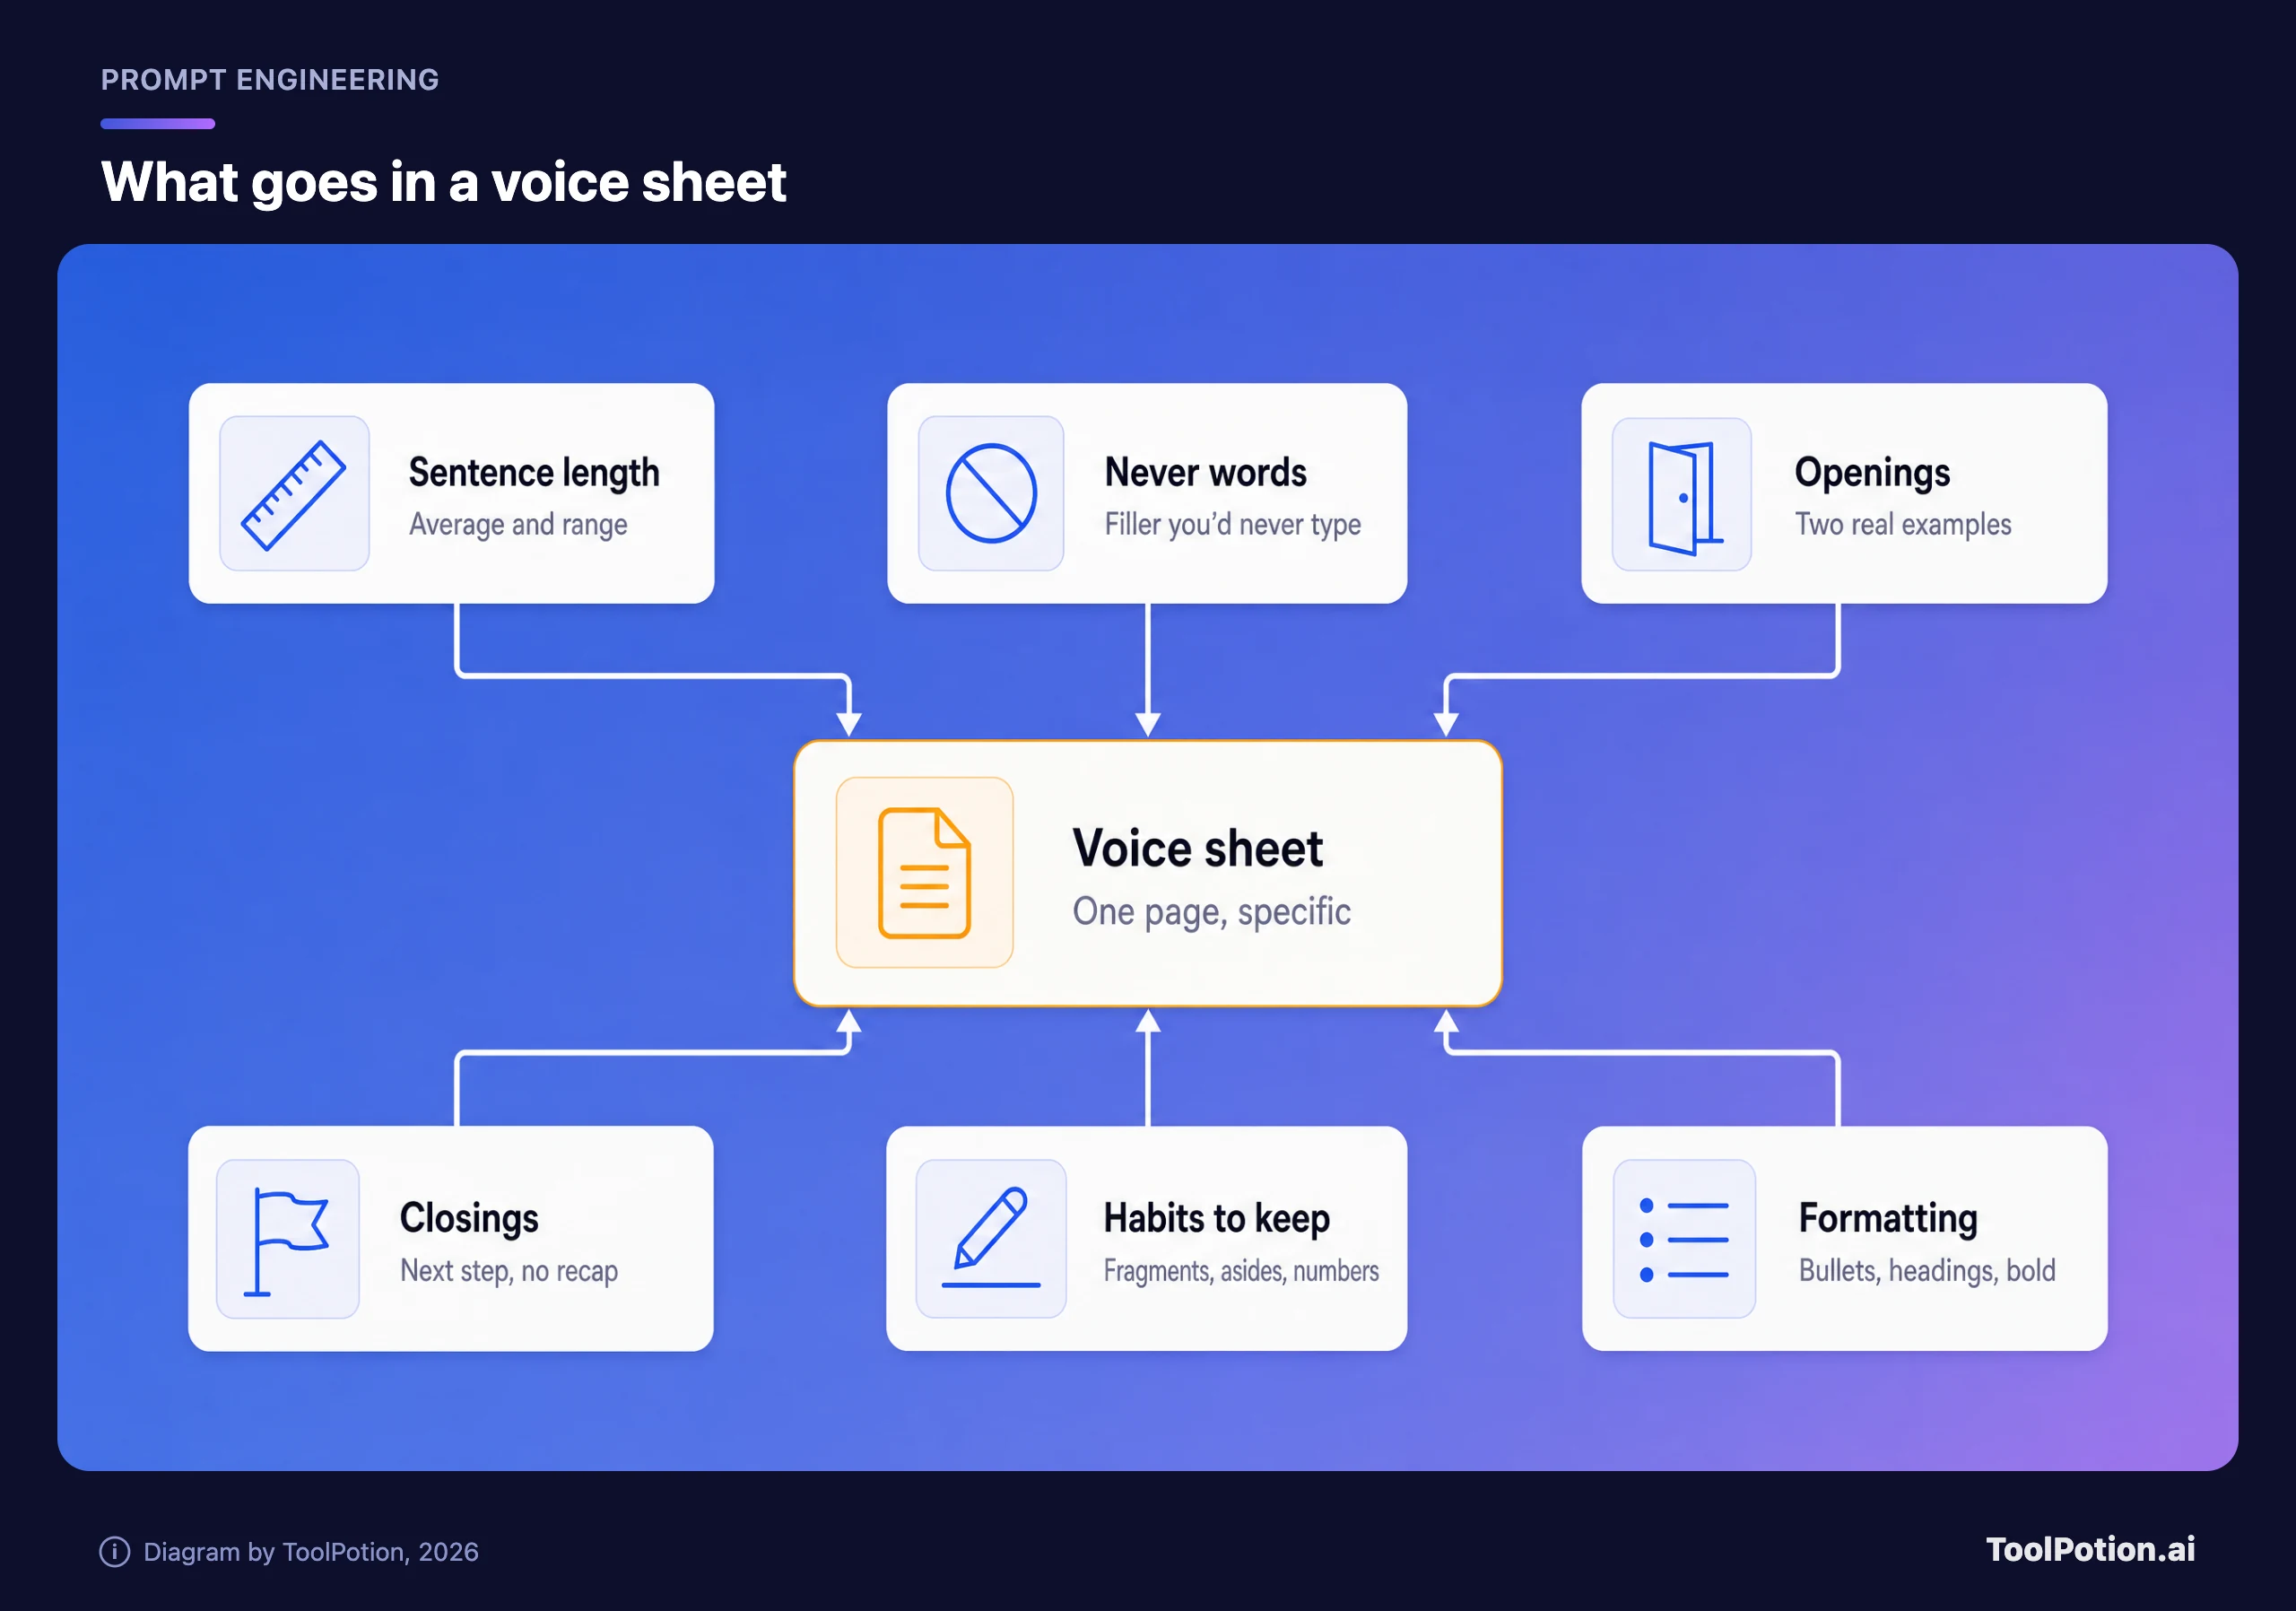
Une fiche de style est une page d'observations sur votre écriture, assez précises pour que quelqu'un puisse vous imiter. Les adjectifs ne comptent pas. « Chaleureux mais professionnel » décrit des millions de gens. Les mesures et les habitudes, c'est vous. Six points méritent d'être notés :
- Longueur des phrases. Comptez sur quelques paragraphes. Si vous tournez autour de 14 mots de moyenne, de 3 à 35, écrivez-le, et précisez que des phrases courtes suivent les longues.
- Mots et expressions que vous n'employez jamais. Parcourez vos échantillons pour repérer le jargon d'entreprise que vous ne taperiez jamais, puis ajoutez ce que vous remarquez dans les brouillons que vous rejetez.
- Votre façon d'ouvrir. Commencez-vous par la réponse, un chiffre, une question ou des excuses ? Citez deux vraies ouvertures.
- Votre façon de conclure. Beaucoup de gens s'arrêtent simplement, ou terminent sur la prochaine étape et une signature. Décrivez la vôtre, et précisez : pas de récapitulatif.
- Les habitudes qu'un modèle lisserait. Fragments, parenthèses, phrases qui commencent par Et, première personne, trait d'ironie sèche, goût du chiffre exact.
- Mise en forme. Si vous utilisez des puces ou non, la longueur de vos paragraphes, la façon dont vous écrivez les titres, si vous faites des contractions (la plupart des gens, oui).
Ajoutez deux ou trois de vos vraies phrases en exemples. Les modèles imitent mieux les exemples que les descriptions.
Voici une fiche condensée que nous avons rédigée pour une responsable des opérations imaginaire, Dana. Elle illustre le format. Ne la copiez pas : la vôtre doit être différente.
VOICE SHEET: Dana
Sentences: average 14 words, range 3 to 35. A short one after every long one.
Openings: the answer first, or the number. Never a greeting line, never "I wanted to".
Closings: the next step and who does it. No recap, no offer to help further.
Contractions always. First person plural for the team, "I" for opinions.
Parentheses for asides, maybe one per email. Fragments are fine.
Never writes: "touch base", "circle back", "moving forward", "going forward", "leverage", "stakeholders", "ensure".
Numbers as digits, with units. Dates as "Thursday the 12th".
No bullets in emails under 200 words. No bold. No headings.
Examples of my sentences:
- "The vendor took nine days, not two."
- "We can cut invoices from this release. Nothing else can slip safely."
- "Not great, but fixable."
Vous pouvez demander à un modèle de rédiger la fiche à partir de vos échantillons, mais vérifiez chaque ligne avec une vraie phrase de vous. Les modèles décrivent un auteur dans la moyenne. Si aucune de vos phrases n'obéit à une règle, supprimez-la.
Où placer la fiche dans chaque outil
Tous les grands assistants ont un emplacement pour les instructions permanentes. Ils diffèrent par la quantité de texte acceptée, et une fiche complète avec exemples est plus longue que ce que certains autorisent.
| Outil | Où mettre votre voix | Ce que dit la page de l'éditeur | Limite |
|---|---|---|---|
| ChatGPT | Paramètres, puis Personnalisation, puis Instructions personnalisées | Appliquées immédiatement à toutes les conversations. Limite de 1 500 caractères en Free et Go, 5 000 en Plus, Pro, Business, Enterprise et Education | Faites tenir la version courte de la fiche ici et collez les exemples en début de conversation |
| Claude | Paramètres, puis Your Claude, puis Instructions ; ou les instructions d'un projet | Instructions au niveau du compte, instructions au niveau du projet, et skills pour des « schémas de communication fondés sur votre propre écriture » | La page de personnalisation d'Anthropic mentionne les instructions, les instructions de projet et les skills, sans fonction de styles distincte |
| Google Gemini | Un Gem : un nom, des instructions et des fichiers de connaissances facultatifs | Gemini peut réécrire pour vous les instructions de votre Gem | Google indique que les Gems des comptes personnels seront bientôt remplacés par des skills |
| Grammarly Humanizer | Collez un échantillon de texte pour créer une voix personnalisée | Quatre styles prédéfinis, plus une voix personnalisée apprise à partir de votre échantillon, pour les réécritures futures | Il réécrit un texte que vous avez déjà. Il ne peut pas fournir les faits que vous avez omis |
Sources : OpenAI, Anthropic, Google et Grammarly.
Notre choix est sans surprise : gardez la version de référence dans un simple fichier texte que vous maîtrisez et collez-la où il le faut. Les éditeurs renomment et retirent ces fonctions (Google indique que les Gems des comptes personnels deviendront des skills), et une fiche que vous pouvez coller n'importe où y survit. Pour transformer un prompt en quelque chose de réutilisable, voyez les instructions IA réutilisables, et pour comprendre pourquoi le contexte l'emporte sur la formulation astucieuse, le context engineering.
La voix personnalisée de Grammarly, fondée sur un échantillon, est la bonne idée, et elle est vendue comme un « AI humanizer ». La FAQ de Grammarly précise que l'outil « n'est pas destiné à contourner les détecteurs d'IA » et encourage à signaler l'aide de l'IA dans un cadre académique ou professionnel. Nous l'utiliserions de la même façon, comme un correcteur qui apprend vos habitudes. D'autres produits de la catégorie des humanizers IA peuvent faire d'autres promesses : lisez leurs conditions. Notre comparatif des assistants d'écriture et la comparaison Grammarly contre QuillBot couvrent les outils plus généralistes.
Donnez-lui vos faits, puis demandez un brouillon
La fiche règle la surface. Le fond doit venir de vous. Avant de demander un brouillon, notez la matière brute en vrac : ce qui s'est passé, les chiffres, la décision, ce que vous attendez du lecteur. Dix lignes en vrac suffisent. Ensuite, dites au modèle de n'utiliser que cette matière, de vous poser la question quand un fait manque au lieu de combler le trou, et de suivre la fiche.
L'instruction « demande-moi » est la plus importante. Un modèle autorisé à deviner devinera, et ses suppositions sont du genre générique, flatteur et plausible. Notre guide du prompt engineering détaille la mécanique de ce type d'instructions, et le guide des e-mails les applique à l'e-mail.
Un point d'étape, avant et après
Nous avons rédigé nous-mêmes les deux versions ci-dessous pour illustrer l'écart. La première ressemble à un brouillon par défaut typique quand on demande à un chatbot d'« écrire un point d'étape à un client sur un retard ». La seconde est ce que Dana enverrait après avoir donné au modèle ses dix lignes et sa fiche, puis retouché le texte.
| Brouillon IA typique (notre illustration) | Brouillon retouché avec la fiche de style (également inventé par nos soins) |
|---|---|
| Objet : Point d'étape sur le projet. J'espère que ce message vous trouve en bonne santé. Je souhaitais prendre un moment pour faire le point sur le calendrier du projet. Notre équipe travaille avec diligence afin de livrer un produit de grande qualité, et nous restons attachés à la transparence. Malheureusement, nous avons rencontré des difficultés imprévues qui ont eu un impact sur notre planning. À l'avenir, nous continuerons de privilégier une communication claire et la collaboration. N'hésitez pas à me contacter si vous avez la moindre question. | Objet : Nous avons une semaine de retard. Le prestataire de paiement a mis neuf jours à valider notre compte de test, et non les deux annoncés, donc nous n'avons pu tester le paiement qu'à partir de lundi. Ça fonctionne maintenant. Nouvelle date : jeudi 12. Si cela casse votre embargo presse, appelez-moi et nous retirerons la facturation de cette version, le seul élément qui peut glisser sans rien casser d'autre. Dana |
Comptez ce qui a changé. La seconde version est plus courte, mais ce n'est pas le sujet : elle contient un neuf, un deux, un lundi, un jeudi et une décision que le client peut prendre. Rien de tout cela ne vient du modèle, et rien ne pouvait en venir. L'essentiel du progrès tient aux faits, le travail sur la voix vient en plus. Rien n'est faux dans le premier brouillon. Mais n'importe qui aurait pu l'envoyer, à propos de n'importe quoi.
Huit choses à traquer à la relecture
Imprimez cette partie. Ces schémas viennent du catalogue de Wikipédia, bâti sur de vrais exemples tirés d'articles, de brouillons et de pages de discussion. La colonne du milieu décrit chaque schéma, avec quelques expressions que la page elle-même montre.
| Le tic | À quoi ça ressemble | Que faire |
|---|---|---|
| Importance gonflée | Des faits ordinaires présentés comme un tournant, un héritage, un rôle dans des tendances plus larges (« marking a pivotal moment », « reflects broader ») | Supprimez la phrase, ou remplacez-la par le fait simple qu'elle enflait |
| Queues de participe | Une phrase qui se termine par un commentaire en « -ing » expliquant au lecteur ce que le fait signifie | Coupez-la. Énoncez l'affirmation dans sa propre phrase, ou supprimez-la si vous ne pouvez pas l'étayer |
| Parallélisme négatif | « Ce n'est pas seulement X, c'est Y » et ses cousins « pas X, mais Y » | Dites Y |
| Attribution vague | Des experts, rapports ou observateurs anonymes cités pour une affirmation que personne ne peut retracer | Nommez qui l'a dit et donnez le lien, ou retirez-le |
| Règle de trois | Trois adjectifs ou trois propositions parallèles par réflexe | Gardez celui ou ceux, un ou deux, qui sont vrais |
| Mise en forme déguisée en réflexion | Étiquettes en gras au début de chaque puce, titres en casse de titre, emoji en guise de puces | Écrivez des phrases simples. N'utilisez une liste que si les éléments sont distincts |
| Un paragraphe de perspectives bien rangé | Une section finale sur les « défis et perspectives d'avenir » qui répète le texte | Terminez sur le dernier point concret ou sur la prochaine étape |
| Restes d'assistant | Formules de politesse en haut, propositions de réviser en bas, marqueurs entre crochets oubliés dans le texte | Supprimez-les tous, puis cherchez les crochets |
Deux remarques sur l'usage de cette liste. D'abord, elle existe pour aider les éditeurs de Wikipédia à repérer du texte IA non déclaré, et ils mettent en garde contre le fait de prendre les signes pour le problème. Leurs mots : « Ne traitez pas simplement ces signes comme des problèmes à corriger ; cela pourrait seulement rendre la détection plus difficile. » Nous utilisons la liste comme une aide à la retouche, pour trouver les phrases où il n'y a rien. L'emphase signifie en général qu'il n'y avait rien à dire : la solution est un fait, pas un meilleur mot.
Ensuite, la page tient une liste d'« indicateurs inefficaces » : une grammaire parfaite, un mélange de registres soutenu et familier, un contenu sans source se retrouvent aussi dans l'écriture humaine. Corrigez ce que votre fiche dit que vous faites autrement, et gardez vos particularités.
Lisez le brouillon à voix haute une fois et marquez chaque accroc. Passez ensuite le tableau en revue. Puis demandez-vous quel fait, quel nom ou quel chiffre porte chaque phrase restante. Si elle n'en porte aucun, coupez.
Trois choses que le modèle ne doit pas gérer
Une fiche de style couvre la formulation, et il est tentant de laisser le modèle s'aventurer sur un terrain qu'il ne connaît pas. Nous tracerions une ligne nette sur trois points.
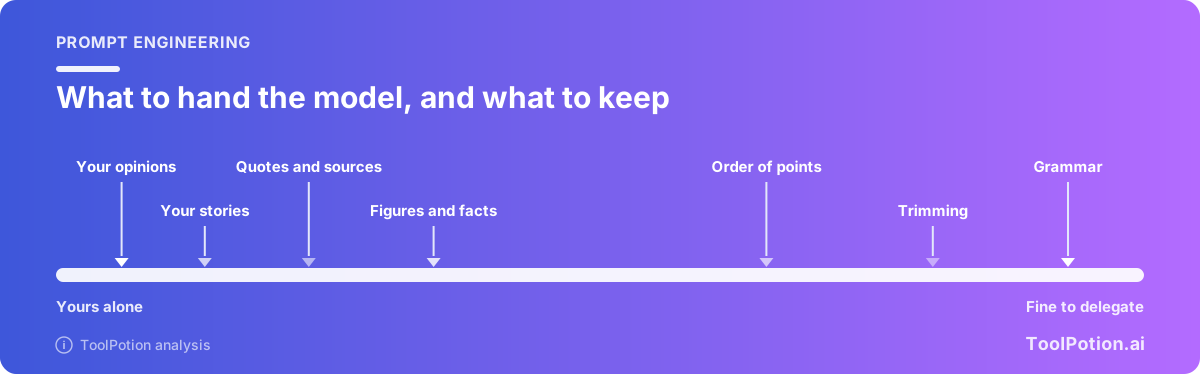
Les opinions que vous n'avez pas. Si vous demandez une position tranchée, un modèle en écrira une avec aplomb, dans votre voix, ce qui est pire qu'une position fade. Si vous n'avez pas tranché, écrivez « je n'ai pas encore décidé ».
Les anecdotes qui n'ont pas eu lieu. « Un client me disait récemment » est une affirmation sur le monde. Si elle est inventée, vous avez menti à la première personne, et les modèles écrivent ce genre de phrase très facilement.
Les citations que personne n'a prononcées, et les sources qui n'existent pas. La page Wikipédia documente des listes de références qui sonnent juste et ne mènent nulle part, dont une modification où « la référence ajoutée pour cette phrase n'existait pas ». Chaque chiffre, citation et lien d'un brouillon, c'est à vous de le vérifier, quel que soit celui qui l'a tapé.
Le modèle est utile pour le reste : questionner vos notes, trouver l'ordre, élaguer, et proposer des façons d'ouvrir un paragraphe pour que vous voliez celle que vous auriez écrite.
Questions fréquentes
Cela fera-t-il passer mon texte à travers les détecteurs d'IA ?
Ce n'est pas fait pour ça et nous ne le promettrons pas. Les éditeurs de Wikipédia disent que des détecteurs comme GPTZero et Pangram « font mieux que le hasard » mais ont des « taux d'erreur non négligeables », et qu'un score élevé ne prouve rien à lui seul. Un score propre ne prouve rien non plus. Si une école ou un employeur interdit l'aide de l'IA, la réponse est de respecter la règle.
Dois-je dire que j'ai utilisé l'IA ?
Suivez les règles de l'endroit où le texte va être publié ou envoyé. Beaucoup d'entreprises ne voient pas d'inconvénient à un e-mail rédigé avec l'aide de l'IA, alors que des revues, des cours et certains clients, si. En cas de doute, demandez.
La fiche fonctionnera-t-elle encore quand le modèle changera ?
Les règles portant sur la forme survivent généralement, celles portant sur les mots vieillissent vite. La page Wikipédia recense des mots favoris différents pour chaque génération de modèles : relisez donc votre ligne « n'écrit jamais » tous les quelques mois et comparez-la à un brouillon par défaut tout neuf.
Puis-je coller un travail client dans un outil de style ?
Vérifiez d'abord les conditions d'utilisation des données de l'éditeur. La page d'OpenAI indique par exemple que les informations issues de votre usage des instructions personnalisées peuvent servir à améliorer les performances du modèle, sauf opposition de votre part. Dans tous les cas, retirez les noms et les détails confidentiels de vos échantillons.