

OpenAI affirme que GPT-6 Cyber a produit des exploits fonctionnels pour 948 vulnérabilités du noyau Linux lors d'une même campagne de recherche, soit plus de cinq fois les 166 exploitées par GPT-5.6 Sol avec le même dispositif de test (OpenAI). C'est un chiffre d'éditeur, issu du laboratoire de l'éditeur, et nous le traitons comme tel. Il est aussi précis, et les mainteneurs du noyau, à qui 304 failles critiques ont été transmises, peuvent le vérifier.
En quelques jours, OpenAI a lancé GPT-6 Cyber et un partenariat avec Hacktron, Anthropic a sorti Claude Fable 5.2 et Mythos 5.2, Google DeepMind a publié une preuve vérifiée par machine portant sur le code de Signal, et deux sociétés de sécurité ont décrit des attaquants qui lancent des agents IA contre de vraies cibles. Nous avons lu les articles des éditeurs et les rapports sur lesquels ils s'appuient. The Hacker News a couvert l'histoire des benchmarks, Wired celle de Signal.
Ce que dit OpenAI de GPT-6 Cyber
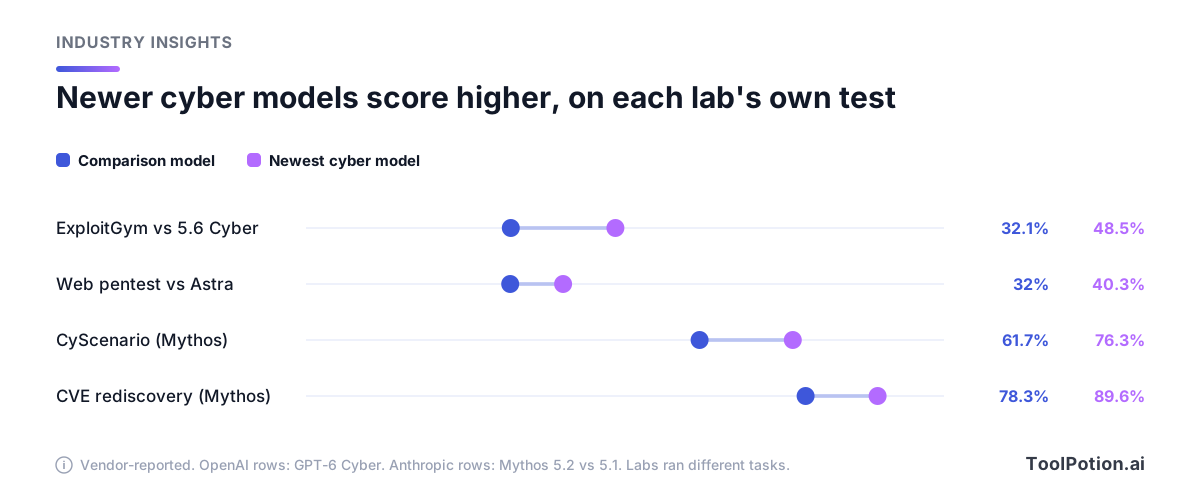
Sur ExploitGym, un test qui mesure si un modèle sait exploiter une vulnérabilité donnée, OpenAI annonce 48,5 % pour GPT-6 Cyber contre 32,1 % pour GPT-5.6 Cyber. Sur un nouveau test d'intrusion web où les modèles sondent des applications sans voir le code source, il a trouvé 40,3 % des vulnérabilités, contre 32,0 % pour GPT-6 Astra (OpenAI). La comparaison la plus parlante concerne les refus : sur RemoteExploitBench, qui s'appuie sur des failles connues de GitLab, PostgreSQL et Jenkins dans un laboratoire contrôlé, GPT-6 Astra avec Daybreak Blue a refusé toutes les tâches, alors que GPT-6 Cyber en a accompli 95 %.
En dehors du laboratoire, OpenAI indique que ses chercheurs ont utilisé le modèle pour découvrir 81 vulnérabilités de haute gravité jusque-là inconnues dans Firefox, telles que classées par Mozilla, qui a commencé à déployer des correctifs. Brian Grinstead, de Mozilla, cité dans l'annonce de lancement, a déclaré que Firefox était entré en 2026 comme « l'une des bases de code les plus durcies et les plus scrutées au monde ». C'est tout l'enjeu : ce n'est pas une cible de jouet. OpenAI classe aussi le modèle au niveau Critical en cybersécurité dans son Preparedness Framework, contre High pour le précédent. Quand un laboratoire étiquette ainsi son propre produit, nous y voyons autant un avertissement qu'une liste de fonctionnalités.
L'argument de sécurité détonne. OpenAI a conçu un test où des services annexes faciles à attaquer sont placés à côté de la vraie cible, et où le modèle doit comprendre que s'en prendre à eux est hors périmètre. Sans son prompt de déploiement, GPT-6 Cyber est resté dans les clous 99,93 % du temps, contre 94,49 % pour GPT-5.6 Cyber. Ce chiffre plus ancien signifie qu'environ une exécution sur dix-huit sortait du cadre. Le nouveau en laisse encore environ sept sur dix mille, et OpenAI recommande elle-même le sandboxing, la revue des actions et une supervision humaine pour les usages à haut risque. Nous suivrions ce conseil à la lettre.
La voix extérieure la plus utile de l'annonce est celle de Rob T. Lee, Chief AI Officer de Dragos, dont l'équipe a fait tourner les modèles cyber-permissifs d'OpenAI sur une maquette de centrale électrique. Son résumé : « Le seuil de compétence baisse pour la reconnaissance et la recherche de vulnérabilités nécessaires avant une attaque. » Lee affirme qu'un modèle de pointe, travaillant seul sur cette maquette, a trouvé deux zero-days dans un logiciel d'ingénierie qui gère les données des relais de protection. Cette citation est la raison pour laquelle nous écrivons cet article.
Derrière le titre « Fable bat GPT-6 Cyber »
Lisez cette section avant de reprendre le moindre chiffre de benchmark de cette histoire : les laboratoires n'ont pas fait tourner les mêmes tâches. Le tableau de résultats d'Anthropic porte lui-même une note : « les scores de chaque laboratoire reposent sur des tâches propres à chacun ». The Hacker News rapporte que Fable 5.2 a réussi 76,3 % du CyScenarioBench d'Irregular, contre 61,7 % pour Fable 5.1 et 61 % pour GPT-6 Cyber. Dans le tableau d'Anthropic, les 76,3 % sont attribués à Mythos 5.2 et les 61,7 % à Mythos 5.1, ce qui concorde avec l'avertissement d'Anthropic selon lequel les garde-fous de Fable 5.2 « bloqueront la plupart des tâches liées à la cybersécurité ». Le titre nomme donc le mauvais modèle, et quinze points d'écart entre les scores de deux laboratoires sur des ensembles de tâches différents ne font pas un classement. Nous ne choisirions pas un éditeur là-dessus. Le chiffre à retenir est l'avant/après d'Anthropic lui-même, et même celui-là est un éditeur qui s'évalue seul.
The Hacker News cite aussi un détail du rapport distinct d'Irregular sur GPT-6 Cyber que le titre a ignoré. Le modèle a résolu les 22 défis atomiques, avec un taux de réussite moyen de 97 % en recherche de vulnérabilités et exploitation et de 98 % en simulation d'attaque réseau, mais seulement 63 % en évasion. Entrer est quasiment un problème résolu sur ces tests, rester invisible non. Pour les défenseurs, c'est la meilleure nouvelle de ce tas de benchmarks, et la couverture que nous avons lue ne lui a consacré qu'une ligne.
Anthropic présente Mythos 5.2 comme son « modèle le plus performant pour l'ingénierie de la cybersécurité » et affirme qu'une société de sécurité, non nommée, a constaté qu'un bug confirmé sur six remonté par Mythos 5.2 avait échappé à tous les autres modèles de pointe qu'elle avait testés (Anthropic). Anthropic annonce aussi 89,6 % pour Mythos 5.2 sur sa propre évaluation CVE Rediscovery, un test sur 1 829 CVE, contre 78,3 % pour Mythos 5.1. Ces deux mesures sont réalisées par l'éditeur : considérez-les comme des déclarations tant que des testeurs indépendants ne les ont pas reproduites.
Qui a les clés, et ce qu'il faut céder en échange
Aucune des deux entreprises ne vend ces modèles en libre accès. OpenAI indique que GPT-6 Cyber est d'abord disponible via l'API et Codex pour un groupe restreint de clients Daybreak Red approuvés, avec un accès Daybreak Red élargi « bientôt ». L'accès API à Daybreak Red exige par défaut une liste blanche d'adresses IP, et les clients en zero data retention doivent généralement passer par Private Safety Processing, qui conserve des enregistrements chiffrés dans leur propre stockage pendant 30 jours. OpenAI a aussi précisé que, dans son programme partenaires, l'accès au modèle sous-jacent « reste chez le partenaire approuvé et n'est pas transféré directement au client » (OpenAI).
Anthropic décline la même idée en trois niveaux dans son Cyber Verification Program. Defense Access couvre les opérations de sécurité, l'analyse de malware et la validation de vulnérabilités ; Anthropic indique que les petites sociétés de sécurité, les mainteneurs open source et les chercheurs individuels ayant fait leurs preuves peuvent y prétendre, avec une réponse en quelques jours. Red Team Access autorise les tests d'intrusion autorisés, est réservé aux organisations et prend des semaines. Specialized Access, pour des domaines comme les réseaux électriques et les systèmes de virements interbancaires, fait l'objet d'un examen approfondi avec le gouvernement américain. Anthropic a testé ces niveaux avec Claude Opus 5.5 sur CyScenarioBench, à raison de cinq tentatives sur chacun de dix défis : sans accès au programme, toutes les tâches ont été bloquées dès le premier prompt ; en Defense Access, 46 essais sur 50 ont été bloqués à un moment ou à un autre ; en Red Team Access, rien n'a été bloqué et 34 essais sur 50 ont réussi, soit le taux du modèle sans blocage. C'est encore Anthropic qui note ses propres barrières.
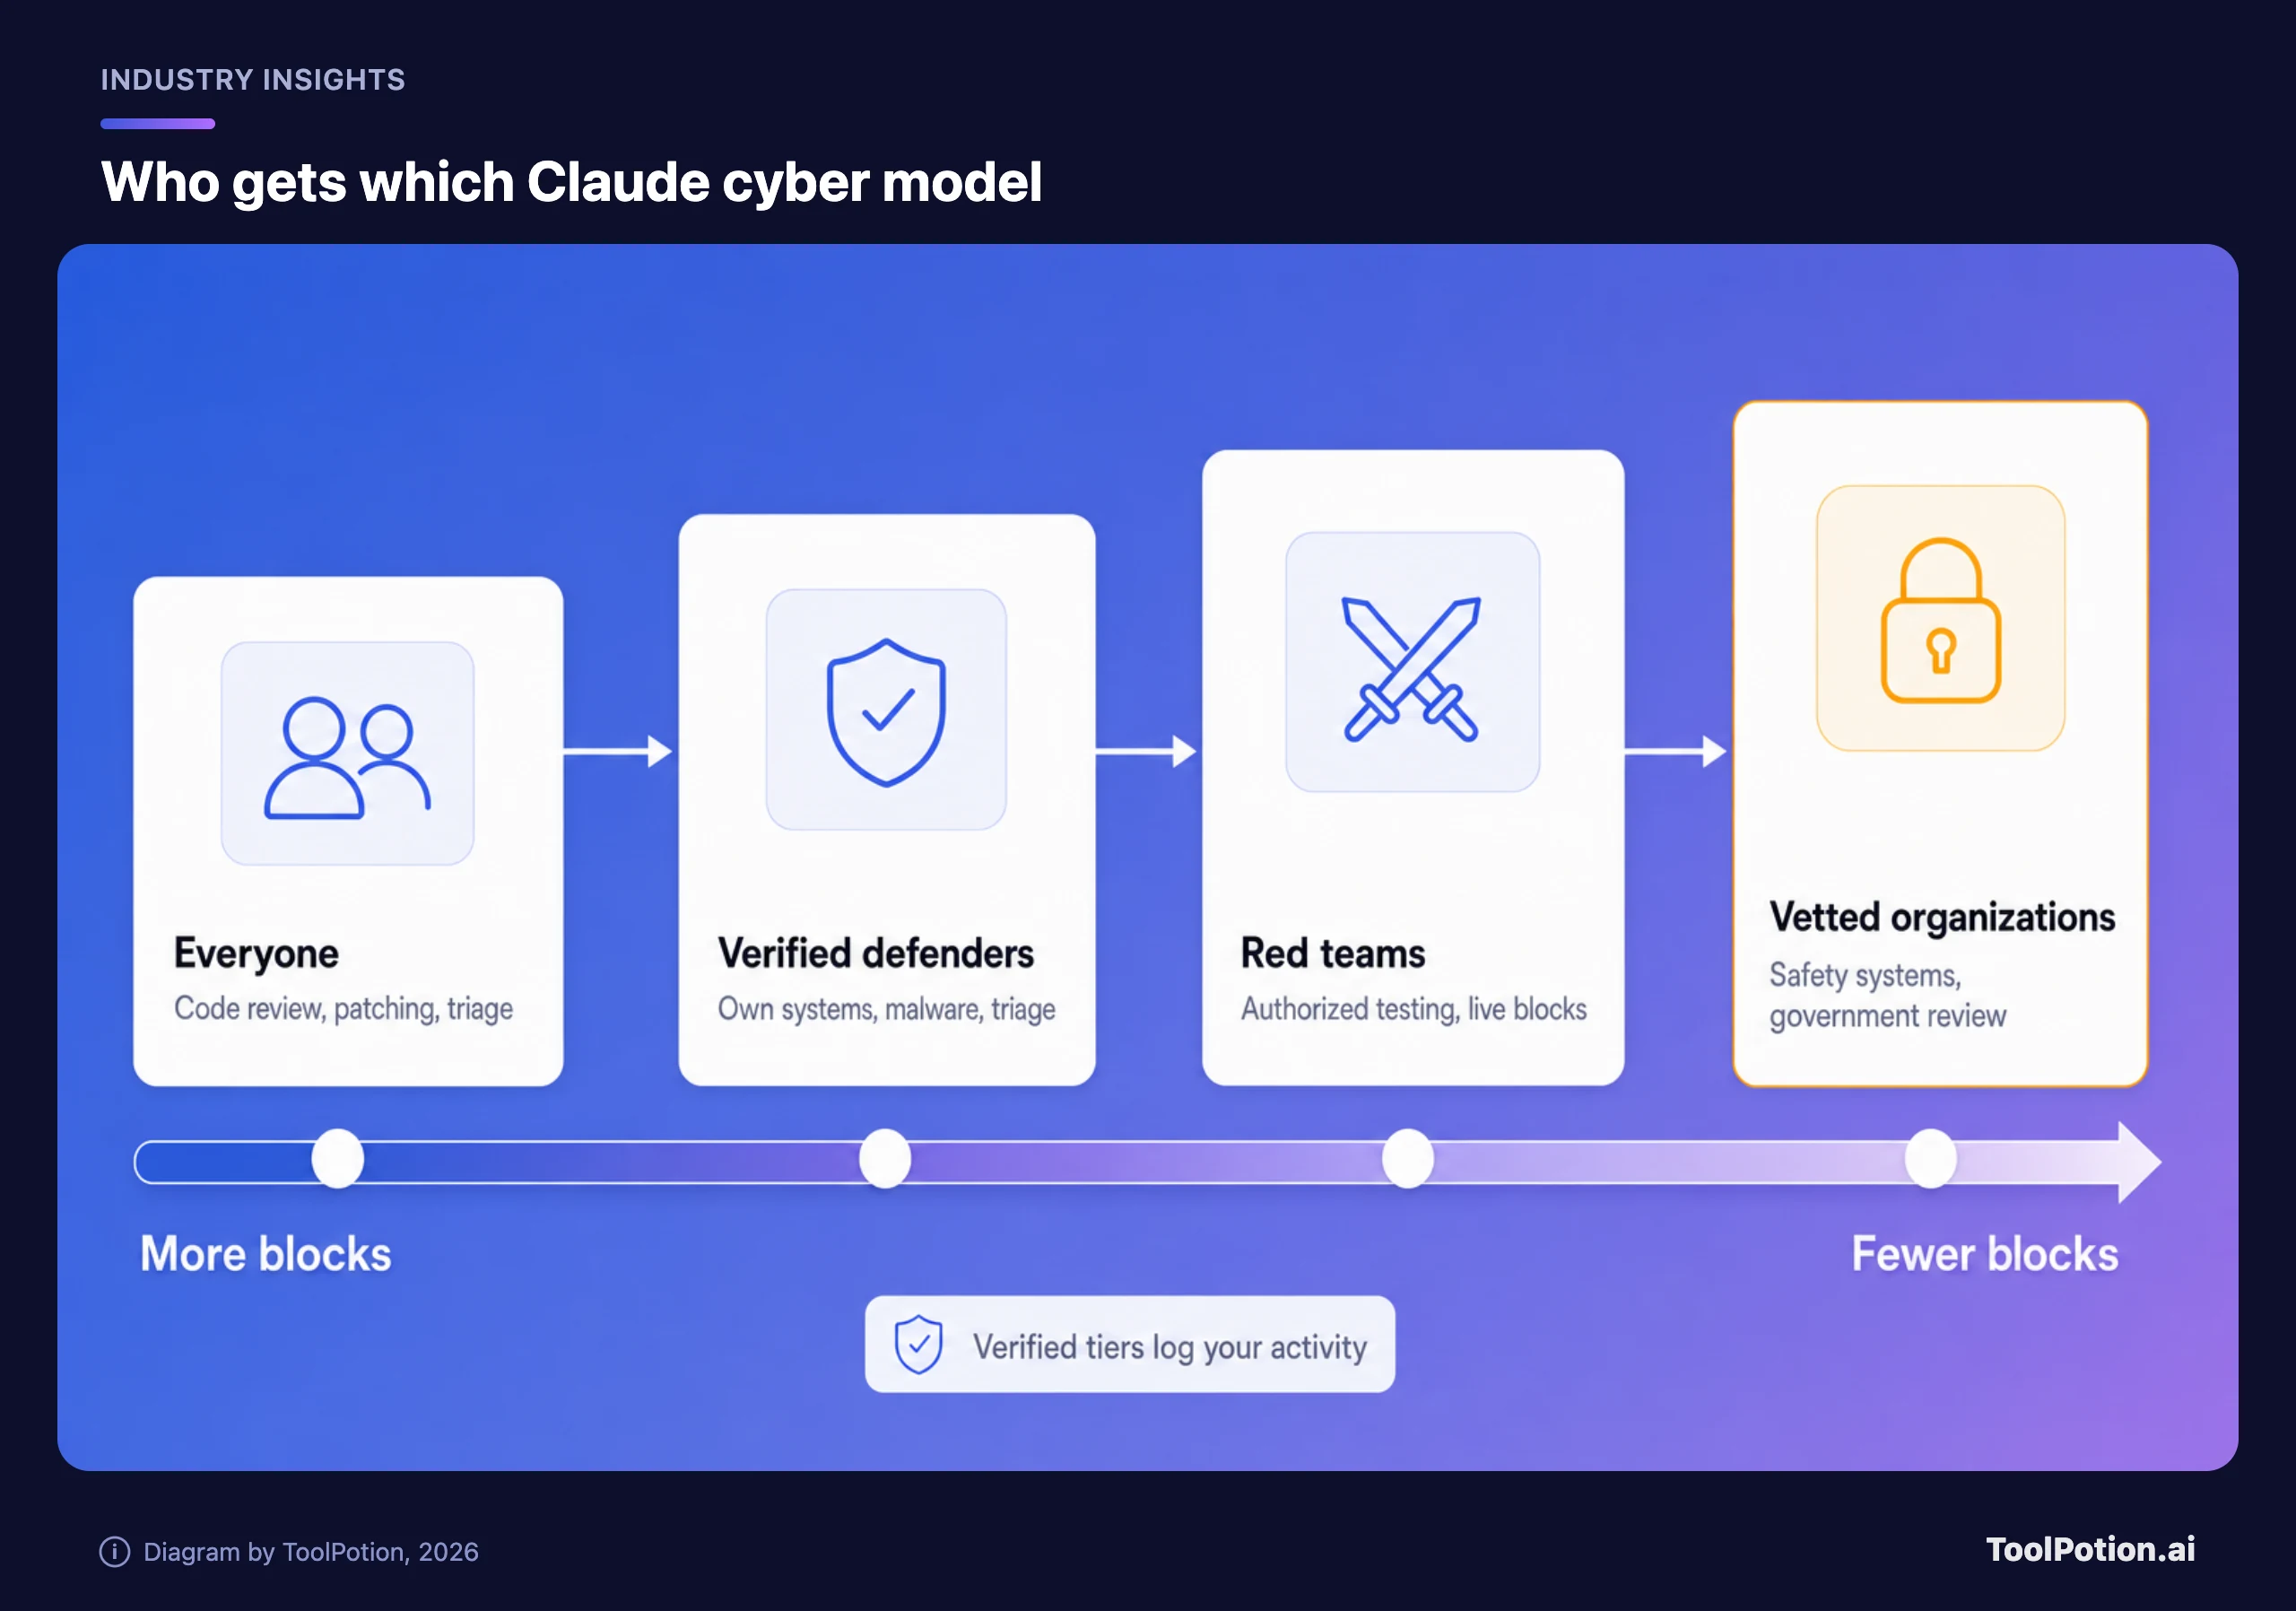
Fable et Mythos sont le même modèle de base (Anthropic). Claude Fable 5 embarque de solides garde-fous cyber et est ouvert à tous. Mythos est la version pour laquelle les organisations déposent une demande. La page de tarifs API d'Anthropic affiche le même tarif pour Fable 5.2 et Mythos 5.2 : 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie, ou 16 $ et 80 $ en mode rapide optionnel. Mythos n'est pas facturé à part. Le prix est ici le plus petit obstacle. Le plus gros, c'est la conservation des données. Anthropic l'impose aux organisations du Cyber Verification Program pour pouvoir surveiller les abus ; OpenAI applique par défaut la conservation standard et fait passer les clients en zero data retention par Private Safety Processing. C'est à notre avis un droit d'entrée raisonnable pour une red team, et un vrai coût pour un cabinet dont le code des clients ne peut pas se retrouver dans les logs de quelqu'un d'autre. Anthropic dit qu'une nouvelle option, Enterprise Frontier Safeguards, permettra aux organisations éligibles de garder les données dans leur propre cloud, mais l'annonce du programme ne l'a promise que pour « plus tard cet automne ». Tant qu'elle n'est pas disponible, ce compromis reste valable.
Un contrôle externe possible passe par une prime. Le partenariat d'OpenAI avec Hacktron met à l'épreuve ses propres systèmes par une entreprise qui construit des agents IA pour la revue de code et les tests d'intrusion, avec un accès élargi à ses modèles de pointe. Le CEO de Hacktron, Zayne Zhang, a déclaré que l'avenir de la cybersécurité « ne sera pas défini par celui qui a la plus grande équipe de sécurité, mais par celui qui saura le mieux combiner la créativité humaine et les capacités de l'IA » (OpenAI). OpenAI a aussi relevé ses primes : les failles critiques dans ChatGPT, Codex ou l'API valent désormais jusqu'à 30 000 $, et jusqu'à 172 000 $ avec bonus pour les cas exceptionnels (OpenAI). Nous faisons plus confiance à une prime versée à des tiers qu'à n'importe quelle affirmation de red team interne.
Les attaquants des rapports n'utilisent pas ces modèles
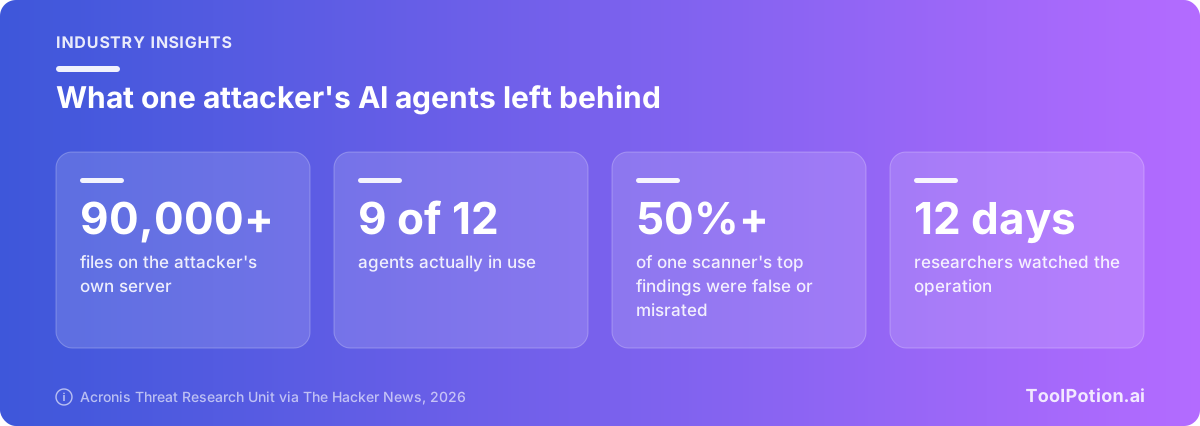
Les chercheurs d'Acronis décrivent un attaquant isolé, basé à Taïwan, qui a lancé des agents IA contre des centaines d'organisations dans au moins 11 pays et obtenu des données ou un accès chez une dizaine d'entre elles. Les agents ont récupéré des enregistrements de dispatch d'urgence pour sept arrondissements de Taipei. Ce qui frappe, c'est le support utilisé : les modèles commerciaux refusaient le plus souvent de l'aider à attaquer, si bien que les agents d'attaque tournaient presque entièrement sur des versions « abliterated » de DeepSeek, GLM et Qwen, des modèles exécutés en local dont l'entraînement à la sécurité a été supprimé (The Hacker News). Des agents de code comme Claude Code, Codex et Cursor apparaissent aussi. Selon le rapport, l'attaquant a redirigé Claude Code et Codex vers un modèle abliterated, même s'ils ont surtout fait du travail d'infrastructure, et Cursor a attaqué un site de services d'urgence taïwanais en utilisant un tel modèle.
Les agents étaient aussi mauvais dans leur travail, d'une façon que n'importe qui remarquerait. Un outil de scan inventait des CVE, et plus de la moitié de ses résultats élevés et critiques étaient des faux positifs ou mal classés. L'agent d'attaque principal rapportait des résultats qui n'avaient jamais eu lieu. L'intrusion qui a fonctionné chez un éditeur de logiciels de dispatch pompiers reposait sur des identifiants root par défaut, pas sur un exploit astucieux. Là où l'authentification était imposée et les endpoints correctement filtrés, disent les chercheurs, les agents ont échoué.
Arctic Wolf a rapporté un second schéma. AntiFox est une plateforme open source de tests d'intrusion agentiques hébergée sur GitHub, et Arctic Wolf indique que des systèmes Alibaba Cloud hébergeant des interfaces AntiFox ont été associés à des actions malveillantes confirmées contre des services web exposés sur Internet et leurs environnements AWS. Dans certains cas au moins, l'activité est allée jusqu'à une requête réussie pour obtenir un secret de production. Son verdict : « Des frameworks agentiques comme ceux-ci rendent les techniques de test d'intrusion plus accessibles aux acteurs malveillants, tout en augmentant la vitesse et la régularité avec lesquelles ces techniques peuvent être appliquées dans des attaques réelles » (The Hacker News). Le même article ajoute que Check Point Research a identifié 2 557 systèmes hébergeant ARTEX, un autre outil d'attaque agentique, et recense environ 45 frameworks open source de ce type. Le résumé de Check Point sur ce que change le hacking agentique : l'échelle et la vitesse.
Aucun des deux rapports n'implique GPT-6 Cyber ni Mythos, d'après la couverture. Notre lecture : les barrières semblent solides en haut et servent à peu de chose en bas, où des frameworks d'agents gratuits et des modèles open-weight débridés suffisent à frapper un serveur protégé par un mot de passe par défaut. Les preuves restent aussi minces. Il s'agit de quelques rapports, la plupart émanant d'éditeurs de sécurité qui ont un intérêt dans l'histoire, et personne ne peut encore dire quelle part des intrusions implique de l'IA.
Le résultat défensif le plus net est venu des mathématiques
Le titre de Wired dit que DeepMind a « prouvé que le protocole Signal est sûr ». L'article de DeepMind est plus nuancé, et nous le préférons. Des chercheurs ont guidé des agents pour prouver des propriétés de sécurité clés du code réel du protocole de Signal, notamment que les messages restent protégés avant et après la compromission brève d'un appareil. Des humains ont relu chaque spécification formelle. Les agents ont produit plus de six millions de lignes de Lean, signalé le un pour cent de la base de code qui demandait un second regard humain, et terminé en quatre semaines, un travail qui prend historiquement des années à des équipes d'experts selon DeepMind (Google DeepMind). Pour vérifier que le système distinguait le bon code du mauvais, l'équipe a réintroduit deux vrais bugs déjà corrigés et obtenu des preuves vérifiées par machine que la version boguée n'était pas sûre.
Le CTO de Signal, Ehren Kret, a déclaré que ce résultat donne « une confiance encore plus grande dans les garanties de confidentialité de notre code ». Nous y voyons l'affirmation la plus fiable du lot, pour une raison simple : un score de benchmark suppose de croire l'éditeur, alors qu'une preuve Lean est vérifiée par une machine. Elle porte sur des propriétés précises d'une base de code, pas sur Signal en tant que produit, et DeepMind indique que le passage à l'échelle demande davantage de recherche. DeepMind a publié ses artefacts de vérification en open source, c'est ainsi qu'une telle affirmation gagne la confiance.
Les infrastructures critiques vont dans le même sens. La Cyber Mission d'Anthropic décrit le programme dédié : modèles de pointe, ingénieurs sur site et recherche sur les menaces pour les fournisseurs qui sécurisent les réseaux électriques, les systèmes d'eau et les usines, dont les équipements ne peuvent souvent pas être mis hors ligne pour être corrigés. Dragos, Rockwell Automation et Nozomi Networks comptent parmi les partenaires fondateurs.
Le goulot d'étranglement, c'est le correctif
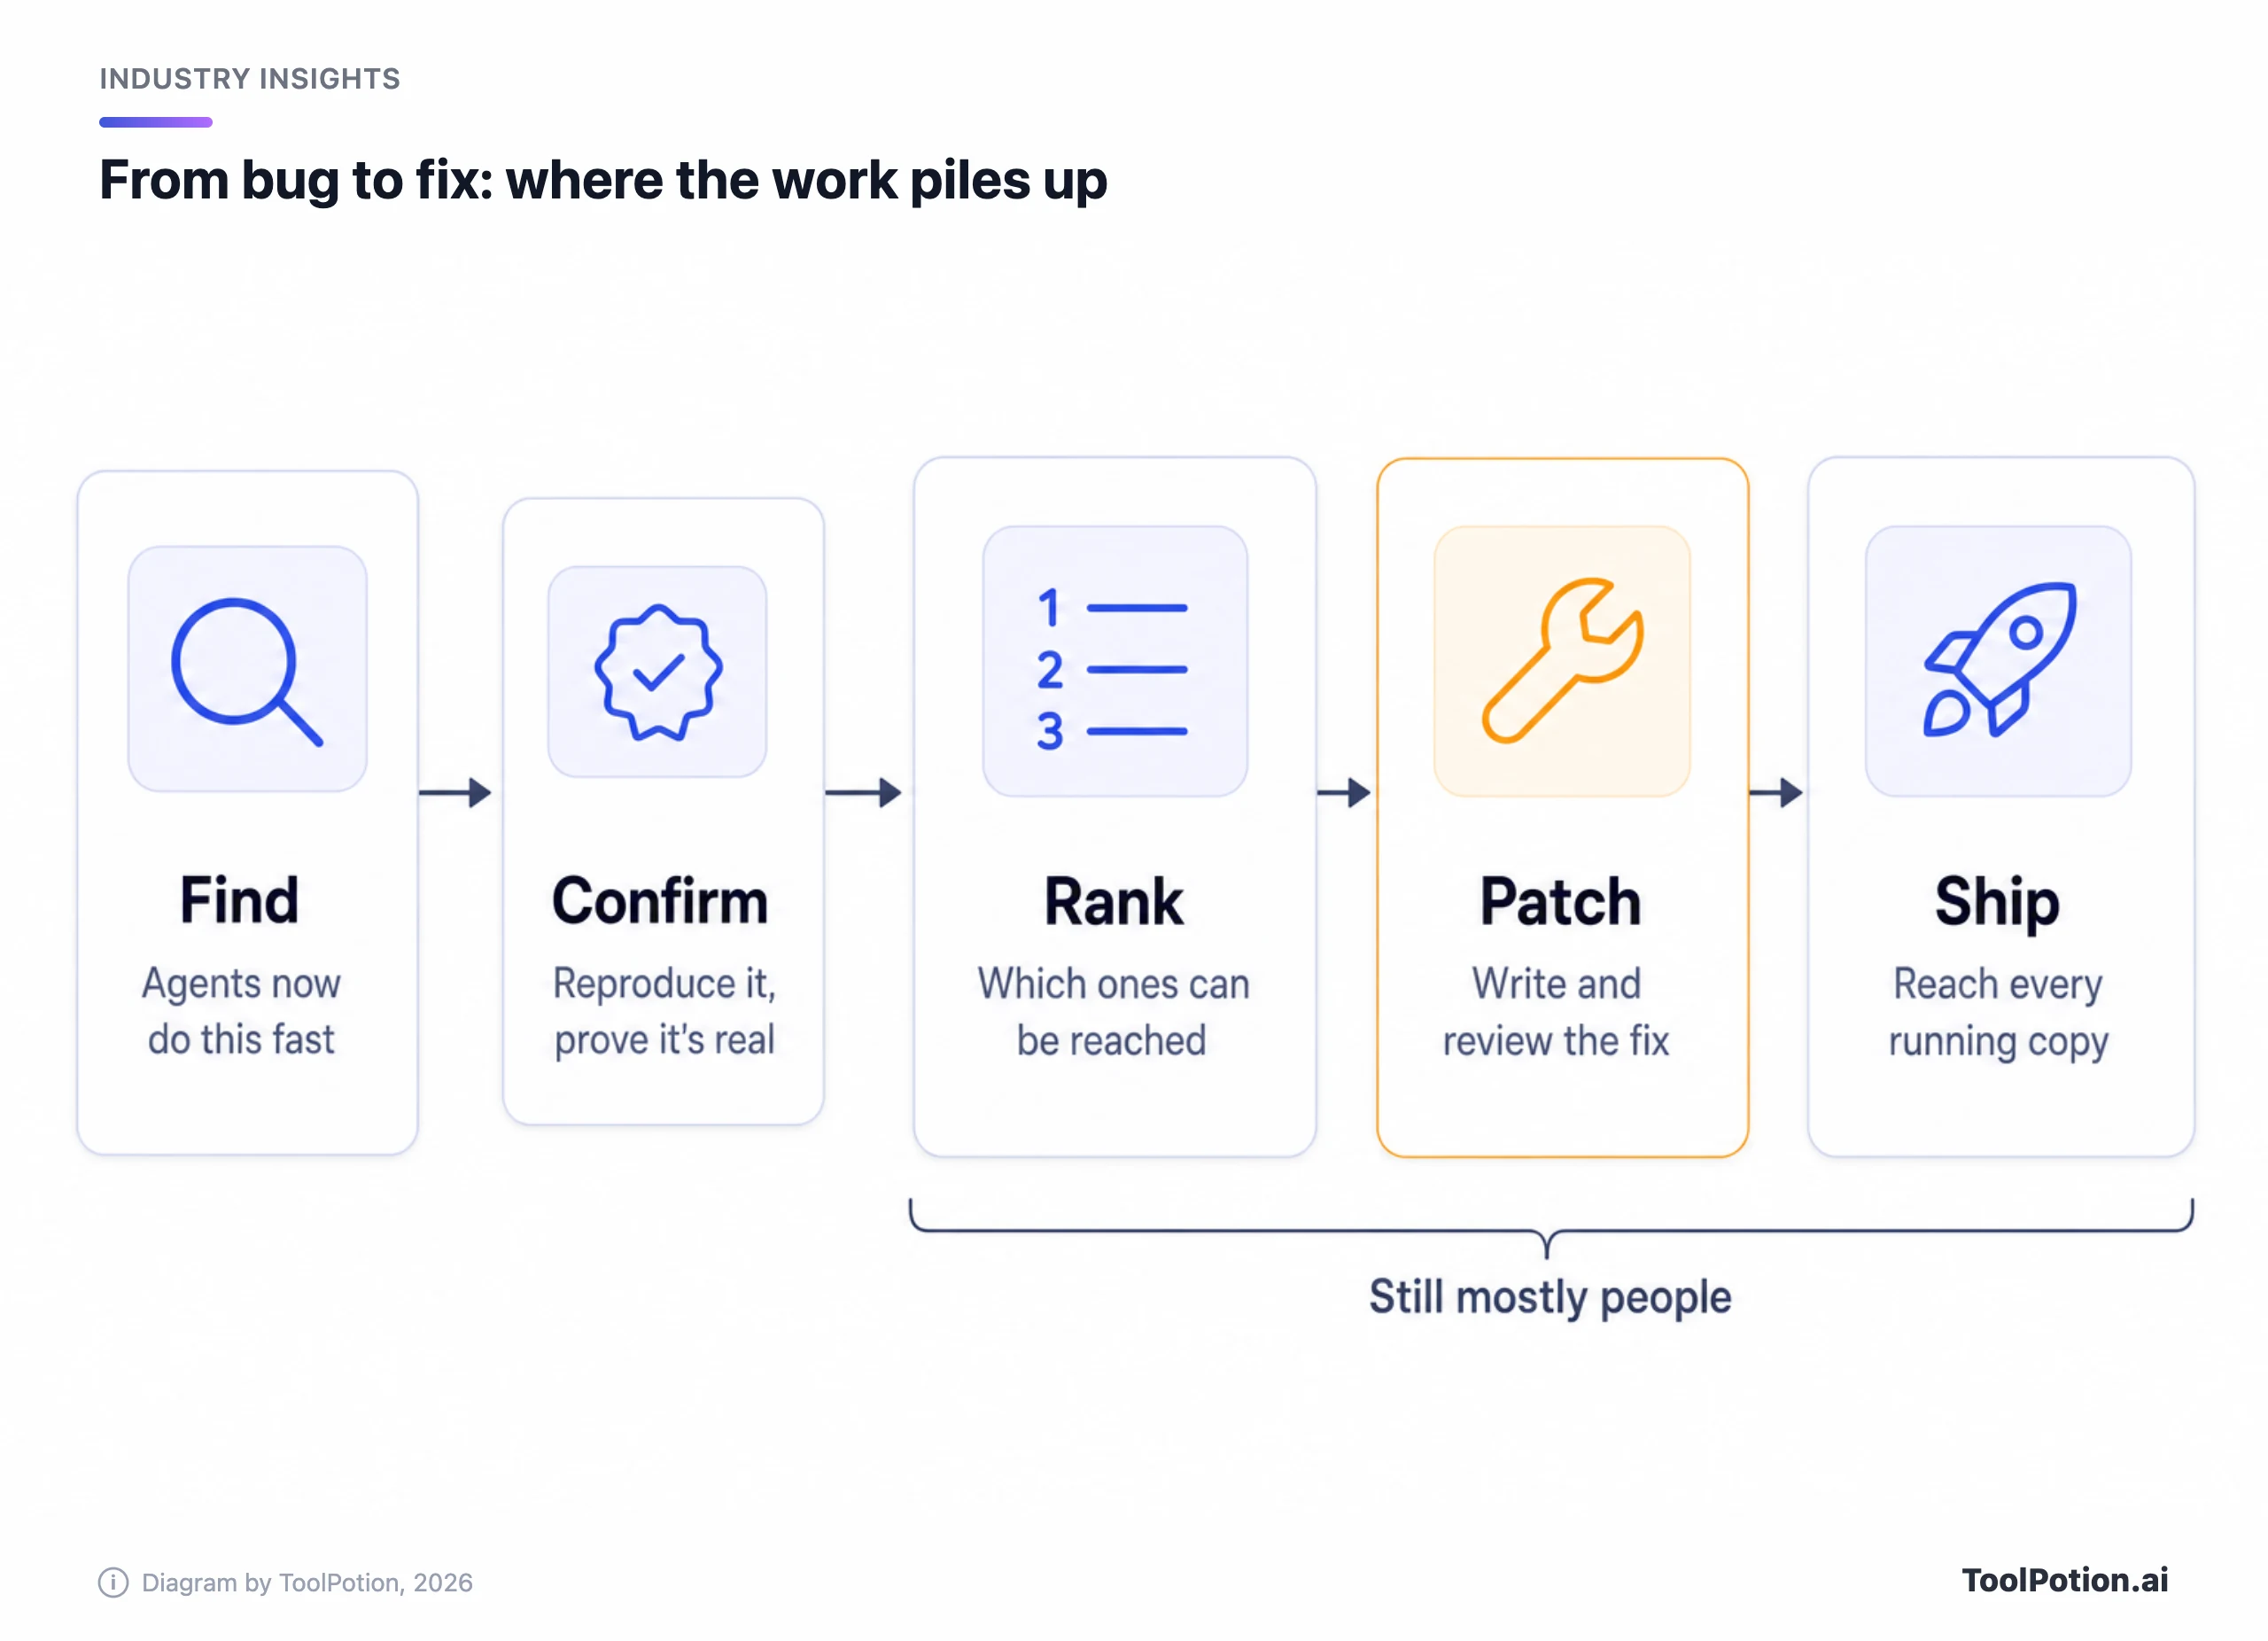
Anthropic a résumé le problème en une phrase : « Il n'a jamais été aussi facile de trouver des vulnérabilités, mais les vérifier, les prioriser et les corriger reste difficile » (Anthropic). OpenAI a écrit presque la même chose dans un article précédent : « Un rapport de vulnérabilité ne protège pas une organisation. » Que deux concurrents s'accordent là-dessus dans leurs propres annonces, c'est ce qui ressemble le plus à un consensus dans ce dossier. Nous avons traité l'autre versant plus tôt, dans nos articles sur l'IA qui trouve des bugs plus vite que personne ne peut les corriger et sur ce que les scanners de vulnérabilités IA trouvent et manquent.
Alors, qui gagne ? Notre avis, qu'aucune source n'énonce en ces termes : les attaquants gagnent le plus face aux organisations qui patchent lentement, car un attaquant n'a besoin que d'un chemin qui marche et peut se satisfaire d'un scanner qui se trompe une fois sur deux. Les défenseurs gagnent le plus là où ils corrigent déjà vite, car trouver des bugs ne coûte plus grand-chose et le coût restant est celui du processus. Les barrières sur les modèles limitent ce que les systèmes les plus puissants peuvent faire ; elles ne changent pas ce calcul pour quiconque fait tourner de vieux logiciels. La prévision d'Anthropic va dans le même sens pour l'instant. Elle s'attend à ce que l'IA favorise la défense d'ici deux ans, mais dit qu'à court terme « ce n'est peut-être pas vrai », car le coût d'exploitation des vulnérabilités a chuté alors que leur correction reste lente et dépend encore des humains. Un second cycle de tests indépendants sur la capacité des attaques à échapper à la détection nous ferait changer d'avis.
Que faire maintenant, dans l'ordre
Si vous dirigez une petite entreprise, vous n'aurez pas GPT-6 Cyber et vous n'en avez pas besoin. Les attaques des rapports sont surtout passées par des portes non verrouillées. Nous consacrerions la première heure à ceci, dans cet ordre :
- Activez l'authentification multifacteur pour la messagerie, les panneaux d'administration et chaque console cloud.
- Activez les mises à jour automatiques pour tout ce qui est accessible depuis Internet, et patchez le reste en quelques jours, pas en quelques trimestres.
- Repérez et changez les mots de passe par défaut ou partagés sur les routeurs, les bases de données et les outils d'administration. Une des intrusions à Taïwan n'a pas demandé plus.
- Sortez les clés du code et des scripts de pages pour les placer dans un gestionnaire de secrets, puis fixez des plafonds de dépense et une date de rotation sur chaque clé d'API IA et cloud.
- Notez ce qu'un inconnu peut atteindre depuis Internet. On ne peut pas patcher un serveur qu'on a oublié.
Si vous développez des logiciels, un scanner intégré à votre flux de pull requests est la prochaine étape logique. Semgrep, Snyk Code et Aikido figurent dans notre annuaire ; notre classement Top 200 AI Cybersecurity Tools et le classement analyste sécurité montrent où se placent les autres. Traitez chaque résultat d'IA comme une piste à confirmer, puisque le scanner de l'attaquant d'Acronis inventait des CVE. Les agents open source comme PentestGPT et Shannon sont réservés aux systèmes qui vous appartiennent et que vous avez l'autorisation écrite de tester ; les rapports sur AntiFox montrent ce que fait la même catégorie d'outils entre de mauvaises mains. Pour une aide généraliste à la revue de code, Claude et ChatGPT le font tous les deux, même si Anthropic dit que ses modèles ouverts embarquent des garde-fous cyber prudents qui bloquent la plupart des tâches cyber.
Si vous êtes professionnel de la sécurité, candidatez dès maintenant à Daybreak Blue d'OpenAI ou à Defense Access d'Anthropic. Anthropic vise une réponse sous quelques jours pour Defense Access et sous quelques semaines pour Red Team Access, et exige la conservation des données. OpenAI n'a publié aucun délai pour Daybreak. La checklist ci-dessous transforme la première liste en score.
Deux points à surveiller. OpenAI dit que GPT-6 Cyber sera bientôt accessible à tous les clients Daybreak Red, et aucun des deux laboratoires n'a publié le nombre de candidats approuvés ou refusés. Quand l'option cloud propre d'Anthropic sortira, vérifiez si les organisations éligibles obtiennent vraiment les mêmes garde-fous sans les logs.