

Anthropic a lancé cette semaine un scanner de sécurité IA gratuit, sur inscription, destiné aux projets open source, et il arrive à un moment confus. L'IA peut désormais trouver de vrais bugs dans du code que des humains auditent depuis des années. Elle peut aussi ensevelir un mainteneur bénévole sous de faux rapports. Les deux sont vrais en même temps, et une petite équipe doit décider quoi en faire.
Le nouveau service, baptisé OSS Scanner, lance des analyses de vulnérabilités périodiques sur les projets inscrits avec les modèles les plus puissants d'Anthropic. Chaque rapport comprend un reproducteur, une explication et, quand c'est possible, un correctif candidat (Anthropic). Il s'ajoute à une foule d'initiatives similaires de Google, OpenAI, GitHub, Snyk et Semgrep, ainsi qu'à une pile grandissante de rapports IA de mauvaise qualité qui a poussé certains mainteneurs à fermer la porte.
Cet article fait le tri : ce que font ces outils, lesquels ne coûtent rien, comment vous inscrire sans vous tirer une balle dans le pied, et un workflow qu'une équipe de deux personnes peut tenir. En résumé : les scanners IA sont désormais assez bons pour être pris au sérieux, et personne ne devrait fusionner leur production sans la relire.
Ce que fait l'OSS Scanner d'Anthropic
Les mainteneurs principaux s'inscrivent en ouvrant une pull request sur un dépôt GitHub, en suivant un modèle. Anthropic tranche au cas par cas, avec des critères proches de ceux d'OSS-Fuzz de Google : un projet doit avoir un « impact critique sur l'infrastructure et la sécurité des utilisateurs » (Anthropic). Ce n'est donc pas pour n'importe quel dépôt de loisir. Pensez à curl et wolfSSL, ces bibliothèques dont dépend la moitié d'internet.
C'est gratuit. Une enveloppe qu'Anthropic appelle le Defender Advantage Fund finance les analyses (SiliconANGLE), et l'entreprise affirme que la participation reste sans frais pour les projets inscrits.
Le plus important, c'est ce qui manque. Les rapports sont « entièrement générés par le modèle, sans relecture ni tri humain », et Anthropic dit clairement que certains seront faux (Anthropic). Un exemple donné : une mauvaise évaluation de la gravité. Les projets qui n'ont pas les effectifs pour trier les rapports peuvent continuer à utiliser le processus de divulgation existant d'Anthropic, où des humains vérifient d'abord (SiliconANGLE).
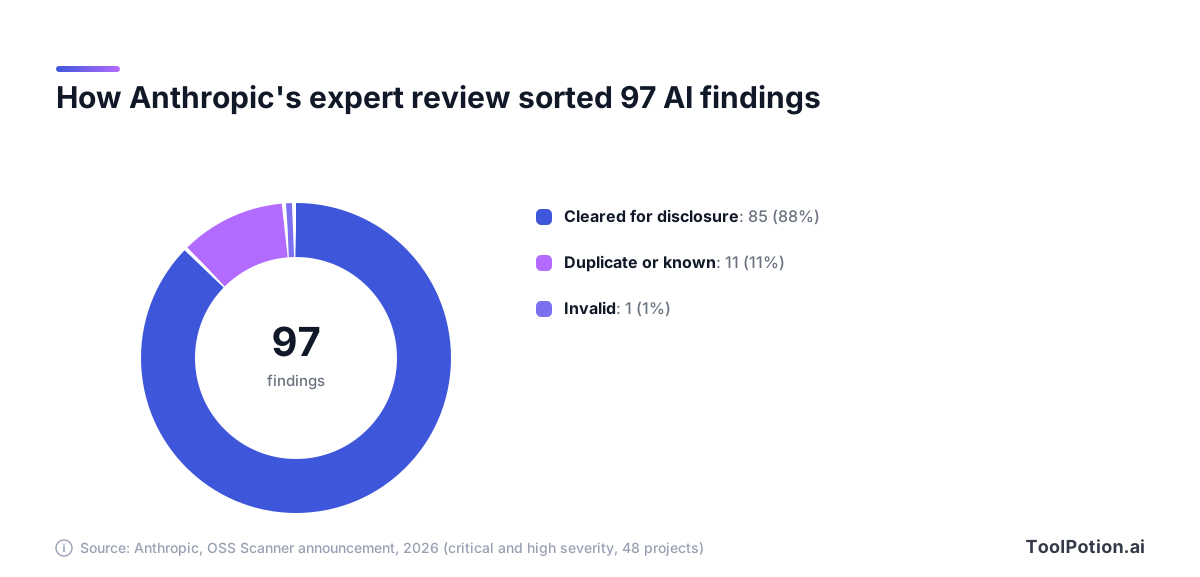
Les chiffres d'Anthropic expliquent pourquoi l'entreprise juge le compromis rentable. Des pentesteurs experts ont examiné 97 résultats de gravité critique ou élevée dans 48 projets. Parmi eux, 85 remplissaient les conditions d'une divulgation coordonnée, 11 étaient des doublons ou des failles réelles mais déjà connues, et un était invalide (Anthropic). Par ailleurs, wolfSSL indique que 72 des 74 rapports d'un essai préliminaire étaient valides, et qu'ils ont donné lieu à cinq CVE (SiliconANGLE).
Daniel Stenberg, qui dirige curl, a déclaré que le scanner avait trouvé « l'une des pires vulnérabilités de curl signalées ces dernières années » (Anthropic). Gardez en tête que tous ces chiffres viennent d'Anthropic ou de ses partenaires. L'entreprise dit aussi s'attendre à un taux de vrais positifs supérieur à 90 % (Anthropic), ce qui est une prévision, pas une garantie pour votre dépôt.
Ce que fait vraiment un scanner IA : trouver, prouver, corriger
L'analyse statique à l'ancienne compare le code à des règles. Elle est rapide, prévisible, et vous inonde d'avertissements. Les scanners agentiques plus récents ressemblent davantage à un chercheur en sécurité junior : ils lisent le code, formulent une hypothèse sur l'endroit où il casse, essaient de déclencher la faille, et ne rédigent le rapport qu'ensuite.
C'est cette étape intermédiaire qu'il faut chercher. Un résultat accompagné d'un exploit fonctionnel n'a rien à voir avec un résultat accompagné d'un paragraphe de prose assurée.
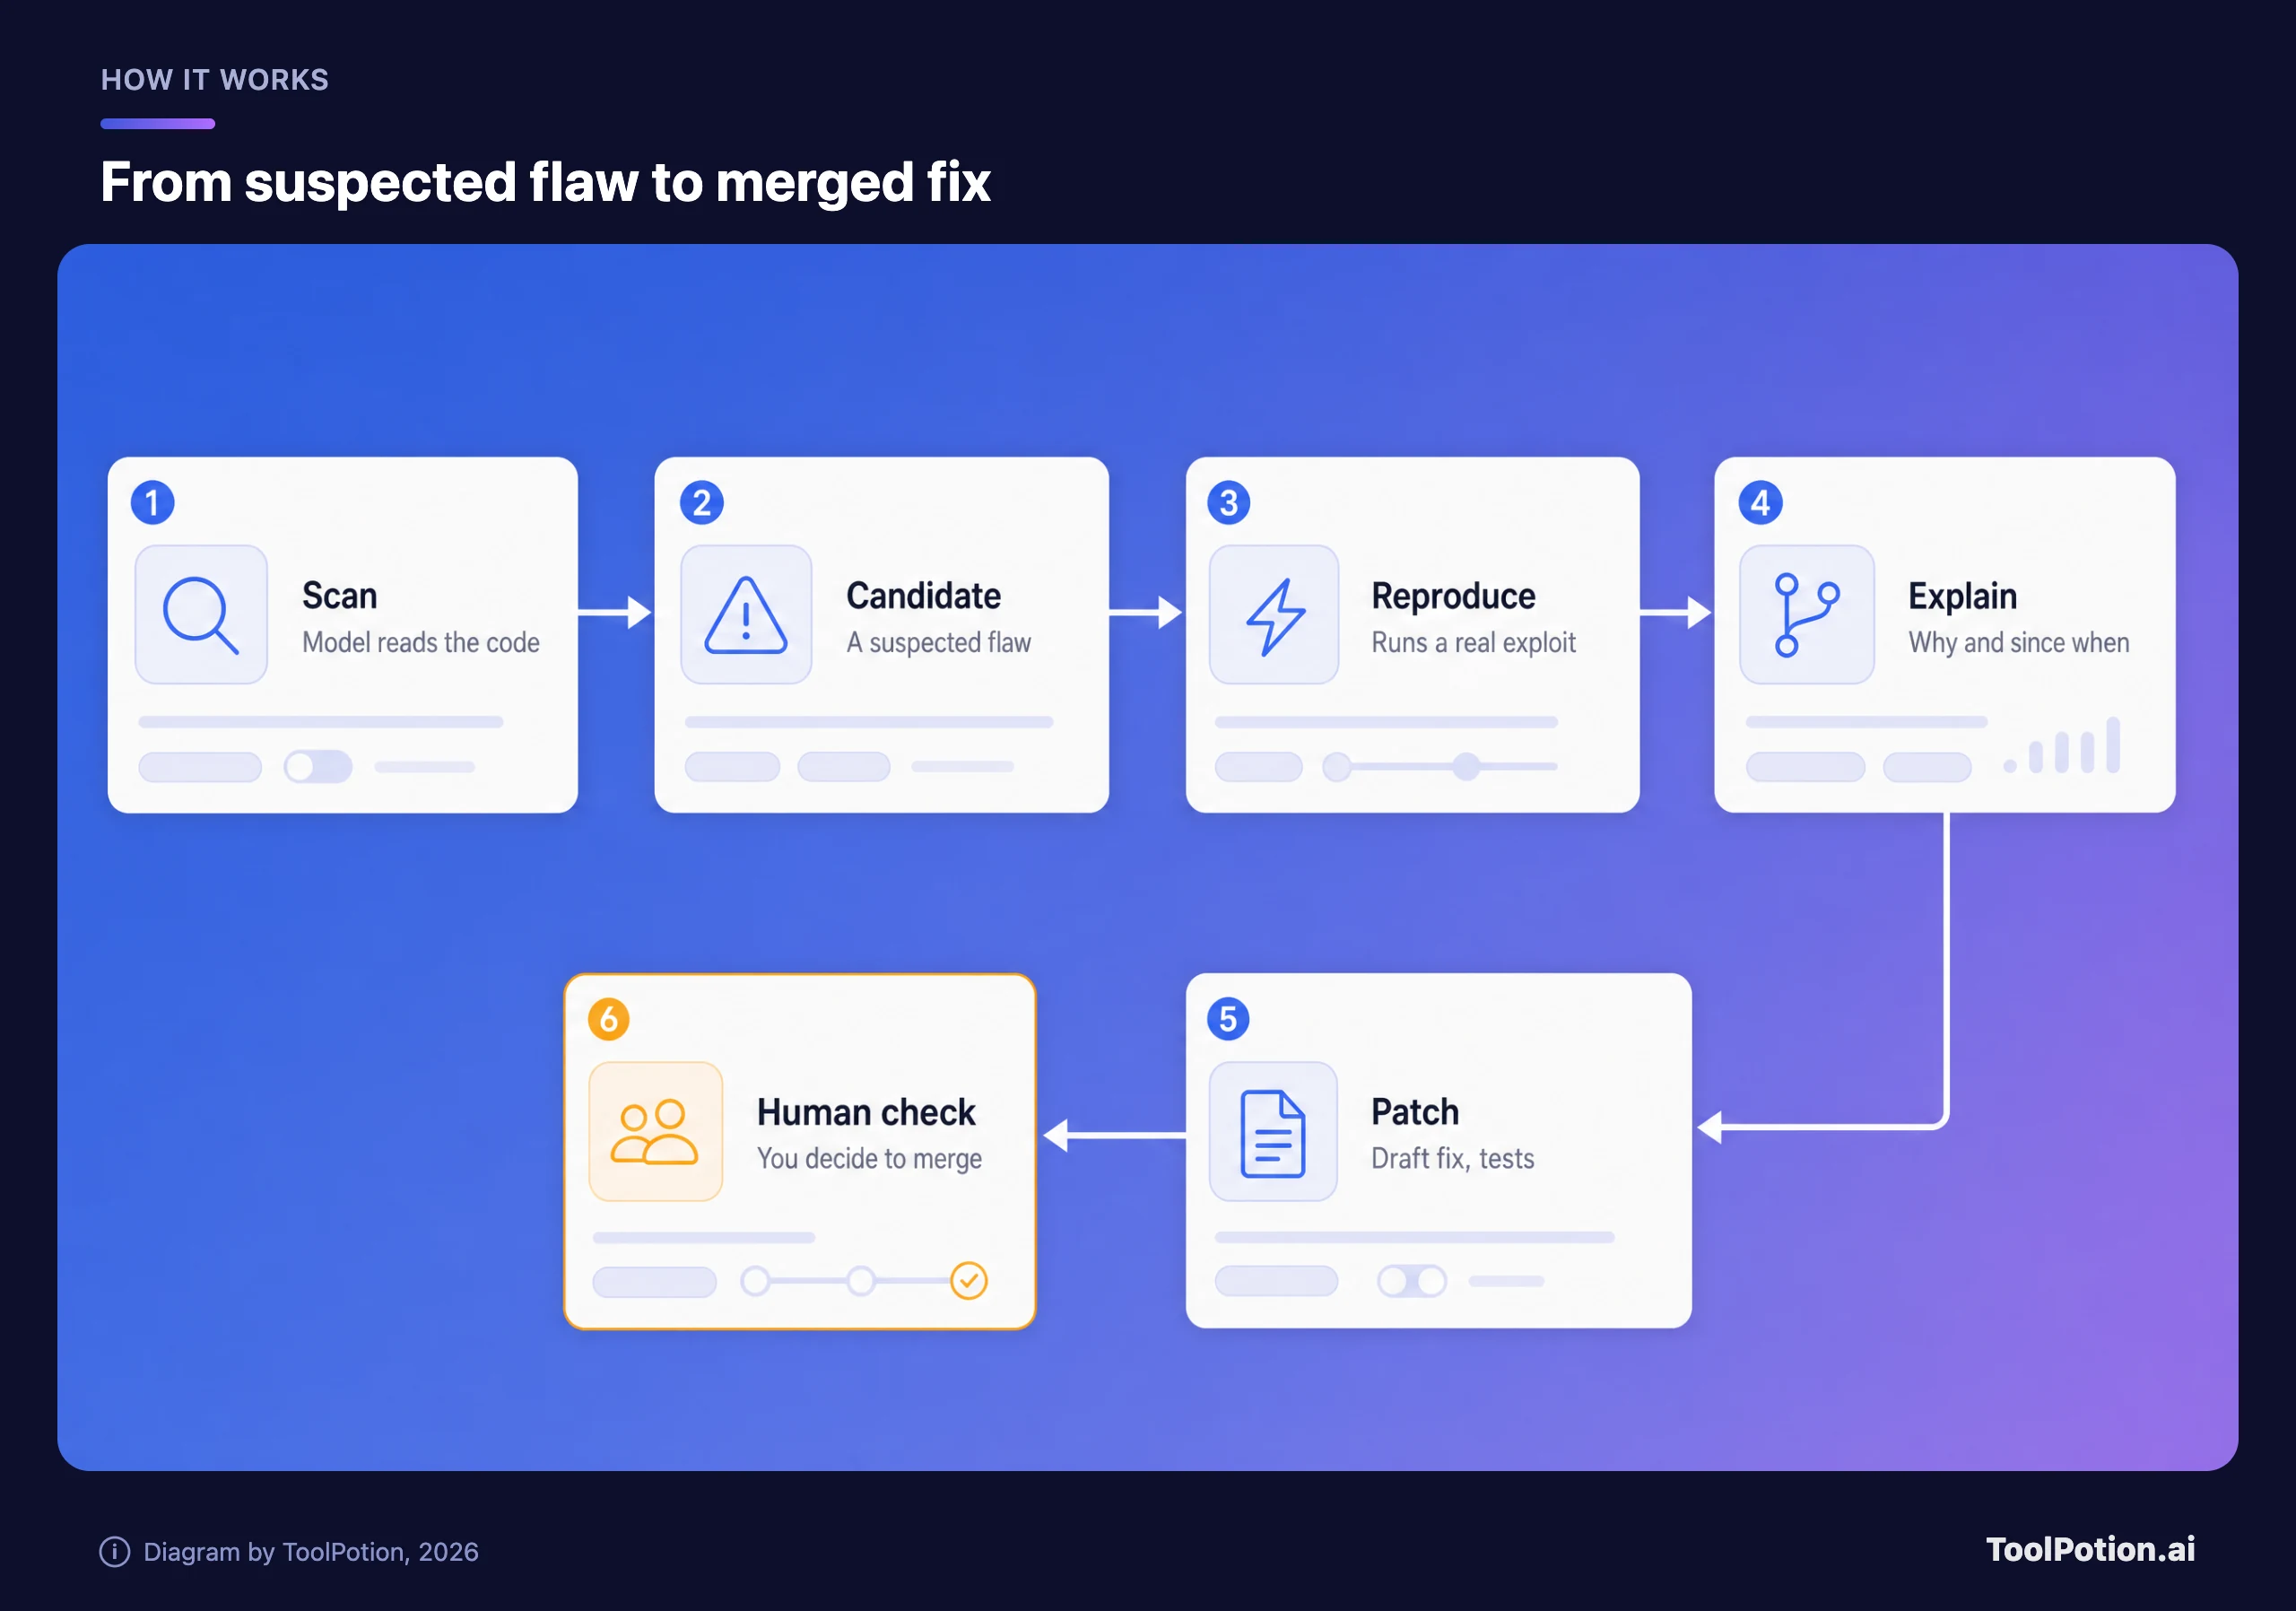
Lisez le pipeline de gauche à droite. Les trois premières étapes servent à avoir raison : un candidat subit un vrai test avant que quiconque le voie. Les étapes quatre et cinq servent à être utile, avec l'explication de ce qui a cassé et un brouillon de correctif. La dernière case est la vôtre, et elle est en orange pour une raison. Google affirme que chaque correctif de CodeMender est relu par un humain, et l'Autofix de GitHub se contente de suggérer. Le scanner d'Anthropic fait exception sur le tri, et c'est pourquoi cette dernière case vous revient.
Le paysage en 2026
L'OSS Scanner n'est pas seul. DeepMind, chez Google, a créé Big Sleep, un agent qui chasse les bugs, et CodeMender, qui écrit les correctifs. DeepMind indique avoir déjà remonté 72 correctifs de sécurité vers des projets open source, chacun relu au préalable par des chercheurs humains (Google DeepMind). CodeMender est depuis passé en préversion publique pour les clients entreprise de Google Cloud : il construit des exploits de preuve de concept dans un bac à sable et renvoie des correctifs testés sous forme de diffs à relire par les développeurs (Infosecurity Magazine).
La version d'OpenAI a été lancée sous le nom d'Aardvark, un agent basé sur GPT-5 qui construit un modèle de menaces de votre dépôt, surveille les nouveaux commits, confirme les failles dans un bac à sable et propose des correctifs. OpenAI affirme avoir atteint 92 % sur des vulnérabilités connues et synthétiques dans des dépôts de test, et avoir trouvé des failles ayant donné dix identifiants CVE (OpenAI). L'outil a depuis été intégré à Codex sous un nouveau nom : la page Aardvark indique désormais « Aardvark is now Codex Security », en préversion de recherche (OpenAI). La documentation décrit Codex Security comme un agent qui aide les équipes à « trouver, confirmer et corriger les vulnérabilités », la version cloud restant en préversion de recherche (OpenAI docs).
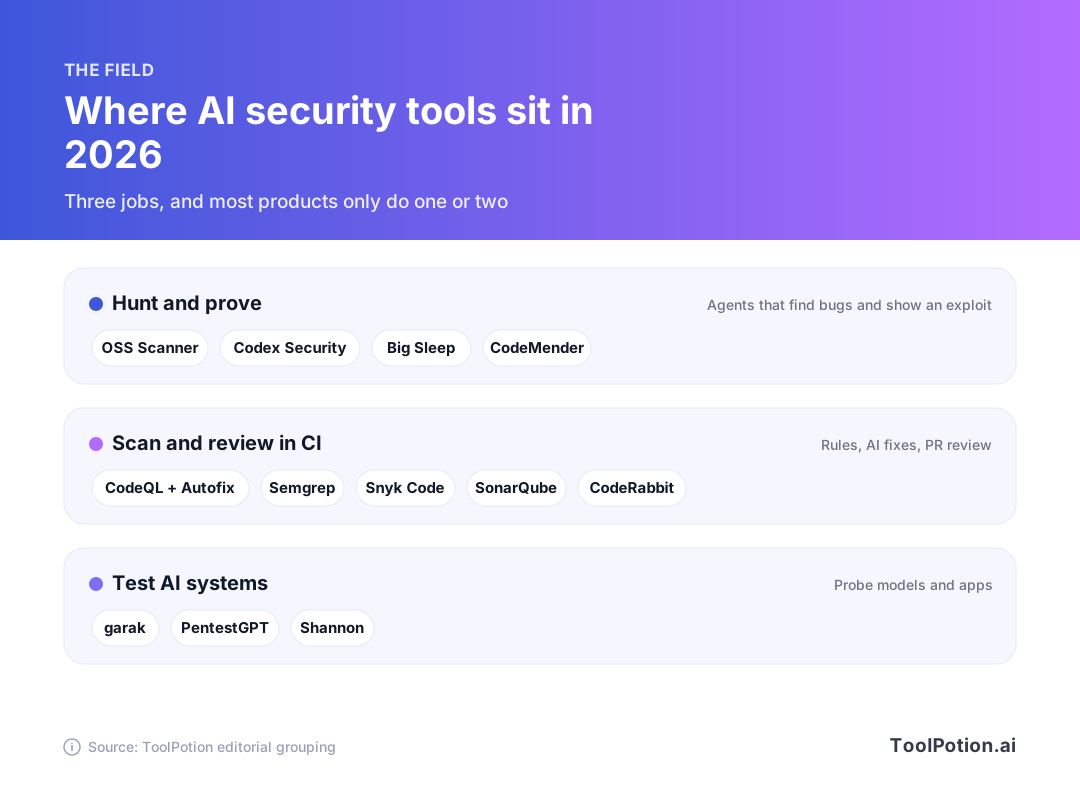
La carte regroupe les outils par fonction, et ce regroupement est le nôtre, pas celui des éditeurs. La rangée du haut chasse et prouve. Celle du milieu vit dans votre pipeline et travaille sur chaque commit. Celle du bas regarde dans l'autre sens et teste les systèmes d'IA eux-mêmes.
Sur la rangée du milieu, l'Autofix de GitHub Copilot suggère des correctifs pour les alertes levées par CodeQL, le scanner de GitHub. Semgrep et Snyk Code font un travail comparable avec leurs propres moteurs, et SonarQube couvre la qualité du code ainsi que des contrôles de sécurité. CodeRabbit relit les pull requests. Sur la rangée du bas, garak sonde les modèles de langage à la recherche de faiblesses, et PentestGPT pilote des tests d'intrusion avec un modèle. Notre classement cybersécurité IA couvre l'ensemble, et le classement revue de code traite des outils de pull request.
| Outil | Rôle principal | Qui peut l'utiliser |
|---|---|---|
| OSS Scanner (Anthropic) | Trouve et prouve les bugs, rédige des correctifs | Projets open source inscrits, gratuit |
| Codex Security (OpenAI) | Trouve, confirme et corrige | Préversion de recherche dans Codex |
| CodeMender (Google) | Analyse, prouve et corrige | Préversion publique, clients Google Cloud |
| Copilot Autofix (GitHub) | Suggère des correctifs pour les alertes CodeQL | Gratuit sur les dépôts publics |
| Semgrep | Analyse par règles avec fonctions IA | Gratuit jusqu'à 10 contributeurs |
| Snyk Code | Analyse du code et des dépendances | Offre gratuite, 100 tests Code par mois |
L'essentiel de ce tableau vient des pages des éditeurs, et les éditeurs parlent de leurs produits avec indulgence. Considérez les conditions d'accès comme la colonne utile. Elles changent vite.
Revers de la médaille : les mainteneurs se noient
Les mêmes modèles qui trouvent de vrais bugs en fabriquent aussi de faux très convaincants. curl en est le cas le plus clair. Son programme de bug bounty a tourné de 2019 à début 2026, versé plus de 100 000 $ pour 87 vulnérabilités confirmées, puis fermé. En 2025, moins de 5 % des rapports étaient confirmés, contre 15 % ou plus les années précédentes (Daniel Stenberg).
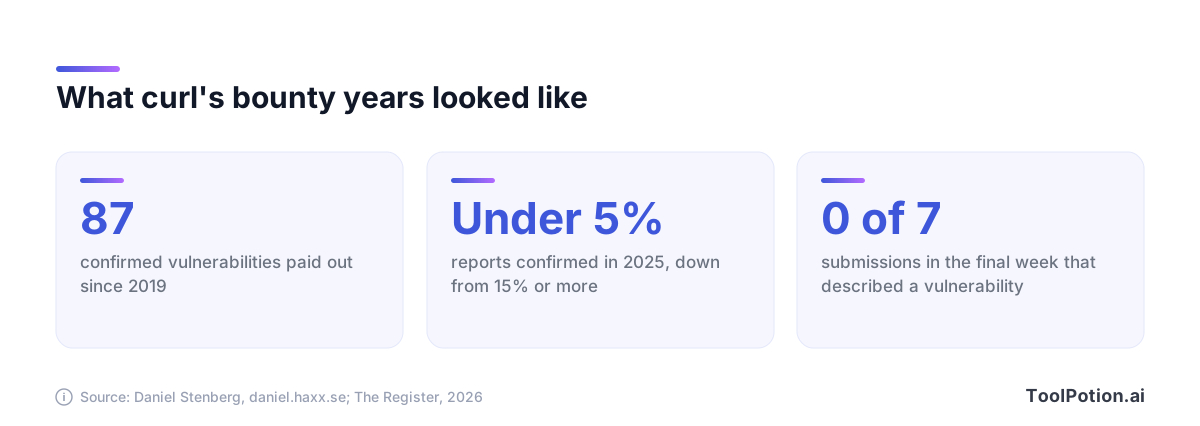
Durant la dernière semaine avant la fin du bounty, curl a reçu sept soumissions et aucune ne décrivait une vulnérabilité (The Register). Le raisonnement de Stenberg était sans détour : l'objectif était de « supprimer l'incitation à nous envoyer des rapports bâclés et mal documentés. Générés par IA ou non. » Piotr Karwasz, d'Apache Log4j, décrit le même phénomène : beaucoup de rapports « passent à côté des fondamentaux de notre modèle de sécurité, ajoutant du bruit plutôt que de la valeur » (Daniel Stenberg).
curl est allé plus loin par la suite. Stenberg a écrit que le projet avait suspendu les signalements de vulnérabilités pendant un mois cet été, et l'a qualifié de « possiblement notre meilleure décision de projet depuis longtemps » (Daniel Stenberg).
Remarquez que le projet qui a fermé son bounty pour endiguer le bruit de l'IA a aussi salué un scanner IA qui a trouvé l'un de ses pires bugs. Ce n'est pas contradictoire. La différence, c'est un reproducteur fonctionnel et un expéditeur qui a déjà fait la vérification. Un modèle qui prouve ce qu'il avance coûte quelques minutes au mainteneur. Une personne qui colle la sortie d'un modèle lui coûte des heures.
Le scanner d'Anthropic supprime l'intermédiaire humain, ce qui fait à la fois son attrait et son risque. Il accélère la livraison, mais il signifie aussi qu'un rapport peut arriver chez vous sans que personne l'ait lu. Si vous maintenez un projet, attendez-vous à en recevoir davantage de la part de chaque éditeur du tableau.
Les attaquants ont les mêmes modèles
L'annonce d'Anthropic elle-même dit que « les modèles de pointe peuvent être détournés pour exploiter des vulnérabilités et mener des cyberopérations » (Anthropic). La conclusion pratique est simple : n'importe qui peut pointer un modèle puissant vers du code public et lui demander où ça casse, et l'open source est public par définition.
C'est le vrai argument pour scanner votre propre code. Non pas que les scanners IA soient magiques, mais que la fenêtre entre l'existence d'un bug et sa découverte par quelqu'un d'autre se réduit, et que vous préférez arriver en premier. Un projet sans analyse n'est pas sûr. Il est simplement non surveillé.
Ce qui est gratuit et ce qui ne l'est pas
Une bonne partie de la couche utile est gratuite si votre code est public. Copilot Autofix est activé par défaut sur les dépôts publics qui utilisent CodeQL, sans abonnement Copilot (GitHub). GitHub l'a rendu gratuit pour tous les dépôts publics dès 2024 (GitHub changelog).
L'édition gratuite de Semgrep couvre jusqu'à 10 contributeurs et 10 dépôts, avec 60 crédits IA inclus (Semgrep). L'offre gratuite de Snyk autorise cinq projets et 100 tests Snyk Code par mois (Snyk), et l'entreprise propose aussi un programme où les mainteneurs open source peuvent demander un accès gratuit.
Le payant concerne surtout le code privé et les agents. L'autofix agentique plus récent de GitHub, encore en préversion, consomme des crédits IA, et Copilot Autofix sur les dépôts privés exige une licence Code Security (GitHub). Codex Security nécessite un accès à la préversion de recherche (OpenAI docs).
Comment s'inscrire sans risque
Gratuit ne veut pas dire sans conséquences. Un scanner qui lit votre code et vous envoie des rapports a un effet sur votre workflow, votre processus de divulgation et parfois votre réputation. Quelques précautions permettent de garder la main.
- Vérifiez d'abord l'éligibilité. L'OSS Scanner vise les projets à impact critique sur l'infrastructure ou la sécurité, donc lisez les critères dans le dépôt d'Anthropic avant de perdre du temps sur une pull request.
- Décidez où vont les rapports. Utilisez un canal privé, comme le signalement privé de vulnérabilités de GitHub ou une adresse e-mail de sécurité, pour qu'un résultat ne devienne pas public avant qu'un correctif existe.
- Désignez un responsable. Une seule personne reçoit tous les rapports et décide de la suite. À deux, chacun suppose que l'autre s'en occupe.
- Lisez les conditions d'utilisation des données de tout scanner hébergé. Semgrep, par exemple, indique que les fonctions IA activées peuvent traiter les parties de fichiers contenant des résultats (Semgrep). Sachez ce qui quitte votre machine.
- Commencez avec un accès en lecture seule et gardez les correctifs à l'état de suggestions. Aucun outil ne devrait pousser sur votre branche principale.
- Mettez par écrit votre calendrier de divulgation avant l'arrivée du premier rapport. Il est bien plus facile de suivre une règle écrite à tête reposée.
Rien d'exotique là-dedans. C'est la même hygiène qu'un bon mainteneur applique à tout chercheur externe, mais appliquée avant l'arrivée du volume.
Un workflow pour une petite équipe
Si vous êtes entre deux et dix personnes à livrer un produit, vous n'avez pas besoin d'un scanner agentique dès le premier jour. Il vous faut une file que vous pouvez réellement vider. La boucle ci-dessous compte six étapes, et celle en orange est celle que la plupart des équipes sautent.
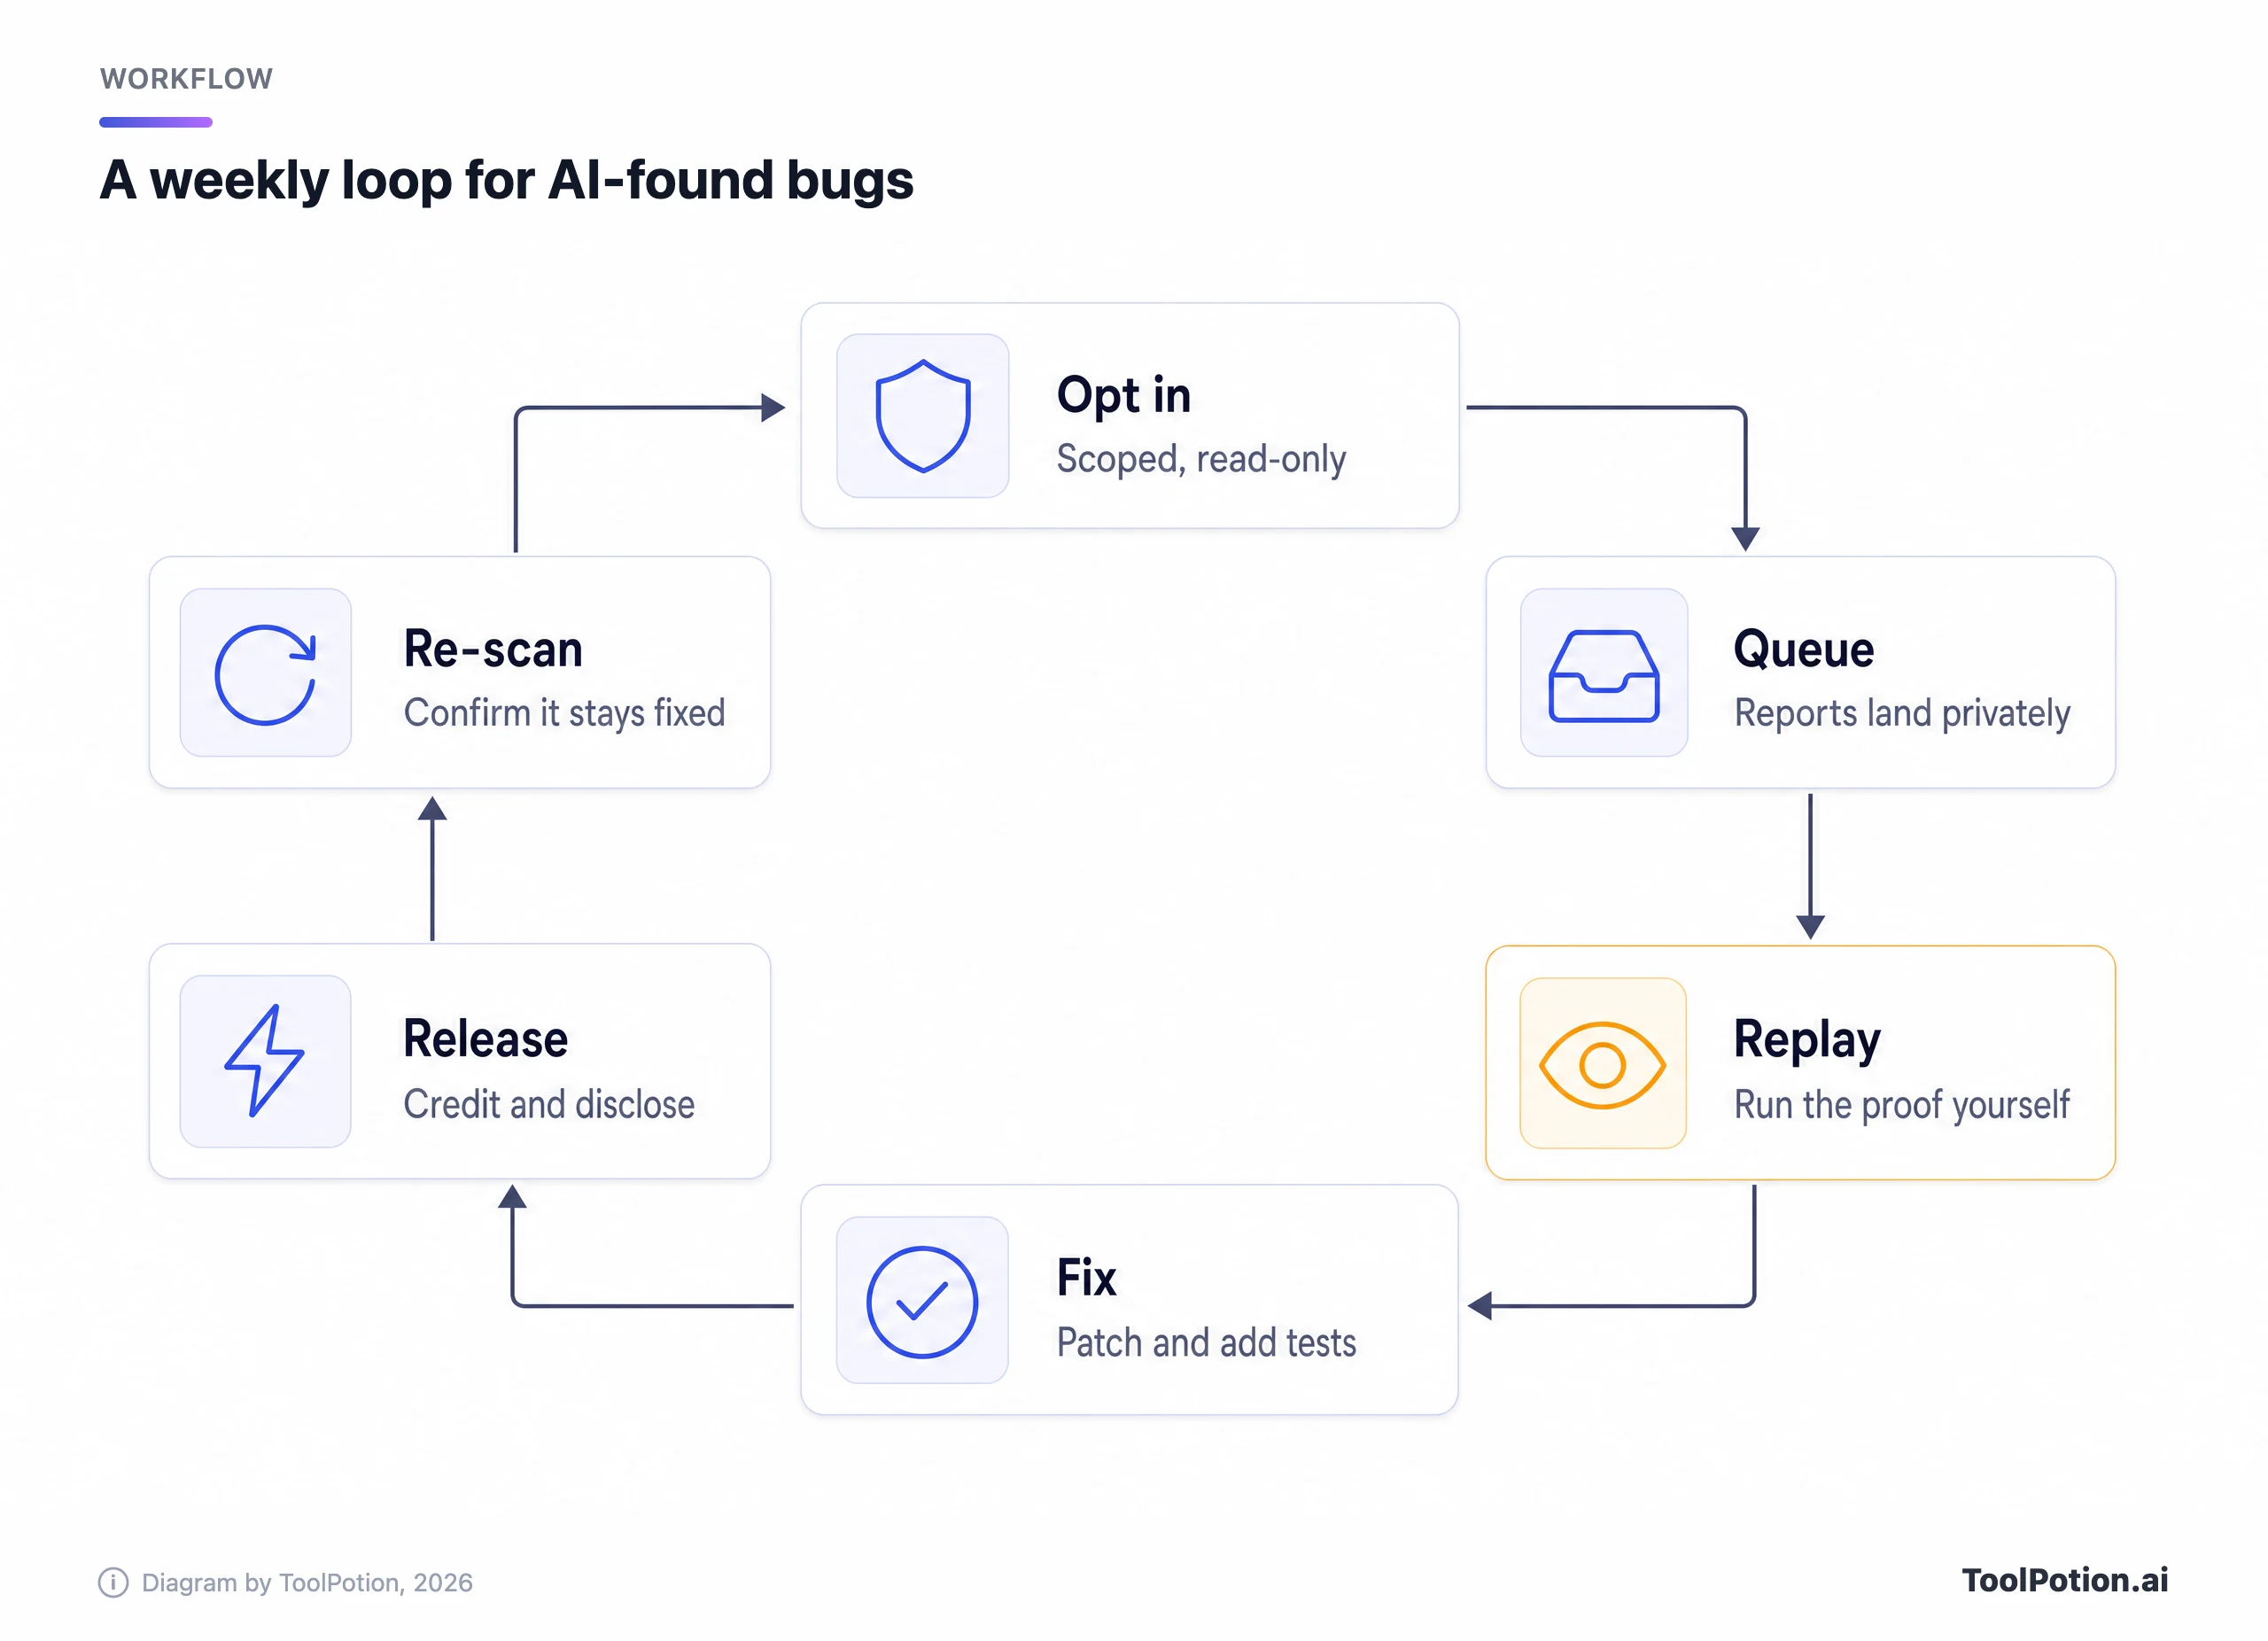
Le rejeu est l'étape qui sépare un scanner utile d'un scanner bruyant. Si un rapport contient un reproducteur, exécutez-le vous-même. Sinon, demandez-en un. Un modèle incapable de montrer que son affirmation fonctionne vous a donné une théorie, et les théories ne coûtent rien.
Vous ne savez pas par où commencer ? L'arbre de décision ci-dessous couvre les cas courants. C'est un conseil éditorial fondé sur les conditions des éditeurs ci-dessus, à adapter à votre situation.
Pour la plupart des petites équipes, le meilleur premier pas est un scanner de pull requests gratuit et une personne qui s'approprie les résultats. Ajoutez un outil agentique une fois que cette file reste calme pendant quelques semaines. Un dépôt de loisir peut se contenter des réglages gratuits que son hébergeur propose déjà. Une bibliothèque située sur un chemin critique est celle qui devrait candidater à l'OSS Scanner.
Mesurer le coût du tri
Personne ne met le temps de tri sur la page de tarifs, et c'est pourtant le coût qui décide si un scanner aide ou nuit. Même un bon outil produit des doublons. La revue d'Anthropic en a trouvé 11 sur 97. Le calculateur ci-dessous convertit votre volume de rapports en heures.
Essayez d'augmenter la part de rapports invalides et voyez à quelle vitesse les heures s'accumulent. Puis ramenez les minutes par rapport à 15, comme ordre de grandeur de ce qu'une preuve fonctionnelle pourrait vous faire gagner (ce chiffre est une illustration, pas une mesure). Cet écart est l'argument pour exiger des reproducteurs, des outils IA comme des humains.
Quelques habitudes aident une fois que les rapports commencent à arriver. Le visuel ci-dessous les résume.
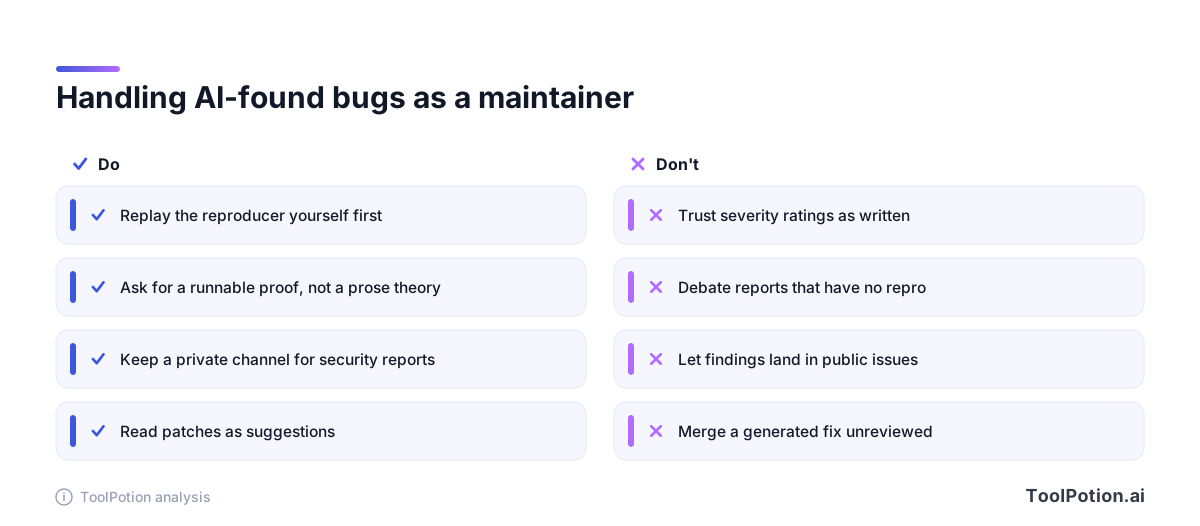
La première paire mérite d'être répétée. Les niveaux de gravité viennent d'un modèle, et Anthropic prévient elle-même qu'ils peuvent être faux (SiliconANGLE). Évaluez-la vous-même après l'avoir rejouée. Un assistant du type Claude Code peut vous aider à écrire le correctif et le test de non-régression une fois que vous avez établi que le bug est réel, mais la décision reste la vôtre. Pour plus de contexte sur ce type d'outils, consultez notre classement des assistants de code et le guide des outils de revue de code IA.
Où ces outils restent limités
Ils sont bons sur les types de bugs qui laissent une trace dans le code : erreurs mémoire, injections, contrôles manquants. Ils sont plus faibles sur les failles qui dépendent du fonctionnement réel d'une entreprise, comme qui a le droit d'approuver quoi. Un scanner ne peut pas connaître votre intention.
Ils ne remplacent pas non plus le reste de la sécurité. CodeMender de Google fait relire les correctifs par des humains avant de les remonter en amont (Google DeepMind), et GitHub précise qu'Autofix fonctionne au mieux de ses capacités et ne peut pas confirmer qu'un correctif résout les alertes issues de requêtes personnalisées (GitHub). Les éditeurs qui ont le plus à y gagner vous disent quand même de vérifier la sortie.
La vraie limite, c'est le volume. Trouver des bugs devient moins cher plus vite que les corriger. Un scanner qui livre quarante vraies failles à un projet de trois personnes a créé un arriéré, pas un produit plus sûr. Choisissez vos outils selon ce que vous pouvez corriger en un mois, pas selon ce qu'ils peuvent trouver.
Questions fréquentes
L'OSS Scanner d'Anthropic est-il ouvert à tout dépôt GitHub ?
Non. Il fonctionne sur inscription, évaluée au cas par cas, avec des critères proches d'OSS-Fuzz : les projets doivent avoir un impact critique sur l'infrastructure et la sécurité des utilisateurs. Les mainteneurs candidatent via une pull request sur le dépôt GitHub d'Anthropic.
Les scanners IA remplacent-ils un test d'intrusion ?
Pas pour ce qui compte pour vos clients. Ils couvrent bien les bugs au niveau du code et mal les failles de logique métier. Voyez-les comme une couche supplémentaire qui tourne en permanence, en complément d'une revue humaine ponctuelle.
Puis-je utiliser Claude ou Gemini directement pour auditer mon code ?
Vous pouvez coller du code dans Claude ou Google Gemini et demander une revue de sécurité. C'est utile pour une seule fonction. Vous n'aurez pas le bac à sable, le modèle de menaces à l'échelle du dépôt ni la vérification d'exploit qu'ajoutent les agents dédiés évoqués plus haut, donc attendez-vous à davantage de fausses alertes.
Que faire si je reçois un rapport écrit par IA qui semble faux ?
Demandez un reproducteur sur une version précise. Une vraie faille permet de répondre à cette question. Une faille inventée, souvent non. Si quelqu'un continue d'en envoyer, vous avez le droit de fermer le rapport et de passer à autre chose.
Les scanners gratuits sont-ils sûrs sur du code privé ?
Lisez les conditions de chacun. Certains tournent entièrement sur votre machine, d'autres envoient des portions de fichiers à un modèle hébergé. Vérifiez ce que l'éditeur stocke et pendant combien de temps avant de connecter un dépôt privé.