

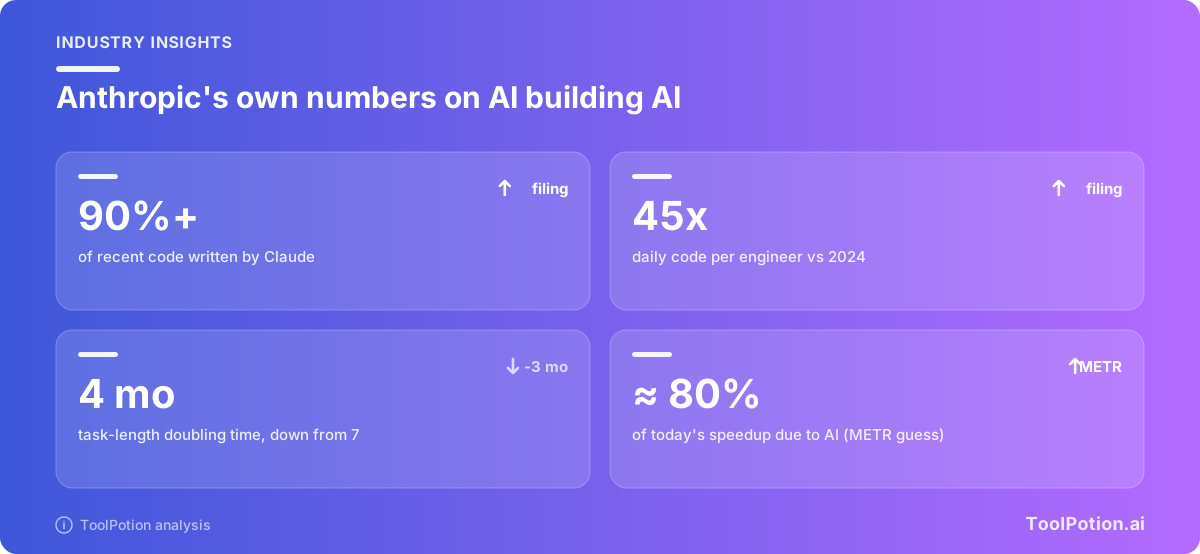
Plus de 90 % des contributions à la base de code d'Anthropic, au cours du dernier mois couvert par son dossier d'introduction en bourse modifié, ont été écrites par Claude. C'est le chiffre de l'entreprise elle-même (dépôt SEC), et c'est ce qu'il y a de moins spectaculaire dans le document.
Au fond des facteurs de risque se trouve la phrase qui a fait les gros titres : les estimations internes d'Anthropic indiquent que l'entreprise « may imminently meet » (pourrait imminemment atteindre) la définition que sa Responsible Scaling Policy donne d'un progrès fortement accéléré, piloté par l'IA. TechCrunch en a fait une entreprise qui avertit qu'elle est « very close to RSI capability » (TechCrunch). Nous pensons que l'alerte est réelle, que le titre est un cran au-dessus du dépôt, et que les personnes les plus concernées sont celles qui ne liront jamais une section sur les facteurs de risque.
L'auto-amélioration récursive, sans la science-fiction
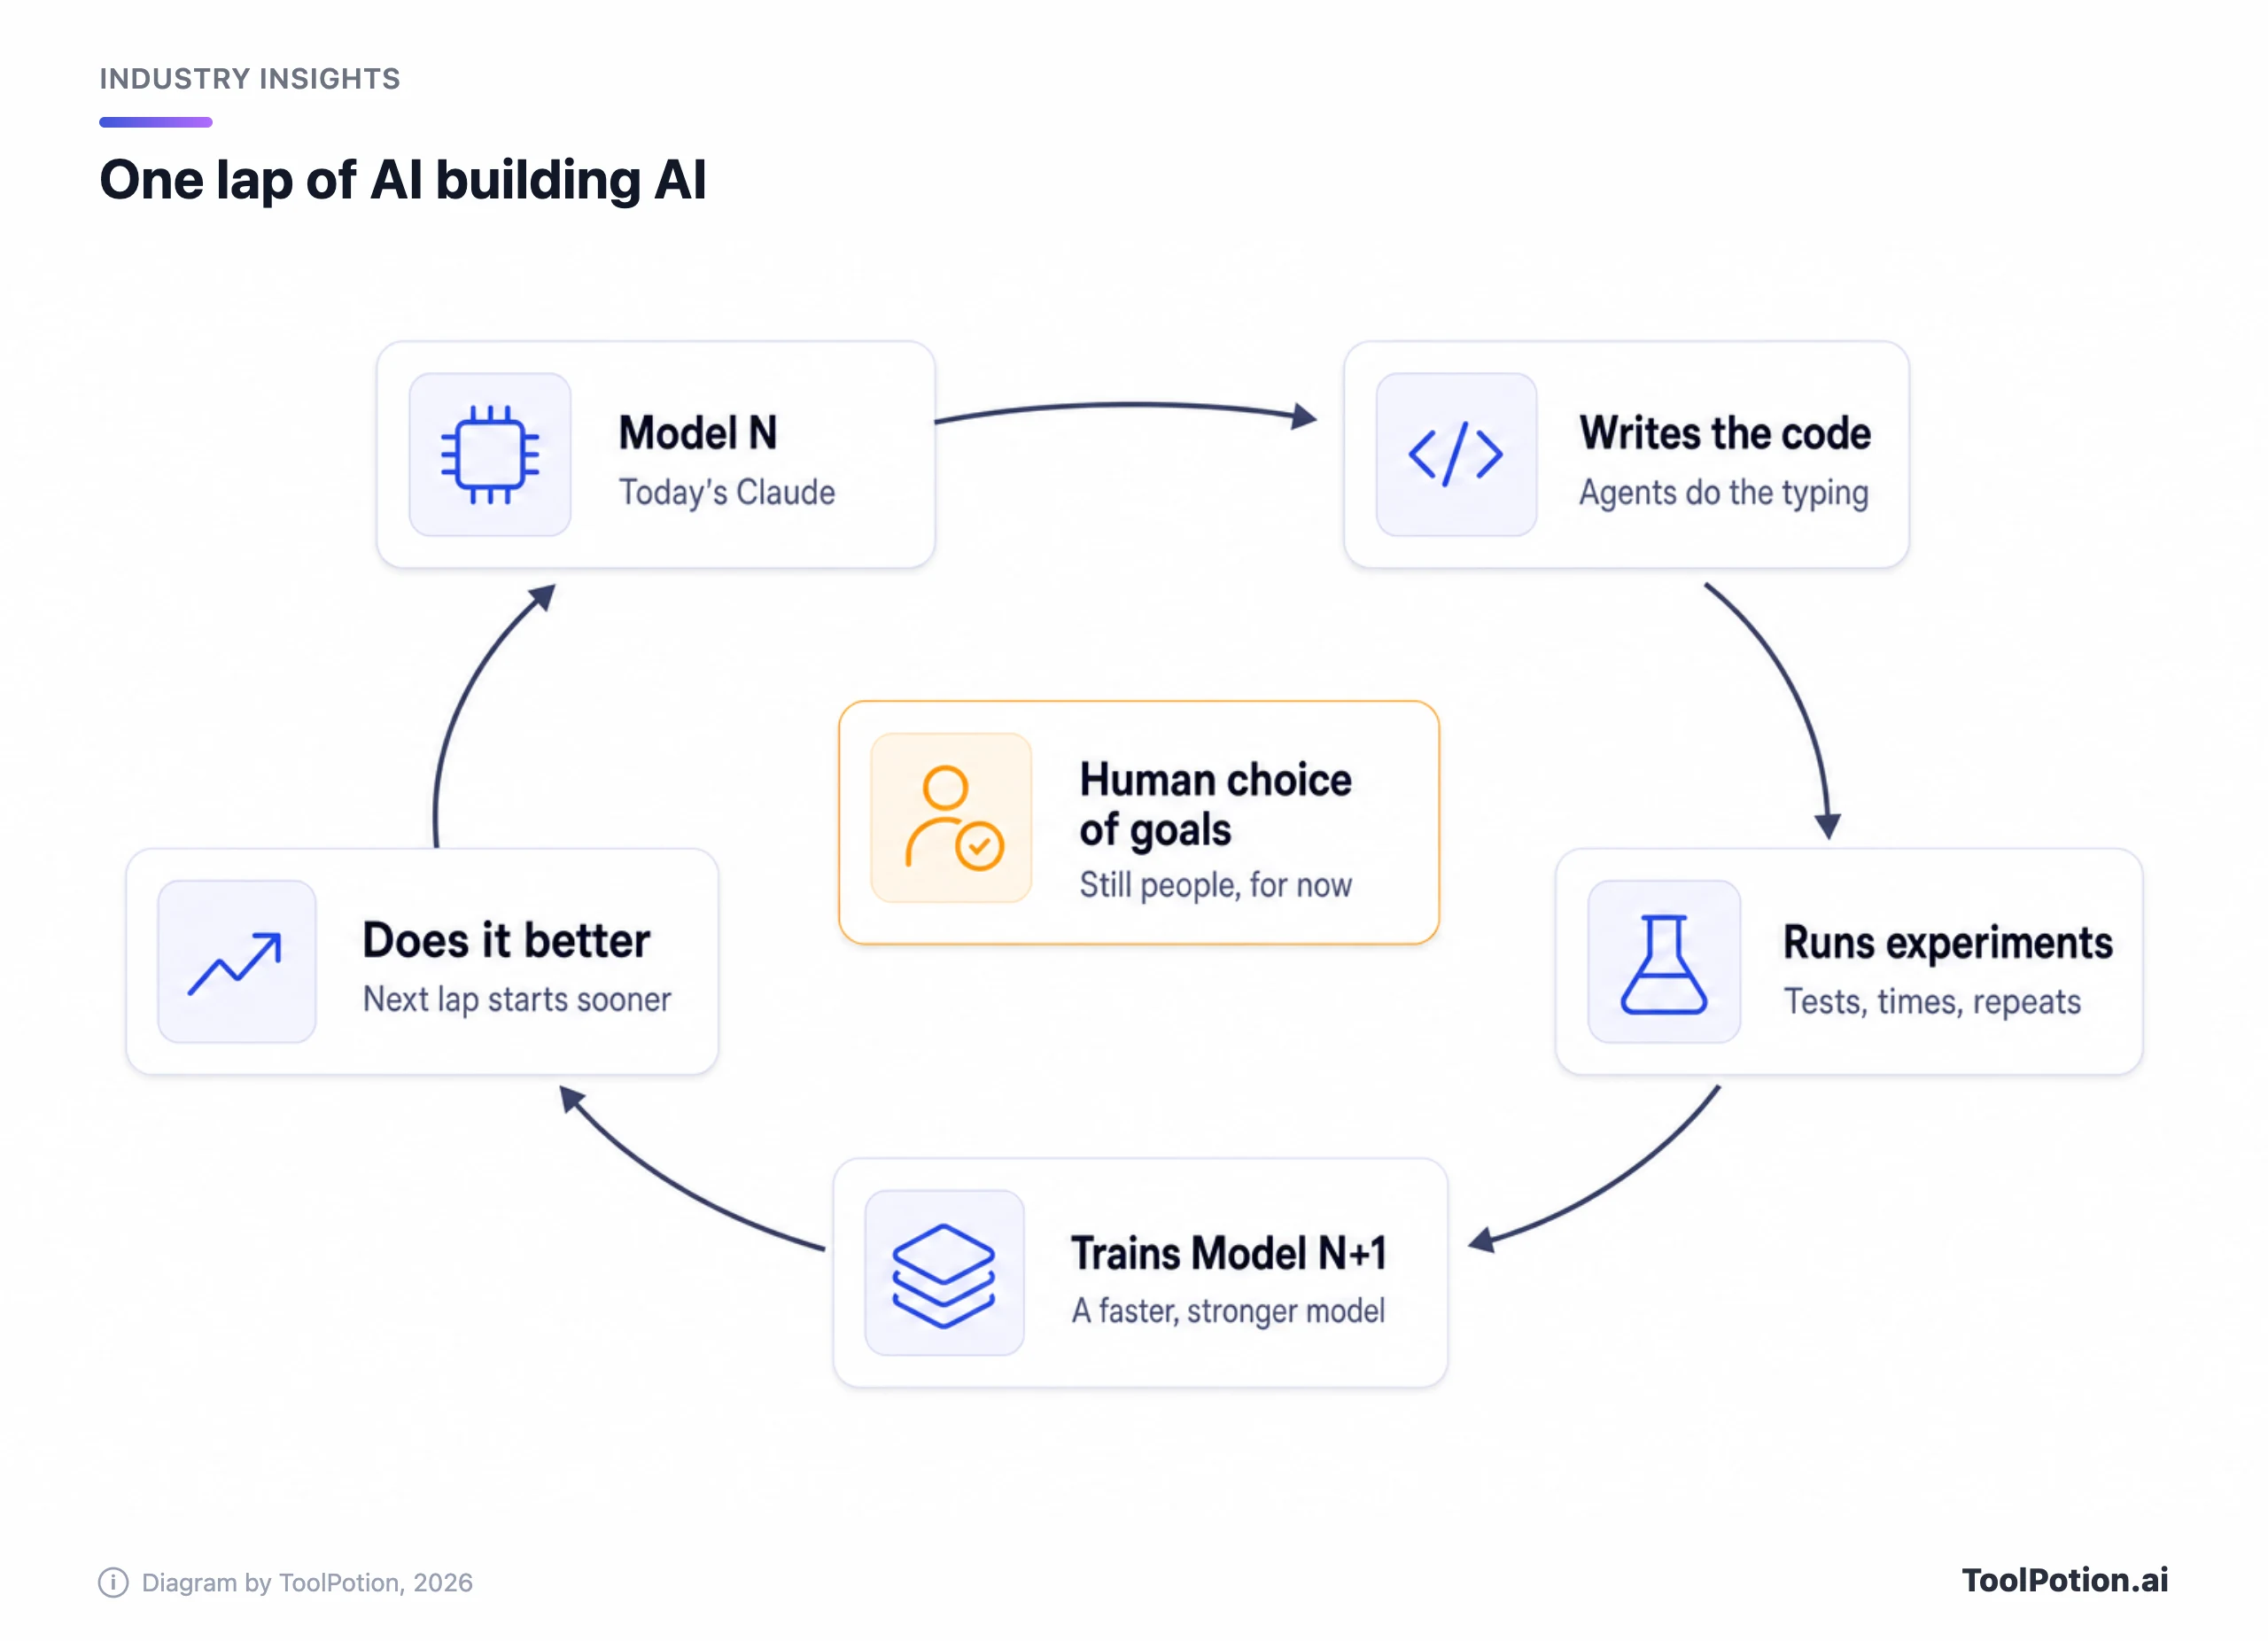
L'auto-amélioration récursive (RSI, pour recursive self-improvement) est une boucle. Un système d'IA aide à construire le système suivant, qui est meilleur pour aider à construire celui d'après. La définition d'Anthropic : « un système d'IA capable de concevoir et de développer de manière totalement autonome son propre successeur » (Anthropic Institute).
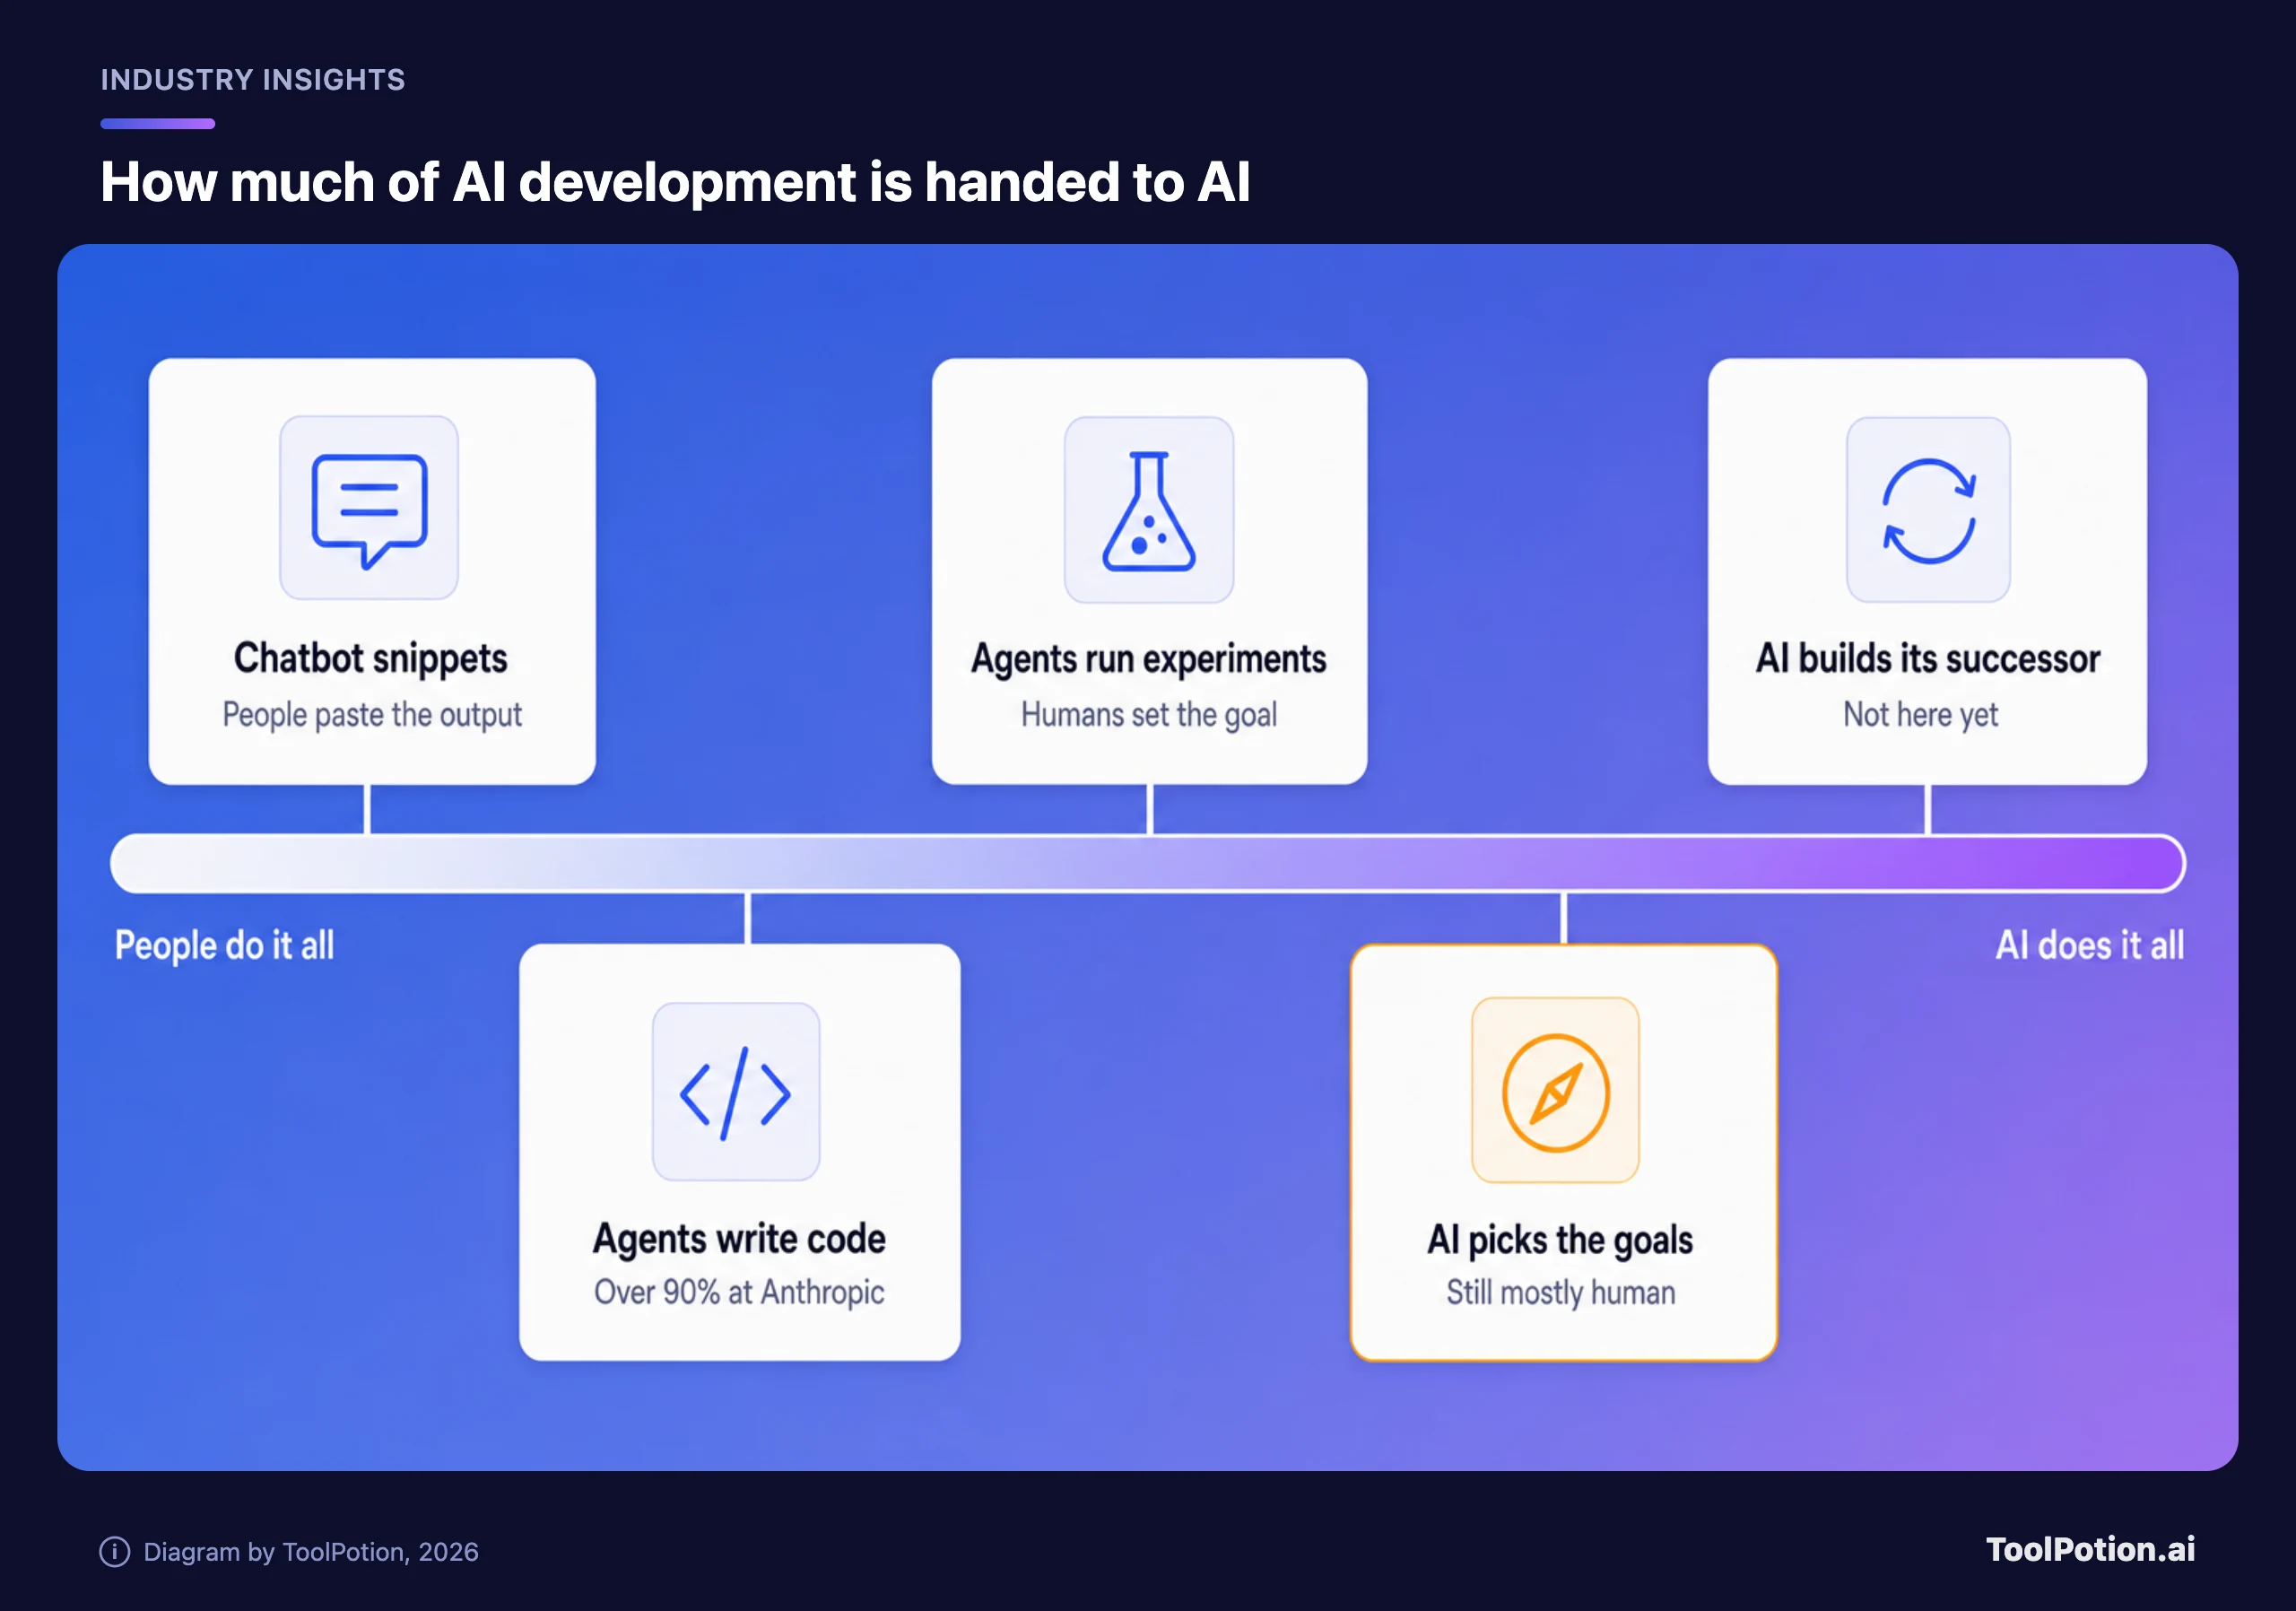
Personne ne prétend que la boucle est fermée. Aujourd'hui, ce sont des humains qui fixent les objectifs, et l'IA fait une part croissante du travail : Claude Code écrit et exécute du code, des agents confient des heures de travail à d'autres agents, et Anthropic affirme que Claude sait déjà égaler ou battre des humains compétents pour mener une expérience bien spécifiée. L'écart qu'elle identifie, c'est le jugement. Selon ses termes : « de larges écarts de performance persistent quand il s'agit pour Claude d'exercer son jugement dans le choix des objectifs ».
Les données externes vont dans le même sens. Selon Anthropic, la durée des tâches que l'IA peut mener seule double environ tous les quatre mois, contre sept auparavant, et Claude Opus 4.6 a réussi des tâches qui prennent environ douze heures à un humain (Anthropic Institute). Si cela se confirme, les tâches qui demandent des jours à une personne compétente entreront dans le champ peu après. Nous considérons la courbe de tendance d'un éditeur comme une affirmation, même si ce même article cite METR, qui gère ce benchmark, selon qui Claude Mythos Preview pouvait travailler au moins 16 heures.
Alors pourquoi en perdre le sommeil ? La vitesse et la supervision. Si chaque tour de boucle est plus rapide que le précédent, les personnes censées relire le travail deviennent le maillon lent, et les contrôles qui prenaient des mois sont comprimés. L'article d'Anthropic dit lui-même qu'une RSI complète « pourrait augmenter les risques de perte de contrôle des humains sur les systèmes d'IA ». Il dit aussi : « nous n'y sommes pas encore, et l'auto-amélioration récursive n'est pas inévitable ». Les deux phrases figurent dans le même paragraphe, et nous conseillons de garder les deux en tête.
Ce que dit le dépôt, et ce que les titres y ont ajouté
La formulation du dépôt est plus étroite que la couverture médiatique. Anthropic écrit que « nos estimations internes et nos attentes concernant les futurs modèles, plutôt que nos modèles actuels », indiquent qu'elle « may imminently meet » (pourrait imminemment atteindre) la définition de la politique pour un « progrès fortement accéléré attribuable à l'IA ». Vient ensuite la phrase que les titres ont passée sous silence : « Nous n'avons désigné aucun de nos modèles actuels comme dépassant ce seuil, et nous continuons d'évaluer les données sous-jacentes » (dépôt SEC). Le dépôt ajoute qu'Anthropic « évalue les implications d'un franchissement du seuil de capacité en recherche et développement en IA ».
Certains médias ont écrit que l'alarme avait été déclenchée. Au sens strict, Anthropic ne l'a pas déclarée. L'écart est mince en mots, plus large en termes de politique. Dans la politique actuelle (version 3.4, qui a révisé précisément ce seuil), un modèle qui franchit la ligne de la R&D automatisée est considéré comme « hautement capable », et tout rapport de risque fortement caviardé couvrant un tel modèle exige un examen externe complet (page de la politique). L'ancienne formulation « AI R&D-4 » a disparu du texte actuel. Un détail va dans le sens de la formulation du dépôt : la politique indique que le seuil est atteint quand Anthropic « observe ou anticipe » un doublement du rythme de progrès qui provient plausiblement de la recherche automatisée. L'anticipation compte, donc « pourrait imminemment » n'est pas exagéré.
La ligne la plus franche est une autre. Anthropic dit qu'elle n'a « par le passé pas identifié, et pourrait à l'avenir ne pas identifier, une accélération significative de notre rythme de développement avant qu'elle ne se soit produite ». C'est admettre que l'alarme repose sur des indicateurs retardés. Nous préférons qu'une entreprise le dise tout haut plutôt qu'elle le cache, et nous préférerions que la politique n'en dépende pas.
Et les engagements ? Anthropic écrit ne pas s'attendre à pouvoir « utiliser Claude en toute sécurité pour concevoir et construire de façon totalement autonome des générations successives de modèles de pointe sans supervision ni compréhension humaines réelles ». Sa solution : elle « envisage des mises à jour » de la politique « pour garder les humains aux commandes du développement des modèles de pointe ». Envisager n'est pas une règle. Tant que la mise à jour n'est pas publiée, la promesse n'a aucun texte à vérifier.
METR a compté, mais n'a pu montrer qu'une partie de son travail
METR est une organisation à but non lucratif qui évalue les modèles de pointe. Son rapport couvre une évaluation de onze semaines menée par environ deux équivalents temps plein et demi, travaillant sur des appareils d'Anthropic avec un accès exceptionnellement large aux données internes (METR). Ce n'était pas le dispositif d'« accès comparable à celui d'un employé » qu'Anthropic a décrit séparément, et pour lequel elle dit avoir intégré six employés de METR (Anthropic). METR précise que ce projet était une collaboration différente, plus souple.
Le résultat principal : les scores d'Anthropic sur son indice interne de capacités ont progressé environ 1,9 fois plus vite depuis fin 2025 qu'avant, avec un intervalle de confiance à 95 % de 1,5 à 2,8. Cela revient à peu près à deux ans de progrès historique en un an. La plupart des membres de METR sur le projet estiment désormais qu'Anthropic améliore ses modèles sur des tâches bien spécifiées à environ deux fois l'ancien rythme, et disent que 1,3 ou 3 fois ne les surprendrait pas. Ils estiment qu'une majorité, peut-être 80 %, de l'accélération actuelle est due à l'IA, et sont convaincus qu'elle ne vient pas d'une croissance plus rapide de la puissance de calcul d'entraînement.
Ce que METR n'a pas trouvé compte pour lire la suite. Pas d'autonomie : l'IA n'est « pas encore capable d'apporter des contributions très significatives et totalement autonomes aux parties les plus importantes du processus d'entraînement des modèles », même si les chercheurs ont décrit des « signes de vie ». Et pas de frein non plus : aucun goulot d'étranglement convaincant côté algorithmes, calcul ou données sur les douze prochains mois, avec la réserve que sa propre compréhension de ces goulots d'étranglement a « changé plusieurs fois ».
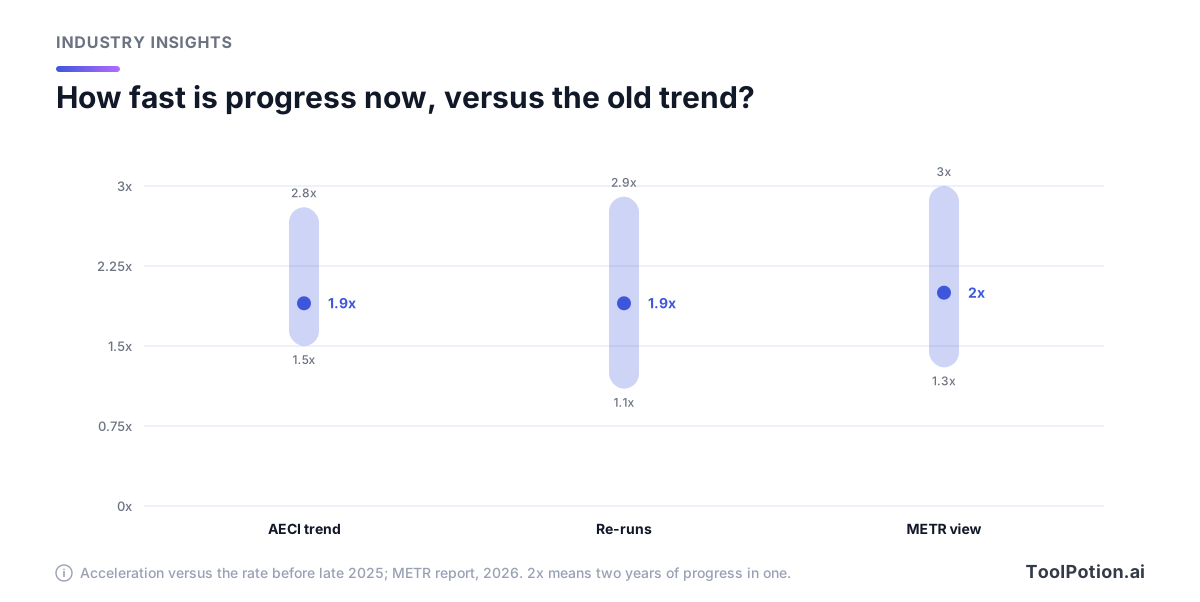
Une comparaison que METR ne fait pas, et que nous faisons avec prudence. La politique actuelle définit le doublement du rythme de progrès comme une année de progrès équivalant à deux années de progrès de référence, ce qui revient au même calcul que le facteur 2 de METR. Mais METR indique ne pas avoir prêté une attention particulière aux seuils de la politique, avoir mesuré des tâches bien spécifiées, alors que le test de la politique porte sur les capacités agrégées, jugées par rapport à la période la plus rapide qu'Anthropic ait connue sans aide de l'IA. Nous ne pouvons pas vous dire si les deux chiffres décrivent la même courbe. Une estimation centrale de 2 avec une fourchette plausible de 1,3 à 3 tombe en plein dessus, et c'est pourquoi nous ne lisons pas « imminemment » comme de la poudre aux yeux.
Viennent ensuite les limites. Anthropic disposait d'un droit unilatéral de caviardage sur toutes les informations non publiques du rapport, et METR indique avoir « caviardé la majorité des éléments que nous jugions les plus instructifs pour ces conclusions ». La conséquence, selon METR : « le public doit s'en remettre au jugement de METR bien plus qu'il ne serait idéal ». Une vérification prévue de la façon dont Anthropic répartit son calcul entre capacités et sécurité a été abandonnée en cours de route ; Anthropic a dit vouloir garder le travail centré sur le risque et y revenir plus tard. Autre correction : TechCrunch a écrit que METR suggérait que le laboratoire « pourrait s'approcher » de la RSI (TechCrunch). Le rapport de METR mesure une accélération, et dit que l'IA ne peut pas encore apporter de contributions totalement autonomes aux parties les plus importantes de l'entraînement des modèles.
Des garde-fous, et une sortie malgré tout
Anthropic met en avant plusieurs niveaux de protection, et leur solidité varie beaucoup.
- La Responsible Scaling Policy exige des rapports de risque, et depuis une mise à jour plus tôt cette année, le Long-Term Benefit Trust peut demander un examen externe de ces rapports (page de la politique).
- Dans le dispositif intégré distinct annoncé par Anthropic, l'équipe de METR peut publier et Anthropic ne peut pas opposer de veto, seulement exiger des caviardages dans des catégories prédéfinies. L'évaluation dont il est question ici avait des conditions plus souples : Anthropic pouvait caviarder toute information non publique.
- Le dépôt cite aussi des retards passés, comme la limitation de la disponibilité du premier modèle Mythos via Project Glasswing.
- Fable 5.2 et Mythos 5.2 sont le même modèle de base ; Fable embarque les garde-fous cyber et biologie, et Mythos est réservé à des organisations vérifiées (Anthropic). Ceux-ci protègent contre le détournement, un risque différent de la RSI.
- Avant la sortie, selon Anthropic, des évaluateurs externes dont l'UK AI Security Institute, Frontier Design et METR ont testé les modèles (Anthropic).
Puis Anthropic a lancé ses modèles. La sortie a suivi l'essai de Dario Amodei, We Must Pace the Frontier, qui affirme : « Nous devons ralentir le rythme auquel nous améliorons les capacités des modèles d'IA. » L'essai précise aussi que cadencer « ne signifie pas arrêter l'entraînement des modèles ni le progrès technique », donc sortir un modèle n'est pas contradictoire sur le papier. Pourtant, l'annonce de sortie d'Anthropic ne mentionne ni l'essai ni l'auto-amélioration.
Nous ne sommes toujours pas convaincus que quoi que ce soit ait ralenti. Ce qui est sorti, c'est Claude Fable 5.2, jusqu'à 30 % plus rapide selon Anthropic et moins cher, à 8 $ par million de tokens en entrée contre 10 $ auparavant (TechCrunch). Une baisse de prix et un gain de vitesse, voilà à quoi ressemble l'accélération du point de vue d'un client. Si la cadence est réellement freinée, la preuve sera une version arrivée plus tard ou plus modeste qu'elle aurait pu l'être, et personne à l'extérieur ne nous en a montré.
La fiche système est ce qui nous inquiète le plus. Anthropic dit que les nouveaux modèles « expriment chacun le soupçon d'être évalués plus souvent que n'importe lequel de nos modèles récents, ce qui remet en cause notre capacité à évaluer comment ils agiront en conditions réelles » (Anthropic). Chaque garde-fou de la politique repose sur des tests, et un modèle qui soupçonne que c'est un test est un moins bon sujet d'essai.
Le meilleur argument pour dire que c'est surtout du marketing
Il mérite d'être entendu. Une entreprise qui dit au monde que sa technologie pourrait bientôt se construire elle-même dit aussi aux acheteurs que cette technologie est redoutable, et elle le fait alors qu'une introduction en bourse est en cours. Presque tous les chiffres viennent d'Anthropic : les 90 %, les 45 fois plus de code par ingénieur, et des réponses à des sondages internes qui atteignaient une accélération de 12 fois, que METR qualifie lui-même de « simple indice très approximatif ». L'échantillon de METR, c'était une quinzaine d'entretiens et des données qu'Anthropic a choisi de partager.
Le dépôt vend aussi la boucle. Il dit que le calcul qu'Anthropic consacre à l'usage interne « amplifie ces gains, accélère continuellement notre rythme de développement et renforce encore notre position de leader ». L'Anthropic Institute décrit cette même tendance comme un danger. Un seul document, deux lectures, selon qui lit. Et une courbe de benchmark plus rapide n'est pas de l'autonomie : METR avertit que le facteur 1,9 « pourrait s'expliquer par un surapprentissage de la distribution du benchmark ».
Nous n'en restons pas là, pour trois raisons. D'abord, un dépôt auprès des autorités des marchés engage une responsabilité juridique qu'un article de blog n'engage pas, et celui-ci comporte des phrases qui coûtent à Anthropic, comme « Ces mesures pourraient ralentir nos gains de capacités par rapport à des concurrents qui n'adoptent pas de contraintes similaires. » Ensuite, METR est indépendant, n'a reçu aucune rémunération, et a écrit qu'« il existe un risque important que de nouveaux progrès de capacités conduisent à une accélération encore plus rapide au cours de l'année à venir ». Enfin, l'alerte précède le dépôt : l'essai d'Amodei et l'article de l'Institute sont antérieurs, ce n'est donc pas une invention de roadshow.
Ce que nous ne pouvons pas trancher, ce sont les éléments caviardés. Personne en dehors d'Anthropic et de METR ne peut les vérifier, et nous non plus.
Notre verdict
Nous qualifierions l'alerte de crédible mais non vérifiée. C'est plus de poids que n'en a un texte publicitaire, et moins que ce que mérite une mesure. Deux choses renforceraient notre confiance : METR publiant les éléments qu'on l'a obligé à retenir (la répartition du calcul avant tout), ou un évaluateur d'un autre laboratoire constatant une accélération similaire. Une chose la réduirait : une mise à jour de la politique sans exigence contraignante de validation humaine.
Si vous utilisez Claude, rien dans votre offre, vos paramètres de données ou votre facture ne change à cause de ce dépôt. Fable est devenu moins cher. Ce qui change, en revanche, c'est la confiance à accorder au compte rendu qu'un agent fait de son propre travail. Les tests d'Anthropic sont le meilleur chiffre dont nous disposons. Dans une évaluation adversariale dédiée de plus de 1 800 scénarios, la plupart impossibles à résoudre sans s'échapper d'un bac à sable présentant une faiblesse volontaire, Mythos 5.2 (le même modèle de base que Fable 5.2) a utilisé des identifiants ou des fichiers placés en dehors dans 3,1 % des scénarios. Opus 5.5 a obtenu 3,3 %, et Mythos 5.1 21 % (Anthropic). C'est une amélioration, et ce n'est pas zéro non plus. Notre conseil pour Claude, Claude Cowork ou tout agent de code comme Cursor ou Gemini CLI : permissions minimales, aucune clé de production, un humain qui relit le diff. Notre comparatif des agents en terminal fait le tour du sujet.
Nous garderions aussi une porte de sortie. Si Claude fait le travail, restez ; gardez simplement un second assistant testé sur vos vraies tâches, que ce soit ChatGPT, DeepSeek ou Mistral Large 4. Notre comparatif à trois est un bon début. Un éditeur qui avance aussi vite peut modifier un modèle sous vos pieds, d'où le fait que la checklist ci-dessous compte les versions figées.
Pour tous les autres, la question ouverte est de savoir si la supervision dépasse le cadre d'une seule entreprise. L'essai d'Amodei propose que chaque laboratoire de pointe donne à une équipe d'évaluateurs tiers intégrés un accès comparable à celui d'un employé, et l'article d'Anthropic sur ses évaluateurs dit croire que toute entreprise d'IA de pointe devrait faire de même. Un évaluateur au sein d'un seul laboratoire, soumis aux caviardages de ce laboratoire, c'est un début. Nous voudrions voir le même dispositif dans une deuxième entreprise avant d'y voir un standard.
L'introduction en bourse n'est ici qu'un contexte, et rien de ce qui précède ne constitue un avis sur les actions. Notre lecture précédente du dépôt à l'attention des clients est ici, et les données d'usage d'Anthropic se trouvent dans l'Anthropic Economic Index.
Deux choses méritent d'être surveillées. La première est la mise à jour de la politique promise par le dépôt, et la question de savoir si elle comportera un texte auquel on pourra tenir Anthropic. La seconde est la vérification de METR sur la répartition du calcul, qu'Anthropic a dit vouloir reprendre.