

La page tarifaire de Google affiche Gemini 4 Carbon à 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie. Quelques lignes plus bas, la même page précise que ces deux montants doublent à la fin de la période de lancement, c'est-à-dire d'ici quelques semaines (Google AI developer pricing). L'annonce de Google met en avant le tarif le plus bas. Nous, on budgétiserait avec le plus élevé.
Carbon est le modèle haut de gamme de la gamme Gemini 4 de Google. Il est arrivé auprès du public environ deux semaines après une phase limitée réservée aux équipes de sécurité (Google), accompagné d'une fonctionnalité en préversion appelée /swarm dans Google Antigravity. Voici les questions auxquelles nous voudrions des réponses avant d'y toucher : ce qu'est un swarm, qui peut en lancer un, ce que ça coûte, où ça pèche, et comment ça se positionne face à Claude Fable 5.2 et GPT-6 Astra. Tout provient des pages de Google, du changelog de GitHub, d'Artificial Analysis et de la presse. Nous n'avons pas testé Carbon nous-mêmes.
Un swarm, c'est un coordinateur, des workers et un vérificateur autour d'un même tableau
La documentation d'Antigravity le décrit sans détour. Quand vous tapez /swarm suivi d'une tâche, votre conversation en cours devient le coordinateur. Il découpe le travail en morceaux qui ne se chevauchent pas (un worker par fichier ou par package, par exemple), donne à chaque worker un brief public et un contexte vierge, et ajoute généralement un vérificateur pour deux à quatre workers. Le vérificateur lit les diffs, lance les tests et signale les problèmes au worker qui a écrit le code (documentation Antigravity).
Tout le monde échange sur un tableau partagé. Les workers ne s'écrivent pas en privé. Un worker qui n'a rien à faire se met en veille et ne consomme aucun token tant que personne ne le mentionne, et un worker de surveillance ne se manifeste que si toute l'équipe est restée silencieuse avant la fin du travail. L'annonce de Google résume l'idée en une phrase : « transformer un simple prompt en une équipe coordonnée d'agents que vous pouvez suivre en temps réel ».
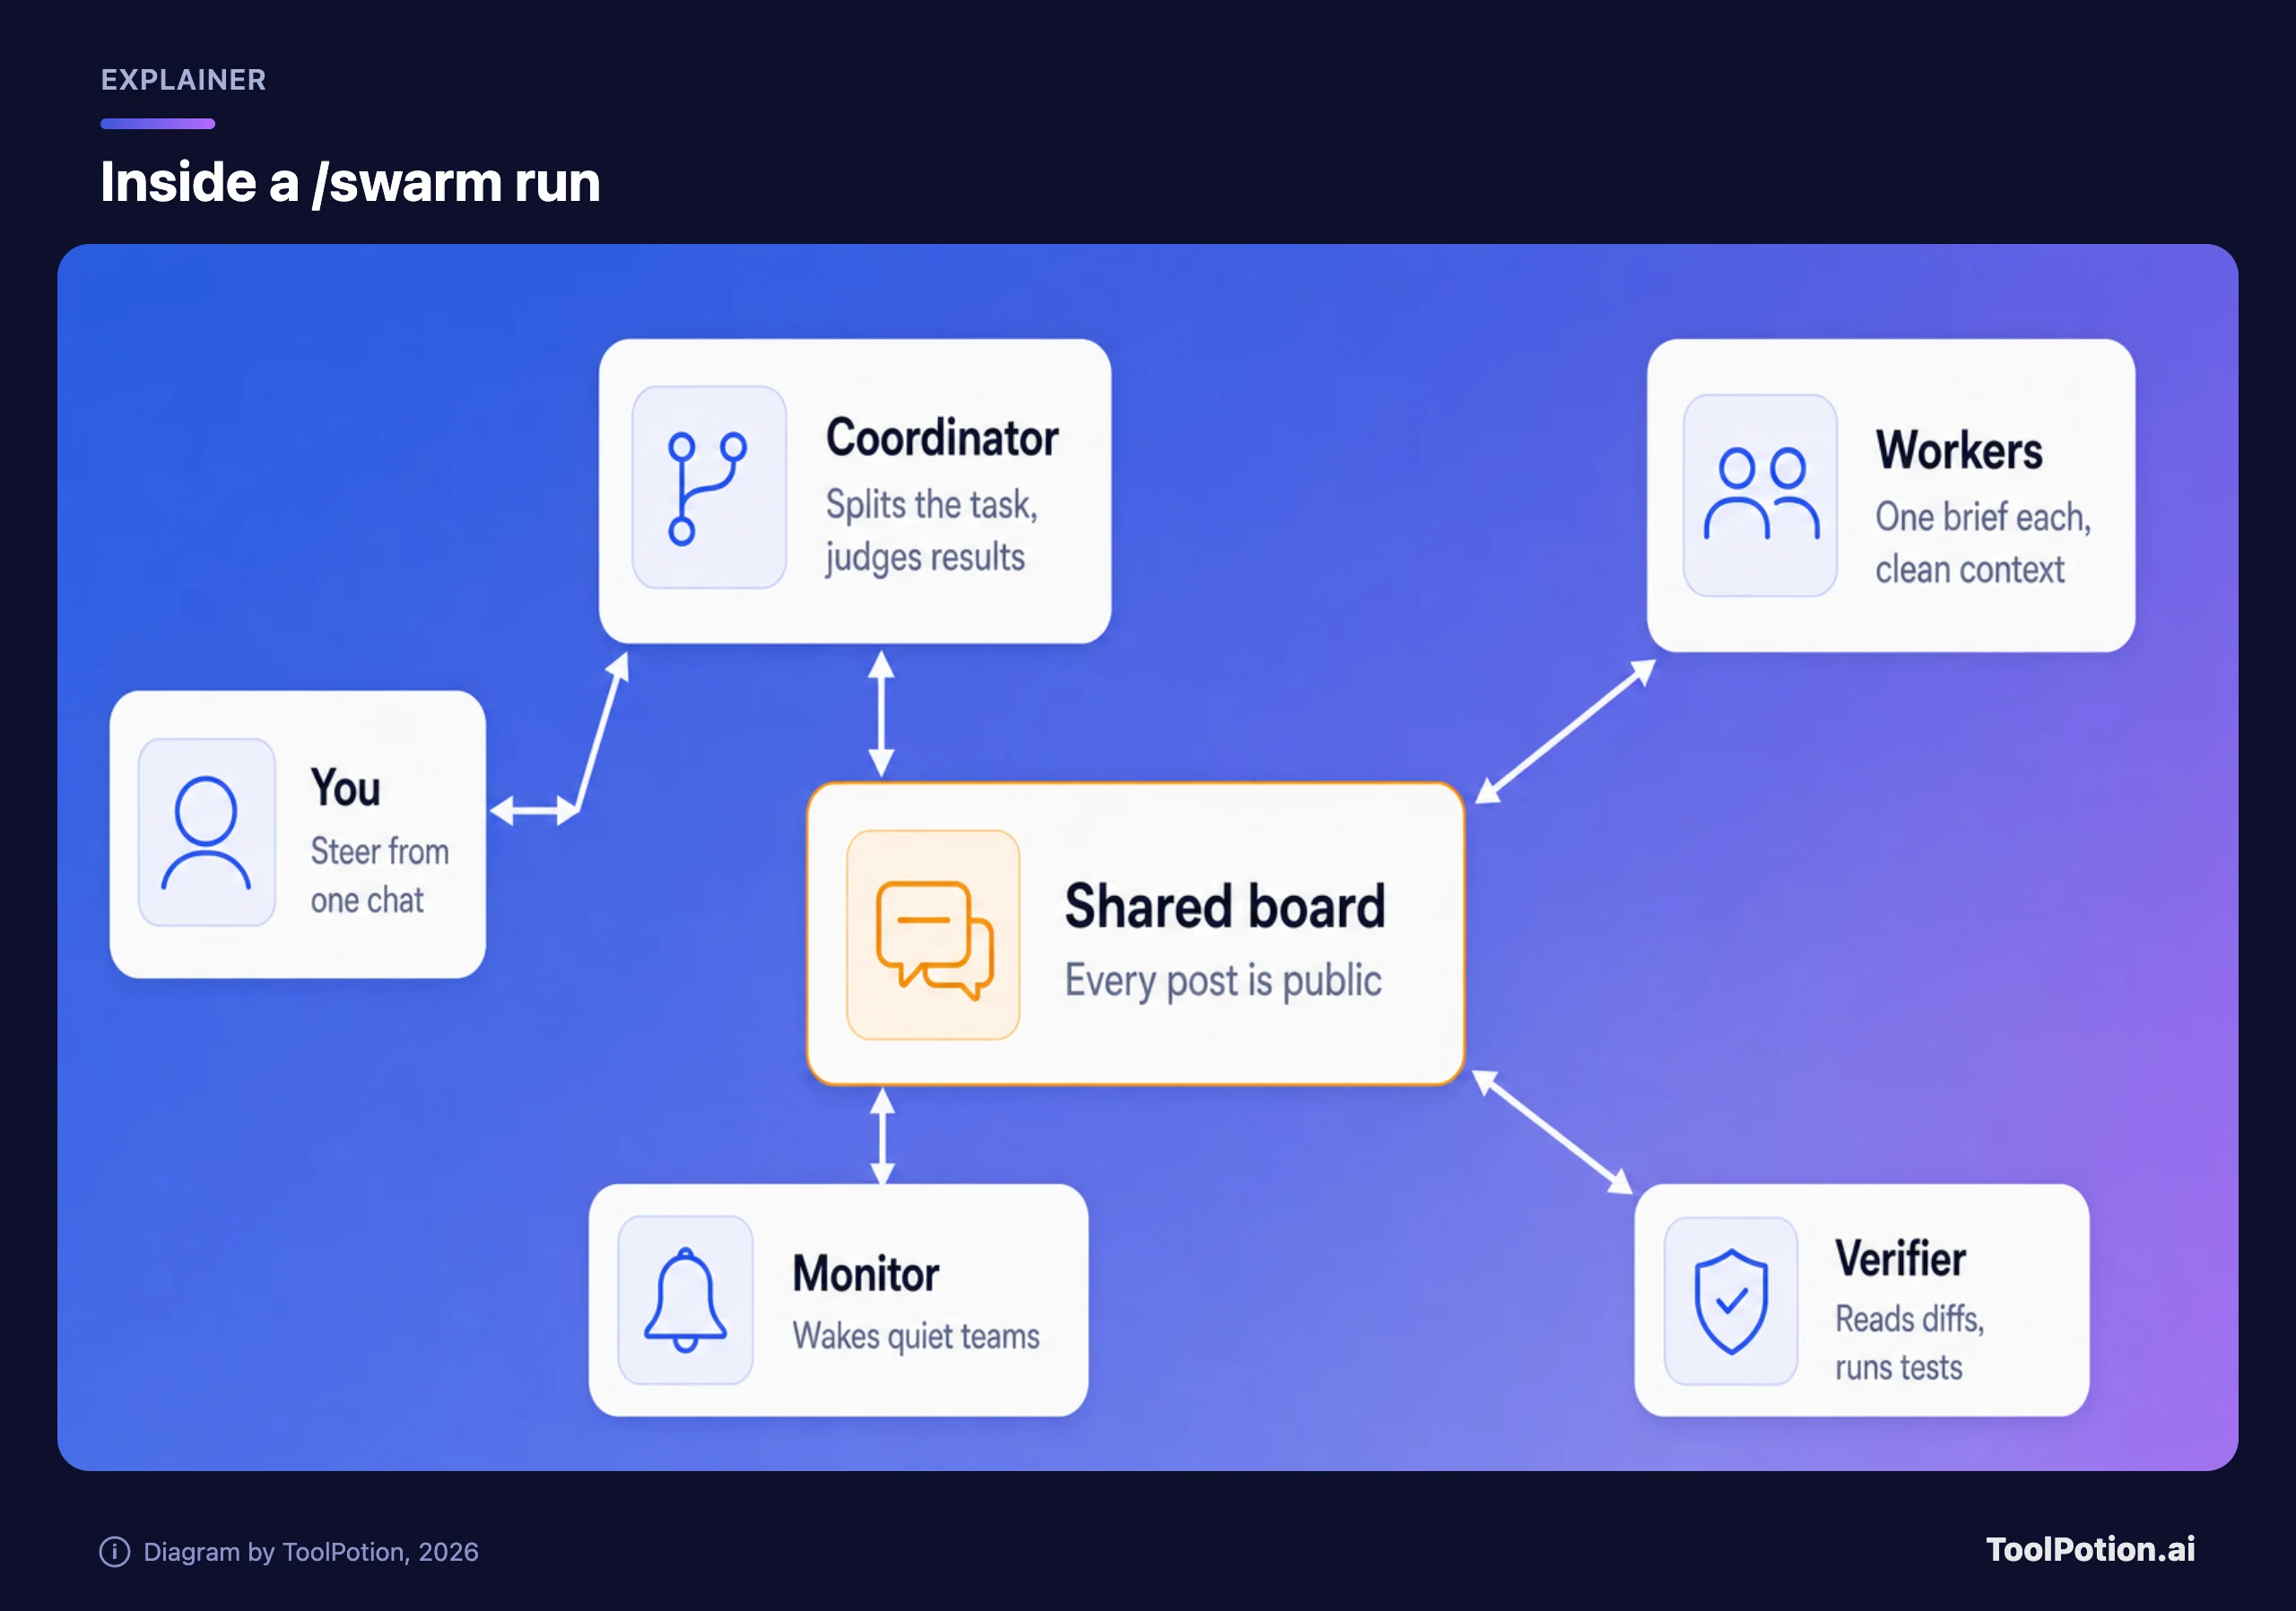
Les workers tournent sur le même modèle que votre conversation, sauf si vous en demandez un autre, et la documentation inclut un exemple de prompt qui place le vérificateur sur un modèle différent de celui des workers. L'annonce de Google suggère de réserver Carbon aux rôles qui demandent le raisonnement le plus poussé (architecture, coordination, audit), avec des modèles plus rapides et plus légers pour le travail en parallèle. Quand plusieurs workers éditent en même temps, le coordinateur peut donner à chacun sa propre copie de votre dépôt.
Google situe aussi swarm par rapport à ses cousins. Les subagents s'occupent d'une tâche annexe. /boost sert pour les problèmes difficiles plutôt que volumineux. /teamwork pilote des projets à plusieurs jalons, avec un entretien de cadrage et des points de contrôle d'audit. /swarm est pour le travail « volumineux mais qui se divise proprement ». Cette dernière formule est le test que nous garderions en tête. Cinq workers sur une tâche qui ne se découpe pas, ce sont cinq agents qui s'attendent les uns les autres, et vous payez pour tous.
Swarm est ouvert à Pro, Carbon surtout à Ultra
Swarm est en préversion, et Google indique qu'il fonctionne avec les offres Google AI Pro et AI Ultra, dans l'Antigravity App comme dans l'Antigravity CLI. Carbon est plus restreint. Selon l'annonce de Google, l'API est ouverte à tous les développeurs et entreprises payants via Google AI Studio et Gemini for business (l'application Gemini Enterprise en est la porte d'entrée côté entreprise). Côté grand public, il est déployé progressivement pour les abonnés Google AI Ultra dans Antigravity, l'application Gemini et le mode IA de la Recherche.
La page d'abonnement américaine de Google range Argon, le petit frère plus léger, sous AI Pro à 19,99 $ par mois, et Carbon sous Ultra, qui démarre à 99,99 $ par mois pour cinq fois les limites d'usage de Pro et monte à 199,99 $ pour vingt fois (Google). En croisant les deux pages, un abonné Pro peut lancer un swarm, mais pas sur Carbon, et le tableau des modèles d'Antigravity le confirme : Carbon est coché pour Ultra et Enterprise, pas pour Pro (documentation Antigravity). Ni l'annonce ni la page d'abonnement ne disent quand, ni même si, Pro y aura droit. Les utilisateurs gratuits n'ont rien : la page tarifaire indique Carbon « Not available » sur l'offre API gratuite, et Business Insider affirme que Carbon et Argon sont réservés aux utilisateurs payants.
GitHub Copilot est l'autre porte d'entrée. Carbon y est en disponibilité générale pour Copilot Pro+, Max, Business et Enterprise, sélectionnable dans le sélecteur de modèles de VS Code, Visual Studio, des IDE JetBrains, de Xcode, d'Eclipse, du Copilot CLI, du coding agent, de github.com et des applications mobiles, avec un déploiement progressif (changelog GitHub). Le changelog ne mentionne pas swarm, donc nous considérerions GitHub Copilot et le Copilot CLI comme des moyens d'utiliser le modèle, pas la fonctionnalité.
Un réglage par défaut mérite votre attention si vous administrez une équipe. Avec l'activation des modèles par défaut, explique GitHub, les nouveaux modèles sont automatiquement activés, sauf si un administrateur a désactivé le réglage global par défaut ou désactive explicitement le modèle. Carbon est facturé au prix catalogue du fournisseur : un développeur qui le choisit dans la liste déroulante dépense donc votre argent au tarif du modèle. Fable 5.2 fonctionne à l'inverse : sa politique reste désactivée tant qu'un administrateur ne l'active pas (changelog GitHub). Vérifiez la politique Carbon avant que le déploiement n'atteigne votre organisation.
Le prix double d'ici quelques semaines
Sur l'API Gemini, le tarif standard de Carbon est de 2 $ en entrée et 10 $ en sortie par million de tokens pendant la période de lancement, puis 4 $ et 20 $. Les tokens de réflexion comptent comme de la sortie. L'entrée en cache coûte 0,10 $ aujourd'hui et 0,20 $ ensuite, et seul le cache implicite fonctionne (le cache explicite n'est pas pris en charge). Batch et Flex sont facturés à moitié prix du tarif standard, Priority à 3,60 $ et 18 $ pour l'instant. L'ancrage dans la Recherche Google donne 5 000 requêtes gratuites par mois (partagées entre Gemini 3 et les modèles plus récents), puis 14 $ les 1 000. Argon a les mêmes prix par token, son économie se joue donc sur le nombre de tokens, pas sur les tarifs (page tarifaire).
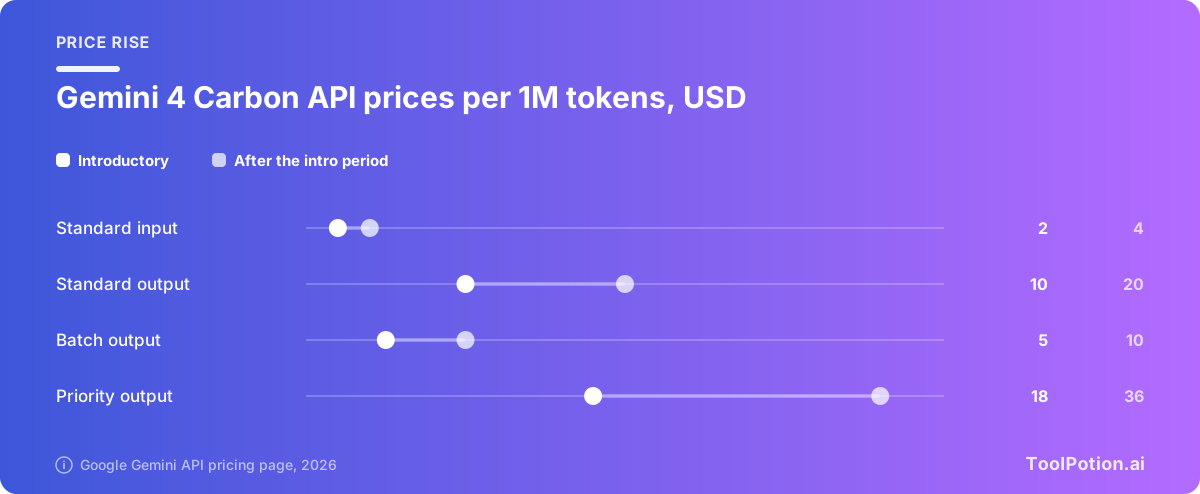
Même doublé, Carbon reste moins cher par token que les deux concurrents ci-dessous. Mais le prix par token n'est pas le prix par tâche : les modèles ne consomment pas le même nombre de tokens pour le même travail, et les chiffres mesurés de la section suivante vont à l'encontre du prix affiché.
Un swarm est plus difficile à chiffrer. Avec un abonnement, vous payez en quota, et la documentation est claire : « Chaque worker est son propre agent, donc un swarm consomme le quota bien plus vite qu'une seule conversation. » Un worker à court de quota se met en pause et le reste jusqu'à ce que quelqu'un poste sur le tableau, que son modèle soit changé ou que vous lui écriviez. Il ne redémarre pas quand votre quota se renouvelle (documentation Antigravity). Google ne dit pas combien de tokens consomme une exécution de swarm typique. Un quota qui se recharge selon un calendrier, sans chiffre par exécution, c'est exactement le genre de coût que nous n'aimons pas. Tant que Google n'en publie pas, nous traiterions un swarm comme un multiplicateur de ce que vous coûte un seul agent.
Dans Copilot, c'est plus simple. Le modèle est facturé au prix catalogue dans le cadre de la facturation à l'usage, et la grille tarifaire de GitHub affiche les mêmes 2 $ et 10 $, avec le même doublement à la fin de la période de lancement (GitHub Docs).
Où Carbon est-il en défaut ?
Google est transparent sur le principal point faible. Carbon dépense plus de tokens de réflexion qu'Argon pour explorer et vérifier, ce qui « augmente la consommation de tokens et la latence par tour » (Google AI docs). Les notes de migration indiquent que les prompts difficiles « peuvent prendre plusieurs minutes » et recommandent aux développeurs de régler des timeouts client d'au moins 15 minutes, de relever le max output tokens à 32 768 ou plus, car Carbon peut consacrer une plus grande part de cette limite à la réflexion, et d'arrêter d'envoyer temperature, top_p et top_k, qui sont ignorés.
Artificial Analysis, un organisme indépendant de benchmarks, a mesuré le même travers. Sa page qualifie le modèle de « notablement lent par tâche et très verbeux ». Carbon a écrit 205 millions de tokens sur l'ensemble de l'Intelligence Index, contre une médiane de 72,8 millions pour des modèles comparables, et a pris 25,3 minutes par tâche contre une médiane de 12,7 minutes (Artificial Analysis).
La page du modèle n'indique que la sortie texte. Pas de génération d'images, pas de génération audio, pas de Live API (page du modèle). L'injection de prompt est l'autre point en suspens. Google annonce un taux de réussite d'attaque de 0 % sur le benchmark d'injection indirecte de Gray Swan, puis ajoute qu'il sait que « la robustesse face à l'injection de prompt reste un domaine à améliorer » (Google). Pour nous, cette phrase pèse plus lourd que le 0 %, parce que les agents qui lisent des pages web et des PDF sont précisément le cas d'usage que Google vend, et qu'un swarm en lit davantage à la fois.
Reste la question des preuves. La plupart des éloges de l'annonce viennent d'entreprises que Google a choisi de citer. Un client évoque « 16 vrais correctifs de bugs » dans son code pour justifier un taux de résolution de 94 %, un échantillon si petit qu'un échec de plus ferait bouger le chiffre de six points. Kit Langton, d'OpenCode, qualifie Carbon de « modèle de planification privilégié pour nos tâches les plus difficiles », un avis utile de la part de quelqu'un qui conçoit des outils de code, mais c'est une seule voix dans un article rédigé par le fournisseur. Les démos ne nous convainquent pas davantage : la reconstitution de bureau à 906 000 triangles et l'exposition de la tour Eiffel sont des essais menés par Google lui-même. Nous attendrions des résultats de gens qui ne figurent pas dans le communiqué.
Moins cher par token que Fable 5.2 et Astra, pas toujours par tâche
Au prix catalogue, Carbon l'emporte largement. Au tarif de lancement, Carbon coûte par token un cinquième de GPT-6 Astra et un quart de Claude Fable 5.2, arrivé dans GitHub Copilot un jour avant Carbon (changelog GitHub). Après le doublement, c'est deux cinquièmes et la moitié. Les pages des éditeurs (OpenAI, Anthropic) donnent les chiffres du tableau ci-dessous.
| Modèle | Entrée / sortie par million de tokens | Où l'utiliser | Coût mesuré par tâche |
|---|---|---|---|
| Gemini 4 Carbon | 2 $ / 10 $ actuellement, 4 $ / 20 $ ensuite | API Gemini payante, Google AI Ultra, Antigravity (Ultra), Copilot Pro+, Max, Business, Enterprise | $7.76 |
| GPT-6 Astra | 10 $ / 50 $ (entrées jusqu'à 272K) | API OpenAI, GitHub Copilot | $6.24 |
| Claude Fable 5.2 | $8 / $40 | API Claude, Copilot Pro+, Max, Business, Enterprise | $26.54 |
La dernière colonne correspond au coût moyen d'Artificial Analysis pour exécuter son Intelligence Index, et pour Carbon, elle utilise le tarif doublé. Par tâche, Carbon (7,76 $) coûte plus cher qu'Astra (6,24 $) malgré un prix par token inférieur, parce qu'il écrit beaucoup plus de tokens. Fable 5.2 est bien plus cher, à 26,54 $, et le plus lent des trois avec 48 minutes par tâche, mais il domine aussi le graphique comparatif de la page avec un score de 65 contre 60 pour Carbon et 57 pour Astra (Artificial Analysis). Une réserve : l'index indique Carbon en réflexion high et les deux autres en max. Au tarif de lancement, le chiffre de Carbon serait à peu près divisé par deux, soit environ 3,90 $ d'après nos calculs, ce qui le placerait sous Astra tant que la remise dure.
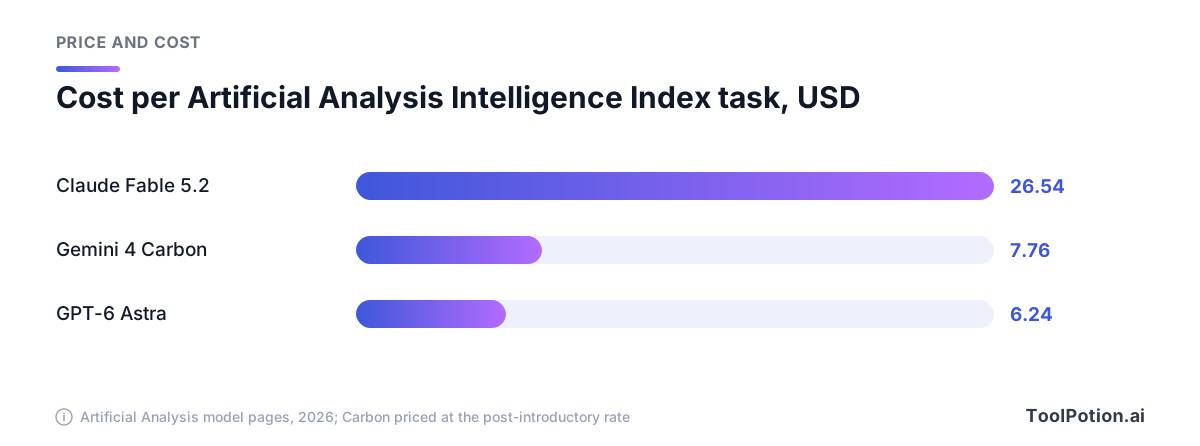
L'affirmation de Google est différente. Il dit que Carbon se classe premier sur CursorBench 4.0 de Cursor, WANDR de Perplexity et AutomationBench de Zapier, avec un coût par tâche plus de deux fois inférieur à celui du meilleur modèle externe suivant (Google). Ce ne sont pas les mêmes tâches que celles d'Artificial Analysis, et Google a choisi lesquelles citer. Les deux peuvent être vrais. Nous doutons que l'économie se retrouve sur votre dépôt sans test.
Les conditions sur les données diffèrent aussi. Le changelog de GitHub indique que Claude Fable 5.2 « exige par défaut la conservation des données » pour faire tourner les classifieurs de sécurité d'Anthropic, la rétention zéro n'étant disponible que pour certains clients entreprise éligibles (changelog GitHub). La page tarifaire de Google précise que le contenu envoyé sur l'offre payante de l'API Gemini n'est pas utilisé pour améliorer ses produits. Les valeurs par défaut sont une question de politique, et sur ce point, celle de Google est plus avenante.
Le calculateur ci-dessous utilise les prix catalogue. Saisissez les volumes de tokens issus de vos propres exécutions, pas des nôtres, car les trois modèles consomment des quantités très différentes pour le même travail.
Quand y aurions-nous recours ?
Pour le travail quotidien, notre choix est Argon. Google le dit lui-même : Argon « reste le choix idéal pour la majorité des tâches d'ingénierie logicielle et de travail intellectuel », tandis que Carbon est « conçu pour les tâches qui testent les limites de l'intelligence d'un modèle » (Google). Carbon justifie ses tokens sur les migrations multi-packages, les chasses à la cause racine à travers plusieurs sous-systèmes et les audits de sécurité, les travaux que cite la documentation. Un swarm ne justifie son quota que lorsque la tâche se découpe en morceaux qui ne se touchent pas.
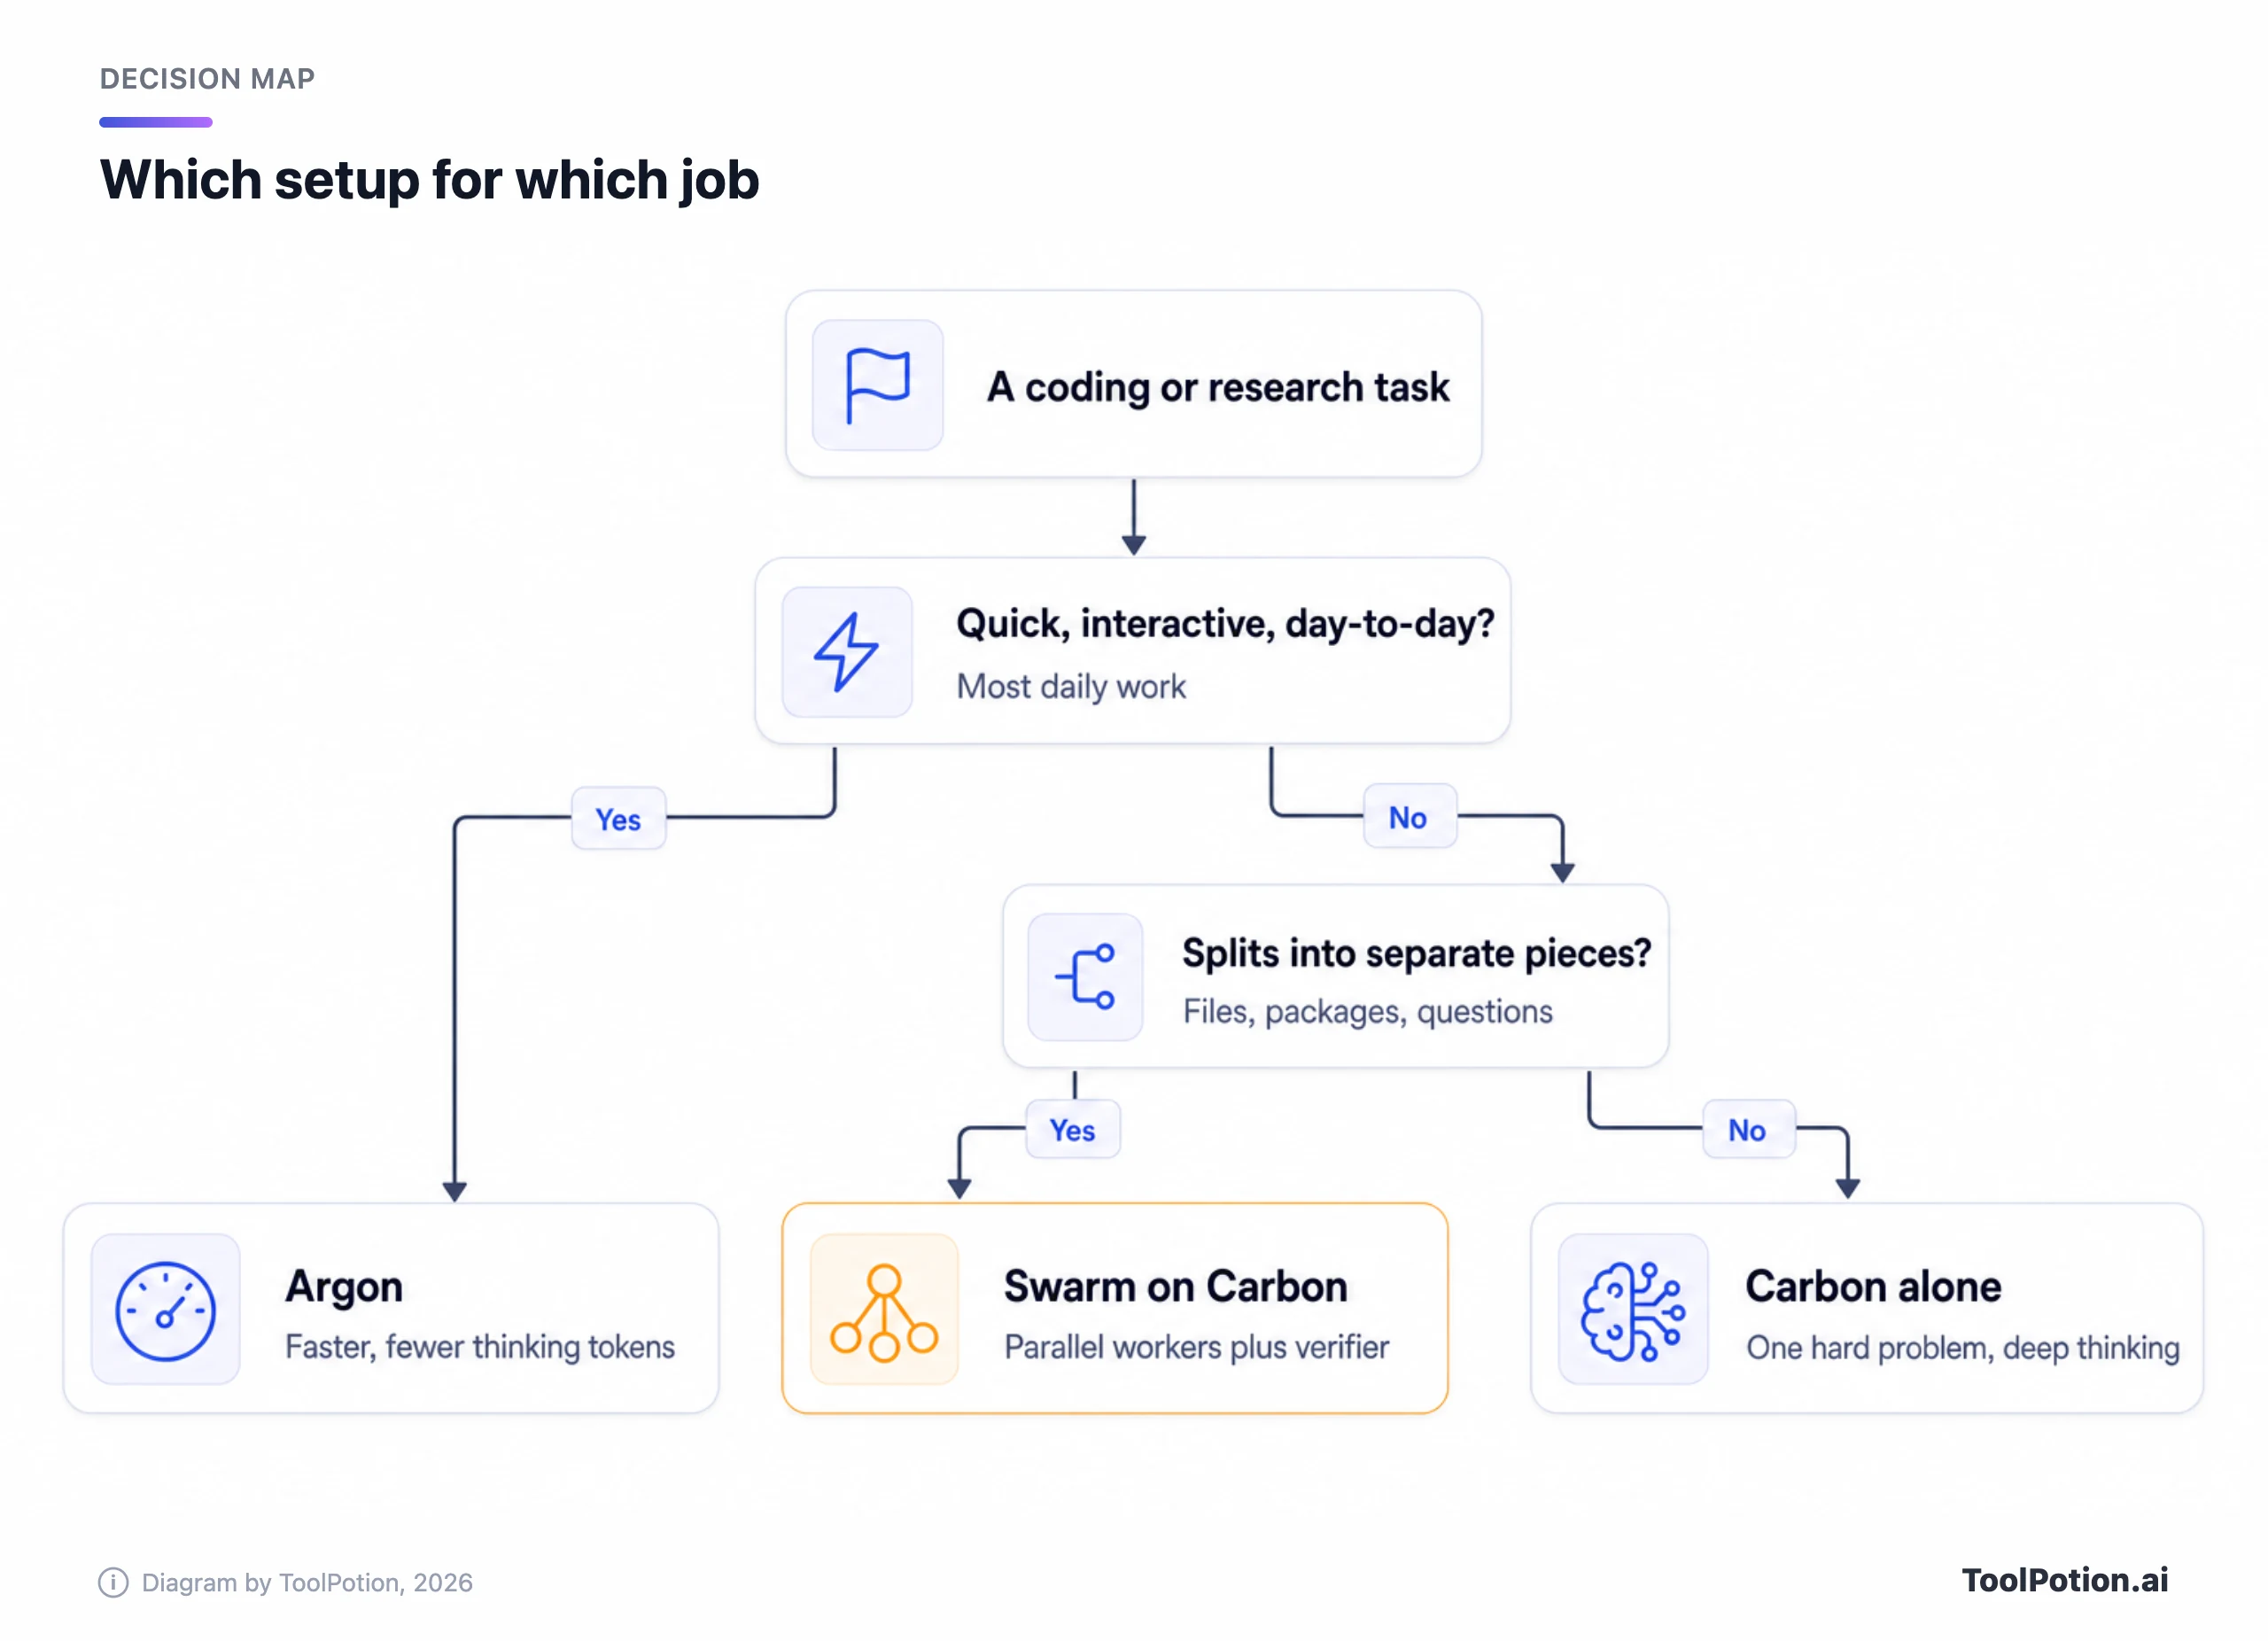
- Lancez d'abord le travail sur Argon. La plupart du temps, il suffira.
- Si Argon ne suffit pas, essayez Carbon au niveau de réflexion medium par défaut, puis high. Le conseil de Google lui-même est de tester les trois niveaux et de retenir le plus bas qui atteint votre seuil (Google AI docs).
- Ne lancez /swarm que pour du travail qui se divise par fichier, par package ou par question, et demandez un vérificateur sur un modèle différent de celui des workers.
- Budgétisez à 4 $ et 20 $, pas à 2 $ et 10 $.
Côté budget, nous éviterions Ultra si Carbon est la seule raison de l'acheter. À partir de 99,99 $ par mois, c'est beaucoup pour un seul modèle alors que l'API le vend au token sur un solde prépayé. Essayez-le là avec un petit budget, et reconsidérez si vous vous retrouvez à faire tourner des agents toute la journée. Si votre équipe vit dans un éditeur, le sélecteur de Copilot est le test le plus simple à mettre en place ; notre article sur Copilot Fusion explique ce que le routage de modèles y change pour les coûts, et notre comparatif Cursor, Copilot et Windsurf traite des éditeurs eux-mêmes. Si vous cherchez des outils d'agents, vous pouvez parcourir tous les classements ToolRank des agents IA ou le hub des agents IA.
Hydrogen est une rumeur, pas un produit
Google a peut-être quelque chose de plus léger en préparation, mais pour l'instant, ce n'est qu'un écho de presse. Business Insider affirme que Google laisse ses employés tester un modèle rapide appelé Hydrogen, en citant un message interne dans lequel un ingénieur le qualifie de « très capable, rapide et efficace ». Un employé a confié au média qu'il ressemble aux modèles Flash de Google, les bêtes de somme moins chères. BI précise qu'on ignore si une sortie publique serait gratuite ou payante, et Google n'a pas souhaité commenter (Business Insider). Aucun nom, prix ni date n'a été annoncé. Si ce sont les workers légers d'un swarm qui feraient grimper votre facture, Hydrogen est le modèle à surveiller. Nous ne bâtirions pas de plan dessus.
Foire aux questions
Gemini 4 Carbon est-il gratuit à l'essai ?
Non. La page tarifaire de Google le marque comme indisponible sur l'offre API gratuite, et dans l'application Gemini, il faut Google AI Ultra. Le moyen le moins cher d'y accéder est un solde API payant.
Google s'entraîne-t-il sur mes données API ?
La page tarifaire de Google indique que le contenu de l'offre payante n'est pas utilisé pour améliorer ses produits. L'offre gratuite est un autre sujet pour d'autres modèles, mais Carbon n'y est pas proposé.
Carbon peut-il générer des images ou de la voix ?
Non. Il accepte en entrée du texte, des images, de la vidéo, de l'audio et des PDF, et ne renvoie que du texte ; la génération d'images, la génération audio et la Live API sont indiquées comme non prises en charge sur sa page de modèle.
Quelle est la taille de la fenêtre de contexte ?
Une seule fenêtre partagée de 1 048 576 tokens pour l'entrée, la réflexion et la sortie. Une réponse normale est plafonnée par défaut à 65 536 tokens, et l'exécution en arrière-plan avec décodage long permet à une seule réponse d'aller jusqu'à la taille de la fenêtre moins votre entrée.
/swarm fonctionne-t-il dans l'application Gemini ?
La documentation de Google ne mentionne que l'Antigravity App et l'Antigravity CLI.
Que faire avant la fin du tarif de lancement ?
Relancez l'une de vos propres tâches sur Carbon aux trois niveaux de réflexion, puis chiffrez les volumes de tokens à 4 $ et 20 $. Ce second chiffre est celui avec lequel vous devrez vivre.