Description
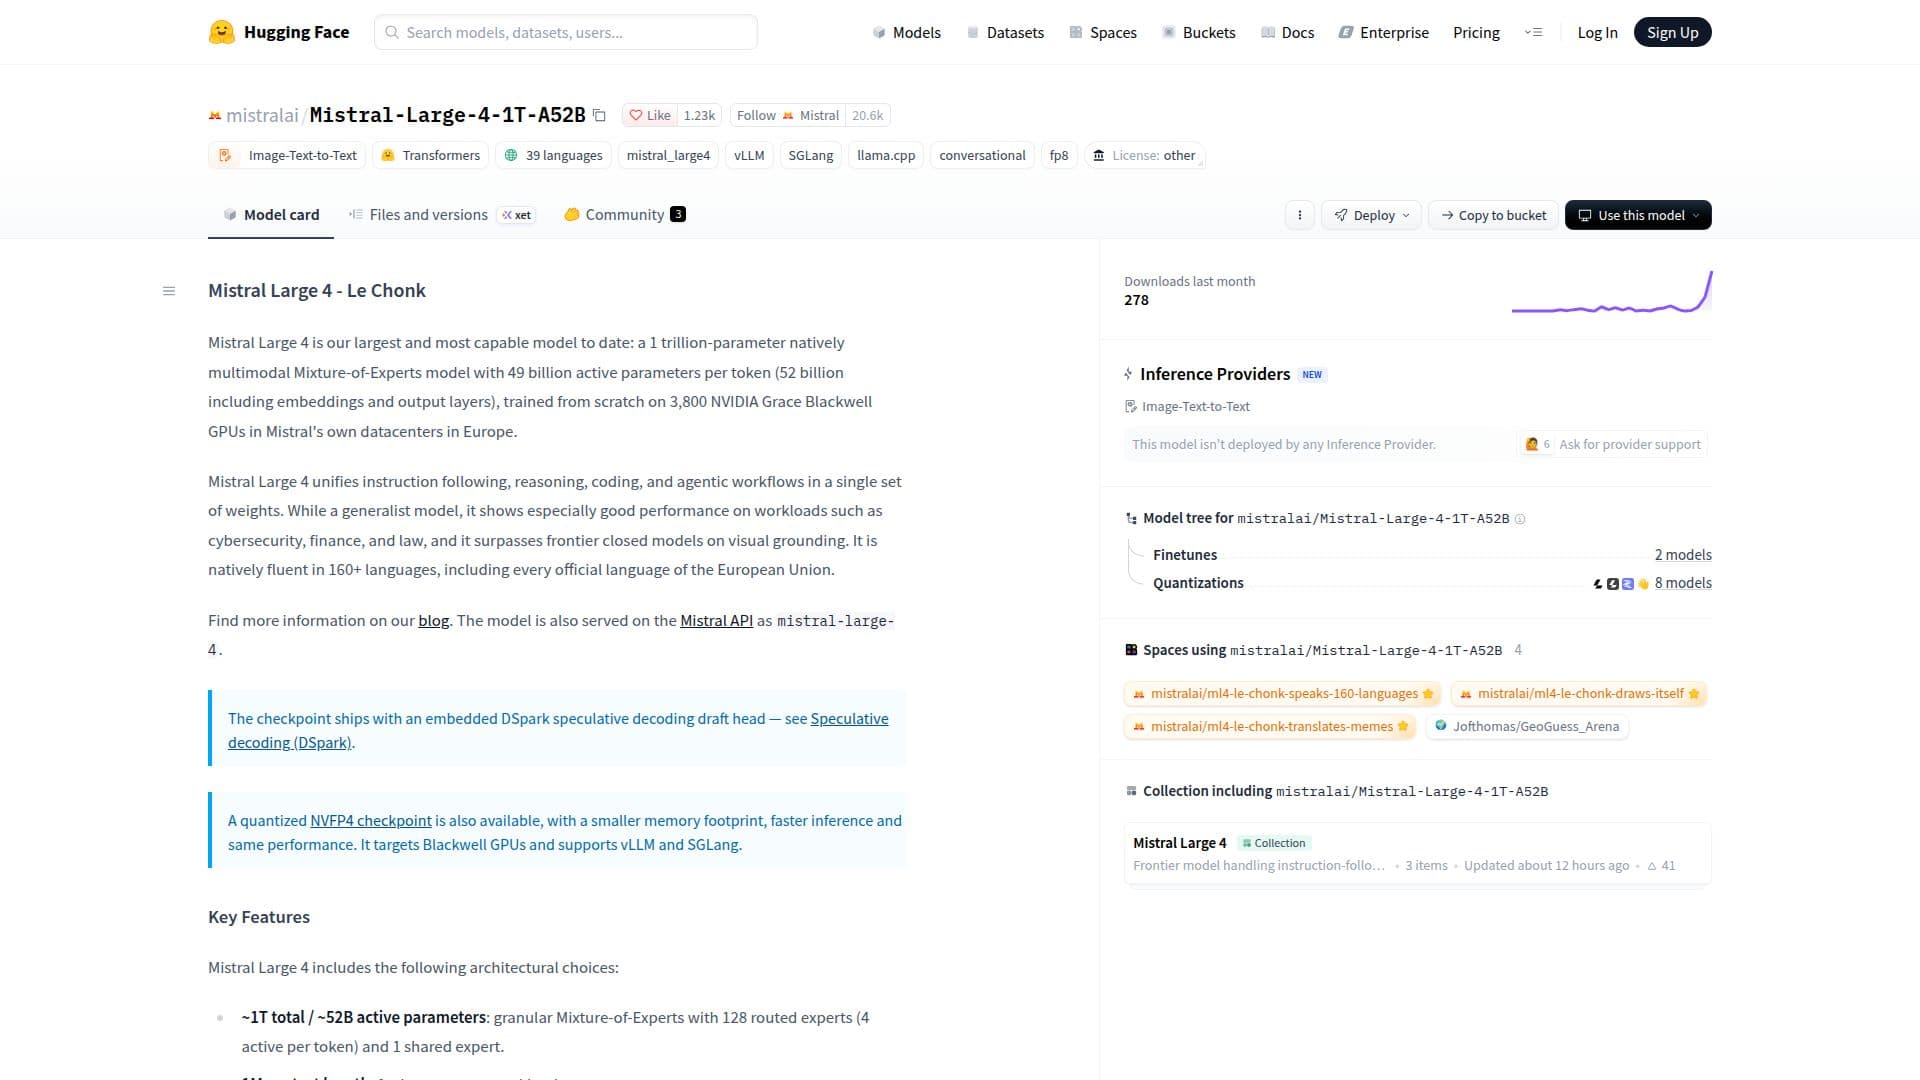
Mistral Large 4, également connu sous le nom de « Le Chonk », représente le modèle le plus avancé et le plus capable de Mistral à ce jour. C'est un modèle Mixture-of-Experts nativement multimodal avec 1 trillion de paramètres, comportant 49 milliards de paramètres actifs par token (52 milliards en incluant les embeddings et les couches de sortie). Le modèle a été entraîné à partir de zéro sur 3 800 GPU NVIDIA Grace Blackwell dans les centres de données européens de Mistral, garantissant des performances robustes et une évolutivité.
Lire la suite
Ce modèle généraliste unifie le suivi d'instructions, le raisonnement, la programmation et les flux de travail agentiques en un seul ensemble de poids. Bien qu'il soit polyvalent dans de nombreux domaines, Mistral Large 4 démontre des performances exceptionnelles dans des domaines spécialisés tels que la cybersécurité, la finance et le droit. Il surpasse également les modèles fermés de pointe en matière de capacités de ancrage visuel, ce qui le rend très efficace pour les tâches impliquant l'analyse d'images.
Une force clé de Mistral Large 4 est sa fluidité native dans plus de 160 langues, englobant toutes les langues officielles de l'Union européenne. Ce large soutien linguistique en fait un outil puissant pour des applications mondiales. Le modèle dispose d'une longueur de contexte substantielle de 1M, lui permettant de gérer efficacement des charges de travail à long contexte. Sa capacité d'entrée multimodale lui permet d'accepter à la fois des entrées textuelles et des images, générant des sorties textuelles.
Architecturalement, Mistral Large 4 utilise un design granulaire Mixture-of-Experts avec 128 experts routés, où 4 experts sont actifs par token, en plus d'un expert partagé. Il comprend également une tête de décodage spéculatif DSpark intégrée, qui peut considérablement accélérer le décodage sans altérer les sorties du modèle cible, offrant jusqu'à 1,9x de débit plus élevé dans certains scénarios. Un point de contrôle NVFP4 quantifié est également disponible, offrant une empreinte mémoire plus petite, une inférence plus rapide et des performances équivalentes, ciblant spécifiquement les GPU Blackwell et prenant en charge vLLM et SGLang.
Mistral Large 4 est publié sous la licence Mistral Ecosystem Open-Weight License, une licence MIT modifiée qui permet une utilisation commerciale et non commerciale. Cependant, l'exploitation d'une entreprise Model-as-a-Service avec Mistral Large 4 nécessite une licence commerciale distincte de Mistral. Le modèle est disponible sur l'API Mistral sous le nom `mistral-large-4` et peut être déployé et affiné à l'aide de diverses bibliothèques telles que vLLM, SGLang, Transformers, llama.cpp, Axolotl, Unsloth et TRL.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesWeb
Points forts de Mistral Large 4
1 Trillion Total Parameters
52 Billion Active Parameters per Token
Natively Multimodal Input (Text and Image)
1 Million Context Length
Multilingual Support (160+ languages)
Configurable Reasoning Mode (Low, Medium, High)
Advanced Vision Capabilities for Image Analysis
Strong System Prompt Adherence
Native Function Calling and JSON Output
Strict JSON Schema Enforcement
State-of-the-Art Cybersecurity Performance
Embedded DSpark Speculative Decoding Draft Head
Quantized NVFP4 Checkpoint Available
Open-Weight License for Commercial and Non-Commercial Use
Premiers pas avec Mistral Large 4
Access Model: Trouvez Mistral Large 4 sur Hugging Face ou via l'API Mistral.
Deploy with vLLM: Utilisez l'image Docker officielle vLLM pour une inférence prête pour la production, en configurant des paramètres comme `--tool-call-parser mistral` et `--reasoning-parser mistral`.
Deploy with SGLang: Utilisez l'image Docker officielle SGLang, en activant le décodage spéculatif avec `--speculative-algorithm DSPARK`.
Deploy with Transformers: Installez Transformers depuis le dépôt principal et utilisez l'extrait d'inférence Python fourni pour le déploiement sur plusieurs GPU.
Fine-tune Model: Utilisez des bibliothèques comme Axolotl, Unsloth ou TRL pour affiner Mistral Large 4.
Integrate with Mistral Vibe: Installez Mistral Vibe et configurez-le pour utiliser Mistral Large 4 via l'API Mistral ou un serveur vLLM local.
Configure Reasoning Effort: Définissez `reasoning_effort` sur 'low', 'medium' ou 'high' en fonction de la complexité de l'invite.
Utilize System Prompts: Définissez des environnements et des cas d'utilisation clairs avec des invites système pour un usage efficace des outils.
Cas d'utilisation de Mistral Large 4
- Flux de travail agentiques complexes
- Analyse de cybersécurité
- Modélisation et analyse financières
- Traitement de documents juridiques
- Communication multilingue
- Récupération d'informations à long contexte
- Analyse d'images et de graphiques
- Génération et débogage de code
- Suivi d'instructions et automatisation
- Chatbot et IA conversationnelle