Description
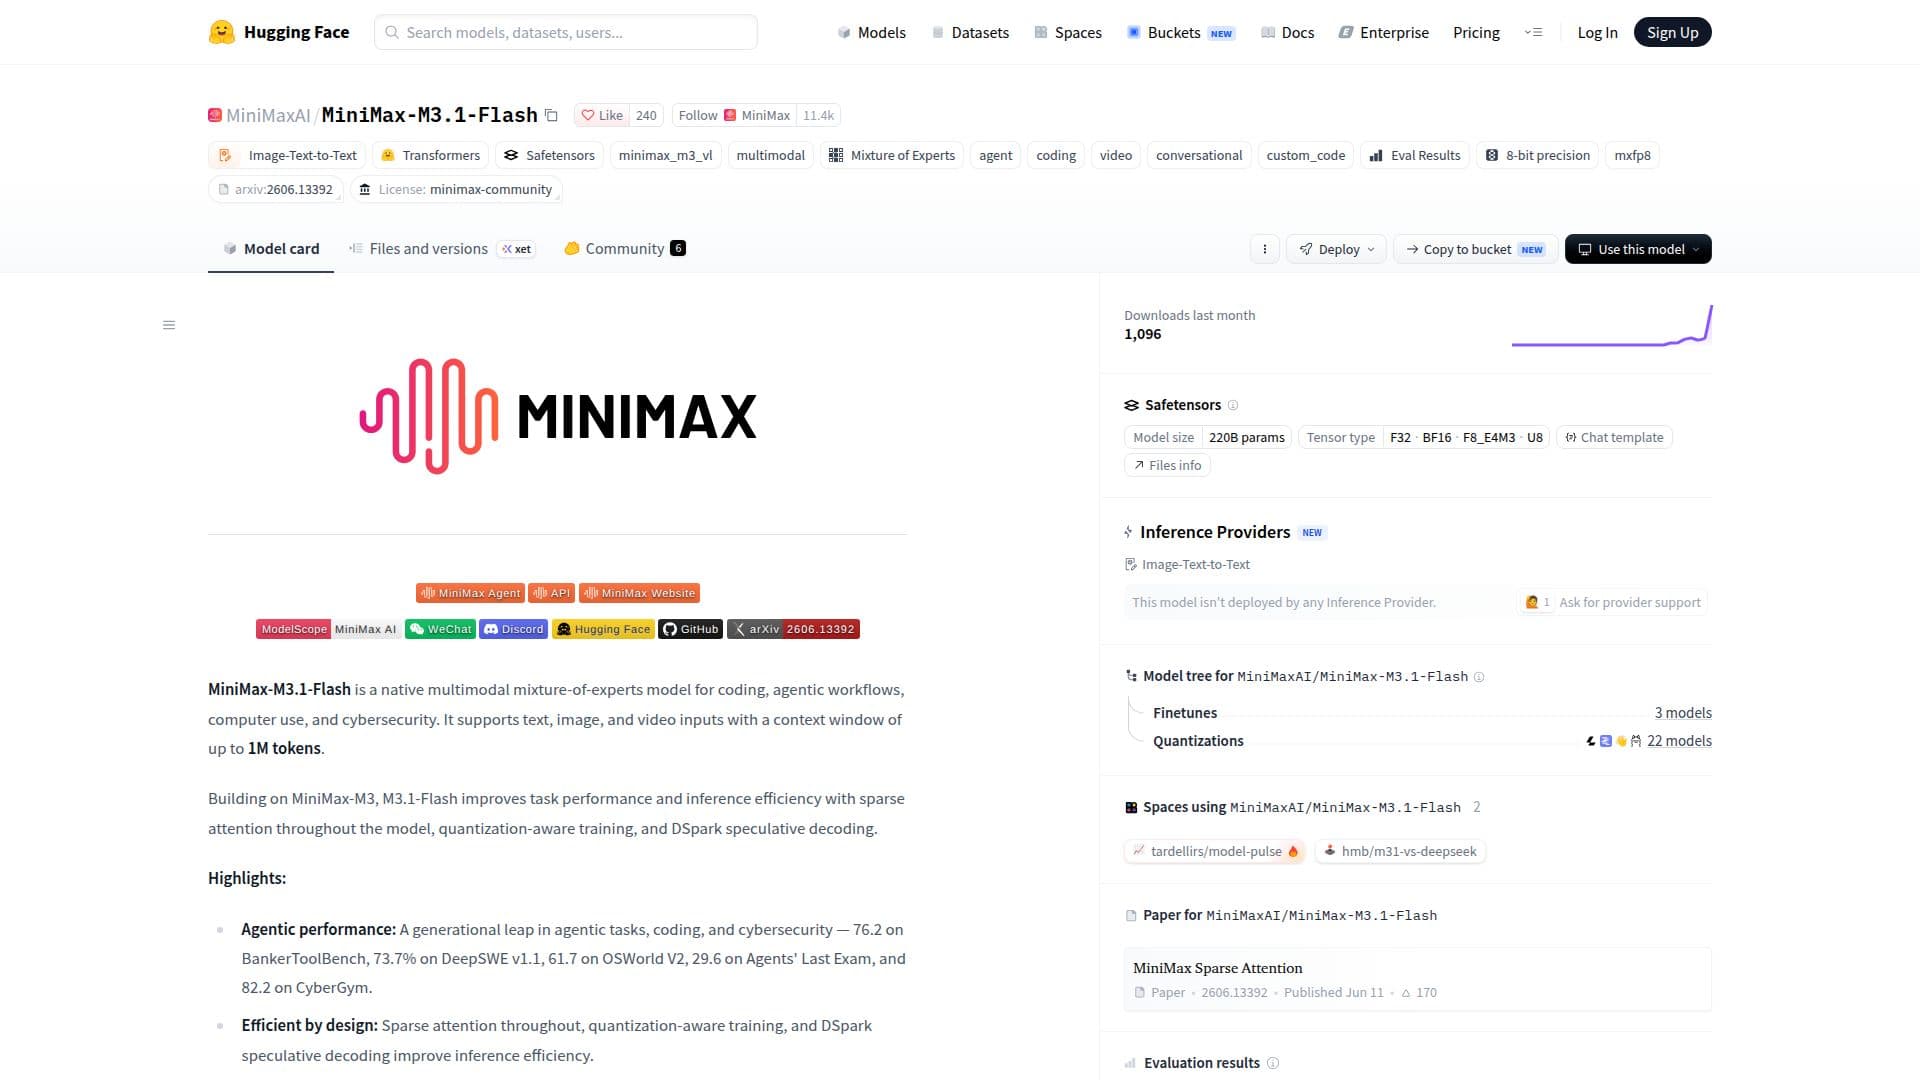
MiniMax-M3.1-Flash est un modèle avancé de mélange d'experts multimodal développé pour améliorer le codage, les flux de travail agentiques, l'utilisation des ordinateurs et la cybersécurité. Ce modèle prend en charge les entrées de texte, d'image et de vidéo, fournissant une fenêtre contextuelle allant jusqu'à 1 million de tokens. S'appuyant sur l'architecture MiniMax-M3, M3.1-Flash introduit des améliorations dans la performance des tâches et l'efficacité d'inférence grâce à l'utilisation d'une attention sparse dans tout le modèle, d'un entraînement conscient de la quantification et du décodage spéculatif DSpark.
Lire la suite
L'architecture du modèle est conçue pour gérer une large gamme d'entrées et de sorties, avec environ 428 milliards de paramètres, dont 23 milliards sont activés par token. Cela permet un traitement efficace et une haute performance sur divers benchmarks, y compris un score de 76,2 sur BankerToolBench et 82,2 sur CyberGym.
M3.1-Flash est particulièrement reconnu pour sa performance agentique, offrant un saut générationnel dans les tâches liées au codage et à la cybersécurité. Il obtient des scores élevés sur plusieurs benchmarks, tels que 73,7 % sur DeepSWE v1.1 et 61,7 sur OSWorld V2. L'efficacité du modèle est encore améliorée par des fonctionnalités telles que l'attention sparse et l'entraînement conscient de la quantification, qui réduisent l'empreinte mémoire et améliorent l'efficacité de service.
Pour le déploiement, MiniMax-M3.1-Flash prend en charge divers frameworks d'inférence, y compris SGLang, vLLM et TokenSpeed, avec d'autres intégrations en cours. Le modèle est conçu pour un déploiement multi-puces, offrant une flexibilité dans les configurations de service. Les utilisateurs peuvent ajuster les paramètres d'inférence, tels que la température et top_p, pour optimiser la performance pour des tâches spécifiques.
Dans l'ensemble, MiniMax-M3.1-Flash est un outil puissant pour les développeurs et les chercheurs cherchant à tirer parti des capacités avancées de l'IA dans des contextes multimodaux, fournissant un soutien robuste pour des flux de travail complexes et des applications de cybersécurité.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesWeb
Points forts de MiniMax-M3.1-Flash
Architecture de mélange d'experts multimodale
Prend en charge les entrées de texte, d'image et de vidéo
Fenêtre contextuelle allant jusqu'à 1 million de tokens
Attention sparse dans tout le modèle
Entraînement conscient de la quantification
Décodage spéculatif DSpark
Environ 428 milliards de paramètres
Haute performance sur plusieurs benchmarks
Premiers pas avec MiniMax-M3.1-Flash
Accéder à la page du modèle : Visitez la page officielle de Hugging Face pour MiniMax-M3.1-Flash
Authentifier : Assurez-vous d'avoir les identifiants nécessaires pour accéder au modèle
Configurer : Configurez le modèle avec votre framework d'inférence préféré
Envoyer des invites : Saisissez des données de texte, d'image ou de vidéo pour le traitement
Ajuster : Modifiez les paramètres comme la température et top_p pour des résultats optimaux
Cas d'utilisation de MiniMax-M3.1-Flash
- Assistance au codage
- Cybersécurité
- Flux de travail agentiques
- Traitement multimodal
- Efficacité d'inférence