Description
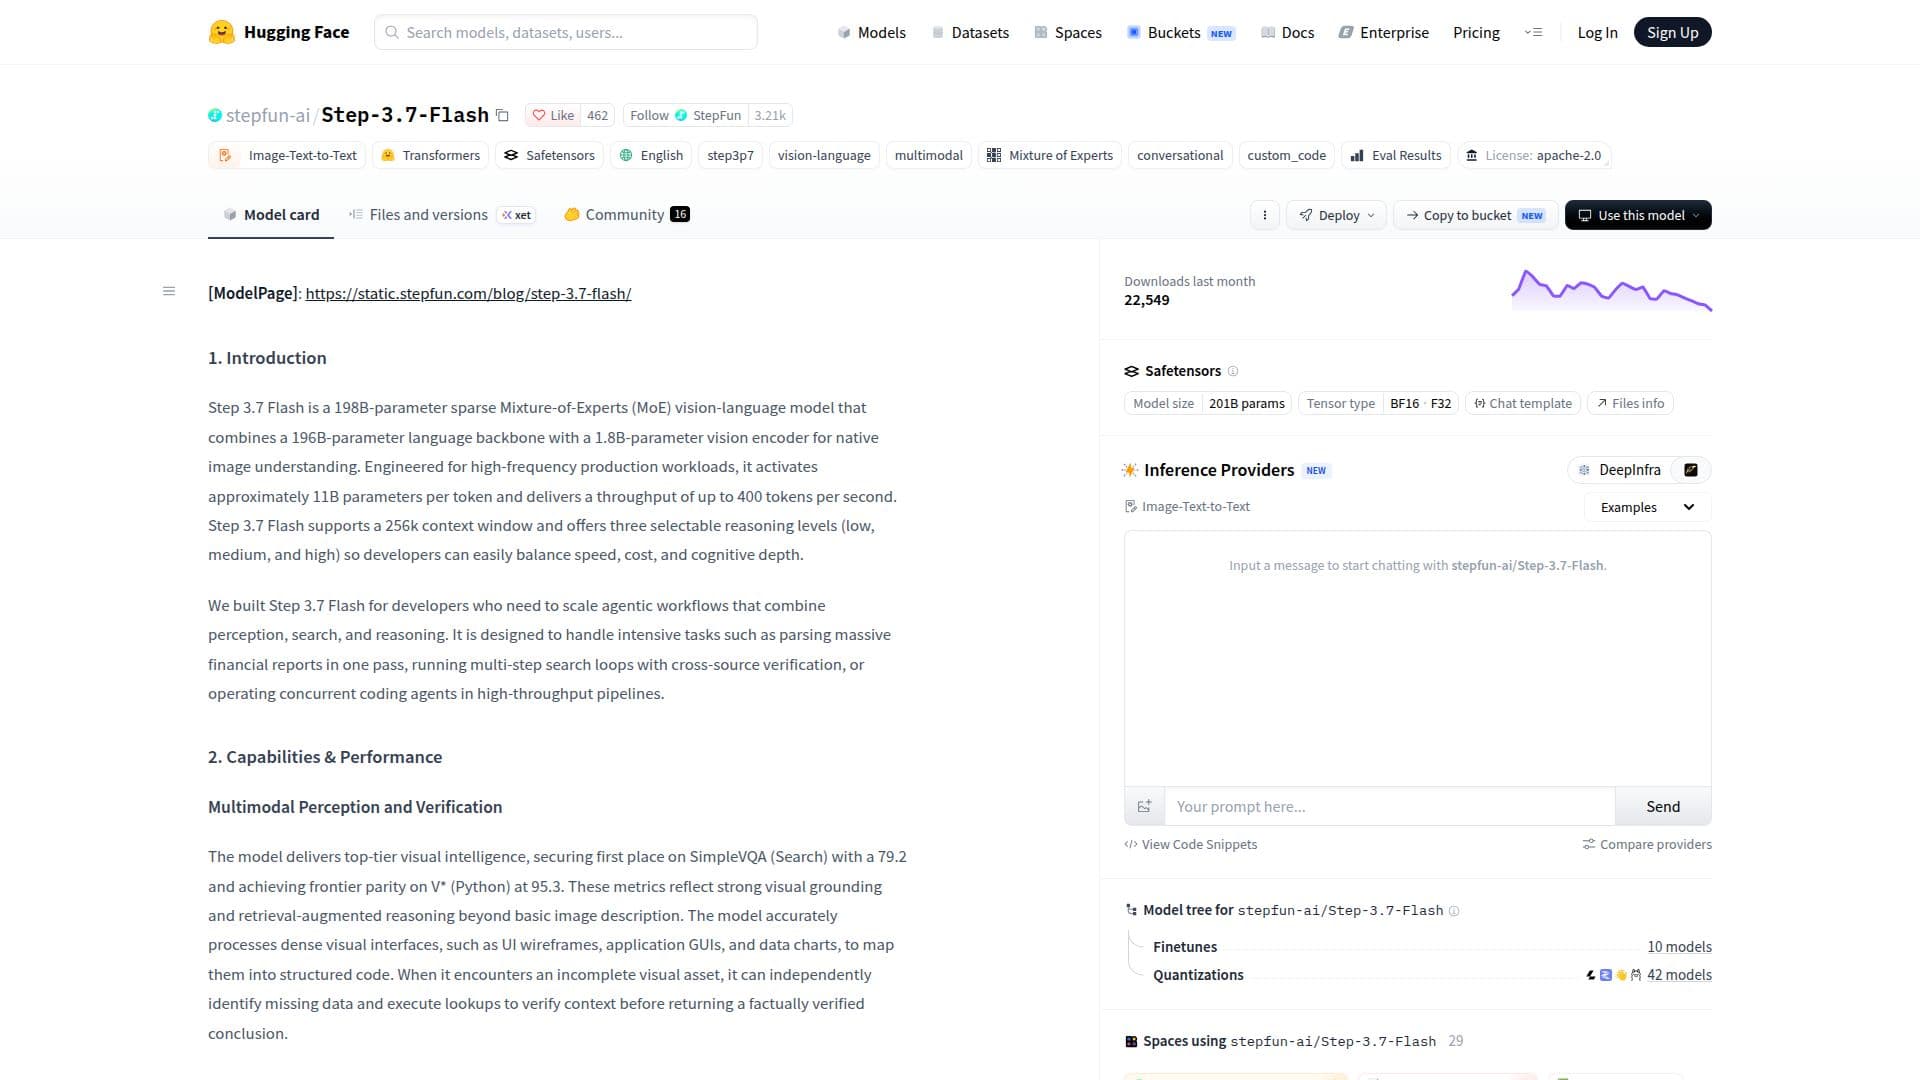
L'étape 3.7 Flash est un modèle de vision-langage Mixture-of-Experts (MoE) sparse de 198 milliards de paramètres, conçu pour gérer des charges de travail de production à haute fréquence. Il combine une architecture linguistique de 196 milliards de paramètres avec un encodeur visuel de 1,8 milliard de paramètres, permettant une compréhension et un traitement natifs des images ainsi que des interfaces visuelles denses telles que les maquettes d'interface utilisateur et les graphiques de données.
Lire la suite
Le modèle active environ 11 milliards de paramètres par jeton et offre un débit allant jusqu'à 400 jetons par seconde, prenant en charge une fenêtre de contexte de 256k. Il propose trois niveaux de raisonnement sélectionnables : faible, moyen et élevé, permettant aux développeurs d'équilibrer vitesse, coût et profondeur cognitive.
L'étape 3.7 Flash est conçue pour les développeurs qui ont besoin d'évoluer des flux de travail agentiques combinant perception, recherche et raisonnement. Elle excelle dans des tâches telles que l'analyse de rapports financiers massifs en un seul passage, l'exécution de boucles de recherche multi-étapes avec vérification inter-sources, et l'exploitation d'agents de codage concurrents dans des pipelines à haut débit.
Le modèle offre une intelligence visuelle de premier ordre, se classant au premier rang sur SimpleVQA (Recherche) avec un score de 79,2 et atteignant la parité de frontière sur V* (Python) à 95,3. Il traite avec précision des interfaces visuelles denses et peut identifier de manière autonome les données manquantes et exécuter des recherches pour vérifier le contexte avant de retourner des conclusions factuellement vérifiées.
L'étape 3.7 Flash domine le benchmark ClawEval-1.1 avec un score de 67,1, démontrant une haute résistance aux pièges adversariaux et un strict respect des politiques système lors de l'orchestration multi-tours. Il interagit de manière fiable avec des API externes et exécute des flux de travail à long terme sans s'écarter des instructions ou violer les contraintes système.
La tarification pour l'étape 3.7 Flash comprend 0,20 $ par million de jetons pour les échecs de cache d'entrée, 0,04 $ par million de jetons pour les réussites de cache d'entrée, et 1,15 $ par million de jetons pour la sortie. Le modèle est disponible sur la plateforme ouverte StepFun, OpenRouter et NVIDIA NIM, avec des plans pour étendre la disponibilité grâce à des partenariats avec DeepInfra, Fireworks AI et Modal.
L'étape 3.7 Flash prend en charge un déploiement flexible dans des environnements cloud, de centre de données et locaux, et est optimisée pour l'inférence locale en utilisant des backends standard de l'industrie tels que vLLM, SGLang, Hugging Face Transformers et llama.cpp. Elle est prise en charge dans les infrastructures open-source populaires pour l'inférence et le développement de modèles, y compris l'écosystème NVIDIA Nemo.
- CatégorieModèles d'IA et LLM
- Modèle tarifairePayant
- DéploiementCloud, Exécution locale
- PlateformesWeb
Points forts de Étape 3.7 Flash
Modèle MoE sparse de 198 milliards de paramètres
Architecture linguistique de 196 milliards
Encodeur visuel de 1,8 milliard
11 milliards de paramètres activés par jeton
Débit de 400 jetons par seconde
Fenêtre de contexte de 256k
Trois niveaux de raisonnement
Intelligence visuelle de premier ordre
Premiers pas avec Étape 3.7 Flash
Accéder à la page du modèle : Visitez la page du modèle Hugging Face
S'authentifier : Utilisez votre clé API pour vous authentifier
Configurer : Configurez les paramètres du modèle
Envoyer des requêtes : Saisissez vos requêtes pour traitement
Ajuster : Ajustez le modèle pour des tâches spécifiques
Cas d'utilisation de Étape 3.7 Flash
- Analyse de Rapports Financiers
- Boucles de Recherche Multi-Étapes
- Opérations d'Agents de Codage
- Traitement d'Interfaces Visuelles Denses
- Interaction API Autonome