

Description
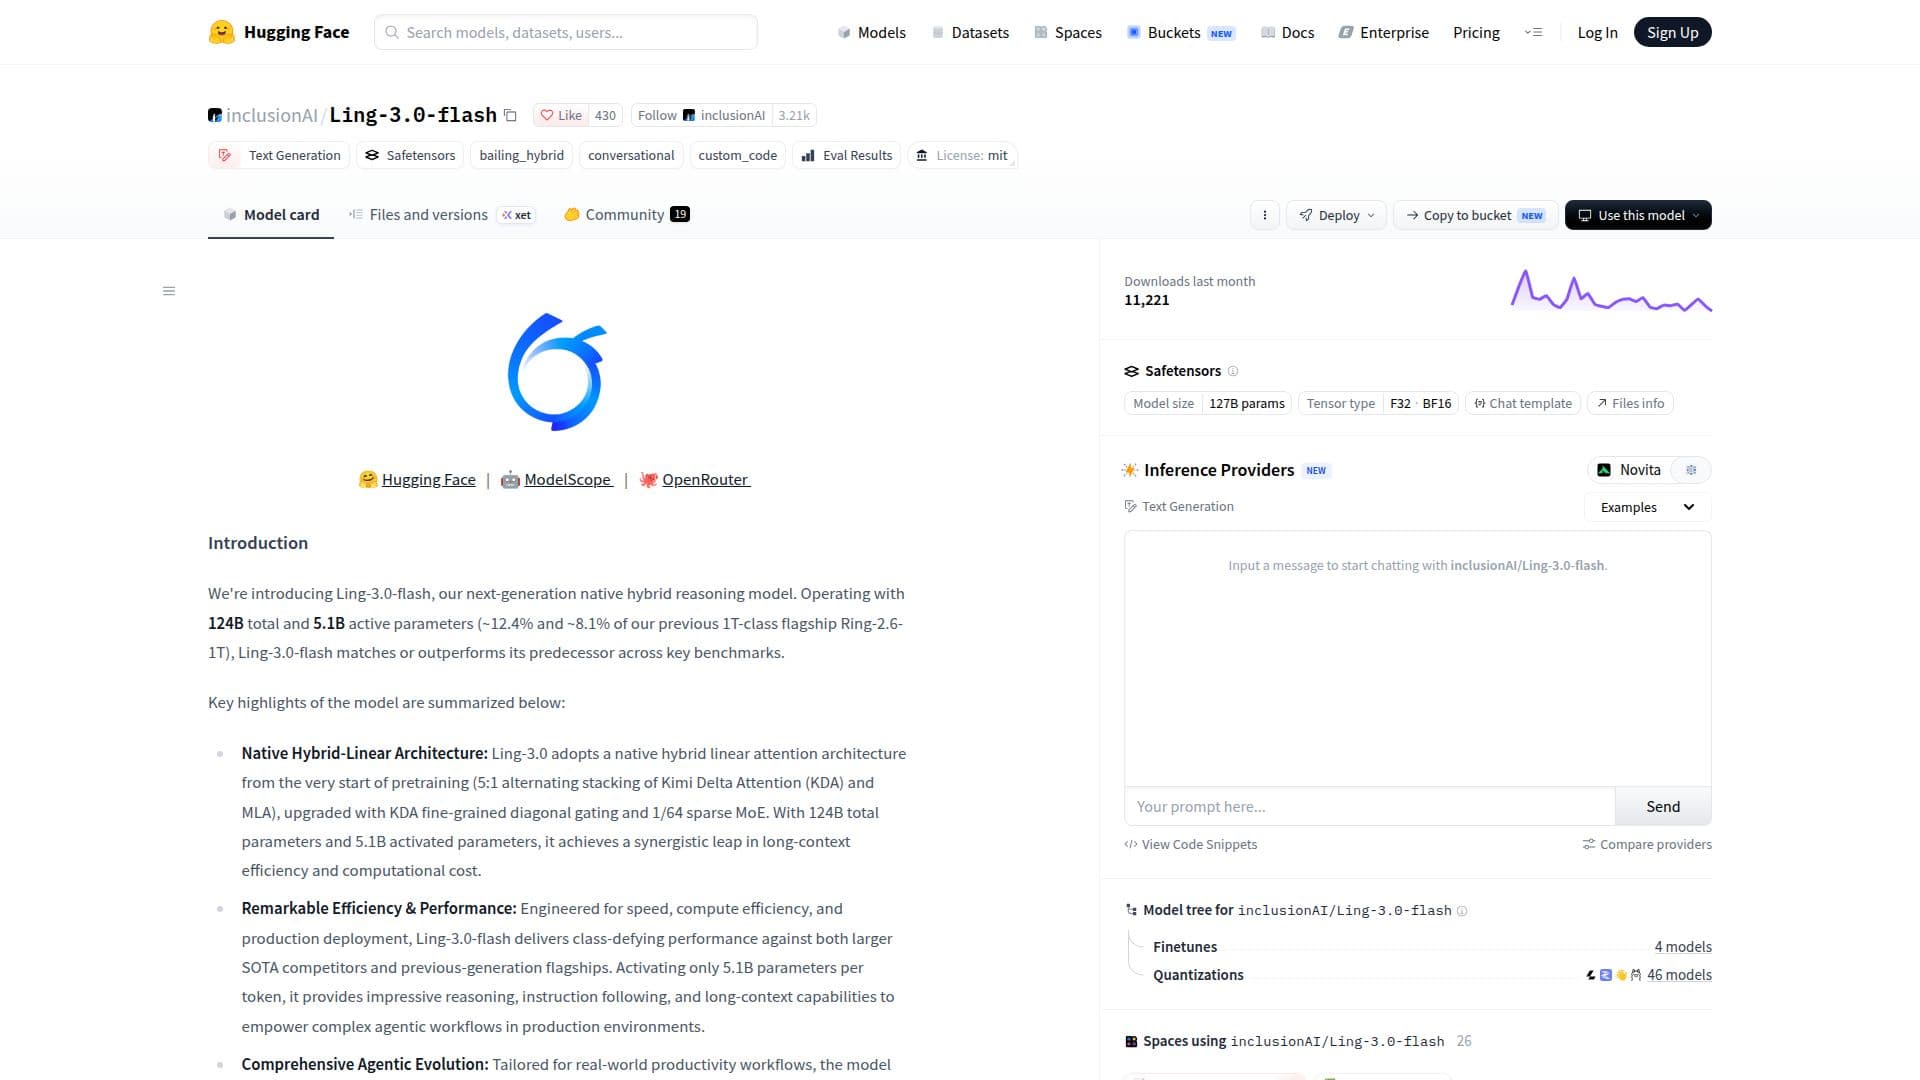
Ling-3.0-flash est un modèle de raisonnement hybride à la pointe de la technologie développé par inclusionAI et hébergé sur Hugging Face. Il fonctionne avec un total de 124 milliards de paramètres, dont 5,1 milliards activés par jeton, offrant une efficacité et une performance remarquables. Le modèle adopte une architecture d'attention linéaire hybride native, avec Kimi Delta Attention (KDA) et MLA, mise à jour avec un contrôle diagonal fin et un MoE sparse. Cette architecture permet à Ling-3.0-flash d'atteindre un bond synergique en efficacité de long contexte et en coût computationnel.
Lire la suite
Conçu pour la rapidité et l'efficacité de calcul, Ling-3.0-flash offre des performances défiant les classes par rapport à des concurrents plus grands et à des modèles phares de générations précédentes. Il permet des flux de travail agentiques complexes dans des environnements de production, n'activant que 5,1 milliards de paramètres par jeton. Le modèle intègre plus de 10 000 environnements d'entraînement interactifs pour réaliser une exécution en boucle fermée de bout en bout à travers des tâches de codage, générales et de recherche approfondie.
Ling-3.0-flash intègre l'architecture de mise en cache hiérarchique SGLang HiCache + Mooncake, avec des pools physiques doubles et un cache L3 partagé par le cluster. Cette configuration élimine le recalcul redondant lors d'interactions à long terme, réduisant le Temps jusqu'au Premier Jeton (TTFT) de 60 % à plus de 80 % dans des scénarios d'entrée longue. Le modèle performe fortement sur plusieurs benchmarks autorisés, y compris SWE-Bench Pro, SWE-Bench Multilingual, Tau3-banking-AA, MCP-Atlas et SkillsBench.
Le modèle est adapté aux flux de travail de productivité dans le monde réel, offrant de solides performances en connaissances générales, raisonnement mathématique, suivi d'instructions et compréhension de longs contextes. Ling-3.0-flash est conçu pour le déploiement en production, offrant des capacités de raisonnement impressionnantes et une efficacité de long contexte, ce qui le rend adapté aux flux de travail agentiques complexes.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireFreemium
- DéploiementCloud
- PlateformesWeb
Points forts de Ling-3.0-flash
Architecture Hybride-Linéaire Native
Efficacité & Performance Remarquables
Évolution Agentique Complète
Mise en Cache SGLang HiCache + Mooncake
Exécution en Boucle Fermée de Bout en Bout
Efficacité de Long Contexte
Suivi d'Instructions
Raisonnement Mathématique
Premiers pas avec Ling-3.0-flash
Accéder à la page du modèle : Visitez Hugging Face
Authentifier : Connectez-vous à votre compte
Configurer : Définissez les paramètres et préférences
Envoyer des invites : Saisissez vos requêtes
Ajuster : Modifiez les paramètres du modèle
Cas d'utilisation de Ling-3.0-flash
- Tâches de Codage
- Agents de Recherche
- Suivi d'Instructions
- Compréhension de Long Contexte
- Raisonnement Mathématique







