Description
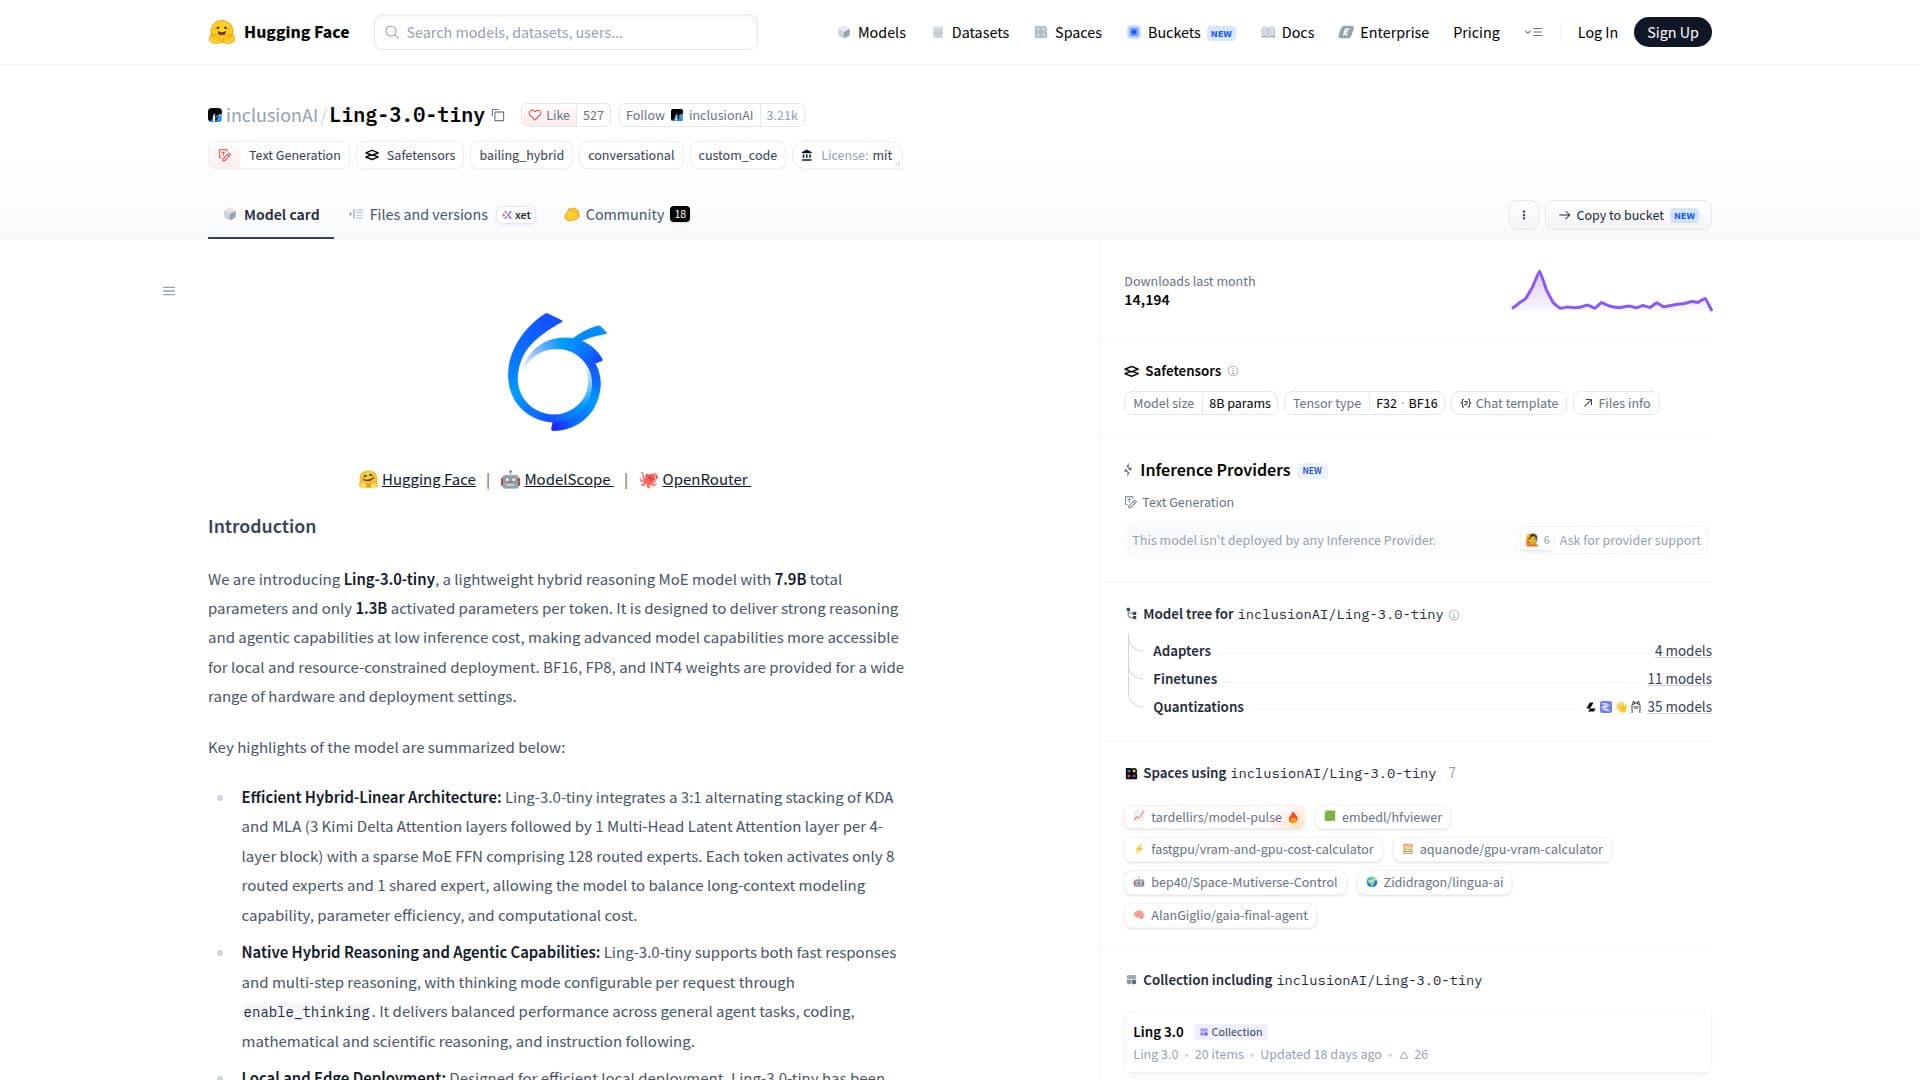
Ling-3.0-tiny est un modèle de raisonnement hybride léger développé par inclusionAI, hébergé sur Hugging Face. Il dispose d'un total de 7,9 milliards de paramètres, avec seulement 1,3 milliard activés par jeton, ce qui le rend efficace pour les déploiements locaux et à ressources limitées. Le modèle intègre un empilement alterné 3:1 de couches Kimi Delta Attention (KDA) et Multi-Head Latent Attention (MLA), ainsi qu'un réseau Feed-Forward Mixture of Experts (MoE) clairsemé comprenant 128 experts routés. Cette architecture permet au modèle d'équilibrer la capacité de modélisation de long contexte, l'efficacité des paramètres et le coût computationnel.
Lire la suite
Ling-3.0-tiny est conçu pour offrir de solides capacités de raisonnement et d'agentivité à un faible coût d'inférence. Il prend en charge à la fois des réponses rapides et un raisonnement en plusieurs étapes, avec un mode de réflexion configurable. Le modèle est validé sur divers matériels, y compris NVIDIA DGX Spark et Apple Silicon MacBook, permettant des charges de travail de raisonnement et d'agentivité sans avoir besoin de GPU de classe datacenter. Avec FP8, il atteint environ 100-105 jetons par seconde sur DGX Spark et 86-90 jetons par seconde sur un MacBook M4 Pro, avec environ 8,34 Go d'utilisation de mémoire maximale à une longueur de contexte de 8K.
L'efficacité du modèle est mise en avant par ses performances sur l'Artificial Analysis Intelligence Index v4.1.1, avec un score de 25, et sur l'Artificial Analysis Agentic Index, avec un score de 16. Il atteint une vitesse de sortie de plus de 160 jetons par seconde, avec environ 18 secondes de latence de bout en bout pour une réponse de 500 jetons. Ling-3.0-tiny est adapté à un large éventail de tâches, y compris les tâches d'agentivité, la programmation, la compréhension de long contexte, la fiabilité des connaissances, le raisonnement mathématique et scientifique, et le suivi d'instructions.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireFreemium
- DéploiementExécution locale
- PlateformesWeb
Points forts de Ling-3.0-tiny
7,9 milliards de paramètres au total
1,3 milliard de paramètres activés par jeton
Capacités de raisonnement hybrides
Déploiement local efficace
Architecture KDA-MLA 3:1
FFN MoE clairsemé avec 128 experts
Prend en charge des réponses rapides et un raisonnement en plusieurs étapes
Validé sur NVIDIA DGX Spark et Apple Silicon
Premiers pas avec Ling-3.0-tiny
Accéder à la page du modèle : Visitez Hugging Face
Authentifiez-vous : Connectez-vous à votre compte
Configurer : Définissez les paramètres du modèle
Envoyer des invites : Utilisez le modèle pour l'inférence
Affiner : Ajustez les paramètres pour des tâches spécifiques
Cas d'utilisation de Ling-3.0-tiny
- Tâches d'Agentivité
- Programmation
- Raisonnement Scientifique
- Suivi d'Instructions
- Déploiement Local