Description
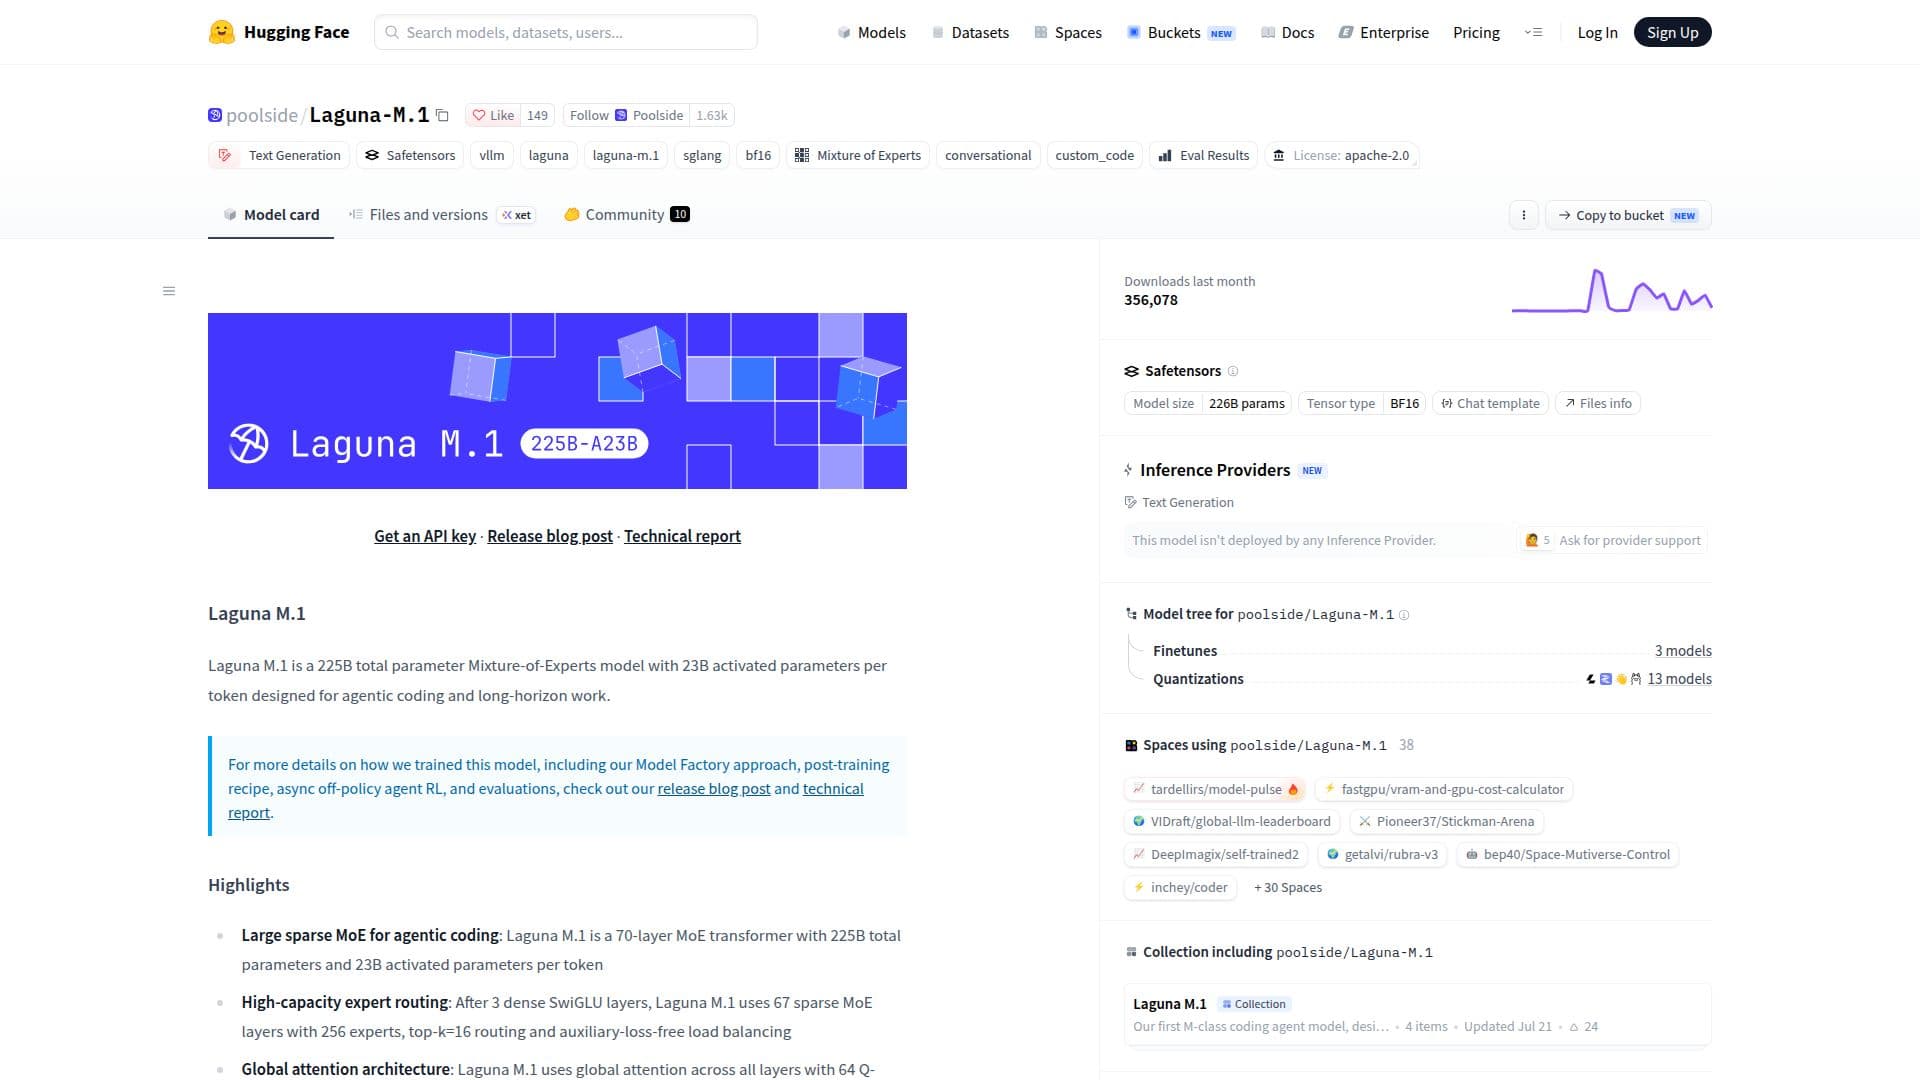
Laguna M.1 est un modèle Mixture-of-Experts (MoE) sophistiqué développé pour le codage agentique et les tâches à long terme. Avec un total de 225 milliards de paramètres et 23 milliards de paramètres activés par token, il est conçu pour gérer efficacement des tâches computationnelles complexes. Le modèle se compose de 70 couches, dont 67 couches MoE éparses avec 256 experts, et utilise un mécanisme de routage d'experts à haute capacité. Ce design permet un routage top-k=16 et un équilibrage de charge sans perte auxiliaire, améliorant son efficacité computationnelle.
Lire la suite
Le modèle emploie une architecture d'attention globale à travers toutes les couches, avec 64 têtes Q et 8 têtes KV, et un contrôle de sortie d'attention softplus. Cette configuration prend en charge des capacités de raisonnement natives, permettant une réflexion entrelacée lors des appels d'outils, qui peuvent être activés ou désactivés par demande. Laguna M.1 démontre de solides performances sur plusieurs benchmarks, y compris SWE-bench Verified, SWE-bench Multilingual, SWE-Bench Pro et Terminal-Bench 2.0, le rendant compétitif avec les modèles de pointe.
Laguna M.1 est sous licence Apache 2.0, permettant une utilisation et une modification gratuites à des fins commerciales et non commerciales. Il est pris en charge par diverses plateformes, y compris vLLM, SGLang, Transformers et TRT-LLM, grâce à des collaborations avec NVIDIA. Le modèle est conçu pour des cas d'utilisation en ingénierie logicielle et en codage agentique, avec un accent sur la préservation du raisonnement dans l'historique des messages pour optimiser les performances.
Les utilisateurs peuvent déployer Laguna M.1 localement en utilisant vLLM ou SGLang, avec un support pour les appels d'outils, les réponses en streaming et l'analyse du raisonnement. Le modèle est également disponible dans des formats quantifiés, tels que FP8 et NVFP4, pour s'adapter à différents besoins de déploiement. Pour ceux qui souhaitent explorer ses capacités, Laguna M.1 peut être accessible via des plateformes comme vLLM et SGLang, avec des conseils de déploiement détaillés disponibles dans leur documentation respective.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud, Auto-hébergé
- PlateformesWeb, macOS, Linux
Points forts de Laguna M.1
225B paramètres au total
23B paramètres activés par token
Transformateur MoE de 70 couches
256 experts avec routage top-k=16
Architecture d'attention globale
Support de raisonnement natif
Licence Apache 2.0
Performances solides sur les benchmarks
Premiers pas avec Laguna M.1
Accéder à la page du modèle : Visitez la page Hugging Face pour Laguna M.1
S'authentifier : Obtenez une clé API pour l'accès
Configurer : Configurez le modèle avec les paramètres souhaités
Envoyer des invites : Utilisez le modèle pour des tâches de texte à texte
Affiner : Ajustez le modèle pour des cas d'utilisation spécifiques
Cas d'utilisation de Laguna M.1
- Codage Agentique
- Tâches à Long Terme
- Tests de Benchmark
- Intégration d'Outils
- Recherche et Développement