

Dire qu'un modèle est « n° 1 du classement » est vrai pour un test précis, mené d'une manière précise, un jour précis. Cela dit bien moins s'il est le meilleur pour votre travail. Avant de changer d'outil ou de payer un forfait supérieur à cause d'un classement, vérifiez de quel classement il vient, qui l'a mené et ce qu'il mesure.
Cela compte davantage en 2026, parce que les classements sont devenus un business. Arena, le site de classement public anciennement appelé LMArena, a levé 200 millions de dollars sur une valorisation de 3,1 milliards de dollars cette année, soit près du double des 1,7 milliard de dollars de plus tôt en 2026 (Phemex). Arena affirme que son chiffre d'affaires annualisé dépasse 100 millions de dollars (Arena). Chaque lancement de modèle met désormais un rang en avant, et ce rang fait vendre.
Cela ne veut pas dire que les classements sont bidon. La plupart sont conçus par des gens sérieux et mesurent quelque chose de réel. Le problème, c'est que chacun mesure une chose différente, et qu'un article de lancement citera celui qui avantage le modèle. Ce guide explique comment fonctionnent les principaux classements, où chacun faiblit, et comment lire une annonce en deux minutes environ.
Quatre types de classements, quatre questions différentes
La plupart des classements que vous croiserez entrent dans quatre groupes. Les groupes comptent plus que n'importe quel classement pris isolément, car un chiffre ne signifie quelque chose qu'une fois que vous savez de quel groupe il vient.
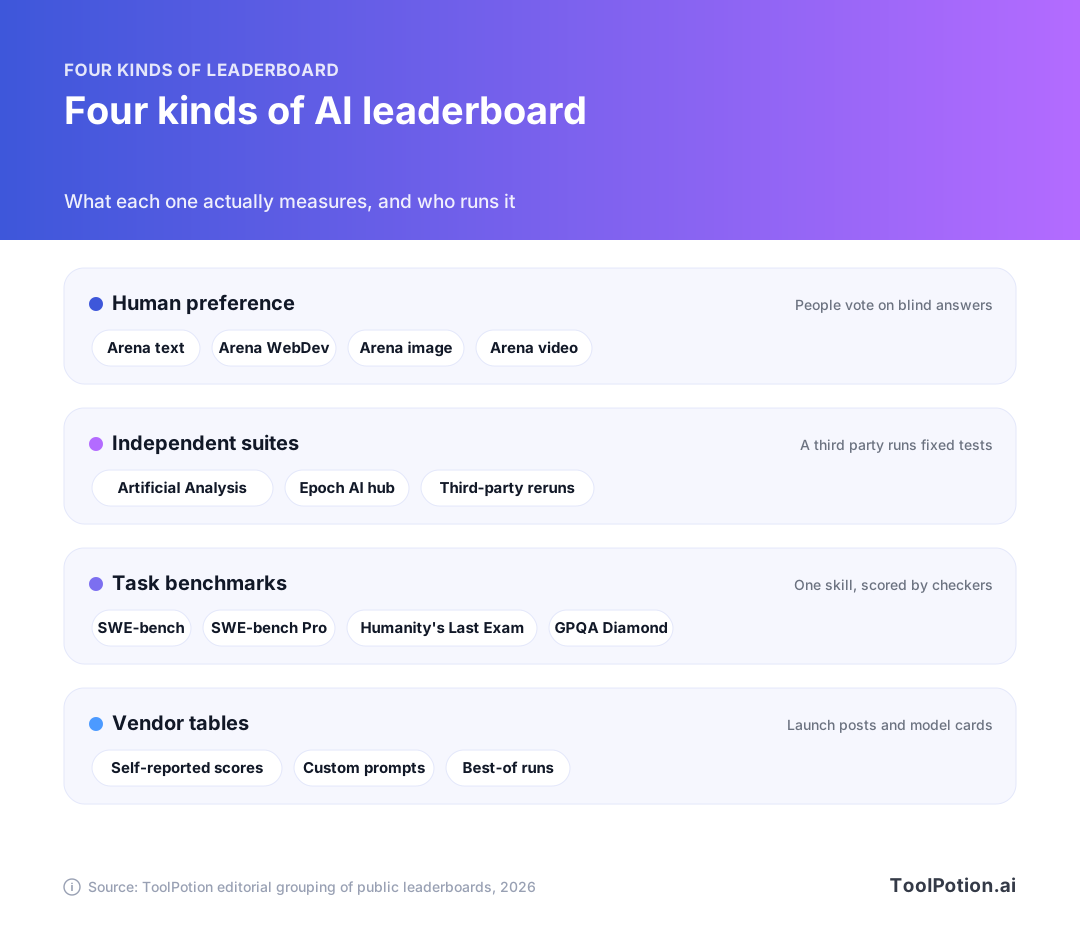
Les arènes de préférence humaine demandent aux gens quelle réponse ils préfèrent. Les suites indépendantes font passer à chaque modèle les mêmes tests, dans les mêmes conditions. Les benchmarks de tâches évaluent une compétence précise, comme corriger de vrais bugs logiciels, avec un correcteur automatique. Les tableaux d'éditeurs sont les scores qu'un labo publie dans son propre article de lancement ou sa model card, généralement avec des réglages qu'il a choisis.
Ces groupes ne se font pas tant concurrence qu'ils répondent à des questions différentes. La préférence vous dit avec quel modèle les gens aiment discuter. Une suite vous dit comment les modèles se comparent quand un tiers neutre tient le chronomètre. Un benchmark de tâche vous dit si un modèle sait faire un travail étroit. Un tableau d'éditeur vous dit ce que le labo veut vous faire remarquer.
| Type de classement | Exemple | Ce qu'il mesure | Principale faiblesse |
|---|---|---|---|
| Préférence humaine | Arena texte et WebDev | La réponse pour laquelle les gens votent | Récompense le style et la longueur, peut être manipulé |
| Suite indépendante | Artificial Analysis, hub d'Epoch AI | Scores sur un jeu de tests fixe | Vaut ce que valent les tests choisis |
| Benchmark de tâche | SWE-bench, Humanity's Last Exam | Une compétence, notation automatique | Contamination, tâches défectueuses, saturation |
| Tableau d'éditeur | Articles de lancement, model cards | Ce que le labo a choisi de publier | Réglages et prompts invérifiables |
Comment un vote dans l'arène devient une note
Arena est né sous le nom de Chatbot Arena, un projet de recherche de l'UC Berkeley. L'idée est simple : vous saisissez un prompt, deux modèles anonymes répondent, et vous choisissez la meilleure réponse. L'article original des chercheurs décrit une plateforme qui avait recueilli plus de 240 000 votes durant ses premiers mois, et constate que les votes de la foule concordaient bien avec les jugements d'experts (arXiv).
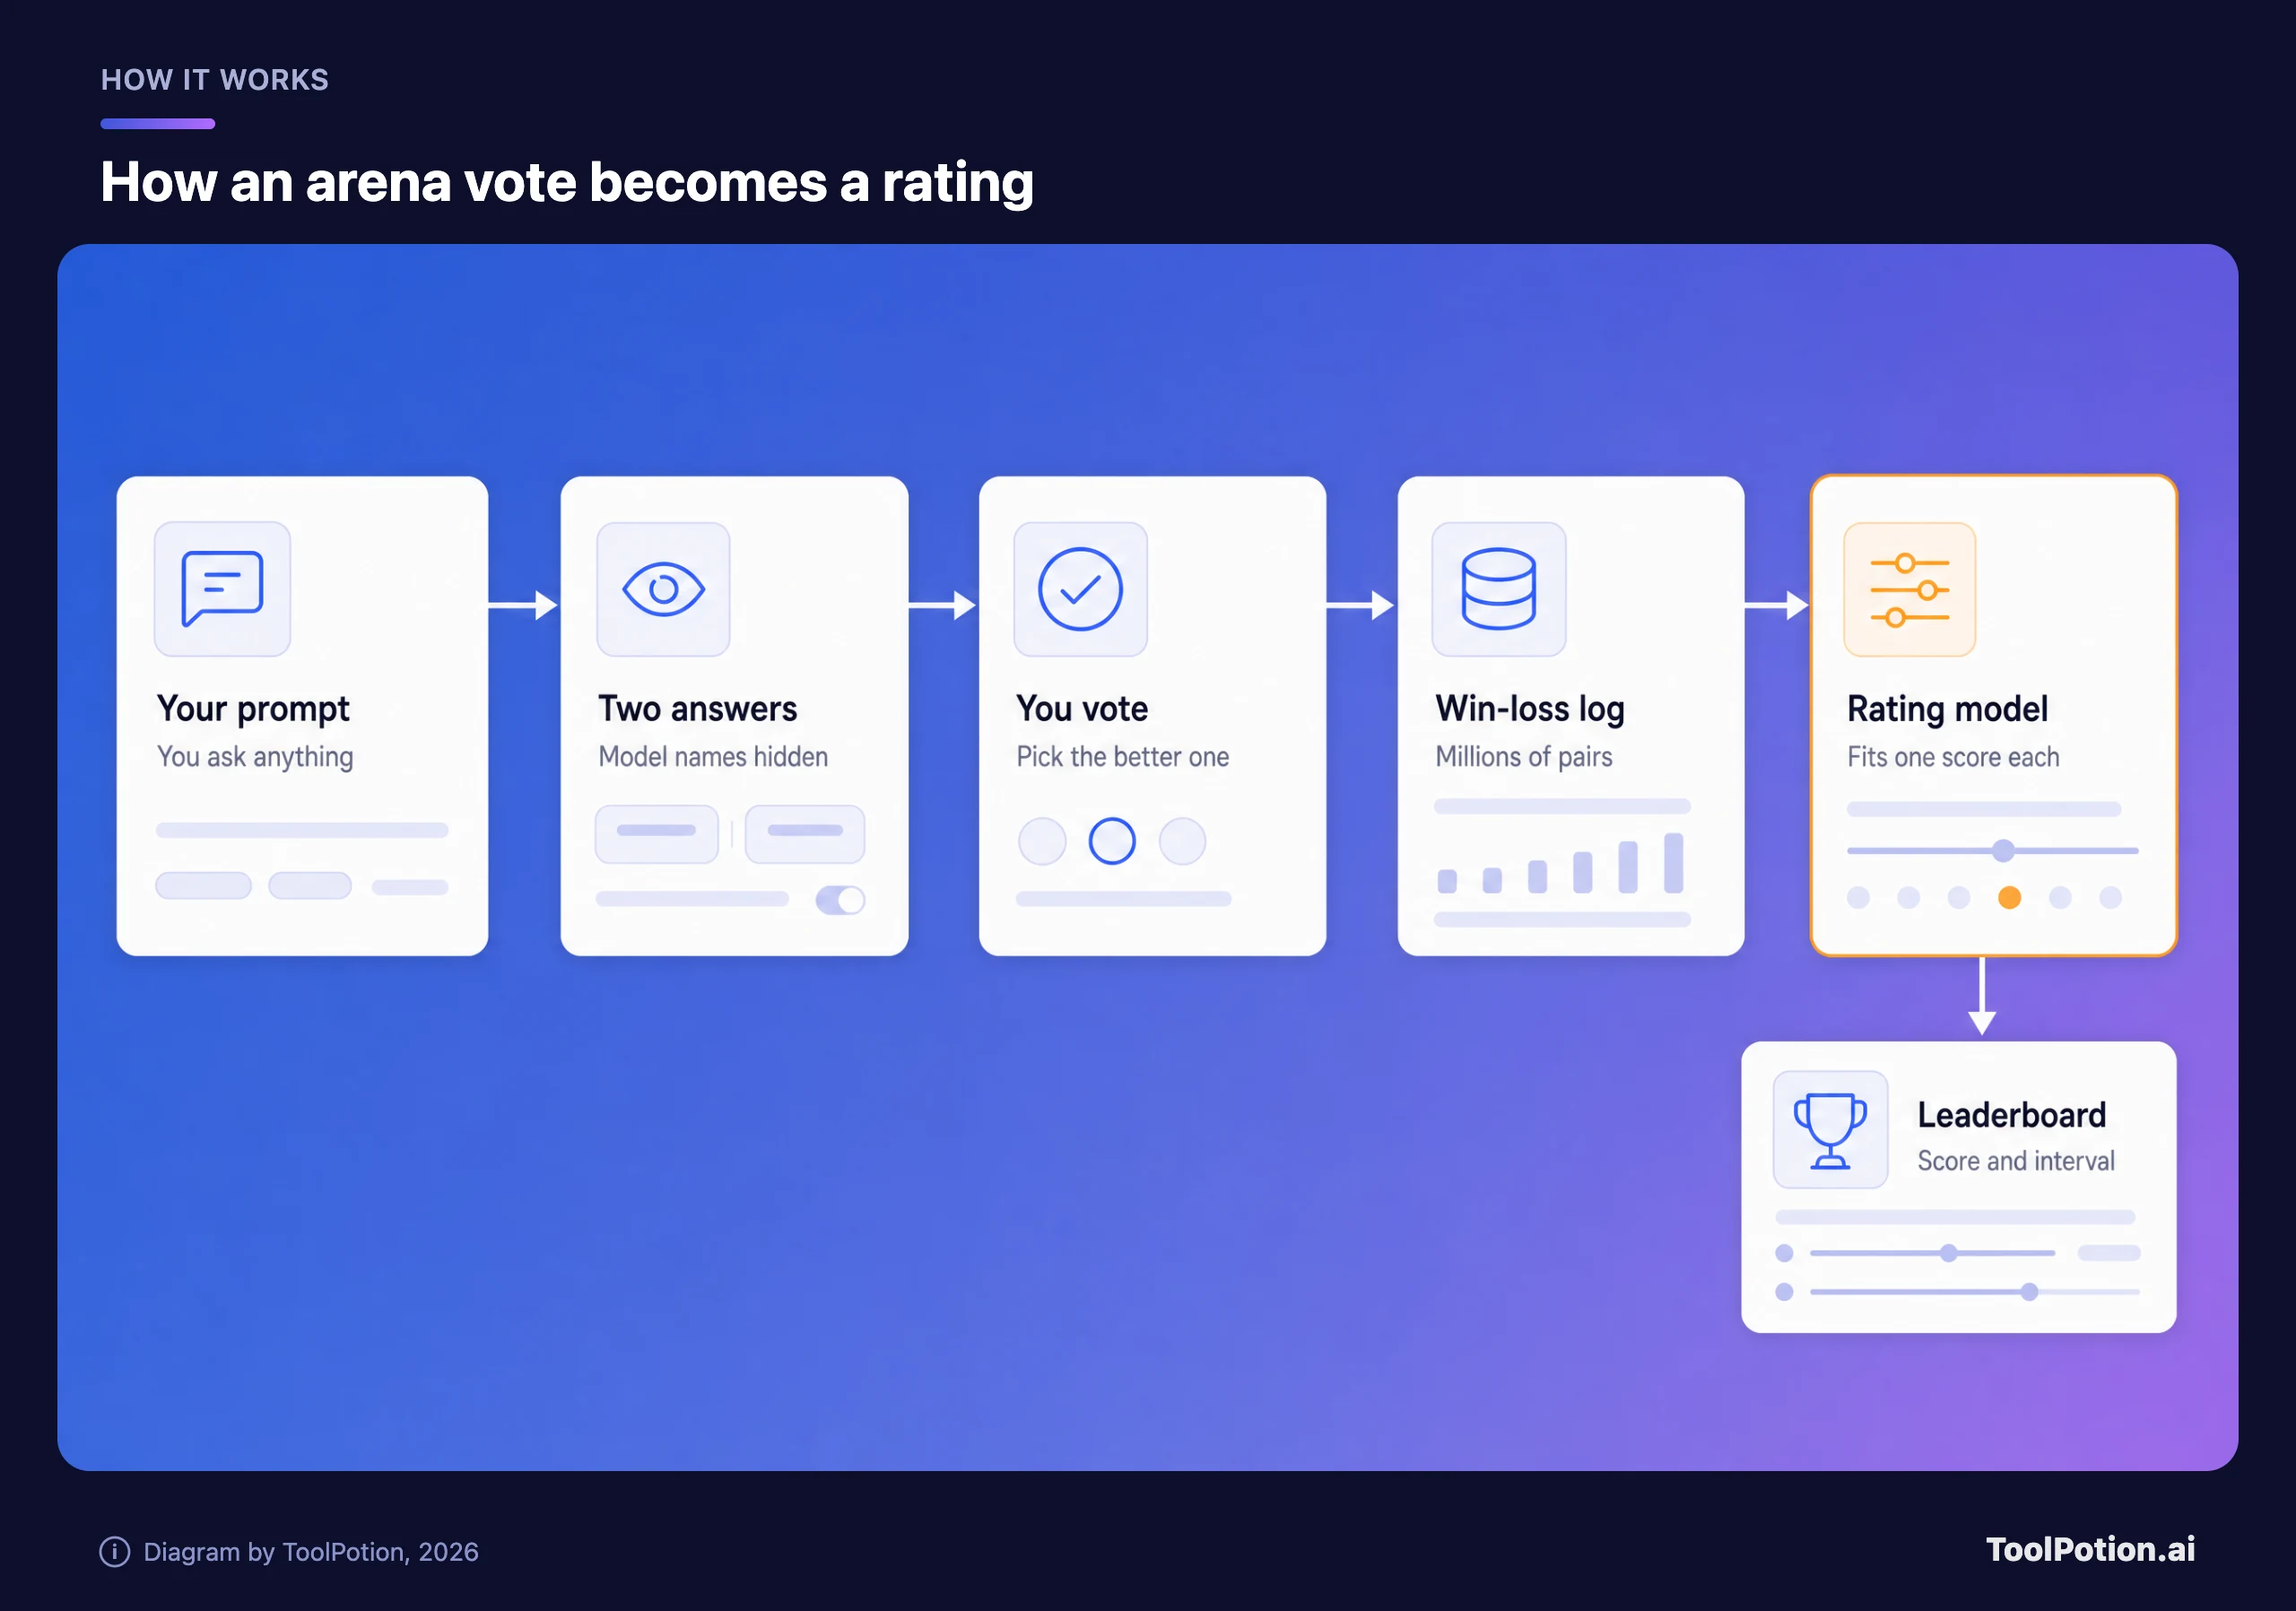
Chaque vote est un minuscule enregistrement : le modèle A a battu le modèle B sur ce prompt. Des millions de ces enregistrements alimentent un modèle statistique qui attribue un score unique à chaque modèle. Les publications d'Arena décrivent la méthode comme une régression de Bradley-Terry, proche cousine du système Elo utilisé aux échecs (LMSYS). Le score d'un modèle monte quand il bat des adversaires forts et baisse quand il perd contre des faibles, et le classement texte affiche un intervalle à côté de chaque score (un chiffre « ± »), pas seulement l'estimation ponctuelle.
Cet intervalle est la partie que les articles de lancement omettent. Si deux modèles sont séparés de quelques points et que leurs intervalles se chevauchent, la lecture honnête est une égalité. Un « n° 1 » qui repose sur un écart de deux ou trois points est généralement un pile ou face statistique.
Arena a aussi largement dépassé le chat. Son classement comprend désormais des tableaux distincts pour le texte, le WebDev, la vision, la recherche, la génération et l'édition d'images, et la vidéo, ainsi qu'un tout nouveau classement d'agents qui indique le coût par tâche à côté du taux de victoire (Arena). La colonne du coût mérite d'être lue. Un modèle qui gagne une place en coûtant plusieurs fois plus cher, ce n'est pas la même recommandation.
Ce qu'une arène ne peut pas vous dire
Le vote de préférence pose trois problèmes bien documentés. Le premier est le style. Les gens aiment les réponses longues et bien mises en forme, donc un modèle peut grimper en écrivant plus et en ajoutant des titres. L'analyse de l'équipe d'Arena a trouvé que la longueur de la réponse était l'effet de style dominant, et que corriger la longueur et le markdown redistribuait les places. Dans cette analyse de 2024, GPT-4o-mini passait de la sixième à la onzième place tandis que Claude 3.5 Sonnet passait de la sixième à la quatrième (LMSYS). Arena propose désormais des vues avec contrôle du style, et il vaut la peine de les utiliser.
Le deuxième problème est l'accès. Un article de 2025 intitulé « The Leaderboard Illusion », dont les auteurs incluent Sayash Kapoor et Noah Smith, soutenait que les grands labos bénéficiaient d'avantages structurels sur Arena. Il rapportait que Meta avait testé 27 variantes privées de modèle avant la sortie de Llama 4 et n'avait publié que le meilleur score, et estimait que Google et OpenAI avaient reçu environ 19,2 % et 20,4 % de toutes les données d'Arena, contre environ 29,7 % pour 83 modèles open-weight réunis (arXiv).
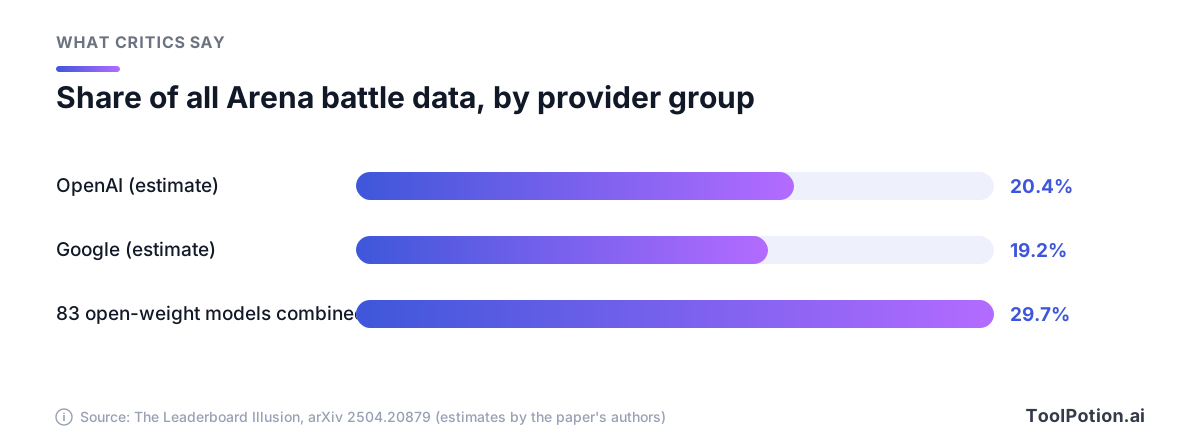
L'article rapportait aussi qu'entraîner un modèle sur des données de type Arena peut améliorer ses performances sur la distribution d'Arena jusqu'à 112 %, ce qui incite à optimiser pour le classement plutôt que pour les capacités générales. Ce sont des estimations et des affirmations des auteurs, qui reflètent un instantané de l'époque de la rédaction. Reste que c'est la description externe la plus claire de la façon dont un classement par préférence peut être manipulé sans que personne enfreigne une règle.
Le troisième problème est que la préférence n'est pas l'exactitude. Une réponse assurée et aimable peut gagner un vote tout en contenant une information fausse. Pour le ressenti en conversation et l'écriture, la préférence est un guide correct. Pour du code qui doit tourner ou un chiffre qui doit être juste, c'est un guide faible.
La page de politique actuelle d'Arena répond à une partie de ces critiques. Elle indique que les modèles pré-sortie sont testés sous des noms anonymes jusqu'à ce que les scores se stabilisent (au minimum 1 000 votes), que ces scores sont partagés en privé avec le fournisseur, et que le score d'un modèle est marqué « preliminary » après la sortie publique jusqu'à l'arrivée de nouveaux votes. Elle précise aussi que chaque duel inclut au moins un modèle accessible publiquement et qu'au moins 20 % des duels opposent uniquement des modèles publics (Arena). La règle pratique : un tag « preliminary » signifie que le chiffre n'est pas encore stabilisé.
Suites indépendantes : Artificial Analysis et Epoch AI
Si les classements de préférence demandent ce que les gens aiment, les suites indépendantes demandent ce qu'un modèle sait faire quand tout le monde passe le même test. Artificial Analysis est la plus connue. Son Intelligence Index, aujourd'hui en version 4.3.2, combine 10 évaluations réparties en quatre groupes : agents (30 % du poids), connaissances générales et raisonnement (30 %), code (20 %) et raisonnement scientifique (20 %). Chaque modèle est évalué dans les mêmes conditions avec un score pass@1, c'est-à-dire une seule tentative par question, et le site indique conserver ses propres copies des jeux de données. Pour la notation subjective, il utilise un panel de trois modèles de pointe issus de labos différents. L'indice est surtout en anglais et en texte, et le site évalue séparément les capacités multilingues et multimodales (Artificial Analysis).
Les pondérations sont un choix éditorial. Une autre pondération, avec moins pour les agents et plus pour le code, réordonnerait certains modèles. Ce n'est pas un défaut, mais cela signifie que le chiffre « global » n'est qu'une opinion sur ce qui compte. Si le code est votre priorité, lisez les résultats de code, pas le titre.
Epoch AI gère un hub de benchmarks qui mêle des tests qu'il administre lui-même, comme GPQA Diamond, FrontierMath et SWE-bench Verified, et des résultats de sources externes. Sa trouvaille la plus utile pour les lecteurs concerne les chiffres des éditeurs. Claude 3.5 Sonnet était annoncé à 65 % sur GPQA Diamond. Epoch a mesuré 55 %, à plus ou moins 3 points, sur 16 exécutions, et a noté que les labos ne publient souvent ni le prompt ni la température utilisés (Epoch AI). Un écart de 10 points dû au seul paramétrage est une bonne raison de préférer les nouvelles exécutions par un tiers. Le hub est financé par l'UK AI Security Institute et ses données sont libres de réutilisation.
Indépendant ne veut pas dire impartial. Un tiers choisit tout de même les tests, et tout indice qui inclut des LLM comme juges hérite de leurs travers. L'étude d'Arena sur les juges IA a constaté que les modèles favorisent leurs propres réponses. Sur 1 460 duels de Text Arena jugés par 12 modèles, les juges ont choisi leurs propres réponses environ 70 % plus souvent que les humains (Arena).
Les benchmarks s'usent
Les benchmarks de tâches ont le problème inverse. Ils sont objectifs, mais vieillissent vite. Un benchmark sort difficile, les labos l'optimisent, les scores grimpent, le test fuite dans les données d'entraînement, et bientôt tous les meilleurs modèles frôlent le plafond et le classement ne veut plus rien dire.
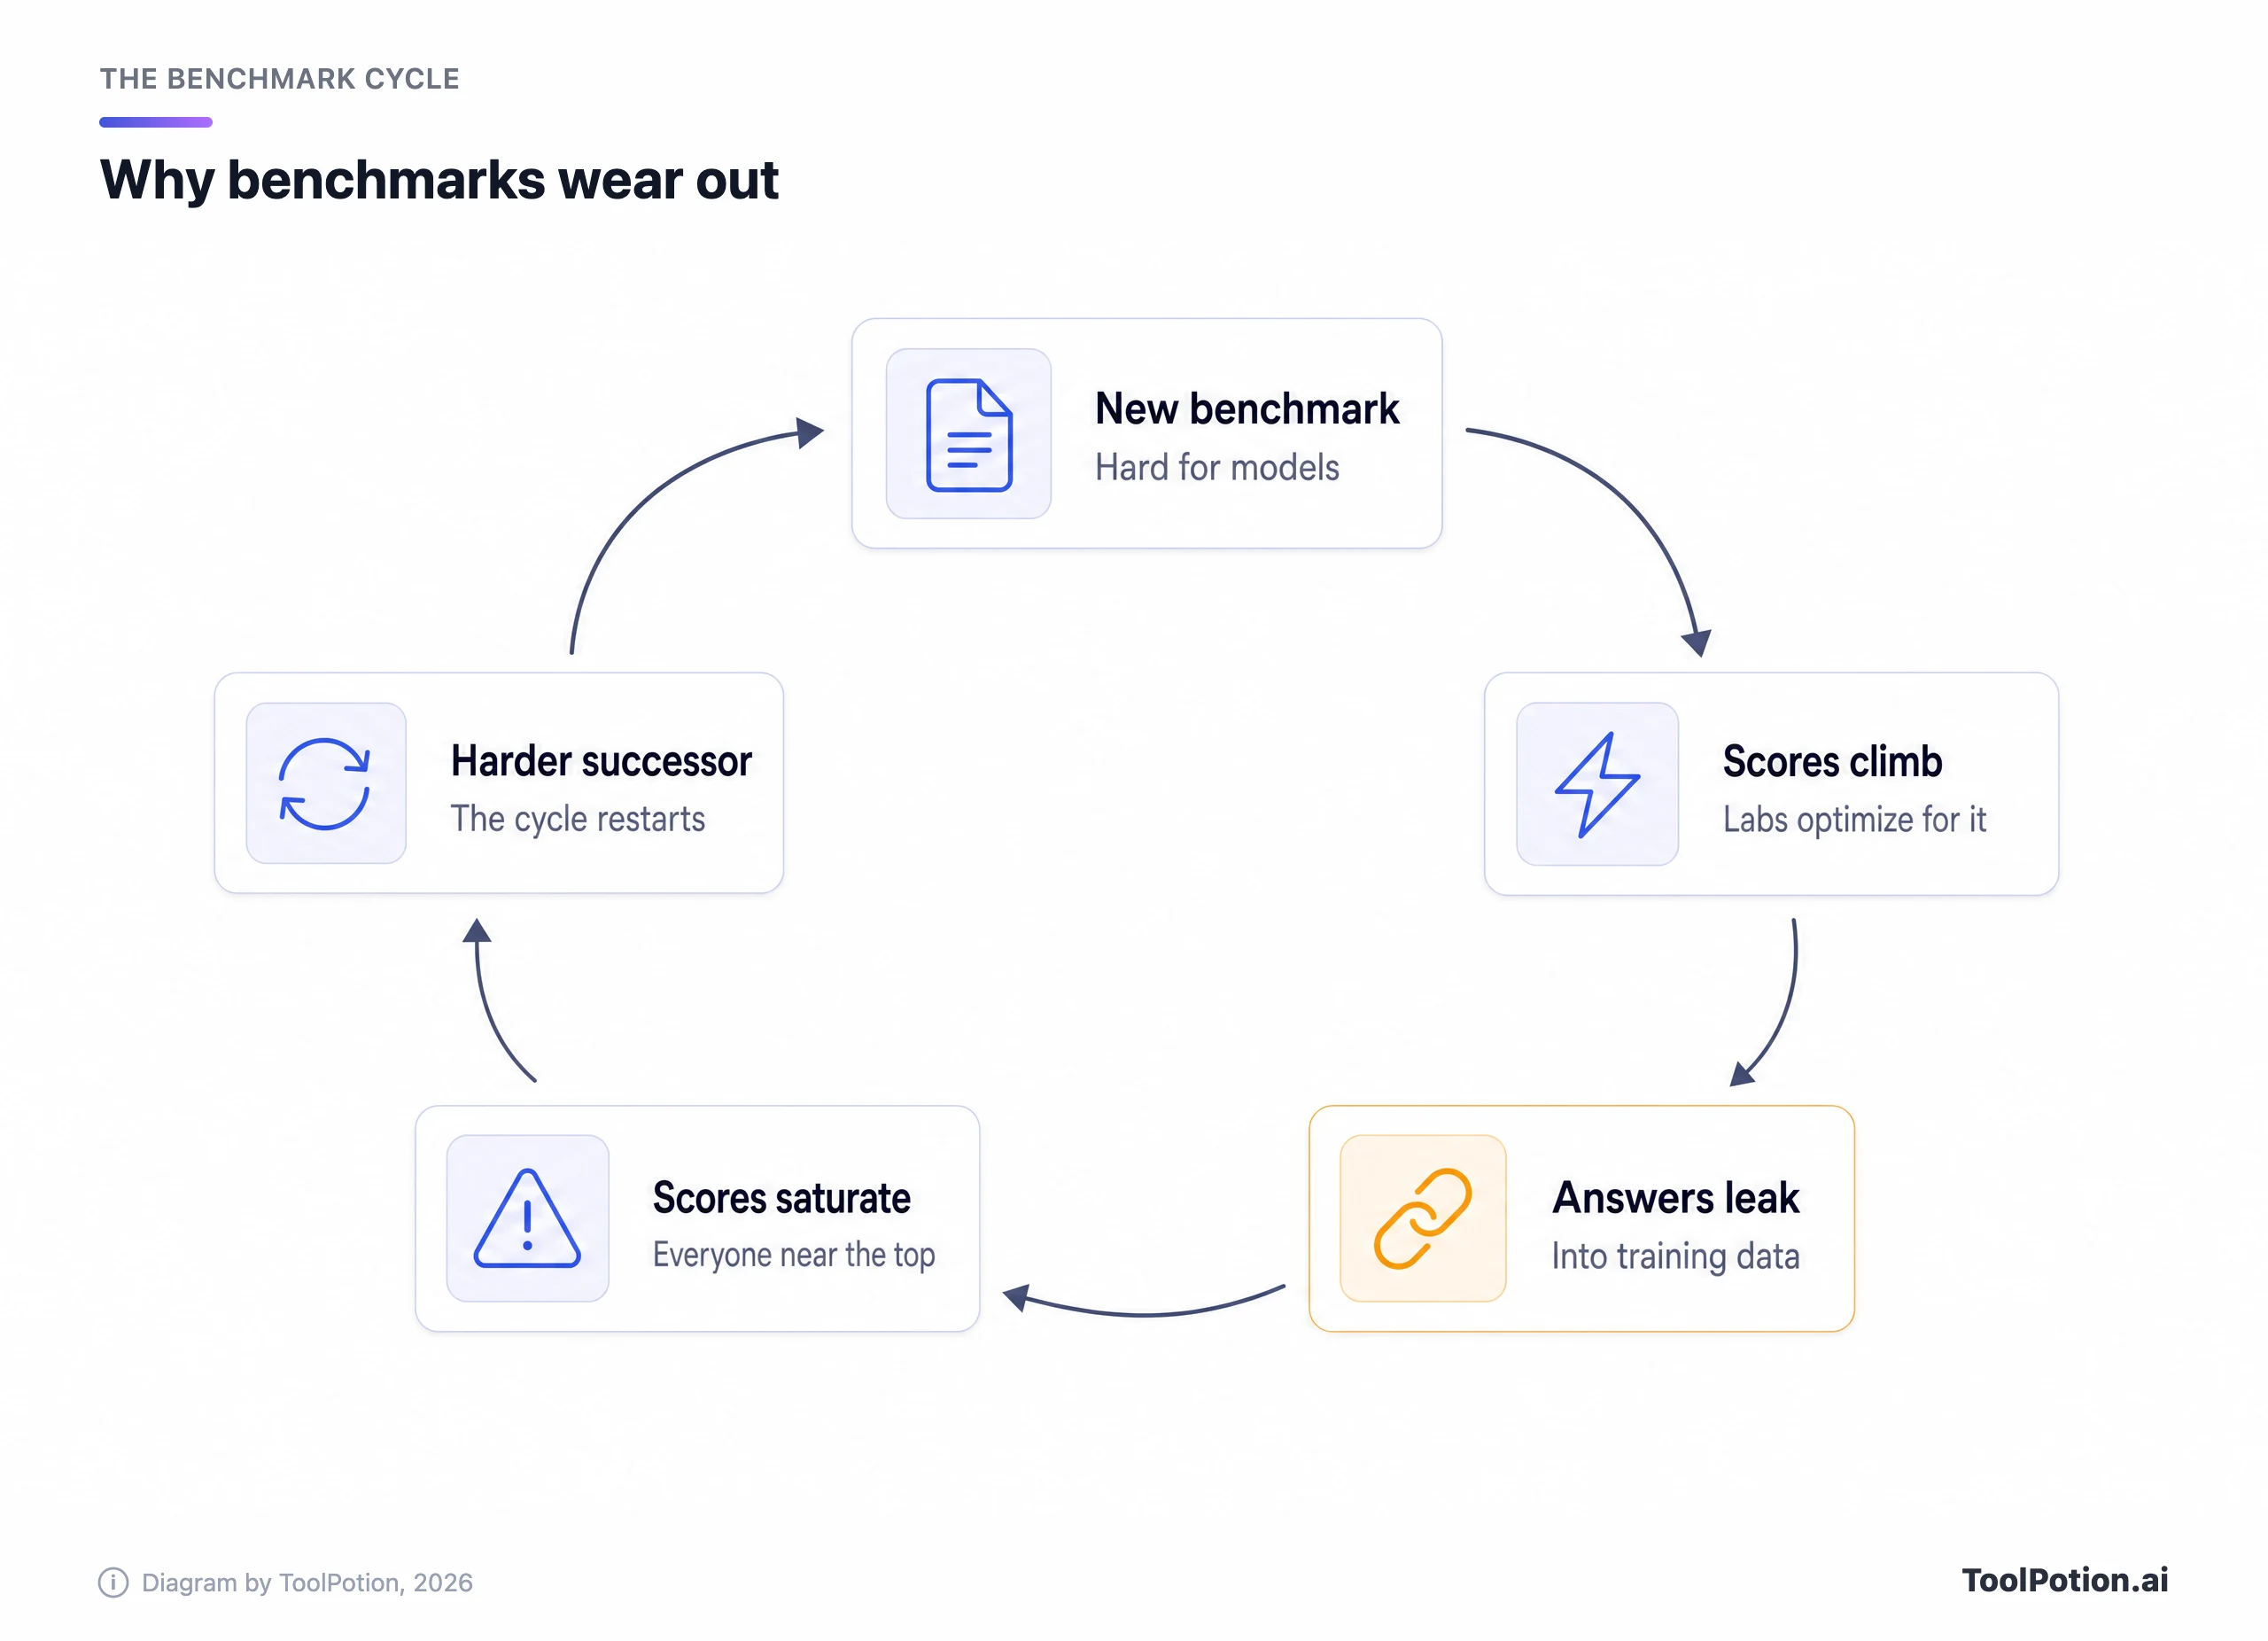
Humanity's Last Exam illustre bien cette réponse. Il compte 2 500 questions dans plus d'une centaine de disciplines, rédigées par près de 1 000 experts de plus de 500 institutions, et conserve un jeu de test privé pour détecter le surapprentissage. Ses auteurs l'ont conçu parce que des tests plus anciens comme MMLU avaient été poussés au-delà de 90 % par les modèles de pointe (arXiv). Il a été publié dans Nature en 2026, et même ses créateurs s'attendaient à ce que les scores progressent vite.
SWE-bench montre le cycle de vie complet. Le benchmark original comptait 2 294 vrais tickets GitHub issus de 12 projets Python, et le meilleur modèle de l'époque, Claude 2, en résolvait 1,96 % (selon l'article original). Un sous-ensemble nettoyé de 500 tâches, appelé Verified, est devenu le chiffre de référence dans les lancements de modèles de code. Puis l'audit est arrivé.
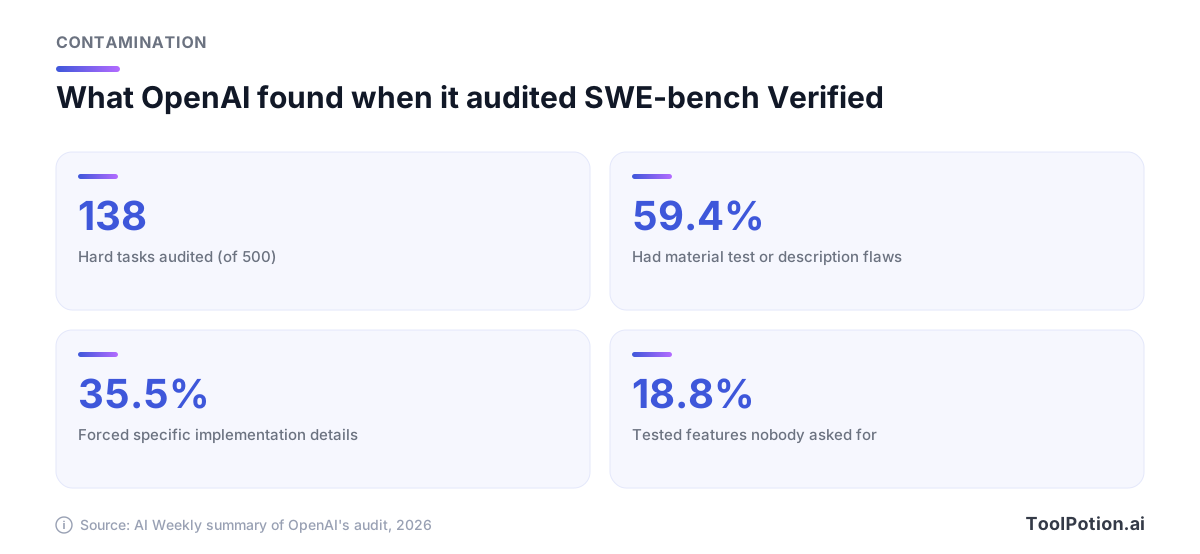
OpenAI a audité 138 problèmes de Verified que son modèle o3 ne résolvait pas de façon fiable, chacun relu par au moins six ingénieurs. Elle a constaté que 59,4 % comportaient des problèmes importants dans leurs tests ou leurs descriptions. Dans un test de contamination distinct, GPT-5.2, Claude Opus 4.5 et Gemini 3 Flash Preview pouvaient chacun reproduire des détails des correctifs originaux, signe que les tâches avaient fuité dans les données d'entraînement. OpenAI indique avoir cessé de publier des scores Verified et recommande SWE-bench Pro à la place (OpenAI). Le résumé d'AI Weekly ajoute que les meilleurs modèles tournaient autour de 80 % sur Verified et environ 35 points plus bas sur Pro, et qu'un audit externe ultérieur a aussi mis en doute les correcteurs de Pro (AI Weekly).
La leçon n'est pas que les benchmarks de code sont inutiles. C'est qu'un score issu d'un test retiré ou qui a fuité est un vieux chiffre. Quand un article de lancement cite SWE-bench, vérifiez la variante, et vérifiez quel scaffolding d'agent entourait le modèle. L'étude « HarnessTax » d'Arena, portant sur 21 paires modèle-scaffolding, a constaté que le choix du scaffolding avait peu d'effet sur le taux de réussite mais pouvait multiplier le coût par 5 à résultats comparables, sur un petit échantillon de 30 tâches par benchmark (Arena).
Une checklist pour toute annonce « n° 1 »
Voici la version en deux minutes. Passez-la en revue avant de croire un classement, et surtout avant de dépenser de l'argent à cause de lui.
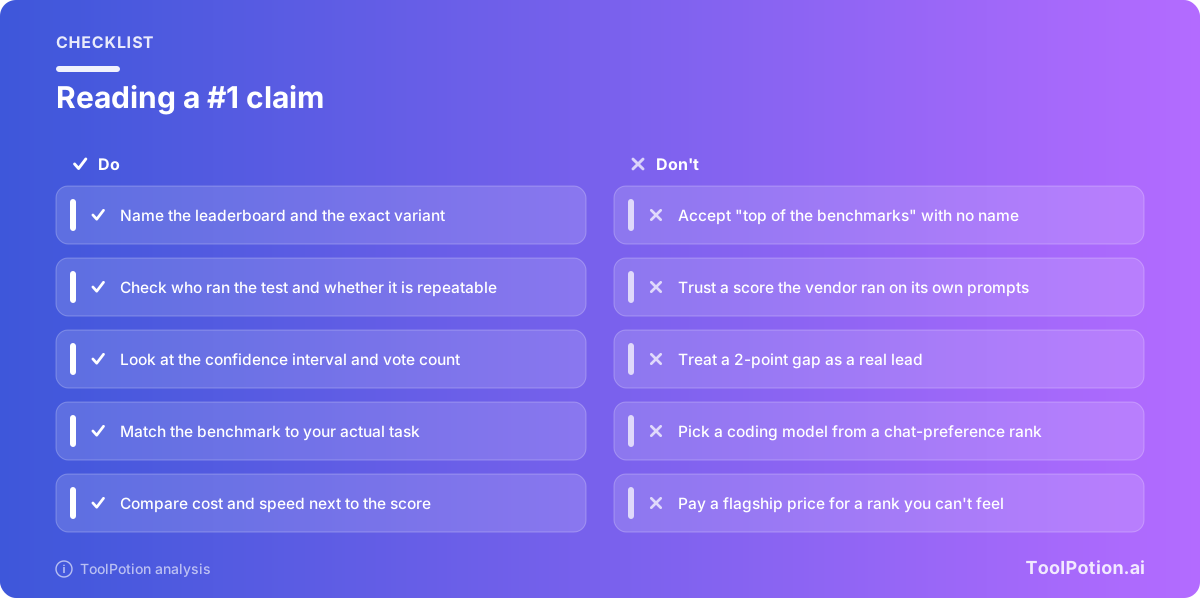
- Trouvez le classement exact et sa version. « Domine les benchmarks » n'est pas une affirmation vérifiable. « Premier sur Arena texte avec contrôle du style » l'est.
- Trouvez qui l'a mené. Un test d'un labo sur ses propres prompts est un chiffre marketing. Une nouvelle exécution par un tiers a plus de poids.
- Lisez l'intervalle et le nombre de votes. Si l'avance est inférieure à l'intervalle, c'est une égalité.
- Vérifiez que le modèle est public. Un score pour quelque chose que vous ne pouvez pas essayer aujourd'hui ne vous aide pas à choisir.
- Demandez-vous si le test correspond à votre tâche. La préférence en chat ne prédira pas comment un modèle gère vos tableurs ou votre base de code.
- Cherchez un second classement, différent, qui concorde. Un classement peut se tromper ou être manipulé. Deux classements indépendants qui concordent, c'est bien plus difficile à truquer.
- Mettez le prix et la vitesse à côté du score. Le modèle moins cher, classé deux places plus bas, est souvent le meilleur achat.
Vous pouvez évaluer une annonce vous-même avec la checklist ci-dessous. Elle pondère davantage ce qui est le plus difficile à truquer, comme les exécutions par des tiers et la concordance entre classements.
Choisir le classement selon votre question
Comme les classements répondent à des questions différentes, le bon réflexe est de partir de votre question et de choisir le classement ensuite. Si vous cherchez un assistant pour écrire et converser, une arène de préférence est un premier filtre correct. Si vous voulez une comparaison reproductible des capacités brutes, utilisez une suite indépendante. Si vous choisissez un outil de code, regardez les benchmarks de tâches construits sur de vrais dépôts, puis testez sur votre propre code.
L'arbre de décision donne un point de départ, pas un verdict. Quel que soit le classement où vous atterrissez, un court test sur votre propre travail vaut mieux que n'importe quel rang public. Prenez 10 tâches réelles que vous faites chaque semaine, passez-les dans deux ou trois finalistes et comparez les résultats côte à côte. Cela prend un après-midi et mesure la seule chose qu'aucun classement ne peut mesurer : votre travail.
Pour comparer par catégorie, l'annuaire AI Models & LLMs de ToolPotion et le classement des modèles d'IA listent les modèles côte à côte, et le guide pour associer les niveaux de modèles d'IA aux tâches explique quand un modèle phare vaut son prix. Pour un panorama plus large, consultez Top 15 AI Models & LLMs in 2026, ou les alternatives à ChatGPT en 2026 si un assistant précis est votre point de départ.
Là où les chiffres sont les moins fiables
Quelques situations appellent une méfiance accrue. Les nouveaux modèles, dans leurs premiers jours, ont moins de votes et des intervalles plus larges, et Arena marque ces scores comme preliminary pour une raison. Les modèles open-weight, ceux que vous pouvez télécharger depuis Hugging Face, sont l'autre angle mort : les auteurs de Leaderboard Illusion estiment qu'ils reçoivent une part plus faible des données d'Arena, donc leurs scores peuvent être plus bruités. Les modèles hébergés peuvent aussi changer de comportement sous le même nom, si bien qu'un score de la semaine de lancement peut ne pas décrire le modèle que vous utilisez des mois plus tard.
Le travail spécialisé est le plus grand angle mort. La rédaction juridique, le codage médical, une langue de niche et la base de code interne d'une entreprise sont tous mal couverts par les classements publics. Real-SWE Benchmark apporte une réponse : il évalue les modèles de pointe sur des bases de code d'entreprise privées, moins susceptibles d'avoir fuité dans les données d'entraînement que les dépôts publics. Considérez un tel classement comme un utile second avis, pas comme un remplaçant de votre propre test.
Et si vous êtes un utilisateur occasionnel, vous n'avez peut-être besoin de rien de tout cela. Pour l'écriture et les questions du quotidien, les meilleurs modèles d'OpenAI, d'Anthropic et de Google sont assez proches pour que le choix se joue sur le prix, l'interface et l'habitude. Passer une heure sur les classements pour départager des quasi-égalités, c'est un mauvais calcul.
Questions fréquentes
Arena, c'est la même chose que LMArena ?
Oui. LMArena est né du projet de recherche Chatbot Arena de l'UC Berkeley et s'appelle désormais Arena, sur arena.ai. L'ancien nom apparaît encore dans des articles et dans d'anciennes publications.
Quel classement est le plus fiable ?
Aucun n'est fiable dans tous les cas, et la réponse dépend de ce que vous voulez savoir. Pour la reproductibilité, une suite tierce qui exécute elle-même chaque modèle est la plus solide. Pour savoir ce que les gens préfèrent, Arena a le plus de données. La preuve la plus fiable, c'est deux classements indépendants qui concordent, suivis d'un court test sur vos propres tâches.
Qu'est-ce que la contamination d'un benchmark ?
C'est quand un modèle a vu les questions ou les réponses d'un test pendant son entraînement, de sorte qu'un score élevé reflète la mémoire plutôt que la compétence. L'audit de SWE-bench Verified par OpenAI a montré que des modèles de pointe pouvaient reproduire les correctifs originaux de certaines tâches. Les jeux de test privés, comme celui que conserve Humanity's Last Exam, sont une parade.
Les éditeurs trichent-ils sur les classements ?
Les preuves soutiennent une affirmation plus étroite. Les labos choisissent quels scores publier, quels réglages utiliser et, selon l'article Leaderboard Illusion, quelles variantes privées révéler. C'est de la communication sélective dans les règles, pas forcément une infraction. C'est la raison pour laquelle les nouvelles exécutions indépendantes comptent.
Dois-je changer de modèle chaque fois qu'un nouveau passe n° 1 ?
Non. Un écart de rang se situe souvent dans la marge d'erreur, et changer a un vrai coût en prompts, workflows et tests. Changez quand un modèle bat celui que vous utilisez sur vos propres tâches, ou quand il l'égale à un prix nettement inférieur.