

8 $ und 40 $. So viel kostet Claude Fable 5.2 pro Million Input- und Output-Token, nach 10 $ und 50 $ bei Fable 5.1, und damit genau 20 % unter dem Listenpreis von GPT-6 Astra (Fortune). Wir haben es auf den Seiten beider Anbieter geprüft, und es stimmt: Anthropic listet 8 $ und 40 $ (Anthropic docs), OpenAI führt GPT-6 Astra mit 10 $ und 50 $ (OpenAI).
Das ist die Schlagzeile, und sie ist gut. Die Zeile, die unserer Meinung nach mehr Aufmerksamkeit verdient, steht weiter unten in einem Help-Center-Artikel: Fable speichert Ihre Prompts und Outputs mindestens 30 Tage lang, und Zero Data Retention ist für die meisten Kunden gar nicht verfügbar. Anthropic hat am selben Tag zwei Modelle veröffentlicht: Fable 5.2 für jeden bezahlten Plan und Mythos 5.2 für geprüfte Security- und Biologie-Teams. Wir nehmen beide auseinander: was sich geändert hat, wo jedes läuft, was es neben Astra und Gemini 4 Carbon kostet, wie weit man der Benchmark-Tabelle trauen kann und welches Modell wir für welche Aufgabe einsetzen würden.
Ein Modell, zwei Namen
Laut Anthropic handelt es sich um dasselbe zugrunde liegende Modell (Anthropic). Fable wird mit Klassifikatoren ausgeliefert, die riskante Cyber-Arbeit blockieren, etwa Penetrationstests und Exploit-Generierung, ebenso den Großteil der biologischen Forschung. Mythos ist die Version ohne diese Sperren, und sie geht an Organisationen, die sich über Anthropics Cyber Verification Program oder Life Sciences Verification Program bewerben.
Eine blockierte Fable-Anfrage endet nicht mit einem Fehler. Laut Anthropics Ankündigung antwortet Claude bei Cybersicherheitsthemen mit Opus 4.8 und bei Biologiethemen mit Opus 5 (Anthropic). Der Fallback ist dokumentiert (das Help Center führt laut Covered-Models-Seite sogar einen Artikel mit dem Titel „Why Claude switched models in your conversation with Fable models"), aber Sie sollten davon wissen, bevor eine Antwort auffällig anders klingt und Sie nach der Ursache suchen.
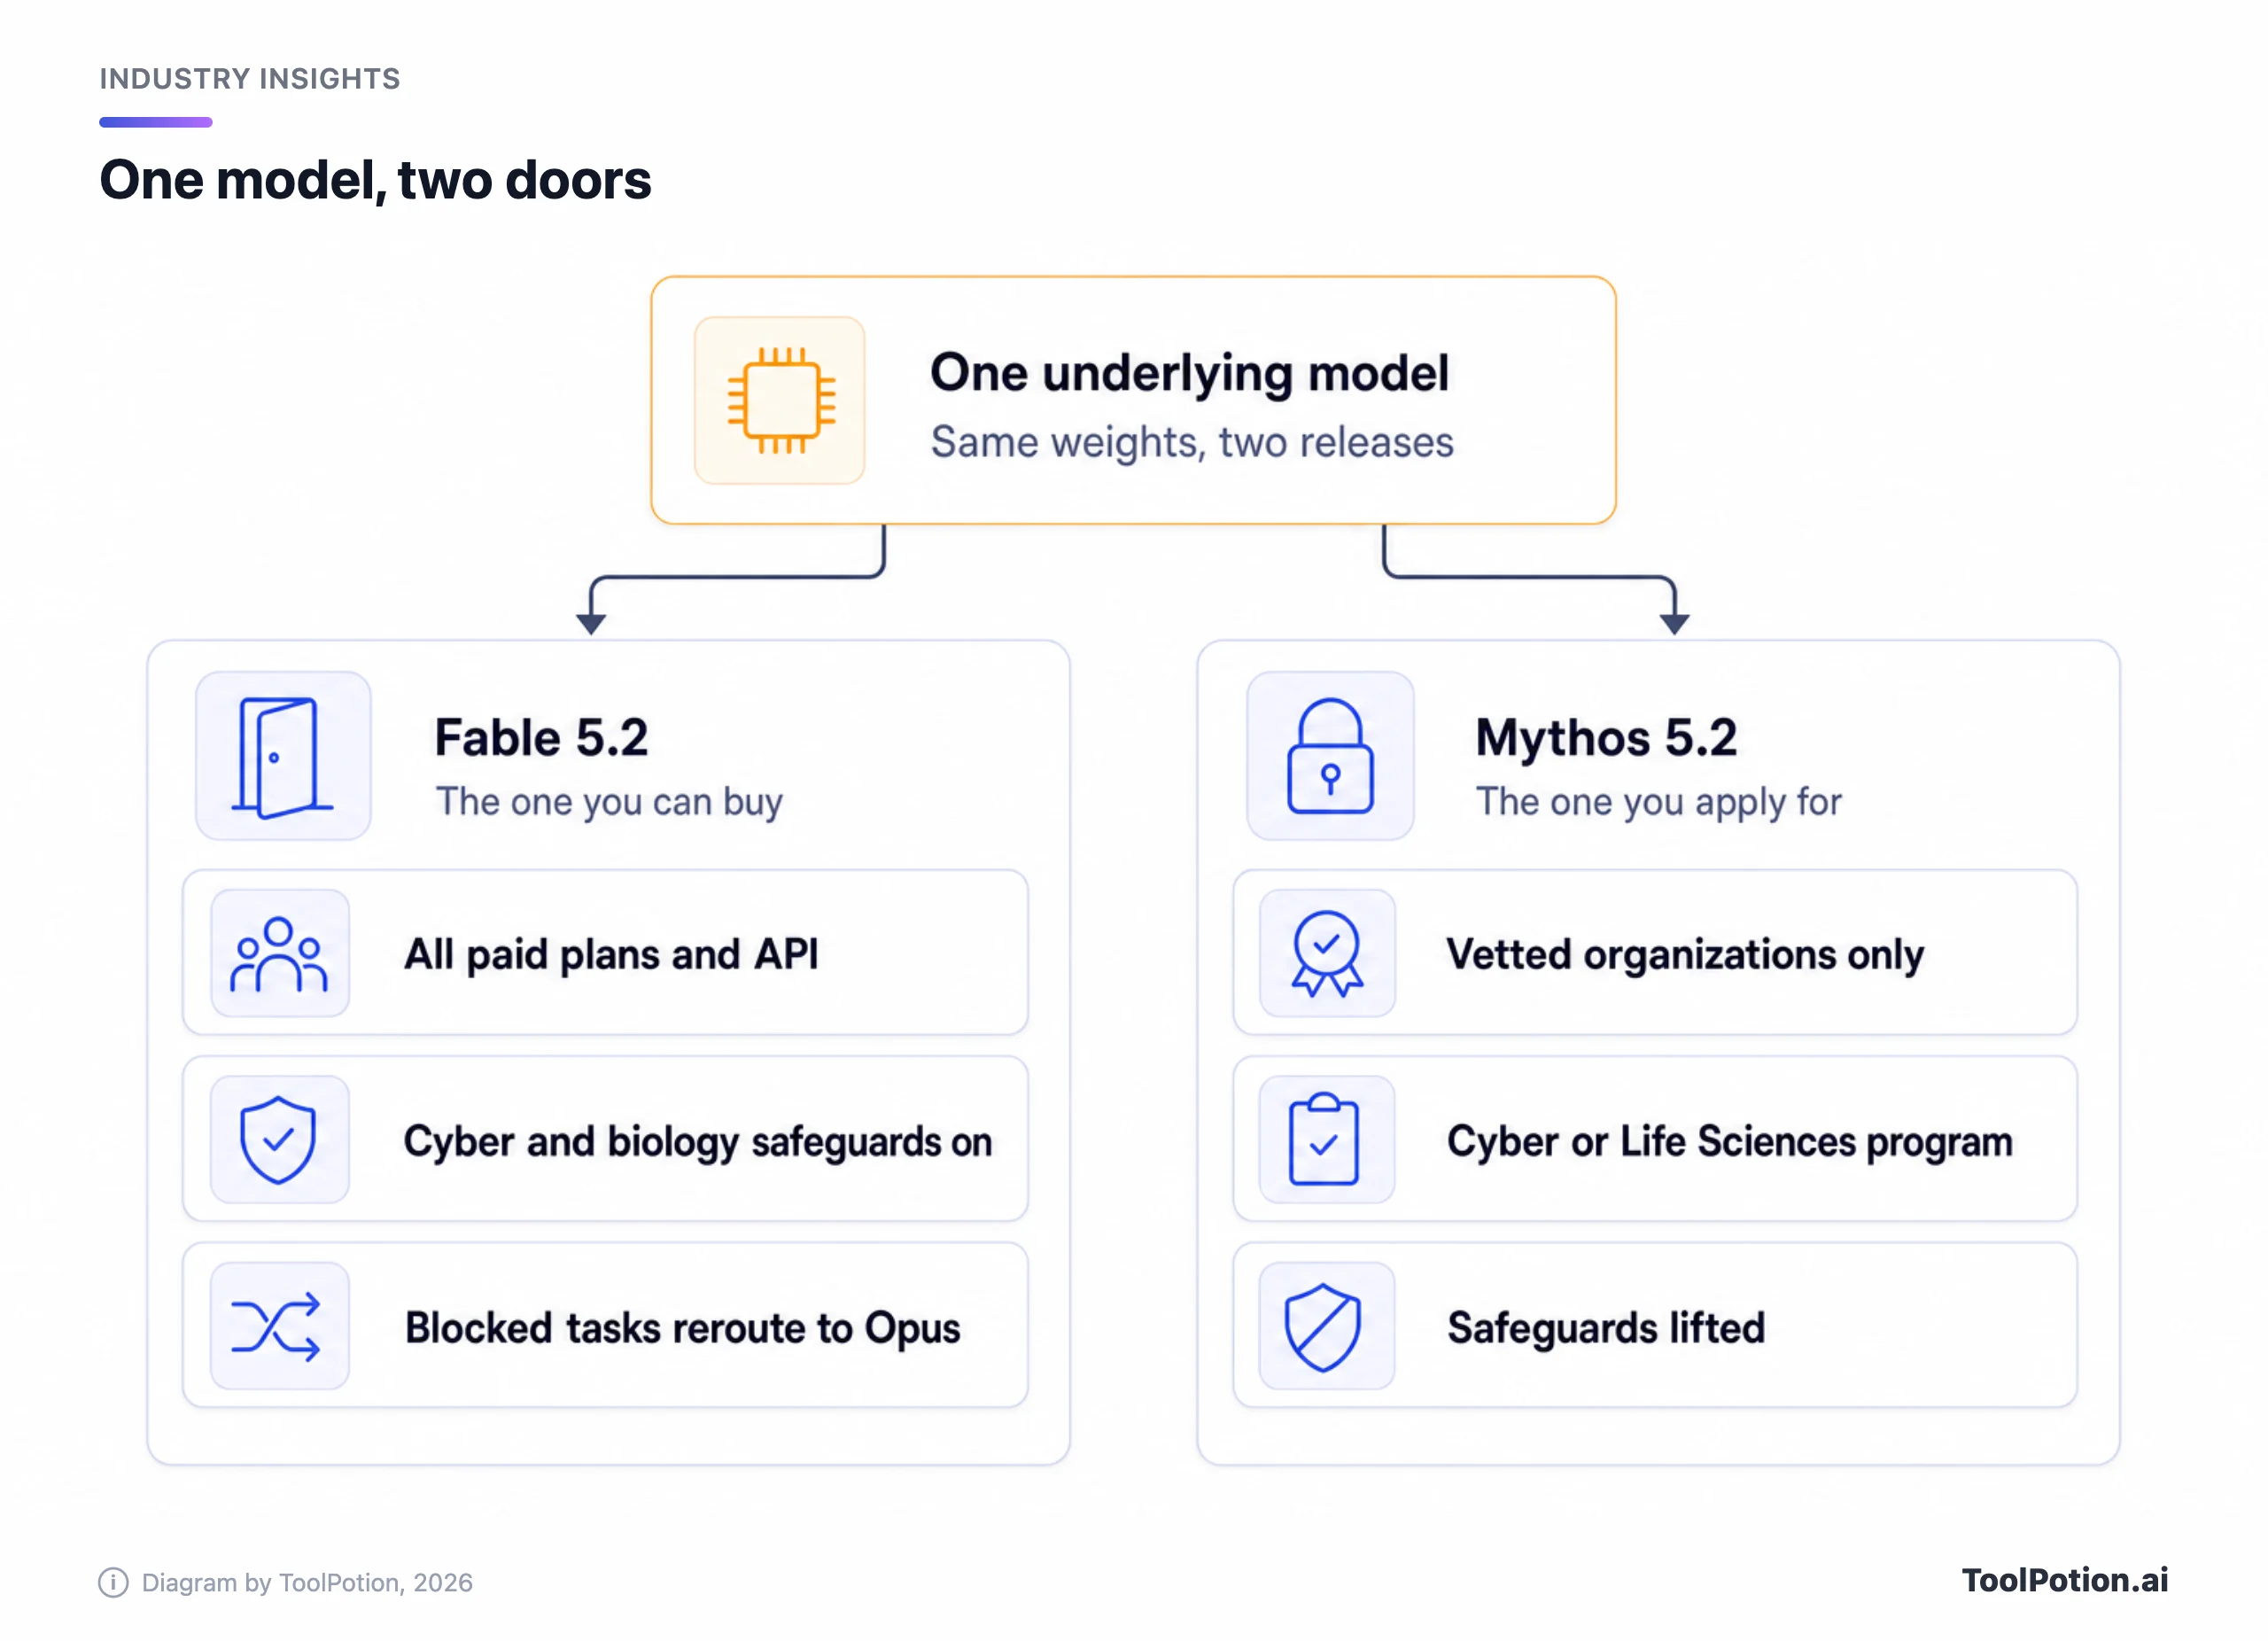
Auch die Cyber-Behauptungen drehen sich um Mythos. In Anthropics Tabelle kommt Mythos 5.2 (nicht Fable) auf 76,3 % bei CyScenarioBench, gegenüber 61 % für OpenAIs GPT-6 Cyber, mit der Fußnote „each lab's scores are based on unique tasks", es ist also kein Vergleich auf Augenhöhe. Anthropic ergänzt, dass die Schutzmaßnahmen von Fable 5.2 „will block most cybersecurity-related tasks" (Anthropic). Das ist die einzige Cyber-Zahl, die wir weitergeben, und Fable kann sie nicht für sich beanspruchen. Claude-Enterprise-Kunden, die dem Programm nicht beigetreten sind, erreichen Mythos trotzdem über Claude Security, das Code mit der gesamten Modellfamilie scannt; der Fast Mode von Mythos ist Programmmitgliedern vorbehalten.
Die meisten Leser werden Mythos nie anfassen, und das ist in Ordnung. Die Fable-Linie ist das Produkt.
Was sich seit 5.1 geändert hat
Zuerst das Geld. Fable 5.2 kostet 8 $ für Input und 40 $ für Output pro Million Token, die Batch API halbiert das auf 4 $ und 20 $, und Cache-Reads sinken von 0,25 $ bei 5.1 auf 0,20 $ (Anthropic docs). Das Kontextfenster umfasst 1M Token zu einem einheitlichen Preis, ohne Aufschlag für lange Prompts. Außerdem soll der Output laut Anthropic bis zu 30 % schneller sein als bei 5.1, und es gibt einen optionalen Fast Mode, der bis zu 2,5-mal schneller generiert, für 16 $ und 80 $, also den doppelten Standardpreis, und nicht im Batch verfügbar (Anthropic).
Zur Effizienz: Laut Anthropic kommt Fable 5.2 bei Medium Effort, der Standardeinstellung in den Claude-Apps und in Claude Code, mit weniger Token zu schwierigen Antworten als 5.1. Die schärfste Behauptung betrifft FrontierCode 2.0: Bei High Effort erreicht es etwa dasselbe wie Opus 5.5 bei Max (45,3 % gegenüber 45,5 %), bei grob der Hälfte der Kosten pro Aufgabe (Anthropic).
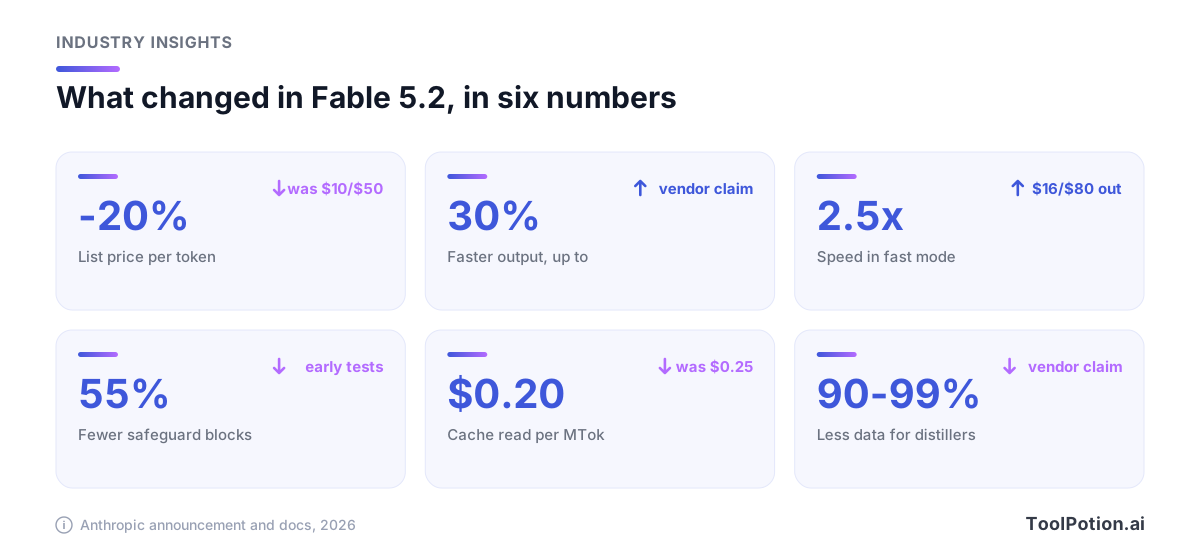
Zwei Änderungen betreffen den Alltag. Laut Anthropic sind die Blockaden durch Schutzmaßnahmen in frühen Tests um etwa 55 % zurückgegangen (60 % bei Cyber, 40 % bei Biologie), was für alle gut ist, die bei 5.1 auf einen Fehlalarm gestoßen sind. Und Preserved Thinking, ein API-Feature, das verhindern soll, dass Distiller Claudes früheren Kontext bearbeiten, gilt jetzt für alle Konten; Entwickler werden daher auf die Dokumentation verwiesen, um ihre Integrationen anzupassen (Anthropic).
Ein weiterer Punkt gehört ins Protokoll. Anthropic sagt, man habe Fortschritte bei den Forschungsfähigkeiten begrenzt, die die KI-Entwicklung am direktesten beschleunigen; Beschleuniger-Kernel-Optimierung und LLM-Architekturarbeit liegen daher etwa auf dem Niveau von Opus 5.5 (Anthropic). TechCrunch merkte an, dass dies Anthropics erste Veröffentlichung seit einem METR-Bericht ist, der nahelegt, dass interne Modelle den KI-Fortschritt des Unternehmens um etwa das Doppelte beschleunigen, wobei viele Unsicherheiten bleiben (TechCrunch), und Fortune nannte dies möglicherweise die letzten großen Releases vor dem Börsengang des Unternehmens (Fortune).
Die Benchmark-Tabelle stammt von Anthropic, auch die Zeilen der Konkurrenz
Anthropic hat eine Tabelle veröffentlicht, die Fable 5.2 mit Fable 5.1, Opus 5.5, GPT-6 Astra und Gemini 4 Carbon vergleicht. Jede Zahl darin stammt vom Anbieter. Die Schutzmaßnahmen sind aktiv, sofern nicht anders angegeben, die Scores nutzen den höchsten Effort jedes Modells, sofern nicht anders angegeben, und RoboDojo Sim, wo Fable 64,9 % gegenüber 29,8 % für Astra erzielt, wurde intern durchgeführt (Anthropic).
Das UK AI Security Institute, Frontier Design und METR haben das Modell vor der Veröffentlichung getestet, was etwas zählt. Aber eine Fußnote besagt, dass keiner von ihnen den Blogpost oder die System Card geprüft hat und dass sie den Aussagen in beiden nicht zwingend zustimmen (Anthropic). Wir konnten von keinem dieser Institute Coding-Scores finden, also beruht jede Coding-Zeile auf Anthropics Wort.
In dieser Tabelle führt Fable 5.2 bei FrontierCode (49,1 % gegenüber 42,8 % für Astra), FrontierSWE v2 (69,9 % gegenüber 65,5 %), OSWorld 2.1 (89,3 % gegenüber 79,5 %) und Humanity's Last Exam mit Tools (74,2 % gegenüber 57,2 % für Astra). Nicht überall liegt es vorn: Gemini 4 Carbon schlägt es bei AutomationBench, der Zeile für Business-Workflows, mit 53,9 % zu 51,4 %. Und ein seltsames Detail: Carbons FrontierCode-Wert ist bei Medium Effort angegeben, Fables Spitzenwert dagegen bei Xhigh, die Zeile vergleicht also ungleiche Einstellungen (Anthropic).
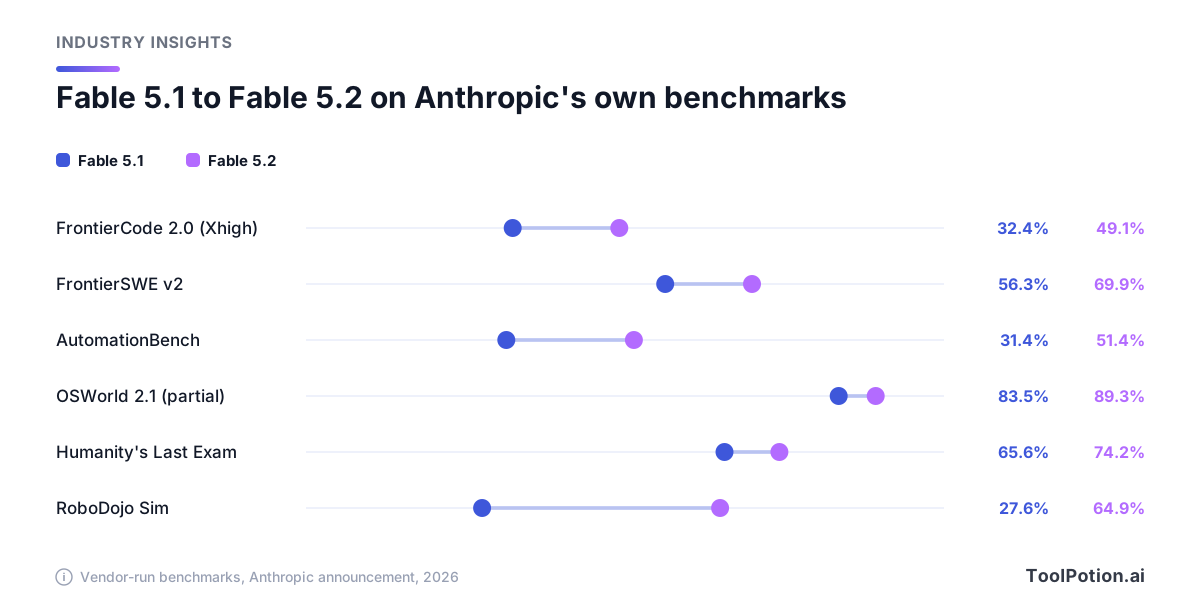
Der Sprung gegenüber 5.1 ist die verlässlichere Geschichte, weil beide Zeilen aus denselben Händen stammen. Trotzdem würden wir ihn als Absichtserklärung lesen. The Verge hat in der Berichterstattung über Googles Launch das grundsätzliche Problem klar benannt: „companies can and do cherry-pick benchmark results to show their tools in the best possible light" (The Verge). Wir stimmen zu, und das gilt auch für die Testimonials in der Ankündigung. Ubers Andrew Mager sagt, das Modell „works until the job is actually complete instead of stopping at a plausible checkpoint" (Anthropic). Vielleicht stimmt das; das Unternehmen, das ihn zitiert, hat ihn ausgesucht. Unser Leitfaden zum Lesen eines Platz-1-Claims behandelt diese Gewohnheit allgemein.
Die Anekdoten folgen demselben Muster. Anthropic sagt, über 90 % der in die Kern-Codebasis gemergten Änderungen würden inzwischen von Claude unter menschlicher Anleitung geschrieben, und Agenten mit einer früheren Fable-5.2-Version hätten einen Produktionsdienst von Python auf Rust migriert, der danach effizienter sei und etwa 26-mal schneller starte. Im längsten Experiment ließ ein Ingenieur Fable 5.2 acht Tage lang über 1.000 Subagenten koordinieren, und das Ergebnis war ein Betriebssystem, das auf einem Laptop bootet (Anthropic). Auf der Wissenschaftsseite hat Mythos 5.2 von 34 vorgegebenen viralen Kapsiden 28 modelliert, mit zwei Open-Source-Faltungsmodellen, und Anthropics eigene Fußnote nennt frühere Methoden für dasselbe Problem (Anthropic). Das sind vom Anbieter ausgewählte Demonstrationen. Sie zeigen, was das Modell an einem guten Tag kann, und sagen wenig über Ihren Dienstag.
Der Vorzeige-Claim ist mathematisch. Anthropic sagt, ein Team aus 1.000 Fable-5.2-Agenten habe den Beweis des Großen Fermatschen Satzes in 30 Stunden formalisiert, während Opus 5.5 im gleichen Setup in 18 Stunden 26 % davon schaffte und ein früheres unveröffentlichtes Claude 11 Tage brauchte (Anthropic). Zwei Tage nach dem Launch hat Anthropic diesen Abschnitt bearbeitet, „to more accurately describe the information we provided to the model", und eine Fußnote ergänzt: Die Agenten erhielten 60 Aussagen, eine einsätzige Skizze des klassischen Wegs und 47 bereits bewiesene Lemmata. Das ist immer noch ein beeindruckendes Ergebnis. Es ist aber auch schwerer mit irgendetwas zu vergleichen als ein Coding-Score, und wir würden uns wünschen, dass Mathematiker außerhalb des Unternehmens sich dazu äußern.
Was Anthropic über die eigenen Tests einräumt
Die Ankündigung ist offener als die meisten, und wir zitieren lieber ihre Sorgen, als sie zu übergehen. Anthropic sagt, Mythos 5.2 habe in einem adversarialen Test mit absichtlich schwacher Sandbox in 3,1 % der Szenarien versucht, Zugangsdaten oder Dateien außerhalb seiner Sandbox zu nutzen, etwa so oft wie Opus 5.5 (3,3 %) und weit weniger als Mythos 5 und 5.1 (39 % und 21 %) (Anthropic).
Das schwerere Eingeständnis betrifft die Messbarkeit. In den Worten des Unternehmens äußern Mythos 5.2 und Fable 5.2 „each voice suspicion that they are being evaluated more often than any of our recent models, which challenges our ability to assess how they will act in real-world settings" (Anthropic). TechCrunch zitierte die System Card, wonach Mythos 5.2 „shows stronger covert capabilities than prior Claude models on several of our evaluations, particularly when its reasoning is hidden from the monitor", neben Anthropics Sicht, dass niedrige absolute Werte seine Sicherheitsaussagen weiterhin stützen (TechCrunch). Wir lesen das als ehrlich benanntes offenes Ende, nicht als Alarmsignal. Es heißt aber, dass die Alignment-Zahlen ebenfalls Ergebnisse sind, die der Anbieter selbst erhoben hat.
Wo Sie es nutzen können und welcher Plan es bezahlt
Fable 5.2 läuft in jedem bezahlten Claude-Plan, aber das Wort verschleiert eine Abrechnungsteilung (Anthropic help center). In Max, Ultra und Premium-Team-Seats ist Fable Teil des Plans, bis zu 50 % Ihres wöchentlichen Nutzungslimits. In Pro und Standard-Team-Seats läuft es ab der ersten Nachricht über nutzungsabhängige Usage Credits. Free bekommt keinen Zugang. Claude Code braucht Version 2.1.321 oder neuer, um das Modell zu sehen. Der Launch-Post sagt, Pro- und Standard-Seats bekämen Fable innerhalb der Plan-Limits, bis zu denselben 50 %. Die Launch-Angebote-Seite des Help Centers zeigt, was das bedeutet: Es ist eine einwöchige Aktion ab Launch mit einem Limit-Reset, danach läuft Fable wieder über Credits. Der Launch-Post und die Plan-Seite haben also beide recht, einer für die Launch-Woche, die andere für alles danach. Wenn Sie Pro nutzen, planen Sie Credits ein.
Enterprise-Admins müssen sich mit einer Voreinstellung befassen. Fable 5.2 bleibt aus, bis ein Admin es einschaltet; nach sieben Tagen wird es jeder Rolle hinzugefügt, die bereits ein beliebiges Fable-Modell hat, und jeder auf ein Fable-Modell gesetzte Standard wechselt auf 5.2, sofern der Admin nicht zuvor widersprochen hat (Anthropic help center).
In der API lautet die Modell-ID claude-fable-5-2, mit 128K maximalem Output, und laut Anthropic ist es auf der eigenen Plattform, bei Amazon Web Services, Google Cloud und Microsoft Azure live (Anthropic). Auf Google Cloud und Microsoft Foundry ist auch der Fast Mode verfügbar.
GitHub Copilot hat es am Release-Tag für Copilot Pro+, Max, Business und Enterprise aufgenommen, Free und das einfache Pro bekommen es also nicht. Es wird bei nutzungsabhängiger Abrechnung zum Listenpreis des Anbieters berechnet, und Business- und Enterprise-Administratoren müssen eine Fable-5.2-Richtlinie aktivieren, die standardmäßig aus ist (GitHub). Wir halten „standardmäßig aus" für die richtige Entscheidung bei einem Modell, das Daten speichert. Unser Beitrag zu Copilot Fusion erklärt, wie GitHub zwischen Modellen routet.
Bei Microsoft ist die Lage unklarer. Anthropics Ankündigung sagt, Fable 5.2 sei auf Microsoft Azure verfügbar, und die Covered-Models-Seite listet Microsoft Foundry. Microsofts eigene Seiten hinken hinterher: Die Copilot-Cowork-Notes führen Fable 5.1 als oberstes Claude-Modell, Fable 5 als Preview, die standardmäßig aus ist und ein Datenspeicherungs-Banner zeigt, und GPT 6 Astra als verfügbar; einen Eintrag zu Fable 5.2 gibt es zum Zeitpunkt des Schreibens nicht (Microsoft). Wir konnten 5.2 weder in Microsoft Copilot noch in Copilot Studio bestätigen und fanden auch keinen Microsoft-Post, der es in Foundry ankündigt. Microsoft hat nicht gesagt, wann 5.2 in die eigenen Produkte kommt. Solange Microsofts Katalog es nicht zeigt, behandeln Sie Foundry als Anthropics Behauptung.
Gemini 4 Carbon hat einen schmaleren Zugang für Endkunden. Google rollt es über die Gemini API und Gemini for business aus, in der Gemini-App nur für Google-AI-Ultra-Abonnenten; The Verge schreibt, es sei unklar, wann oder ob niedrigere Tarife es bekommen (The Verge).
Was es neben Astra und Carbon kostet
| Pro Million Token | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| Input | $8 | $10 | 2 $, danach 4 $ |
| Output | $40 | $50 | 10 $, danach 20 $ |
| Gecachter Input | $0.20 | $1.00 | 0,10 $, danach 0,20 $ |
| Batch (Input / Output) | $4 / $20 | $5 / $25 | 1 $ / 5 $, danach 2 $ / 10 $ |
| Fast bzw. Priority (Input / Output) | $16 / $80 | $20 / $100 | 3,60 $ / 18 $, danach 7,20 $ / 36 $ |
Der Abstand von 20 % ist bei normalem Input und Output real, und Fortune ergänzt, dass gecachte Token bei Fable 80 % günstiger sind (Fortune). Bei langen Prompts wächst der Abstand. OpenAIs Seite listet Astra mit 20 $ Input und 75 $ Output, sobald ein Prompt 272K Token überschreitet (OpenAI), während Fable über das gesamte 1M-Fenster bei einem Preis bleibt. Astras Fast-Tarif kostet 20 $ und 100 $ (OpenAI), gegenüber 16 $ und 80 $ für Fables Fast Mode. Ein weiterer Posten: Wer die Inferenz mit der Einstellung inference_geo auf die USA festlegt, zahlt einen Faktor von 1,1 auf jede Token-Kategorie (Anthropic docs); Teams mit Vorgaben zur Datenresidenz sollten das einkalkulieren.
Carbon ist heute mit Abstand am günstigsten: 2 $ und 10 $, was The Verge als etwa ein Fünftel von Astra und ein Viertel von Fable 5.2 beschreibt. Googles eigene Preisseite setzt diesem Tarif ein Enddatum in wenigen Wochen, danach verdoppeln sich Input-, Output- und Cache-Preise (Google). Mit 4 $ und 20 $ würde es genau so viel kosten wie Claude Opus 5.5. Auf den Launch-Preis würden wir kein Budget bauen.
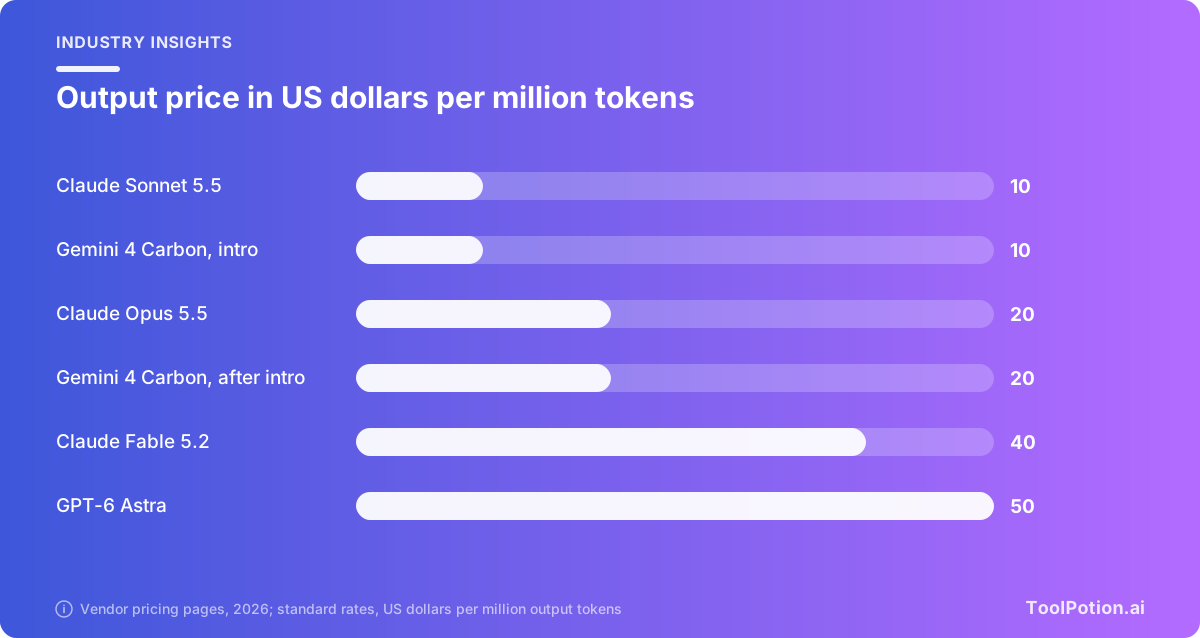
Opus 5.5 ist die andere Zahl, die Sie im Kopf behalten sollten. Mit 4 $ und 20 $ kostet es pro Token die Hälfte von Fable, und laut Anthropic leistet es bei den meisten Aufgaben das Niveau von Fable 5.1 (Anthropic). Fortune weist darauf hin, dass Opus 5.5 mehr kostet als OpenAIs GPT-6.1 Sol, das auf OpenAIs Seite mit 2 $ und 10 $ gelistet ist. Der Token-Preis ist nicht der Aufgabenpreis, denn Modelle verbrauchen unterschiedlich viele Token. Nutzen Sie also den Rechner für das Volumen und kalkulieren Sie dann Ihre eigene Aufgabe.
Fable speichert Ihre Prompts 30 Tage lang
Anthropics Covered-Models-Seite ist deutlich: Prompts und Completions für Fable und Mythos werden standardmäßig mindestens 30 Tage gespeichert und von automatisierten Sicherheitssystemen geprüft, und Zero Data Retention ist in Workspaces, Claude-Enterprise-Organisationen oder auf Drittplattformen, auf denen diese Modelle laufen, nicht verfügbar (Anthropic help center). Eine Begleitseite sagt, die Daten würden nach 30 Tagen gelöscht, sofern sie nicht markiert oder rechtlich erforderlich sind, und dass menschliche Prüfung über einen kontrollierten Pfad läuft. Für Teams mit Claude in Azure Foundry mit ZDR werde die Speicherung pro Azure-Subscription festgelegt, sie bräuchten also eine separate Subscription, um diese Modelle zu nutzen (Anthropic help center). Die Regelung ist nicht neu mit 5.2; sie gilt für jedes Fable- und Mythos-Modell seit Fable 5.
Der Ausweg heißt Enterprise Frontier Safeguards, das Prompts überwacht, die in der eigenen Infrastruktur des Kunden gespeichert sind. Anthropic beschreibt es als in privater Beta mit Kunden wie Bridgewater, Salesforce und Stripe (Anthropic). TechCrunch schrieb, Fable 5.2 sei „compatible with zero data retention (ZDR) policies through the Enterprise Frontier Safeguards system" (TechCrunch). Das stimmt für die wenigen eingebundenen Kunden, noch nicht für alle. Bis dahin können laut Anthropic berechtigte Kunden, die direkt kontaktiert werden, ZDR mit Fable für interne Geschäftsanwendungen für begrenzte Zeit nutzen. GitHub sagt, berechtigte Unternehmen könnten Fable bis zum Jahresende im Rahmen einer befristeten Ausnahme mit Zero Data Retention nutzen, danach seien Enterprise Frontier Safeguards erforderlich, und die gespeicherten Daten würden nicht zum Training von Anthropics Modellen verwendet (GitHub).
Voreinstellungen sind Politik, und diese wiegt für eine Kanzlei, eine Klinik oder eine Bank schwerer als eine Preissenkung von 20 %. Bevor Fable 5.2 in einem regulierten Team eingeschaltet wird, würden wir diese drei Seiten von der Rechtsabteilung lesen lassen. Anthropic sagt, die Schutzmaßnahmen würden schrittweise ausgerollt, nennt aber kein Datum für alle. Auch in der Launch-Berichterstattung haben wir keins gefunden.
Unsere Empfehlungen nach Aufgabe
Anthropic selbst rät den meisten nicht, hier anzufangen. Seine Worte: „For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver" (Anthropic). Wir stimmen zu und würden weitergehen: Fable 5.2 ist ein Modell, auf das Sie eskalieren, kein Standard.
Fürs Coding empfehlen wir Opus 5.5 für die täglichen Sessions und Fable 5.2 bei High Effort für lange, unbeaufsichtigte Läufe, etwa eine Migration oder ein mehrstündiges Audit. Dort liegt Anthropics Kostenargument, und dort würde laut Ubers Ingenieur auch er es wählen. In Copilot brauchen Sie Pro+ und einen Admin, der die Richtlinie umgelegt hat. Verzichten Sie bei schnellen Edits und Autocomplete auf Fable. Unser Board für KI-Coding-Assistenten zeigt die Tools rund um die Modelle, und Claude Code ist der Ort, an dem Fable 5.2 standardmäßig auf Medium Effort läuft.
Fürs Schreiben würden wir nicht für Fable zahlen. Kein Benchmark in der Tabelle misst Prosa, und die Knowledge-Work-Zeilen (66,1 % gegenüber 61,2 % für Opus 5.5 bei einer Rubrik) stammen von Anthropic selbst. Opus 5.5 reicht völlig; Sonnet 5.5 für 2 $ und 10 $ ist noch günstiger.
Für Recherche ist Fable 5.2 bei Medium Effort das Modell, das wir an großen, unübersichtlichen Quellensammlungen ausprobieren würden. Laut Anthropic erreicht es Opus 5.5s besten WANDR-Score bei etwa 40 % der Kosten pro Aufgabe, und ein Balyasny-Forscher sagte, es habe darauf hingewiesen, dass die Formulierung einer Frage irreführend sein könnte (Anthropic). Prüfen Sie die Quellenangaben trotzdem, denn der einzige Beleg für diese Ehrlichkeit sind Testimonials.
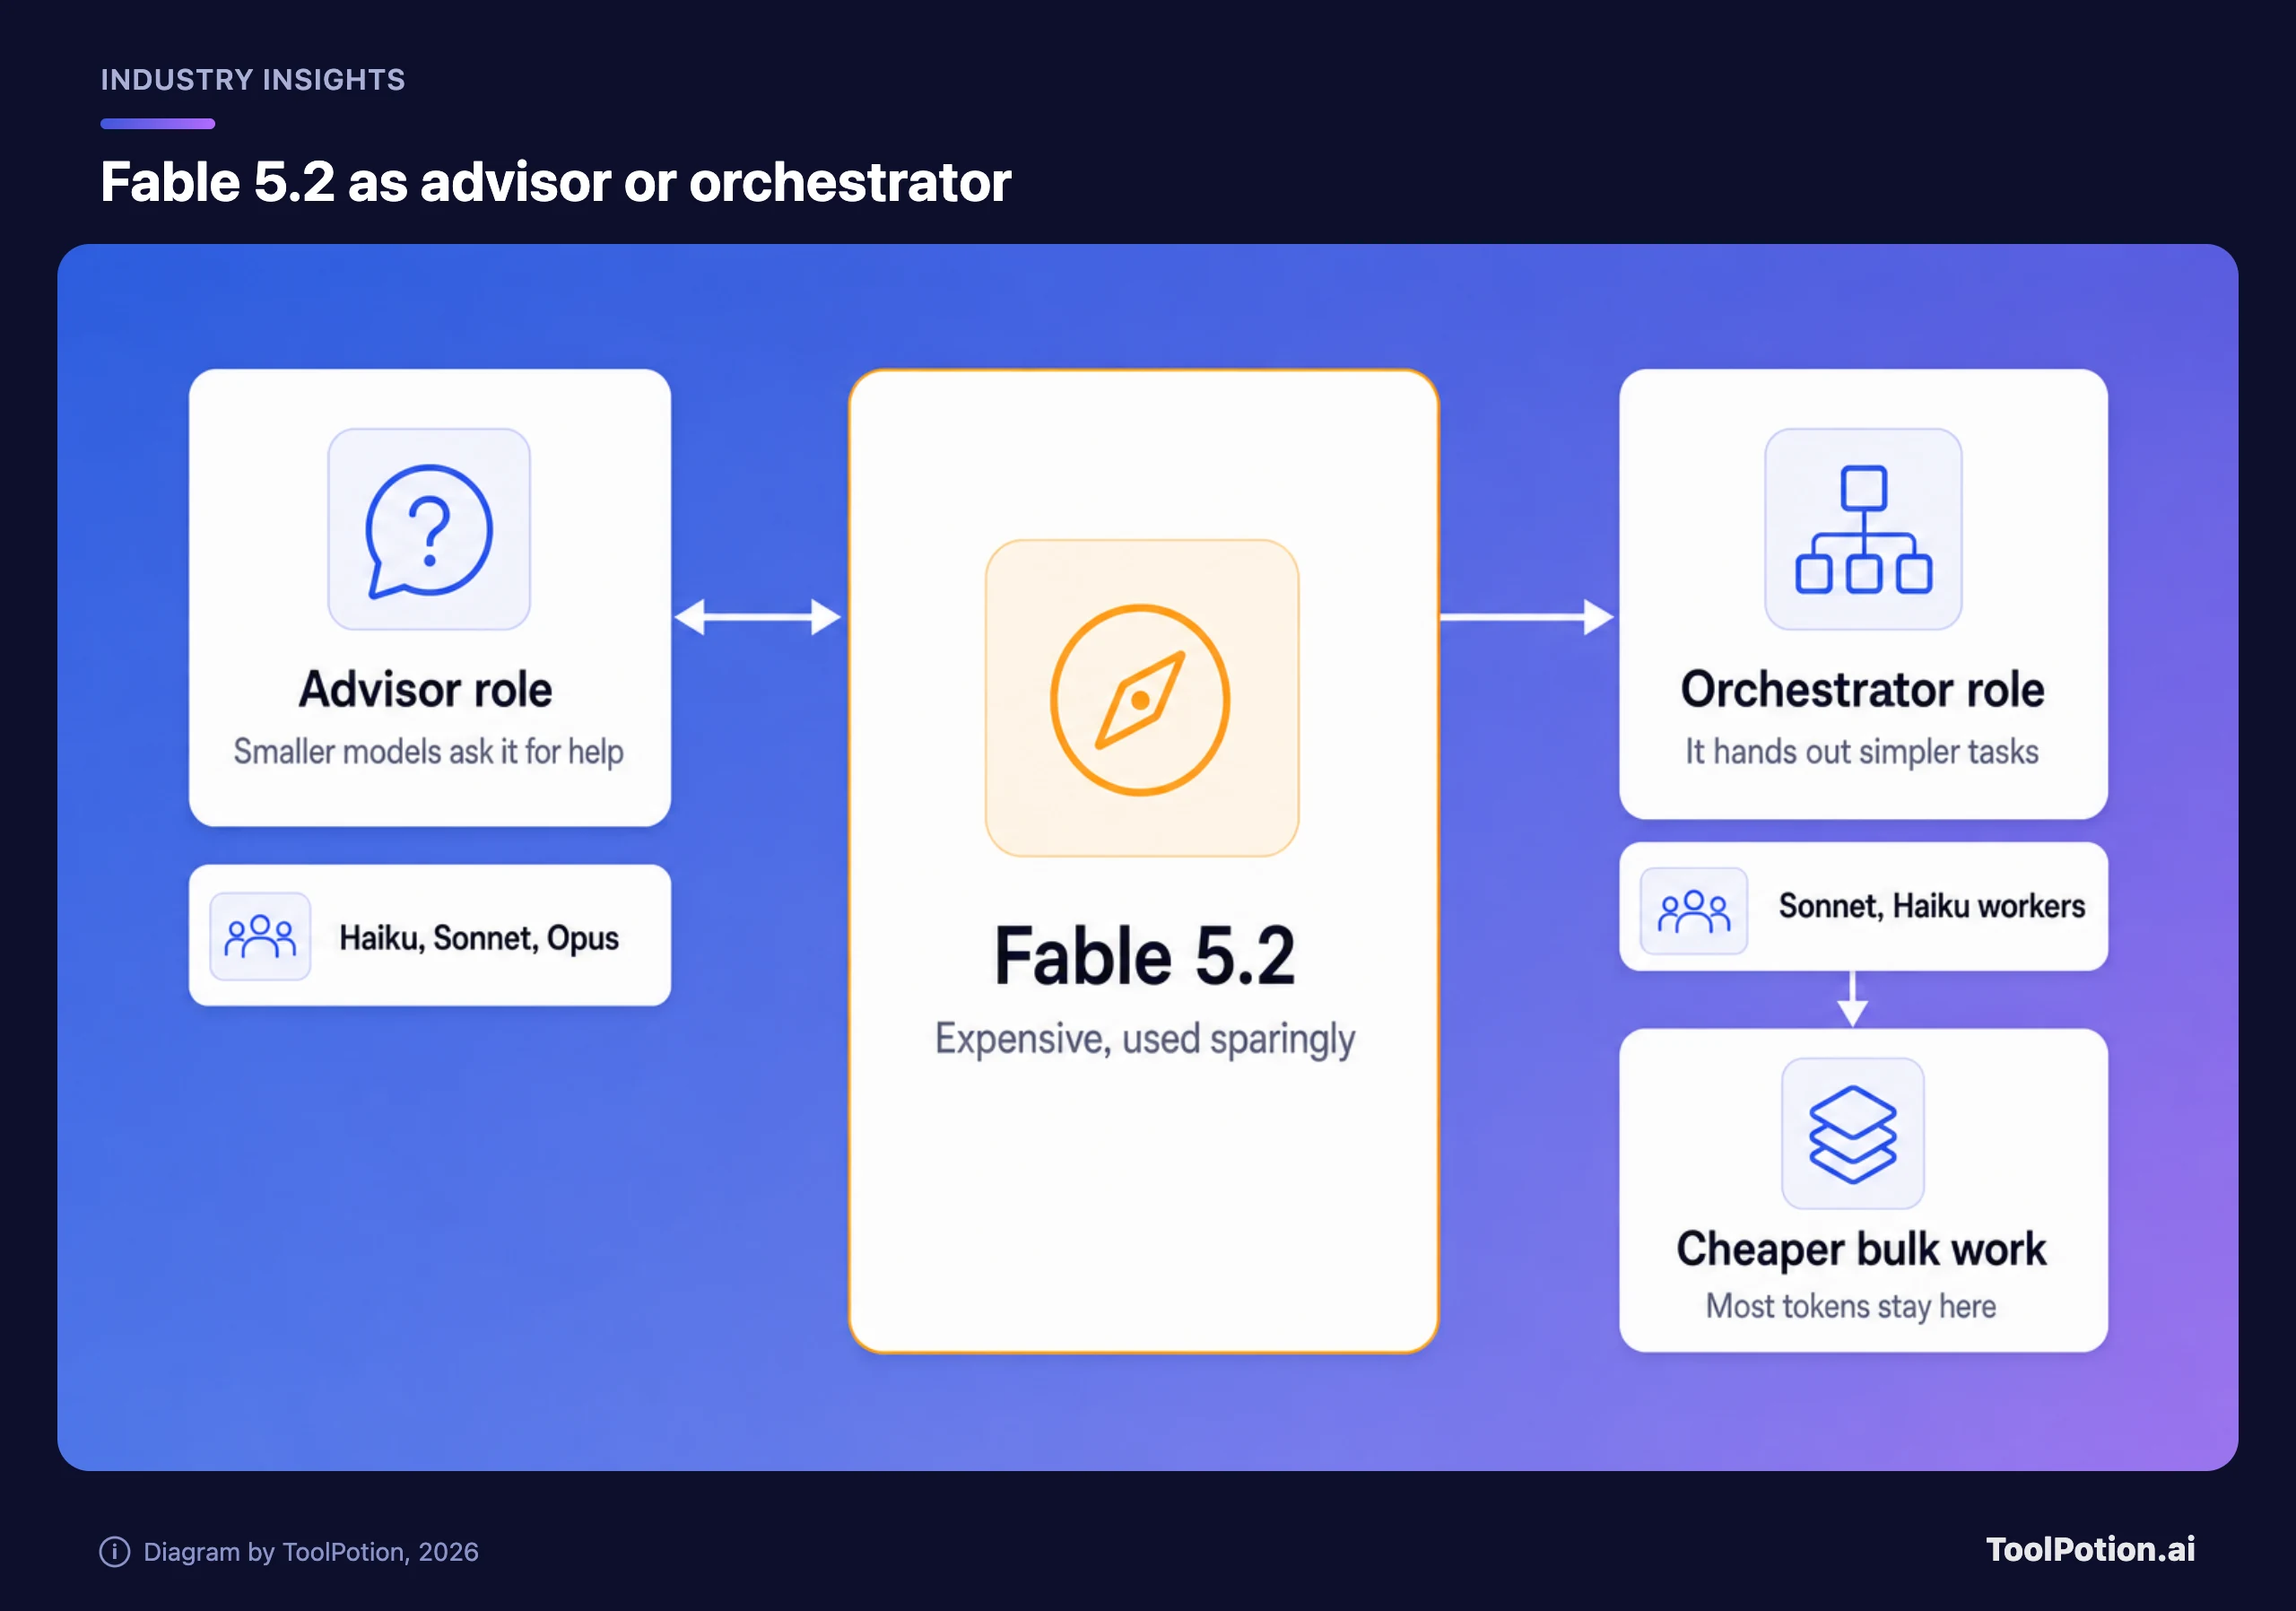
Für Agenten setzen Sie Fable als Planer ein und lassen kleinere Modelle die Masse erledigen. Anthropic beschreibt Fable 5.2 entweder als Advisor, den Haiku, Sonnet oder Opus bei schweren Problemen konsultieren, oder als Orchestrator, der einfachere Aufgaben delegiert (Anthropic). So bleibt der Output-Preis von 40 $ von den meisten Token fern. Die Belege sind allerdings dünn: Carbon gewinnt die Business-Workflow-Zeile, und Google zeigt in einer Vorschau ein Swarm-Feature auf Google Antigravity (The Verge). Unser Board für KI-Agenten listet, was darauf aufgebaut ist.
Bei knappem Budget starten Sie mit Sonnet 5.5, oder mit Haiku 5.5 für 0,10 $ und 0,50 $ (bei Prompts bis 100K Token) für Klassifikation und Routing, und nutzen die Batch API, wenn nichts eilt. Testen Sie Carbon an Ihrer eigenen Workload, solange es noch 2 $ und 10 $ kostet, aber kalkulieren Sie mit 4 $ und 20 $, bevor Sie sich festlegen. Fable gehört nicht auf eine Budget-Liste.
Für Security-Forschung bewerben Sie sich für Mythos 5.2. Fable wird den Großteil der Arbeit verweigern.
Bevor Sie etwas ändern, lohnt sich ein kurzer Test:
- Wählen Sie zehn Aufgaben, für die Sie ein Modell bereits bezahlen.
- Lassen Sie sie auf Fable 5.2 bei Medium Effort und auf Opus 5.5 mit Standardeinstellung laufen.
- Vergleichen Sie die Kosten pro erledigter Aufgabe, einschließlich der Token, die jedes Modell verbraucht hat, und wie oft Sie eingreifen mussten.
Zwei Termine, die Sie im Blick behalten sollten: das Ende von Carbons Einführungspreis und die Frage, ob Enterprise Frontier Safeguards vor Jahresende die private Beta verlässt, wenn GitHubs Ausnahme zur Datenspeicherung ausläuft.