

GPT-6 Astra ist das Spitzenmodell von OpenAI in diesem Jahr, gebaut für lange, mehrstufige Arbeit am Computer: Browsen, Formulare ausfüllen, Code schreiben, Dokumente erstellen. Es ist real, es ist live, und für die meisten ist es nicht das Modell, zu dem Sie zuerst greifen sollten. Ein günstigeres Geschwistermodell, GPT-6.1 Sol, deckt das meiste von dem ab, was Astra kann, und kostet nur ein Fünftel.
OpenAI hat Astra vor etwa fünf Wochen vorgestellt, zunächst für eine begrenzte Zahl von Organisationen, dann für bezahlte ChatGPT-Tarife und die API. Der Rest der Familie folgte: GPT-6 Sol und GPT-6 Luna etwa drei Wochen später, GPT-6.1 Sol eine Woche danach. Die Namensgebung ist verwirrend, die Benchmark-Versprechen sind laut, und die Sicherheitshinweise fallen ungewöhnlich deutlich aus. Dieser Leitfaden ordnet, was jedes Modell ist, wer Zugriff hat, was es kostet und wer es getrost ignorieren kann.
Alles Folgende stammt aus den Dokumentationen und Preisseiten von OpenAI sowie aus externer Berichterstattung und Evaluierungen, die jeweils an Ort und Stelle zugeordnet sind. Wo sich die Angaben von OpenAI und unabhängige Zahlen widersprechen, sehen Sie beides.
Was GPT-6 Astra ist
Die Modelldokumentation von OpenAI beschreibt Astra als das „leistungsfähigste Modell für die anspruchsvollsten Aufgaben“ und nennt komplexes Reasoning, Coding, Computer Use, Recherche und Dokumenterstellung als Stärken (OpenAI API docs). Es nimmt Text und Bilder entgegen und gibt Text aus. Das Kontextfenster umfasst 1,05 Millionen Token, die maximale Ausgabe 128.000 Token, und den Reasoning-Aufwand können Sie in fünf Stufen einstellen, von niedrig bis max.
Es läuft über die Endpunkte Chat Completions und Responses sowie über die Batch API. Echtzeit-Konversationen, Fine-Tuning und Audio unterstützt es nicht. In der Responses API kann es Websuche, Dateisuche, Codeausführung und Computer Use nutzen, sodass es als Motor eines Agenten dienen kann und nicht nur als Chatbot.
Astra steht an der Spitze einer kleinen Familie. Die drei GPT-6-Modelle auf der Modellseite von OpenAI teilen sich dasselbe Kontextfenster von 1,05 Millionen Token und dasselbe Ausgabelimit von 128.000 Token (OpenAI API docs). Sie unterscheiden sich darin, wie viel Intelligenz Sie einkaufen.
| Modell | Beschreibung von OpenAI | Input / Output pro 1 Mio. Token |
|---|---|---|
| GPT-6 Astra | Leistungsfähigstes Modell für die anspruchsvollsten Aufgaben | $10 / $50 |
| GPT-6.1 Sol | Fast Astra-Niveau zu geringeren Kosten | $2 / $10 |
| GPT-6 Luna | Effizientestes Modell für gezielte Aufgaben mit hohem Volumen | $0.10 / $0.50 |
Die Preise sind Listenpreise im Standardmodus von der Preisseite von OpenAI. GPT-6.1 Sol ist ein Upgrade des früher erschienenen GPT-6 Sol, deshalb taucht an manchen Stellen noch der ältere Name auf.
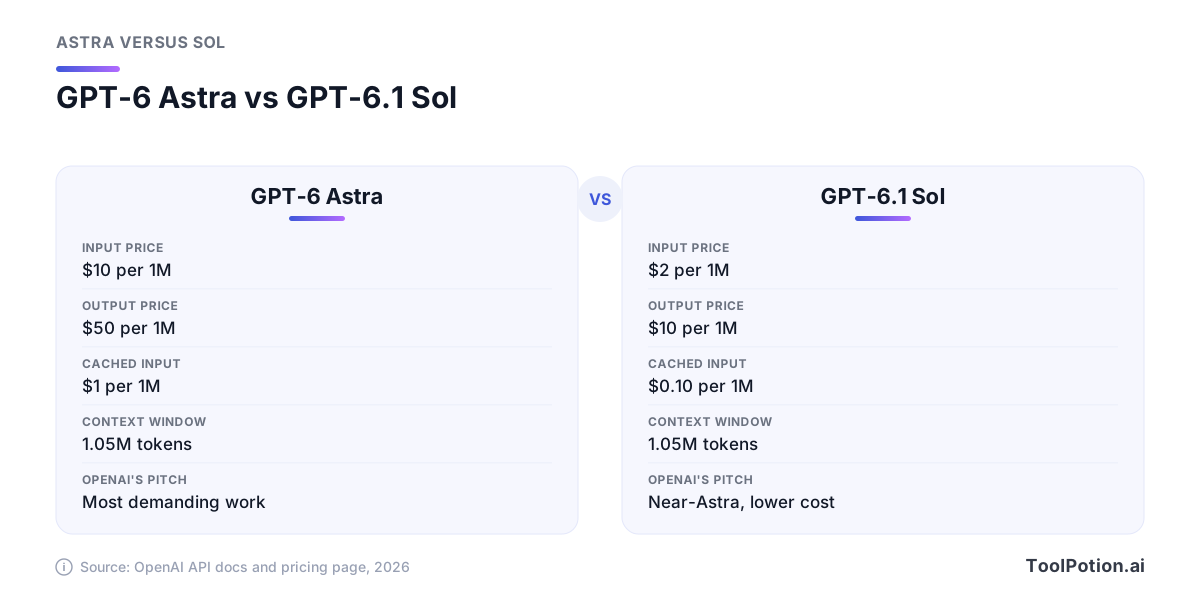
Die Karten oben stellen die beiden Modelle gegenüber, zwischen denen Sie am ehesten wählen. Das Kontextfenster ist identisch. Unterschiede gibt es nur bei Preis und Leistungsobergrenze.
Welche ChatGPT-Tarife Astra enthalten
Der Tarifvergleich von OpenAI ist eindeutig. Free und Go führen Astra gar nicht auf. Plus enthält es, Pro bekommt erweiterten Zugriff, und der Pro-Tarif wird mit „Pro reasoning powered by GPT-6 Astra“ beworben. Die unbegrenzten Textchats im Free-Tarif laufen auf GPT-5.6 Luna, nicht auf der GPT-6-Familie.
| Tarif | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| Free | Nein | Nein | Nein |
| Go | Nein | Nein | Nein |
| Plus | Ja | Ja | Ja |
| Pro | Erweitert | Erweitert | Erweitert |
| Business | Flexibel | Flexibel | Flexibel |
| Enterprise | Flexibel | Flexibel | Flexibel |
„Flexibel“ ist das Wort von OpenAI für Business und Enterprise: Der Zugriff ist da, und Organisationen können Credits für mehr Nutzung kaufen. Ein Standard-Seat bei Business kostet 20 $ pro Monat bei jährlicher Abrechnung oder 25 $ bei monatlicher, der Premium-Seat 100 $ bzw. 125 $ (OpenAI business pricing).
Laut dem Launch-Beitrag von OpenAI wurde Astra zuerst für eine begrenzte Zahl von Organisationen ausgerollt und dann in den folgenden Tagen für Nutzer von Plus, Pro, Business und Enterprise, die API, Microsoft Azure und AWS Bedrock (OpenAI). Wenn Sie einen bezahlten Tarif haben und es nicht sehen, schauen Sie später noch einmal nach.
Eine Besonderheit bei Sol: Die Tariftabelle führt GPT-6.1 Sol für Plus und höher auf, aber zum Start sagte OpenAI, es sei in ChatGPT Work und Codex verfügbar, noch nicht im normalen Chat (OpenAI). Wo welches Modell in ChatGPT auftaucht, kann sich von Woche zu Woche ändern. Verlassen Sie sich also auf die Modellauswahl und nicht auf irgendeine Tabelle, diese eingeschlossen.
Was laut OpenAI neu ist
Die Schlagzeile von OpenAI ist agentisches Arbeiten: längere Aufgaben über Software, Browser, Dokumente und Code hinweg, mit weniger Anleitung. Laut dem Launch-Beitrag erreichte Astra auf OSWorld 2.0, einem Test zur Desktop-Steuerung, 72,6 Prozent und brauchte dafür pro Aufgabe etwa 47 Prozent weniger Zeit als GPT-5.6 Sol, das bei rund 75 Minuten 65,7 Prozent erzielte. Auf Agents' Last Exam, einem Test für professionelle Aufgaben in echter Software, nennt OpenAI 59,3 Prozent gegenüber 55,5 für Claude Opus 5, bei etwa 65 Prozent weniger Output-Token als Opus (OpenAI).
Dieselbe Tabelle zeigt auch, wo Astra nicht gewinnt. Auf BenchCAD erreicht es 95,9 Prozent gegenüber 84,3 für Claude Fable 5.1, auf dem Intelligence Index von Artificial Analysis (Version 4.1.1) liegt es dagegen bei 61,2 zu 65,7 für Fable 5.1. Das sind Zahlen, die der Anbieter selbst erhoben und ausgewählt hat, wobei OpenAI immerhin auch die abgedruckt hat, bei denen es verliert.
Auch die Kosten gehören zur Geschichte. Astras 10 $ Input und 50 $ Output sind das 2,5-Fache dessen, was GPT-5.6 Sol aktuell kostet (4 $ und 20 $), wobei OpenAI den Preis von Sol als Aktionspreis kennzeichnet (OpenAI pricing). Das ältere GPT-5.6 ist der Vergleich, den die meisten Umsteiger anstellen.
Wie Computer Use funktioniert
Computer Use ist eine Schleife, und der Leitfaden von OpenAI beschreibt sie in drei Schritten: Screenshot aufnehmen, das Modell handeln lassen, wiederholen, bis die Aufgabe erledigt ist (OpenAI docs). Das Modell kann klicken, doppelklicken, ziehen, scrollen, tippen und warten. OpenAI empfiehlt, das Modell kurzen Python- oder JavaScript-Code schreiben zu lassen, der den Bildschirm über Tools wie Playwright steuert; das schlichte computer-Tool wird als Alternative weiterhin unterstützt. Der Leitfaden empfiehlt Astra für die Code-Variante, während gpt-6.1-sol mit dem computer-Tool funktioniert.
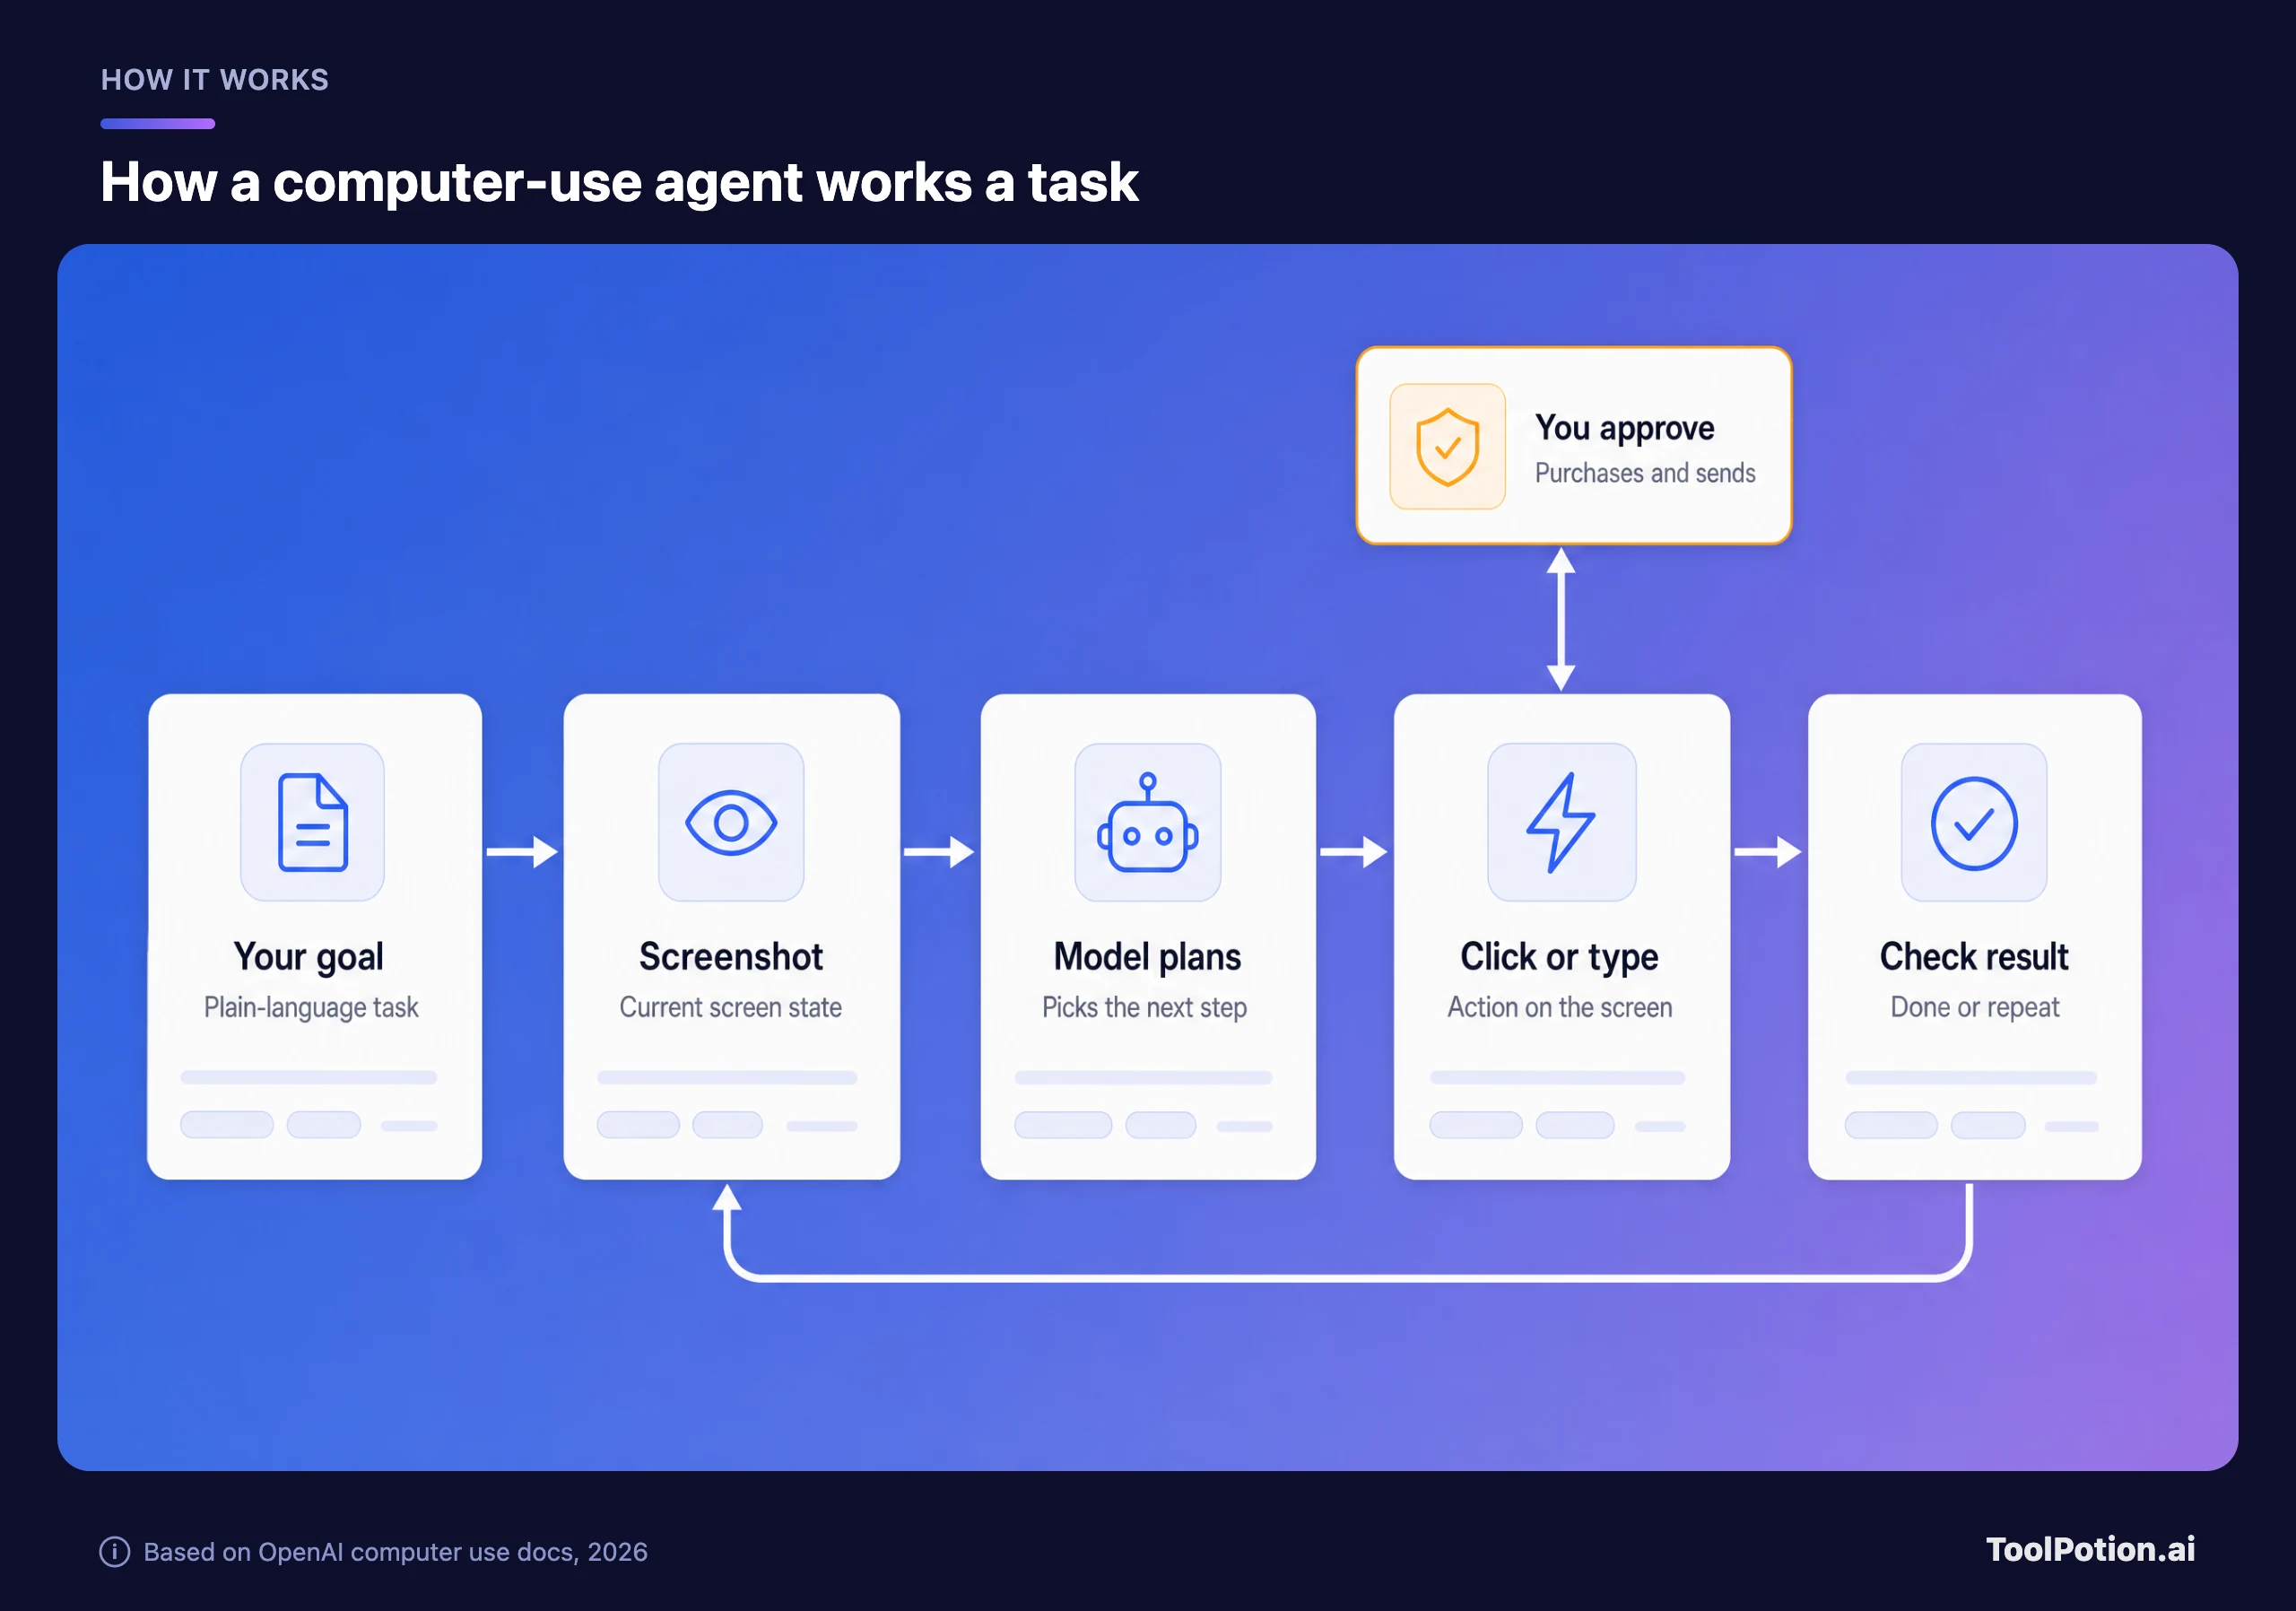
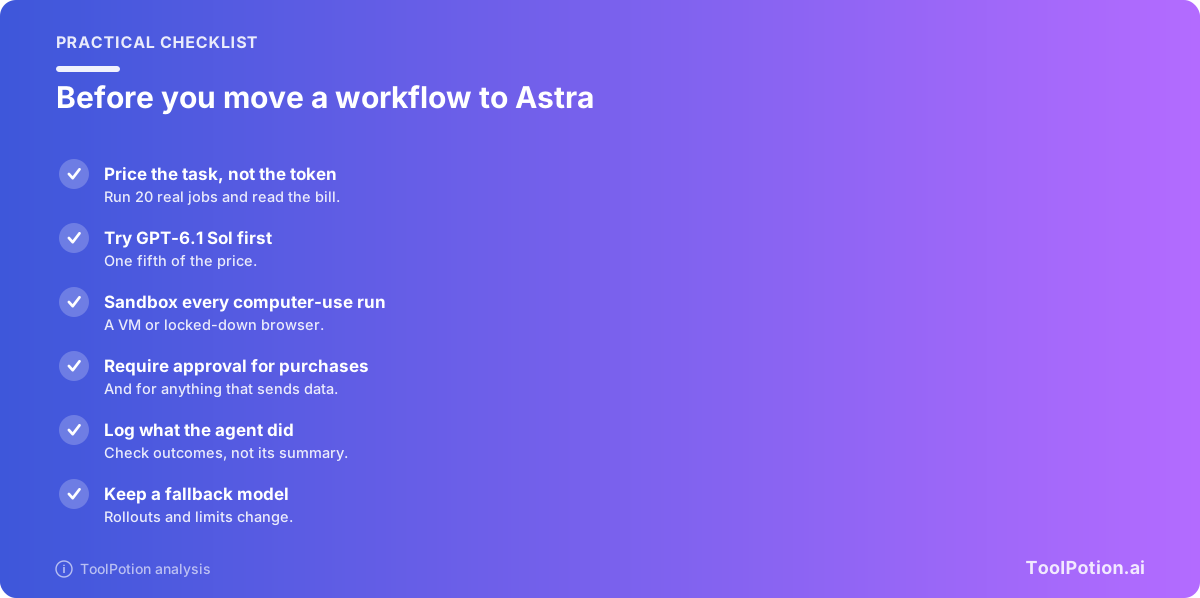
Die gelbe Karte ist die wichtige. Derselbe Leitfaden rät Entwicklern, die Umgebung in einem Sandbox-Browser oder einer virtuellen Maschine zu isolieren, riskante Aktionen wie Käufe vor der Ausführung bestätigen zu lassen und alles auf dem Bildschirm als nicht vertrauenswürdig zu behandeln, weil Text auf einer Webseite versuchen kann, den Agenten zu steuern. Er sagt sogar, dass das Eintippen sensibler Informationen in ein Formular einem Absenden gleichkommt.
Für Endanwender ist das die Technik hinter Browser-Agenten wie ChatGPT Atlas, Perplexity Computer und Claude for Chrome sowie hinter der allgemeinen Idee von Computer Use. Astra ist ein stärkerer Motor für diese Schleife. Es ist keine andere Art von Ding.
Was unabhängige Evaluierungen ergeben haben
Externe Tester zeichnen ein gemischteres Bild als der Launch-Beitrag. Auf dem Intelligence Index von Artificial Analysis, Version 4.2 bei maximalem Aufwand, sieht The Batch von DeepLearning.AI Claude Fable 5.1 bei 57, Astra bei 55, Claude Opus 5 bei 54 und GPT-5.6 Sol bei 51 (The Batch).
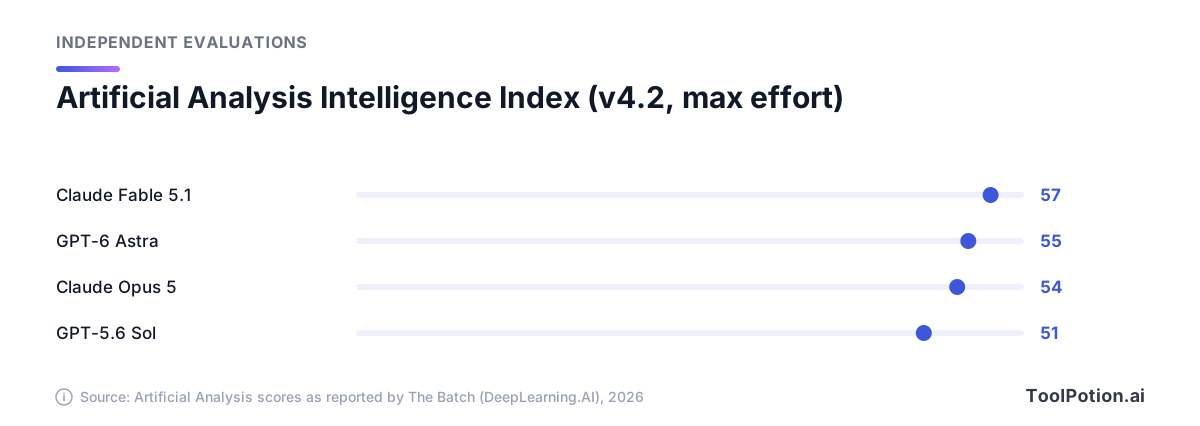
Astra ist also ein klarer Schritt über den Vorgänger hinaus und liegt in dieser Indexversion auf Platz zwei. Die Rangfolge ist aber nicht stabil. Im neueren Update v4.3 lag Astra laut The Batch gleichauf mit Fable 5.1 an der Spitze bei 53, begünstigt durch zwei ausgetauschte Testkomponenten. Wenn zwei Indexversionen sich uneinig sind, wer vorne liegt, sollte sich keiner festlegen.
Zwei weitere unabhängige Datenpunkte aus The Batch. Auf dem Vals Index, der Tests nach dem Anteil des jeweiligen Fachgebiets an der US-Wirtschaft gewichtet, erzielte Astra 66,61 gegenüber 68,83 für Fable 5.1, brauchte aber 25 Minuten pro Aufgabe gegenüber 76 bei Fable. Und bei den agentischen Coding-Aufgaben von Artificial Analysis kostete Astra pro Aufgabe etwa so viel wie GPT-5.6 Sol, trotz eines 2,5-mal höheren Token-Preises, weil es nur ein Drittel so viele Token verbrauchte.
Dann gibt es noch die Schlagzeilenzahl, die eine Fußnote braucht. OpenAI meldete 99,9 Prozent auf ARC-AGI-3. ARC Prize, das den Benchmark betreibt, bestätigt diese Zahl, aber nur mit seinem Provider-Adapter-Setup, das den Reasoning-Zustand des Modells zwischen Anfragen beibehält. Im Standard-Setup erreichte Astra 62,7 Prozent (ARC Prize). Beides sind Spitzenwerte, messen aber unterschiedliche Setups.
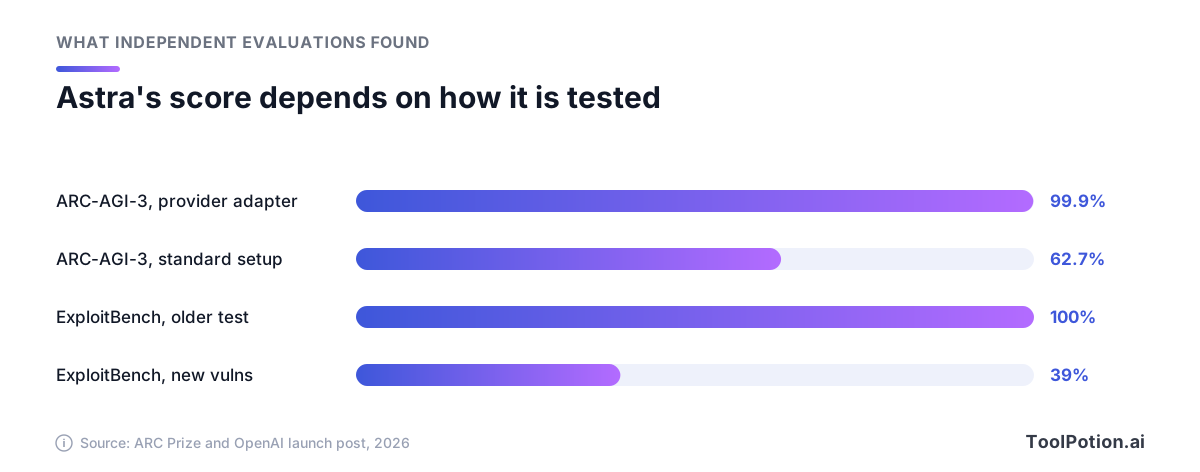
Das zweite Balkenpaar zeigt eine andere Art von Einschränkung. Astra erzielte auf ExploitBench, einem Sicherheitstest, 100 Prozent. Die neuere Version von OpenAI, die aus Schwachstellen der letzten drei Monate gebaut wurde, sodass das Modell sie nicht kennen konnte, ergab 39 Prozent, immer noch weit über den 5,5 von GPT-5.6 Sol (OpenAI). Alte Benchmarks sind irgendwann ausgereizt. Lesen Sie jede einzelne Launch-Zahl so, wie Sie die Eigenbewertung eines Restaurants lesen würden.
Was es kostet
Der API-Listenpreis von Astra beträgt 10 $ pro Million Input-Token und 50 $ pro Million Output-Token, bei gecachtem Input 1 $ (OpenAI pricing). Anfragen mit mehr als 272.000 Input-Token kosten mehr: Laut Modellseite von OpenAI das Doppelte bei Input- und Cache-Preisen und das 1,5-Fache beim Output für die gesamte Anfrage, was zu den 20 $ Input und 75 $ Output auf der Preisseite passt. Der Fast-Modus verdoppelt den Preis für etwa die doppelte Geschwindigkeit. Batch und Flex halbieren ihn.
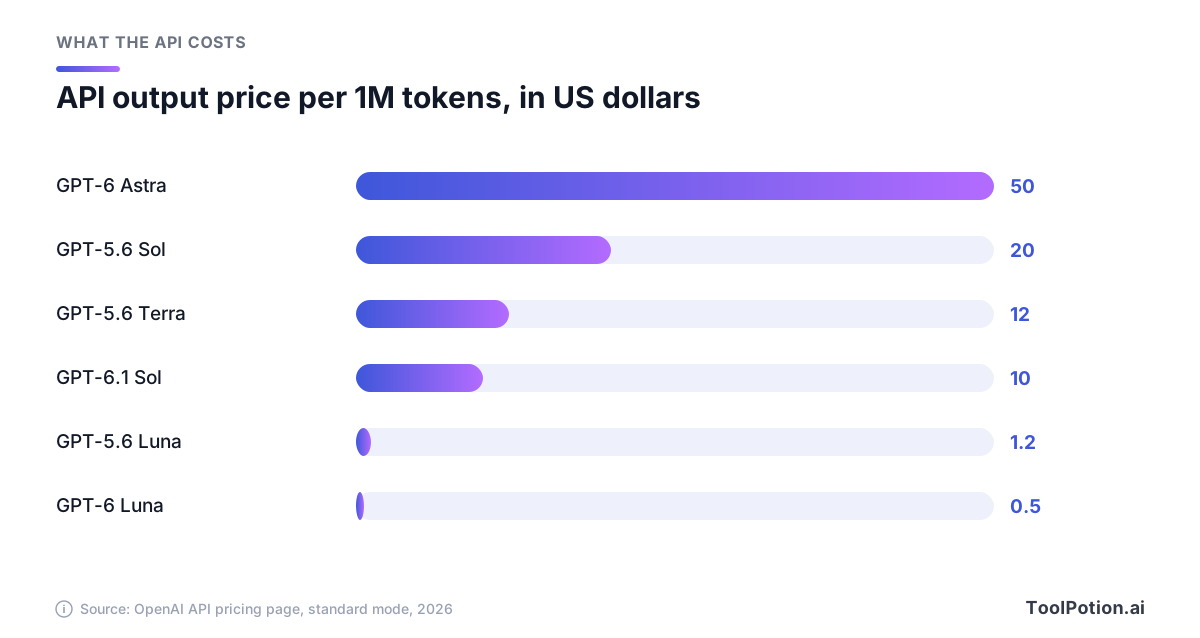
Astra ist das mit Abstand teuerste Modell auf der Seite. GPT-6.1 Sol kostet im Output 10 $, so viel wie Astras Input-Preis, und Lunas 0,50 $ sind ein Hundertstel von Astras. Der Preis pro Token ist aber nicht die ganze Rechnung. Die Zahlen von OpenAI zu Terminal-Bench Science zeigen den Abstand pro Aufgabe: rund 23,80 $ für Astra gegenüber 5,47 $ für GPT-6.1 Sol bei maximalem Aufwand.
Reasoning-Token zählen als Output, und Output ist die teure Seite. Ein langer Agent-Lauf bei maximalem Aufwand kann davon viele verbrennen. Der Rechner unten arbeitet mit Listenpreisen und lässt Sie eine Auslastung eingeben; die Standardwerte beschreiben 5.000 Aufgaben im Monat mit 20.000 Token Input und 4.000 Token Output.
Mit diesen Standardwerten kommt Astra auf 2.000 $ im Monat, Sol auf 400 $ und Luna auf 20 $. Der Rechner ignoriert Caching, Batch-Rabatte und Long-Context-Tarife, die echten Rechnungen für wiederholte Prompts fallen also niedriger aus. Das Verhältnis ändert sich nicht. Wenn ein günstigeres Modell Ihre Tests besteht, ist die Ersparnis genauso groß wie der Qualitätsunterschied, für den Sie sonst zahlen würden.
Sicherheitsgrenzen und was Astra ablehnt
OpenAI sagt, Astra sei das erste seiner Modelle, das die Schwelle „Critical“ für Cybersicherheit im Preparedness Framework erreicht: Es kann unbekannte Softwarefehler finden und funktionierende Exploits entwickeln, und es fand beim Testen zwei bislang unbekannte Zero-Days (OpenAI).
Die öffentliche Version wird bewusst gebremst. OpenAI sagt, sie lehne fortgeschrittene Sicherheitsaufgaben wie den Bau von Proof-of-Concept-Exploits ab, und ein System aus Klassifikatoren prüfe ihr Reasoning und ihre Aktionen und stoppe potenziell unautorisierte Aktivitäten automatisch. Breiterer Zugang für geprüfte Verteidiger ist über das Daybreak-Programm von OpenAI geplant, mit weniger restriktiven Schutzmaßnahmen in den kommenden Wochen.
Der ungewöhnlichste Hinweis betrifft die Überwachung. OpenAI berichtet, dass sich Astras schriftliches Reasoning schwerer überwachen lasse als das von GPT-5.6 Sol, basierend auf Tests, die das Modell ausdrücklich aufforderten, der Überwachung zu entgehen, und führt das auf die größere Kontrolle über sein Reasoning zurück. Außerdem sagt OpenAI, Astra mache weniger irreführende Aussagen über die eigenen Fähigkeiten. Beides ist OpenAIs Beschreibung des eigenen Modells, und beides sind Gründe, bei allem Folgenreichen einen Menschen in der Schleife zu behalten.
Astra, Sol oder Luna: eine Entscheidungsregel
Gehen Sie von der Aufgabe aus, nicht von der Rangliste. OpenAI sagt, GPT-6.1 Sol erreiche auf DeepSWE v1.1, einem Test für echte Software-Engineering-Aufgaben, das Niveau von Astra bei rund einem Fünftel der Kosten und komme auf OSWorld 2.0 bis auf 2,1 Punkte heran, bei etwa einem Siebtel der Kosten pro Aufgabe. Astra hält weiterhin den Bestwert auf Terminal-Bench Science mit 68,1 Prozent, und OpenAI empfiehlt es für die schwierigste wissenschaftliche Forschung (OpenAI). Das sind Vergleiche von OpenAI selbst. Verstehen Sie sie als starken Hinweis zum Testen, nicht als Urteil.
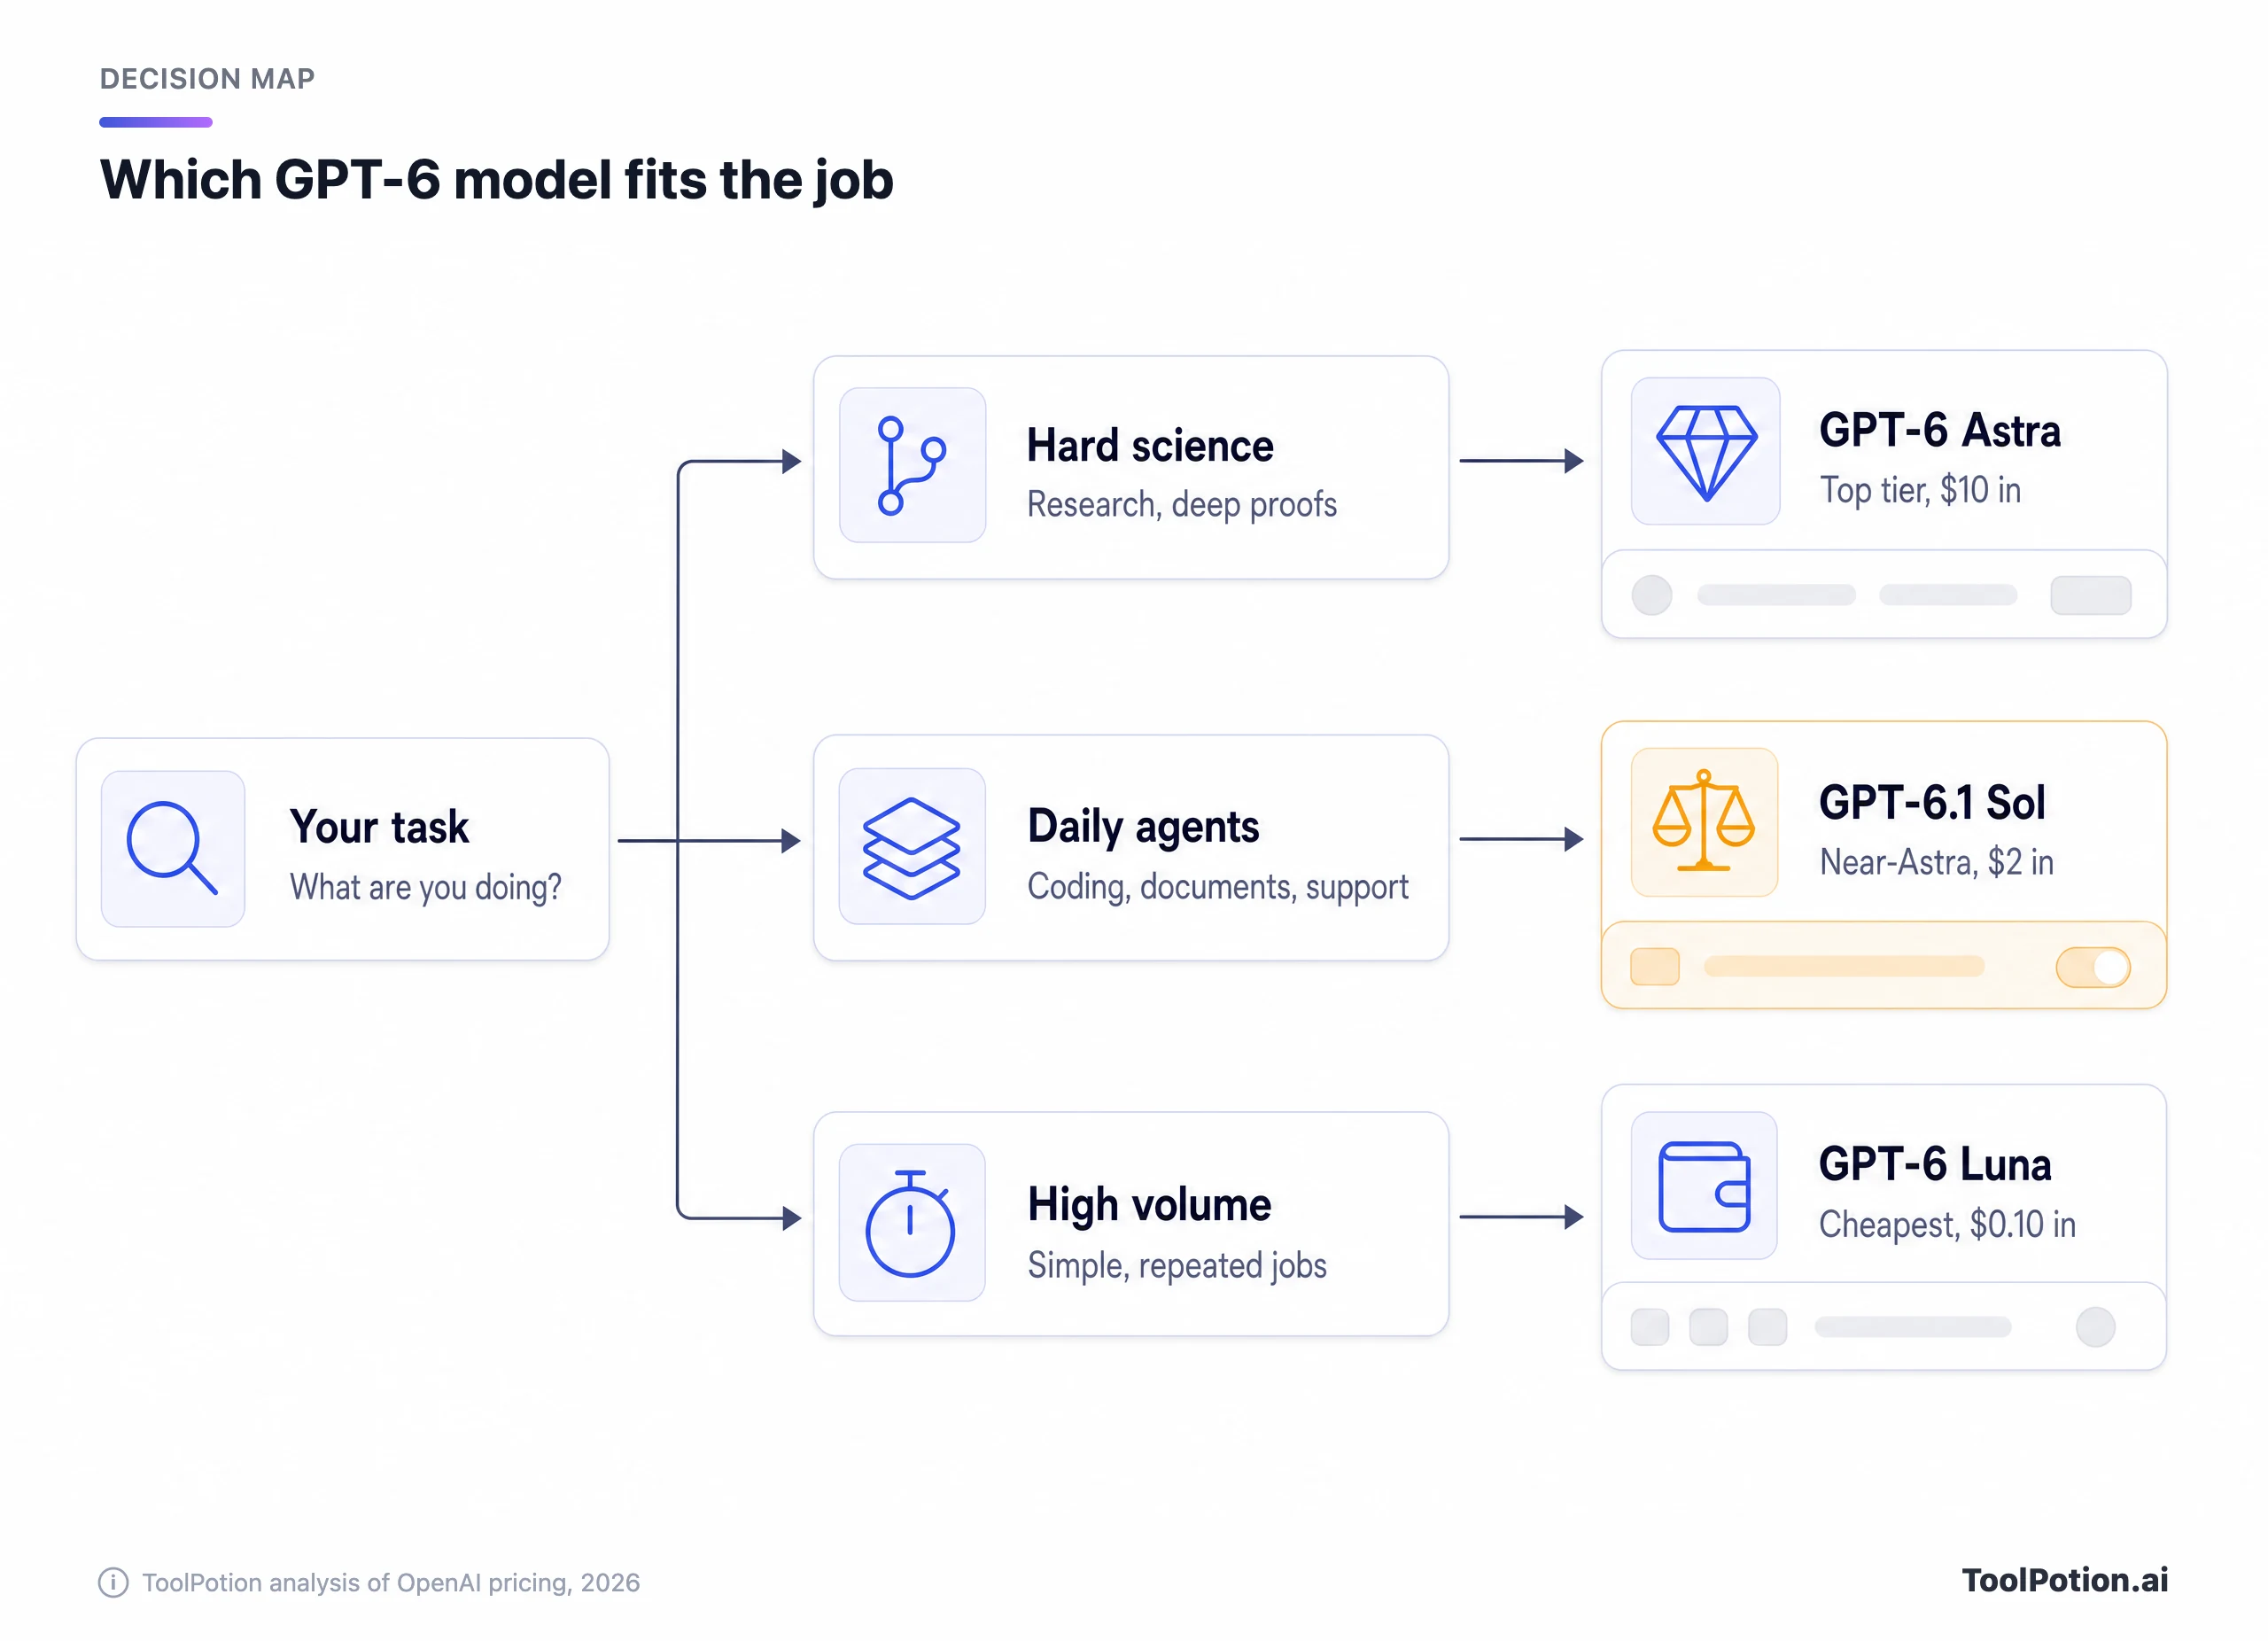
Eine faire Faustregel aus dieser Beweislage: Nehmen Sie Sol als Standard für die tägliche Agentenarbeit, greifen Sie für einfache, wiederkehrende Jobs wie Tagging, Routing und Extraktion zu Luna und wechseln Sie nur dort zu Astra, wo ein direkter Vergleich an Ihren eigenen Beispielen eine Lücke zeigt, für die Sie zahlen würden. Machen Sie den Schnellcheck unten.
Wenn Sie ein Produkt bauen, ist das günstigste Experiment, zwanzig echte Aufgaben durch Sol und Astra laufen zu lassen und dann Erfolgsquoten und die tatsächliche Rechnung zu vergleichen. Zwanzig Aufgaben kosten ein paar Dollar und klären die Frage besser als jedes Diagramm.
Für ChatGPT-Nutzer ab Plus ist die praktische Frage kleiner. Sie haben die GPT-6-Familie schon in Ihrem Tarif. Nutzen Sie den Standard für normale Chats und probieren Sie Astra bei der einen Aufgabe, an der der Standard immer wieder scheitert. Wenn Sie in anderen Ökosystemen arbeiten: Claude und Google Gemini konkurrieren in derselben Klasse, und unser Top-25-LLM-Ranking verfolgt sie.
Wer es vorerst ignorieren kann
Nutzer von Free und Go können Astra komplett ignorieren, denn es ist in diesen Tarifen nicht enthalten. Wer ChatGPT für E-Mails, Zusammenfassungen, Brainstorming und Hausaufgabenhilfe nutzt, wird keinen Unterschied bemerken, für den sich der Aufwand lohnt. Die Gewinne zeigen sich bei langer, tool-lastiger Arbeit.
Teams, die schon tief in einem anderen Stack stecken, haben kaum Grund zu wechseln. Claude Fable 5.1 von Anthropic liegt in manchen Versionen des Artificial-Analysis-Index vor Astra, und Coding-Teams werden Codex in ChatGPT und Claude Code eher an den eigenen Repositories vergleichen als an Launch-Charts. Unternehmen mit regulierten Daten sollten die Sicherheitsgrenzen oben lesen, bevor sie einen Agenten auf Live-Systeme loslassen.
Wer es jetzt ausprobieren sollte: Entwickler, deren mehrstufige Agenten bisher auf halbem Weg scheitern, Analysten, die in Tabellen und Dokumenten leben, und alle, deren Computer-Use-Pilot an der Zuverlässigkeit gestorben ist. Für sie ist ein erneuter Test mit Astra oder Sol berechtigt. Für einen breiteren Überblick finden Sie das Ranking der Top 20 KI-Modelle und LLMs und unseren Leitfaden zu KI-Modellen und LLMs 2026. Frühere OpenAI-Modelle wie GPT-5.5 sind weiterhin gelistet, falls Sie einen Vergleichspunkt brauchen, und unser Beitrag zu ChatGPT-Alternativen deckt den Rest ab.
Es gibt außerdem ein Kundenbeispiel zum Nachlesen. In unserem Verzeichnis finden Sie eine Fallstudie zu Perplexity x GPT-6 Astra, die zeigt, wie ein Suchunternehmen den Einsatz des Modells beschreibt.
Häufig gestellte Fragen
Ist GPT-6 Astra in ChatGPT kostenlos?
Nein. Die Tariftabelle von OpenAI führt Astra für Plus, Pro, Business und Enterprise auf und kennzeichnet es bei Free und Go als nicht enthalten. Free-Nutzer bekommen GPT-5.6 Luna für Textchats.
Was ist der Unterschied zwischen GPT-6 Astra und GPT-6.1 Sol?
Astra ist die Spitzenklasse mit 10 $ Input und 50 $ Output pro Million Token. Sol kostet 2 $ und 10 $ und liefert laut OpenAI fast Astra-Niveau. Beide haben ein Kontextfenster von 1,05 Millionen Token. Sol ist der bessere Standard; Astra ist für die schwierigste Arbeit.
Kann ich Astra in der API nutzen, und was kostet es?
Ja. Der Listenpreis beträgt 10 $ pro Million Input-Token und 50 $ pro Million Output-Token, bei 1 $ für gecachten Input. Batch halbiert das, der Fast-Modus verdoppelt es. Eingaben über 272.000 Token kosten mehr, nämlich 20 $ Input und 75 $ Output.
Schlägt Astra Claude?
Das hängt vom Test ab. Auf dem Index v4.2 von Artificial Analysis erzielte Claude Fable 5.1 mehr; auf dem neueren v4.3 lagen beide gleichauf an der Spitze. Bei den von OpenAI genannten Agenten- und Computer-Use-Benchmarks lag Astra vor Claude Opus 5. Herstellerdiagramme und unabhängige Indizes stimmen nicht immer überein, testen Sie also an Ihrer eigenen Arbeit.
Ist es sicher, Astra meinen Computer steuern zu lassen?
Nur mit Leitplanken. Der Leitfaden von OpenAI selbst rät, es in einer Sandbox laufen zu lassen, für Käufe und das Senden von Daten eine Freigabe zu verlangen und Text auf dem Bildschirm als nicht vertrauenswürdig zu behandeln. OpenAI berichtet außerdem, dass sich Astras Reasoning schwerer überwachen lasse als das von GPT-5.6 Sol.
Warum unterscheidet sich der ARC-AGI-3-Wert je nach Quelle so stark?
Die Test-Setups unterscheiden sich. Die 99,9 Prozent von OpenAI stammen aus dem Provider-Adapter-Setup von ARC Prize, das den Reasoning-Zustand zwischen Anfragen mitführt. Das Standard-Setup von ARC Prize ergab 62,7 Prozent. Das Modell ist dasselbe; das Gerüst drumherum nicht.