

„Wir behaupten nicht, den Beweis schon vollständig zu verstehen.“ Dieser Satz stammt vom Komitee, das OpenAI eingesetzt hat, um sein angebliches Yang-Mills-Ergebnis zu prüfen, zitiert von Scientific American. Die Gruppe unter Leitung des Physikers David Gross hatte gerade bestätigt, dass der Beweis für eine Hälfte des Problems in Lean besteht, einer Programmiersprache, die mathematische Arbeit überprüft. Wie der Beweis funktioniert, konnte sie trotzdem nicht erklären.
Wir haben das neueste KI-für-die-Wissenschaft-Material gelesen: diesen Artikel, fünf Beiträge von Anthropic, einen Wet-Lab-Benchmark von OpenAI, TechCrunch über ein Startup namens PSI und den Blogbeitrag eines Bloggers, dessen KI-Agenten eine Maya-Stätte entdeckten, die im offiziellen mexikanischen Register fehlt. Die Schlagzeilen eilen all dem weit voraus. Deshalb haben wir sechs verbreitete Behauptungen genommen und jede mit dem abgeglichen, was die Quellen tatsächlich sagen.
Behauptung 1: KI entdeckt inzwischen von allein neue Wissenschaft
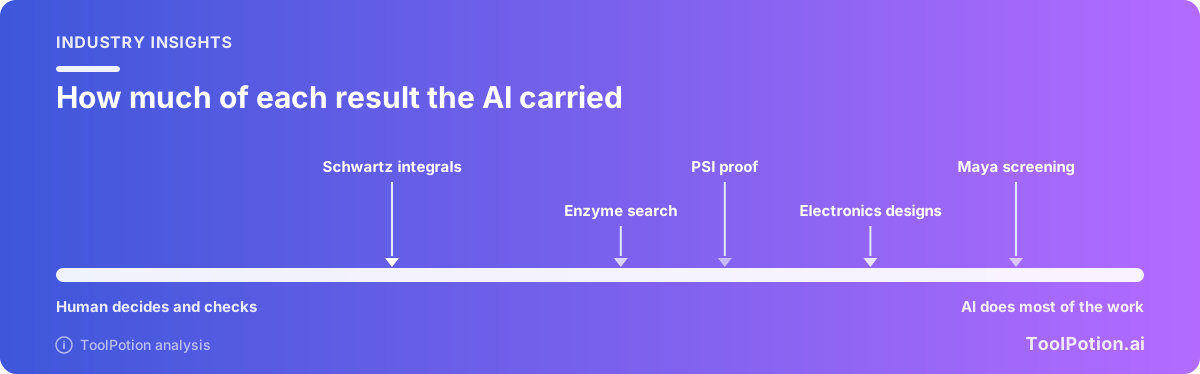
Urteil: nicht von allein. Die besten Fälle sind echt, und in jedem hat ein Mensch die Frage gewählt, die Prüfungen durchgeführt oder beides getan.
Beginnen wir mit der Biologie. Anthropic sagt, Claude-Agenten hätten ein Enzymsystem mit CRISPR-ähnlichen Repeats gefunden, und zwar mit etwa 950 Agenten, 210 Millionen Tokens und 21 Stunden (Anthropic). Ein Agent erkannte das Repeat-Muster. Die Wissenschaftler von Anthropic lieferten den Start-Prompt und erledigten die gesamte Laborarbeit, die meisten Kandidaten von Claude schieden in der Prüfung aus, und die Veröffentlichung ist ein Preprint. Die Arbeit an der Hauptfunktion des Systems läuft noch. Laut dem Beitrag „scheint Claude als Erstes“ die charakteristischen Merkmale des Systems bemerkt zu haben, und Claude „kann Anomalien autonom erkennen“: für die Suchphase fair, für den Rest nicht. Feng Zhang vom MIT und vom Broad Institute, im selben Beitrag nach der Lektüre des Preprints zitiert, nannte es „ein spannendes Beispiel dafür, wie KI-Agenten zu biologischen Entdeckungen beitragen können“, und sagte, der Fund „verdient weitere Untersuchung“.
Der Physiker Matthew Schwartz, Gastforscher bei Anthropic, ist offener als die meisten. In einem Gastbeitrag für Anthropic berichtet er von 30 Integralen, die er mit Claude durchgängig berechnen ließ: 15 reproduzierten bekannte Ergebnisse, 15 waren noch nie berechnet worden (Anthropic). Er nennt die guten Ziele „Claude-förmige“ Probleme und fügt hinzu: „Es kann viel Händchenhalten erfordern, bis sie etwas von wissenschaftlichem Wert hervorbringen.“ Nachdem er externe Experten hinzugezogen hatte, stellte er fest: „In fast allen Fällen war Claude technisch korrekt, aber das Ergebnis war nicht sonderlich interessant, bis der Experte uns die Richtung wies.“ Claude, sagt er, „scheint alte Debatten zu bevorzugen, viel zitierte, aber längst vergessene.“ Die Entscheidung darüber, was zu lösen sich lohnt, blieb bei den Menschen.
Dann PSI. TechCrunch berichtet, dass David Turturean, Mitglied des technischen Teams beim Startup-Labor Physical Superintelligence (PSI), mit frühem Zugang zu Anthropics Modell Fable 5.2 ein 18 Jahre altes Problem aus dem Quantencomputing gelöst hat, die Aaronson-Ambainis-Vermutung (TechCrunch). Scott Aaronson, der das Problem gestellt hat, schreibt, er verstehe den Beweis nicht ganz, halte ihn aber für korrekt, weil er in Lean autoformalisiert und von einem Team führender Forscher erklärt wurde, denen PSI ihn gezeigt hat. Turtureans eigene Beschreibung ist bescheiden: „Es ist ein negatives Ergebnis, das den Leuten sagt: Okay, da suchen wir nicht mehr.“ Die Lösung scheint einen Weg zu Quanten-Speedups zu verschließen, nicht alle.
Wir würden das einen schnellen, unermüdlichen Mitarbeiter nennen, der jemanden braucht, der das Problem auswählt. Das ist eine Menge. Autonomie ist es nicht, und die eigenen Beiträge der Unternehmen sagen das auch, wenn man bis zu den Einschränkungen liest.
Behauptung 2: Die Ergebnisse sind verifiziert
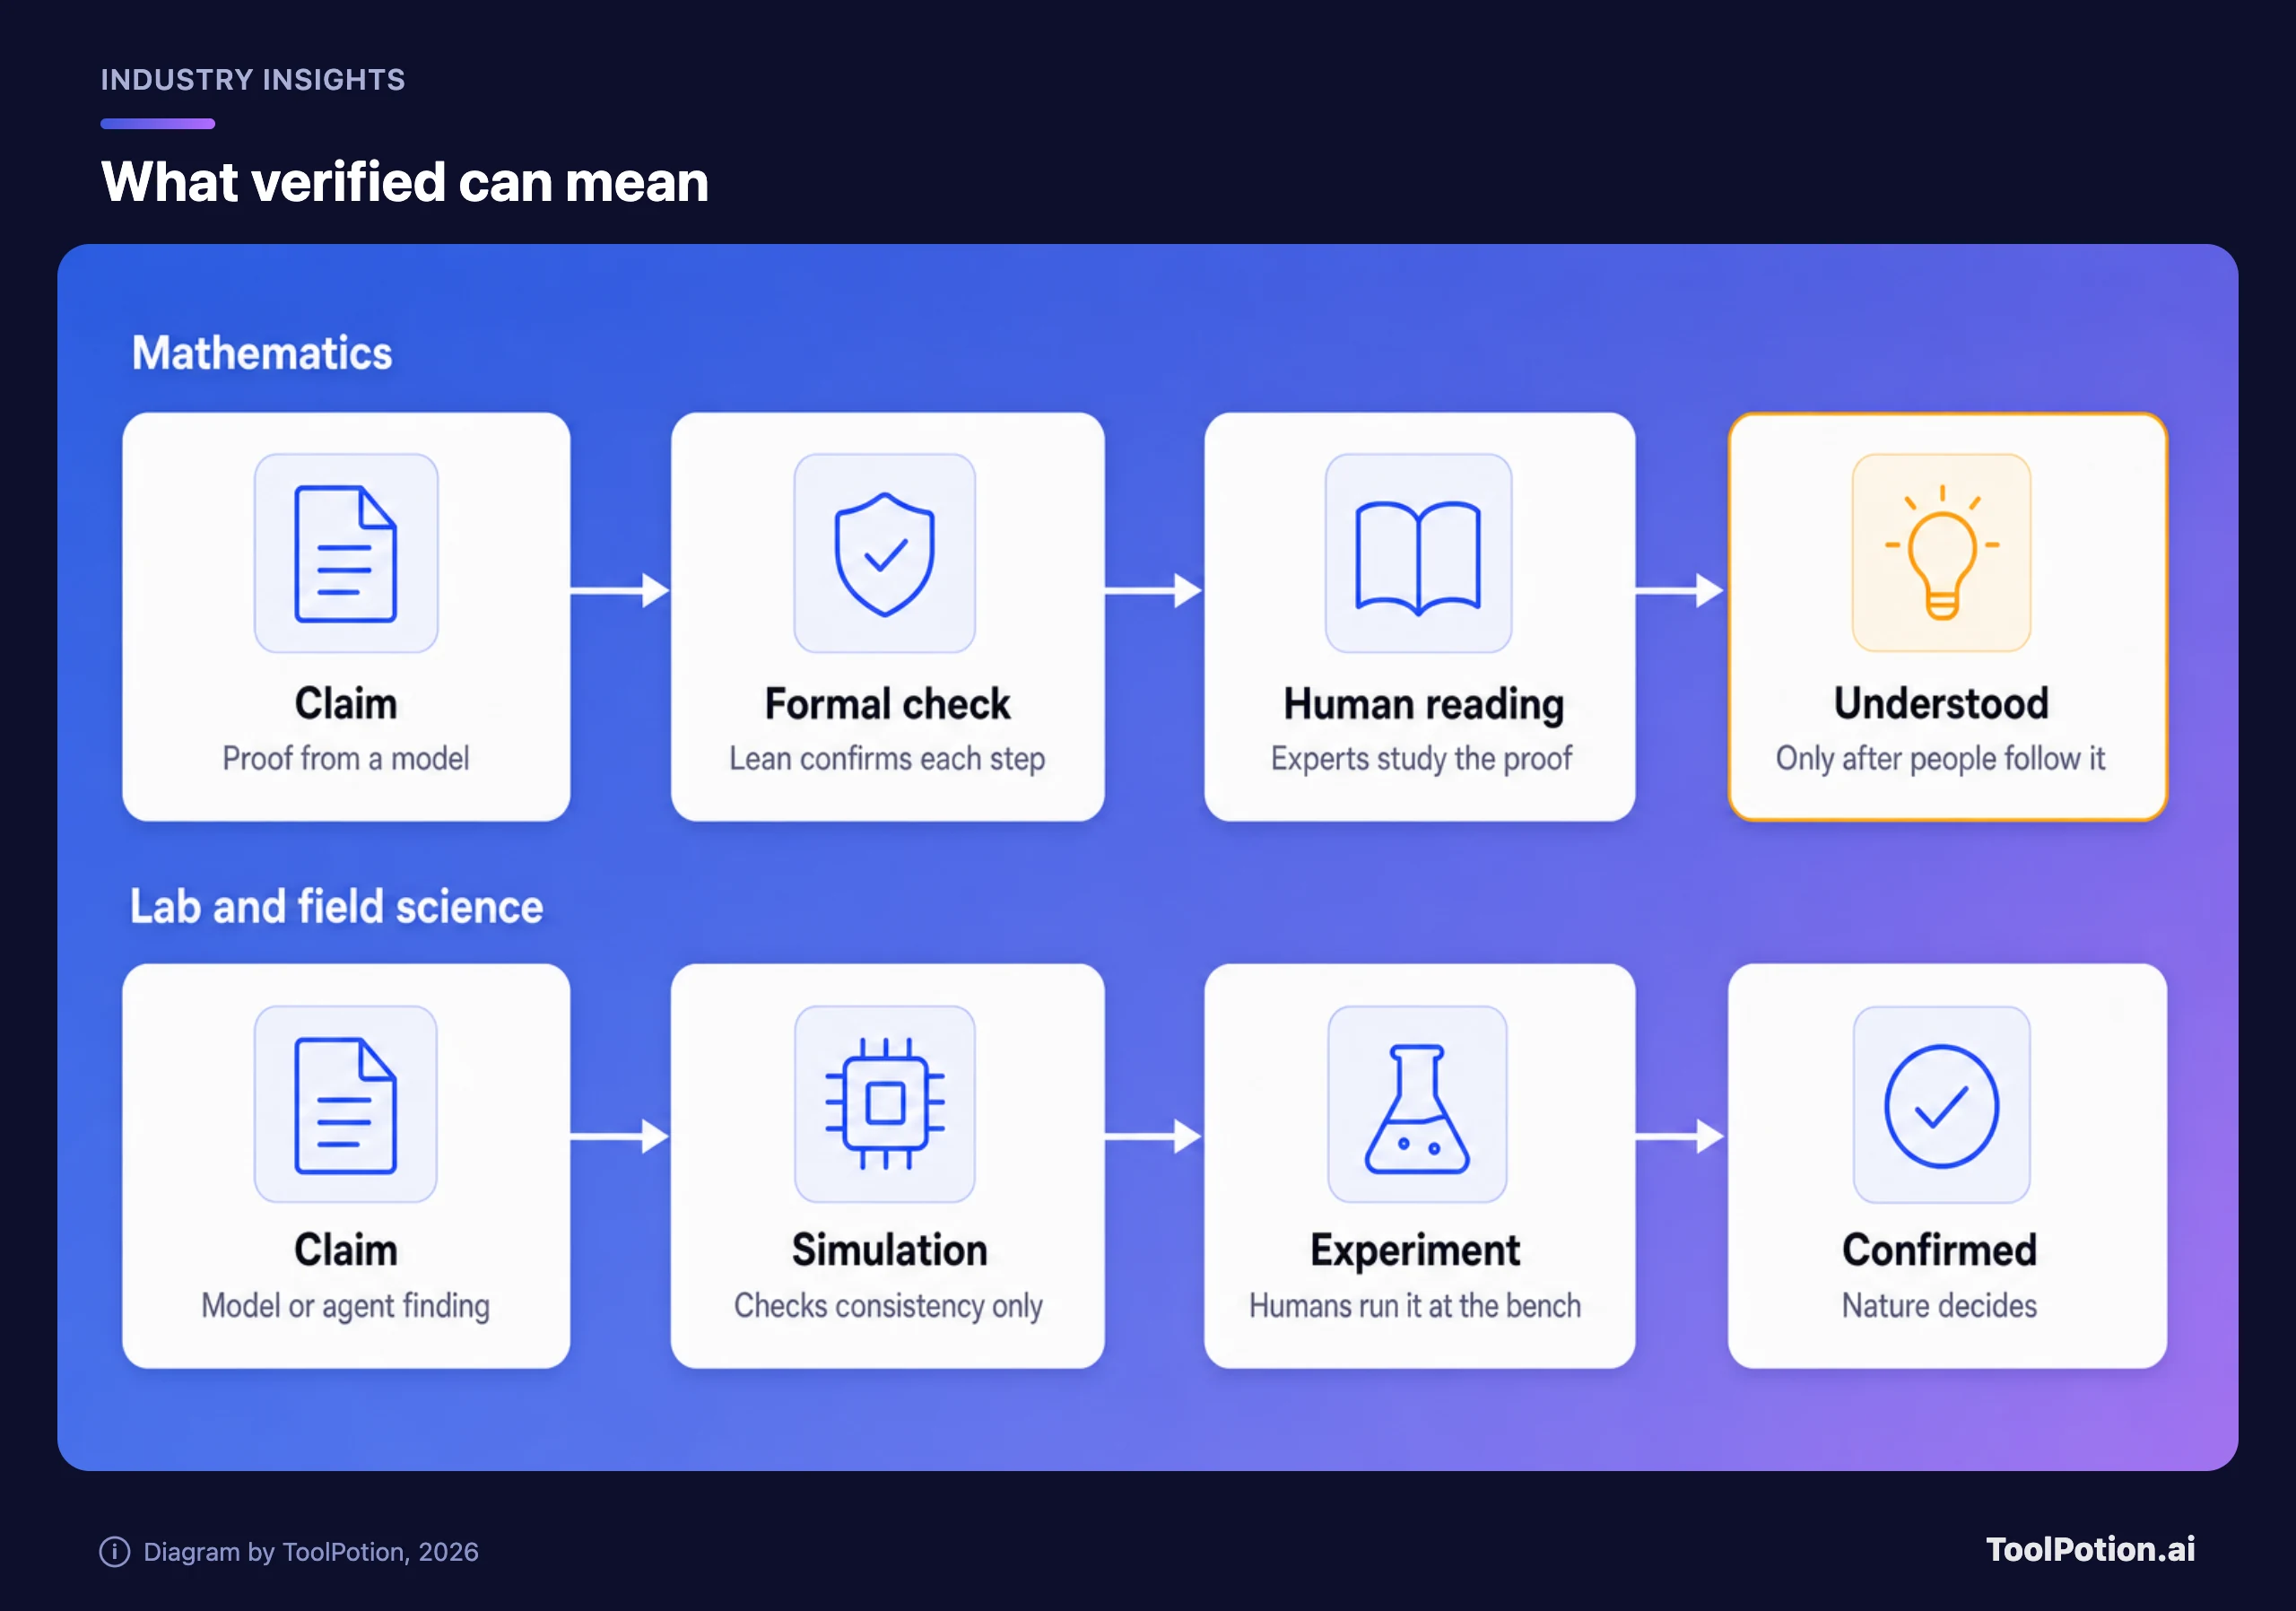
Urteil: teilweise. In der Mathematik ist ein formaler Checker ein starker Test. Anderswo kann „verifiziert“ alles Mögliche bedeuten, von einer Simulation bis zu einer Registerabfrage.
In der Mathematik kann Lean maschinell bestätigen, dass ein Beweis aus der gegebenen Aussage folgt. Das ist eine starke Prüfung, und deshalb werden die Ergebnisse von PSI und OpenAI überhaupt ernst genommen. Aber die Berichterstattung von Scientific American zeigt die Grenzen. OpenAIs Behauptung betrifft die Existenzhälfte des Yang-Mills-Problems; die separate Massenlücken-Hälfte ist ungelöst. Das Komitee nutzte OpenAIs eigenes Modell Astra, um den Lean-Code zu erschließen, und sagt offen, dass es den Beweis noch nicht zu verstehen beansprucht.
Dann ist da die Frage der Offenheit. Scientific American vermerkt, der Ansatz mit den „Hirten“ widerspreche Transparenzempfehlungen einer OpenAI-nahen Beratergruppe und habe einige Mathematiker verärgert, die darin Gatekeeping sehen. Der Lean-Beweis ist inzwischen öffentlich. Scott Armstrong von der NYU sagte, er sei froh, dass er endlich draußen sei, und ergänzte: „Diese Prüfung lässt sich offen effizienter und schneller durchführen“ (Scientific American). Wir stimmen ihm zu. Ein Beweis, den nur OpenAIs eigenes Komitee gesehen hatte, war eine Behauptung, die auf Prüfung wartete, und die Prüfung kann nun endlich beginnen.
Außerhalb der Mathematik gibt es kein Lean. PSI-CEO Matt Pines sagte TechCrunch, Physik unterscheide sich von Mathe, weil „die Natur bei euren Modellen der Wirklichkeit ein Wörtchen mitzureden hat“, und dass maschinengetriebene theoretische Physik „noch nicht so weit ist, aber auf dem Weg dorthin“. Schwartz stellte fest: „Den automatisierten Prüfungen kann man noch nicht trauen.“ Und der Maya-Beitrag, auf den wir noch zurückkommen, bekam eine offizielle Antwort: Das mexikanische Institut fand an der gemeldeten Stelle keine registrierte Stätte. Das bestätigt eine Lücke im Register. Es bestätigt keine Stätte.
Behauptung 3: Agenten können ein Labor betreiben
Urteil: noch nicht. Sie können planen, entwerfen und auswerten. Pipettiert und gelötet wird weiterhin von Menschen.
Anthropics Elektronik-Beitrag ist das stärkste jüngere Beispiel und lohnt die vollständige Lektüre. In Zusammenarbeit mit dem Platinenhersteller Diode (Anthropic sagt, es unterhalte eine Geschäftsbeziehung zu dem Unternehmen) entwarf Claude (das Modell Fable 5.2) eine USB-C-Freisprecheinrichtung, einen Sprachassistenten-Hub und ein tragbares virtuelles Haustier, vom Schaltplan über das Layout bis zur Firmware (Anthropic). Die Ingenieure von Diode fertigten die Platinen nach Claudes Designdateien und bauten und testeten die Prototypen von Hand, weil Claude weder an Messgeräte noch an die Maschinen zur Platinenfertigung angeschlossen war. Die Geräte haben weder eine elektrische Validierung noch Antennenabstimmung, Temperaturtests oder Zertifizierung durchlaufen. Der Beitrag nennt außerdem Benchmark-Gewinne (69 % im internen PCB-Gym-Layouttest von Diode, gegenüber 25 % beim Vorgängermodell). Das sind Anthropics Zahlen aus einem Test, der in dessen Auftrag lief, und die Kosten erscheinen nur auf einer Diagrammachse, nicht im Text.
Auf der Biologieseite hat OpenAI BioBasicsBench veröffentlicht, einen Benchmark mit 100 Aufgaben, der nach eigenen Angaben misst, wie gut KI-Agenten rohe Versuchsdaten interpretieren und alltägliche Wet-Lab-Forschung bewältigen (OpenAI). Es ist ein vom Anbieter gebauter Test, und ein Benchmark bleibt eine Behauptung, bis Leute außerhalb des Anbieters ihn ausführen.
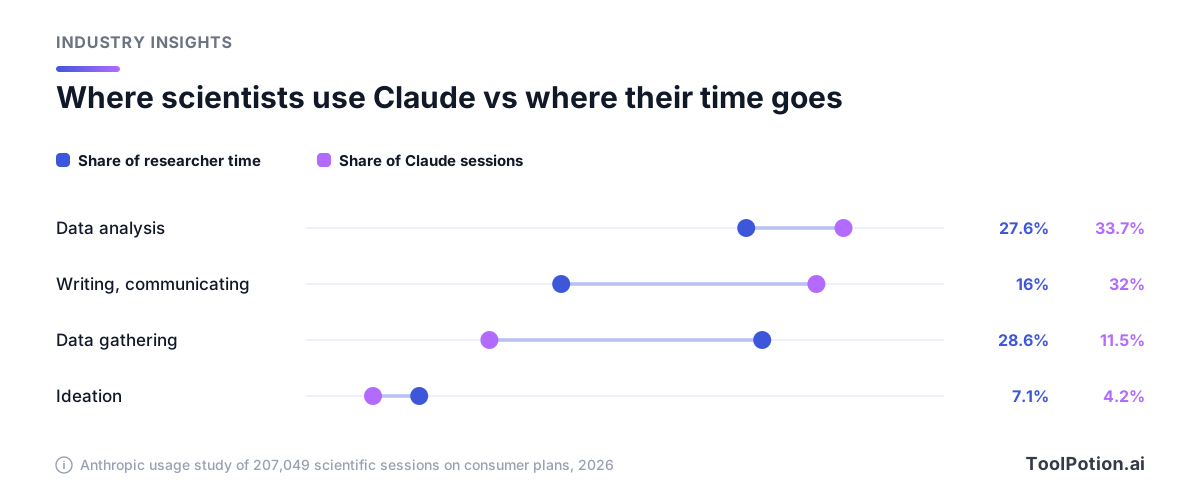
Anthropics Nutzungsstudie mit 207.049 wissenschaftlichen Sitzungen in Consumer-Tarifen zeigt dasselbe Muster in der Praxis. Datenerhebung macht 28,6 % der Zeit von Forschenden aus, aber nur 11,5 % der Sitzungen mit Claude, und die Lücke ist dort am größten, wo es physische Hürden gibt, etwa beim Erheben klinischer oder biochemischer Daten (Anthropic). In den Worten der Studie: „Physische Engpässe bleiben mächtig.“
Behauptung 4: Das kann jetzt jeder
Urteil: Jeder kann anfangen. Ein Ergebnis, das Bestand hat, erfordert jemanden, der das Fachgebiet kennt.
Die Maya-Geschichte ist der klarste Test. Pietro Miotti, der nach eigener Aussage kein Archäologe ist, setzte 48 Agenten auf rund 1.200 Quadratkilometer öffentlicher NASA-Lidardaten an und bekam eine Stätte auf einem Hügel mit Plaza und Pyramide, dann eine offizielle Antwort, in unter 72 Stunden (sein Beitrag). Seine Methodenzeile ist erfrischend schlicht: „Es kam kein besonderes Modell und kein Klassifikator zum Einsatz: Die Agenten haben sich die Bilder buchstäblich angesehen.“
Dann die Korrektur, die jetzt ganz oben auf der Seite steht. „Die Agenten haben es bei der Literatursuche übersehen, also haben sie es wiederentdeckt statt entdeckt.“ Die Stätte war bereits in einer Studie von 2025 von Estrada-Belli und Kollegen kartiert; sie fehlte nur noch im mexikanischen Register. Dass Miotti das an den Anfang gestellt hat, verdient Anerkennung. Er sagt außerdem, er spreche kein Spanisch und habe der Übersetzung seines Berichts durch die Agenten vertraut, die Geschichte zur klassischen Periode sei „Spekulation aus einem langen Chat mit den Agenten“, und das Rekonstruktionsbild sei KI-generiert. Eine Begehung vor Ort wird nicht beschrieben.
Unsere Lesart: Es ist eine gute Demonstration für günstiges Screening und eine schlechte für Entdeckung. Hinschauen ist inzwischen fast kostenlos. Zu wissen, ob schon jemand vorher hingeschaut hat, erfordert weiterhin einen Spezialisten oder zumindest eine Literaturrecherche, die die Agenten nicht ordentlich gemacht haben. PSIs Weg war anders und lehrreich: Das Team hielt das Ergebnis zurück, bis Anthropics Modell fast veröffentlichungsreif war, und nutzte die Zeit, um es Forschern zu zeigen, die es erklären konnten. Jim Halverson, Professor an der Northeastern und Berater von PSI, sagte TechCrunch: „Best Practices bilden sich noch heraus.“
Behauptung 5: Wissenschaftler werden bald automatisiert
Urteil: unbewiesen, und die lautesten Behauptungen kommen von Leuten mit eigenem Interesse daran.
Turturean sagte TechCrunch: „Ich akzeptiere völlig die Idee, dass dies das letzte Paper sein könnte, das ich veröffentliche.“ Pines sagte, vor sechs bis neun Monaten habe er im Gespräch mit Investoren „etwas übertreiben müssen“, wenn er sagte, theoretische Physik werde bald überwiegend Sache der Maschinen sein, und dass es „noch nicht so weit“ sei. Anthropics Umfrage zufolge erwarten etwa 40 % von 528 Forschenden, dass KI bis 2030 ganze Forschungsprojekte selbstständig durchführt. Sie wurden allerdings unter Bewerbern für Anthropics eigene AI-for-Science-Förderprogramme rekrutiert und nutzen KI deshalb vermutlich intensiver als die meisten (Anthropic).
Die modellierten Zahlen fallen kleiner aus. Anthropics Modellrechnung besagt, dass die heutigen Fähigkeiten bei breiter Einführung 27 bis 52 % der Forschungszeit übernehmen könnten, die für eine neue Studie nötig ist. Das entspricht einem Output-Anstieg um das 1,35-Fache in den Geisteswissenschaften bis zum 2,02-Fachen in der Statistik. Das hypothetische Szenario des Berichts, in dem KI alle nicht-physische Arbeit automatisiert, erreicht in Statistik und Informatik etwa das 15-Fache, in Laborwissenschaften wie Biologie und Chemie aber nur das 3- bis 4-Fache, weil die physischen Schritte der Engpass bleiben. Das ist ein Szenario, keine Messung. Selbst der moderate Fall ist für ein Fach eine große Veränderung. Ersatz ist es nicht, und der Bericht merkt an, dass KI-Arbeit heute überwiegend unterstützend oder geteilt ist. Zur Frage, wer die Anerkennung bekommt, formuliert Schwartz es besser, als wir es könnten: Sie „wird sich nicht dadurch klären, dass man so tut, als sei der menschliche Beitrag das Tippen gewesen“.
Behauptung 6: Wenn das KI-Modell zu den Daten passt, verstehen wir das System
Urteil: falsch, und die Autoren, die diese Systeme bauen, sagen das selbst.
Ein Gastbeitrag einer Tübinger Gruppe (Jakob Macke, Daniel Gedon und Stefan Wahl, alle Förderempfänger von Anthropic AI for Science) darüber, KI das Bauen wissenschaftlicher Modelle beizubringen, argumentiert sorgfältig. Viele Modelle passen zu denselben Daten, daher besteht der nützliche Output aus einer Bandbreite plausibler Modelle und einer Liste dessen, worin sie übereinstimmen (Anthropic). Sie räumen ein, dass diese Systeme „bislang meist daran getestet wurden, Modelle wiederzuentdecken, die Wissenschaftler schon kennen“, mit wenig Evidenz für Probleme ohne bekannte Lösung. Und sie schreiben: „Ein KI-System, das Ihnen lediglich das Modell reicht, gibt Ihnen vielleicht eine Antwort, aber kein Verständnis.“
Wir finden, dieser letzte Satz gehört über jede Laborbank und über jeden Schreibtisch von Studierenden. Ein Fit ist eine Zahl. Eine Erklärung ist etwas, womit ein Mensch vorhersagen kann, was als Nächstes passiert.
Eine Routine für Forschende und Studierende
Nichts davon heißt: Nutzen Sie diese Tools nicht. Anthropics Nutzungsdaten deuten darauf hin, dass Wissenschaftler sie bereits dort einsetzen, wo sie am besten funktionieren, vor allem bei Analyse und Schreiben. Hier ist die Routine, der wir folgen würden, abgeleitet aus dem, was in den obigen Fällen schiefging.
- Geben Sie Agenten Aufgaben, deren Ergebnis Sie selbst prüfen können: Datenanalyse, Code zwischen Sprachen portieren, Paper oder Bilder sichten. Claude Code und Claude Cowork sind für solche Jobs gebaut, und unser Vergleich von Terminal-Coding-Agenten deckt das Feld ab.
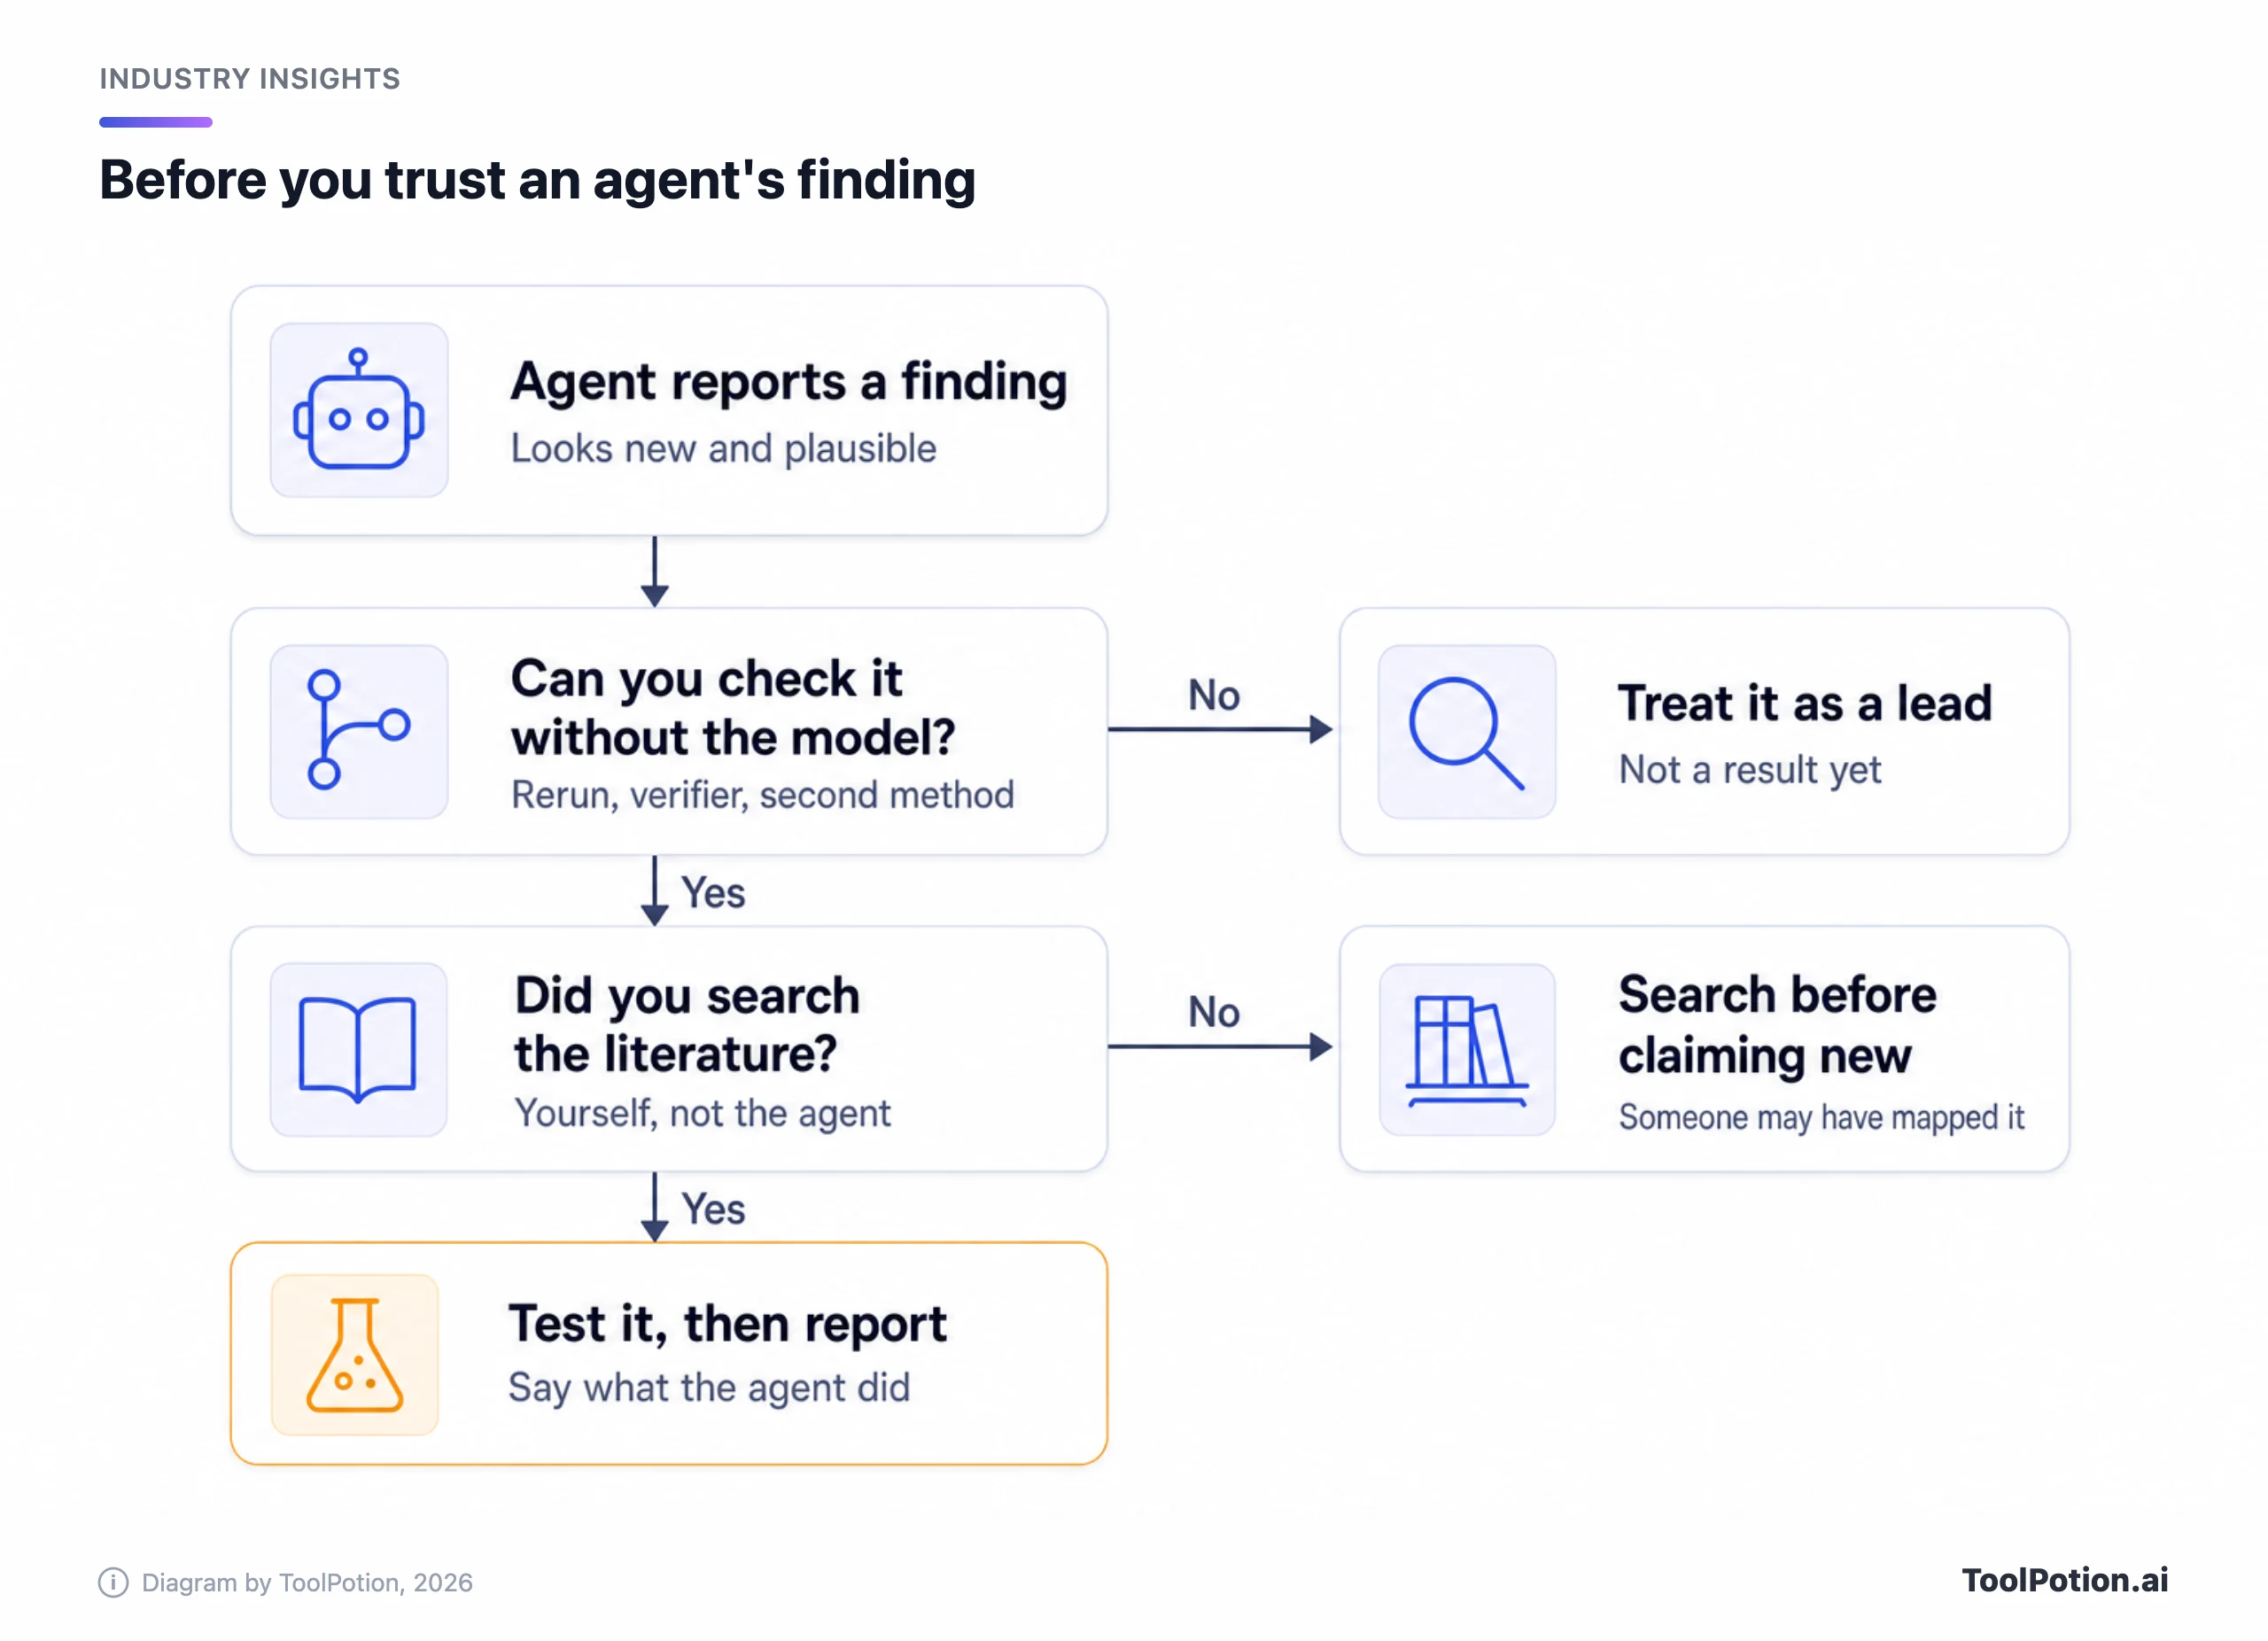
- Legen Sie vor dem Start fest, was als Prüfung gilt und wer sie durchführt. Nicht dasselbe Modell. Ein formaler Verifizierer, eine zweite Analyse, ein Laborexperiment oder ein Kollege.
- Wenn ein Agent sagt, etwas sei neu, recherchieren Sie die Literatur selbst. Ein spezielles Tool wie Elicit, Consensus, SciSpace oder ResearchRabbit braucht Minuten, und der Maya-Fall zeigt, was es kostet, darauf zu verzichten. Unser Ranking der KI-Recherche-Assistenten enthält die längere Liste.
- Lassen Sie den physischen Schritt in menschlicher Hand und protokollieren Sie ihn. Hängt ein Ergebnis von einer Messung, einer Probe oder einem Besuch vor Ort ab, wird es genau dort getestet.
- Schreiben Sie bei der Veröffentlichung, was der Agent getan hat und was Sie geprüft haben. Schwartz stellt unverblümt fest, dass der menschliche Beitrag nicht das Tippen war.
- Studierende: Bauen Sie Ihre ersten Modelle selbst. Die Tübinger Autoren schreiben: „Erst der Prozess des Konstruierens liefert die Einsicht.“ Nutzen Sie einen Agenten, um Ihr Modell zu kritisieren, nicht um sich eines liefern zu lassen.
Wenn Sie das ältere, besser erprobte Beispiel für KI in der Biologie suchen: Das ist weiterhin AlphaFold, das Strukturen vorhersagt, die Labore dann testen. Für Literaturarbeit und agentenartige Recherche gibt es außerdem Edison Scientific, Scientific Agent Skills zum Ausstatten eigener Agenten und das Ranking Top 250 KI-Tools für Forschende. Bei den Allzweck-Assistenten stellt ChatGPT vs Claude vs Gemini ChatGPT seinen beiden Hauptrivalen gegenüber, während die Ranglisten KI-Recherche-Assistenten und KI-Agenten die Spezialtools einordnen.
Wo wir landen und was uns umstimmen würde
Real: Agenten sind inzwischen nützliche, unermüdliche Analysten und Ingenieure. Die Elektronik-Prototypen funktionieren, der Enzym-Hinweis ist interessant, und ein von einem Modell stammender, in Lean geprüfter Beweis ist ein echtes Ergebnis, wer ihn auch immer zuerst versteht. Schwartz' 15 neue Integrale sind echte Ergebnisse in einem engen Feld.
Hype: Autonomie, locker verwendetes „verifiziert“ und eine kommende Welle automatisierter Wissenschaftler. Fast jedes beeindruckende Ergebnis oben hat einen Menschen in der Schleife, der den Teil erledigt, der darüber entscheidet, ob es stimmt, und die Menschen sagen das auch. Wir wünschen uns außerdem, dass die Labore die Dollarkosten neben den Benchmark-Wert drucken. Credits und Token-Zahlen verschleiern, was eine Entdeckung kostet, und 210 Millionen Tokens für eine Enzymsuche sind eine Zahl, die ein Laborbudget interessiert.
Zwei Dinge würden uns umstimmen. Das eine: Mathematiker außerhalb von OpenAIs Komitee lesen den Yang-Mills-Lean-Code und berichten, dass sie ihn verstehen. Das andere: eine begutachtete Fassung der Enzymarbeit, die sagt, was das System tut. Bis dahin behandeln wir beides als vielversprechend und unfertig.