

Anthropic-Entwickler ließen einmal einen Lead-Agenten kurze Anweisungen wie „Recherchiere den Halbleitermangel" verteilen. Die Subagenten verstanden das falsch: Einer untersuchte die Chipkrise der Autoindustrie von 2021, zwei andere erledigten doppelte Arbeit zu den Lieferketten von 2025 (Anthropic Engineering). Nichts stürzte ab. Jeder Agent machte etwas Sinnvolles aus einer Anfrage, die so vage war, dass man sie auf mehrere Arten lesen konnte.
Die meisten von uns wiederholen diesen Fehler, sobald wir Arbeit an ChatGPT, Claude, Gemini CLI oder einen der Coding-Agenten fürs Terminal übergeben. Wir tippen eine Aufgabe und nennen das Briefing. Im Folgenden: sechs Teile, die ein Briefing braucht, drei Umschreibungen zum Übernehmen, eine Vorlage und eine Tabelle mit den typischen Fehlern. Unsere Positionen, die wir unterwegs begründen: Schreiben Sie zuerst die Done-when-Zeile, ersetzen Sie „Frag mich, wenn du unsicher bist" durch eine benannte Liste von Aktionen, und streichen Sie die Wände aus Großbuchstaben. Die Herstellerdokumentation, die wir zitieren, stützt einen Teil davon und lässt den Rest offen. Wir sagen jeweils, was was ist.
Eine Aufgabe ist kein Briefing
Eine Aufgabe nennt eine Tätigkeit. Ein Briefing gibt der ausführenden Person alles, was sie sonst raten müsste. Anthropics Prompting-Leitfaden beschreibt das als neuen Mitarbeiter: „Think of Claude as a brilliant but new employee who lacks context on your norms and workflows." (Anthropic docs) OpenAI zieht eine ähnliche Linie zwischen Modelltypen. Ein Reasoning-Modell sei „like a senior co-worker", das ein Ziel nehmen und die Details selbst klären kann, ein GPT-Modell dagegen „like a junior coworker", das am besten „with explicit instructions to create a specific output" arbeitet (OpenAI docs).
OpenAI sagt, Reasoning-Modelle kämen mit übergeordneten Hinweisen gut zurecht. Darauf würden wir uns nicht mehr verlassen, sobald ein Job Dutzende Schritte mit Nebenwirkungen umfasst. Der Senior-Kollege weiß trotzdem nicht, was für Sie „fertig" heißt, und beim Junior kostet ein falscher Tipp eine E-Mail. Ein Agent dagegen handelt bei jedem folgenden Schritt auf Basis seiner ersten Fehlinterpretation, wie der Lead-Agent von Anthropic gezeigt hat.
Anthropic bietet einen Test, den wir mögen, weil er zwei Minuten dauert: „Show your prompt to a colleague with minimal context on the task and ask them to follow it. If they’d be confused, Claude will be too." (Anthropic docs) Wenn ein Auftragnehmer mit Ihrer Nachricht nicht starten könnte, ohne fünf Rückfragen zu schicken, beantwortet der Agent diese fünf Fragen selbst, stillschweigend, und Sie erfahren es am Ergebnis.
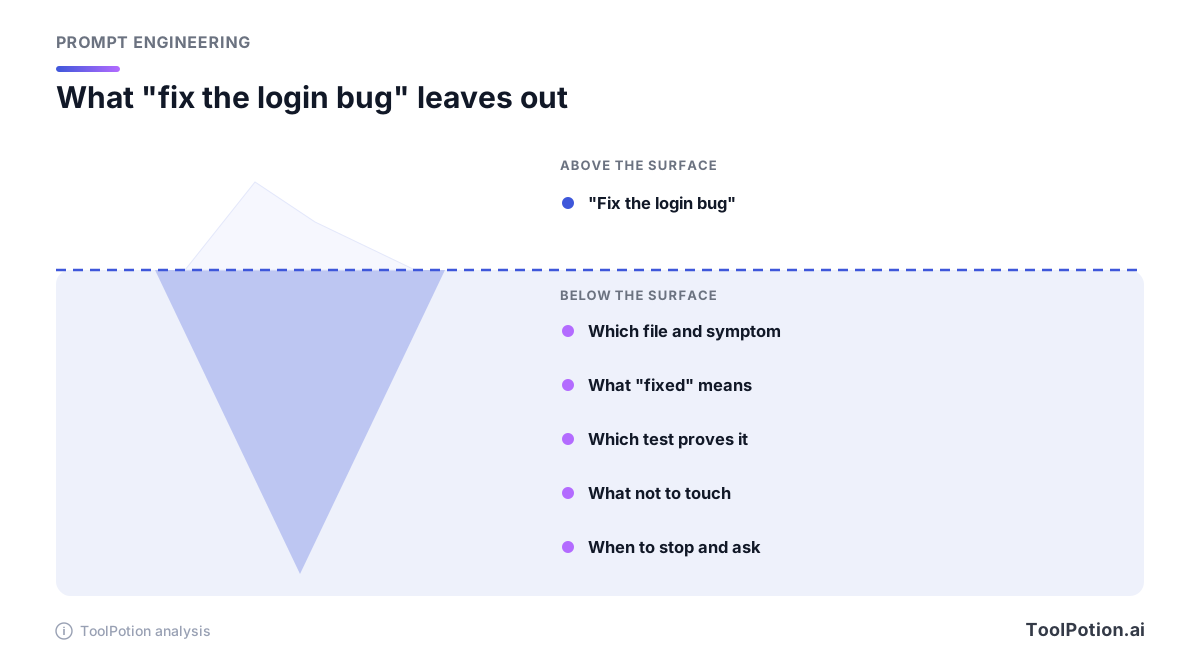
Schreiben Sie zuerst die Done-when-Zeile
Die Best-Practices-Seite von Claude Code sagt es unverblümt: „Claude stops when the work looks done." Ohne etwas Ausführbares, das sagt, ob die Arbeit erledigt ist, so die Seite weiter, „In practice that makes you the test suite, and every mistake sits there until you happen to notice it." (Claude Code docs)
Die Codex-Hinweise von OpenAI kommen von der anderen Seite zum gleichen Gedanken. Sie empfehlen vier Dinge im Prompt: ein Ziel, Kontext, Constraints und „Done when", formuliert als Frage danach, was gelten soll, bevor die Aufgabe abgeschlossen ist, „such as tests passing, behavior changing, or a bug no longer reproducing" (OpenAI Codex docs). Zwei Hersteller, zwei Produkte, ein Grundgerüst. Wir ergänzen zwei eigene Teile (Stopp-und-frag und Bericht) und würden die Done-when-Zeile zuerst schreiben, obwohl sie im fertigen Briefing an vierter Stelle steht, denn das Schreiben zwingt Sie herauszufinden, was Sie eigentlich wollen.
Außerhalb von Code funktioniert dieselbe Zeile mit einer anderen Prüfung. „Eine Tabelle mit zwölf Anbietern, ein Quellenlink neben jedem Preis und eine Markierung bei jedem Preis, der nicht öffentlich ist" kann ein Agent nachzählen. „Ein gründlicher Vergleich" kann er nur fühlen.
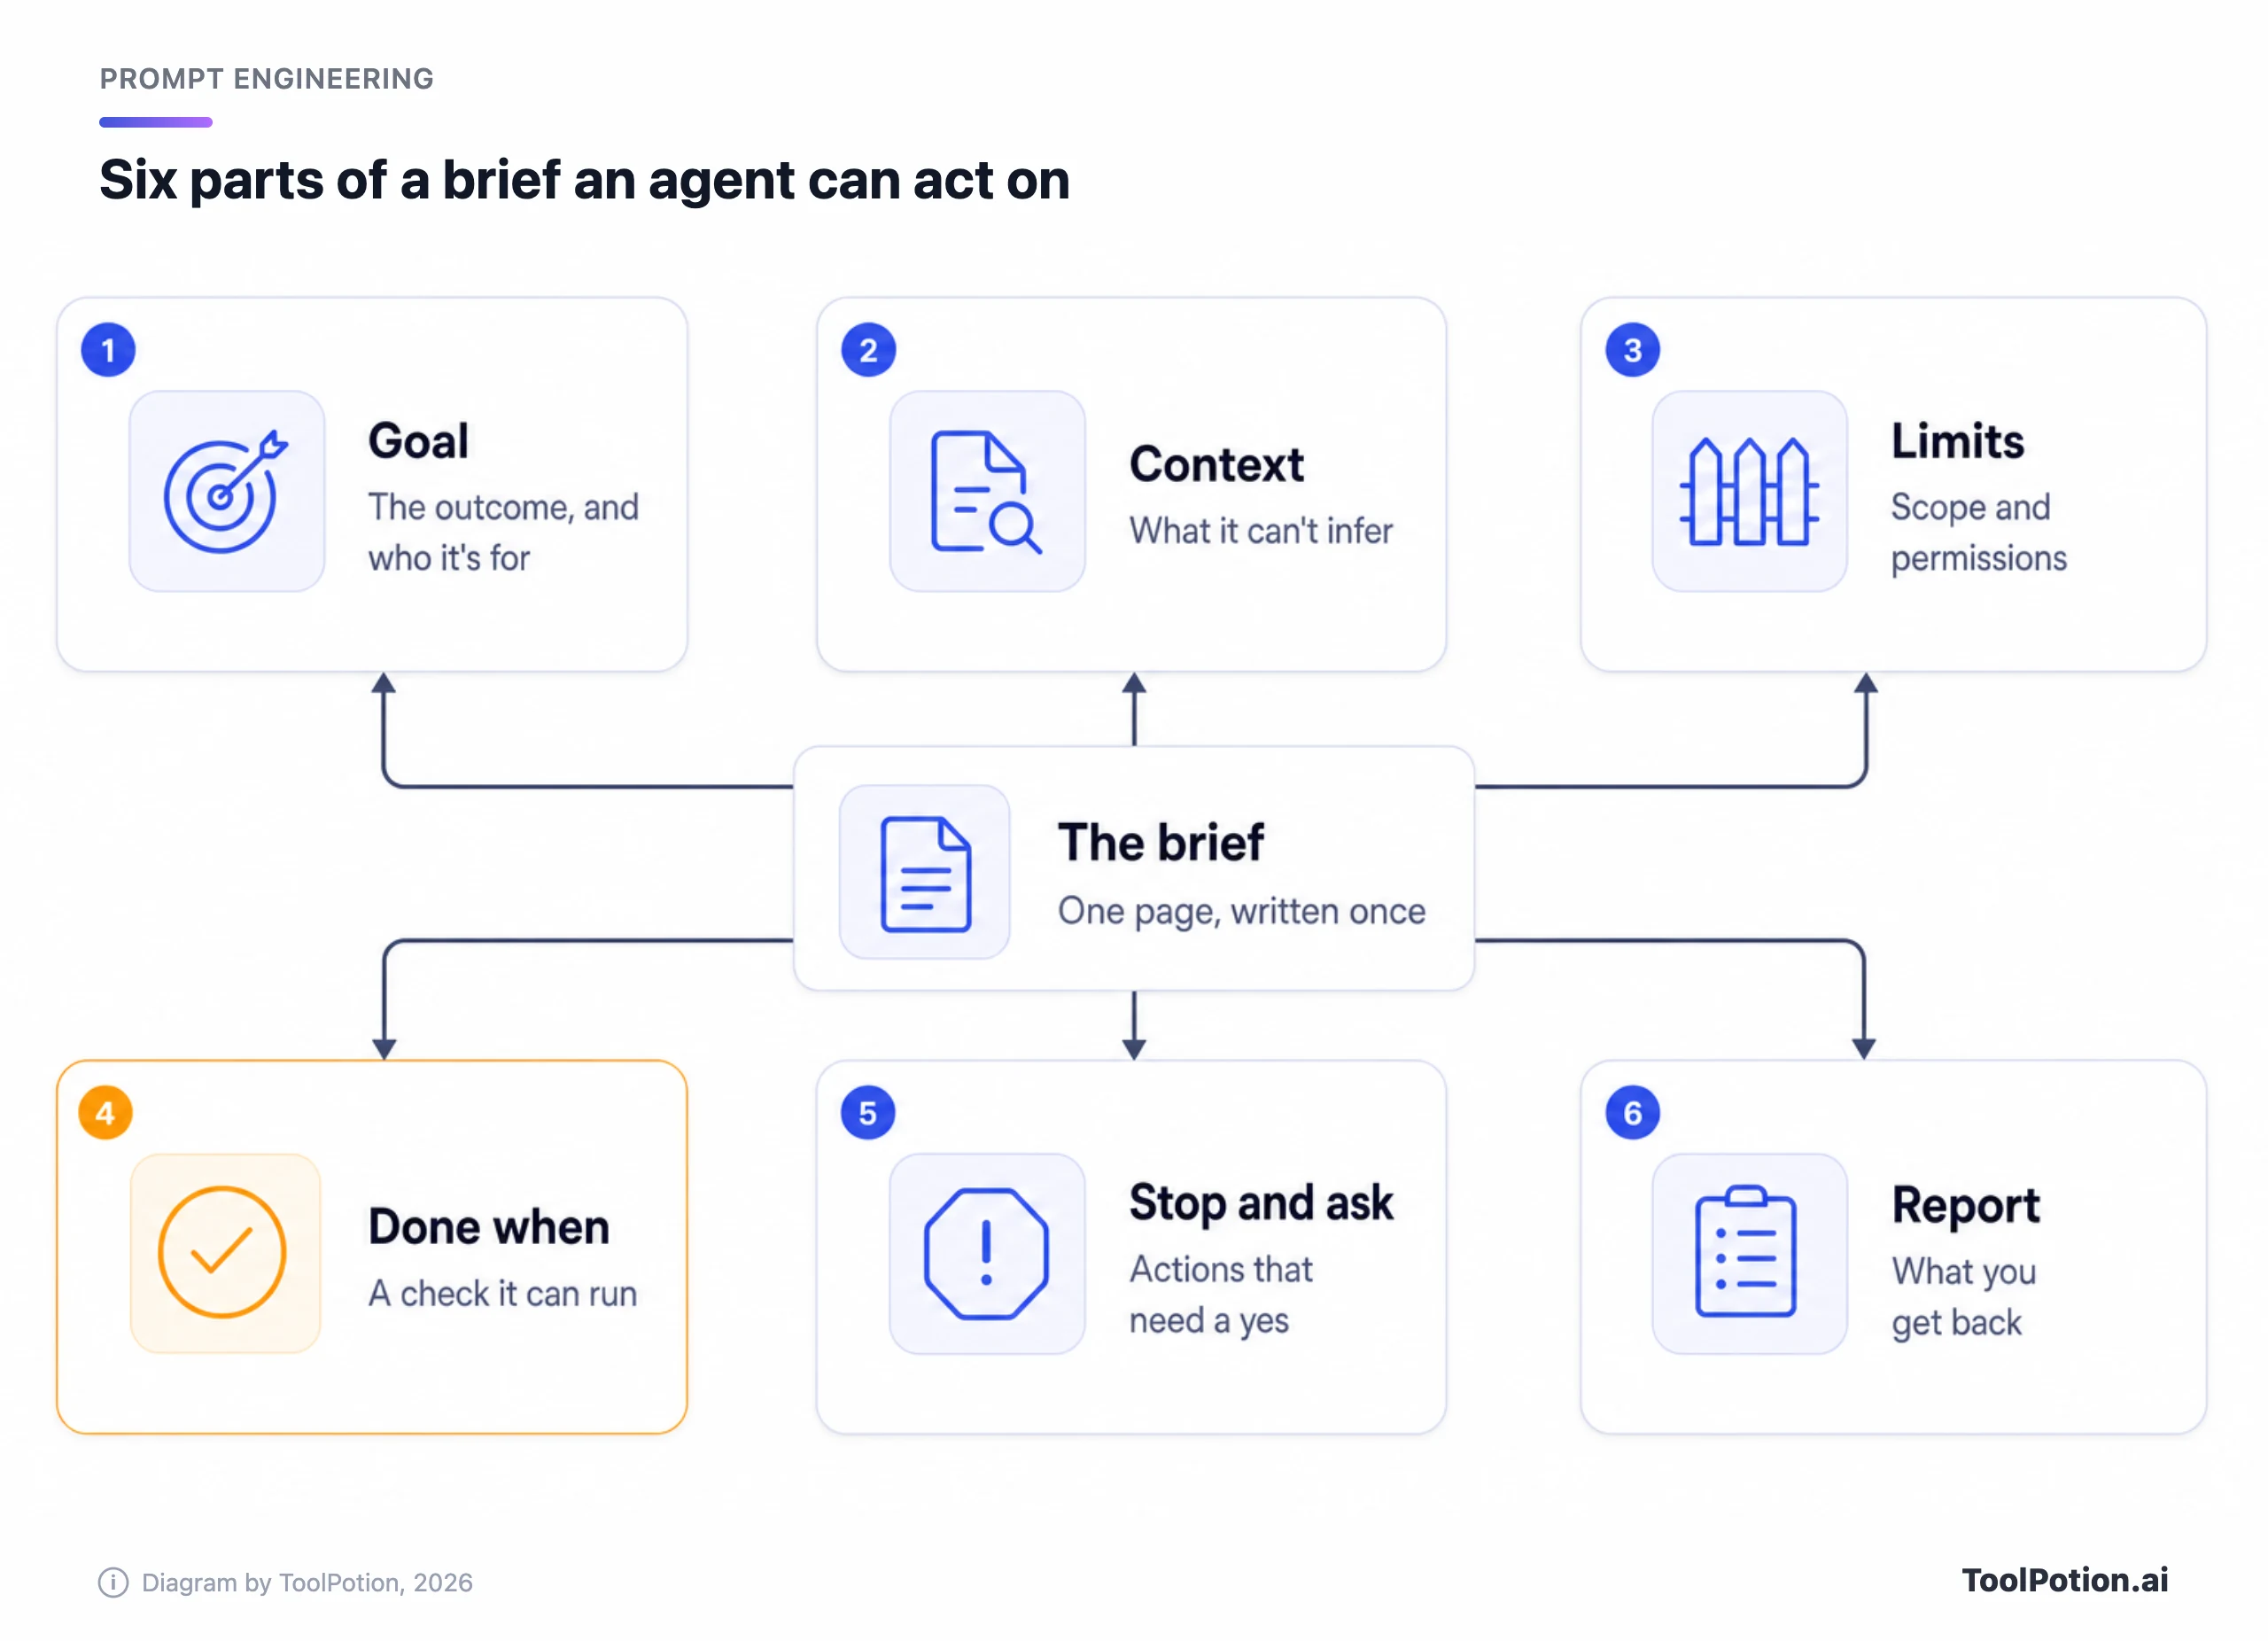
Die sechs Teile eines Briefings, von oben nach unten
Das Ziel nennt das Ergebnis und wer es nutzt
Ein bis zwei Sätze. Sagen Sie, was am Ende vorliegen soll und was damit gespeist wird: eine Empfehlung, die zwei Partner in fünf Minuten lesen, ein Fix, der am Freitag live geht, eine Shortlist für einen Kauf. Das Ziel bestimmt, was der Agent aufnimmt und was er weglässt. „Schau dir die Preise an" erzeugt Masse. „Empfiehl ein Tool unter 15 $ pro Seat" erzeugt eine Entscheidung.
Kontext ist alles, was er nicht selbst finden kann
Die Docs von Claude Code liefern einen nützlichen Filter: „Could it find this by reading the code? Would it actually go and look? If both are yes, leave it out." (Claude Code docs) Drin bleiben die Entscheidung aus dem Meeting, die nie im Repo gelandet ist, der Account, den der Agent verwenden soll, das Tool, das Sie schon probiert und verworfen haben, und das Niveau der Leser.
Nennen Sie auch den Grund hinter einer Regel. Anthropics Leitfaden sagt, dass Kontext oder Motivation hinter einer Anweisung „can give Claude more information about your goals and help it deliver more targeted responses", und sein eigenes Beispiel für die schwächere Variante ist ein nacktes „NEVER use ellipses" (Anthropic docs).
Grenzen sagen, was im Rahmen liegt und was tabu ist
Agenten neigen dazu, mehr zu tun, als Sie verlangt haben. Anthropics Leitfaden sagt, Claude Opus 4.5 und 4.6 neigten zu „creating extra files, adding unnecessary abstractions, or building in flexibility that wasn’t requested", und bietet eine Beispielanweisung an, die „Don't add features, refactor code, or make \"improvements\" beyond what was asked." enthält. (Anthropic docs) Der Leitfaden knüpft diese Angewohnheit an genau diese beiden Modelle, prüfen Sie es also gegen das Modell, das Sie nutzen. Den Satz würden wir in jedem Fall übernehmen. Ergänzen Sie dann Ihre eigene Liste: Ordner, die er anfassen darf, Quellen, die er nutzen darf, Accounts, in die er sich nicht einloggen darf.
Googles Gemini-Leitfaden führt Risikobewertung unter den Einstellungen auf, die ein Agent-Prompt steuert, und sagt, man könne explizit zwischen risikoarmen explorativen Aktionen (Lesen) und riskanten Zustandsänderungen (Schreiben) unterscheiden (Google AI docs). Diese Trennung ist der nützliche Teil. Lesen und Tests ausführen brauchen keinen Passierschein; Löschen, Senden und Bezahlen schon.
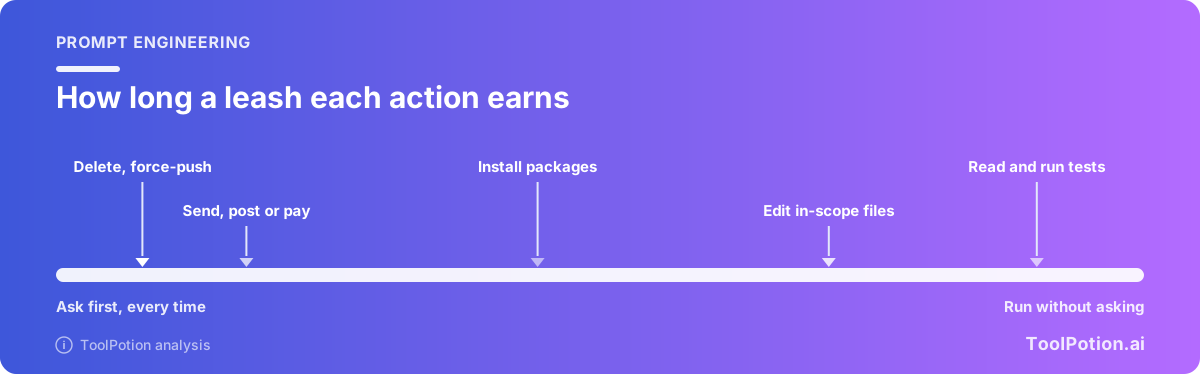
Ein Vorbehalt, bevor Sie sich auf irgendetwas davon stützen. Worte in einem Briefing sind Bitten. Eine Sandbox, ein schreibgeschütztes Token oder eine Berechtigungsregel ist Durchsetzung, und das eine ersetzt das andere nicht. Unser Leitfaden zum Eindämmen von KI-Agenten behandelt die Durchsetzungsseite; dieser Beitrag bleibt bei dem, was Sie schreiben.
Done when ist eine Prüfung, die er ausführen kann
Nennen Sie den Befehl, die Anzahl oder die Datei. „Tests laufen durch" ist ein Anfang. „pnpm test läuft durch, und ein neuer Test belegt, dass die 101. Anfrage innerhalb einer Minute ein 429 bekommt" ist eine Prüfung. Bei Recherche sagen Sie, wie viele Einträge, welche Felder und was zu schreiben ist, wenn ein Feld nicht auffindbar ist. Wenn die Prüfung fehlschlagen kann, sagen Sie dem Agenten, was dann zu tun ist, und deckeln Sie es. Googles Leitfaden hält fest: „High persistence increases success rates but risks higher token costs or loops." Deshalb ist „Wiederhole einen fehlschlagenden Test zweimal, dann stopp und berichte" besser als Schweigen (Google AI docs).
Stopp-und-frag ist eine Liste von Aktionen, keine Stimmung
„Frag mich, wenn du unsicher bist" überlässt dem Agenten ein Urteil, und ein eifriger Agent ist selten unsicher. Listen Sie stattdessen die Aktionen auf. Anthropics Leitfaden hat dafür einen Beispiel-Prompt, geschrieben für Claude Opus 4.6: Bei Aktionen, die „hard to reverse, affect shared systems, or could be destructive" sind, solle der Agent „ask the user before proceeding", mit dem Löschen von Dateien oder Branches, git push --force und dem Versenden von Nachrichten als Beispielen (Anthropic docs). Die Liste würden wir übernehmen, egal welches Modell Sie nutzen.
Anthropics Essay zum Agent-Design beschreibt das Muster: Agenten „can then pause for human feedback at checkpoints or when encountering blockers" (Anthropic Engineering). Machen Sie den ersten Checkpoint zu einem Plan. Lassen Sie sich die Schritte vor jeder Änderung zeigen, lesen Sie sie und sagen Sie dann „los". Das kostet einen Hin-und-Her-Durchlauf, und wir halten es für den günstigsten Checkpoint, den es gibt.
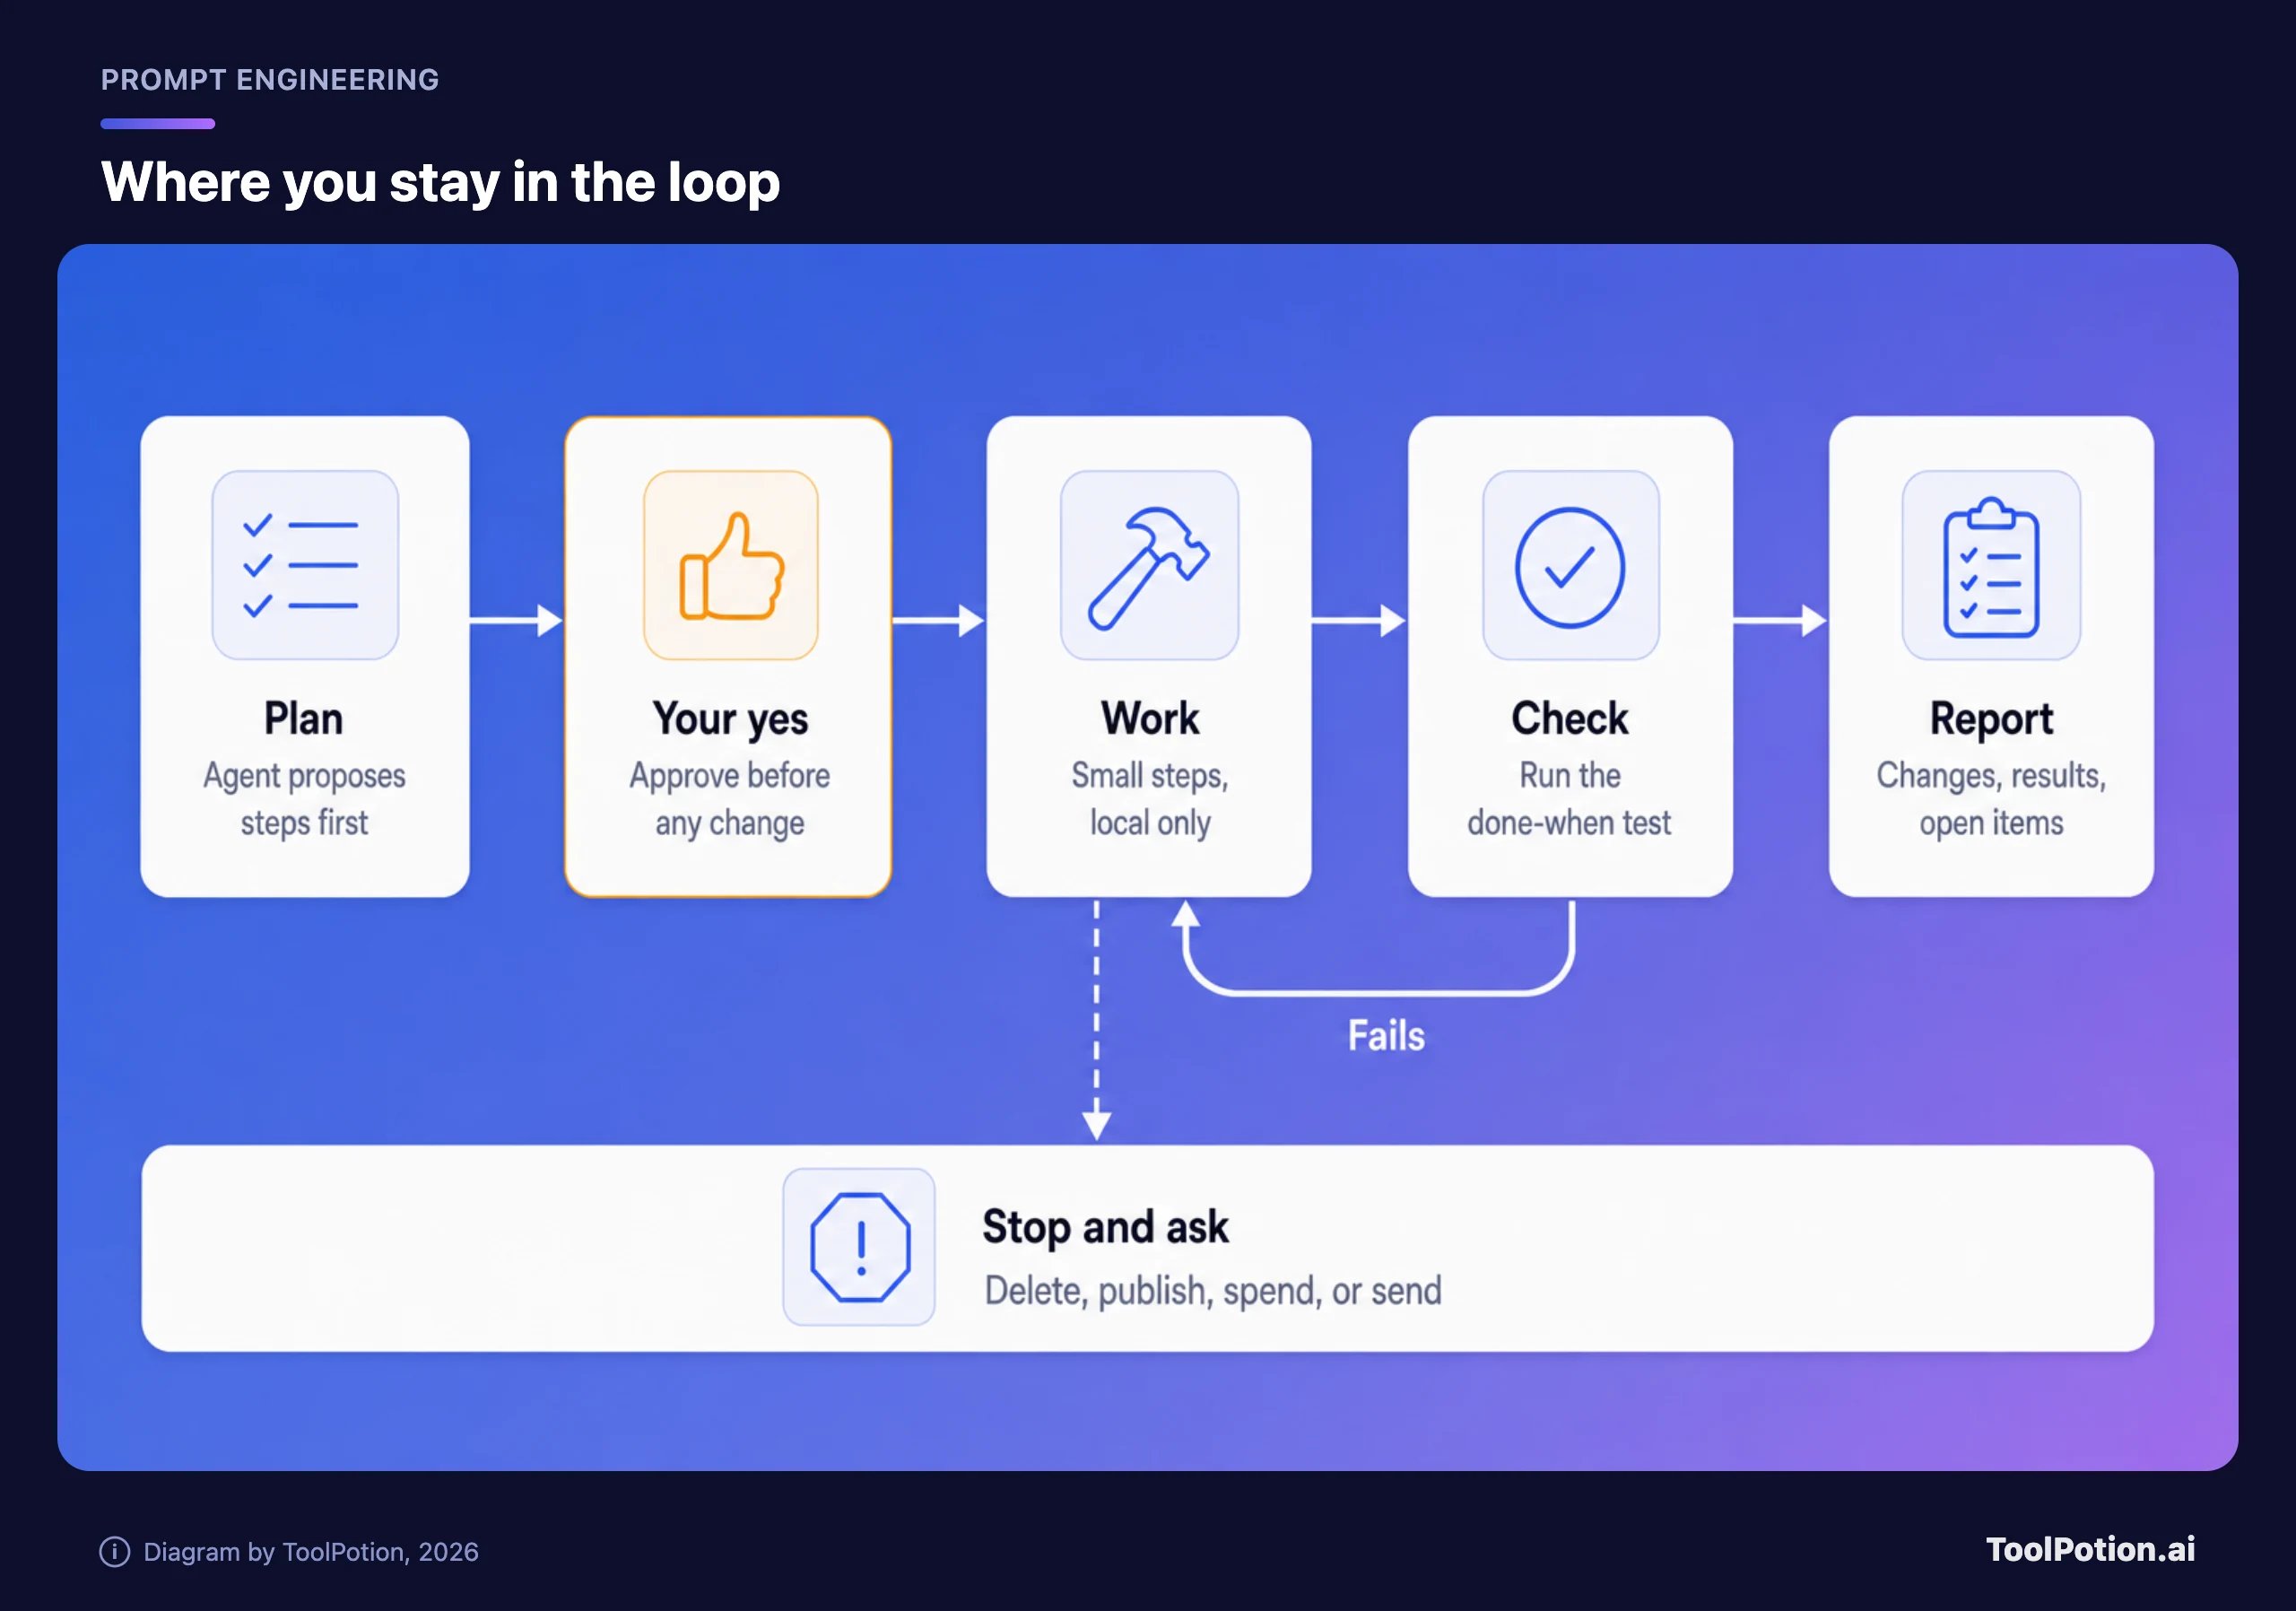
Der Bericht legt fest, was zurückkommt
Fordern Sie die vorgenommenen Änderungen, die durchgeführten Prüfungen samt Ergebnissen, alle Annahmen und alles, was der Agent bewusst nicht getan hat. Der letzte Punkt wird am häufigsten vergessen. Hier sagt Ihnen der Agent, dass er die Migration übersprungen hat, weil Sie ihm verboten haben, das Schema anzufassen.
Drei Briefings, vorher und nachher
Jede Umschreibung unten umfasst etwa 120 bis 150 Wörter. Das ist länger als der durchschnittliche Prompt und kürzer, als man fürchtet. Alle drei Briefings sind von uns erfundene Beispiele: Aufgaben, Tools und Zahlen sind zur Illustration ausgedacht, und keines stammt von einem Hersteller oder aus einem echten Projekt.
Ein Recherche-Agent (erfundenes Beispiel)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.Ein Coding-Agent (erfundenes Beispiel)
Die Docs von Claude Code enthalten ein eigenes Vorher-nachher: Aus „add a calendar widget" wird die Bitte, dem Muster einer bestehenden Widget-Datei zu folgen, mit „no new libraries" (Claude Code docs). Hier derselbe Schritt bei einem größeren Job, geschrieben für Claude Code oder Codex.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.Ein Posteingangs-Agent (erfundenes Beispiel)
Dieses Briefing gilt für jeden Assistenten, den Sie an Ihre Mails lassen, also für die Art Job, für die Agent-Produkte wie Manus und Claude Cowork verkauft werden. Bei Mails kann aus „aufräumen" leicht still und leise „gelöscht" werden.
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.Die Goal-Zeile ändert sich zwischen vorher und nachher kaum. Das Gewicht liegt in den letzten vier Zeilen: eine Prüfung, ein Stopp, ein Bericht und eine Grenze, die festlegt, was der Agent niemals tun darf.
Eine Vorlage zum Einfügen
Streichen Sie jede Zeile, die nicht passt, aber streichen Sie sie mit Absicht.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
Bewerten Sie damit Ihren eigenen Entwurf. Acht Ja-Nein-Fragen, dreißig Sekunden.
Woran Briefings scheitern und was wir ändern würden
| Fehler | Was Sie sehen | Änderung |
|---|---|---|
| Das Ziel ist eine Tätigkeit | Seitenweise Output, keine Entscheidung | Angeben, wofür der Output gebraucht wird |
| Kein Done-when | Er hört bei „sieht fertig aus" auf oder hört nie auf | Eine ausführbare Prüfung und ein Retry-Limit ergänzen |
| Scope bleibt unausgesprochen | Zusätzliche Dateien, Refactorings, ungefragte Verbesserungen | Auflisten, was tabu ist |
| Warnungen ohne Begründung | Eine Wand aus NEVER-Zeilen, ignoriert oder übertrieben angewendet | Den Grund in einem Nebensatz ergänzen |
| Freigabe nur angedeutet | Er löscht, pusht oder sendet nach eigenem Ermessen | Die Aktionen benennen und zuerst einen Plan verlangen |
| Korrekturen häufen sich | Anweisungen widersprechen sich | Briefing neu schreiben und frisch starten |
Zwei davon verdienen ein paar Worte mehr. Das erste ist der Berg aus Großbuchstaben. Wir bezweifeln, dass mehr Betonung je einen fehlenden Grund ersetzt hat, und Anthropics Leitfaden weist in dieselbe Richtung: Ein nacktes „NEVER use ellipses" ist sein schwächeres Beispiel. Die Docs von Claude Code ergänzen, dass „Phrases like think step by step or be thorough are ordinary prompt text rather than keywords" (Claude Code docs). Aus diesem Grund würden wir „Sei gründlich"-Floskeln streichen. Anthropics Leitfaden empfiehlt durchaus, Claude eine Rolle zu geben, auch nur in einem Satz, deshalb würden wir das nicht verbieten; wir würden aber auf die „Weltklasse-Experte"-Persona verzichten, weil die sechs Teile dem Agenten ohnehin mehr sagen als ein Titel.
Das zweite ist das umgekehrte Problem. Der Beispiel-Agent-Prompt im Leitfaden von OpenAI (gezeigt für das Modell gpt-6-astra, als Beispiel und nicht als Regel) weist das Modell an, „keep going until the user's query is completely resolved", und sagt „Do not stop after completing only part of the request" (OpenAI docs). Das ist vernünftig für einen Job mit klarer Ziellinie und eine Falle für einen ohne. Ein hartnäckiger Agent mit vagem Ziel kann in einer Schleife immer weiter Tokens verbrennen; Googles Leitfaden sagt zu hoher Persistenz dasselbe. Anthropics Essay nennt es üblich, „stopping conditions (such as a maximum number of iterations)" einzubauen, um die Kontrolle zu behalten (Anthropic Engineering).
Eine weitere Gewohnheit, die wir ablegen würden: das Briefing in einen Thread zu kopieren, in dem schon zehn Korrekturen stehen. Der Agent hat dann elf Anweisungssätze und keine Möglichkeit, sie zu gewichten.
Beobachten Sie die erste Minute, dann schreiben Sie um
Die Docs von Claude Code raten: „Watch the first minute, press Esc the moment Claude drifts, and after two failed corrections run /clear and write a better prompt instead of a third" (Claude Code docs). Das würden wir auf jeden Agenten anwenden: Der erste Plan und die ersten Aktionen zeigen, ob Ihr Briefing so gelesen wurde, wie Sie es gemeint haben.
Wenn Sie das Briefing noch nicht schreiben können, lassen Sie den Agenten Sie interviewen. Die Docs von Claude Code schlagen einen Prompt in der Art von „Interview me until you could write the spec, then write it to SPEC.md" vor, und Codex rät, ihn zuerst Fragen stellen zu lassen und Ihre Annahmen zu „challenge your assumptions" (Claude Code docs, und OpenAI Codex docs). Starten Sie danach eine neue Session mit der geschriebenen Spec.
Briefings, die zweimal funktionieren, verdienen ein Zuhause. Dauerhafte Regeln (wie Tests laufen, was nie angefasst wird) gehören in eine AGENTS.md- oder CLAUDE.md-Datei; OpenAI sagt: „A short, accurate AGENTS.md is more useful than a long file full of vague rules" (OpenAI Codex docs). Ein Ablauf, den Sie wiederholen, kann zu einem Skill werden, was wir in From Prompts to Skills behandeln. Was überhaupt in die Session geladen werden sollte, ist Thema unseres Beitrags zu Context Engineering, und die Gewohnheiten, die Prompts über Modell-Releases hinweg funktionieren lassen, stehen in Prompt Patterns That Survive Model Updates. Für Tools, die auf diese Art von Delegation ausgelegt sind, sehen Sie sich unsere Bestenlisten für KI-Agenten, Aufgaben zum Bau von Agenten und Prompt-Engineering-Tools an.
Häufig gestellte Fragen
Wie lang sollte ein Briefing sein?
Lang genug für die sechs Teile, bei den meisten Jobs sind das 100 bis 200 Wörter. Dauerhafte Vorlieben gehören in eine Regeldatei, damit jedes Briefing nur diese eine Aufgabe abdeckt. Wächst das Briefing über eine Seite hinaus, sollte der Job wahrscheinlich in zwei geteilt werden.
Brauchen ChatGPT, Claude und Gemini unterschiedliche Briefings?
Das Grundgerüst ist dasselbe. Die vier Teile in OpenAIs Codex-Leitfaden, Anthropics Rat, Kontext zu liefern und vor riskanten Aktionen zu fragen, und Googles Agent-Dimensionen (Umgang mit Mehrdeutigkeit, Risikobewertung, Persistenz) beschreiben denselben Bedarf mit anderen Worten. Bei der Formatierung gibt es kleine Unterschiede: Googles Leitfaden empfiehlt XML-artige Tags oder Markdown-Überschriften und rät: „Choose one format and use it consistently" (Google AI docs). Welcher Assistent zu welchem Job passt, ist eine eigene Frage, die wir in ChatGPT vs Claude vs Gemini in 2026 behandeln.
Was soll ich dem Agenten sagen, wenn er unsicher ist?
Geben Sie ihm eine Regel, die er anwenden kann. „Nimm alles Umkehrbare einfach an und liste es im Bericht auf; frag vor allem, was nicht umkehrbar ist" funktioniert besser als „Frag, wenn du unsicher bist." Googles Leitfaden beschreibt dieselbe Entscheidung als die Frage, wann das Modell Annahmen treffen darf und wann es für Klärung oder Erlaubnis pausieren muss.
Reicht ein gutes Briefing, um einen Agenten sicher zu machen?
Nein. Ein Briefing verringert Fehler und verhindert keinen einzigen. Anthropic empfiehlt „extensive testing in sandboxed environments, along with the appropriate guardrails" (Anthropic Engineering), und unser Leitfaden zur Eindämmung behandelt Berechtigungen und Audit-Trails.
Der Agent hat es trotzdem falsch gemacht. Was nun?
Finden Sie den ersten Schritt, an dem er vom Kurs abgekommen ist, und fragen Sie, was das Briefing zu diesem Schritt sagte. Ergänzen Sie die eine Zeile, die es verhindert hätte, und starten Sie dann aus einer frischen Session neu.