

Wenn Sie KI-Output prüfen wollen, ohne darin zu ertrinken, versuchen Sie nicht, jeden Satz zu verifizieren. Ziehen Sie die Behauptungen heraus, ordnen Sie sie danach, was bei einem Fehler kaputtgeht, und prüfen Sie diejenigen, auf denen Ihr Text aufbaut, an der Originalquelle. Weder eine saubere Quellenangabe noch das „Ja, ich bin sicher" des Modells beweist irgendetwas.
Die Kosten fürs Weglassen dieses Schritts steigen immer weiter. Eine öffentliche Datenbank mit Gerichtsentscheidungen zu KI-halluzinierten Inhalten hatte zum Zeitpunkt des Schreibens 2.125 davon erfasst, 1.193 allein in diesem Jahr (AI Hallucination Cases database). Anfang des Jahres zog KPMG einen veröffentlichten Bericht wegen offenkundiger KI-Halluzinationen zurück, nachdem Organisationen, die darin beschrieben wurden, die Aussagen über ihren KI-Einsatz als „entweder unwahr oder irreführend" bezeichnet hatten (TechCrunch).
Halluzinationen sind nicht verschwunden. Sie sind schwerer zu erkennen, weil der Text drumherum flüssig klingt und die erfundenen Verweise echten zum Verwechseln ähnlich sehen. Im Folgenden erfahren Sie, bei welchen Behauptungstypen es am häufigsten schiefgeht, warum Selbstkontrolle durch das Modell nicht reicht, wie ein risikobasierter Workflow mit Prompts zum Kopieren aussieht und was Grounding-Tools wie Gemini Notebook (früher NotebookLM), Perplexity und Consensus wirklich leisten.
Erfundene Quellenangaben sind vor Gericht längst ein eigenes Genre
Juristen haben das als Erste gelernt, und zwar öffentlich. Damien Charlotins Datenbank erfasst Entscheidungen, in denen ein Gericht feststellte oder andeutete, dass sich eine Partei auf halluzinierte Inhalte gestützt hat, meist auf erfundene Rechtsprechung. Sie versucht nicht, jede jemals eingereichte gefälschte Quelle zu zählen, sondern nur solche, die ein Gericht schriftlich behandelt hat. Selbst mit diesem engen Filter ist die Kurve steil.
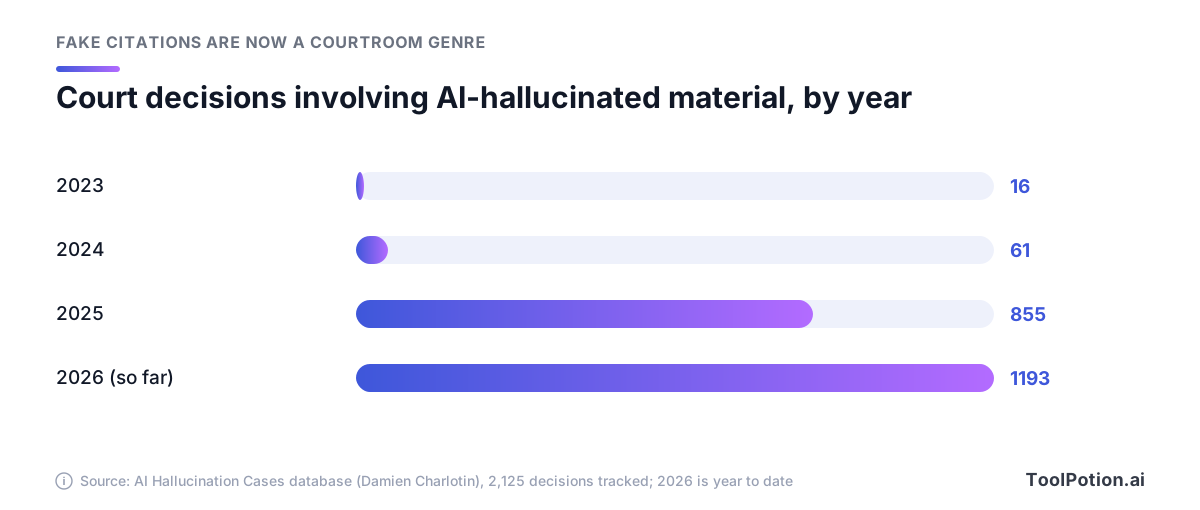
Der Balken für 2026 deckt nur einen Teil des Jahres ab und hat 2025 bereits überholt. Auf Personen, die sich selbst vertreten, entfallen 1.227 der erfassten Entscheidungen, auf Anwälte 840, und in 33 Fällen stammte das halluzinierte Material von einem Richter. Die USA dominieren mit 1.459 Entscheidungen, gefolgt von Kanada mit 223 und Australien mit 112.
Der Fall, mit dem alles begann, ist bis heute die beste Lehre. In Mata v. Avianca fragte 2023 ein Anwalt in einem New Yorker Bundesverfahren ChatGPT, ob einer der von der KI gelieferten Fälle real sei. Die Antwort: ja. Auf Nachfrage hieß es, der Fall „existiert tatsächlich und ist in juristischen Recherchedatenbanken wie Westlaw und LexisNexis zu finden" (CNN). Den Fall gab es nicht, und das Gericht verhängte gegen die Anwälte und ihre Kanzlei eine Geldstrafe von 5.000 $. Der Anwalt erklärte eidesstattlich, er „war sich der Möglichkeit nicht bewusst, dass der Inhalt falsch sein könnte."
Die Rechnungen sind seitdem gewachsen. In Couvrette v. Wisnovsky stellte ein Bundesgericht in Oregon fünfzehn erfundene Quellenangaben und sieben falsche Zitate in den Schriftsätzen der Kläger fest. Es strich die Schriftsätze, wies die Klagen endgültig ab und verhängte Sanktionen und Kosten in Höhe von 110.204 $, die höchste Gesamtsumme für einen US-Fall in der Datenbank. Wenn Sie KI in der juristischen Arbeit einsetzen, zeigt unser Leitfaden zu KI für juristische Arbeit, welche Setups sicherer sind.
Gerichte sind nur die sichtbarste Bühne. Deloitte stimmte einer teilweisen Rückerstattung für eine australische Regierungsstudie über 440.000 $ zu, in der nicht existierende Berichte von Universitätsprofessoren zitiert wurden und ein erfundener Verweis auf eine echte Gerichtsentscheidung vorkam. Die Firma räumte später ein, eine auf Azure OpenAIs GPT-4o basierende Toolchain eingesetzt zu haben (The Guardian). EY zog dieses Jahr einen Bericht über Kundenbindungsprogramme zurück, der offenbar gefälschte Fußnoten enthielt, so derselbe TechCrunch-Artikel, der auch über KPMG berichtete. Und 2025 druckte die Chicago Sun-Times eine syndizierte Sommerleseliste, auf der 10 der 15 Bücher erfunden waren, wie NPR berichtete.
Wo KI-Output danebenliegt
Modelle vertippen sich kaum noch, und OpenAIs Forscher erklären, warum die Fehler woandershin gewandert sind. Rechtschreibung folgt Mustern, die ein großes Modell lernt, aber „willkürliche, selten vorkommende Fakten wie der Geburtstag eines Haustiers lassen sich nicht allein aus Mustern vorhersagen und führen daher zu Halluzinationen" (OpenAI). Als sie einen weit verbreiteten Chatbot nach dem Dissertationstitel eines der Autoren des Papers fragten, lieferte er drei verschiedene Antworten. Keine stimmte.
Das gibt Ihnen eine Landkarte. Fehler häufen sich bei einer Handvoll Behauptungstypen, und am riskantesten sind die, die sich als Beweis tarnen.
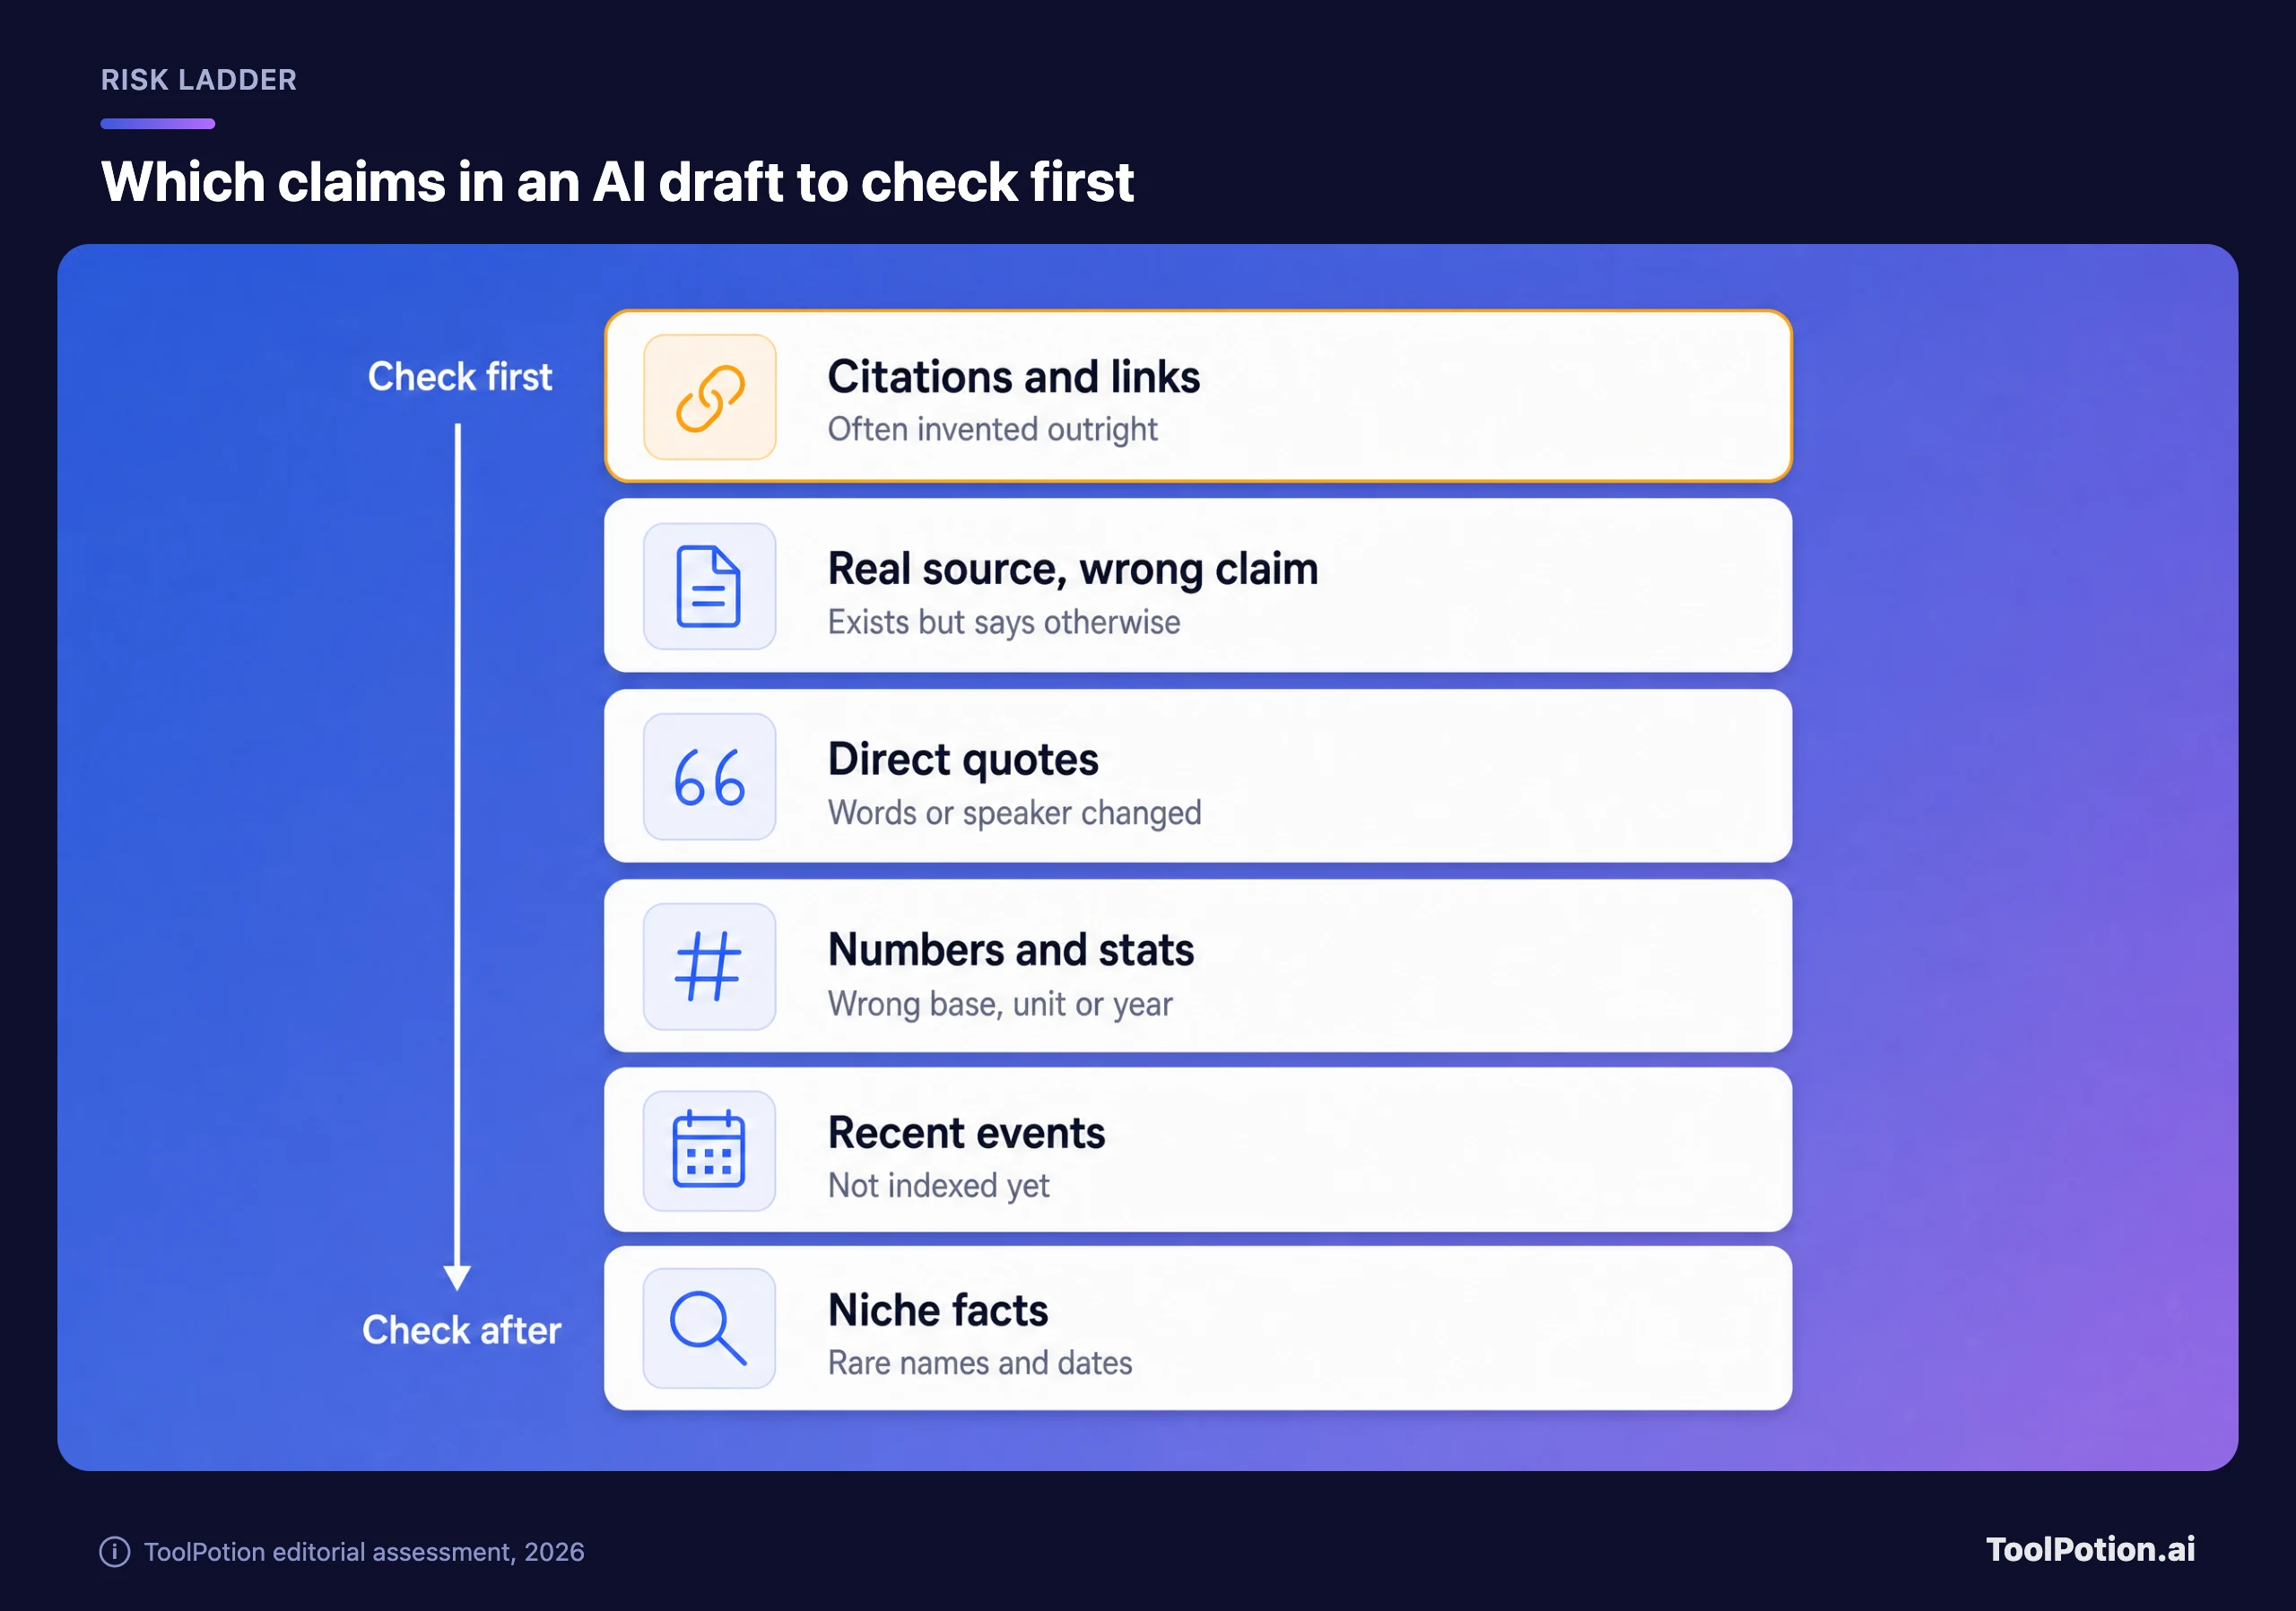
Quellenangaben stehen ganz oben, weil sie auf zwei Arten scheitern. Manche sind schlicht erfunden: Als das Tow Center der Columbia University 2025 1.600 Anfragen durch acht KI-Suchtools schickte und jedes die Quelle eines Nachrichtenauszugs benennen ließ, lagen die Tools zusammen in über 60 % der Fälle falsch, und Grok 3 verwies 154 seiner 200 Quellenangaben auf Fehlerseiten (Tow Center). Andere sind echt, werden aber für etwas angeführt, das dort nicht steht. Charlotins Datenbank zählt 894 Entscheidungen mit verfälschtem Material, neben 1.752 mit Erfindungen. Ein funktionierender Link fängt diese zweite Sorte nicht ab.
Danach kommen Zitate. Die Datenbank listet 572 Entscheidungen mit falschen Zitaten, und OpenAIs eigenes Help Center nennt „erfundene Zitate, Studien, Quellenangaben oder Verweise auf nicht existierende Quellen" unter den bekannten Fehlermustern von ChatGPT (OpenAI Help). Zahlen scheitern leiser: ein echter Wert aus dem falschen Jahr, Prozent statt Prozentpunkte, ein regionaler Preis, der als globaler durchgeht.
Aktualität ist eine eigene Falle. Laut Perplexitys Entwicklerdokumentation sind Halluzinationen am wahrscheinlichsten, wenn Informationen hinter einem Login oder einer Paywall liegen, wenn Suchen „verwandte, aber nicht passende Ergebnisse" liefern oder „wenn sehr aktuelle Informationen noch nicht indexiert sind" (Perplexity docs). Eine von der BBC geleitete Studie von 2025 mit mehr als 3.000 Nachrichtenantworten von ChatGPT, Microsoft Copilot, Google Gemini und Perplexity fand bei 20 % davon gravierende Genauigkeitsprobleme, darunter veraltete Informationen.
Hinzu kommt der Ton. In dem Tow-Center-Test identifizierte ChatGPT 134 Artikel falsch, signalisierte aber nur 15 Mal in 200 Antworten Unsicherheit, und Bezahlstufen mancher Tools beantworteten mehr Fragen richtig, gaben aber auch mehr selbstsicher falsche Antworten. Die Hilfeseite von OpenAI sagt es klar: „Das Modell kann auch bei falschen Antworten hohe Sicherheit ausdrücken." Bei KI-Output verrät ein selbstsicherer Ton so gut wie nichts über die Richtigkeit.
Warum die Bitte ans Modell, selbst nachzuprüfen, nicht reicht
Die naheliegende Abkürzung: den Entwurf wieder einfügen und fragen, ob er stimmt. Wie das ausgeht, hat Mata v. Avianca schon gezeigt, und die Forschung bestätigt es. Ein auf der ICLR 2024 vorgestelltes Paper stellte fest, dass Modelle „Schwierigkeiten haben, ihre Antworten ohne externes Feedback zu korrigieren, und ihre Leistung nach der Selbstkorrektur mitunter sogar sinkt" (Huang et al.).
Die Ursache liegt im Training. OpenAIs Forscher argumentieren, dass „gängige Trainings- und Evaluierungsverfahren Raten belohnen statt das Eingeständnis von Unsicherheit", ähnlich wie eine Multiple-Choice-Prüfung einen blinden Tipp besser stellt als eine leere Antwort. Sie räumen auch ein, dass die Genauigkeit „nie 100 % erreichen wird", weil manche echten Fragen nicht beantwortbar sind. Ein Modell, das seinen eigenen Entwurf prüft, greift auf dasselbe Wissen zurück, das den Fehler hervorgebracht hat, und wiederholt ihn deshalb oft.
Selbstprüfung hat trotzdem ihren Nutzen. Ein Paper von 2023 zur Chain-of-Verification zeigte, dass eine strukturierte Variante hilft: Das Modell entwirft eine Antwort, formuliert Prüffragen, beantwortet sie unabhängig vom Entwurf und überarbeitet dann. Das senkte die Halluzinationen bei mehreren Aufgaben. Nutzen Sie sie, um Verdächtige zu finden, nie, um sie freizusprechen.
Grounded heißt nicht korrekt
Wenn Sie dem Modell eine Quelle zum Arbeiten geben, sinkt die Fehlerquote. Auf null sinkt sie nicht. Vectaras öffentliches Leaderboard lässt Modelle über 7.700 Artikel zusammenfassen, und zwar nur anhand der Fakten im jeweiligen Artikel, und bewertet die Zusammenfassungen dann mit Vectaras eigenem Erkennungsmodell. Selbst in dieser einfachen Situation fügt jedes Modell auf der Liste in einem Teil seiner Zusammenfassungen nicht belegte Inhalte hinzu (Vectara).
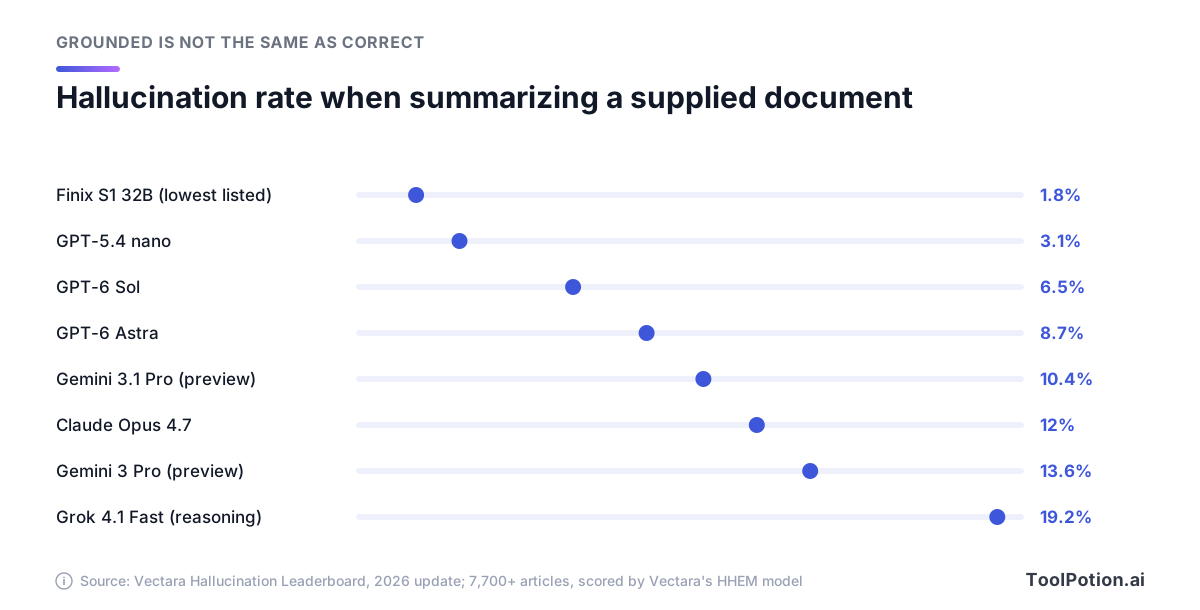
Im jüngsten Update fügte GPT-6 Sol in 6,5 % der Zusammenfassungen nicht belegtes Material hinzu, Claude Opus 4.7 in 12 %. Ein Modell, das ein anderes bewertet, ist unvollkommen, Vectara sagt offen, dass der Test nicht jede Art von Halluzination erfasst, und die Tabelle enthält noch nicht jedes aktuelle Release. Die Richtung ist trotzdem klar. Eine Studie von 2024 zu Rechercheinstrumenten für Juristen, die echte Rechtsprechung abrufen, darunter Lexis+ AI und Westlaws AI-Assisted Research, ergab, dass sie dennoch in 17 bis 33 % der Fälle halluzinierten. Grounding reduziert das Problem auf eine Frage: Steht das so in der Quelle? Stellen müssen Sie sie trotzdem selbst.
Ein Verifikations-Workflow nach Risiko
Die Lösung heißt Triage. Der größte Teil eines Entwurfs ist Bindegewebe: Rahmung, Überleitungen und Meinungen, die Sie ohnehin vertreten würden. Eine kleine Zahl von Behauptungen trägt den Text, und genau dort richtet ein Fehler Schaden an. Sortieren Sie zuerst, und investieren Sie Ihre Prüfzeit dann dort, wo sie sich auszahlt.
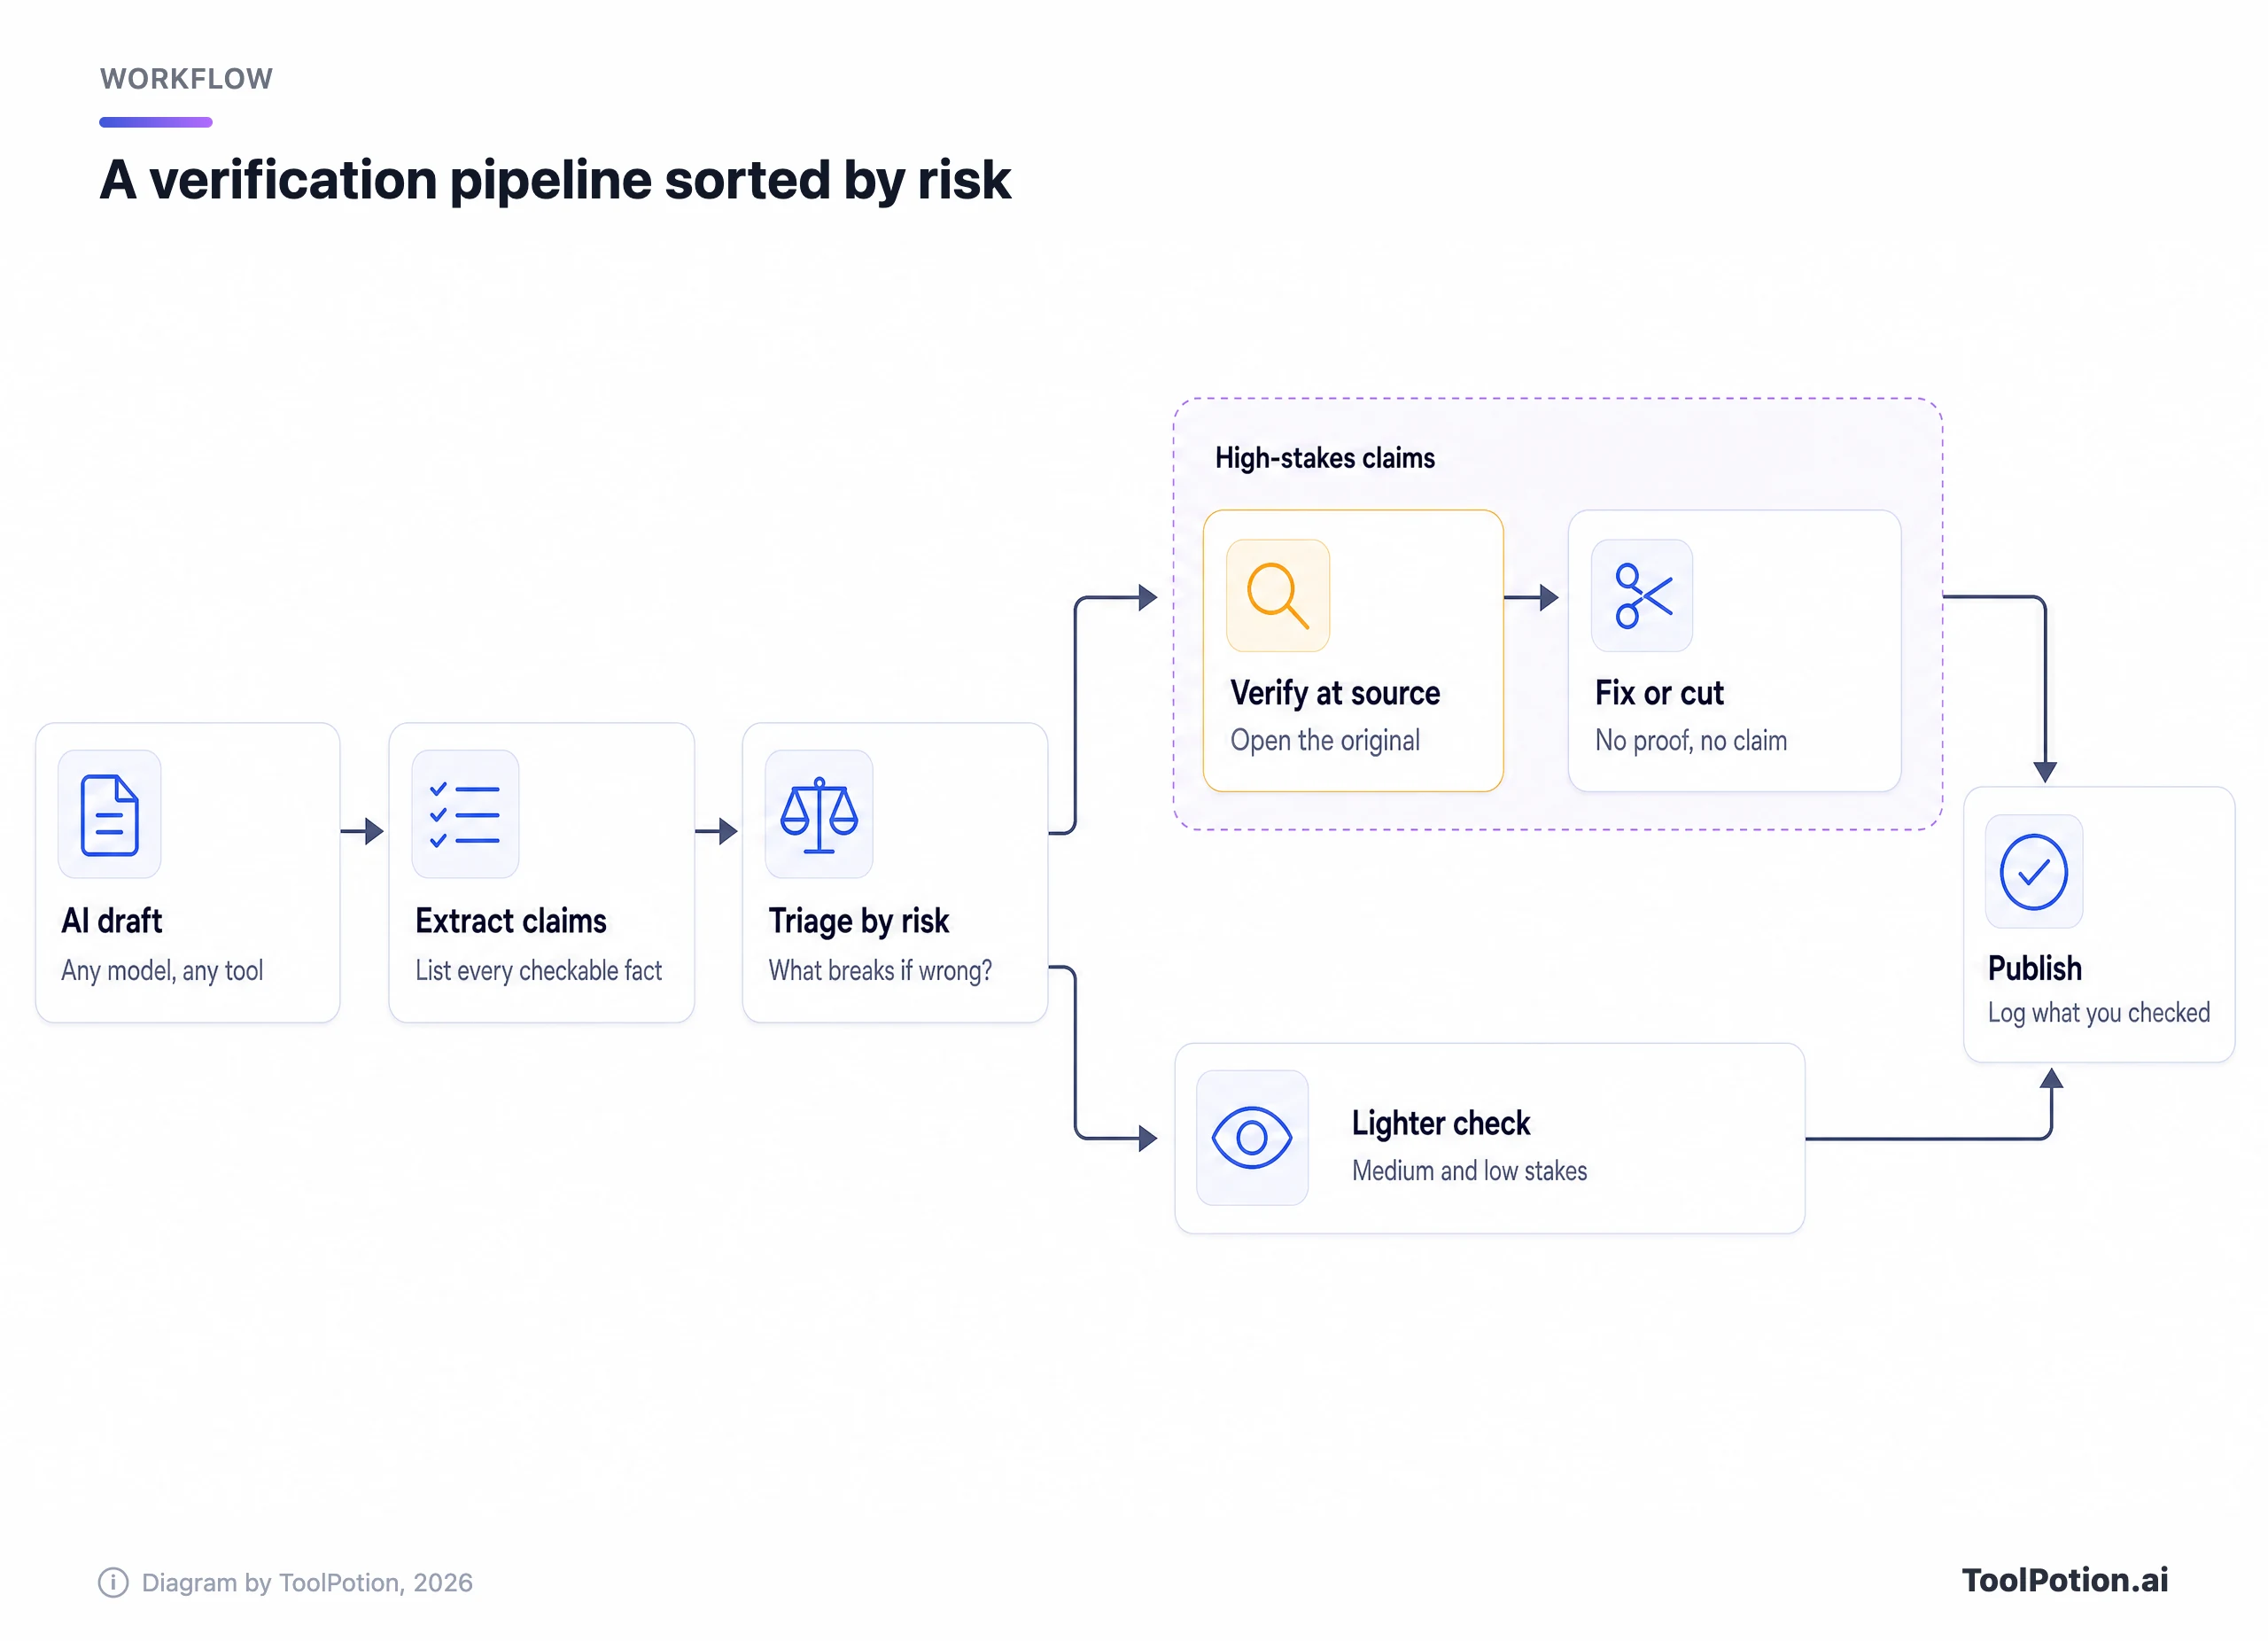
- Behauptungen extrahieren. Lassen Sie ein Modell jede prüfbare Aussage im Entwurf auflisten: Namen, Zahlen, Daten, Zitate, Quellenangaben und Ursache-Wirkungs-Behauptungen. Sie werden Behauptungen finden, von denen Sie nicht gemerkt haben, dass Sie sie aufstellen.
- Nach Tragweite priorisieren. Fragen Sie bei jeder Behauptung, was passiert, wenn sie falsch ist. Alles Juristische, Medizinische oder Finanzielle hat hohes Risiko, ebenso jede Quellenangabe, jedes direkte Zitat, jede Statistik in Überschrift oder Zusammenfassung und jede Behauptung über eine namentlich genannte Person oder Firma. Unterstützender Kontext, den Leser weitererzählen könnten, hat mittleres Risiko. Rahmung, die Sie aus dem Kopf vertreten könnten, hat niedriges.
- Die hohe Stufe an der Primärquelle verifizieren: Gerichtsurteil, Schriftsatz, Datensatz, die eigene Seite des Unternehmens, die Studie selbst. Ein Nachrichtenartikel über eine Studie ist nicht die Studie.
- Die mittlere Stufe stichprobenartig per lateralem Lesen prüfen (siehe unten) und der niedrigen Stufe eine redaktionelle Lektüre gönnen.
- Korrigieren, abschwächen oder streichen. Wenn Sie eine Behauptung nicht in der Zeit bestätigen können, die sie verdient, nehmen Sie sie raus oder schreiben Sie sie klar zu („laut Anbieter"). Behalten Sie nie eine Behauptung, nur weil sie plausibel klingt.
- Ein Protokoll führen. Eine Zeile pro Behauptung der hohen Stufe, mit Behauptung, Quelle und der Fundstelle des Belegs, kostet nur Minuten und beantwortet die Frage, die irgendwann ein Redakteur, Kunde oder Richter stellen wird.
Skalieren Sie den Aufwand danach, wie weit der Output reist. Ein Brainstorming braucht eine sorgfältige Lektüre. Ein Kundendokument braucht, dass jede Behauptung der hohen Stufe an ihrer Quelle geöffnet wird. Wenn die Prüfrechnung zu groß aussieht, enthält der Entwurf wahrscheinlich zu viele Behauptungen, und Streichen geht oft schneller als Verifizieren.
Sie wissen nicht, in welche Stufe ein Output fällt? Beantworten Sie unten bis zu drei Fragen.
Beachten Sie, wonach der Entscheidungsbaum fragt: wohin der Output geht und was er enthält, nie, welches Modell ihn geschrieben hat. Ein stärkeres Modell verschiebt die Wahrscheinlichkeiten. Es ändert nichts daran, wer für den Fehler geradesteht.
So prüfen Sie Quellenangaben, Zitate und Zahlen
Jeder Behauptungstyp hat seinen eigenen Schnelltest. Keiner braucht Spezialsoftware, nur die Disziplin, den Chatbot zu verlassen und das Original zu öffnen.
Quellenangaben
Prüfen Sie zuerst die Existenz. Suchen Sie nach Titel, DOI, Aktenzeichen oder URL in einer Datenbank oder Suchmaschine, die Sie selbst kontrollieren, nie im Chatbot, der sie geliefert hat. Prüfen Sie dann den Beleg: Öffnen Sie die Quelle und finden Sie die Passage, die den Satz stützt. Finden Sie sie nicht innerhalb weniger Minuten, fällt die Quellenangabe durch. Achten Sie auch auf die Version. Das Tow Center stellte fest, dass KI-Suchtools oft auf syndizierte Kopien statt auf den ursprünglichen Verlag verwiesen, und ein Preprint kann sich vom veröffentlichten Paper unterscheiden.
Zitate
Suchen Sie eine markante Wendung aus fünf oder sechs Wörtern in Anführungszeichen. Taucht sie nirgends auf oder nur auf Seiten, die maschinell geschrieben wirken, behandeln Sie das Zitat als erfunden. Ist es echt, lesen Sie den Absatz drumherum und bestätigen Sie Sprecher, Datum und Bedeutung. Ein echtes Zitat, das aus dem Kontext gerissen wurde, täuscht genauso wie ein gefälschtes.
Zahlen
Rechnen Sie alles nach, was geht. Bestätigen Sie die Einheit (Prozent oder Prozentpunkte, monatlich oder jährlich, welche Währung), das Jahr und die Bezugsgröße. Wenn im Entwurf steht, ein Wert habe sich verdoppelt, suchen Sie beide Zahlen. Eine Statistik ohne benannte Quelle kommt nicht rein, so plausibel sie auch aussieht.
Aktuelle Ereignisse und virale Behauptungen
Prüfen Sie bei jeder Quelle das Datum und bevorzugen Sie Berichte, die nach dem Ereignis erschienen sind. Bei einer Behauptung, die schon online kursiert, durchsucht der Fact Check Explorer von Google veröffentlichte Faktenchecks und zeigt, welche Organisation die Behauptung wie bewertet hat. Sie können auch ein Bild hochladen, um zu sehen, ob es schon geprüft wurde.
Gehen Sie vor dem Veröffentlichen diese Checkliste durch. Die ersten vier Punkte zählen doppelt.
Die Gewichtung folgt den Gerichtsdaten: Erfundene Quellenangaben, verfälschte Quellen und falsche Zitate machen den Großteil dieser Datenbank aus. Bleiben diese vier Kästchen leer, macht nichts anderes auf der Liste den Entwurf versandfertig.
Laterales Lesen für Behauptungen ohne Beleg
Manche Behauptungen kommen ohne Quellenangabe, die Sie öffnen könnten. Übernehmen Sie dafür die Gewohnheit professioneller Faktenchecker. Stanfords Civic Online Reasoning Group kam, nachdem sie Faktencheckern bei der Arbeit zugesehen hatte, zu dem Schluss: „Der beste Weg, etwas über eine Website zu erfahren, ist laterales Lesen." Man verlässt also die Seite und schaut, was andere Quellen über sie sagen, statt die Seite selbst zu studieren.
Mike Caulfield hat daraus eine Routine in vier Schritten gemacht, genannt SIFT (Caulfield). Sie passt gut zu KI-Antworten, mit einer Anpassung: Die Quelle, die Sie untersuchen, ist der Chatbot samt dem Link, den er gewählt hat.
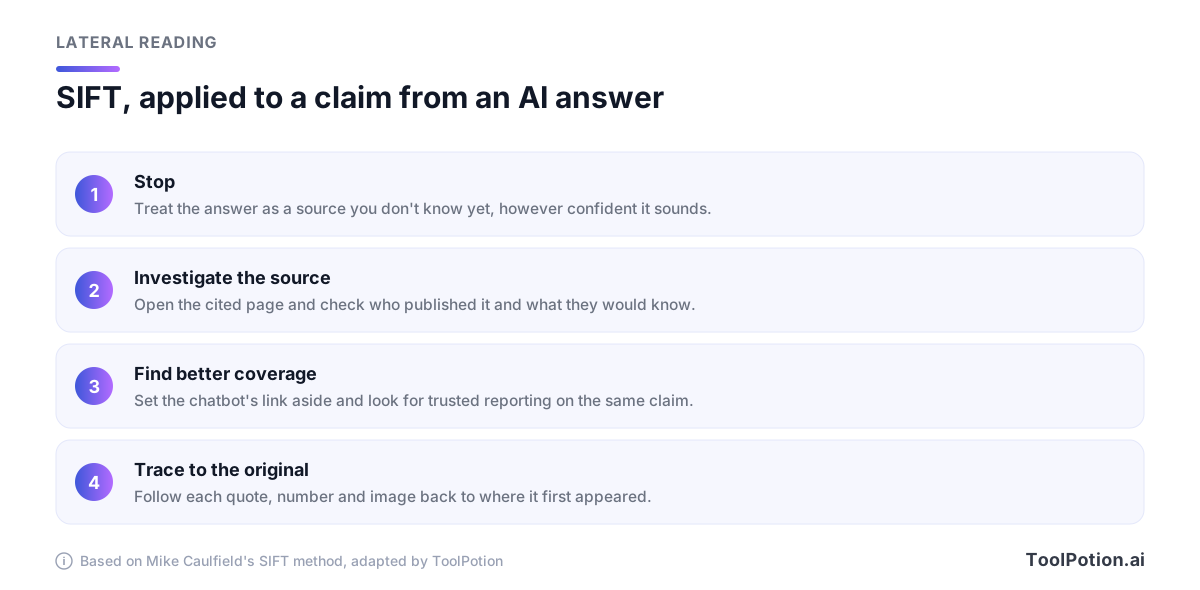
Der dritte Schritt leistet bei Chatbots am meisten. Wenn die Behauptung wichtiger ist als der Artikel, der sie transportiert hat, rät Caulfield, „die Quelle zu ignorieren, über die sie Sie erreicht hat, und nach vertrauenswürdiger Berichterstattung oder Analyse zur Behauptung zu suchen." Suchen Sie die Behauptung also neu, in Ihren eigenen Worten. Gibt es zu etwas, das breit berichtet sein müsste, keine unabhängige Berichterstattung, haben Sie Ihre Antwort.
Laterales Lesen klärt auch die Quellen, die ein Modell selbst findet. Eine echte URL auf einer Seite, von der Sie noch nie gehört haben, ist eine schwache Quelle, egal wie ordentlich die KI den Verweis formatiert hat.
Prompts, die den Output leichter prüfbar machen
Halluzinationen lassen sich nicht wegprompten, aber Sie können den Output so formen, dass Fehler leichter auffallen. Die Dokumentation der Anbieter selbst ist der beste Leitfaden. Anthropic sagt, die empfohlenen Techniken „reduzieren Halluzinationen erheblich", „beseitigen sie aber nicht vollständig" (Anthropic docs). Für allgemeinere Prompting-Gewohnheiten lesen Sie unseren praktischen Leitfaden zu Prompt Engineering.
Erlauben Sie ihm ausdrücklich, „Ich weiß es nicht" zu sagen
Anthropic und Perplexity raten Entwicklern beide, dem Modell ausdrücklich zu erlauben, Unsicherheit einzugestehen oder zu melden, dass es nichts gefunden hat. OpenAIs Forschung zeigt, warum das wichtig ist. In ihrem Vergleich auf dem SimpleQA-Benchmark lag ein Modell, das bei 52 % der Fragen passte, bei 26 % falsch, eines, das bei 1 % passte, dagegen bei 75 %, bei fast gleicher Genauigkeit. Nutzen Sie das als Standardanweisung:
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
Zitate vor Schlussfolgerungen verlangen
Anthropics Dokumentation empfiehlt, bei langen Dokumenten zuerst wörtliche Zitate zu extrahieren, bevor die Aufgabe erledigt wird, und das Modell anschließend zu jeder Behauptung ein stützendes Zitat suchen zu lassen und jede Behauptung zurückzuziehen, die es nicht belegen kann. In der Praxis sieht das so aus:
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
Lassen Sie es Beinahe-Treffer melden, und erzwingen Sie keine Kürze
Perplexitys Leitfaden ergänzt eine Regel, die sich zu übernehmen lohnt: „Wenn Sie verwandte, aber nicht passende Ergebnisse finden (zum Beispiel ein anderes Jahr, eine Muttergesellschaft oder eine Tochterfirma), nennen Sie die Abweichung ausdrücklich, bevor Sie antworten." Das fängt den richtigen Fakt zur falschen Einheit ab, einen der Fehler, die man mit bloßem Auge am schwersten erkennt. Die Beispielregeln weisen das Modell außerdem an, Quellen per Domain zu nennen und „keine vollständigen URLs zu schreiben."
Auch die Länge spielt eine Rolle. Giskard, ein Pariser Unternehmen für KI-Tests, stellte fest, dass GPT-4o, Mistral Large und Claude 3.7 Sonnet ungenauer wurden, wenn man sie um knappe Antworten bat, denn „wenn sie sich kurzfassen müssen, wählen Modelle konsequent Kürze statt Genauigkeit." Dieselbe Studie zeigte, dass Modelle weniger dazu neigten, einer vom Nutzer selbstsicher aufgestellten umstrittenen Behauptung zu widersprechen. Formulieren Sie Fragen neutral („Stimmt es, dass X?"), statt die Behauptung vorauszusetzen wie bei „Erkläre, warum X."
Behauptungen extrahieren, dann zweimal laufen lassen
Dieser Prompt liefert den ersten Schritt des Workflows. Lassen Sie ihn über jeden Entwurf laufen, auch über einen, den Sie selbst geschrieben haben.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic schlägt außerdem Best-of-N-Prüfung vor: denselben Prompt mehrfach ausführen und vergleichen, denn widersprüchliche Antworten deuten auf wahrscheinliche Halluzinationen hin. Es ist dasselbe Symptom, das OpenAI bei den drei Dissertationstiteln sah. Abweichungen zwischen den Läufen zeigen Ihnen, wo Sie hinschauen sollten. Übereinstimmung beweist nichts.
Quellenbasierte Tools helfen, aber nur bis zu einem Punkt
Eine andere Klasse von Tools schränkt ein, worauf das Modell zurückgreifen kann. Aus „Stimmt das?" wird so „Steht das in der Quelle?", und das ist schneller zu prüfen. Die Prüfung entfällt dadurch nicht.
Google hat NotebookLM Anfang des Jahres in Gemini Notebook umbenannt und als eigenständiges Recherchetool beibehalten, das laut Google mehr als 30 Millionen Menschen nutzen (Google). Im Chat antwortet es aus den Quellen, die Sie hinzufügen, und „verwendet direkte Zitate, Text und Bilder aus Ihren Quellen als Belege". Fahren Sie mit der Maus über einen Beleg, um den zitierten Text zu sehen, oder klicken Sie, um im Kontext dorthin zu springen (Gemini Notebook Help). Das macht Belegprüfungen schnell. Kennen Sie aber auch die Lücken: Laut Googles Hilfeseiten werden Webseiten hinter Paywalls nicht unterstützt, und Fußnoten und Kommentare in Google-Dateien werden nicht importiert. Die neueren agentischen Chat-Funktionen, die im Web suchen und Code ausführen können, sind als experimentell gekennzeichnet, mit dem Hinweis „Prüfen Sie das unbedingt noch einmal."
Answer Engines wie Perplexity hängen jeder Antwort Links an, ein echter Fortschritt gegenüber einem Chatbot ohne Quellen. Die Links müssen Sie trotzdem öffnen. Perplexity lag im Tow-Center-Test 2025 bei 37 % der Anfragen falsch (die Tools haben sich seitdem verändert), und Googles eigene Gemini-Hilfe weist darauf hin, dass „nicht alle Antworten zugehörige Links oder Quellen enthalten."
Für Forschungsbehauptungen verankern akademische Suchtools die Antworten in Papers statt im offenen Web. Consensus durchsucht begutachtete Fachliteratur und sagt, dass es Ihnen mitteilt, wenn es „nicht genug relevante Belege findet", statt Lücken zu füllen. Elicit gibt an, jede KI-generierte Aussage mit Belegen auf Satzebene zu untermauern. Scite zeigt, ob spätere Forschung die Ergebnisse eines Papers bestätigt oder widerlegt hat, und fängt damit einen Fehler ab, den die anderen übersehen: eine echte Studie, die inzwischen angefochten wurde.
Wenn Sie eine eigene Pipeline bauen, liefert Anthropics Citations API die genaue Passage hinter jeder Aussage, und laut Anthropics Dokumentation enthalten diese Belege „garantiert gültige Verweise auf die bereitgestellten Dokumente." Das schließt erfundene Quellen aus. Es bestätigt nicht, dass die Passage den Satz stützt, an den sie gehängt wurde. Referenzprüfer stehen am Ende der Kette. GPTZero bietet einen Halluzinationsdetektor, der Literaturverzeichnisse scannt. Das Team markierte den KPMG-Bericht und fand Anfang des Jahres 100 halluzinierte Quellenangaben in 51 Papers, die auf der NeurIPS, einer führenden KI-Konferenz, angenommen worden waren, wie TechCrunch berichtete.
| Tool-Typ | Verankert Antworten in | Was Sie weiterhin prüfen |
|---|---|---|
| Notebook-Tools (Gemini Notebook) | Von Ihnen hochgeladene Quellen | Ob jede zitierte Passage die Behauptung stützt und ob Ihre Quellen stimmen |
| Answer Engines (Perplexity, ChatGPT mit Suche) | Live-Webergebnisse | Jeden Link öffnen, das Datum prüfen und den ursprünglichen Verlag finden |
| Forschungssuche (Consensus, Elicit, Scite) | Wissenschaftliche Papers | Die tatsächlichen Ergebnisse und Grenzen des Papers sowie spätere widersprechende Arbeiten |
| Citation-APIs (Claude Citations) | Von Ihnen gelieferte Dokumente | Ob die Behauptung gestützt wird, über einen gültigen Verweis hinaus |
| Referenzprüfer (GPTZero) | Bibliografische Einträge | Ob eine echte Quelle das aussagt, was der Entwurf behauptet |
Zum Vergleich der Optionen stöbern Sie im Ranking der KI-Recherche-Assistenten, im Ranking der KI-Suchmaschinen und im Ranking für die Suche in wissenschaftlicher Literatur. Unsere Übersichten zu KI-Recherche-Assistenten und KI-Suchmaschinen gehen tiefer auf Funktionen und Preise ein.
Häufig gestellte Fragen
Kann ich ein KI-Modell nutzen, um ein anderes zu überprüfen?
Für einen ersten Durchgang ja. Ein zweites Modell, besonders eines mit Suche, markiert einige Fehler, die das erste übersehen hat, und Abweichungen zeigen Ihnen, wo Sie hinschauen sollten. Bestätigen kann es nichts, denn beide können dieselben Lücken haben. Behandeln Sie seine Markierungen als To-do-Liste und klären Sie jede an der Quelle. Wenn Sie einen zweiten Assistenten auswählen, vergleicht unser Leitfaden zu ChatGPT-Alternativen die wichtigsten Optionen.
Prüfen KI-Detektoren Fakten?
Nein. Tools wie der Originality.ai detector schätzen, ob ein Text maschinell geschrieben wurde. Das sagt nichts darüber aus, ob eine Behauptung stimmt, und ein von Menschen geschriebener Entwurf kann genauso falsch sein. Für den Faktencheck brauchen Sie die Originalquelle.
Wie lange sollte der Faktencheck eines KI-Entwurfs dauern?
Das hängt davon ab, wie viele Behauptungen mit hohem Risiko der Entwurf enthält, nicht von seiner Länge. Zählen Sie sie nach der Triage. Ein Erklärtext mit 2.000 Wörtern, vier Statistiken und zwei Zitaten ist schnell erledigt, ein einseitiges Memo voller Quellenangaben dagegen nicht.
Kann ich ChatGPT oder einen anderen Chatbot als Quelle angeben?
Nicht für Fakten. OpenAI selbst rät, „ChatGPT als ersten Entwurf zu nutzen, nicht als endgültige Quelle". Zitieren Sie das zugrunde liegende Dokument, das Sie verifiziert haben. Ist der KI-Output selbst das Thema, etwa bei einem Modelltest, geben Sie an, welches Modell Sie wann verwendet haben.
Machen Deep-Research-Agenten das Prüfen überflüssig?
Nein. Agenten wie OpenAIs Deep Research stellen aus vielen Webquellen Recherche-Berichte mit Belegen zusammen, und das bedeutet mehr Quellenangaben zum Öffnen, nicht weniger Behauptungen zum Prüfen. Das Problem verfälschter Quellen betrifft jeden zitierten Satz, deshalb wird die Triage umso wichtiger, je länger die Berichte werden.