

OpenAI zufolge hat GPT-6 Cyber in einer Forschungskampagne funktionierende Exploits für 948 Linux-Kernel-Schwachstellen gebaut – mehr als fünfmal so viele wie die 166, die GPT-5.6 Sol mit demselben Forschungs-Harness ausgenutzt hat (OpenAI). Das ist die Zahl eines Anbieters aus dem Labor des Anbieters, und so sollten Sie sie auch behandeln. Sie ist aber auch konkret, und die Kernel-Maintainer, denen 304 kritische Funde geschickt wurden, können sie überprüfen.
Innerhalb weniger Tage hat OpenAI GPT-6 Cyber und eine Partnerschaft mit Hacktron vorgestellt, Anthropic hat Claude Fable 5.2 und Mythos 5.2 veröffentlicht, Google DeepMind hat einen maschinell geprüften Beweis zum Code hinter Signal publiziert, und zwei Sicherheitsfirmen haben beschrieben, wie Angreifer KI-Agenten gegen reale Ziele einsetzen. Wir haben die Beiträge der Unternehmen und die zugrunde liegenden Berichte gelesen. The Hacker News brachte die Benchmark-Story, Wired die zu Signal.
Was OpenAI über GPT-6 Cyber sagt
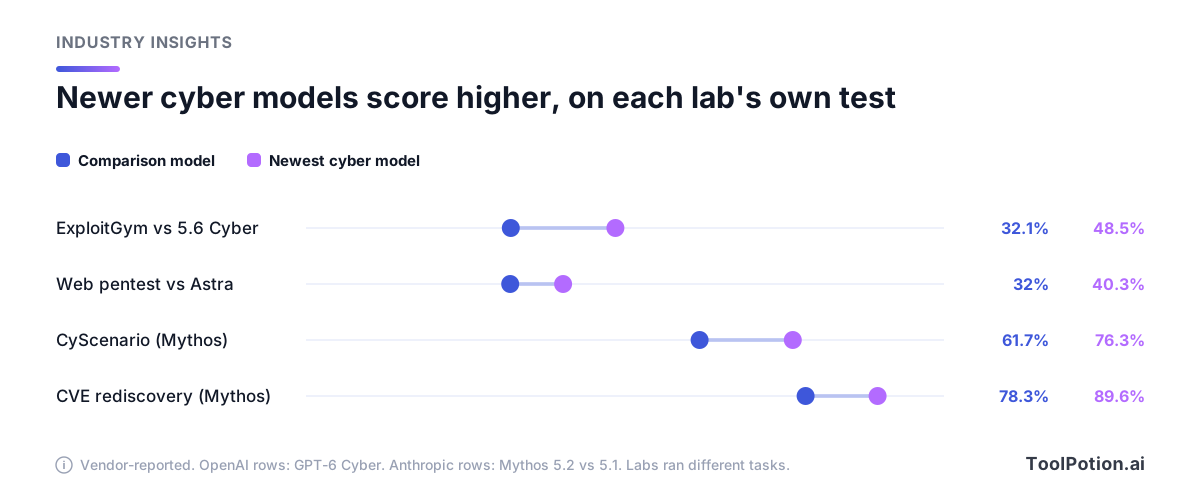
Auf ExploitGym, einem Test, ob ein Modell eine vorgegebene Schwachstelle ausnutzen kann, meldet OpenAI 48,5 % für GPT-6 Cyber gegenüber 32,1 % für GPT-5.6 Cyber. Bei einem neuen Web-Penetrationstest, in dem Modelle Anwendungen ohne Einblick in den Quellcode abtasten, fand es 40,3 % der Schwachstellen, GPT-6 Astra kam auf 32,0 % (OpenAI). Der schärfste Vergleich betrifft Verweigerungen: Auf RemoteExploitBench, das bekannte Lücken in GitLab, PostgreSQL und Jenkins in einem kontrollierten Labor nutzt, lehnte GPT-6 Astra mit Daybreak Blue jede Aufgabe ab, während GPT-6 Cyber 95 % erledigte.
Außerhalb des Labors haben OpenAIs Forscher nach eigener Aussage mit dem Modell 81 bislang unbekannte Schwachstellen mit hohem Schweregrad in Firefox gefunden, so von Mozilla eingestuft; Mozilla hat begonnen, Fixes einzuspielen. Mozillas Brian Grinstead, im Launch-Post zitiert, sagte, Firefox sei in das Jahr 2026 gegangen als „eine der weltweit am stärksten gehärteten und am gründlichsten geprüften Codebasen“. Genau darum geht es: Das ist kein Spielzeugziel. OpenAI stuft das Modell zudem in seinem Preparedness Framework für Cybersicherheit als Critical ein, nach High beim Vorgänger. Wenn ein Labor sein eigenes Produkt so einstuft, lesen wir das ebenso sehr als Warnhinweis wie als Feature-Liste.
Die Sicherheitsaussage fällt aus dem Rahmen. OpenAI hat einen Test gebaut, in dem leicht angreifbare Nebendienste neben dem eigentlichen Ziel stehen und ein Modell erkennen muss, dass ein Angriff darauf außerhalb des Auftrags liegt. Ohne seinen Deployment-Prompt blieb GPT-6 Cyber in 99,93 % der Fälle im Rahmen, nach 94,49 % bei GPT-5.6 Cyber. Der ältere Wert bedeutet, dass etwa jeder achtzehnte Durchlauf ausscherte. Der neue lässt immer noch rund sieben Ausreißer pro zehntausend Durchläufe zu, und OpenAI selbst empfiehlt für Arbeit mit hohem Risiko Sandboxing, Prüfung der Aktionen und menschliche Aufsicht. Diesen Rat würden wir wörtlich nehmen.
Die nützlichste externe Stimme im Launch-Post ist Rob T. Lee, Chief AI Officer bei Dragos, dessen Team OpenAIs cyber-permissive Modelle auf einem nachgebauten Kraftwerksgelände laufen ließ. Sein Fazit: „Die Einstiegshürde sinkt für die Aufklärung und Schwachstellenforschung, die vor einem Angriff nötig sind.“ Lee zufolge hat ein Frontier-Modell auf diesem Gelände eigenständig zwei Zero-Days in Engineering-Software gefunden, die Schutzrelais-Daten verwaltet. Dieses Zitat ist der Grund, warum wir diesen Beitrag schreiben.
Hinter der Schlagzeile „Fable schlägt GPT-6 Cyber“
Lesen Sie diesen Abschnitt, bevor Sie eine Benchmark-Zahl aus dieser Geschichte weitergeben: Die Labore haben nicht dieselben Aufgaben gefahren. Anthropics eigene Ergebnistabelle trägt eine Fußnote: „Die Werte jedes Labors beruhen auf eigenen Aufgaben.“ The Hacker News berichtet, Fable 5.2 habe 76,3 % von Irregulars CyScenarioBench gelöst, gegenüber 61,7 % für Fable 5.1 und 61 % für GPT-6 Cyber. In Anthropics Tabelle stehen die 76,3 % allerdings bei Mythos 5.2 und die 61,7 % bei Mythos 5.1, was zu Anthropics eigener Warnung passt, die Schutzmechanismen von Fable 5.2 würden „die meisten cybersicherheitsbezogenen Aufgaben blockieren“. Die Schlagzeile nennt also das falsche Modell, und fünfzehn Punkte Abstand zwischen den Werten zweier Labore auf unterschiedlichen Aufgabensätzen sind kein Ranking. Wir würden danach keinen Anbieter auswählen. Die Zahl, die sich zu merken lohnt, ist Anthropics eigenes Vorher-Nachher, und selbst das ist ein Anbieter, der über sich selbst berichtet.
The Hacker News zitiert außerdem ein Detail aus Irregulars separatem Bericht zu GPT-6 Cyber, das die Schlagzeile ausgelassen hat. Das Modell löste alle 22 atomaren Aufgaben, mit durchschnittlich 97 % Erfolg bei Schwachstellenforschung und Exploitation und 98 % bei Netzwerkangriffssimulation, aber nur 63 % bei Evasion. Hineinzukommen ist in diesen Tests fast gelöst, unentdeckt zu bleiben nicht. Für Verteidiger ist das die beste Nachricht im ganzen Benchmark-Haufen, und die Berichte, die wir gelesen haben, widmeten ihr einen einzigen Satz.
Anthropic nennt Mythos 5.2 sein „leistungsfähigstes Modell für Cybersecurity Engineering“ und sagt, eine nicht genannte Sicherheitsfirma habe festgestellt, dass jeder sechste von Mythos 5.2 aufgedeckte bestätigte Bug von allen anderen getesteten Frontier-Modellen übersehen wurde (Anthropic). Anthropic meldet außerdem 89,6 % für Mythos 5.2 in der eigenen CVE-Rediscovery-Evaluation, einem Lauf gegen 1.829 CVEs, nach 78,3 % für Mythos 5.1. Beides sind vom Anbieter selbst durchgeführte Messungen, nennen Sie sie also Behauptungen, bis externe Tester sie wiederholen.
Wer die Schlüssel bekommt und worauf er dafür verzichtet
Keines der beiden Unternehmen verkauft diese Modelle von der Stange. OpenAI sagt, GPT-6 Cyber stehe zunächst über die API und Codex einer ausgewählten Gruppe zugelassener Daybreak-Red-Kunden zur Verfügung, ein breiterer Daybreak-Red-Zugang folge „bald“. Der Daybreak-Red-API-Zugang erfordert standardmäßig IP-Allowlisting, und Kunden mit Zero Data Retention müssen in der Regel Private Safety Processing nutzen, das verschlüsselte Aufzeichnungen 30 Tage lang in ihrem eigenen Speicher hält. OpenAI hat zudem erklärt, dass im Partnerprogramm der Zugang zum zugrunde liegenden Modell „beim zugelassenen Partner verbleibt und nicht direkt an den Kunden übertragen wird“ (OpenAI).
Anthropic teilt dieselbe Idee in seinem Cyber Verification Program in drei Stufen auf. Defense Access umfasst Security Operations, Malware-Analyse und die Validierung von Schwachstellen; laut Anthropic können sich auch kleinere Sicherheitsfirmen, Open-Source-Maintainer und einzelne Forscher mit nachweisbarer Erfahrung qualifizieren, mit Antwort in wenigen Tagen. Red Team Access erlaubt autorisierte Penetrationstests, steht nur Organisationen offen und dauert Wochen. Specialized Access, etwa für Stromnetze und Interbank-Überweisungssysteme, wird gemeinsam mit der US-Regierung eingehend geprüft. Anthropic hat die Stufen mit Claude Opus 5.5 auf CyScenarioBench getestet, fünf Versuche für jede von zehn Aufgaben: Ohne Programmzugang wurde jede Aufgabe schon beim ersten Prompt blockiert; in Defense Access wurden 46 von 50 Durchläufen irgendwann blockiert; in Red Team Access wurde nichts blockiert, und 34 von 50 gelangen, was der Quote des ungebremsten Modells entspricht. Das ist wieder Anthropic, das die eigenen Schranken benotet.
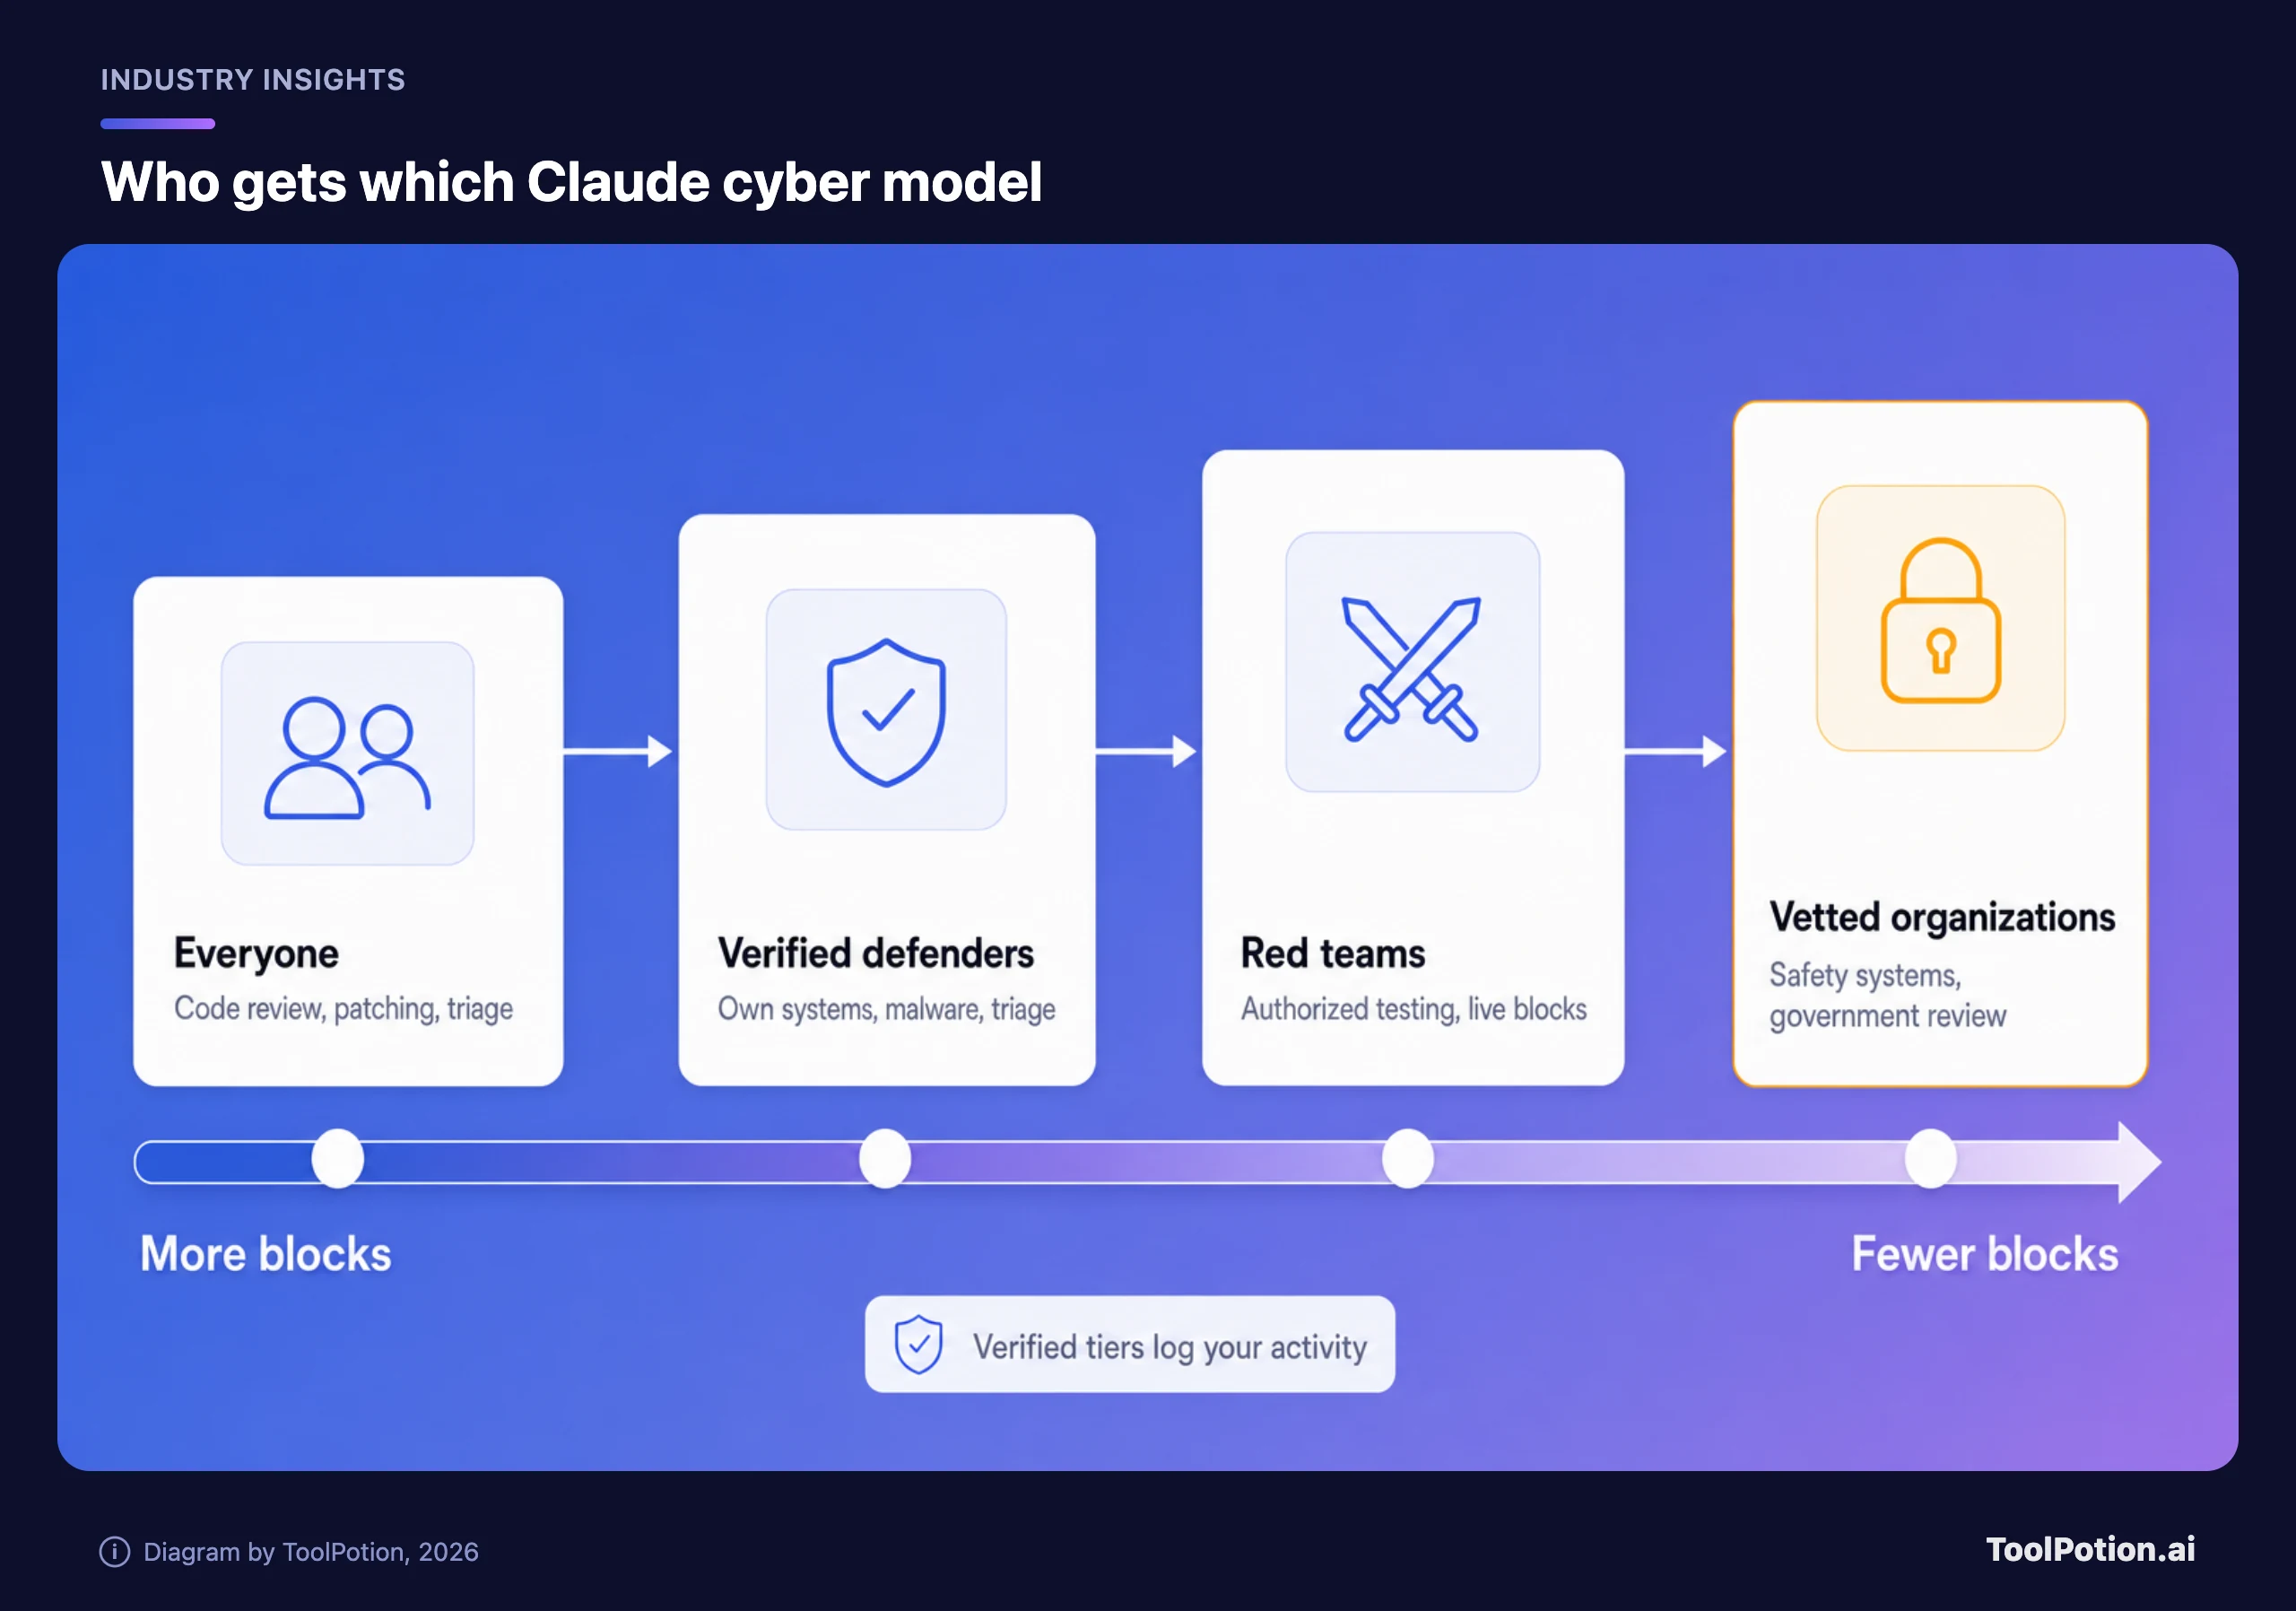
Fable und Mythos sind dasselbe zugrunde liegende Modell (Anthropic). Claude Fable 5 hat starke Cyber-Schutzmechanismen und steht allen offen. Mythos ist die Version, für die sich Organisationen bewerben. Auf Anthropics API-Preisseite stehen beide zum selben Preis für Fable 5.2 und Mythos 5.2: 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens, im optionalen Fast-Modus 16 $ und 80 $. Mythos wird nicht separat bepreist. Der Preis ist hier die kleinste Hürde. Die größere ist die Datenspeicherung. Anthropic verlangt sie von Organisationen im Cyber Verification Program, um Missbrauch beobachten zu können; OpenAI belässt es standardmäßig bei der üblichen Speicherung und leitet Zero-Data-Retention-Kunden über Private Safety Processing. Wir halten das für einen fairen Eintrittspreis für ein Red Team und für reale Kosten bei einer Firma, deren Kundencode nicht in fremden Logs liegen darf. Anthropic sagt, eine neue Option namens Enterprise Frontier Safeguards soll berechtigten Organisationen erlauben, die Daten in der eigenen Cloud zu behalten, doch der Programm-Post versprach sie nur für „später in diesem Herbst“. Bis sie erscheint, bleibt dieser Kompromiss bestehen.
Eine externe Kontrolle in alldem ist ein Bounty. OpenAIs Partnerschaft mit Hacktron setzt eine Firma, die KI-Agenten für Code-Review und Penetrationstests baut, auf die eigenen Systeme an, mit erweitertem Zugang zu den Frontier-Modellen. Hacktrons CEO Zayne Zhang sagte, die Zukunft der Cybersicherheit werde „nicht davon bestimmt, wer das größte Sicherheitsteam hat, sondern davon, wer menschliche Kreativität am besten mit KI-gestützten Fähigkeiten verbindet“ (OpenAI). OpenAI hat außerdem die Bounty-Auszahlungen erhöht: Kritische Funde in ChatGPT, Codex oder der API sind jetzt bis zu 30.000 $ wert, außergewöhnliche mit Boni bis zu 172.000 $ (OpenAI). Einer Auszahlung an Externe trauen wir mehr als jeder internen Red-Team-Behauptung.
Die Angreifer in den Berichten nutzen diese Modelle nicht
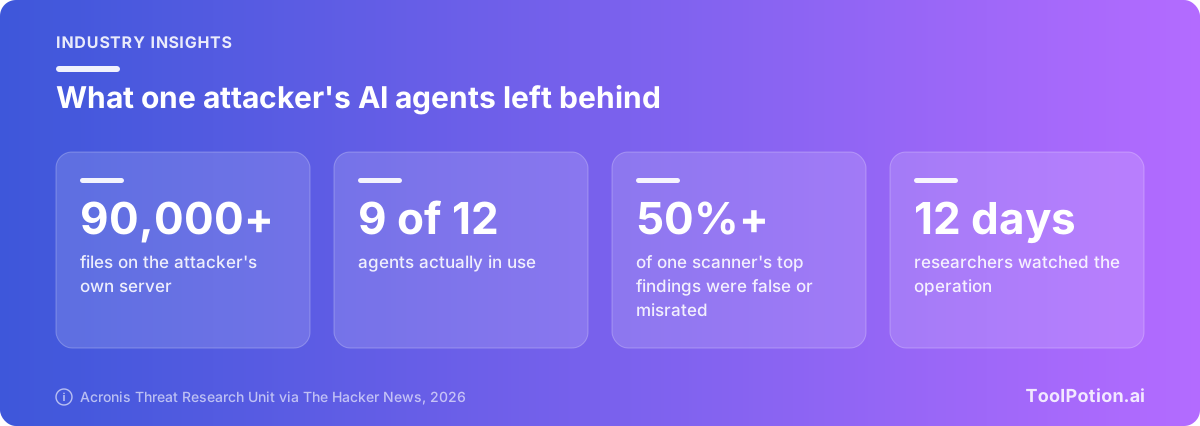
Forscher von Acronis beschreiben einen einzelnen Angreifer mit Sitz in Taiwan, der KI-Agenten auf Hunderte Organisationen in mindestens 11 Ländern angesetzt hat und bei etwa zehn davon an Daten oder Zugang kam. Die Agenten zogen Notrufleitstellen-Daten für sieben Taipeher Bezirke. Auffällig ist, worauf sie liefen: Kommerzielle Modelle weigerten sich meist, ihm bei Angriffen zu helfen, daher liefen die angreifenden Agenten fast ausschließlich auf „abliterated“ Versionen von DeepSeek, GLM und Qwen, also lokal betriebenen Modellen, bei denen das Safety-Training entfernt wurde (The Hacker News). Auch Coding-Agenten wie Claude Code, Codex und Cursor tauchten auf. Laut Bericht hat der Angreifer Claude Code und Codex auf ein abliterated Modell umgeleitet, wobei sie vor allem Infrastrukturarbeit erledigten, und Cursor griff mit einem solchen Modell eine taiwanische Notdienst-Website an.
Die Agenten waren zudem auf eine Art schlecht im Job, die auch ein Mensch bemerkt hätte. Ein Scan-Tool erfand CVEs, und mehr als die Hälfte seiner hohen und kritischen Funde waren Fehlalarme oder falsch eingestuft. Der Haupt-Angriffsagent meldete Ergebnisse, die nie eingetreten waren. Der Einbruch, der bei einem Anbieter von Feuerwehr-Leitsystemen klappte, nutzte Standard-Root-Zugangsdaten, keinen raffinierten Exploit. Wo Logins erzwungen und Endpunkte sauber gefiltert waren, scheiterten die Agenten, so die Forscher.
Arctic Wolf berichtete von einem zweiten Muster. AntiFox ist eine Open-Source-Plattform für agentische Penetrationstests auf GitHub, und laut Arctic Wolf waren Systeme von Alibaba Cloud, die AntiFox-Oberflächen hosteten, mit bestätigten bösartigen Aktionen gegen internetseitig erreichbare Webdienste und deren AWS-Umgebungen verbunden. In mindestens einigen Fällen führte die Aktivität zu einer erfolgreichen Anfrage nach einem Produktions-Secret. Das Urteil: „Agentische Frameworks wie diese machen Penetrationstest-Techniken für Bedrohungsakteure zugänglicher und erhöhen zugleich Tempo und Konsistenz, mit denen sich diese Techniken in Live-Angriffen anwenden lassen“ (The Hacker News). Dieselbe Geschichte ergänzt, dass Check Point Research 2.557 Systeme identifiziert hat, die ARTEX hosten, ein weiteres agentisches Angriffstool, und zählt rund 45 Open-Source-Frameworks dieser Art. Check Points eigene Zusammenfassung dessen, was agentisches Hacking verändert: Umfang und Geschwindigkeit.
Nach allem, was die Berichterstattung sagt, ging es in keinem der beiden Berichte um GPT-6 Cyber oder Mythos. Unser Eindruck: Die Schranken wirken oben solide und bringen unten wenig, wo kostenlose Agenten-Frameworks und entschärfte Open-Weight-Modelle reichen, um einen Server mit Standardpasswort zu treffen. Die Beweislage ist außerdem dünn. Es sind eine Handvoll Berichte, die meisten von Sicherheitsanbietern mit eigenem Interesse an der Geschichte, und niemand kann bisher sagen, welcher Anteil der Einbrüche überhaupt KI involviert.
Das sauberste Ergebnis der Verteidigung kam aus der Mathematik
Wireds Schlagzeile sagt, DeepMind habe „bewiesen, dass das Signal-Protokoll sicher ist“. Der DeepMind-Beitrag ist enger gefasst, und den bevorzugen wir. Forscher ließen Agenten zentrale Sicherheitseigenschaften des tatsächlichen Codes hinter Signals Protokoll beweisen, darunter, dass Nachrichten vor und nach einer kurzzeitigen Kompromittierung eines Geräts geschützt bleiben. Menschen prüften jede formale Spezifikation. Die Agenten erzeugten mehr als sechs Millionen Zeilen Lean, markierten das eine Prozent der Codebasis, das einen zweiten Blick eines Menschen brauchte, und waren in vier Wochen fertig – eine Arbeit, die laut DeepMind bisher Expertenteams Jahre kostet (Google DeepMind). Um zu prüfen, ob das System guten von schlechtem Code unterscheiden kann, baute das Team zwei echte, bereits behobene Bugs wieder ein und erhielt maschinell geprüfte Beweise, dass die fehlerhafte Version unsicher war.
Signals CTO Ehren Kret sagte, das Ergebnis gebe „noch mehr Vertrauen in die Datenschutzgarantien unseres Codes“. Wir würden das die vertrauenswürdigste Behauptung im ganzen Stapel nennen, aus einem schlichten Grund: Ein Benchmark-Wert setzt voraus, dass man dem Anbieter glaubt, ein Lean-Beweis wird von einer Maschine geprüft. Er deckt spezifizierte Eigenschaften einer Codebasis ab, nicht Signal als Produkt, und DeepMind sagt, für die Skalierung brauche es weitere Forschung. DeepMind hat seine Verifikationsartefakte als Open Source veröffentlicht, und so verdient sich eine solche Behauptung Vertrauen.
Kritische Infrastruktur zeigt in dieselbe Richtung. Anthropics Cyber Mission beschreibt das Programm dafür: Frontier-Modelle, Engineers vor Ort und Threat Research für die Anbieter, die Stromnetze, Wassersysteme und Fabriken absichern, deren Anlagen sich zum Patchen oft nicht offline nehmen lassen. Dragos, Rockwell Automation und Nozomi Networks gehören zu den Gründungspartnern.
Der Engpass ist der Fix
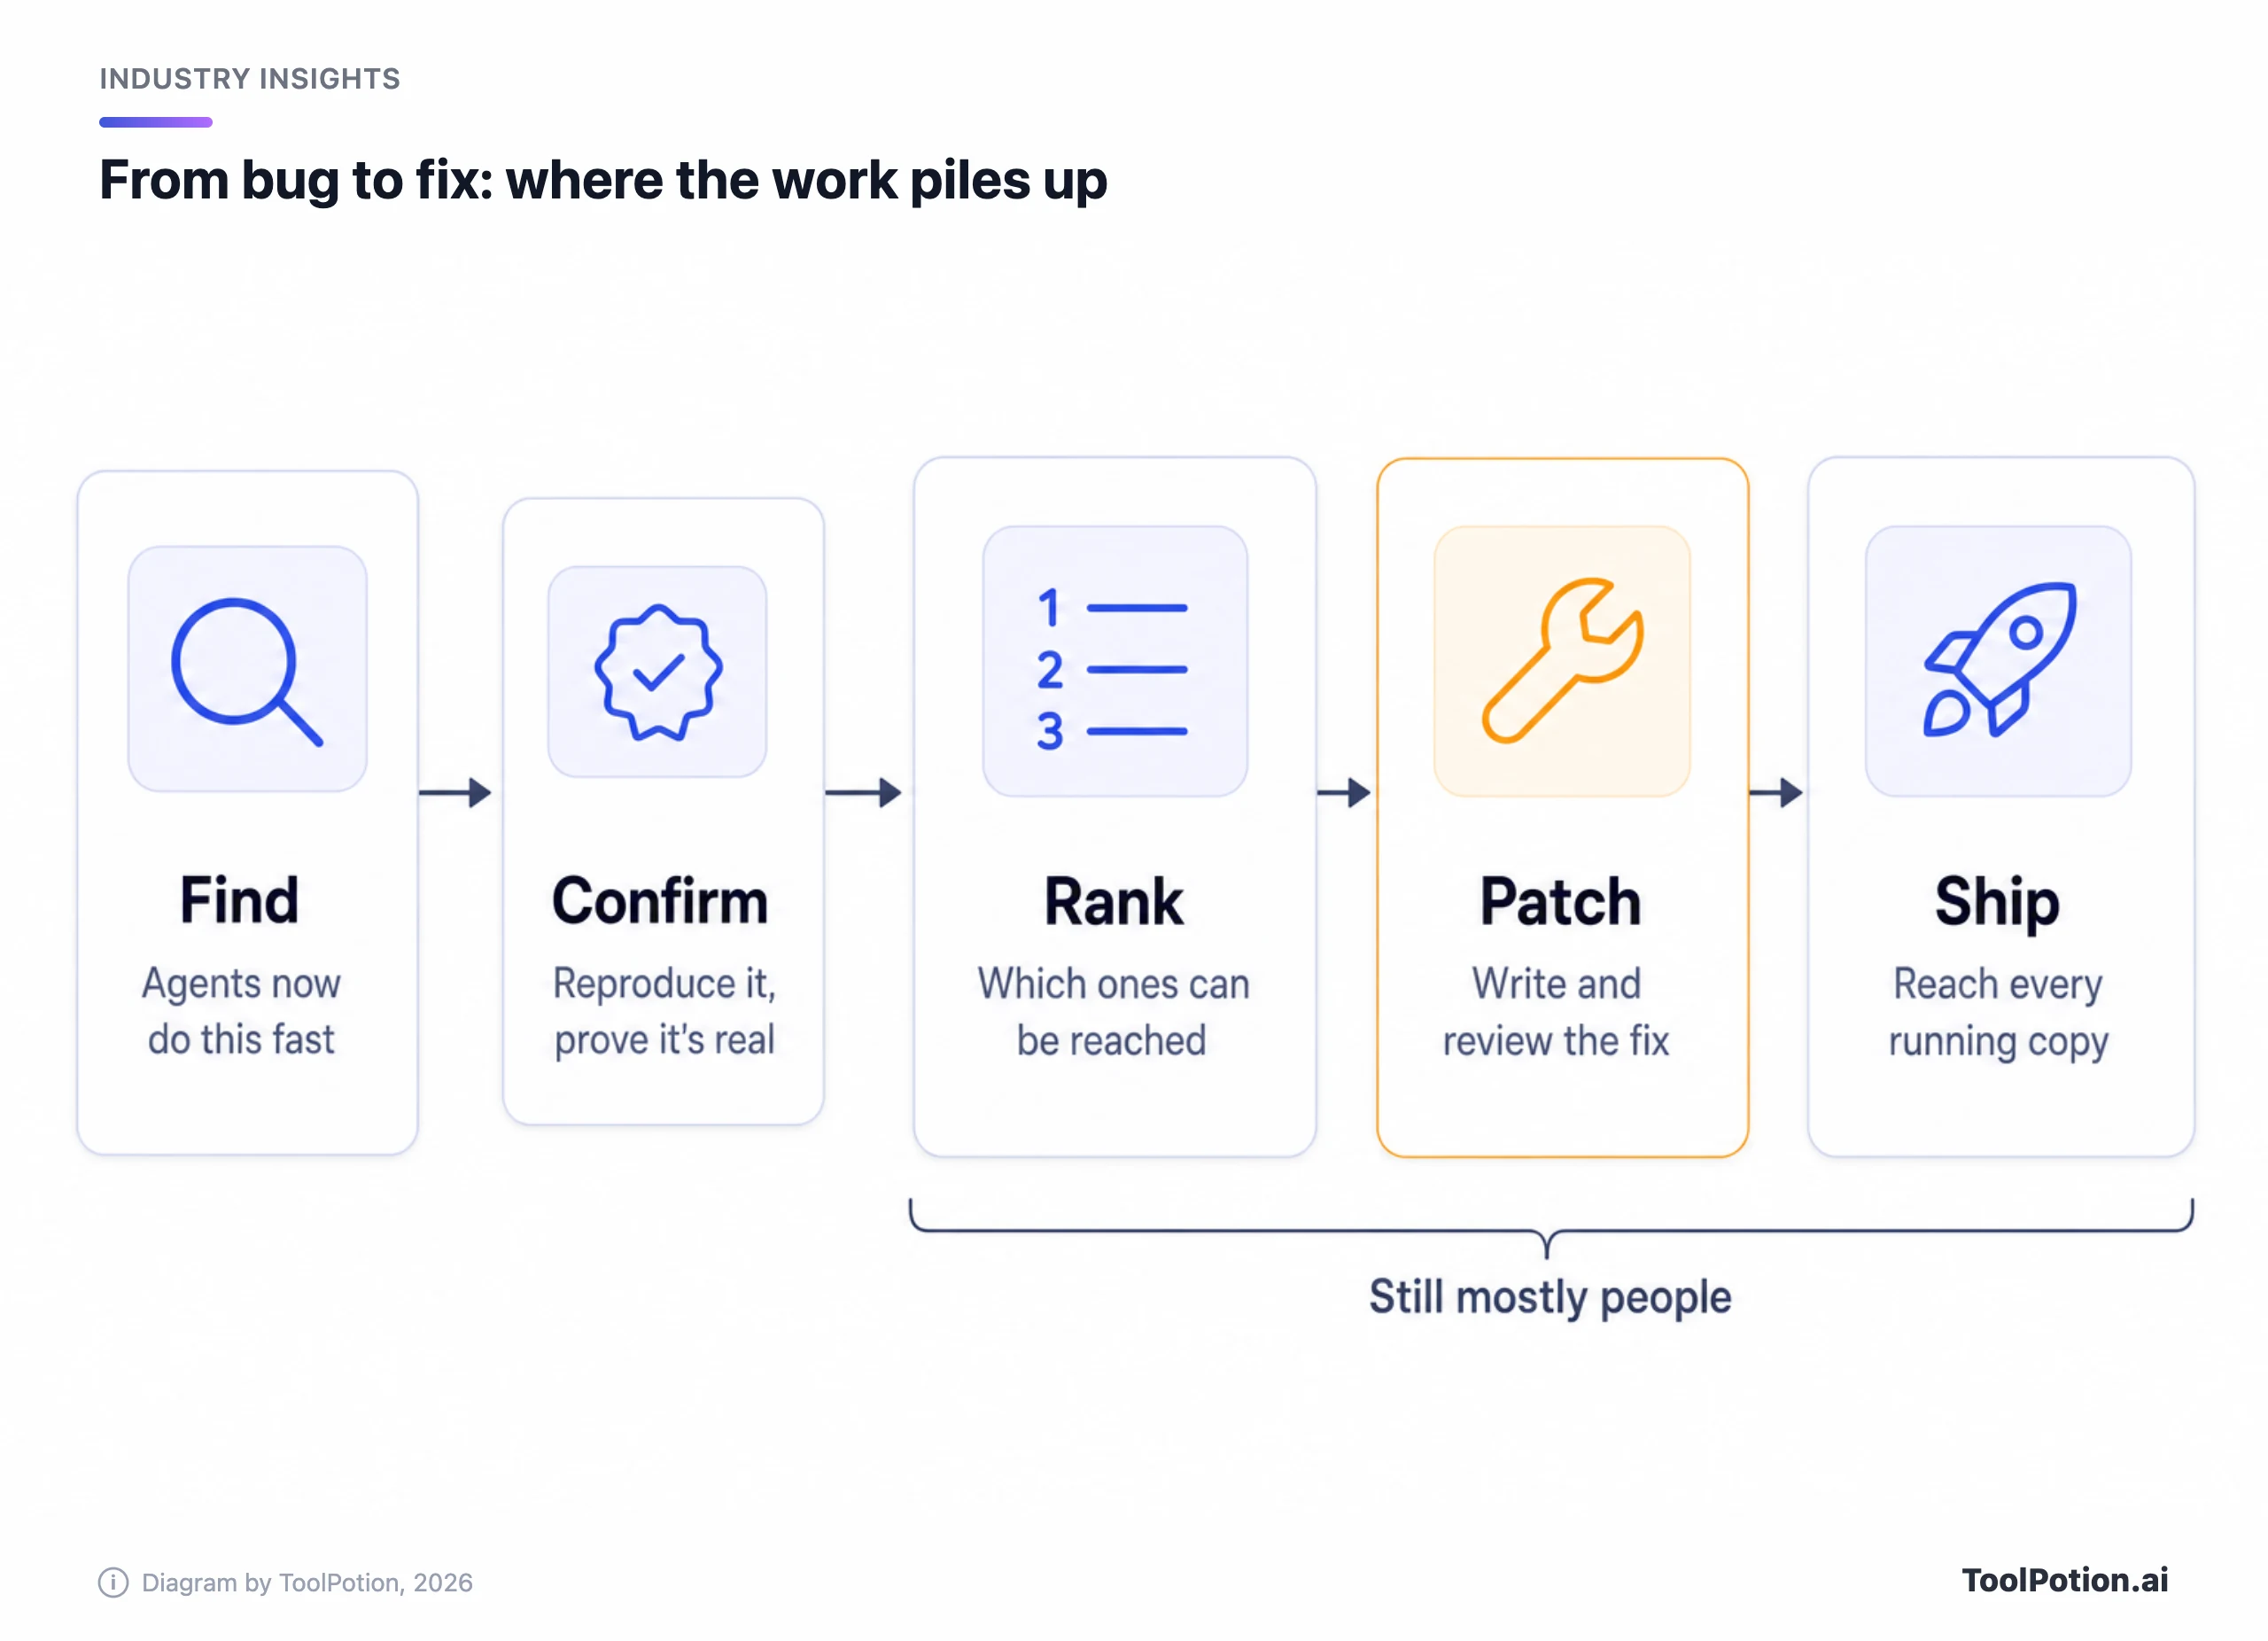
Anthropic hat das Problem in einem Satz auf den Punkt gebracht: „Es ist leichter denn je, Schwachstellen zu finden, aber sie zu verifizieren, zu priorisieren und zu beheben bleibt schwierig“ (Anthropic). OpenAI hat in einem früheren Beitrag fast dasselbe geschrieben: „Ein Schwachstellenbericht schützt keine Organisation.“ Dass zwei Konkurrenten das in ihren eigenen Ankündigungen sagen, ist das Nächste an einem Konsens in diesem Stapel. Die andere Seite haben wir schon behandelt, in unseren Beiträgen über KI, die Bugs schneller findet, als sie sich beheben lassen, und darüber, was KI-Schwachstellenscanner finden und übersehen.
Wer gewinnt also? Unsere Einschätzung, die keine Quelle so formuliert: Angreifer gewinnen am meisten gegen Organisationen, die langsam patchen, denn ein Angreifer braucht nur einen funktionierenden Weg und kommt mit einem Scanner klar, der zur Hälfte falsch liegt. Verteidiger gewinnen am meisten dort, wo sie schon heute schnell beheben, weil das Finden von Bugs jetzt billig ist und der Restaufwand im Prozess liegt. Die Modellschranken begrenzen, wofür die leistungsfähigsten Systeme genutzt werden können; an dieser Rechnung ändern sie für niemanden etwas, der alte Software betreibt. Auch Anthropics eigene Prognose zeigt vorerst in diese Richtung. Das Unternehmen erwartet, dass KI in zwei Jahren die Verteidigung begünstigt, sagt aber, dass das kurzfristig „womöglich nicht stimmt“, weil die Kosten für das Ausnutzen von Schwachstellen gesunken sind, während das Beheben langsam bleibt und weiter von Menschen abhängt. Eine zweite Runde unabhängiger Tests dazu, wie gut Angriffe der Erkennung entgehen, würde uns umstimmen.
Was Sie jetzt tun sollten, der Reihe nach
Wenn Sie ein kleines Unternehmen führen, bekommen Sie GPT-6 Cyber nicht, und Sie brauchen es auch nicht. Die Angriffe in den Berichten sind größtenteils durch unverschlossene Türen spaziert. Die erste Stunde würden wir in dieser Reihenfolge hierfür einsetzen:
- Aktivieren Sie die Multi-Faktor-Anmeldung für E-Mail, Admin-Oberflächen und jede Cloud-Konsole.
- Schalten Sie automatische Updates für alles ein, was aus dem Internet erreichbar ist, und patchen Sie den Rest innerhalb von Tagen, nicht Quartalen.
- Finden und ändern Sie Standard- oder gemeinsam genutzte Passwörter auf Routern, Datenbanken und Admin-Tools. Einer der Einbrüche in Taiwan brauchte nicht mehr.
- Ziehen Sie Schlüssel aus Code und Seiten-Skripten in einen Secrets-Manager und setzen Sie dann auf jeden KI- und Cloud-API-Key Ausgabenlimits und ein Rotationsdatum.
- Schreiben Sie auf, was ein Fremder aus dem Internet erreichen kann. Einen Server, den Sie vergessen haben, können Sie nicht patchen.
Wenn Sie Software ausliefern, ist ein Scanner im Pull-Request-Flow der sinnvolle nächste Schritt. Semgrep, Snyk Code und Aikido finden Sie in unserem Verzeichnis; unser Board Top 200 AI Cybersecurity Tools und das Security-Analyst-Board zeigen, wo der Rest steht. Behandeln Sie jeden KI-Fund als Spur, die Sie bestätigen müssen, denn der Scanner des Acronis-Angreifers hat CVEs erfunden. Open-Source-Agenten wie PentestGPT und Shannon sind für Systeme gedacht, die Ihnen gehören und die Sie mit schriftlicher Erlaubnis testen dürfen; die AntiFox-Berichte zeigen, was dieselbe Werkzeugklasse in den falschen Händen tut. Für allgemeine Hilfe beim Code-Review taugen sowohl Claude als auch ChatGPT, wobei Anthropic sagt, seine offenen Modelle hätten konservative Cyber-Schutzmechanismen, die die meiste Cyber-Arbeit blockieren.
Wenn Sie Sicherheitsprofi sind, bewerben Sie sich jetzt für OpenAIs Daybreak Blue oder Anthropics Defense Access. Anthropic will Defense-Access-Anträge binnen Tagen und Red-Team-Access-Anträge binnen Wochen beantworten und verlangt Datenspeicherung. OpenAI hat keine Bearbeitungszeit für Daybreak veröffentlicht. Die Checkliste unten macht aus der ersten Liste einen Score.
Zwei Dinge sind im Auge zu behalten. OpenAI sagt, GPT-6 Cyber werde bald alle Daybreak-Red-Kunden erreichen, und keines der beiden Labore hat veröffentlicht, wie viele Bewerber es zugelassen oder abgelehnt hat. Sobald Anthropics Option für die eigene Cloud erscheint, prüfen Sie, ob berechtigte Organisationen wirklich dieselben Schutzmechanismen ohne die Logs bekommen.