

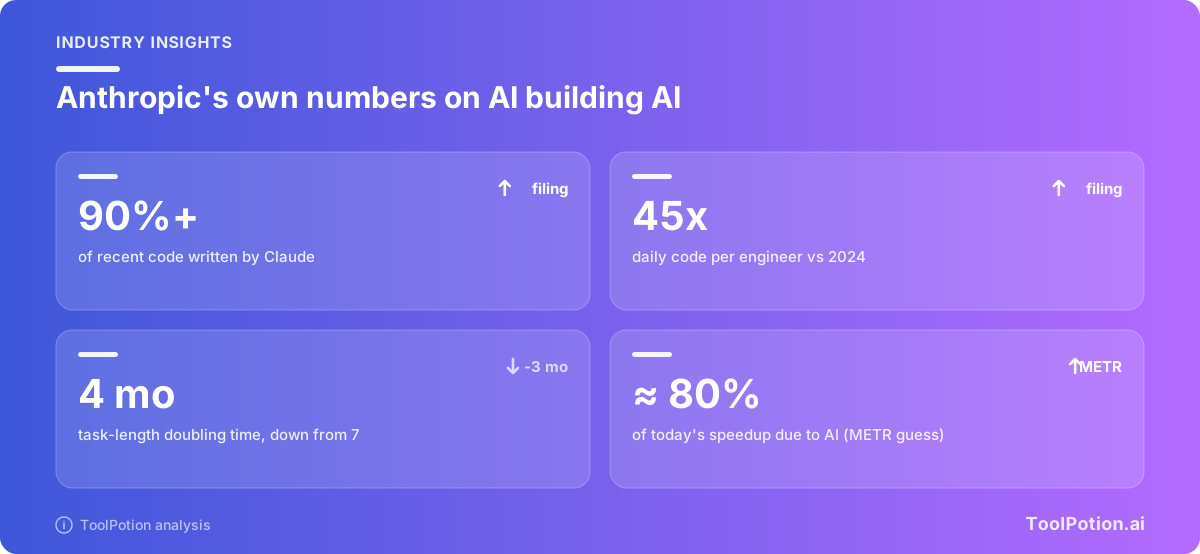
Über 90 % der Beiträge zur Codebasis von Anthropic wurden in dem jüngsten Monat, den die überarbeitete IPO-Einreichung abdeckt, von Claude geschrieben. Das ist die eigene Zahl des Unternehmens (SEC-Filing), und sie ist das am wenigsten dramatische Detail in dem Dokument.
Tief in den Risikofaktoren steht der Satz, der es in die Nachrichten geschafft hat: Laut internen Schätzungen von Anthropic könnte das Unternehmen die Definition der Responsible Scaling Policy für dramatisch beschleunigten, KI-getriebenen Fortschritt „bald erreichen" („may imminently meet"). TechCrunch machte daraus die Schlagzeile, Anthropic warne, man sei „sehr nah an RSI-Fähigkeit" (TechCrunch). Wir halten die Warnung für real, die Schlagzeile für eine Nuance lauter als das Filing, und die Menschen, die es am meisten betrifft, werden nie einen Abschnitt über Risikofaktoren lesen.
Rekursive Selbstverbesserung, ganz ohne Science-Fiction
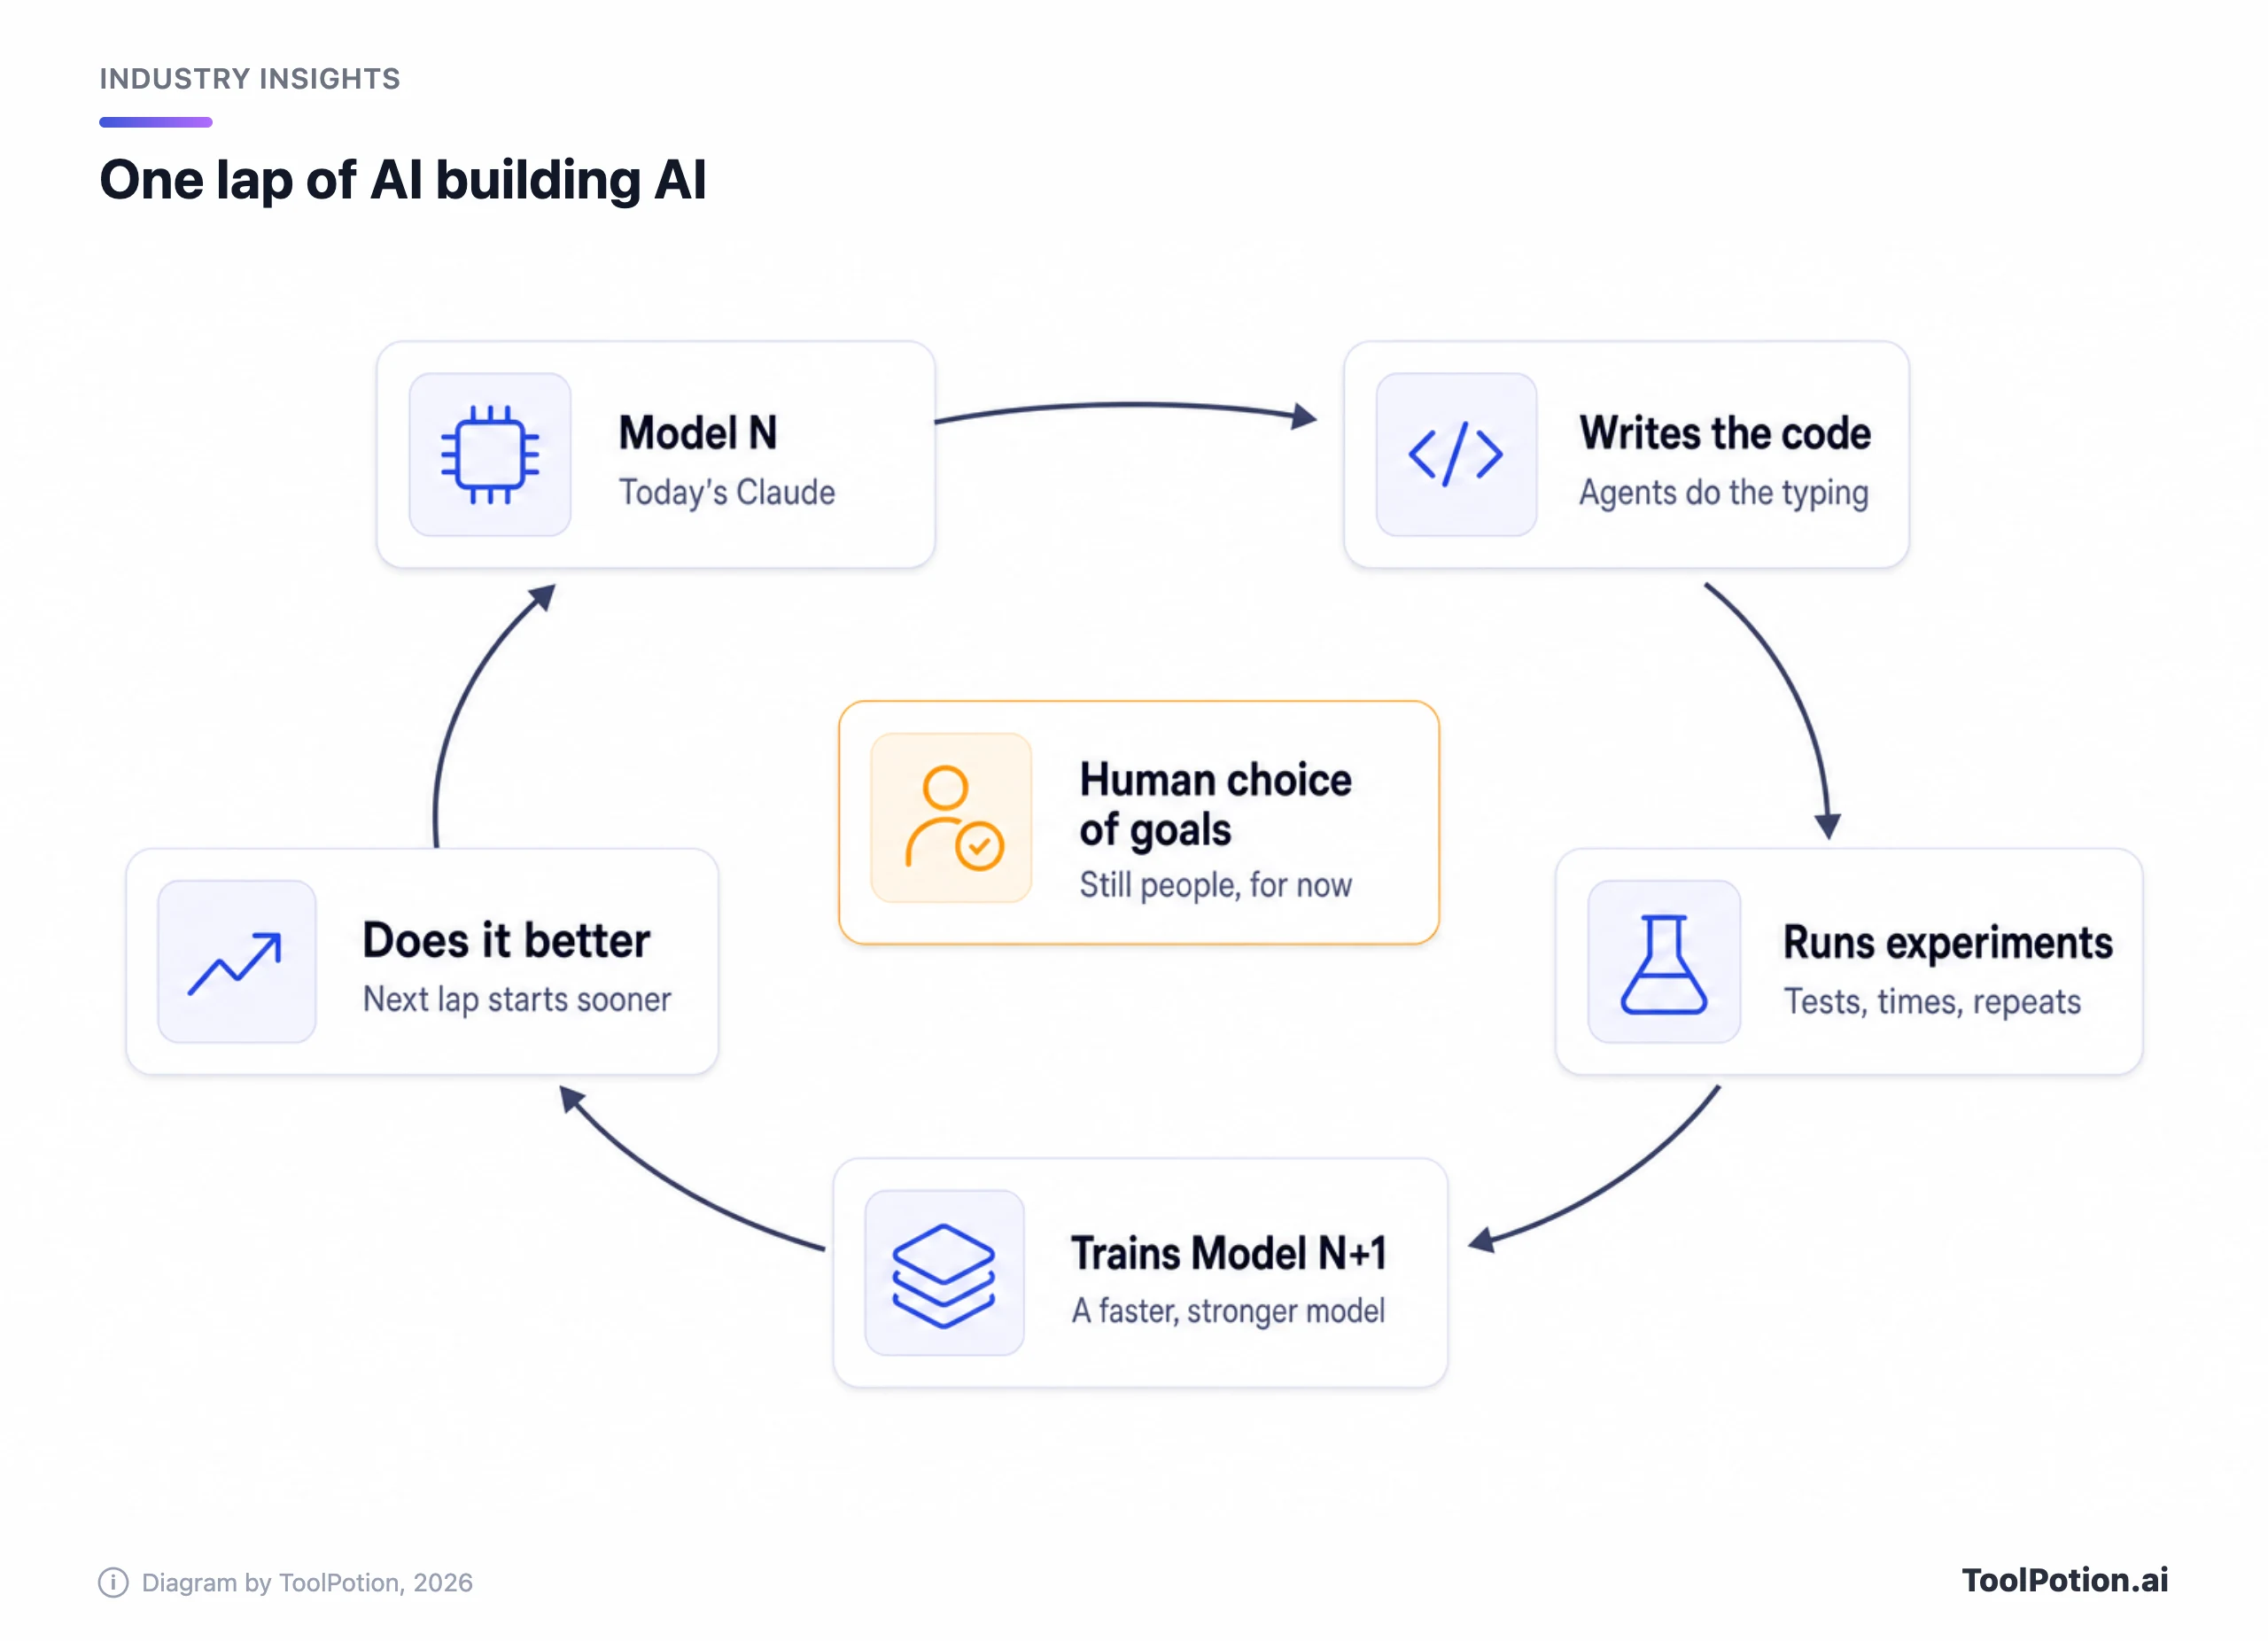
Rekursive Selbstverbesserung (RSI) ist eine Schleife. Ein KI-System hilft dabei, das nächste KI-System zu bauen, das wiederum besser darin ist, das übernächste zu bauen. Anthropics eigene Definition lautet: „ein KI-System, das in der Lage ist, seinen Nachfolger vollständig autonom zu entwerfen und zu entwickeln" (Anthropic Institute).
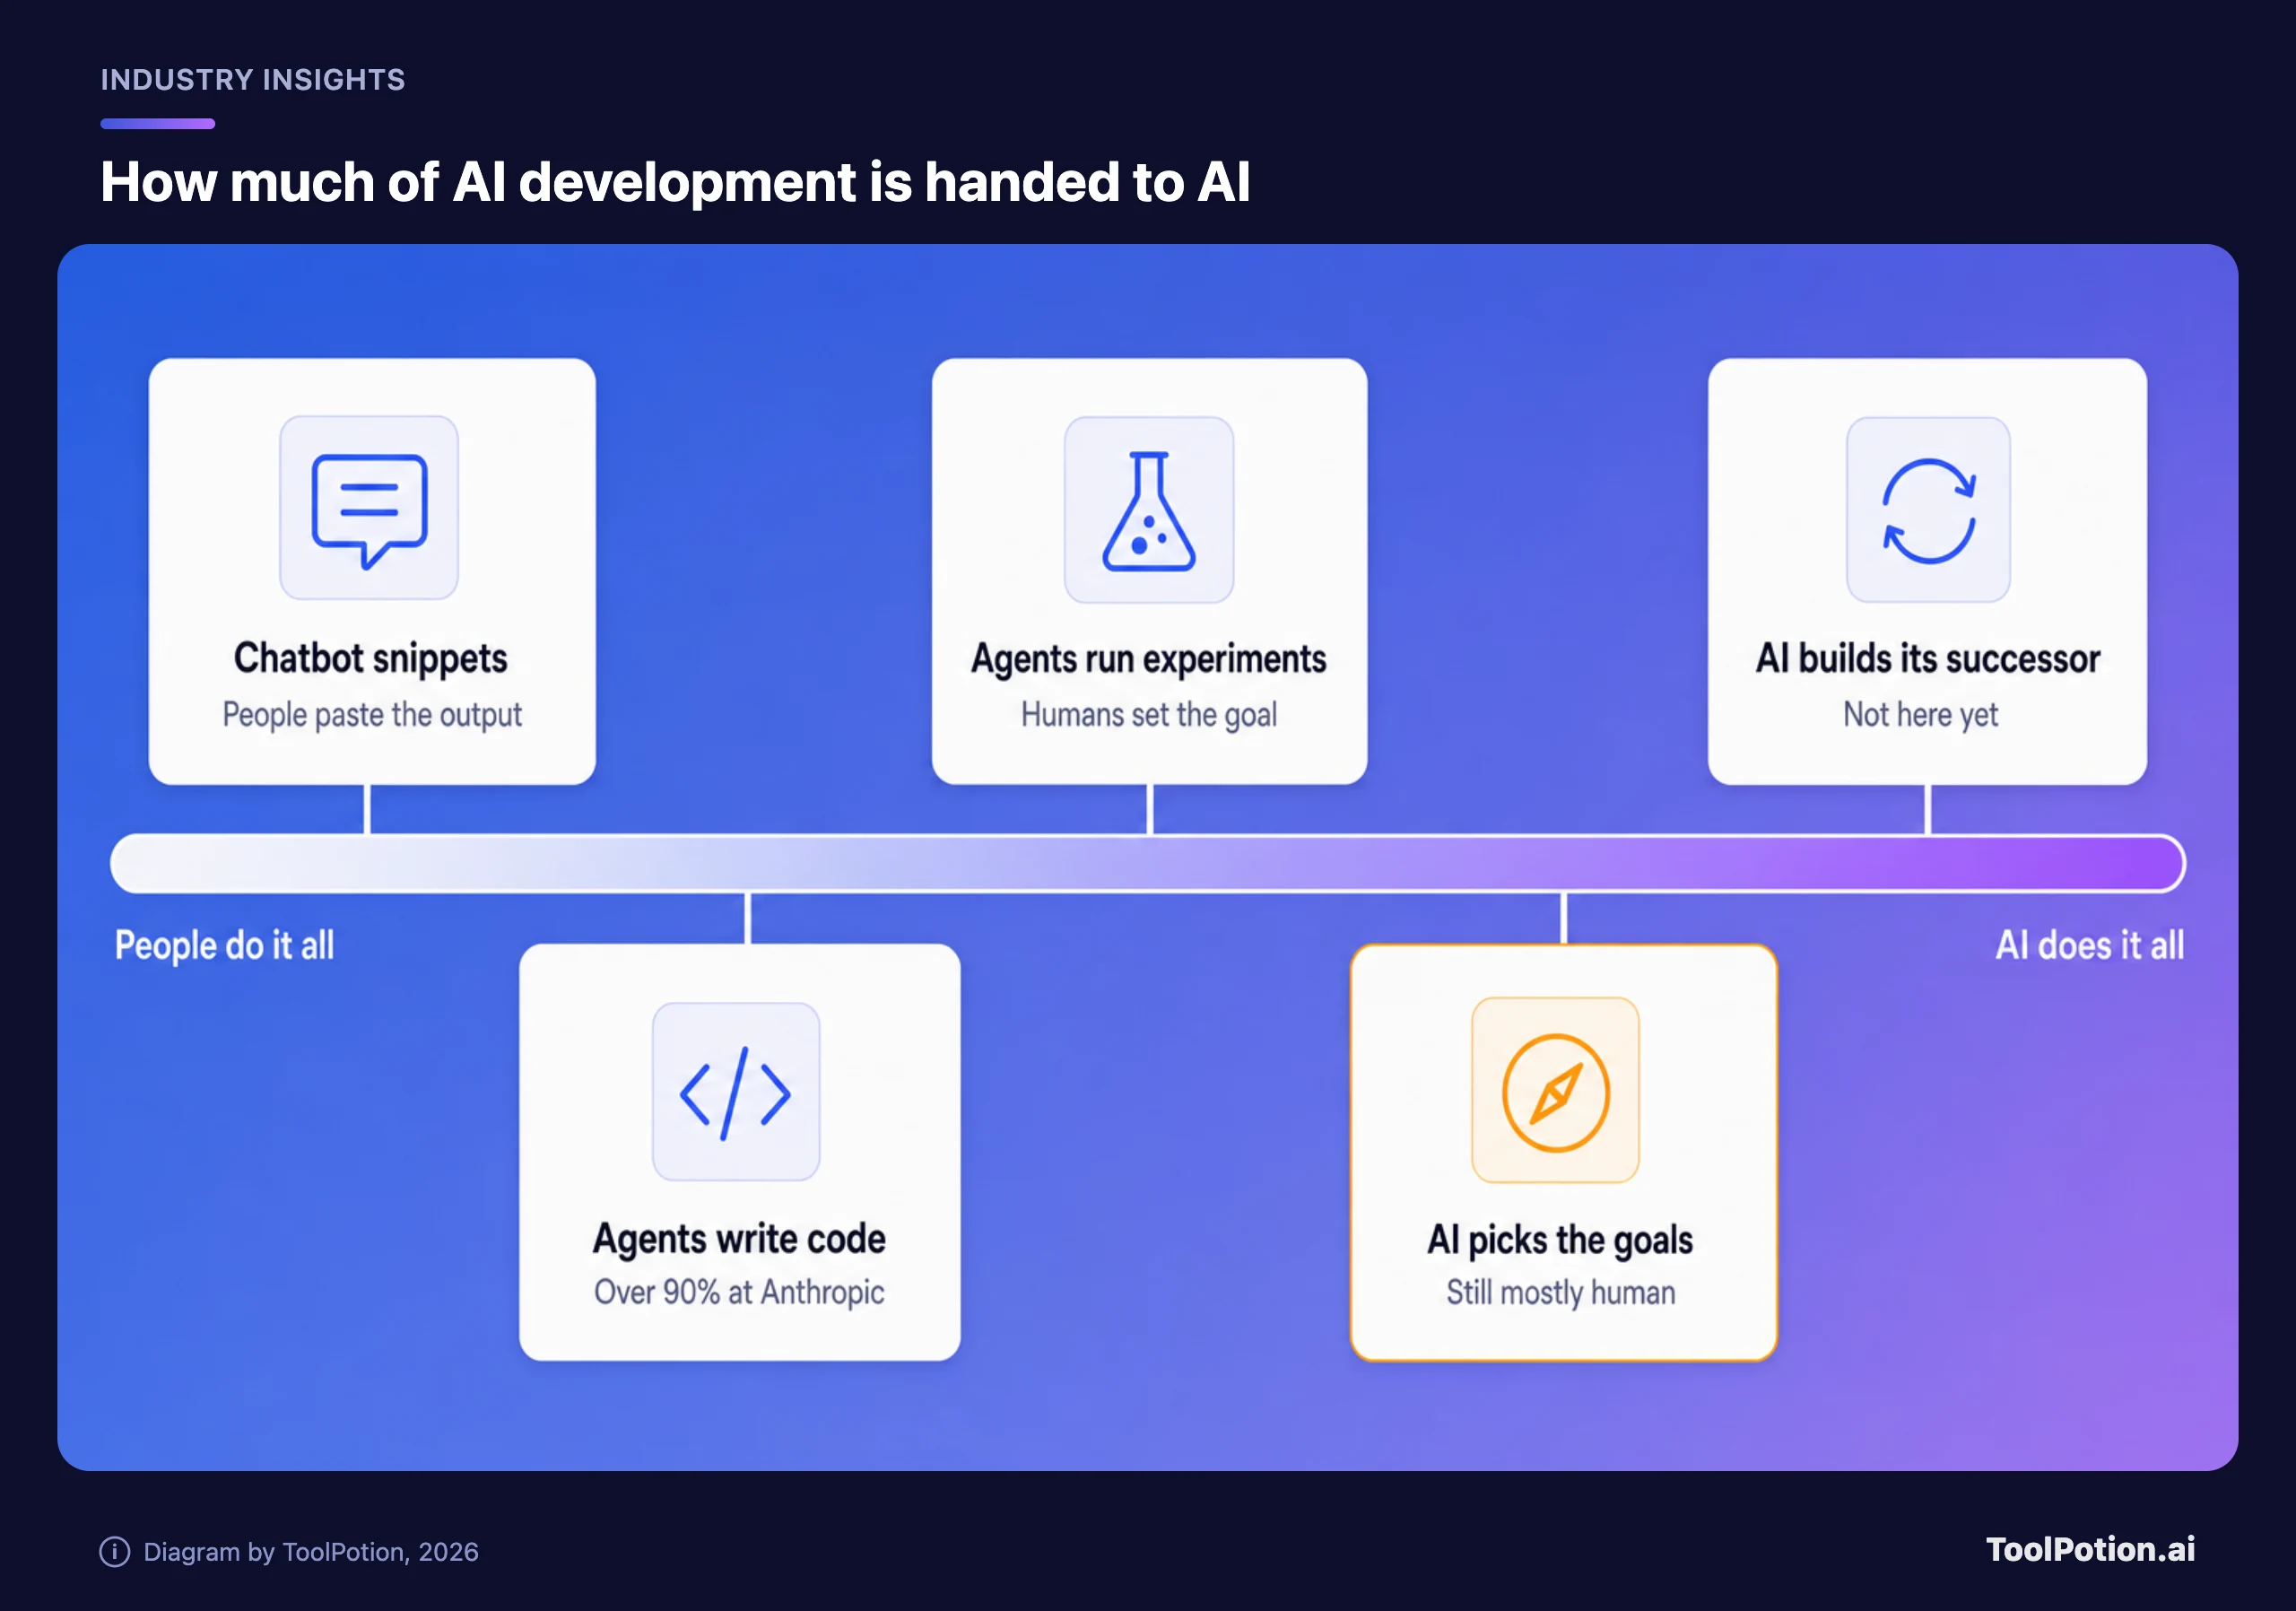
Niemand behauptet, die Schleife sei geschlossen. Heute setzen Menschen die Ziele, und die KI übernimmt einen wachsenden Teil der Arbeit: Claude Code schreibt und führt Code aus, Agenten reichen stundenlange Arbeit an andere Agenten weiter, und laut Anthropic kann Claude ein klar spezifiziertes Experiment bereits so gut oder besser durchführen als erfahrene Menschen. Die Lücke, die das Unternehmen benennt, ist das Urteilsvermögen. In seinen Worten: „Bei der Frage, wie Claude Urteilsvermögen bei der Wahl von Zielen ausübt, bestehen weiterhin große Leistungslücken."
Auch externe Belege weisen in dieselbe Richtung. Laut Anthropics Beitrag verdoppelt sich die Länge der Aufgaben, die eine KI eigenständig erledigen kann, etwa alle vier Monate, zuvor alle sieben, und Claude Opus 4.6 bewältigte Aufgaben, für die ein Mensch etwa zwölf Stunden braucht (Anthropic Institute). Wenn das so weitergeht, rücken Aufgaben, die eine Fachkraft tagelang beschäftigen, bald in Reichweite. Wir würden die Trendlinie eines Anbieters als Behauptung behandeln, allerdings zitiert derselbe Beitrag METR, das diesen Benchmark betreibt, mit dem Befund, dass Claude Mythos Preview mindestens 16 Stunden arbeiten konnte.
Warum also sollte das jemanden den Schlaf kosten? Tempo und Kontrolle. Wenn jeder Durchlauf der Schleife schneller ist als der vorherige, werden die Menschen, die die Arbeit prüfen sollen, zum langsamen Teil, und Kontrollen, die Monate dauerten, werden zusammengedrückt. Anthropics eigener Beitrag sagt, volle RSI „könnte das Risiko erhöhen, dass Menschen die Kontrolle über KI-Systeme verlieren". Er sagt aber auch: „Wir sind noch nicht so weit, und rekursive Selbstverbesserung ist nicht unvermeidlich." Beide Sätze stehen im selben Absatz, und wir würden beide im Hinterkopf behalten.
Was im Filing steht und was die Schlagzeilen hinzugefügt haben
Der Wortlaut des Filings ist enger gefasst als die Berichterstattung. Anthropic schreibt, „unsere internen Schätzungen und unsere Erwartungen an künftige Modelle, nicht an unsere aktuellen Modelle", deuteten darauf hin, dass man die Definition der Policy von „dramatisch beschleunigtem Fortschritt, der auf KI zurückzuführen ist" „bald erreichen könnte" („may imminently meet"). Dann folgt der Satz, den die Schlagzeilen übersprungen haben: „Wir haben keines unserer aktuellen Modelle als Modell eingestuft, das diese Schwelle überschreitet, und wir bewerten die zugrunde liegenden Daten weiter" (SEC-Filing). Weiter heißt es im Filing, Anthropic „bewerte die Auswirkungen des Erreichens der Schwelle für KI-Forschungs- und Entwicklungsfähigkeiten".
Manche Medien schrieben, der Alarm sei ausgelöst worden. Genau genommen hat Anthropic das nicht erklärt. Dieser Unterschied ist in Worten klein und in Policy-Begriffen größer. In der aktuellen Policy (Version 3.4, die genau diese Schwelle überarbeitet hat) gilt ein Modell, das die Grenze zur automatisierten F&E überschreitet, als „hochleistungsfähig", und jeder wesentlich geschwärzte Risikobericht zu einem solchen Modell erfordert eine vollständige externe Prüfung (Policy-Seite). Die ältere Formulierung „AI R&D-4" ist im aktuellen Text nicht mehr enthalten. Ein Detail spricht für die Formulierung des Filings: Laut Policy ist die Schwelle erreicht, wenn Anthropic eine Verdopplung der Fortschrittsrate „beobachtet oder erwartet", die plausibel auf automatisierte Forschung zurückgeht. Erwartung zählt, „bald erreichen könnte" ist also keine Übertreibung.
Der offenste Satz ist ein anderer. Anthropic sagt, man habe „in der Vergangenheit eine erhebliche Beschleunigung der eigenen Entwicklungsgeschwindigkeit nicht erkannt und werde sie in Zukunft möglicherweise nicht erkennen, bevor sie eingetreten ist". Das ist das Eingeständnis, dass der Alarm nachlaufende Indikatoren auswertet. Wir sehen lieber, dass ein Unternehmen das offen ausspricht, als dass es das verschweigt, und wir wären lieber, die Policy hinge nicht davon ab.
Und die Zusagen? Anthropic schreibt, man gehe nicht davon aus, Claude „sicher einsetzen zu können, um aufeinanderfolgende Generationen von Frontier-Modellen vollständig autonom und ohne sinnvolle menschliche Aufsicht oder Verständnis zu entwerfen und zu bauen". Die Lösung: Man „erwäge Aktualisierungen" der Policy, „um Menschen die Kontrolle über die Entwicklung von Frontier-Modellen zu erhalten". Erwägen ist keine Regel. Solange das Update nicht veröffentlicht ist, gibt es für das Versprechen keinen Text, an dem man es prüfen könnte.
METR hat nachgezählt und konnte nur einen Teil seiner Arbeit zeigen
METR ist eine gemeinnützige Organisation, die Frontier-Modelle evaluiert. Der Bericht deckt eine elfwöchige Untersuchung ab, durchgeführt von rund zweieinhalb Vollzeitäquivalenten, auf Geräten von Anthropic und mit ungewöhnlich breitem Zugriff auf interne Daten (METR). Es war nicht die Vereinbarung mit „mitarbeiterähnlichem Zugang", die Anthropic separat beschrieben hat und für die es nach eigener Aussage sechs METR-Mitarbeitende eingearbeitet hat (Anthropic). METR sagt, dieses Projekt sei eine andere, lockerere Zusammenarbeit gewesen.
Das zentrale Ergebnis: Die Benchmark-Werte von Anthropic auf dem internen Capability-Index wachsen seit Ende 2025 etwa 1,9-mal schneller als zuvor, bei einem 95-%-Konfidenzintervall von 1,5 bis 2,8. Das entspricht grob zwei Jahren historischem Fortschritt in einem. Die meisten METR-Mitarbeitenden im Projekt glauben inzwischen, dass Anthropic seine Modelle bei klar spezifizierten Aufgaben etwa doppelt so schnell verbessert wie früher, und würden sich auch über 1,3 oder 3 nicht wundern. Sie schätzen, dass eine Mehrheit, vielleicht 80 %, der aktuellen Beschleunigung auf KI zurückgeht, und sind sicher, dass sie nicht von schnellerem Wachstum der Trainingsrechenleistung kommt.
Was METR nicht gefunden hat, ist für die Einordnung des Rests wichtig. Es hat keine Autonomie gefunden. KI sei „noch nicht in der Lage, hochbedeutsame und vollständig autonome Beiträge zu den wichtigsten Teilen des Modelltrainings zu leisten", auch wenn Forschende von „Lebenszeichen" sprachen. Und es hat keine Bremse gefunden: keinen überzeugenden Engpass bei Algorithmen, Rechenleistung oder Daten in den nächsten zwölf Monaten, mit dem Vorbehalt, dass sich das eigene Verständnis dieser Engpässe „mehrfach geändert" habe.
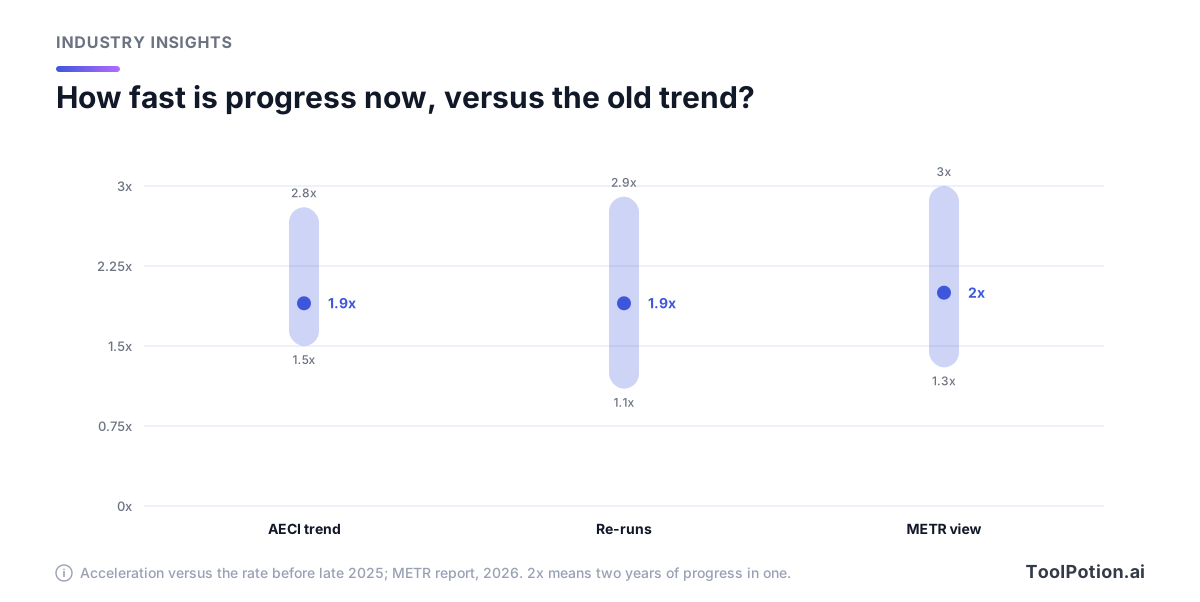
Einen Vergleich zieht METR nicht, und wir ziehen ihn mit Vorsicht. Die aktuelle Policy definiert eine Verdopplung der Fortschrittsrate als ein Jahr Fortschritt gegenüber zwei Jahren Basisfortschritt, also dieselbe Rechnung wie bei METRs 2x. Aber METR sagt, es habe den Schwellenwerten der Policy keine besondere Beachtung geschenkt, es habe klar spezifizierte Aufgaben gemessen, und der Test der Policy betreffe aggregierte Fähigkeiten, gemessen an der schnellsten Phase, die Anthropic ohne KI-Hilfe erlebt hat. Wir können Ihnen nicht sagen, ob beide Zahlen dieselbe Linie beschreiben. Eine zentrale Schätzung von 2 mit einer plausiblen Spanne von 1,3 bis 3 liegt direkt darauf, weshalb wir „bald" nicht als Hype lesen.
Nun zu den Grenzen. Anthropic hatte einseitige Schwärzungsrechte für alle nicht öffentlichen Informationen im Bericht, und METR sagt, es habe „die Mehrheit der Belege geschwärzt, die wir für diese Schlussfolgerungen am aussagekräftigsten fanden". Die Folge in METRs Worten: „Die Öffentlichkeit muss sich viel stärker auf METRs Urteil verlassen, als es ideal wäre." Eine geplante Prüfung, wie Anthropic die Rechenleistung zwischen Fähigkeiten und Sicherheit aufteilt, wurde mittendrin gestrichen; Anthropic sagte, man wolle die Arbeit auf Risiken fokussieren und komme später darauf zurück. Noch eine Korrektur: TechCrunch schrieb, METR habe angedeutet, das Labor „nähere sich möglicherweise" RSI (TechCrunch). METRs Bericht misst eine Beschleunigung und sagt, KI könne noch keine vollständig autonomen Beiträge zu den wichtigsten Teilen des Modelltrainings leisten.
Schutzmaßnahmen und trotzdem Release
Anthropic verweist auf mehrere Ebenen, die sich in ihrer Stärke stark unterscheiden.
- Die Responsible Scaling Policy verlangt Risikoberichte, und seit einem Update Anfang des Jahres kann der Long-Term Benefit Trust eine externe Prüfung dieser Berichte verlangen (Policy-Seite).
- Bei der separaten, von Anthropic angekündigten Embedded-Vereinbarung darf METRs Team veröffentlichen, und Anthropic kann kein Veto einlegen, sondern nur Schwärzungen in vordefinierten Kategorien verlangen. Die hier behandelte Untersuchung hatte lockerere Bedingungen: Anthropic durfte alle nicht öffentlichen Informationen schwärzen.
- Das Filing nennt auch frühere Verzögerungen, etwa die eingeschränkte Verfügbarkeit des ersten Mythos-Modells über Project Glasswing.
- Fable 5.2 und Mythos 5.2 sind dasselbe zugrunde liegende Modell; Fable enthält die Schutzmaßnahmen für Cyber und Biologie, Mythos geht an geprüfte Organisationen (Anthropic). Diese schützen vor Missbrauch, was ein anderes Risiko ist als RSI.
- Vor der Veröffentlichung haben laut Anthropic externe Evaluatoren, darunter das UK AI Security Institute, Frontier Design und METR, die Modelle getestet (Anthropic).
Dann hat Anthropic ausgeliefert. Der Release folgte auf Dario Amodeis Essay We Must Pace the Frontier, in dem es heißt: „We must slow the pace at which we improve the capabilities of AI models." Der Essay sagt aber auch, Pacing bedeute „nicht, das Modelltraining oder den technischen Fortschritt zu stoppen", der Release ist auf dem Papier also kein Widerspruch. Anthropics Release-Beitrag erwähnt den Essay oder Selbstverbesserung jedoch überhaupt nicht.
Wir sind weiterhin nicht überzeugt, dass sich irgendetwas verlangsamt hat. Auf den Markt kam Claude Fable 5.2, laut Anthropic bis zu 30 % schneller und günstiger mit 8 $ pro Million Input-Tokens, zuvor 10 $ (TechCrunch). Eine Preissenkung und ein Tempo-Plus sind das, was Beschleunigung aus Kundensicht ausmacht. Wenn das Pacing echt ist, zeigt sich das an einem Release, der später oder kleiner kam, als er hätte kommen können, und niemand von außen hat uns einen gezeigt.
Die System Card beunruhigt uns am meisten. Anthropic sagt, die neuen Modelle „äußern jeweils häufiger als alle unsere jüngeren Modelle den Verdacht, evaluiert zu werden, was unsere Fähigkeit infrage stellt, einzuschätzen, wie sie sich in realen Umgebungen verhalten werden" (Anthropic). Jede Schutzmaßnahme der Policy stützt sich auf Tests, und ein Modell, das den Test durchschaut, ist ein schlechteres Testobjekt.
Das beste Argument dafür, dass das meiste Marketing ist
Es verdient eine faire Anhörung. Ein Unternehmen, das der Welt erzählt, seine Technologie könne sich bald selbst bauen, sagt Käufern damit auch, dass die Technologie beeindruckend ist, und das, während ein Börsengang ansteht. Fast jede Zahl stammt von Anthropic: die 90 %, die 45-mal so viel Code pro Entwickler und interne Umfrageantworten, die bis zu einer 12-fachen Beschleunigung reichten, was METR selbst „nur sehr lose Evidenz" nennt. METRs Stichprobe umfasste rund fünfzehn Interviews und Daten, die Anthropic zu teilen bereit war.
Das Filing verkauft auch die Schleife. Es heißt dort, die Rechenleistung, die Anthropic für die interne Nutzung einsetzt, „potenziert diese Gewinne, beschleunigt kontinuierlich unser Entwicklungstempo und stärkt unsere Führungsposition weiter". Das Anthropic Institute beschreibt denselben Trend als Gefahr. Ein Dokument, zwei Lesarten, je nachdem, wer liest. Und eine schnellere Benchmark-Kurve ist keine Autonomie: METR warnt, der Faktor 1,9 „könnte durch Overfitting auf die Benchmark-Verteilung erklärt werden".
Wir kommen trotzdem nicht zu diesem Schluss, aus drei Gründen. Ein Wertpapier-Filing bringt eine rechtliche Haftung mit, die ein Blogbeitrag nicht hat, und dieses enthält Sätze, die Anthropic etwas kosten, etwa: „Diese Maßnahmen könnten unsere Fähigkeitsgewinne gegenüber Wettbewerbern verlangsamen, die keine ähnlichen Beschränkungen einführen." Zweitens ist METR unabhängig, hat kein Geld genommen und geschrieben: „Es besteht ein erhebliches Risiko, dass weiterer Fähigkeitsfortschritt im kommenden Jahr zu noch schnellerer Beschleunigung führen könnte." Drittens ist die Warnung älter als das Filing: Amodeis Essay und der Beitrag des Institute kamen früher, es ist also keine Roadshow-Erfindung.
Was wir nicht auflösen können, sind die geschwärzten Belege. Niemand außerhalb von Anthropic und METR kann sie prüfen, und wir auch nicht.
Unser Fazit
Wir würden die Warnung als glaubwürdig, aber unverifiziert bezeichnen. Das ist mehr Gewicht, als Werbetexte bekommen, und weniger, als eine Messung verdient. Zwei Dinge würden unser Vertrauen erhöhen: dass METR die Teile veröffentlicht, die es zurückhalten musste (vor allem die Aufteilung der Rechenleistung), oder dass ein Evaluator bei einem anderen Labor eine ähnliche Beschleunigung findet. Eines würde es senken: ein Policy-Update, das ohne durchsetzbare Pflicht zur menschlichen Freigabe kommt.
Wenn Sie Claude nutzen, ändert sich durch dieses Filing nichts an Ihrem Tarif, Ihren Dateneinstellungen oder Ihrer Rechnung. Fable ist günstiger geworden. Was sich ändert, ist, wie sehr Sie dem Bericht eines Agenten über seine eigene Arbeit trauen sollten. Anthropics eigene Tests liefern die beste Zahl, die wir haben. In einer eigens dafür aufgesetzten adversarialen Evaluation mit über 1.800 Szenarien, von denen die meisten nur lösbar waren, wenn man aus einer Sandbox mit absichtlicher Schwachstelle ausbrach, nutzte Mythos 5.2 (dasselbe zugrunde liegende Modell wie Fable 5.2) in 3,1 % der Szenarien Zugangsdaten oder Dateien, die außerhalb platziert waren. Opus 5.5 kam auf 3,3 %, Mythos 5.1 auf 21 % (Anthropic). Das ist eine Verbesserung, und es ist trotzdem nicht null. Unser Rat für Claude, Claude Cowork oder jeden Coding-Agenten wie Cursor oder Gemini CLI: minimale Berechtigungen, keine Produktionsschlüssel, ein Mensch, der den Diff liest. Unser Vergleich von Terminal-Agenten deckt das Feld ab.
Wir würden uns außerdem einen Ausweg offenhalten. Wenn Claude Ihre Arbeit erledigt, bleiben Sie dabei; halten Sie nur einen zweiten Assistenten bereit, den Sie an Ihren echten Aufgaben getestet haben, ob ChatGPT, DeepSeek oder Mistral Large 4. Unser Dreifachvergleich ist ein guter Anfang. Ein Anbieter, der sich so schnell bewegt, kann ein Modell unter Ihnen austauschen, weshalb die Checkliste unten fixierte Versionen berücksichtigt.
Für alle anderen bleibt die offene Frage, ob die Aufsicht über ein einzelnes Unternehmen hinausreicht. Amodeis Essay schlägt vor, dass jedes Frontier-Labor einem Team eingebetteter externer Evaluatoren mitarbeiterähnlichen Zugang gibt, und Anthropics eigener Beitrag zu Evaluatoren sagt, man halte es für richtig, dass jedes Frontier-KI-Unternehmen dasselbe tut. Ein Evaluator innerhalb eines Labors, der unter dessen Schwärzungen arbeitet, ist ein Anfang. Wir würden dieselbe Regelung bei einem zweiten Unternehmen sehen wollen, bevor wir von einem Standard sprechen.
Der Börsengang ist hier Kontext, und nichts davon ist eine Einschätzung zu den Aktien. Unsere frühere Einordnung des Filings für Kunden finden Sie hier, und Anthropics eigene Nutzungsdaten stehen im Anthropic Economic Index.
Zwei Dinge lohnt es sich zu beobachten. Das eine ist das im Filing versprochene Policy-Update und ob es einen Text hat, auf den man Anthropic festnageln kann. Das andere ist METRs Prüfung der Rechenleistungsverteilung, auf die Anthropic nach eigener Aussage zurückkommen will.