Beschreibung
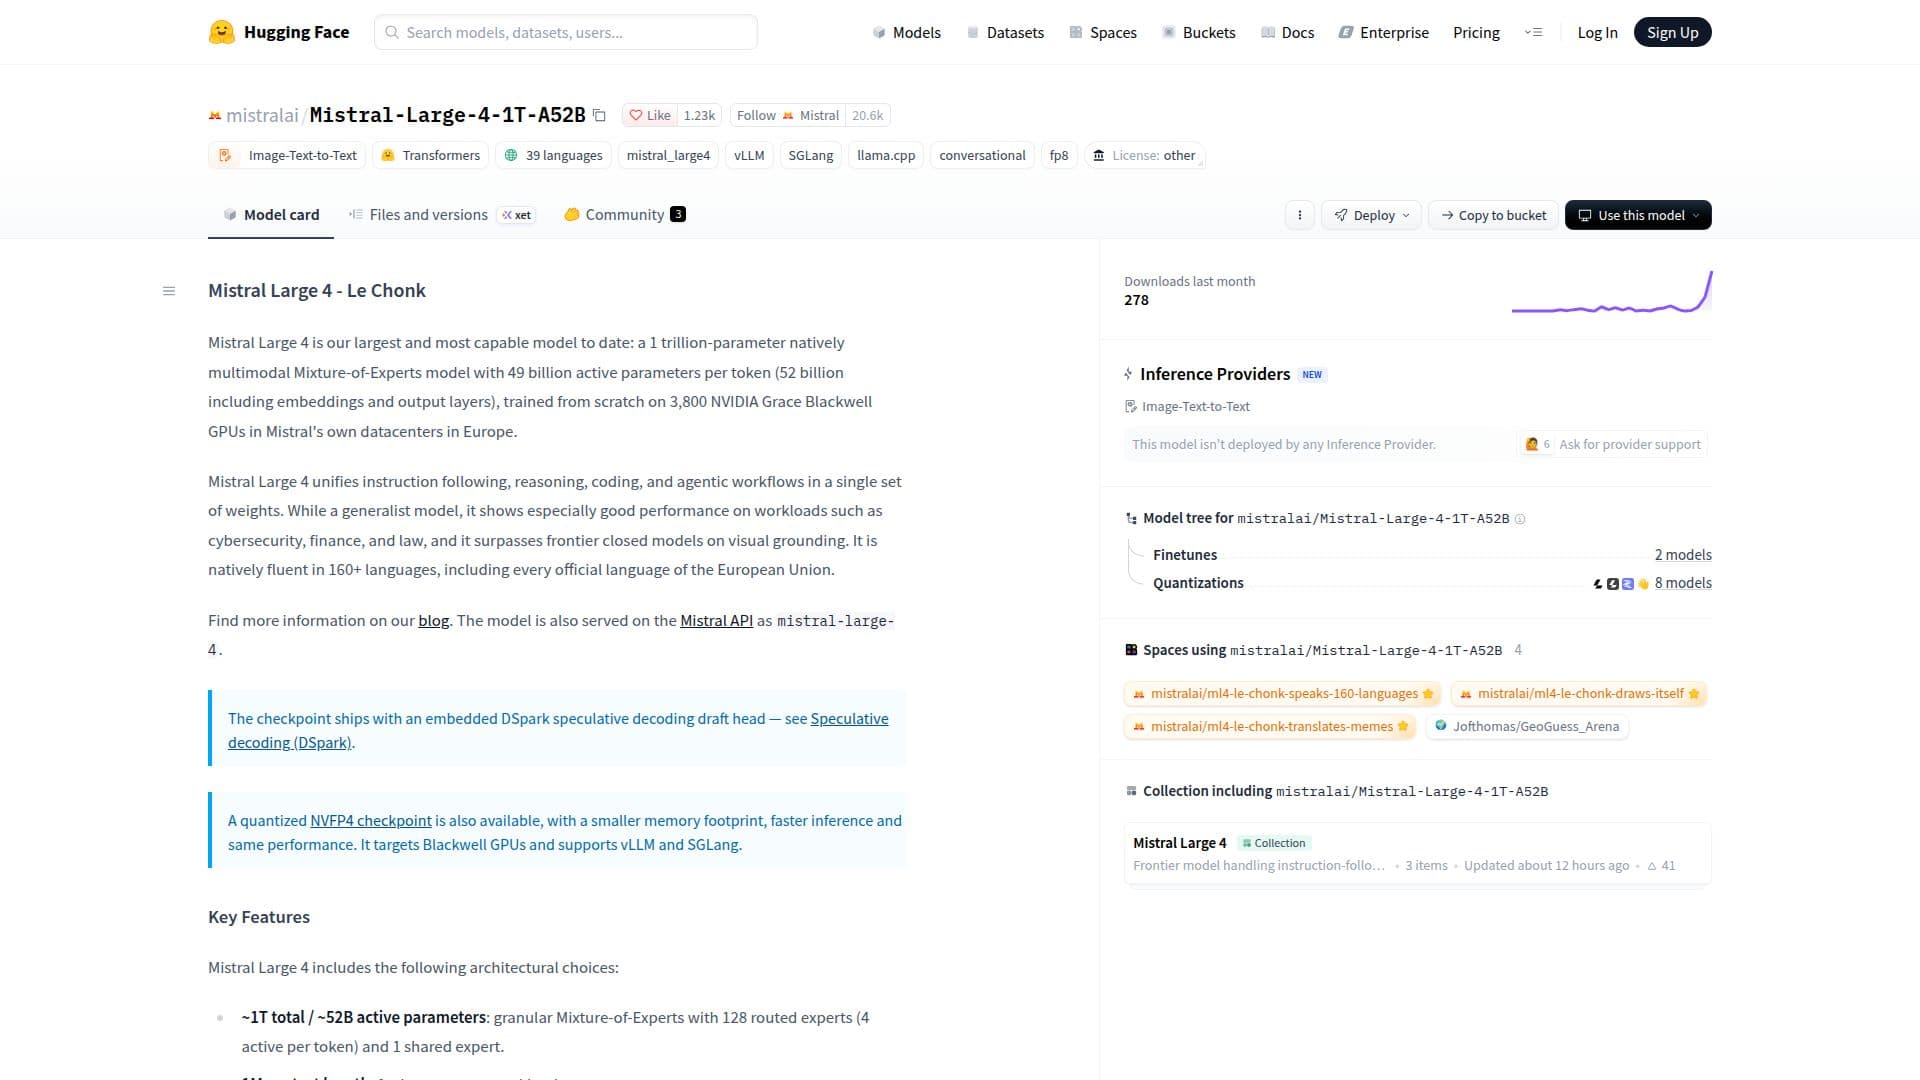
Mistral Large 4, auch bekannt als „Le Chonk“, stellt das bisher fortschrittlichste und leistungsfähigste Modell von Mistral dar. Es handelt sich um ein nativ multimodales Mixture-of-Experts-Modell mit 1 Billion Parametern, das 49 Milliarden aktive Parameter pro Token (52 Milliarden einschließlich Einbettungen und Ausgabeschichten) aufweist. Das Modell wurde von Grund auf auf 3.800 NVIDIA Grace Blackwell GPUs in den europäischen Rechenzentren von Mistral trainiert, was eine robuste Leistung und Skalierbarkeit gewährleistet.
Weiterlesen
Dieses Generalistenmodell vereint die Befolgung von Anweisungen, das Denken, Programmieren und agentische Arbeitsabläufe in einem einzigen Satz von Gewichten. Während es in vielen Bereichen vielseitig einsetzbar ist, zeigt Mistral Large 4 außergewöhnliche Leistungen in spezialisierten Bereichen wie Cybersicherheit, Finanzen und Recht. Es übertrifft auch geschlossene Modelle an der Grenze in Bezug auf visuelle Verankerungsfähigkeiten, was es äußerst effektiv für Aufgaben macht, die Bildanalysen erfordern.
Eine der Hauptstärken von Mistral Large 4 ist seine native Beherrschung von über 160 Sprachen, einschließlich aller Amtssprachen der Europäischen Union. Diese umfangreiche Sprachunterstützung macht es zu einem leistungsstarken Werkzeug für globale Anwendungen. Das Modell verfügt über eine beträchtliche Kontextlänge von 1 Million, die es ihm ermöglicht, Arbeitslasten mit langen Kontexten effizient zu bewältigen. Seine multimodale Eingabefähigkeit erlaubt es, sowohl Text- als auch Bildeingaben zu akzeptieren und Textausgaben zu generieren.
Architektonisch nutzt Mistral Large 4 ein granuläres Mixture-of-Experts-Design mit 128 gerouteten Experten, wobei 4 Experten pro Token aktiv sind, neben 1 gemeinsamen Experten. Es enthält auch einen eingebetteten DSpark-spekulativen Dekodierungsentwurf, der die Dekodierung erheblich beschleunigen kann, ohne die Ausgaben des Zielmodells zu verändern, und in bestimmten Szenarien eine bis zu 1,9-fache höhere Durchsatzrate bietet. Ein quantisierter NVFP4-Checkpoint ist ebenfalls verfügbar, der einen kleineren Speicherbedarf, schnellere Inferenz und gleichwertige Leistung bietet, speziell für Blackwell GPUs und unterstützt vLLM und SGLang.
Mistral Large 4 wird unter der Mistral Ecosystem Open-Weight License veröffentlicht, einer modifizierten MIT-Lizenz, die sowohl kommerzielle als auch nicht-kommerzielle Nutzung erlaubt. Der Betrieb eines Model-as-a-Service-Geschäfts mit Mistral Large 4 erfordert jedoch eine separate kommerzielle Lizenz von Mistral. Das Modell ist über die Mistral API als `mistral-large-4` verfügbar und kann mit verschiedenen Bibliotheken wie vLLM, SGLang, Transformers, llama.cpp, Axolotl, Unsloth und TRL bereitgestellt und feinabgestimmt werden.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
Mistral Large 4 im Überblick
1 Billion Gesamtparameter
52 Milliarden aktive Parameter pro Token
Nativ multimodale Eingabe (Text und Bild)
1 Million Kontextlänge
Mehrsprachige Unterstützung (über 160 Sprachen)
Konfigurierbarer Denkmodus (Niedrig, Mittel, Hoch)
Erweiterte Vision-Fähigkeiten für Bildanalysen
Starke Einhaltung von Systemaufforderungen
Native Funktionsaufrufe und JSON-Ausgabe
Strikte Durchsetzung des JSON-Schemas
State-of-the-Art Cybersicherheitsleistung
Eingebetteter DSpark-spekulativer Dekodierungsentwurf
Quantisierter NVFP4-Checkpoint verfügbar
Open-Weight-Lizenz für kommerzielle und nicht-kommerzielle Nutzung
Erste Schritte mit Mistral Large 4
Modellzugang: Finden Sie Mistral Large 4 auf Hugging Face oder über die Mistral API.
Bereitstellung mit vLLM: Verwenden Sie das offizielle vLLM-Docker-Image für produktionsbereite Inferenz und konfigurieren Sie Parameter wie `--tool-call-parser mistral` und `--reasoning-parser mistral`.
Bereitstellung mit SGLang: Nutzen Sie das offizielle SGLang-Docker-Image und aktivieren Sie die spekulative Dekodierung mit `--speculative-algorithm DSPARK`.
Bereitstellung mit Transformers: Installieren Sie Transformers aus dem Hauptverzeichnis und verwenden Sie den bereitgestellten Python-Inferenz-Snippet für die Bereitstellung auf mehreren GPUs.
Modell feinabstimmen: Verwenden Sie Bibliotheken wie Axolotl, Unsloth oder TRL zur Feinabstimmung von Mistral Large 4.
Integration mit Mistral Vibe: Installieren Sie Mistral Vibe und konfigurieren Sie es, um Mistral Large 4 über die Mistral API oder einen lokalen vLLM-Server zu verwenden.
Denkaufwand konfigurieren: Setzen Sie `reasoning_effort` auf 'niedrig', 'mittel' oder 'hoch' basierend auf der Komplexität der Eingabeaufforderung.
Systemaufforderungen nutzen: Definieren Sie klare Umgebungen und Anwendungsfälle mit Systemaufforderungen für eine effektive Nutzung des Werkzeugs.
Mistral Large 4's Anwendungsfälle
- Komplexe agentische Arbeitsabläufe
- Cybersicherheitsanalyse
- Finanzmodellierung & -analyse
- Verarbeitung juristischer Dokumente
- Mehrsprachige Kommunikation
- Information Retrieval mit langen Kontexten
- Bild- und Diagrammanalyse
- Codegenerierung & -debugging
- Befolgung von Anweisungen & Automatisierung
- Chatbot & Konversations-KI