Beschreibung
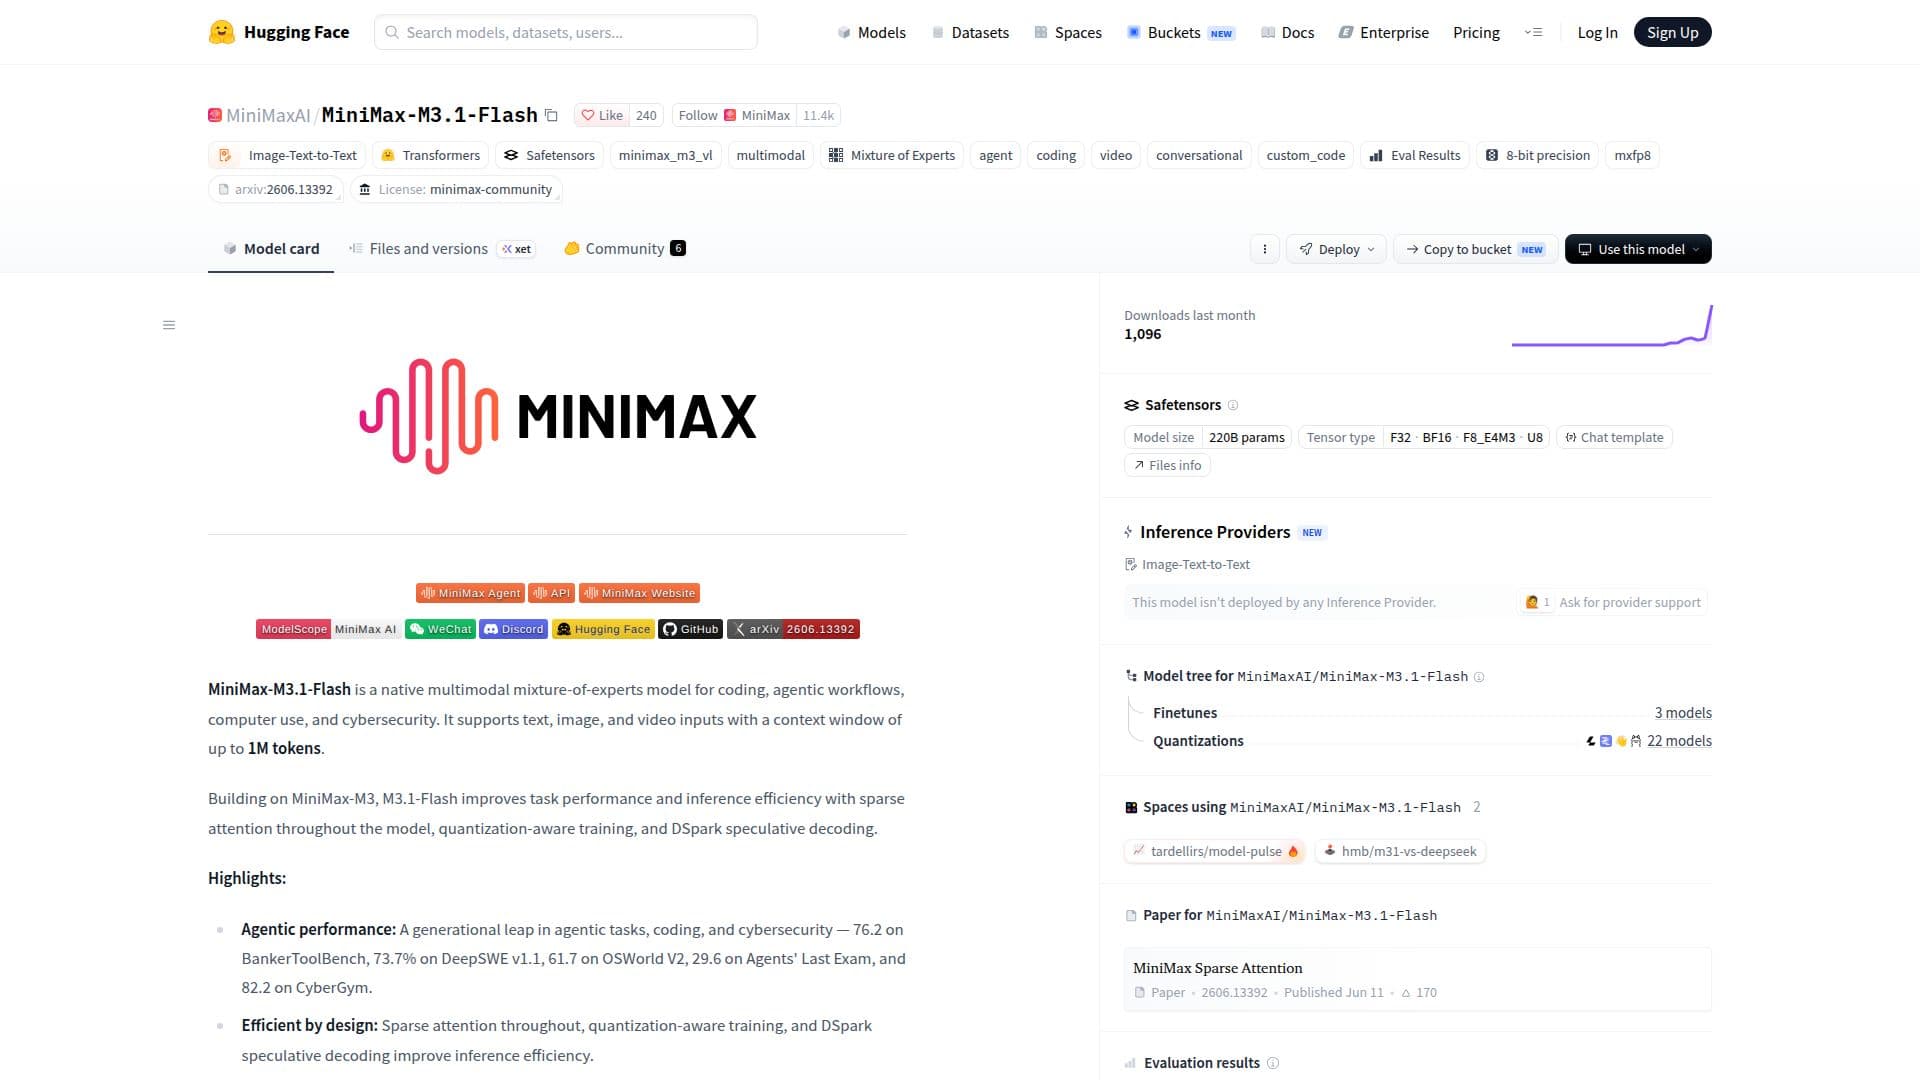
MiniMax-M3.1-Flash ist ein fortschrittliches multimodales Mischmodell von Experten, das entwickelt wurde, um Programmierung, agentische Arbeitsabläufe, Computeranwendungen und Cybersicherheit zu verbessern. Dieses Modell unterstützt Texteingaben, Bilder und Videos und bietet ein Kontextfenster von bis zu 1 Million Tokens. Aufbauend auf der MiniMax-M3-Architektur führt M3.1-Flash Verbesserungen in der Aufgabenleistung und Inferenzeffizienz durch die Verwendung von spärlicher Aufmerksamkeit im gesamten Modell, quantisierungsbewusstem Training und DSpark spekulativer Dekodierung ein.
Weiterlesen
Die Architektur des Modells ist darauf ausgelegt, eine Vielzahl von Eingaben und Ausgaben zu verarbeiten, mit etwa 428 Milliarden Parametern, von denen 23 Milliarden pro Token aktiviert sind. Dies ermöglicht eine effiziente Verarbeitung und hohe Leistung über verschiedene Benchmarks hinweg, einschließlich eines Scores von 76,2 auf BankerToolBench und 82,2 auf CyberGym.
M3.1-Flash wird besonders für seine agentische Leistung geschätzt und bietet einen generationalen Sprung bei Aufgaben im Zusammenhang mit Programmierung und Cybersicherheit. Es erzielt hohe Punktzahlen in mehreren Benchmarks, wie 73,7 % auf DeepSWE v1.1 und 61,7 auf OSWorld V2. Die Effizienz des Modells wird durch Funktionen wie spärliche Aufmerksamkeit und quantisierungsbewusstes Training weiter verbessert, die den Speicherbedarf reduzieren und die Effizienz beim Bereitstellen erhöhen.
Für die Bereitstellung unterstützt MiniMax-M3.1-Flash verschiedene Inferenz-Frameworks, einschließlich SGLang, vLLM und TokenSpeed, mit weiteren Integrationen in Arbeit. Das Modell ist für den Multi-Chip-Einsatz konzipiert und bietet Flexibilität bei den Bereitstellungskonfigurationen. Benutzer können die Inferenzparameter wie Temperatur und top_p anpassen, um die Leistung für spezifische Aufgaben zu optimieren.
Insgesamt ist MiniMax-M3.1-Flash ein leistungsstarkes Werkzeug für Entwickler und Forscher, die fortschrittliche KI-Fähigkeiten in multimodalen Kontexten nutzen möchten, und bietet robuste Unterstützung für komplexe Arbeitsabläufe und Anwendungen in der Cybersicherheit.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
MiniMax-M3.1-Flash im Überblick
Multimodale Mischmodell-Architektur
Unterstützt Texteingaben, Bilder und Videos
Kontextfenster von bis zu 1 Million Tokens
Spärliche Aufmerksamkeit im gesamten Modell
Quantisierungsbewusstes Training
DSpark spekulative Dekodierung
Etwa 428 Milliarden Parameter
Hohe Leistung in mehreren Benchmarks
Erste Schritte mit MiniMax-M3.1-Flash
Zugriff auf die Modellseite: Besuchen Sie die offizielle Hugging Face-Seite für MiniMax-M3.1-Flash
Authentifizieren: Stellen Sie sicher, dass Sie die erforderlichen Anmeldeinformationen haben, um auf das Modell zuzugreifen
Konfigurieren: Richten Sie das Modell mit Ihrem bevorzugten Inferenz-Framework ein
Eingabeaufforderungen senden: Geben Sie Text-, Bild- oder Videodaten zur Verarbeitung ein
Feinabstimmung: Passen Sie Einstellungen wie Temperatur und top_p für optimale Ergebnisse an
MiniMax-M3.1-Flash's Anwendungsfälle
- Programmierungsunterstützung
- Cybersicherheit
- Agentische Arbeitsabläufe
- Multimodale Verarbeitung
- Inferenzeffizienz