Beschreibung
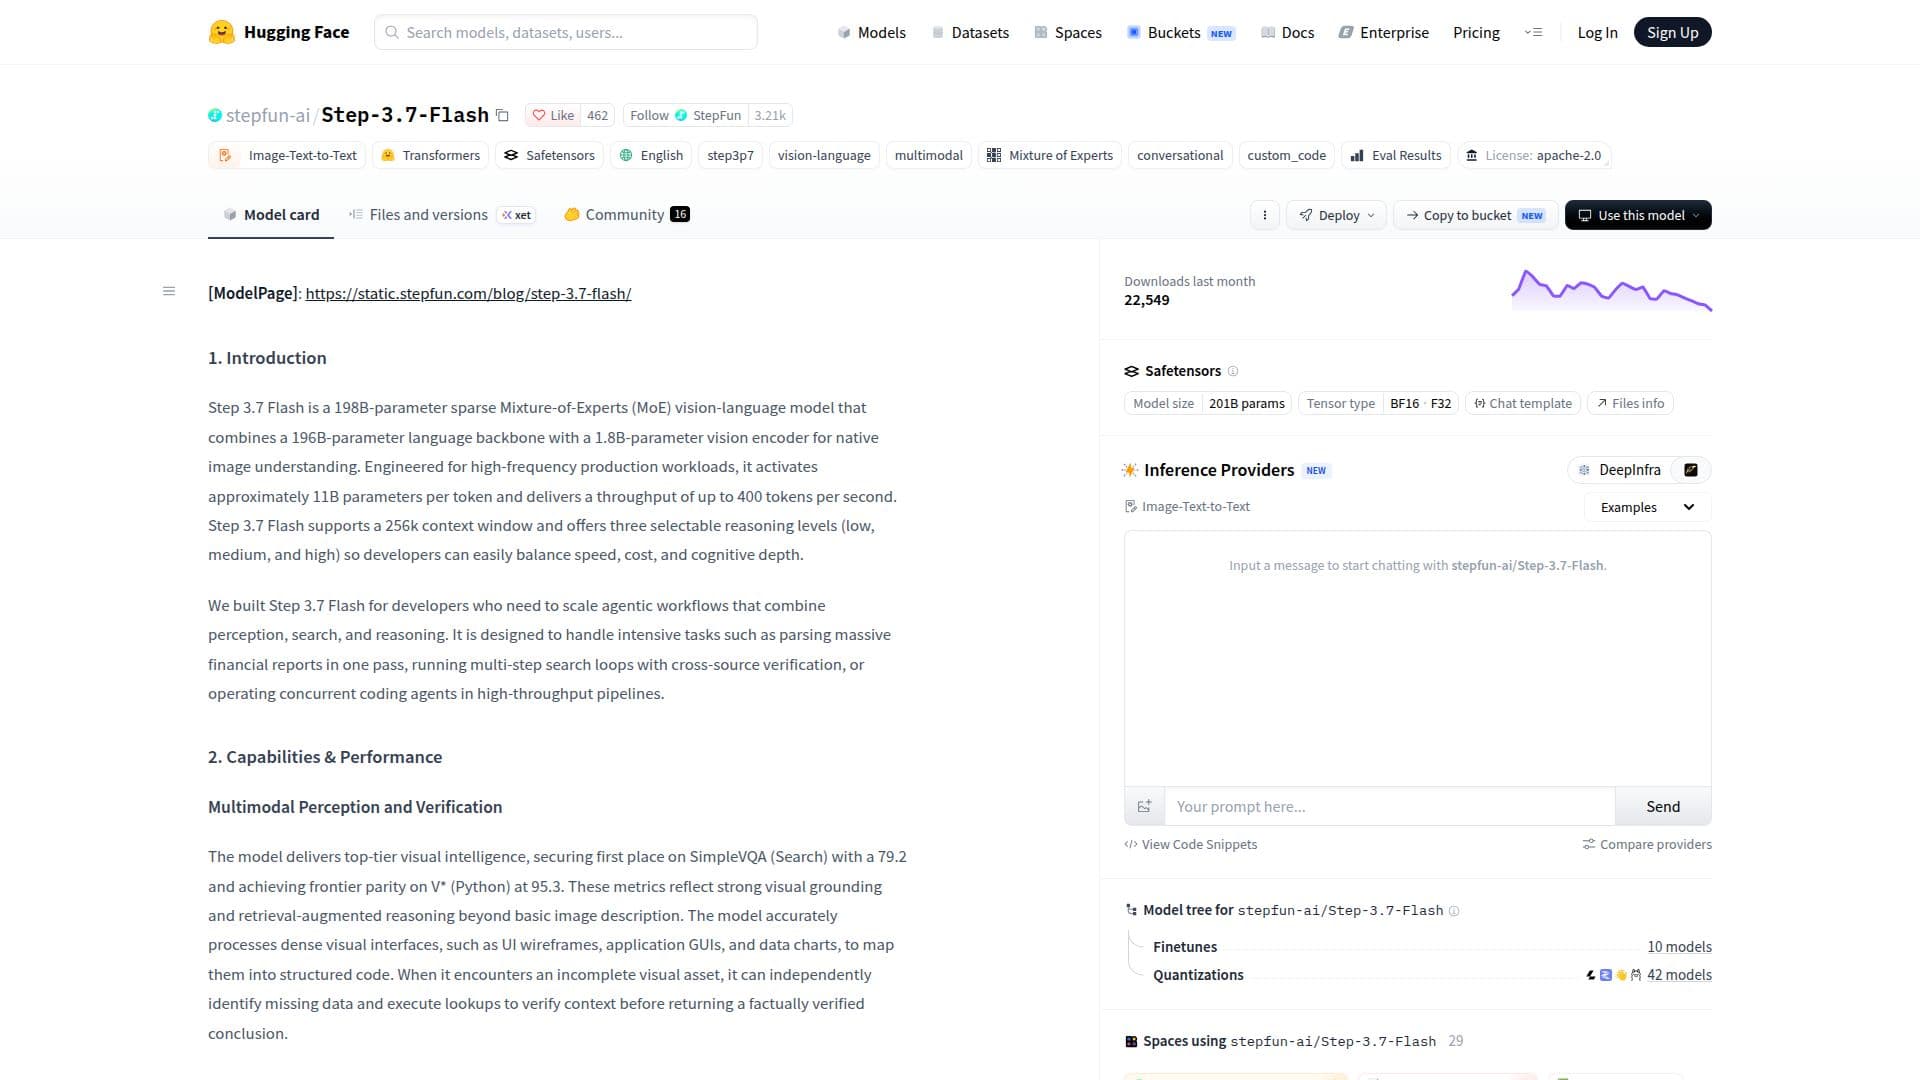
Schritt 3.7 Flash ist ein 198B-Parameter sparsames Mixture-of-Experts (MoE) Vision-Language-Modell, das entwickelt wurde, um hochfrequente Produktionsarbeitslasten zu bewältigen. Es kombiniert ein 196B-Parameter Sprach-Backbone mit einem 1.8B-Parameter Vision-Encoder, der ein natives Verständnis von Bildern ermöglicht und dichte visuelle Schnittstellen wie UI-Drahtmodelle und Datencharts verarbeitet.
Weiterlesen
Das Modell aktiviert etwa 11B Parameter pro Token und liefert eine Durchsatzrate von bis zu 400 Tokens pro Sekunde, unterstützt durch ein Kontextfenster von 256k. Es bietet drei wählbare Denkstufen – niedrig, mittel und hoch – die es Entwicklern ermöglichen, Geschwindigkeit, Kosten und kognitive Tiefe auszubalancieren.
Schritt 3.7 Flash ist für Entwickler konzipiert, die agentische Arbeitsabläufe skalieren müssen, die Wahrnehmung, Suche und Schlussfolgerung kombinieren. Es glänzt bei Aufgaben wie dem Parsen massiver Finanzberichte in einem Durchgang, dem Ausführen von mehrstufigen Suchschleifen mit Quellüberprüfung und dem Betrieb von parallelen Codierungsagenten in Hochdurchsatz-Pipelines.
Das Modell bietet erstklassige visuelle Intelligenz und sichert sich den ersten Platz bei SimpleVQA (Suche) mit einer Punktzahl von 79.2 und erreicht Grenzparität bei V* (Python) mit 95.3. Es verarbeitet genau dichte visuelle Schnittstellen und kann unabhängig fehlende Daten identifizieren und Nachschlagevorgänge ausführen, um den Kontext zu überprüfen, bevor es faktisch verifizierte Schlussfolgerungen zurückgibt.
Schritt 3.7 Flash führt den ClawEval-1.1-Benchmark mit einer Punktzahl von 67.1 an und zeigt eine hohe Widerstandsfähigkeit gegenüber adversarialen Fallen sowie eine strikte Einhaltung der Systemrichtlinien während der mehrstufigen Orchestrierung. Es interagiert zuverlässig mit externen APIs und führt langfristige Arbeitsabläufe aus, ohne von Anweisungen abzuweichen oder Systembeschränkungen zu verletzen.
Die Preisgestaltung für Schritt 3.7 Flash umfasst 0,20 USD pro Million Tokens für Eingabecache-Fehlhits, 0,04 USD pro Million Tokens für Eingabecache-Treffer und 1,15 USD pro Million Tokens für Ausgaben. Das Modell ist auf der StepFun Open Platform, OpenRouter und NVIDIA NIM verfügbar, mit Plänen zur Erweiterung der Verfügbarkeit durch Partnerschaften mit DeepInfra, Fireworks AI und Modal.
Schritt 3.7 Flash unterstützt flexible Bereitstellungen in Cloud-, Rechenzentrums- und lokalen Umgebungen und ist für lokale Inferenz mit branchenüblichen Backends wie vLLM, SGLang, Hugging Face Transformers und llama.cpp optimiert. Es wird in beliebten Open-Source-Infrastrukturen sowohl für Inferenz als auch für die Modellentwicklung unterstützt, einschließlich des NVIDIA Nemo-Ökosystems.
- KategorieKI-Modelle & LLMs
- PreismodellKostenpflichtig
- BereitstellungCloud, Läuft lokal
- PlattformenWeb
Schritt 3.7 Flash im Überblick
198B-Parameter sparsames MoE-Modell
196B Sprach-Backbone
1.8B Vision-Encoder
11B Parameter pro Token aktiviert
400 Tokens pro Sekunde Durchsatz
256k Kontextfenster
Drei Denkstufen
Erstklassige visuelle Intelligenz
Erste Schritte mit Schritt 3.7 Flash
Zugriff auf die Modellseite: Besuchen Sie die Hugging Face Modellseite
Authentifizieren: Verwenden Sie Ihren API-Schlüssel zur Authentifizierung
Konfigurieren: Richten Sie die Modellparameter ein
Eingabeaufforderungen senden: Geben Sie Ihre Anfragen zur Verarbeitung ein
Feinabstimmung: Passen Sie das Modell für spezifische Aufgaben an
Schritt 3.7 Flash's Anwendungsfälle
- Parsing von Finanzberichten
- Mehrstufige Suchschleifen
- Betrieb von Codierungsagenten
- Verarbeitung dichte visueller Schnittstellen
- Autonome API-Interaktion