

Beschreibung
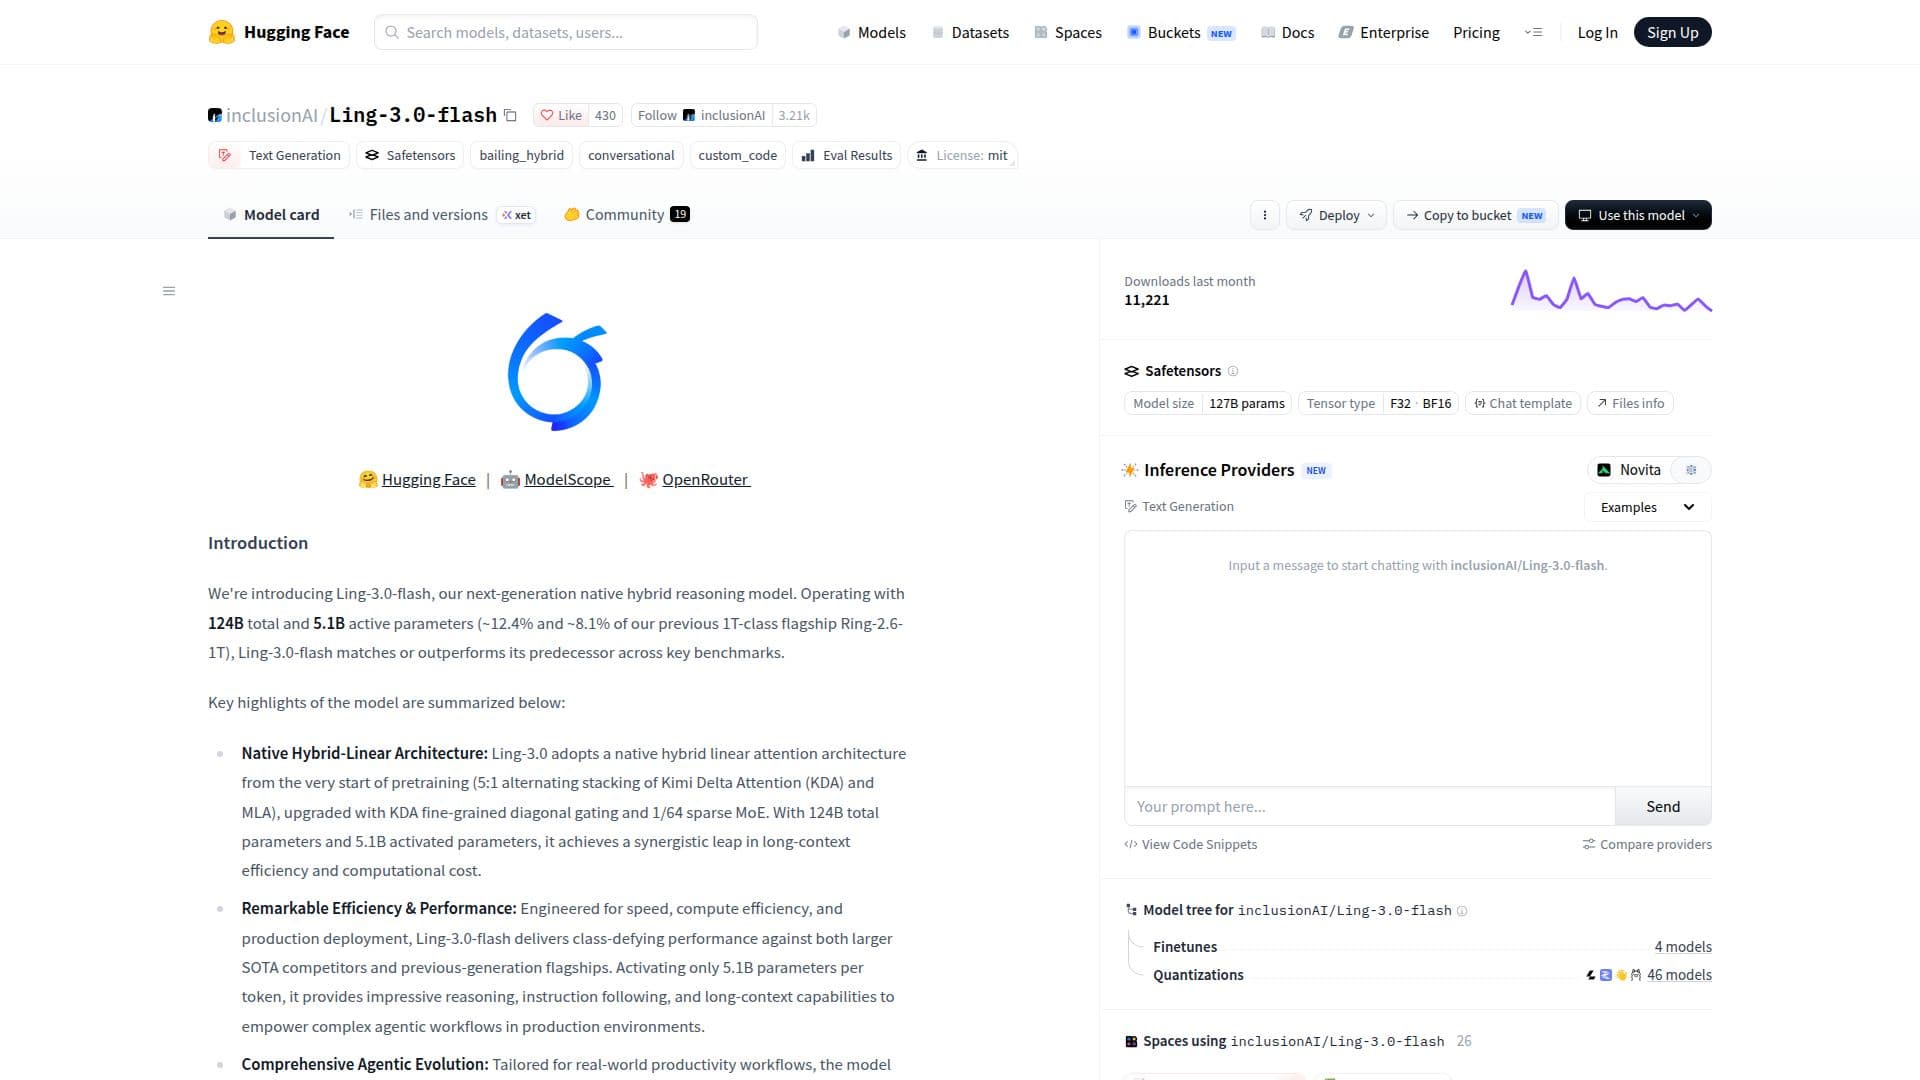
Ling-3.0-flash ist ein hochmodernes hybrides Denkmodell, das von inclusionAI entwickelt und auf Hugging Face gehostet wird. Es arbeitet mit insgesamt 124 Milliarden Parametern, wobei pro Token 5,1 Milliarden aktiviert sind, was bemerkenswerte Effizienz und Leistung bietet. Das Modell verwendet eine native hybride lineare Aufmerksamkeitsarchitektur, die Kimi Delta Attention (KDA) und MLA umfasst, aufgerüstet mit feingranularer diagonaler Steuerung und spärlichem MoE. Diese Architektur ermöglicht es Ling-3.0-flash, einen synergistischen Sprung in der Effizienz bei langen Kontexten und den Rechenkosten zu erreichen.
Weiterlesen
Entwickelt für Geschwindigkeit und Recheneffizienz, bietet Ling-3.0-flash eine leistungsstarke Performance im Vergleich zu größeren, hochmodernen Wettbewerbern und Flaggschiffen der vorherigen Generation. Es ermöglicht komplexe agentische Arbeitsabläufe in Produktionsumgebungen und aktiviert nur 5,1 Milliarden Parameter pro Token. Das Modell integriert über 10.000 interaktive Trainingsumgebungen, um eine End-to-End-Closed-Loop-Ausführung über Programmier-, allgemeine und tiefgehende Forschungsagentenaufgaben zu erreichen.
Ling-3.0-flash integriert die SGLang HiCache + Mooncake hierarchische Caching-Architektur, die physische Dual-Pools und einen clustergeteilten L3-Cache umfasst. Diese Konfiguration eliminiert redundante Neuberechnungen während langer Interaktionen und reduziert die Zeit bis zum ersten Token (TTFT) um 60 % bis über 80 % in Szenarien mit langen Eingaben. Das Modell schneidet in mehreren autoritativen Benchmarks stark ab, darunter SWE-Bench Pro, SWE-Bench Multilingual, Tau3-banking-AA, MCP-Atlas und SkillsBench.
Das Modell ist auf produktive Arbeitsabläufe in der realen Welt zugeschnitten und bietet starke Leistungen in allgemeinem Wissen, mathematischer Argumentation, dem Befolgen von Anweisungen und dem Verständnis von langen Kontexten. Ling-3.0-flash ist für den Einsatz in der Produktion konzipiert und bietet beeindruckende Argumentationsfähigkeiten und Effizienz bei langen Kontexten, was es für komplexe agentische Arbeitsabläufe geeignet macht.
- KategorieKI-Modelle & LLMs
- PreismodellFreemium
- BereitstellungCloud
- PlattformenWeb
Ling-3.0-flash im Überblick
Native Hybride-Lineare Architektur
Bemerkenswerte Effizienz & Leistung
Umfassende agentische Evolution
SGLang HiCache + Mooncake Caching
End-to-End Closed-Loop-Ausführung
Effizienz bei langen Kontexten
Befolgen von Anweisungen
Mathematische Argumentation
Erste Schritte mit Ling-3.0-flash
Zugriff auf die Modellseite: Besuchen Sie Hugging Face
Authentifizieren: Melden Sie sich bei Ihrem Konto an
Konfigurieren: Parameter und Präferenzen festlegen
Eingabeaufforderungen senden: Geben Sie Ihre Anfragen ein
Feinabstimmung: Modell-Einstellungen anpassen
Ling-3.0-flash's Anwendungsfälle
- Programmierungsaufgaben
- Forschungsagenten
- Befolgen von Anweisungen
- Verständnis von langen Kontexten
- Mathematische Argumentation







