Beschreibung
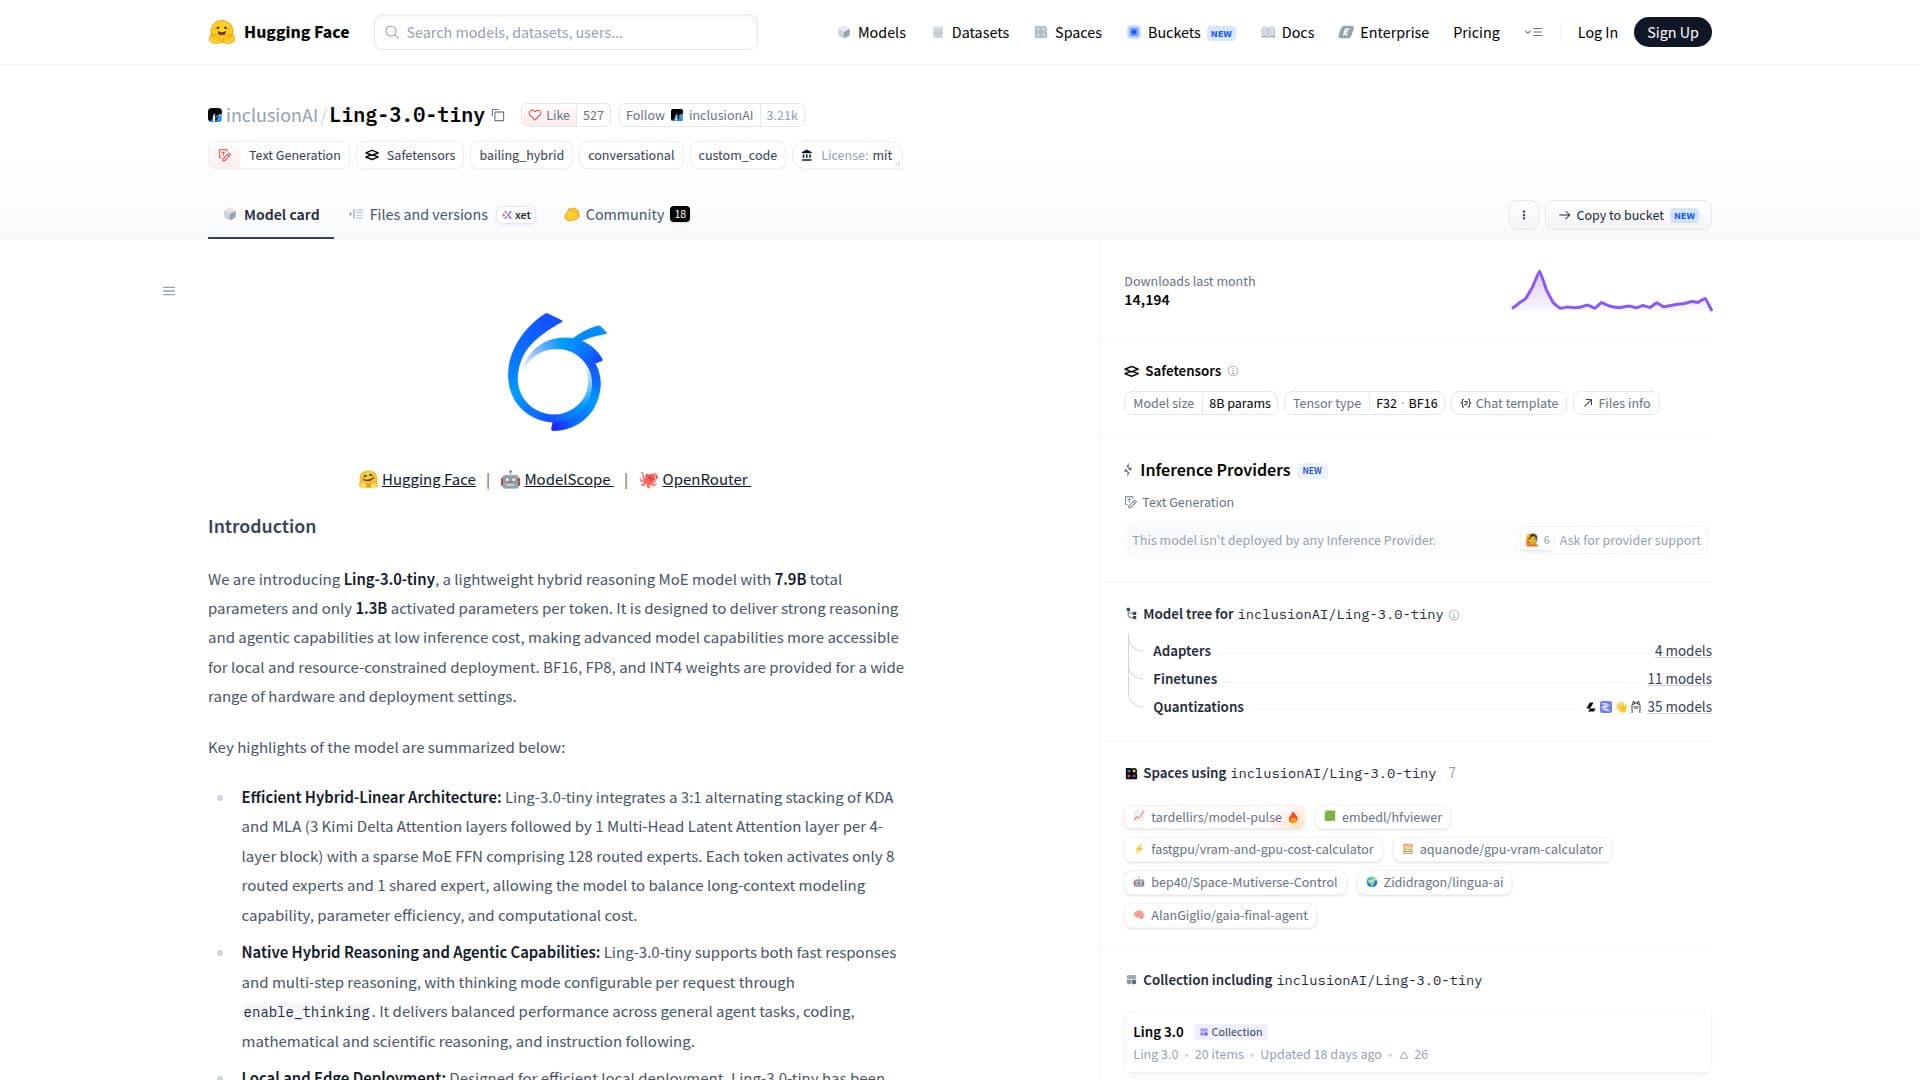
Ling-3.0-tiny ist ein leichtgewichtiges hybrides Denkmodell, das von inclusionAI entwickelt und auf Hugging Face gehostet wird. Es verfügt über insgesamt 7,9 Milliarden Parameter, von denen nur 1,3 Milliarden pro Token aktiviert sind, was es effizient für lokale und ressourcenbeschränkte Bereitstellungen macht. Das Modell integriert eine 3:1-Wechselstapelung von Kimi Delta Attention (KDA) und Multi-Head Latent Attention (MLA) Schichten sowie ein sparsames Mixture of Experts (MoE) Feed-Forward-Netzwerk (FFN) mit 128 gerouteten Experten. Diese Architektur ermöglicht es dem Modell, die Fähigkeit zur Modellierung von langen Kontexten, die Parameter-Effizienz und die Rechenkosten auszubalancieren.
Weiterlesen
Ling-3.0-tiny ist darauf ausgelegt, starke Denk- und agentische Fähigkeiten zu einem niedrigen Inferenzkosten zu liefern. Es unterstützt sowohl schnelle Antworten als auch mehrstufiges Denken mit einem konfigurierbaren Denkmodus. Das Modell wurde auf verschiedenen Hardware-Plattformen validiert, darunter NVIDIA DGX Spark und Apple Silicon MacBook, und ermöglicht fähige Denk- und agentische Arbeitslasten ohne die Notwendigkeit von GPUs der Datacenter-Klasse. Mit FP8 erreicht es etwa 100-105 Tokens pro Sekunde auf DGX Spark und 86-90 Tokens pro Sekunde auf einem M4 Pro MacBook, mit einem maximalen Speicherverbrauch von etwa 8,34 GiB bei einer Kontextlänge von 8K.
Die Effizienz des Modells wird durch seine Leistung im Artificial Analysis Intelligence Index v4.1.1 hervorgehoben, wo es 25 Punkte erzielt, und im Artificial Analysis Agentic Index, wo es 16 Punkte erreicht. Es erreicht eine Ausgabegeschwindigkeit von über 160 Tokens pro Sekunde, mit einer End-to-End-Latenz von etwa 18 Sekunden für eine 500-Token-Antwort. Ling-3.0-tiny eignet sich für eine Vielzahl von Aufgaben, einschließlich agentischer Aufgaben, Programmierung, Verständnis von langen Kontexten, Zuverlässigkeit von Wissen, mathematisches und wissenschaftliches Denken sowie das Befolgen von Anweisungen.
- KategorieKI-Modelle & LLMs
- PreismodellFreemium
- BereitstellungLäuft lokal
- PlattformenWeb
Ling-3.0-tiny im Überblick
7,9B Gesamtparameter
1,3B aktivierte Parameter pro Token
Hybride Denkfähigkeiten
Effiziente lokale Bereitstellung
3:1 KDA-MLA-Architektur
Sparsames MoE FFN mit 128 Experten
Unterstützt schnelle Antworten und mehrstufiges Denken
Validiert auf NVIDIA DGX Spark und Apple Silicon
Erste Schritte mit Ling-3.0-tiny
Zugriff auf die Modellseite: Besuchen Sie Hugging Face
Authentifizieren: Melden Sie sich bei Ihrem Konto an
Konfigurieren: Richten Sie die Modellparameter ein
Eingaben senden: Verwenden Sie das Modell für die Inferenz
Feinabstimmung: Passen Sie die Einstellungen für spezifische Aufgaben an
Ling-3.0-tiny's Anwendungsfälle
- Agentische Aufgaben
- Programmierung
- Wissenschaftliches Denken
- Befolgen von Anweisungen
- Lokale Bereitstellung